Conformité de la qualité des données : guide d'audit 2026
|
7
minute de lecture

Une mauvaise qualité des données coûte en moyenne 12,9 millions USD par an aux organisations selon le benchmark cité dans une étude de marché, et ce avant même de parler du constat d'audit, du ticket de remédiation ou du rapport auquel plus personne ne fait confiance. Dans les environnements réglementés, ce coût cesse d'être un problème d'efficacité pour devenir un problème de contrôle, car les mêmes enregistrements fragiles qui ralentissent les analystes affaiblissent aussi les preuves réglementaires, financières et d'audit.
J'ai vu ce schéma se répéter dans des Data Warehouses et des Data Pipelines qui semblaient sains en apparence. Les rapports correspondaient aux chiffres du mois précédent, les alertes étaient bruyantes mais familières, puis une revue de conformité a mis au jour le vrai problème : personne ne pouvait prouver comment les données avaient été validées, tracées ou défendues. C'est précisément cet écart que traite ce guide : transformer des contrôles continus de qualité des données en preuves d'audit capables de résister à un examen approfondi.
Table des matières
Pourquoi la conformité de la qualité des données est un sujet de direction générale
Comment une mauvaise qualité des données provoque des manquements de conformité
Relier les dimensions de la qualité des données aux normes réglementaires
Pourquoi la validation par règles ne suffit plus à la conformité moderne
Constituer des preuves prêtes pour l'audit grâce au monitoring continu
Étude de cas : remplacer 9000 règles manuelles par une observabilité pilotée par l'IA
Opérationnaliser la conformité de la qualité des données entre les équipes
Pourquoi la conformité de la qualité des données est un sujet de direction générale
Un dispositif de contrôle des données fragile crée un risque au niveau de la direction bien avant de devenir un constat d'audit. Un benchmark largement cité estime le coût moyen d'une mauvaise qualité des données à 12,9 millions USD par an, et la même étude évalue les pertes jusqu'à 3 100 milliards USD par an pour l'économie américaine synthèse d'étude de marché. Ces chiffres comptent parce qu'ils montrent à quelle vitesse les lacunes de validation deviennent une exposition financière, et pas seulement un travail de nettoyage pour l'équipe data.
Le coût opérationnel apparaît d'abord dans la salle de contrôle. Lorsque les rapports de chiffre d'affaires reposent sur des jeux de données incohérents, lorsque les enregistrements d'audit sont incomplets ou lorsque les équipes ne savent pas expliquer comment un chiffre a été produit, le problème cesse d'être un problème d'outillage pour devenir un problème de responsabilité. La même source associe une mauvaise qualité des données à un impact négatif sur 31 % du chiffre d'affaires et indique que les équipes data peuvent consacrer jusqu'à 80 % de leur temps à nettoyer et préparer les données au lieu de les analyser synthèse d'étude de marché. C'est un coup direct porté à la fois à la supervision et à l'exécution.
Règle pratique : si un jeu de données ne peut pas être validé, tracé et défendu, le tableau de bord n'est qu'une façade.
La mesure constitue la ligne de fracture suivante. Une enquête sectorielle a révélé que 59 % des organisations ne mesurent pas du tout la qualité de leurs données synthèse d'étude de marché. Dans les secteurs réglementés comme les services financiers, la santé, les télécoms et le secteur public, cette lacune crée des frictions lors des audits, car des données non mesurées ne peuvent pas être défendues de manière cohérente lorsque quelqu'un demande des preuves.
Pour les équipes qui définissent leur socle, ce que signifie la conformité des données en pratique constitue un bon point de départ. Les responsables juridiques et opérationnels s'appuient aussi sur des procédures de gouvernance et de conformité, car la véritable défaillance n'est généralement pas un champ erroné isolé. C'est l'absence d'un système de contrôle capable de prouver comment les données ont été vérifiées, corrigées et conservées.
Comment une mauvaise qualité des données provoque des manquements de conformité
Les manquements de conformité ressemblent rarement à une panne franche. Ils se manifestent généralement par des rapports incohérents, une échéance de déclaration manquée ou une piste d'audit incapable de prouver que les chiffres ont été vérifiés. C'est pour cela qu'ils sont difficiles à détecter tôt. Les équipes ne remarquent souvent le problème que lorsque quelqu'un demande comment un chiffre a été produit, bien après le début de la dérive du pipeline.
La pression réglementaire est déjà bien réelle. La synthèse sur la réglementation numérique rappelle que le Data Governance Act de l'UE s'applique depuis le 24 septembre 2023, et que les entreprises qui fournissaient déjà des services d'intermédiation de données au 23 juin 2022 avaient jusqu'au 24 septembre 2025 pour se conformer aux dispositions applicables aux intermédiaires. La gouvernance n'est plus une préférence interne. Elle est inscrite dans la loi, et des contrôles de données fragiles deviennent une exposition juridique.
Où les défaillances commencent généralement
Le point de rupture est souvent organisationnel plutôt que technique. Un contrôle casse au moment du passage de relais entre systèmes sources, une équipe utilise des définitions incohérentes, ou la validation manuelle est jugée suffisante parce que la revue mensuelle passe habituellement. Dans la même synthèse réglementaire, une enquête indique que 58 % des organisations estiment qu'une mauvaise qualité des données a causé d'importants problèmes de conformité, et 45 % font état de cadres de gouvernance des données insuffisants ou incohérents.
La qualité des données devient un problème de conformité lorsque personne ne peut montrer que le contrôle s'est exécuté au bon moment, sur les bonnes données, avec le bon résultat.
L'impact métier suit le même schéma. L'impact d'une mauvaise qualité des données sur l'entreprise montre comment des données fragiles débordent de l'analytique pour atteindre les décisions opérationnelles, où les erreurs sont plus difficiles à défendre et à corriger. Une autre étude de marché citée dans la même synthèse indique que 78 % des grandes entreprises ont rencontré d'importants problèmes de qualité des données au cours des 12 derniers mois, et que 54 % déclarent que ces problèmes ont directement affecté leur chiffre d'affaires, leur conformité réglementaire ou leur efficacité opérationnelle. Si les données d'entrée sont instables, les preuves de conformité le sont aussi.
Des audits périodiques aux contrôles de conformité continus
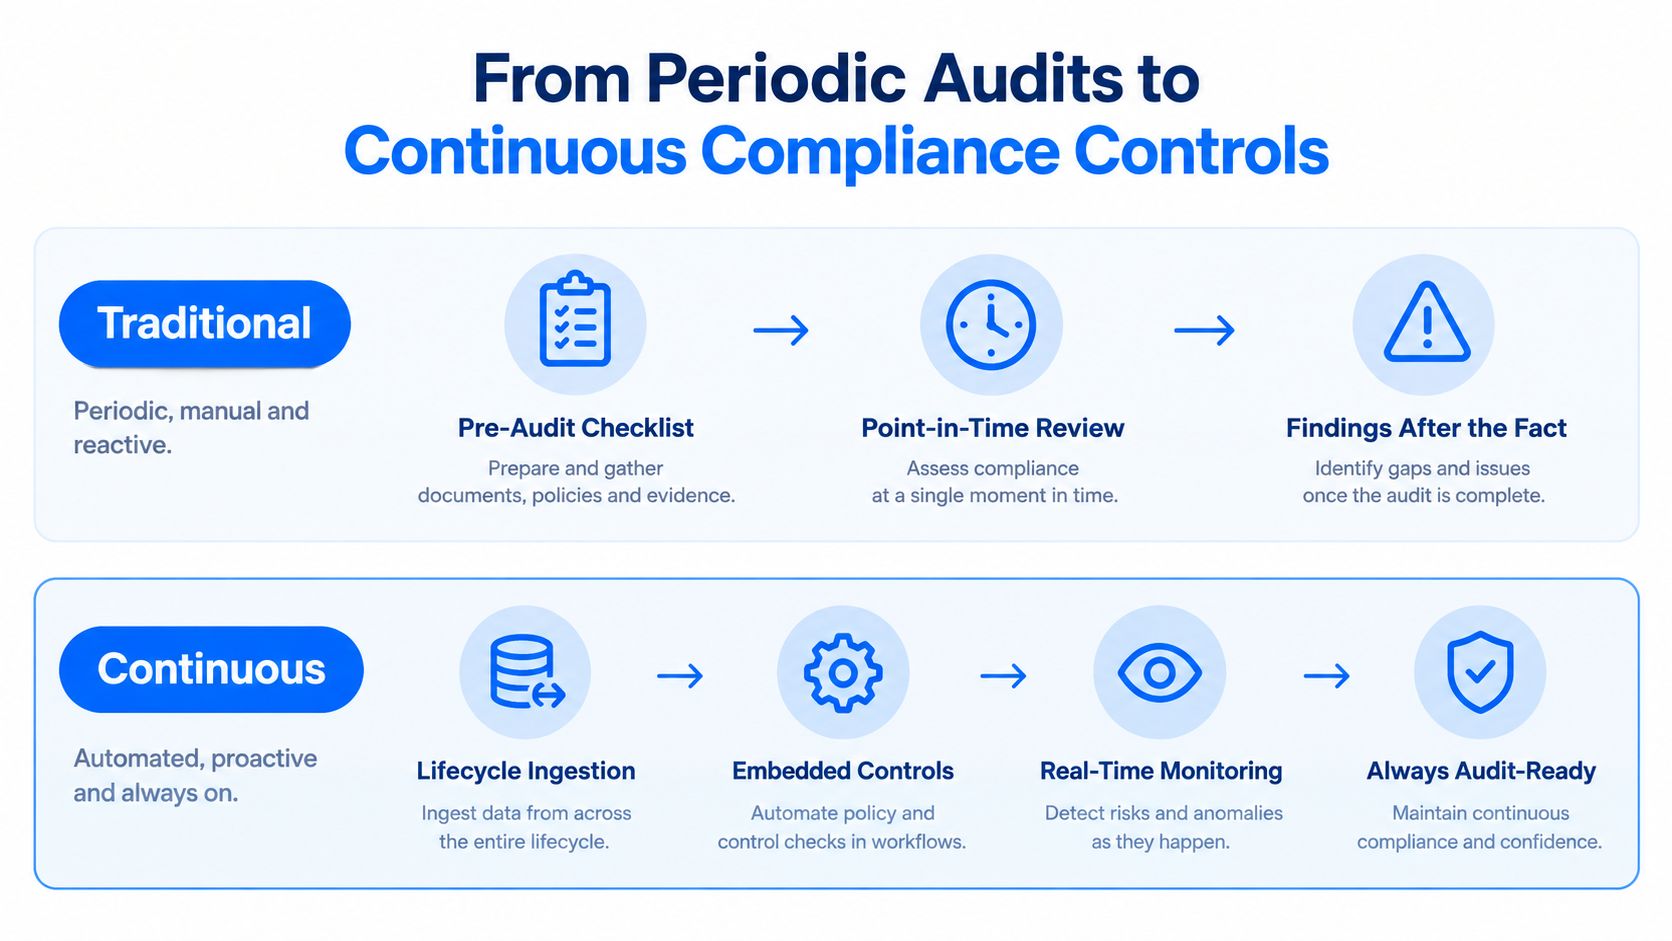
Les audits périodiques restent importants, mais ils sont trop lents pour constituer la seule ligne de défense. Le temps qu'un audit détecte un contrôle défaillant, les mauvaises données ont déjà traversé l'ingestion, la transformation et le reporting. C'est pourquoi la conformité de la qualité des données moderne repose sur des contrôles continus intégrés au cycle de vie, et non sur une revue trimestrielle.

Ce changement paraît abstrait tant qu'on ne le rattache pas au travail que votre équipe fait déjà. Le monitoring continu surveille la fraîcheur, la complétude et les changements structurels au fil du parcours des données. La validation automatisée applique la même logique à chaque exécution, ce qui compte, car les auditeurs s'intéressent moins à l'existence d'une règle qu'à son application cohérente. La documentation du lineage boucle la boucle en montrant d'où viennent les données, comment elles ont été transformées et quels contrôles les ont concernées.
Ce qui change sur le plan opérationnel
Dans un modèle périodique, la gouvernance est quelque chose à quoi l'on se prépare. Dans un modèle continu, la gouvernance est quelque chose que la plateforme produit chaque jour. Cette différence réduit l'écart entre la conception et l'exécution des contrôles, car les preuves sont générées dans le cadre du traitement normal au lieu d'être reconstituées après coup.
Règle pratique : si un contrôle n'existe que pendant la préparation de l'audit, ce n'est pas un contrôle, c'est un aide-mémoire.
Le grand avantage de ce modèle, c'est qu'il correspond au comportement réel des pipelines réglementés. Les données arrivent en retard, les Schemas dérivent et les systèmes sources changent sans grand préavis. Lorsque les contrôles sont intégrés au workflow, l'équipe voit ces défaillances assez tôt pour les corriger avant qu'elles ne deviennent des défauts de reporting.
Un schéma de mise en œuvre utile consiste à acheminer automatiquement ces contrôles vers le reporting de conformité, et c'est là que l'automatisation du reporting de conformité devient pertinente sur le plan opérationnel. Elle supprime le travail manuel de compilation qui ralentit habituellement la réponse aux audits.
Relier les dimensions de la qualité des données aux normes réglementaires
Les cadres de conformité et les équipes de data engineering utilisent souvent des vocabulaires différents pour le même problème. Un régulateur demande si l'enregistrement est apte à l'usage, tandis qu'un ingénieur demande si la colonne a passé la validation. L'écart se referme lorsqu'on relie les dimensions de qualité à des normes reconnues au lieu de les traiter comme des conversations distinctes.
Le Data Quality Guidance du gouvernement canadien définit neuf dimensions : accès, exactitude, cohérence, complétude, homogénéité, interprétabilité, pertinence, fiabilité et actualité guide du gouvernement canadien. Les Archives nationales australiennes identifient l'ISO 8000-110:2021 comme norme mondiale pour la qualité des données et les données de référence d'entreprise, et énumèrent des dimensions courantes comme l'exactitude, la complétude, la cohérence, l'intégrité, l'actualité, l'unicité/déduplication et la validité guide des Archives nationales australiennes.
Ce que les auditeurs peuvent réellement exploiter
Ces cadres comptent parce qu'ils donnent aux équipes un langage qui se traduit directement en contrôles. Si une politique exige que les données clients soient exactes et à jour, l'équipe technique peut traduire cela en règles de validation, en contrôles de latence et en logique de rapprochement. Si la politique exige des données fiables, les preuves doivent montrer comment et quand elles ont été testées.
Le Data Governance Primer de l'Administration for Community Living des États-Unis indique que les données d'entreprise doivent être testées périodiquement par rapport à des normes de qualité définies et cite l'accès aux données, la définition des données, les politiques de confidentialité, les normes de sécurité et les normes de qualité des données comme thèmes de gouvernance guide de l'ACL. Le gouvernement de Nouvelle-Galles du Sud ajoute un détail opérationnel utile : la gestion de la qualité des données est un processus continu sur l'ensemble du cycle de vie des données, et les agences doivent définir des exigences liées aux besoins métier, y compris des normes de disponibilité, des indicateurs et des objectifs module qualité des données de la NSW.
Cette combinaison constitue le modèle pratique. Les normes définissent les dimensions, la gouvernance définit les responsabilités et les opérations définissent la manière dont les preuves sont produites.
Pour les équipes qui transforment ces catégories en cartographie de contrôles opérationnelle, les dimensions de la qualité des données constituent une référence utile. Ce que l'on sait nommer clairement est toujours plus facile à auditer.
Pourquoi la validation par règles ne suffit plus à la conformité moderne
La validation par règles a toujours sa place, mais elle montre vite ses limites lorsque les pipelines deviennent plus volumineux, plus rapides et plus interdépendants. Les contrôles codés en dur fonctionnent lorsque le modèle de données est stable et que les exceptions sont rares. Ils fonctionnent mal lorsque les Schemas changent, que les systèmes sources évoluent ou que la même règle doit être maintenue à une demi-douzaine d'endroits.
Le vrai problème, c'est la maintenance
Une règle peut vous dire que quelque chose a échoué. Elle ne peut pas vous dire si l'échec est significatif dans son contexte, si la structure des données a changé, ou si un même comportement est normal pour une source et suspect pour une autre. C'est ainsi que les équipes se retrouvent avec une fatigue des alertes, des scripts SQL fragiles et des contrôles qui s'éloignent de la réalité. Le coût opérationnel ne se limite pas au temps d'exécution : c'est aussi la perte de connaissances lorsqu'un ingénieur s'en va et emporte avec lui la logique des règles.
L'écart de conformité dépasse l'exactitude, la complétude et l'actualité. Les évolutions réglementaires récentes exigent des preuves, pas seulement des règles. Cela signifie un lineage démontrable, une traçabilité, des sources de données d'entraînement documentées et des indicateurs de qualité mesurables. Les exigences de l'AI Act de l'UE pour les systèmes à haut risque insistent sur la documentation des sources, des transformations et de l'utilisation des données d'entraînement, tandis que le cadre 2026 de l'ETSI formalise 18 indicateurs de qualité des données, dont l'utilisabilité, le lineage, la traçabilité et l'actualité synthèse réglementaire et normative.
Un ensemble de règles statiques peut prouver qu'une condition a été vérifiée. Il ne peut pas prouver que l'environnement de contrôle dans son ensemble est resté digne de confiance.
C'est là que l'observabilité prend tout son sens. Le monitoring continu détecte les dérives, surveille les changements de contexte et conserve l'historique opérationnel dont les auditeurs ont besoin. Il aide aussi les équipes à éviter le piège classique qui consiste à traiter la conformité comme une checklist plutôt que comme un système de contrôle vivant.
Pour les Data Warehouses qui reposent encore sur des validations faites à la main, une comparaison directe est disponible dans les règles techniques de qualité des données définies manuellement. En pratique, la question n'est pas de savoir si les règles doivent exister. C'est de savoir si elles suffisent à elles seules. En général, ce n'est pas le cas.
Constituer des preuves prêtes pour l'audit grâce au monitoring continu
La différence entre réussir et échouer un audit tient souvent à la preuve. Si un contrôle de validation a eu lieu mais qu'il n'existe aucun enregistrement durable du jeu de données, des paramètres de la règle, de l'horodatage et du résultat, le contrôle est difficile à défendre. C'est pourquoi je considère les preuves prêtes pour l'audit comme un objectif de conception à part entière, et non comme un effet secondaire.
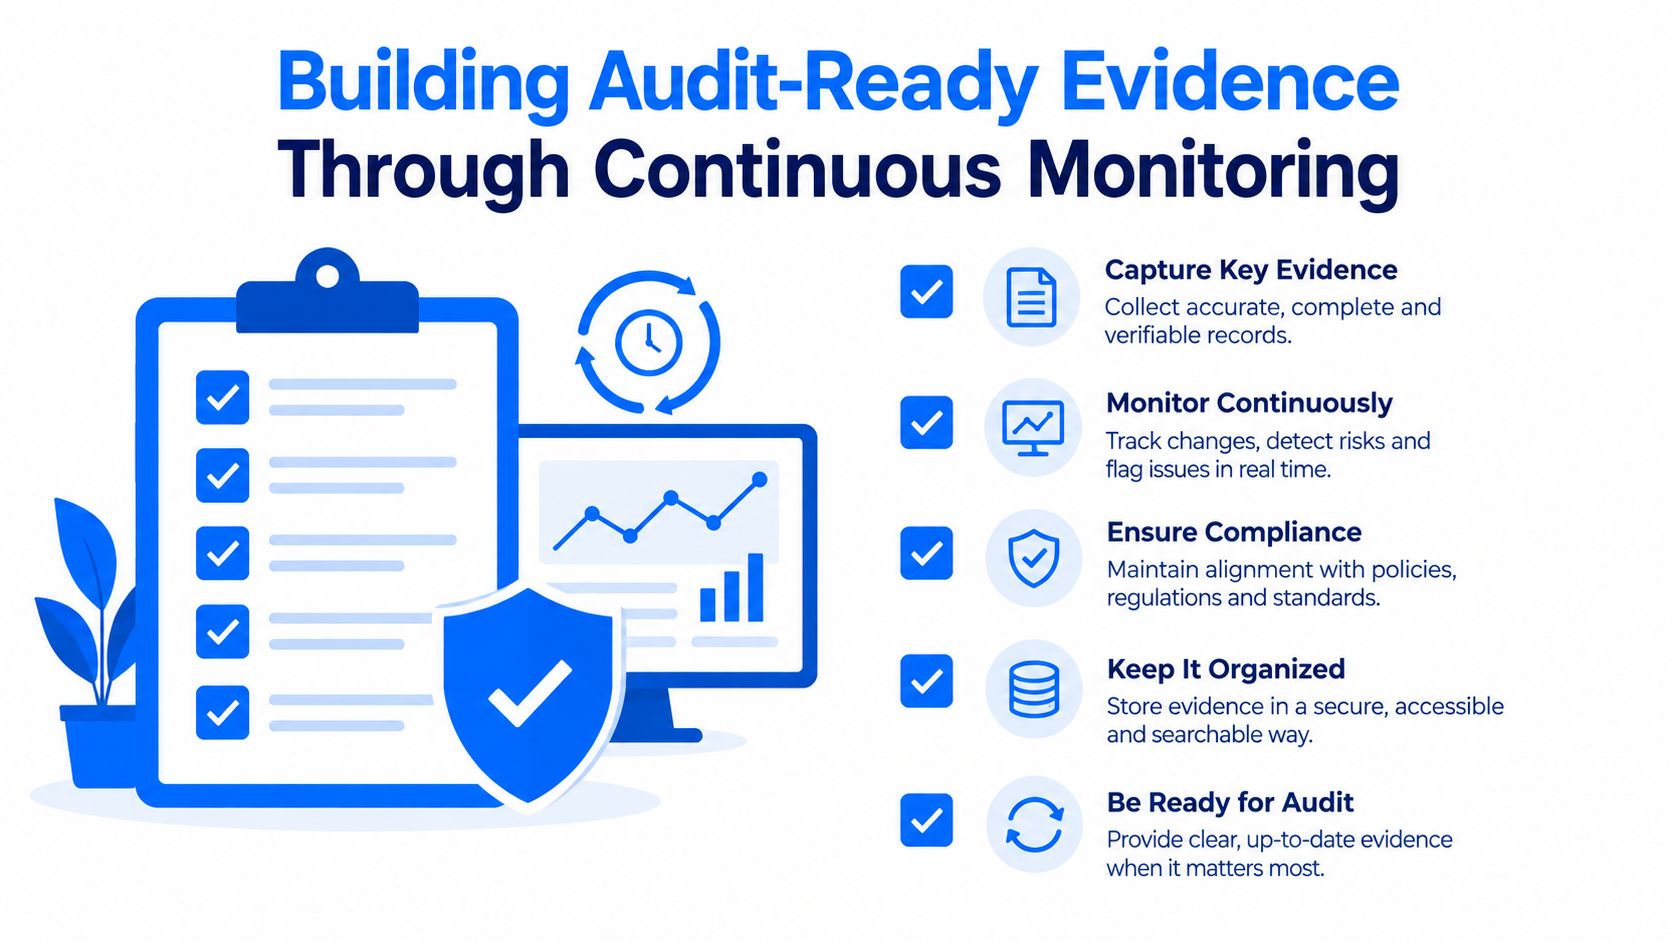
Le principe pratique est simple. Journalisez chaque événement de validation de manière immuable, avec un niveau de détail suffisant pour répondre aux questions que posent réellement les auditeurs. Cela signifie l'identité du jeu de données, l'identité de la colonne, les paramètres de la règle, les horodatages, le résultat réussite/échec, le nombre d'erreurs et l'historique de résolution recommandations sur les pistes d'audit. Une fois cela en place, les équipes peuvent reconstituer ce qui a été vérifié, quand le contrôle s'est exécuté et comment il s'est comporté avant et après une modification de règle.
Ce que ces preuves vous apportent
Elles raccourcissent les investigations lorsqu'une dérive de Schema ou des données arrivées en retard affectent le reporting en aval. Elles conservent aussi les seuils historiques, ce qui compte lorsqu'une règle change mais que l'équipe d'audit doit encore savoir ce qui s'est passé avec le paramétrage précédent. Dans les pipelines réglementés, c'est la différence entre « nous pensons que tout allait bien » et « voici l'état exact du contrôle à ce moment-là ».
Le bénéfice technique est tout aussi important. Lorsque les résultats de validation sont journalisés de façon cohérente, les équipes peuvent quantifier la qualité au moment de la validation plutôt qu'une fois les données déjà propagées. L'analyse des causes racines en devient beaucoup plus rapide, car les preuves renvoient à l'événement de contrôle précis plutôt qu'à un vague symptôme du pipeline.
Le workflow associé n'a pas besoin de ralentir les livraisons. Bien conçu, il s'exécute dans le pipeline, stocke l'enregistrement de contrôle avec l'événement et l'exporte à la demande lorsque la conformité en a besoin. C'est le modèle auquel je fais confiance, car il résiste à la fois à la pression opérationnelle et à l'examen des auditeurs.
Une vidéo de démonstration pratique est également disponible pour les équipes qui veulent voir à quoi cela ressemble concrètement.
Étude de cas : remplacer 9000 règles manuelles par une observabilité pilotée par l'IA
ITSV, le socle informatique de la sécurité sociale autrichienne, est un exemple parlant, car l'échelle l'a contraint à une vraie décision. L'équipe gérait la qualité des données avec 9000 règles écrites à la main dans son Data Warehouse, et ce modèle ne correspondait plus ni au volume ni à la charge de maintenance. L'environnement traitait 50 Go par jour provenant de plus de 30 sources réparties dans plus de 500 structures, ce qui rendait l'ajustement permanent des règles intenable détails de l'étude de cas.
L'ancien dispositif présentait les symptômes habituels. Les connaissances se perdaient lorsque des personnes partaient, la documentation était en retard sur les règles et aucune équipe ne portait réellement le framework de bout en bout. Plus de 140 alertes quotidiennes remplissaient les boîtes de réception, la plupart ignorées faute de sens clair, et seulement 25 % des cas pertinents de qualité des données étaient couverts détails de l'étude de cas.
Ce qui a changé avec la migration des contrôles
Dès septembre 2021, ITSV a commencé à remplacer son framework à base de règles par digna Data Anomalies et digna Data Timeliness. L'analyse est restée au sein de la propre infrastructure d'ITSV, conformément à ses exigences de confidentialité, et l'équipe n'a plus eu à ajuster des seuils ni à maintenir des règles manuellement. Data Timeliness a appris les schémas d'arrivée et signalé les données en retard ou manquantes, tandis que Data Anomalies a appris le comportement normal de l'ensemble du Data Warehouse et signalé les écarts détails de l'étude de cas.
C'est important, car ce cas ne porte pas vraiment sur un changement d'outil. Il s'agit de remplacer un travail de maintenance fragile par une observabilité qui produit des preuves. Les contrôles sont devenus plus faciles à défendre parce qu'ils étaient à la fois continus et traçables, et l'équipe a récupéré le temps qu'elle passait à trier le bruit.
J'ai vu des migrations similaires réussir pour une seule raison : elles transfèrent la responsabilité de la mémoire humaine vers le comportement du système. Les contrôles ne dépendent plus de quelqu'un qui se souvient de la règle censée être mise à jour le trimestre dernier. Ils s'exécutent, journalisent et escaladent d'eux-mêmes.
Opérationnaliser la conformité de la qualité des données entre les équipes
Même une observabilité solide ne comblera pas une lacune de gouvernance. Le plus difficile dans la conformité de la qualité des données est souvent la question de la responsabilité, car les défaillances se situent généralement entre les équipes plutôt qu'à l'intérieur d'un seul système. Des données d'enquête récentes montrent que 44 % des répondants déclarent que la responsabilité est partagée entre plusieurs équipes, que 61 % s'appuient encore sur des contrôles manuels ou une validation en SQL, et que seulement 14 % font respecter des SLA à l'échelle de l'organisation, alors que 39 % suivent des SLA pour leurs pipelines clés rapport d'enquête.
Cela indique où se situe le travail. Le problème n'est pas que les équipes se désintéressent de la qualité. C'est qu'elles ont réparti la responsabilité sans répartir l'application des contrôles. Si personne ne porte le contrôle de bout en bout, les alertes sont triées de manière informelle, les incidents sont acheminés par habitude et les preuves d'audit sont rassemblées trop tard.
Un modèle opérationnel concret
Commencez par désigner un responsable nommé pour chaque jeu de données critique, puis définissez ce qui est mesuré, à quelle fréquence c'est vérifié et où vont les incidents lorsque le contrôle échoue. Rendez la journalisation immuable, gardez le lineage rattaché à l'enregistrement et assurez-vous que le chemin d'escalade est explicite. Si une défaillance de contrôle ne peut pas être acheminée vers une personne, elle n'est pas encore opérationnelle.
Une deuxième exigence est la cohérence entre les équipes. L'ingénierie, l'analytique et la gouvernance doivent utiliser les mêmes définitions pour la fraîcheur, la complétude et les changements de Schema. Si un groupe rend compte d'un indicateur pendant qu'un autre valide une interprétation différente du même champ, la piste d'audit ne paraîtra cohérente que jusqu'à ce que quelqu'un pose des questions.
Règle pratique : la conformité ne devient continue que lorsque la responsabilité, le monitoring et l'escalade sont suffisamment automatisés pour survivre à une semaine chargée.
Une option pour les équipes qui construisent ce modèle opérationnel est digna, qui surveille le comportement des données au sein de l'environnement du client et prend en charge la validation, le monitoring de l'actualité des données, le suivi des Schemas et les preuves prêtes pour l'audit. Si votre objectif est de rendre vos contrôles plus faciles à défendre sans transformer votre équipe en usine à règles manuelles, il vaut la peine de regarder comment la plateforme s'intègre à votre Data Warehouse et à vos pipelines.
Si vous voulez voir comment fonctionne l'approche par baseline apprise du cas ITSV sans écrire ni ajuster de seuils, digna Data Anomalies montre comment elle modélise le comportement normal de chaque table et signale automatiquement les écarts.
Questions fréquentes
Qu'est-ce que la conformité de la qualité des données ?
La conformité de la qualité des données consiste à pouvoir prouver que des données réglementées ont été validées, tracées et défendues, et pas seulement vérifiées. L'article soutient qu'un contrôle ne compte que si des preuves montrent qu'il s'est exécuté au bon moment, sur les bonnes données, avec le bon résultat, au lieu d'être reconstitué pendant la préparation de l'audit.
Pourquoi les contrôles de qualité des données par règles ne suffisent-ils pas pour la conformité ?
Les règles codées en dur prouvent qu'une condition a été vérifiée, mais elles ne peuvent pas montrer que l'environnement de contrôle dans son ensemble est resté fiable. Elles cassent lorsque les Schemas dérivent et que les sources changent, provoquent une fatigue des alertes et perdent des connaissances lorsque des ingénieurs partent. Des réglementations comme l'AI Act de l'UE et les 18 indicateurs de qualité des données de l'ETSI exigent désormais aussi lineage et traçabilité.
Que doit contenir une piste d'audit pour la validation des données ?
Chaque événement de validation doit être journalisé de manière immuable avec l'identité du jeu de données, l'identité de la colonne, les paramètres de la règle, l'horodatage, le résultat réussite ou échec, le nombre d'erreurs et l'historique de résolution. Grâce à cet enregistrement, les équipes peuvent reconstituer exactement ce qui s'est exécuté et comment un contrôle s'est comporté avant et après la modification d'un seuil ou d'une règle.
Quelles dimensions de la qualité des données correspondent aux normes réglementaires ?
Le Data Quality Guidance canadien cite neuf dimensions, dont l'exactitude, la complétude, la cohérence, la fiabilité et l'actualité. L'ISO 8000-110:2021, citée par les Archives nationales australiennes, ajoute l'intégrité, l'unicité et la validité. Relier ces dimensions à des règles de validation, des contrôles de latence et une logique de rapprochement donne aux auditeurs et aux ingénieurs un vocabulaire commun.
Comment ITSV a-t-il remplacé 9000 règles manuelles de qualité des données ?
À partir de septembre 2021, ITSV a remplacé son framework de règles écrites à la main par digna Data Anomalies et Data Timeliness, exécutés au sein de sa propre infrastructure. Le Data Warehouse ingère 50 Go par jour provenant de plus de 30 sources, et l'ancien dispositif générait plus de 140 alertes quotidiennes tout en ne couvrant que 25 % des cas pertinents.


