Ingestion de données Apache Kafka : un guide pratique de construction
|
6
minute de lecture

À 3 h 00 du matin, l'alerte n'indique généralement pas « votre architecture d'ingestion est incorrecte ». Elle signale que le consumer lag augmente, qu'une tâche de destination (sink) est en cours de nouvelle tentative, ou qu'une table en aval a cessé de se rafraîchir. Le temps que quelqu'un retrace le problème du producteur vers le lakehouse en passant par Kafka, la défaillance d'origine peut être enfouie sous les rééquilibrages, les tentatives, les incohérences de schéma et les enregistrements en doublon.
C'est pourquoi l'ingestion de données Apache Kafka doit être conçue comme un cycle de vie complet. Kafka peut fournir une infrastructure d'événements durable et à haut débit, mais la fiabilité en production dépend de ce qui se passe avant que les enregistrements n'atteignent un broker et après que les consommateurs les ont lus. La conception des topics, le partitionnement, la sémantique de livraison, l'application des schémas, le comportement des destinations (sinks) et l'Observability déterminent tous si le pipeline reste correct sous pression.
Table des matières
Le véritable défi derrière l'ingestion Kafka
Chaque décision initiale crée du travail en aval
La fiabilité inclut la traîne (tail)
Modèles d'architecture de base pour les pipelines d'ingestion
Producteur direct vers le broker
Passerelle ou proxy REST
Kafka Connect pour l'intégration des sources et des destinations
ETL en continu avec Kafka Streams ou Flink
Créer des producteurs et des consommateurs qui fonctionnent vraiment
La configuration du producteur doit exprimer le contrat
La configuration du consommateur protège la progression
Gestion des schémas et stratégies de reprise après erreur
L'évolution des schémas nécessite une frontière stricte
Séparer les erreurs temporaires des erreurs fatales
Sémantique de livraison contre charge de travail
Optimisation des partitions et du traitement par lots pour le débit
Faire des tests de performance (benchmark) avant de modifier la topologie de production
Optimiser pour la charge de travail, pas pour une liste de contrôle
Le problème en aval dont personne ne parle
La santé du broker peut masquer la défaillance d'une destination
La governance doit se situer au niveau de la couche d'exposition
Habitudes opérationnelles et liste de contrôle pré-lancement
Les habitudes qui évitent les alertes nocturnes
La semaine précédant le lancement
Le véritable défi derrière l'ingestion Kafka
La première panne de production grave que j'ai vue dans un pipeline de paiements n'a pas commencé par une panne de broker. Un déploiement d'évolution de schéma a déclenché un rééquilibrage de consommateur au mauvais moment. Un consommateur a cessé de progresser utilement, le retard accumulé a augmenté, et la destination (sink) lakehouse en aval a commencé à insérer des lignes en doublon à mesure que la logique de récupération rejouait le travail qui avait déjà atteint le stockage.
Le broker était en bonne santé. Les taux d'erreur des producteurs semblaient ordinaires. L'incident a tout de même déclenché une alerte à 3 h 00 du matin parce que l'équipe avait traité l'ingestion comme une simple connexion entre une application et Kafka, plutôt que comme une chaîne de contrats à état. La définition pratique de l'ingestion de données est plus large que le seul transport, comme le montre clairement le guide de signification de l'ingestion de données. Les enregistrements doivent arriver, rester interprétables, être traités dans une fenêtre acceptable et atteindre leur destination sans dégradation.
Chaque décision initiale crée du travail en aval
La clé de partition d'un topic détermine l'ordre et la répartition de la charge. Son nombre de partitions limite le parallélisme des consommateurs et affecte les rééquilibrages. Les accusés de réception du producteur et l'idempotence influencent le comportement des doublons. La taille du groupe de consommateurs affecte le temps de récupération, tandis que le modèle de validation (commit) et de tentative de la destination détermine si la livraison au moins une fois se traduit par des lignes dupliquées.
Ces choix créent également des dépendances en dehors de Kafka :
Structure des topics : Les topics partagés nécessitent une propriété claire, des règles de nommage, de rétention et de schéma.
Clé de partitionnement : Une mauvaise clé crée des partitions surchargées (hot partitions) ou rompt la garantie d'ordre dont dépend un processus métier.
Sémantique de livraison : Un événement de grand livre et une télémétrie jetable ne doivent pas porter le même contrat de traitement.
Dimensionnement des consommateurs : Ajouter des consommateurs au-delà des partitions disponibles ne crée pas de parallélisme utile supplémentaire.
Écritures dans le lakehouse : Les flux continus peuvent créer de nombreux petits fichiers, ce qui augmente le travail de compactage et dégrade l'efficacité des requêtes, un compromis mis en évidence dans le guide sur la livraison de données Kafka vers des tables de streaming Iceberg.
Règle pratique : Un pipeline Kafka n'est pas sain simplement parce que les producteurs reçoivent des accusés de réception. Il est sain lorsque les données en aval restent complètes, fournies dans les temps (Timeliness), correctement structurées et récupérables.
La fiabilité inclut la traîne (tail)
Dans la finance et la santé, un enregistrement qui arrive en retard ou avec un champ modifié peut être aussi préjudiciable qu'un enregistrement perdu. Un événement de paiement peut être présent mais dupliqué. Un événement clinique peut être livré mais échouer à la validation après une modification de schéma. Un flux opérationnel peut afficher un faible retard de broker alors que sa destination accumule des fichiers non validés.
Les sections qui suivent se concentrent sur ces modes de défaillance. L'objectif n'est pas simplement de déplacer des octets vers Kafka. Il s'agit d'éviter la prochaine alerte en concevant l'ensemble du parcours, depuis le comportement de la source et l'attribution des partitions jusqu'à la gouvernance des schémas, les validations des destinations et les preuves dont les opérateurs ont besoin lors de la récupération.
Modèles d'architecture de base pour les pipelines d'ingestion
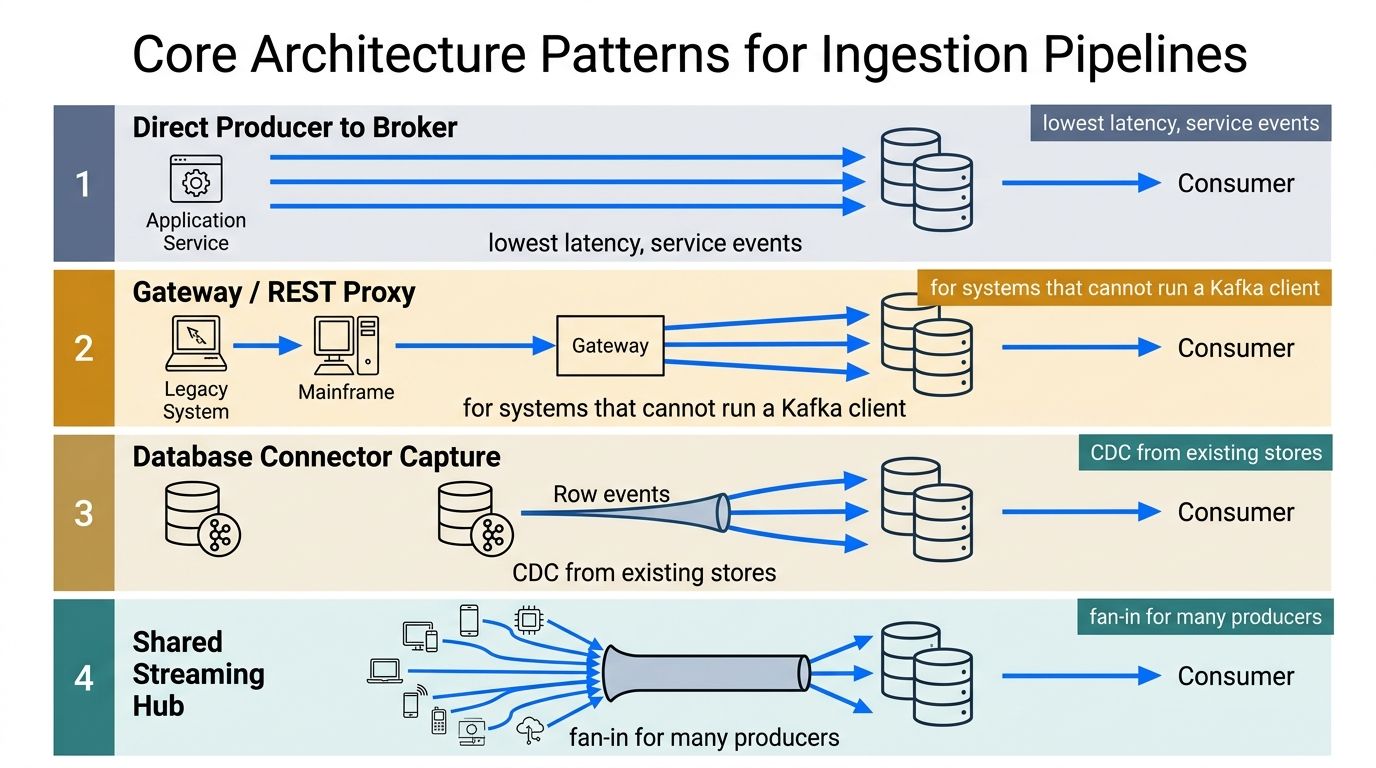
Choisissez la topologie en fonction des capacités de la source et du contrat en aval. Un service qui communique déjà nativement avec Kafka ne devrait pas être contraint de passer par une passerelle HTTP, tandis qu'un mainframe hérité ne devrait pas se voir imposer un projet d'intégration de client Kafka qu'il ne peut pas supporter.
Producteur direct vers le broker
Un service Java, Go ou Python peut publier directement sur Kafka à l'aide d'un client natif. C'est la solution idéale pour les événements de service, l'activité applicative, les changements d'état de paiement et la télémétrie où le producteur contrôle les clés de message, le traitement par lots, les tentatives et la sérialisation des schémas.
L'avantage réside dans une faible latence et un contrôle précis. Le coût est le couplage. Chaque équipe de production doit comprendre les rappels de livraison (callbacks), le comportement des clés de partition, l'authentification, la compatibilité des schémas et la contre-pression (backpressure). Un producteur direct peut également exposer immédiatement une mauvaise conception de clé, ce qui est utile lors des tests mais douloureux si le topic transporte déjà du trafic de production.
Passerelle ou proxy REST
Une passerelle offre aux systèmes qui ne peuvent pas exécuter de client Kafka une interface HTTP plus simple. Les applications héritées, les mainframes, les intégrations partenaires et les petits utilitaires peuvent soumettre des enregistrements sans gérer les détails du protocole Kafka.
La passerelle centralise l'authentification, la validation et la limitation de débit, mais elle peut masquer des erreurs de clé de partition. Si la passerelle attribue des clés ou utilise par défaut une stratégie de distribution inadaptée, l'équipe source peut ne pas remarquer que les événements associés arrivent de manière déséquilibrée. Cela ajoute également une autre frontière de défaillance, de sorte que les opérateurs ont besoin de métriques pour les requêtes acceptées, rejetées, les enregistrements en file d'attente, les accusés de réception des brokers et la livraison en aval.
Kafka Connect pour l'intégration des sources et des destinations
Kafka Connect est pratique pour la capture de bases de données, les systèmes SaaS, les fichiers et la livraison vers des entrepôts de données ou des lakehouses. Les connecteurs de source peuvent publier des modifications dans Kafka, tandis que les connecteurs de destination peuvent déplacer des enregistrements vers des systèmes externes sans application consommatrice personnalisée.
Le modèle d'offset de Connect simplifie le redémarrage et la récupération car les tâches du connecteur conservent leur progression. Cette commodité ne garantit pas automatiquement un comportement exactement une fois (exactly-once). Les tentatives du connecteur, l'idempotence côté destination, les validations externes et les redémarrages de tâches doivent toujours être évalués comme un système unique. Les déploiements de connecteurs entraînent également des coûts opérationnels, notamment la compatibilité des plugins, les configurations personnalisées, les tâches échouées et la maintenance, des sujets abordés dans la comparaison entre Kafka Connect, Flink et Spark.
ETL en continu avec Kafka Streams ou Flink
Utilisez Kafka Streams ou Flink lorsque les enregistrements ont besoin d'enrichissement, de jointures, de déduplication, de fenêtrage, de traitement avec état ou de gestion du temps d'événement avant d'atteindre une destination. Cette topologie maintient la logique de transformation dans une couche de streaming contrôlée au lieu de disperser les règles métier entre les producteurs et les connecteurs.
Le compromis réside dans la complexité opérationnelle. Les tâches avec état introduisent des points de contrôle (checkpoints), des comportements de restauration, la croissance de l'état, la compatibilité des déploiements et des tests plus complexes. Une heuristique de décision utile est simple : utilisez des producteurs directs pour les contrats de service stables, des passerelles pour les sources contraintes, Connect pour les mouvements principalement mécaniques, et un moteur de traitement lorsque la correction dépend de l'état de transformation ou d'une logique multi-flux.
Pour une vue plus large de la façon dont les producteurs, les brokers, les consommateurs et les destinations s'articulent, utilisez cette référence d'architecture de pipeline de données.
Créer des producteurs et des consommateurs qui fonctionnent vraiment
Un producteur en production doit rendre la publication de doublons peu probable, exposer les échecs de livraison et éviter de réessayer indéfiniment. Un consommateur doit traiter les enregistrements de manière délibérée, ne valider qu'après un travail réussi et isoler les enregistrements corrompus (poison pills) avant qu'ils ne bloquent une partition entière.
La configuration du producteur doit exprimer le contrat
Une configuration de producteur Java pourrait ressembler à ceci :
acks=all oblige le producteur à attendre l'accusé de réception du broker configuré de la manière la plus forte. enable.idempotence=true empêche les tentatives du producteur de créer des enregistrements en doublon dans le modèle de livraison idempotent de Kafka. Une valeur bornée pour linger.ms donne aux enregistrements le temps de former des lots utiles sans transformer la latence en une file d'attente incontrôlée.
Un partitionneur personnalisé doit refléter l'exigence d'ordonnancement métier. Les événements de paiement nécessitent généralement que tous les enregistrements d'un compte ou d'un agrégat de transactions restent ordonnés, tandis que les comptes non liés doivent être répartis sur les partitions. Ne qualifiez pas un partitionneur personnalisé d'« ordonnancement collant » (sticky ordering) à moins que la clé ne définisse réellement la limite d'ordonnancement.
Utilisez des rappels de livraison (callbacks) et inspectez l'exception. Un délai d'attente dépassé (timeout), une élection de leader ou une panne réseau temporaire relèvent d'un comportement de tentative client contrôlé. Configurez delivery.timeout.ms de manière à ce que le client dispose d'une limite supérieure définie au lieu de créer une boucle de tentative aveugle autour de send().
La configuration du consommateur protège la progression
Un consommateur Python utilisant confluent-kafka peut rendre explicite le comportement d'affectation et de validation (commit) :
L'assignateur cooperative-sticky réduit les mouvements inutiles lors des changements de groupe. Les validations manuelles garantissent que l'offset n'avance qu'après que la destination a accepté l'enregistrement, et pas simplement après que le consommateur l'a récupéré. Un topic de lettres mortes (dead-letter topic) empêche un seul enregistrement malformé de bloquer une partition entière.
La boucle de scrutation (poll loop) doit rester réactive même lorsque le système en aval est lent. Si les écritures dans le lakehouse peuvent bloquer pendant une longue période, séparez la scrutation du traitement, limitez la file d'attente de travail et ajustez max.poll.interval.ms au contrat de traitement réel. Sinon, Kafka peut interpréter un consommateur lent mais fonctionnel comme mort et lancer un nouveau rééquilibrage.
Le client natif a également son importance. Les paramètres de librdkafka tels que les limites de file d'attente, la taille des récupérations (fetch), la compression, le comportement des sockets et les intervalles de statistiques peuvent modifier le débit et la latence de traîne. Examinez ces valeurs par défaut au lieu de supposer que l'enveloppe (wrapper) du langage de programmation a fait le bon choix. La question pertinente n'est pas de savoir si un paramètre est populaire, mais quel échec il prévient et quelle ressource il consomme.
Un aperçu utile des logiciels d'ingestion de données peut aider à séparer les composants de transport des fonctionnalités de validation et de surveillance qui doivent les entourer.
Gestion des schémas et stratégies de reprise après erreur
La sémantique de livraison est une décision commerciale déguisée en configuration client. Le traitement au plus une fois (at-most-once) peut être acceptable pour de la télémétrie jetable. Le traitement au moins une fois (at-least-once) est souvent la base pratique pour les flux analytiques. Les événements de grand livre financier nécessitent généralement une gestion idempotente et une frontière exactement une fois (exactly-once) soigneusement conçue.
Kafka distingue le traitement au moins une fois et exactement une fois. Le support de l'exactly-once a commencé avec la version 0.11.0.0, en utilisant des producteurs et des consommateurs transactionnels pour éviter la duplication et la perte sur les topics Kafka, comme documenté dans la documentation de Confluent sur la sémantique de livraison. Cette fonctionnalité ne rend pas pour autant une destination externe arbitraire transactionnelle. Le lakehouse, la base de données ou l'API doivent participer à la conception de la cohérence.
L'évolution des schémas nécessite une frontière stricte
Avro, JSON Schema et Protobuf peuvent tous fonctionner. Le format importe moins que le fait que les producteurs partagent un registre (registry), une politique de compatibilité et un processus de Release. Pour les topics partagés, un Schema Registry avec compatibilité ascendante (backward) et ascendante transitive (backward-transitive) est le choix par défaut le plus sûr, car les consommateurs ont besoin d'un moyen prévisible de lire les nouveaux enregistrements pendant que les anciens consommateurs restent déployés.
La dérive des schémas est plus dangereuse qu'un plantage visible. Un changement de type incompatible peut arrêter un chargement, tandis qu'un changement de champ non validé peut fausser silencieusement les valeurs. Un registre fournit des contrôles de compatibilité, mais les opérateurs ont tout de même besoin d'alertes lorsqu'un producteur tente d'utiliser une version rejetée, lorsque les consommateurs prennent du retard après un déploiement et lorsqu'un topic de lettres mortes commence à grossir.
Séparer les erreurs temporaires des erreurs fatales
Les délais d'attente réseau, les élections temporaires de leader et les brokers indisponibles sont généralement des erreurs temporaires réessayables. Les échecs de désérialisation, les valeurs métier invalides et les messages corrompus (poison pills) ne se résolvent pas en répétant la même opération. Dirigez les échecs fatals vers un topic de lettres mortes avec la charge utile d'origine, le topic, la partition, l'offset, l'identifiant du schéma, la classe d'erreur et l'horodatage du traitement.
Pour un parcours de traitement transactionnel, les paramètres importants incluent :
Le transactional.id doit être stable par identité de traitement et géré avec soin lors du déploiement. Les consommateurs utilisant read_committed évitent d'exposer des enregistrements transactionnels abandonnés, mais l'exactly-once nécessite toujours une coordination atomique entre la lecture, le traitement et l'écriture. Les producteurs idempotents sont une assurance bon marché. Le véritable exactly-once est un choix d'architecture délibéré, pas un comportement par défaut.
Sémantique de livraison contre charge de travail
Charge de travail | Sémantique de livraison | Stratégie de schéma | Routage des erreurs | Configuration clé |
|---|---|---|---|---|
Télémétrie sans confirmation (fire-and-forget) | Au plus une fois (at-most-once) là où la perte est acceptable | JSON ou Protobuf versionné avec validation | Ignorer ou échantillonner les enregistrements invalides uniquement si le responsable métier accepte la perte | Délai de livraison limité |
Analyses opérationnelles | Au moins une fois (at-least-once) avec déduplication côté destination | Avro, JSON Schema ou Protobuf géré par registre | Topic de lettres mortes pour les échecs fatals |
|
Événements de grand livre financier | Exactement une fois (exactly-once) sur la frontière de traitement définie | Schéma géré par registre avec compatibilité stricte | Réessayer les erreurs temporaires, mettre en quarantaine les enregistrements corrompus | Transactions, |
Événements cliniques de santé | Au moins une fois ou exactement une fois selon le contrat source et destination | Politique de compatibilité explicite et validation des champs | Topic de lettres mortes avec métadonnées d'audit | Validations manuelles après persistance validée |
Utilisez une taxonomie de schémas claire avant de créer des topics. Les types de schémas et leurs compromis constituent un contexte utile, mais la règle opérationnelle reste la même : chaque topic partagé nécessite un propriétaire, une politique de compatibilité et un chemin de rejeu (replay).
Optimisation des partitions et du traitement par lots pour le débit
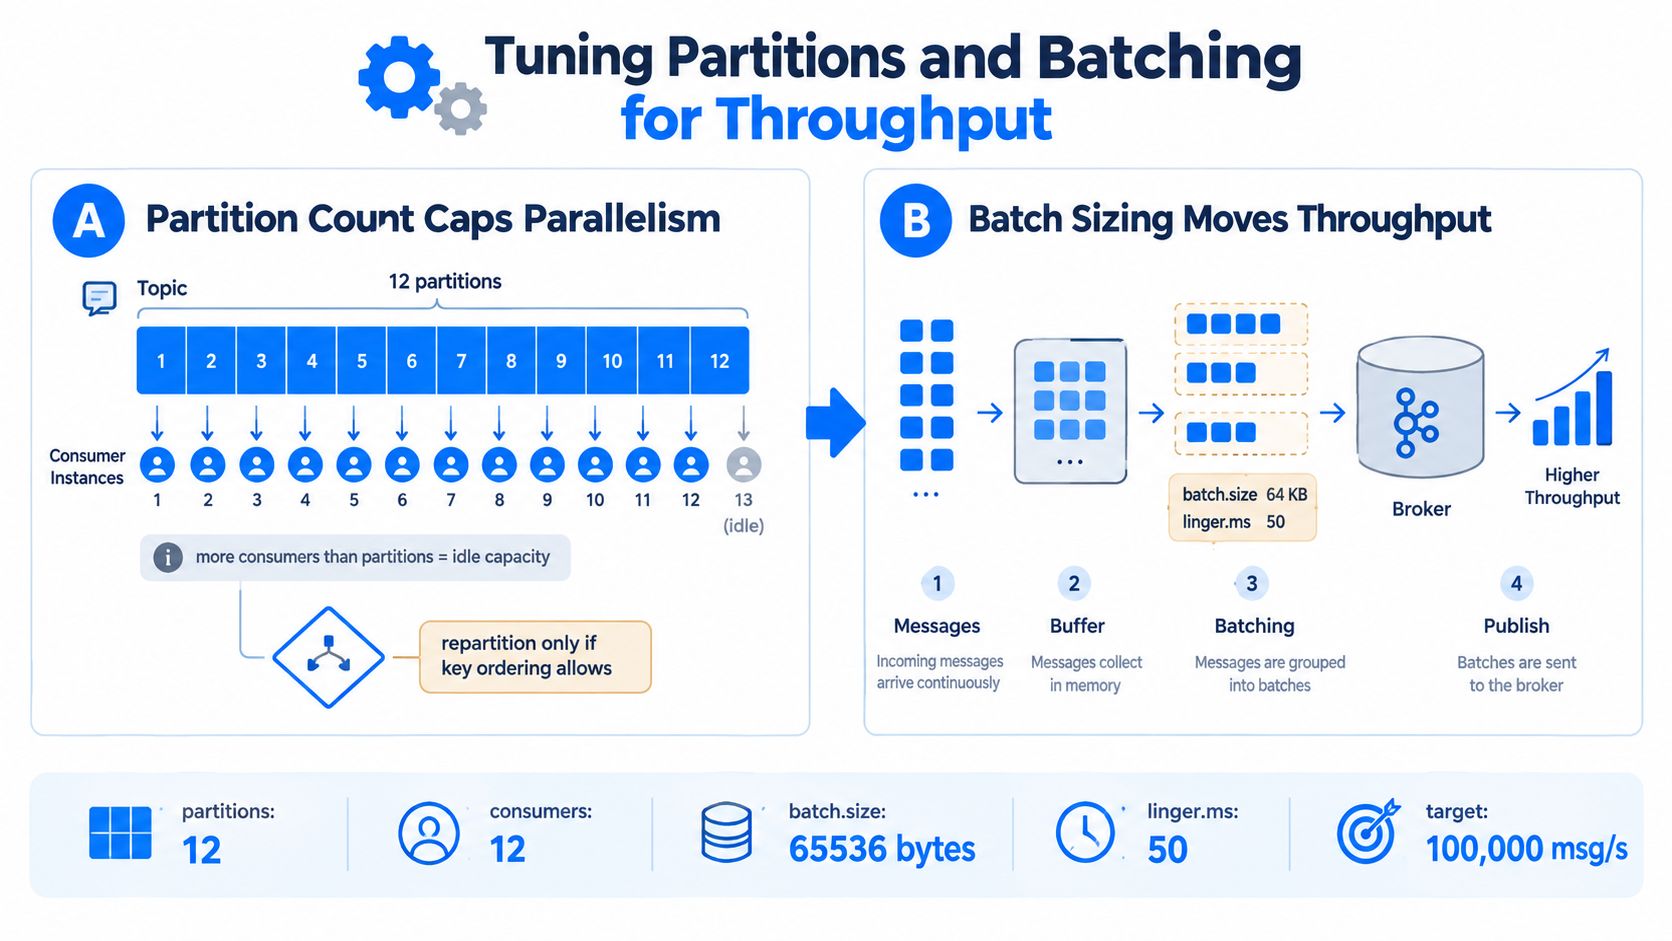
Deux leviers influencent généralement le débit d'ingestion de Kafka plus que n'importe quel code applicatif astucieux : le nombre de partitions et la taille des lots (batch size). Les partitions permettent le parallélisme, mais elles créent également des fichiers, des métadonnées, du travail de réplication et une surcharge d'affectation. Une fois qu'un topic est en production, réduire son nombre de partitions n'est pas une opération de routine sûre, laissez donc de la place pour la croissance sans pour autant créer une empreinte de cluster inutilement grande.
Un modèle de dimensionnement pratique commence par diviser le débit de pointe attendu par le débit soutenable d'une seule partition sous la distribution de clé prévue. Une référence d'optimisation indique une plage moyenne soutenue de 10 à 30 Mo/s par partition, mais traitez cela comme une hypothèse de départ, pas comme une garantie. Faites des tests de performance (benchmark) avec des tailles de charge utile réelles, la compression, la réplication, le matériel du broker et des clés déséquilibrées (skewed).
Faire des tests de performance (benchmark) avant de modifier la topologie de production
Les benchmarks publiés par Kafka et ses fournisseurs montrent pourquoi la configuration est importante. Un benchmark empirique a enregistré environ 420 000 messages par seconde sur du matériel standard avec une seule partition et un facteur de réplication de un, tandis qu'une autre étude a rapporté environ 800 000 messages per seconde sur un seul broker correctement configuré. Une étude de cas d'ingénierie d'Azure a cité environ 2 Go/s avec 10 brokers et 16 disques par broker. Ces chiffres proviennent d'environnements différents et ne sont pas interchangeables, utilisez-les donc pour établir une échelle, pas pour promettre un résultat. Consultez la référence sur l'histoire et les performances de Kafka pour connaître le contexte historique et les benchmarks.
Le traitement par lots peut avoir un effet spectaculaire. Un benchmark a rapporté que passer d'une taille de lot de 16 Ko à 100 Ko augmentait le débit du producteur d'environ 300 %, tandis qu'un autre a mesuré 605 Mo/s avec un batch.size de 1 Mo, un linger.ms=10 ms, 100 partitions et une réplication 3x, comme résumé dans le benchmark de débit Kafka.
Optimiser pour la charge de travail, pas pour une liste de contrôle
Commencez les tests de production en augmentant le nombre de producteurs jusqu'à ce que la latence au 99e centile (p99) se rapproche de la cible de niveau de service (SLO). Augmentez ensuite les partitions pour correspondre au parallélisme souhaité et vérifiez que les clés se répartissent uniformément. Un nombre de partitions surdimensionné crée une surcharge de métadonnées et de coordination, tandis qu'un nombre trop faible de partitions produit des partitions surchargées et des pics de latence lors des rafales de trafic.
Pour les producteurs, testez une valeur de linger.ms limitée dans la plage de 5 à 20 ms et un batch.size entre 64 Ko et 256 Ko avant d'envisager des lots plus grands. zstd ou lz4 peuvent réduire la pression sur le réseau et le stockage pour les charges utiles de type journal (log), mais la compression consomme du processeur. Configurez buffer.memory au-dessus du taux de rafale attendu afin que de courts ralentissements de la destination ou du broker ne se transforment pas immédiatement en échecs de production.
Pour les consommateurs, plafonnez max.poll.records afin que le traitement s'adapte à l'intervalle de scrutation. Ajustez fetch.min.bytes pour amortir les allers-retours avec le broker lorsque la latence le permet, et utilisez l'appartenance statique (static membership) lorsque les déploiements provoqueraient autrement un roulement de groupe évitable. N'oubliez pas que le débit du consommateur plafonne généralement dès que le nombre de consommateurs dépasse le nombre de partitions. Des processus supplémentaires ne créeront pas de travail que le topic ne peut pas attribuer.
Le problème en aval dont personne ne parle
L'ingestion Kafka continue après que le broker a accepté un enregistrement. Les pannes difficiles apparaissent souvent lorsqu'une destination convertit un flux d'événements illimité en tables de lakehouse, en lignes d'entrepôt de données ou en appels de service. Un pipeline peut atteindre les objectifs du producteur et du broker alors que les données en aval restent en retard, fragmentées, malformées ou invisibles pour les utilisateurs.
Les écritures à haut débit dans Iceberg peuvent créer de nombreux petits fichiers. Ces fichiers augmentent le travail sur les métadonnées et le compactage, et les requêtes ralentissent à mesure que la structure de la table se fragmente. Les équipes doivent choisir le niveau de fraîcheur à accepter avant le compactage et comment regrouper les écritures sans créer un retard ingérable. Traitez la destination lakehouse comme faisant partie intégrante de la conception de l'ingestion, en surveillant ensemble la taille des fichiers, le comportement de validation, la capacité de compactage et la fraîcheur visible par les requêtes.
La santé du broker peut masquer la défaillance d'une destination
Le consumer lag de Kafka est la différence entre le dernier offset produit d'une partition, l'offset de fin de journal, et le dernier offset validé par un groupe de consommateurs. Il s'agit d'un signal par partition, et non d'une mesure complète de la fraîcheur de bout en bout, comme l'explique cette référence sur le consumer lag.
Une destination peut valider des offsets alors que les écritures restent retardées, mises en mémoire tampon, dupliquées ou indisponibles pour les requêtes. Surveillez l'intégralité du parcours :
Côté broker : Offset de fin de journal, offset validé, retard (lag) par partition, latence des requêtes, partitions sous-répliquées, utilisation du disque et déséquilibre des partitions.
Côté consommateur : Durée du traitement, enregistrements persistés, nombre de tentatives, événements de rééquilibrage, échecs de désérialisation et volume de lettres mortes.
Côté destination (sink) : Latence de validation (commit), taux de création de fichiers, accumulation de petits fichiers, retard de compactage, écritures rejetées, conflits de transactions et fraîcheur visible par les requêtes.
Côté données : Ponctualité de l'arrivée (Timeliness), nombre de lignes, motifs de valeurs nulles, unicité des clés, échecs des règles métier et modifications de schémas.
La dérive des schémas crée un autre chemin de défaillance silencieux. Un champ obsolète (deprecated) peut continuer à transiter par le producteur et le broker alors qu'une table en aval l'ignore ou lui attribue une mauvaise signification. Imposez la compatibilité à la frontière du topic, enregistrez la version du schéma avec chaque événement et attribuez un propriétaire pour les modifications et les notifications de défaillance.
La governance doit se situer au niveau de la couche d'exposition
Les nouveaux consommateurs doivent avoir des identités définies, des limites de débit, des topics autorisés, un accès aux schémas, des attentes de rétention et des pistes d'audit liées à une équipe propriétaire ou à un objectif métier. Les approbations informelles et les proxys personnalisés rendent l'accès difficile à examiner et à révoquer.
Cela est important dans la finance, la santé, les télécoms et les systèmes du secteur public. Les opérateurs doivent être en mesure de démontrer que les enregistrements sont arrivés dans la structure attendue, dans la fenêtre requise et avec un chemin de récupération traçable. La governance des consommateurs inclut donc l'accès, l'utilisation, l'autorité de rejeu et la qualité des données en aval.
Un pipeline n'est fiable qu'à la hauteur de son étape la plus lente et la moins surveillée.
Habitudes opérationnelles et liste de contrôle pré-lancement
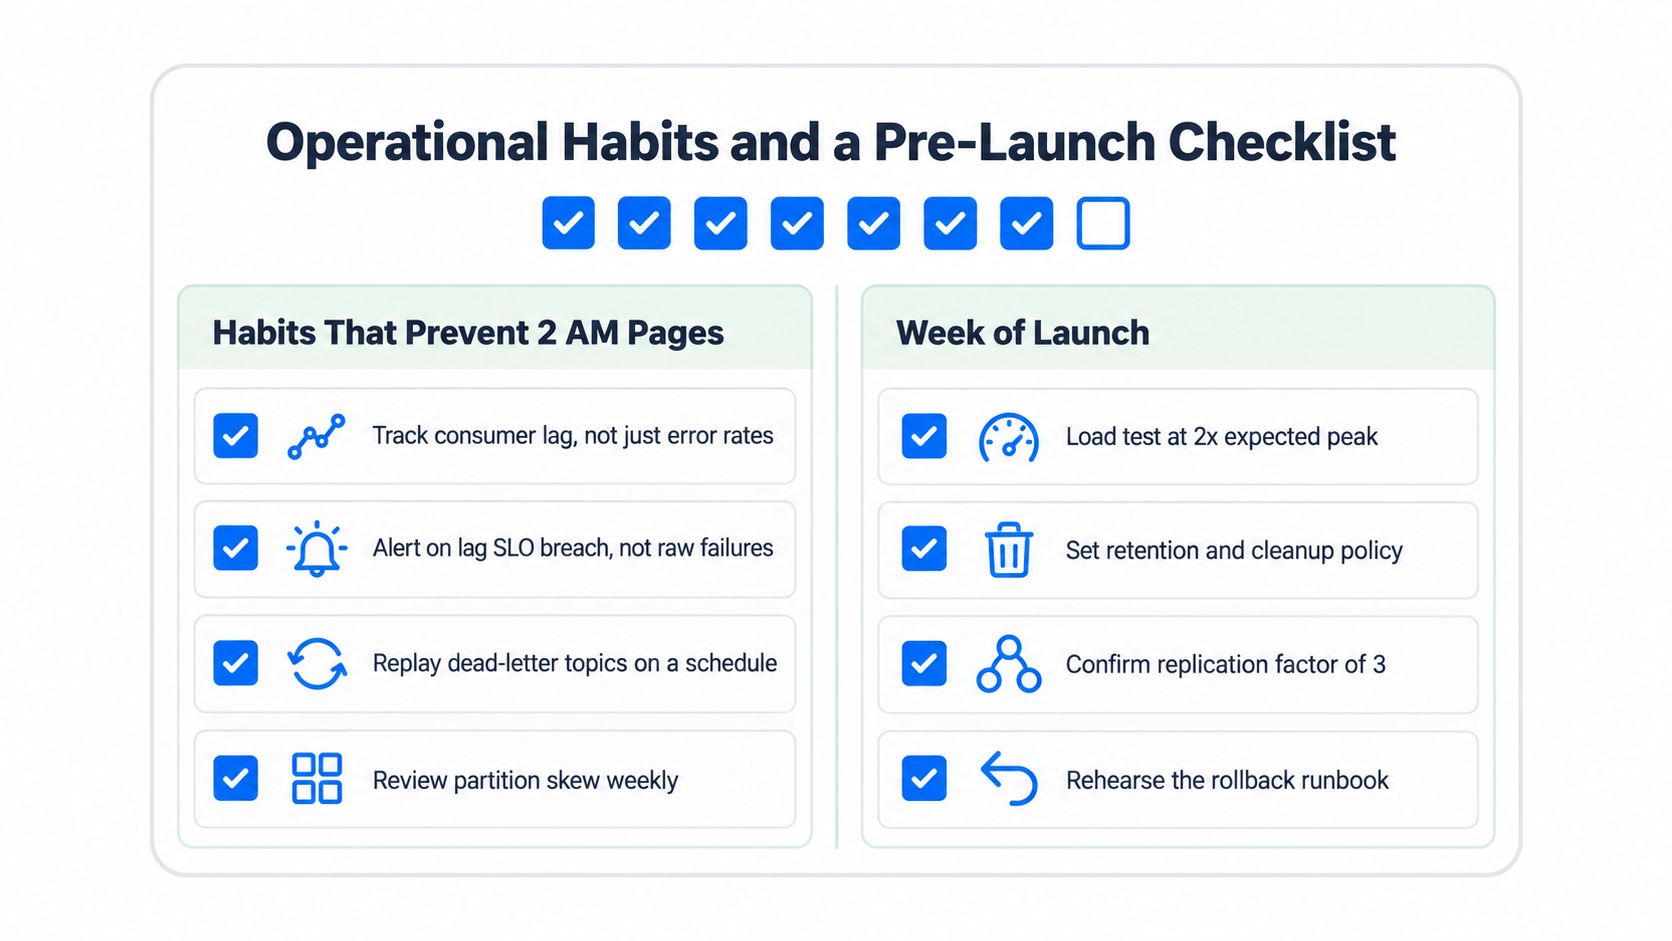
Les équipes fiables n'attendent pas le jour du lancement pour découvrir que la distribution de leurs clés est inégale ou que leur destination ne peut pas suivre le rythme. Elles effectuent des tests de charge avec des enregistrements réalistes, examinent les tableaux de bord chaque semaine et traitent le rejeu comme une procédure opérationnelle normale plutôt que comme une astuce d'urgence.
Les habitudes qui évitent les alertes nocturnes
Suivez le consumer lag par rapport à un SLO, et pas seulement les taux d'erreur bruts. Un consommateur peut ne signaler aucune exception tout en traitant trop lentement pour l'échéance métier. Créez des alertes en cas de dépassement de retard, de déséquilibre des partitions, de pression sur le disque du broker, de rééquilibrages fréquents et de croissance des lettres mortes.
Examinez chaque semaine les panneaux Grafana et les métriques JMX, notamment la latence des requêtes du producteur, la taille des lots d'enregistrements, le taux de récupération du consommateur, la latence de validation, les octets entrants et sortants, les partitions sous-répliquées et l'activité de rééquilibrage de groupe. Cet examen devrait permettre d'identifier les tendances avant que les tableaux de bord en aval ne les exposent.
Les topics de lettres mortes nécessitent un propriétaire et un calendrier de rejeu. Une file d'attente de lettres mortes (DLQ) qui grandit indéfiniment n'est pas une solution de récupération. C'est une mise en quarantaine non documentée.
La semaine précédant le lancement
Exécutez les vérifications suivantes sur un environnement de pré-production (staging) qui ressemble à la production :
Distribution de la charge : Testez avec des distributions de clés réalistes, y compris des scénarios de clés surchargées (hot-key) et de trafic par rafales.
Compatibilité des schémas : Enregistrez des versions représentatives et vérifiez le comportement ascendant (backward) et ascendant transitif (backward-transitive) avec Confluent Schema Registry.
Défaillance de broker : Arrêtez un broker pendant l'ingestion et confirmez la récupération du producteur, du consommateur et la correction de la destination.
Récupération des offsets : Confirmez que la rétention des offsets dépasse la pire fenêtre de récupération. Kafka conserve les offsets des consommateurs pendant une période configurable après qu'un groupe devient inactif, contrôlée par
offsets.retention.minutes; Red Hat documente égalementauto.offset.reset=earliestcomme un moyen d'éviter de manquer des données lorsqu'un offset validé n'est plus valide, comme décrit dans le guide de configuration du consommateur de Red Hat.Procédures d'exploitation (Runbooks) : Documentez les trois principaux modes de défaillance, le propriétaire de chacun d'eux, la procédure de retour arrière (rollback) et la commande ou le flux de travail de rejeu.
Utilisez les conseils d'orchestration de pipeline pour clarifier quel système planifie la récupération, quel système valide le résultat et quelle équipe résout l'incident. La fiabilité de l'ingestion se gagne par des examens opérationnels répétés, et non par une simple configuration finale.
digna fournit une Observability des données intégrée à l'environnement pour les pipelines alimentés par Kafka, y compris la surveillance de la ponctualité (Timeliness), la validation des enregistrements, la détection des anomalies et le suivi continu des modifications de schémas sur les actifs de données en aval. Visitez digna pour voir comment sa plateforme modulaire peut vous aider à connecter l'activité du broker avec les signaux de qualité et de fraîcheur des données dont vos runbooks d'ingestion ont besoin.


