Gestion de la qualité des données : ce que c'est et comment ça marche
|
6
minute de lecture

Toute entreprise fonctionne avec des données, mais toutes ne peuvent pas leur faire confiance. Un tableau de bord affiche des chiffres qui ne correspondent pas au rapport de la finance. Un modèle de machine learning se dégrade parce que les données d'entrée ont dérivé le mois dernier. Personne ne le remarque avant qu'un client ne se plaigne ou qu'un auditeur ne pose une question sans réponse. Voilà ce qui arrive sans gestion de la qualité des données, et c'est pourquoi de plus en plus d'équipes data l'intègrent à leurs opérations au lieu d'en faire un nettoyage ponctuel.
Qu'est-ce donc, exactement, que la gestion de la qualité des données ? C'est la discipline consistant à définir, mesurer et maintenir l'exactitude, la complétude, la cohérence et la ponctualité des données tout au long de leur cycle de vie. Ce n'est ni un outil unique ni un tableur de règles de validation. C'est un cadre structuré associant processus, responsabilité et technologie pour attraper les problèmes avant qu'ils n'atteignent un rapport ou un modèle.
Dans cet article, nous décomposons les composants d'un cadre de gestion de la qualité des données, parcourons les processus qui maintiennent la confiance au quotidien et couvrons les bonnes pratiques qui distinguent les équipes détectant tôt les incidents de celles qui l'apprennent à leurs dépens. Si vous gérez des pipelines, des entrepôts ou des lacs à grande échelle, c'est le socle de tout ce que vous construisez ensuite sur vos données.
Pourquoi la gestion de la qualité des données compte pour votre organisation
Les mauvaises données ne s'annoncent pas. Elles se cachent dans un pipeline jusqu'à ce qu'un rapport trimestriel sorte avec un chiffre d'affaires erroné, ou qu'un modèle d'IA entraîné sur des données dérivées prenne des décisions que personne ne sait expliquer. La gestion de la qualité des données compte parce que le coût de détection d'un problème augmente à mesure qu'il descend la chaîne. Une colonne manquante attrapée à l'ingestion coûte dix minutes à un ingénieur. Le même problème repéré après avoir façonné une présentation au conseil coûte de la crédibilité, et parfois bien davantage.
Le coût réel des mauvaises données
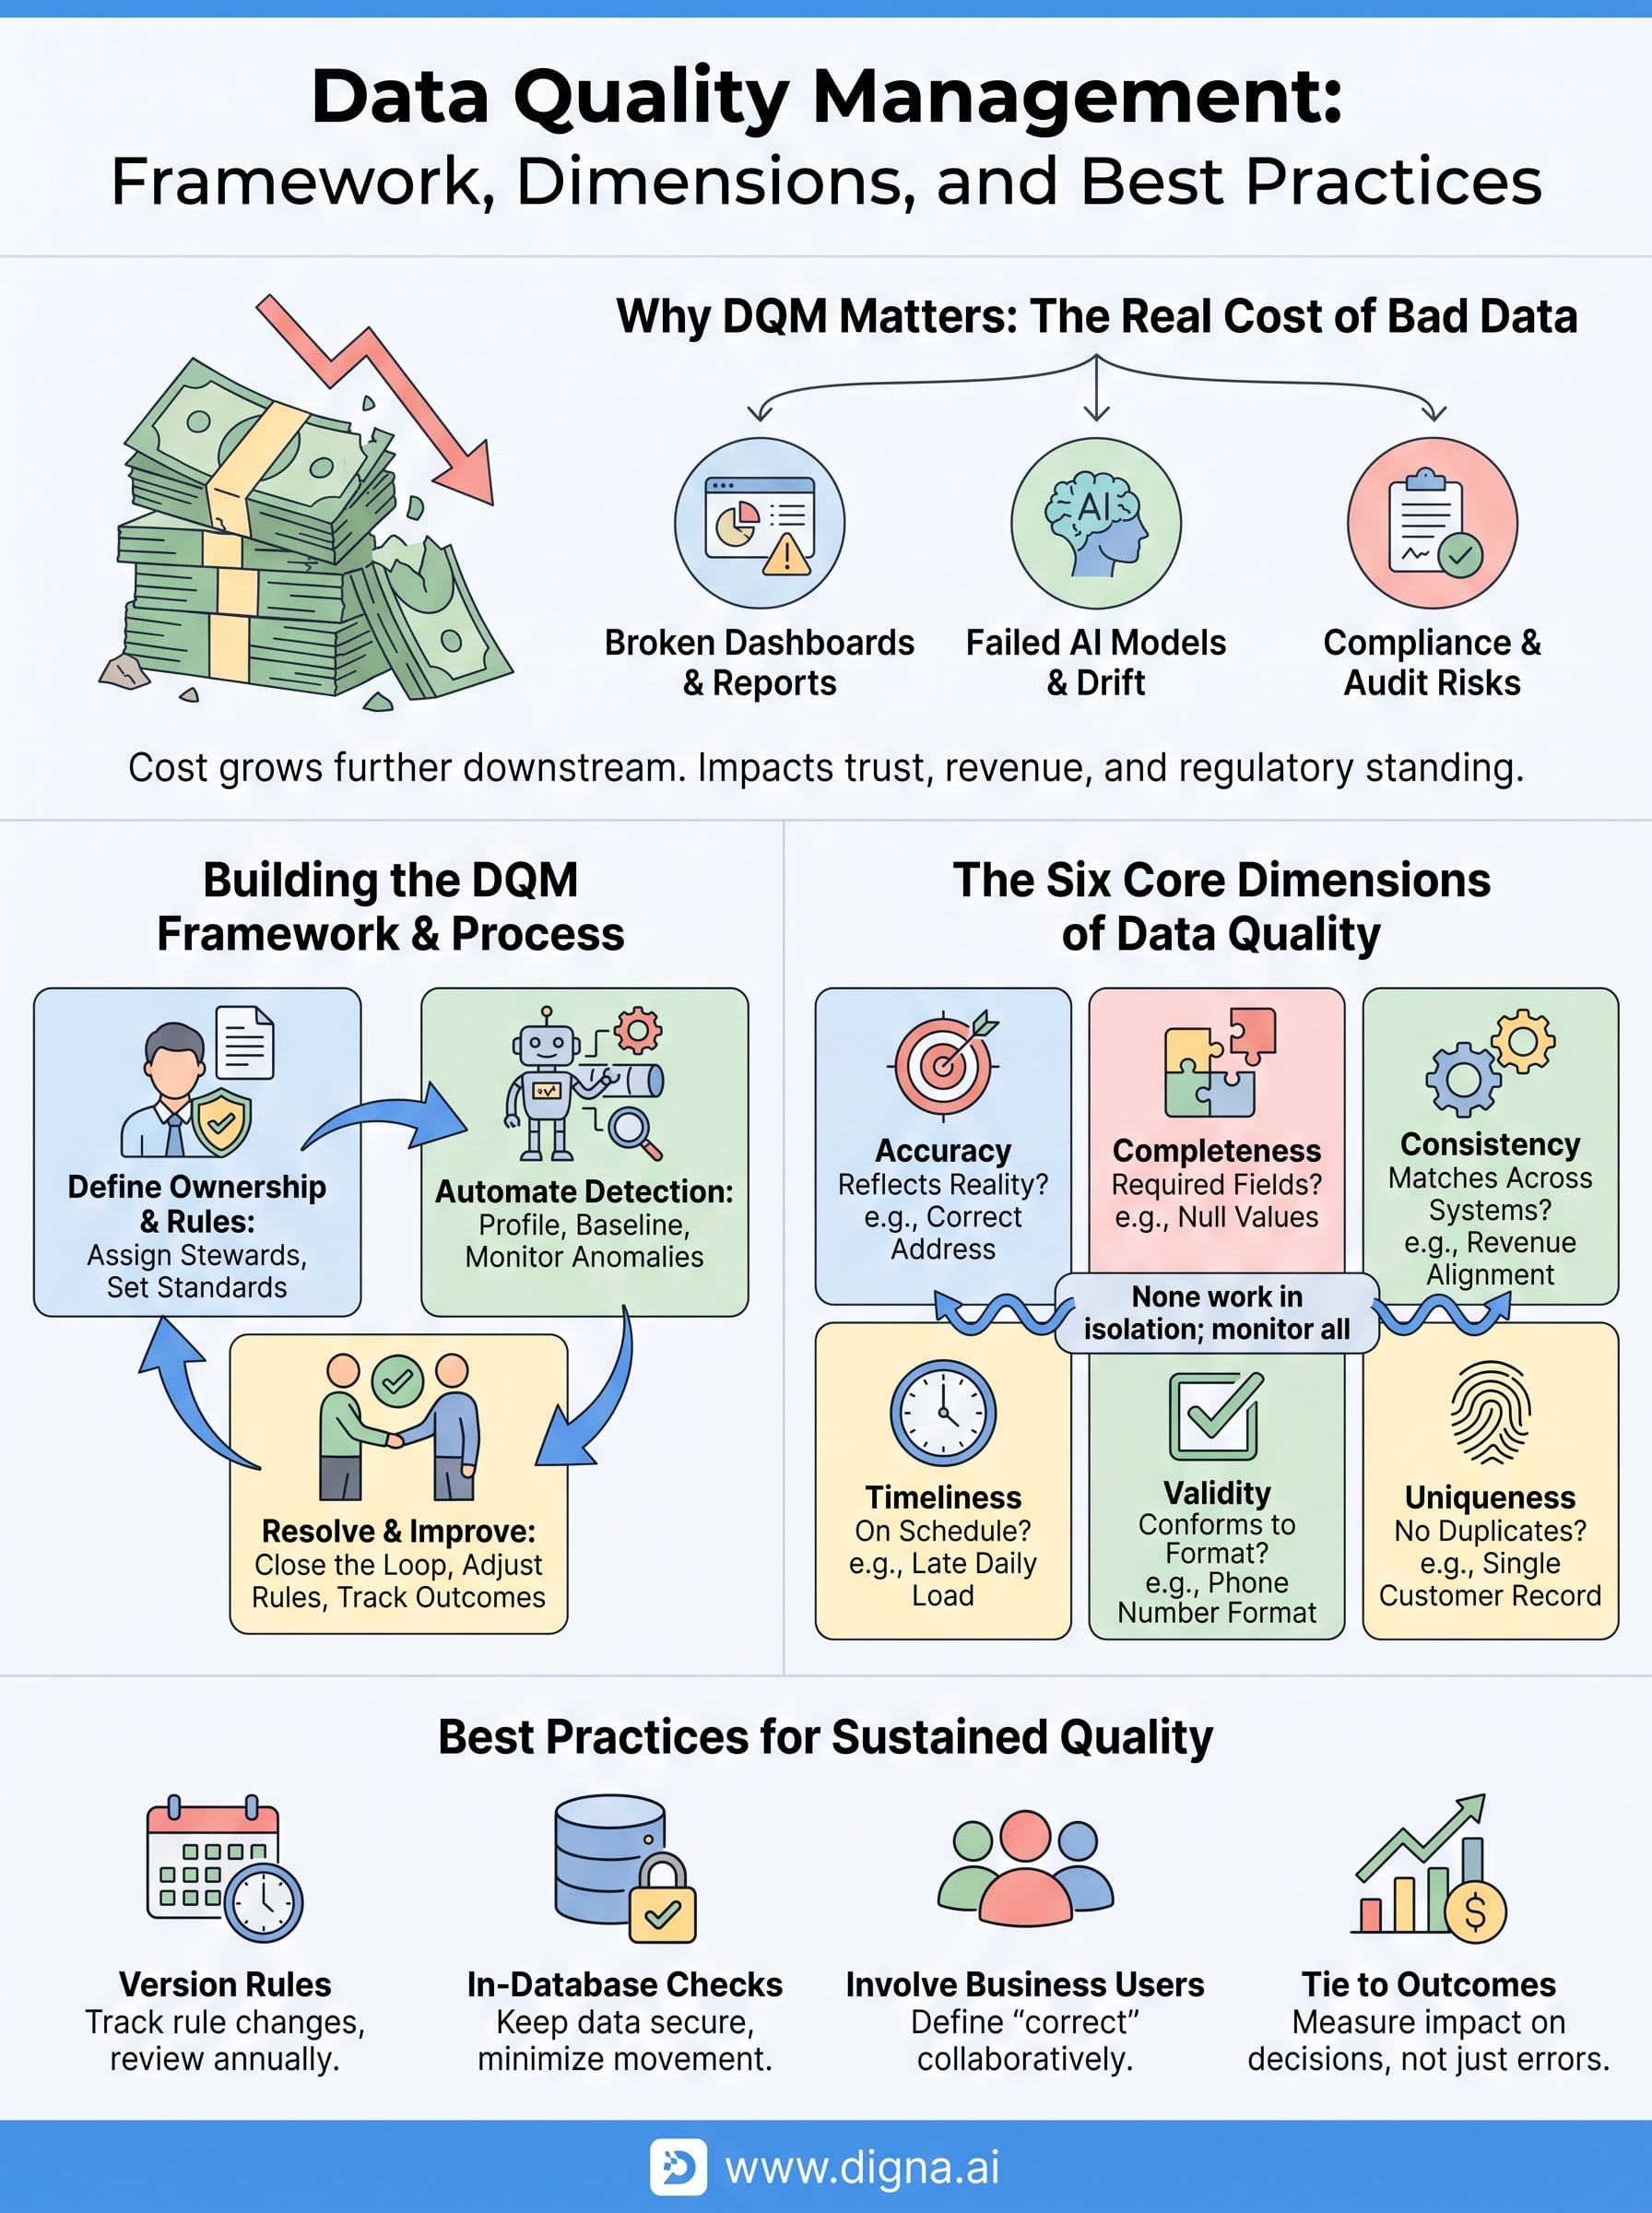
Gartner estime que la mauvaise qualité des données coûte aux organisations 12,9 millions de dollars par an en moyenne, un chiffre qui couvre le travail gaspillé, les occasions manquées et les erreurs pures et simples de décision. Ce chiffre ne capte même pas le dommage plus lent : des analystes qui cessent de faire confiance aux tableaux de bord, des dirigeants qui reviennent à l'intuition parce que les chiffres « ne semblent jamais justes », et des équipes d'ingénierie qui brûlent des heures à éteindre des incendies au lieu de construire. Les organisations qui gèrent la qualité des données de façon systématique attrapent ces problèmes à la source au lieu de les payer trois fois : une fois quand l'erreur survient, une fois quand quelqu'un la trouve, et une fois quand quelqu'un doit l'expliquer.
Chaque euro dépensé à attraper une erreur de données à la source rapporte bien plus que sa correction une fois qu'elle a atteint une décision.
Où la mauvaise qualité des données se manifeste vraiment
Le dommage reste rarement confiné à une seule équipe. Voici comment il se propage typiquement dans une organisation :
Tableaux de bord cassés : les dirigeants perdent confiance dans le reporting après avoir vu des chiffres contradictoires entre services.
Modèles d'IA en échec : les systèmes de machine learning entraînés sur des données incohérentes ou incomplètes dérivent silencieusement et produisent des sorties que personne ne signale avant la chute des performances.
Exposition réglementaire : les secteurs régulés s'exposent à des amendes ou à des échecs d'audit quand les enregistrements ne correspondent pas aux systèmes sources.
Gaspillage opérationnel : les ingénieurs passent des heures à remonter un mauvais chiffre jusqu'à son origine au lieu de construire de nouvelles fonctionnalités.
Confiance client : les erreurs de facturation, de dossiers ou de communication érodent la confiance plus vite que presque tout le reste.
Comme ces défaillances restent rarement isolées, un problème dans un pipeline peut apparaître discrètement dans cinq rapports différents avant que quiconque n'en retrouve l'origine.
Pression réglementaire et de conformité
La finance, la santé, les télécommunications et le secteur public opèrent sous des réglementations qui exigent des données traçables et exactes. Des cadres comme le RGPD en Europe imposent aux organisations de démontrer leur maîtrise des données personnelles, y compris leur exactitude et la façon dont elles sont traitées. Les auditeurs ne veulent pas seulement un rapport propre, ils veulent la preuve d'un processus reproductible qui attrape les erreurs avant qu'elles n'atteignent une déclaration ou le bureau d'un régulateur. Sans ce processus, chaque audit devient une course d'urgence au lieu d'une simple liste à cocher.
Confiance dans l'IA et les décisions automatisées
À mesure que les organisations s'appuient sur l'IA et des pipelines automatisés pour décider à grande échelle, la tolérance aux mauvaises données d'entrée se réduit. Un modèle ne fait pas la différence entre une vraie tendance et une erreur de saisie : il apprend simplement de ce qu'on lui donne. Les équipes qui font l'impasse sur la gestion de la qualité des données finissent par déboguer le comportement d'un modèle alors que le vrai problème était un changement de schéma trois pipelines plus haut. Intégrer les contrôles qualité dans le pipeline lui-même, plutôt que de compter sur un humain pour remarquer l'anomalie, est le seul moyen d'empêcher des systèmes automatisés de se tromper avec assurance à grande échelle.
Les dimensions fondamentales d'une donnée de qualité
La qualité n'est pas un attribut unique que l'on possède ou non. C'est un ensemble de dimensions mesurables, et la gestion de la qualité des données traite chacune comme une métrique à suivre, pas comme l'impression vague que « les données ont l'air correctes ». La plupart des cadres convergent vers six dimensions couvrant exactitude, structure et fraîcheur, chacune attrapant un type de défaillance différent.
Les six dimensions que les équipes mesurent
Voici comment les dimensions se déclinent en pratique, avec le type de défaillance que chacune est conçue à attraper :
Dimension | Ce qu'elle mesure | Exemple de défaillance |
|---|---|---|
Exactitude | La valeur reflète-t-elle la réalité ? | L'adresse client correspond à un ancien enregistrement, pas à l'actuel |
Complétude | Les champs obligatoires sont-ils renseignés ? | 15 % des commandes arrivent sans date de livraison |
Cohérence | Les valeurs concordent-elles entre les systèmes ? | Le chiffre d'affaires de l'entrepôt ne correspond pas à l'ERP source |
Timeliness | Les données arrivent-elles quand elles sont attendues ? | Un chargement quotidien arrive six heures en retard et casse un rapport du matin |
Validité | Les données respectent-elles les formats ou règles définis ? | Un champ de numéro de téléphone contient des lettres |
Unicité | Les enregistrements sont-ils dupliqués ? | Le même client apparaît trois fois sous des noms légèrement différents |
Pourquoi aucune dimension ne raconte toute l'histoire
Aucune de ces dimensions ne fonctionne isolément. Une donnée peut être parfaitement complète et rester fausse, chaque champ rempli d'une valeur périmée. Elle peut être à l'heure et rester invalide, arrivant dans les temps mais au mauvais format. Traiter les dimensions séparément est exactement la raison pour laquelle tant d'efforts qualité s'enlisent : une équipe corrige la complétude, crie victoire, et se fait surprendre trois mois plus tard par une défaillance de cohérence que personne ne surveillait.
La qualité des données n'est pas un score unique, ce sont six questions différentes qu'il faut continuer à poser en même temps.
Les changements de schéma méritent aussi d'être cités ici, car ils cassent discrètement plusieurs dimensions à la fois. Une colonne supprimée en amont ne nuit pas seulement à la complétude : elle peut corrompre silencieusement des contrôles de validité et de cohérence qui supposaient l'ancienne structure. C'est pourquoi les cadres de qualité des données matures associent des métriques par dimension à une surveillance structurelle, attrapant la cause racine au lieu de poursuivre les symptômes dimension par dimension.
Comment construire un processus de gestion de la qualité des données
Construire un processus de gestion de la qualité des données commence par une décision que la plupart des équipes esquivent : quelqu'un doit en être propriétaire. Sans responsable nommé, les contrôles qualité deviennent un projet annexe abandonné dès qu'un sprint se charge. Un processus qui fonctionne a besoin de quatre pièces qui se renforcent : une responsabilité claire, des règles définies, une détection automatisée et un flux de résolution qui boucle la boucle au lieu de se contenter de journaliser le problème.
Définissez responsabilité et règles avant d'écrire le moindre contrôle
Commencez par attribuer un data steward ou un propriétaire à chaque jeu de données critique, quelqu'un qui sait à quoi ressemble le « correct » pour ces données et qui est alerté quand quelque chose casse. Associez cette responsabilité à des règles métier documentées : quels champs sont obligatoires, quelles plages sont valides, quels formats sont acceptables. Sauter cette étape est le raccourci le plus fréquent, et c'est pourquoi tant de programmes qualité s'effondrent en moins d'un an : personne ne s'était mis d'accord sur ce que « bon » voulait dire.
Un processus qualité sans responsable nommé est une liste à cocher dont personne n'a la charge.
Automatisez la détection au lieu de compter sur des revues manuelles
Les contrôles ponctuels manuels attrapent ce que quelqu'un pense à vérifier, ce qui signifie qu'ils manquent tout le reste. Une surveillance automatisée, en particulier une détection d'anomalies qui apprend le comportement normal des données, attrape les défaillances pour lesquelles personne n'avait pensé à écrire une règle. Un déploiement concret suit généralement cet ordre :
Profilez vos données pour comprendre le volume, la distribution et les taux de valeurs nulles actuels.
Fixez des règles de base pour les dimensions qui comptent le plus dans votre activité.
Ajoutez la détection d'anomalies pour signaler les écarts que les règles seules n'attraperont pas.
Surveillez les changements de schéma en continu, puisque les évolutions structurelles cassent plusieurs contrôles à la fois.
Bouclez la boucle avec un flux de résolution
Détecter un problème ne sert à rien s'il meurt dans un tableau de bord que personne ne consulte. Chaque alerte a besoin d'une destination : un ticket, un canal Slack, un responsable censé répondre dans un délai fixé. La résolution doit aussi nourrir le jeu de règles : si la même anomalie déclenche sans cesse de fausses alertes, c'est le seuil qu'il faut ajuster, pas l'alerte qu'il faut faire taire. Les équipes qui considèrent cette boucle de retour comme optionnelle se noient dans la fatigue d'alerte en un trimestre.
Bonnes pratiques et pièges courants à éviter
Connaître le cadre est une chose. Le faire tourner sans tomber dans les mêmes pièges que toutes les équipes en est une autre. La gestion de la qualité des données réussit ou échoue moins sur la technologie choisie que sur les habitudes construites autour d'elle. Les pratiques ci-dessous séparent les équipes qui maintiennent un haut niveau de qualité pendant des années de celles qui corrigent une fois et regardent la qualité s'éroder de nouveau.
Les pratiques qui tiennent vraiment dans la durée
Versionner vos règles métier compte plus que la plupart des équipes ne l'imaginent, car des règles qui avaient du sens l'an dernier cessent souvent de coller à la réalité dès qu'un système source change. Traitez votre jeu de règles comme du code : suivez les modifications, relisez les mises à jour et revenez en arrière quand une nouvelle règle produit plus de fausses alertes qu'elle n'en attrape. Associez cette discipline à une surveillance qui s'exécute in-database, afin que des enregistrements sensibles n'aient jamais à quitter votre environnement pour être contrôlés, ce qui compte surtout pour les équipes de la finance, de la santé et du secteur public soumises à des règles de conformité strictes.
Impliquez les utilisateurs métier, pas seulement les ingénieurs, pour définir ce que « correct » signifie pour un jeu de données.
Revoyez les seuils chaque trimestre pour que les règles restent alignées sur le comportement réel des données et non sur des hypothèses d'il y a un an.
Documentez chaque dérogation, car une règle que quelqu'un a désactivée en silence est une règle que plus personne ne vérifie.
Reliez les métriques qualité aux résultats métier, comme l'exactitude des rapports ou la performance des modèles, pas seulement à un décompte brut d'erreurs.
Des règles qu'on ne revisite jamais deviennent des angles morts déguisés en garde-fous.
Les pièges qui défont discrètement le bon travail
La fatigue d'alerte est le mode de défaillance le plus courant, et elle commence innocemment : une équipe serre trop ses règles, se retrouve inondée de faux positifs et finit par ignorer complètement le canal. Dès lors, un vrai problème passe inaperçu au milieu du bruit. Surcorriger vers la revue manuelle est tout aussi dommageable, car cela ne passe pas l'échelle au-delà d'une poignée de tables et épuise les analystes chargés des contrôles.
La propriété en silos fait autant de dégâts que l'absence totale de propriété. Quand cinq équipes rapiècent chacune leur coin de pipeline sans se parler, la même anomalie est « corrigée » de cinq manières différentes, et aucune ne traite la cause racine. Poursuivre chaque dimension avec la même intensité est un autre piège : tous les champs ne méritent pas la même attention, et traiter un champ de log à faible risque comme un enregistrement réglementaire gaspille l'attention qui devrait aller aux données qui guident réellement les décisions.
Faire de la qualité des données une habitude quotidienne
Une bonne qualité des données n'est pas un projet que l'on termine. C'est une habitude que l'on inscrit dans la façon de travailler des équipes, comme la revue de code est devenue une habitude une fois que les équipes se sont brûlées sur de mauvais déploiements. Les dimensions, la responsabilité et les flux évoqués ici ne tiennent que si quelqu'un les fait vivre une fois l'enthousiasme du lancement retombé. La gestion de la qualité des données fonctionne quand elle est ennuyeuse : les contrôles tournent automatiquement, les responsables sont alertés avant qu'un client ne remarque quoi que ce soit, et les règles sont revisitées avant de devenir des angles morts.
Vous n'avez pas à construire tout cela de zéro ni à mobiliser une équipe pour surveiller des tableaux de bord. Les plateformes qui réunissent détection d'anomalies, suivi de schéma et validation au même endroit, en s'exécutant directement dans votre propre base de données, vous mènent de l'installation à un constat exploitable en quelques heures plutôt qu'en quelques mois. Si vous êtes prêt à cesser d'éteindre des incendies de données pour les attraper à la source, découvrez comment digna peut vous aider.
Chacune des six dimensions récompense un contrôle différent, et les traiter comme un score unique est précisément ce qui permet à une défaillance de cohérence de se cacher derrière une victoire sur la complétude — pour le détail de mesure derrière chacune, voyez les dimensions de la qualité des données.
Questions fréquentes
Qu'est-ce que la gestion de la qualité des données ?
La discipline consistant à définir, mesurer et maintenir l'exactitude, la complétude, la cohérence et la ponctualité des données tout au long de leur cycle de vie. Ce n'est ni un outil unique ni un tableur de règles de validation, mais un cadre associant processus, responsabilité et technologie pour attraper les problèmes avant un rapport ou un modèle.
Quelles sont les six dimensions de la qualité des données ?
Exactitude, complétude, cohérence, Timeliness, validité et unicité. Chacune attrape une défaillance différente : 15 % de commandes arrivant sans date de livraison relève de la complétude, tandis qu'un chiffre d'affaires d'entrepôt divergeant de l'ERP source relève de la cohérence. En corriger une et crier victoire est exactement ce qui fait caler ces programmes.
Comment construire un processus de gestion de la qualité des données ?
Quatre éléments se renforcent : un responsable nommé pour chaque jeu de données critique, des règles métier documentées, une détection automatisée et un flux de résolution. Profilez d'abord volume, distribution et taux de valeurs nulles, fixez des règles de base pour les dimensions importantes, puis ajoutez détection d'anomalies et surveillance continue du schéma.
Pourquoi les programmes de qualité des données échouent-ils ?
La fatigue d'alerte est le mode de défaillance le plus courant. Des règles trop serrées inondent le canal de faux positifs jusqu'à ce que plus personne ne le lise, et un vrai problème passe avec le bruit. La propriété en silos cause autant de dégâts, cinq équipes rapiéçant la même anomalie de cinq manières différentes.
Combien coûte une mauvaise qualité des données ?
Gartner estime une moyenne de 12,9 millions USD par an et par organisation, couvrant le travail gaspillé, les occasions manquées et les erreurs de décision. Le dommage le plus lent se chiffre moins bien : des analystes qui cessent de faire confiance aux tableaux de bord et des ingénieurs qui passent leurs heures à éteindre des incendies plutôt qu'à construire.


