Gestion de produits de données : guide de fiabilité
|
7
minute de lecture
Un tableau de bord de chiffre d'affaires lâche juste avant une réunion de planification. L'actualisation est arrivée en retard, un champ en amont a changé sans prévenir, et les chiffres ne correspondent plus au rapport financier. Au même moment, une fonction d'IA se met à produire des recommandations instables parce que les données d'entraînement ont dérivé. Le problème visible est un graphique cassé ou un modèle qui dérive. Le problème de fond est que personne n'a exploité ces données comme quelque chose sur quoi les consommateurs pouvaient compter.
C'est là que la gestion de produits de données compte. Un produit de données n'est pas simplement une table, un pipeline, un tableau de bord ou un modèle. C'est une offre de données gérée, dotée d'un consommateur défini, d'une propriété claire, d'attentes de qualité, de niveaux de service et d'un cycle de vie qui se poursuit après la mise en production. Ce guide construit l'idée depuis les principes de base, puis relie rôles, décisions de cycle de vie, KPI de fiabilité, workflows de gouvernance et observabilité.
L'approche s'accorde aussi naturellement avec les pratiques DataOps pour des opérations de données fiables, en particulier quand ingénieurs et analystes doivent détecter les défaillances avant qu'elles n'atteignent rapports, applications ou systèmes d'IA.
Table des matières
Introduction : pourquoi les données ont besoin d'une pensée produit maintenant
Le cycle de vie d'un produit de données, de l'idée au retrait
Workflows de gouvernance et observabilité qui gardent les produits fiables
Applications concrètes et prochaines étapes pour vos produits de données
Introduction : pourquoi les données ont besoin d'une pensée produit maintenant
Un pipeline peut passer son premier test de livraison, puis faire défaut aux équipes qui en dépendent. Un champ source change, une actualisation arrive en retard, ou deux rapports appliquent des définitions différentes à la même métrique. La sortie existe toujours, mais son comportement n'est plus prévisible.
La discussion de Thoughtworks de 2025 présente la donnée comme un produit doté de son propre cycle de vie, de ses standards de qualité et des besoins de ses consommateurs. Ce cadrage déplace la question de « avons-nous publié le jeu de données ? » vers « les personnes et les systèmes peuvent-ils l'utiliser en sécurité et de façon répétée ? ». La même discussion relie la discipline produit à la prolifération des plateformes : les organisations déclarent accumuler 10 à 15 plateformes ou plus, ce qui crée fragmentation, efforts dupliqués et problèmes d'intégration. (La discussion de Thoughtworks de 2025 sur la donnée comme produit décrit cette idée d'exploitation et son lien avec la prolifération des plateformes.)
La documentation peut prendre du retard tout aussi vite. Le guide cite un Product Excellence Report selon lequel seuls 41 % des professionnels produit tiennent leurs feuilles de route à jour et alignées sur les attentes des parties prenantes, un avertissement pour les équipes data dont les priorités, les schémas et les consommateurs évoluent avec le temps.
Règle pratique : Un produit de données gagne la confiance par un comportement fiable, pas par une fiche de catalogue soignée.
Ce comportement exige des contrôles opérationnels. Les vérifications Timeliness montrent si la livraison respecte les attentes. La validation attrape les valeurs inattendues. Le suivi de schéma expose les changements cassants avant que les consommateurs ne les rencontrent. L'observabilité relie ces signaux pour qu'ingénieurs et analystes voient si un jeu de données reste exploitable pour des rapports, des applications ou des systèmes d'IA. Les équipes qui appliquent des pratiques DataOps pour des opérations de données fiables peuvent traiter ces contrôles comme une partie de la livraison plutôt que comme une réparation d'urgence.
La pensée produit donne donc au travail sur les données une discipline de fiabilité : définir le consommateur, exploiter l'interface et conserver des preuves après la mise en production.
Ce que signifie vraiment la gestion de produits de données
Partons d'une analogie familière de rayonnage. Un jeu de données brut ressemble à un ingrédient non étiqueté dans une réserve. Quelqu'un sait peut-être d'où il vient, mais un nouveau consommateur doit encore demander ce qu'il contient, s'il est frais, comment l'utiliser et qui contacter quand quelque chose cloche.
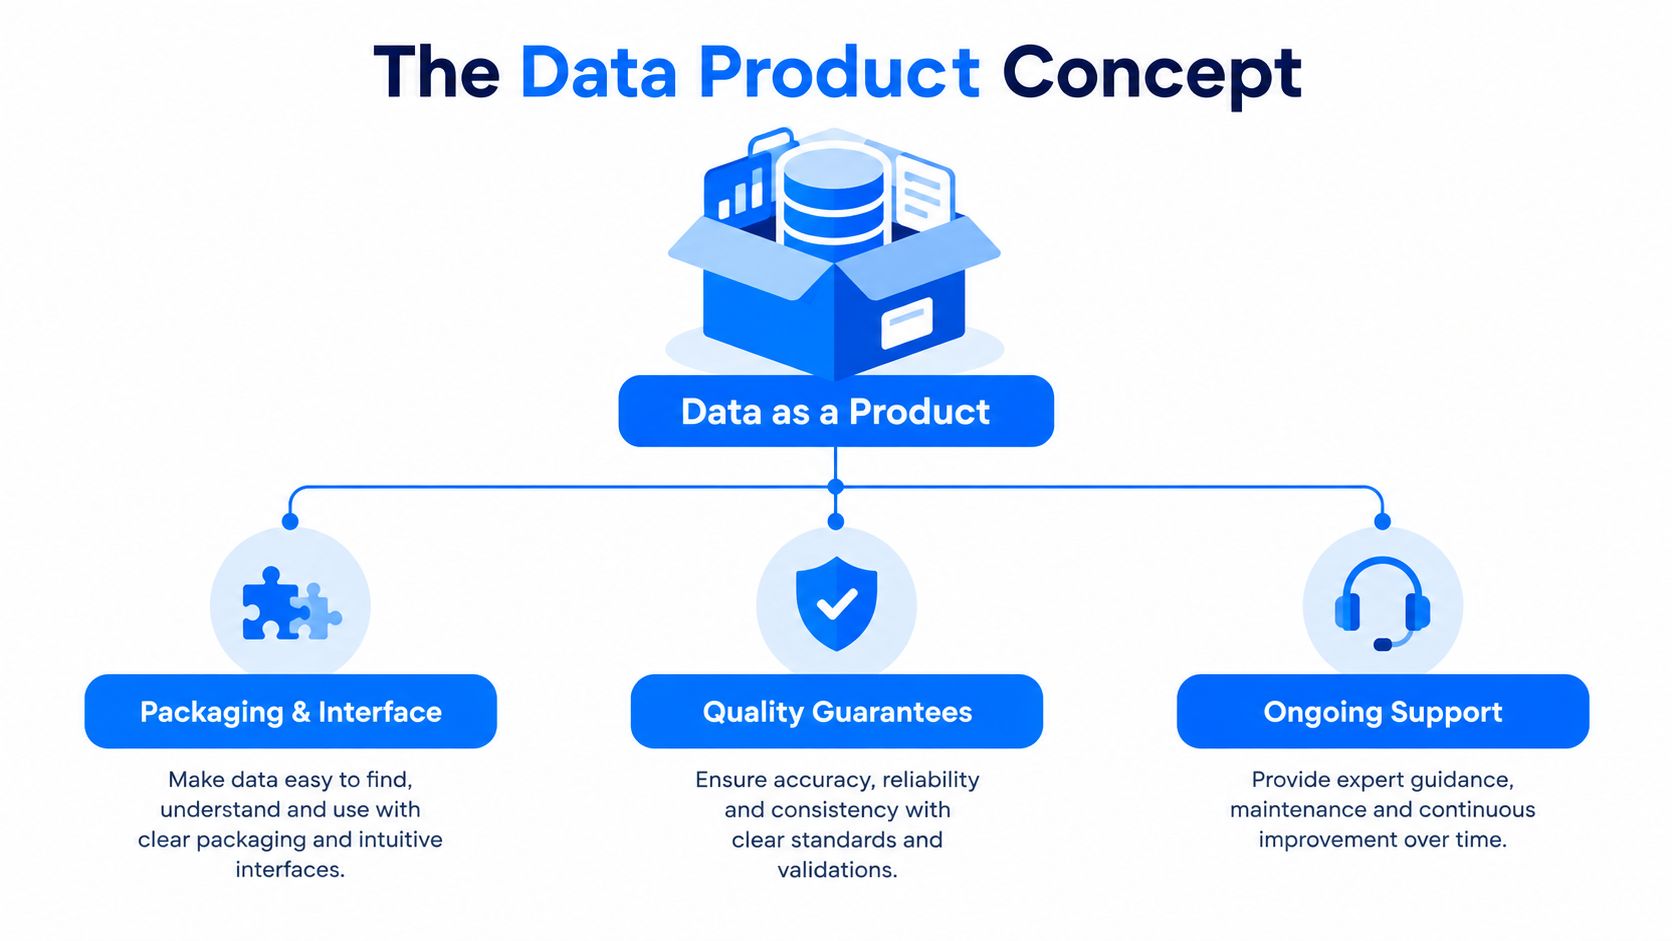
Un produit de données ressemble davantage à un article conditionné, conçu pour un usage répété. Il a un nom clair, une interface, un mode d'emploi, des attentes de qualité et un support. Le conditionnement peut être une vue SQL gouvernée, une API, un modèle analytique, un ensemble de features ou un tableau de bord adossé à une logique sémantique stable. Le format compte moins que l'engagement d'exploitation qui l'entoure.
Les quatre tests de la pensée produit
Un produit de données utile devrait passer quatre tests :
Découvrabilité : Les consommateurs le trouvent via un catalogue, un portail ou une interface connue, sans dépendre de relations personnelles.
Adressabilité : Les consommateurs savent y accéder, que ce soit par un endpoint de requête, une API, un partage gouverné ou une vue documentée.
Fiabilité : Le produit publie des attentes de qualité mesurables et surveille s'il les respecte.
Auto-description : Les métadonnées expliquent définitions, propriété, lineage, sensibilité, usage autorisé et limites connues.
Ces propriétés séparent un produit d'un livrable de projet. Un projet optimise généralement un périmètre défini et un point d'achèvement. Un produit porte une responsabilité continue sur la pertinence, la fiabilité, le retour des consommateurs, le changement maîtrisé et, à terme, le retrait.
La distinction gagne en importance à mesure que les piles technologiques se multiplient. L'expansion des plateformes peut donner plus de capacités aux équipes tout en rendant plus difficile d'identifier le jeu de données faisant autorité, la définition en vigueur ou le responsable. La gestion de produit apporte la discipline manquante. Elle demande qui consomme la donnée, quelle décision elle soutient, quel niveau de service cette décision exige, et comment l'équipe réagira quand la réalité changera.
Ce que gère réellement le product manager
Le manager ne se contente pas d'ordonner des champs de catalogue. Il gère une promesse entre producteurs et consommateurs. Cette promesse comprend la finalité du produit, son interface, ses contrôles qualité, sa voie de support, sa feuille de route et ses conditions de retrait.
Un produit peut soutenir du reporting réglementaire, des opérations client, de la prévision ou un workflow d'IA. Chaque cas d'usage crée des attentes différentes en matière de fraîcheur, de validation, d'accès et de sûreté du changement. La pensée produit rend ces attentes explicites avant que les ingénieurs ne les codent dans des pipelines.
Une courte explication visuelle peut aider les équipes à s'accorder sur la distinction entre une sortie et une offre gérée :
L'idée centrale est simple : la donnée devient un produit quand les consommateurs peuvent compter sur son comportement, et non dès qu'une équipe colle une nouvelle étiquette sur un actif existant.
Rôles et propriété dans une équipe produit de données
Une équipe produit de données fonctionne le mieux quand la responsabilité suit le produit plutôt que l'outil. Le data product manager possède la direction du produit et la réussite du consommateur. Les ingénieurs font fonctionner le produit. Analystes, scientifiques, spécialistes de la gouvernance et équipes plateforme apportent des capacités distinctes sans brouiller les droits de décision.

La responsabilité doit être visible
Le data product manager répond de la vision, de la priorisation, de la recherche consommateur, de la feuille de route et des résultats du produit. Il traduit un problème métier en décision produit, décide quelles demandes méritent un investissement et garde les parties prenantes alignées quand des arbitrages apparaissent.
L'ingénieur de données possède l'ingestion, la fiabilité des transformations, le comportement d'exécution et les dépendances opérationnelles. L'ingénieur analytique transforme les définitions métier en modèles gouvernés, métriques réutilisables, tests et documentation. Le data scientist peut consommer le produit pour bâtir des modèles ou des systèmes de décision, tout en donnant un retour sur la stabilité des features, les données d'entraînement et la maturité du modèle.
Les équipes de gouvernance et de plateforme fournissent des garde-fous au lieu de remplacer la propriété produit. Les spécialistes de la gouvernance définissent politiques, attentes d'accès, règles de classification et exigences d'audit. Les ingénieurs plateforme fournissent l'infrastructure, les schémas de déploiement, les permissions et les capacités d'observabilité qui permettent aux équipes produit d'opérer en sécurité.
Une carte de propriété concrète peut ressembler à ceci :
Vision et priorisation : Data product manager, avec l'apport du domaine et de la direction.
Définitions métier : Ingénieur analytique et expert du domaine, avec validation produit.
Fiabilité du pipeline et de l'exécution : Ingénieur de données, épaulé par l'ingénierie plateforme.
Contrôles qualité et d'accès : Responsable gouvernance et propriétaire d'ingénierie désigné.
Accueil et retour des consommateurs : Product manager, épaulé par les analystes et les référents de domaine.
Réponse aux incidents de production : Responsable opérationnel nommé, avec voies d'escalade documentées.
La propriété devient le goulot d'étranglement quand un produit a un nom mais personne d'habilité à décider, à financer la maintenance ou à retirer l'actif.
Ce problème est particulièrement sérieux en environnement réglementé. Un catalogue peut afficher un propriétaire, et pourtant ce propriétaire n'a peut-être pas l'autorité d'approuver un changement de schéma ou de prioriser un contrôle de fraîcheur en échec. Une propriété efficace associe responsabilité, droits de décision, capacité opérationnelle et un parcours de support clair.
Un tableau de bord partagé peut donner aux ingénieurs, analystes et parties prenantes la même vue des incidents, des tendances et de l'état du produit sans sortir les données de l'environnement du client. Le modèle de rôles de gouvernance des données plus large aide les équipes à rendre ces passages de relais explicites au lieu de les laisser dans des conversations informelles.
Le cycle de vie d'un produit de données, de l'idée au retrait
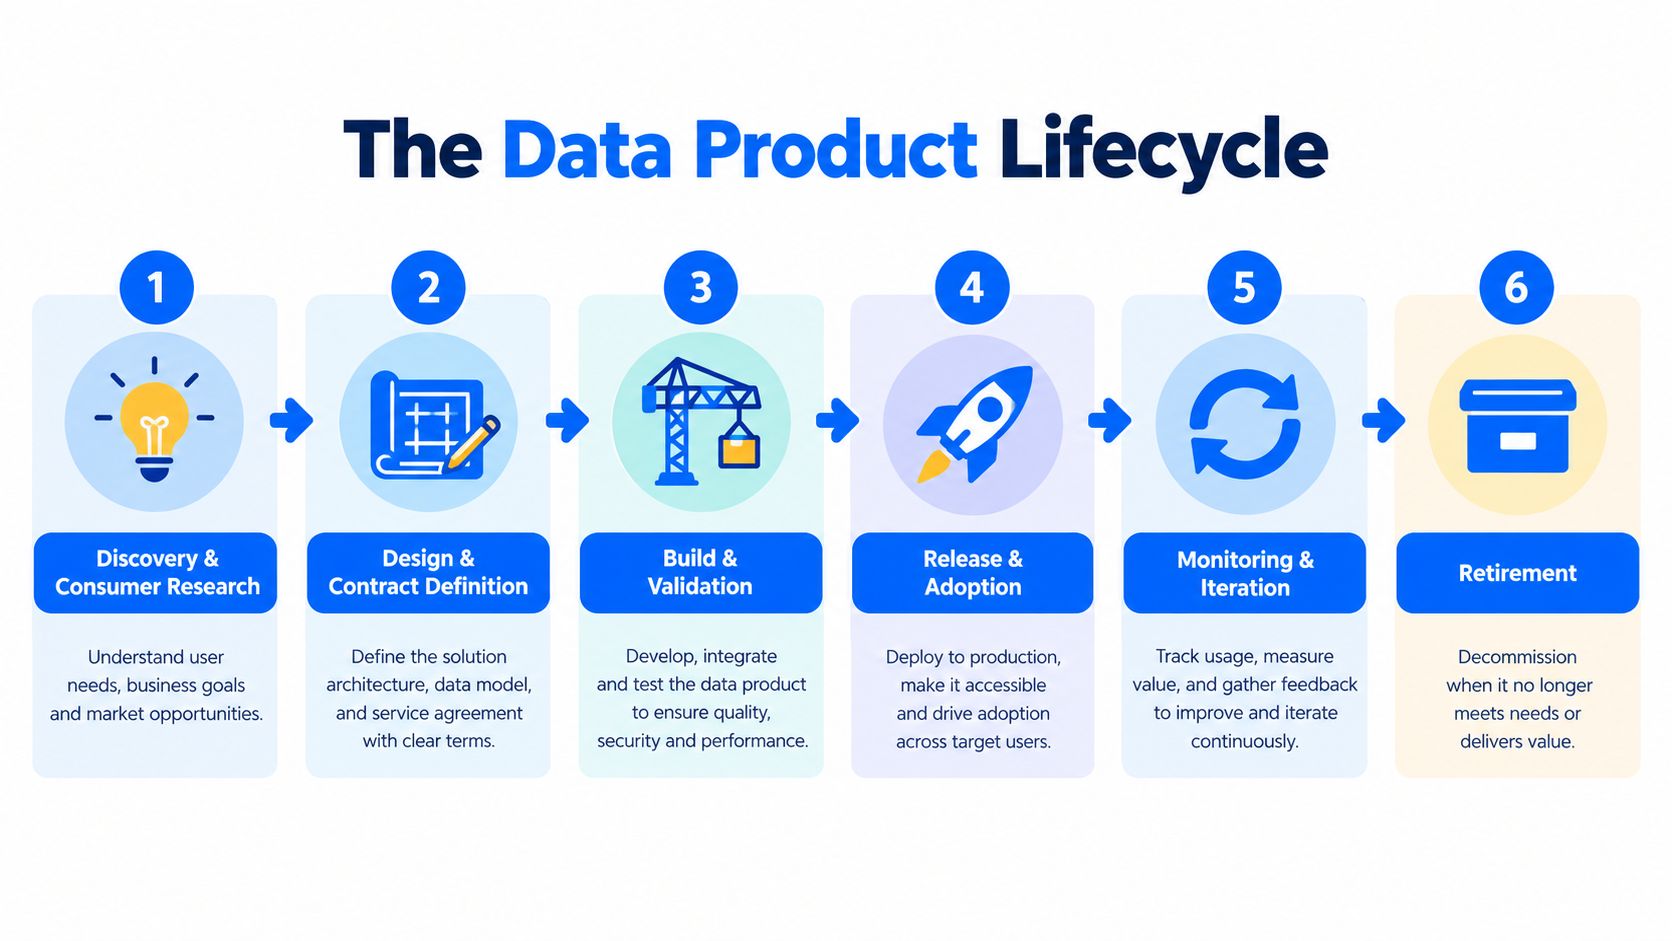
Le cycle de vie d'un produit de données commence avant le code et se poursuit après la mise en production. Chaque étape répond à une question différente, et chaque point de décision empêche l'équipe d'emporter en production des hypothèses non résolues.
Découverte et recherche consommateur
Partez de la décision, pas de la source disponible. Identifiez le groupe de consommateurs, le problème métier, l'action que le produit doit soutenir et les conséquences de données tardives ou fausses. Interrogez séparément analystes, opérateurs, équipes applicatives et référents gouvernance, car chaque groupe voit des modes de défaillance différents.
Une sortie de découverte utile comprend un énoncé du problème, un responsable nommé, des parcours consommateurs initiaux, la sensibilité des données, le modèle d'accès attendu et une définition grossière du succès. Si les utilisateurs ne savent pas expliquer ce qu'ils feront du produit, l'équipe devrait éprouver le besoin avant d'engager de la capacité d'ingénierie.
Conception et définition du contrat
Définissez ensuite l'interface et les garanties du produit. Documentez entités, métriques, sens des champs, valeurs autorisées, comportement de livraison attendu, contrôles d'accès et règles de gestion du changement. Les contrats de données doivent décrire ce que fournissent les producteurs et ce que les consommateurs peuvent supposer sans risque.
L'équipe doit aussi décider quels changements sont rétrocompatibles, lesquels exigent une nouvelle version et lesquels imposent de notifier les consommateurs. Ingénieurs analytiques et experts du domaine préviennent la dérive sémantique avant qu'elle n'atteigne tableaux de bord ou modèles.
Construction et validation
Les ingénieurs implémentent ensuite ingestion, transformation, tests, métadonnées, lineage et contrôles opérationnels. La validation ne doit pas être repoussée à la revue finale. Les règles métier connues, les attentes structurelles et le comportement de livraison ont besoin de contrôles tout au long du développement et avant la mise en production.
Un produit n'est pas prêt parce que sa requête renvoie des lignes. Il est prêt quand l'équipe peut démontrer que ces lignes suivent des définitions documentées, arrivent dans l'attente convenue et produisent une réponse claire quand une dépendance amont tombe.
Mise en production et adoption
La mise en production comprend l'accueil, des exemples, des instructions d'accès, l'aiguillage du support et la formation des consommateurs. Un produit techniquement solide peut échouer malgré tout si les utilisateurs ne comprennent pas les définitions ou ne peuvent pas y accéder depuis leur workflow habituel.
Le product manager doit observer les premiers retours et distinguer un problème de découvrabilité, un problème d'utilisabilité, un problème de confiance et une véritable absence de demande. Chacun appelle une réponse différente.
Surveillance et itération
Après le lancement, l'équipe examine signaux qualité, incidents, usages et retours. La surveillance doit déboucher sur des décisions de backlog, pas seulement sur du bruit d'alertes. Si les utilisateurs ont besoin d'une autre granularité, d'une autre fenêtre de livraison ou d'une autre interface, la feuille de route doit refléter cette preuve.
La discipline de feuille de route compte, car les produits de données se dégradent quand les attentes des parties prenantes bougent pendant que le produit reste figé. La couverture de 2026 citée plus haut relie un faible alignement de feuille de route à la difficulté de gestion produit, ce qui fait de la communication et de la priorisation une part de la fiabilité plutôt qu'une charge administrative.
Retrait
Le retrait est une décision produit maîtrisée. Définissez la raison, identifiez les consommateurs restants, communiquez la voie de remplacement ou d'archivage, conservez les preuves exigées et supprimez les accès obsolètes. Un retrait propre garde le portefeuille compréhensible et évite que les ingénieurs entretiennent des sorties qui ne soutiennent plus aucune décision utile.
Mesurer le succès avec des KPI qui prouvent la fiabilité
Un produit peut avoir de nombreux consommateurs et rester peu fiable. Il peut aussi avoir une adoption initiale limitée parce qu'il sert un workflow spécialisé tout en tenant sa promesse de service. C'est pourquoi les KPI d'un produit de données doivent relier la valeur pour le consommateur à la santé opérationnelle, au lieu de compter tableaux de bord, tables ou fiches de catalogue.
Les recommandations d'experts préconisent de suivre le respect du SLA de fraîcheur, la couverture de propriété, la couverture des contrats de données et la détection d'impact avant déploiement, car ces mesures relient fiabilité et sûreté du changement (les recommandations sur la gouvernance des produits de données expliquent cette approche opérationnelle). Les cadres de gouvernance recommandent aussi des mesures d'adoption et de support telles que le taux de réutilisation, la croissance des consommateurs actifs, le temps de découverte, l'aiguillage des incidents vers un responsable nommé et les incidents résolus dans le SLA (les recommandations de suivi de la gouvernance de portefeuille relient ces indicateurs aux résultats de réutilisation et de contrôle).
Choisir les KPI d'un produit de données par résultat
Résultat visé | KPI principal | Ce qu'il signale |
|---|---|---|
Construire la confiance des consommateurs | Respect du SLA de fraîcheur | Si la livraison tient l'attente sur laquelle comptent les consommateurs |
Rendre la responsabilité visible | Couverture de propriété | Si chaque produit et chaque incident a un responsable désigné |
Réduire le risque du changement | Couverture des contrats de données et détection d'impact avant déploiement | Si les changements structurels sont compris avant la mise en production |
Augmenter la réutilisation | Taux de réutilisation et croissance des consommateurs actifs | Si le produit résout des besoins répétables chez plusieurs consommateurs |
Améliorer la découvrabilité | Recherche-vers-ouverture ou temps de découverte | Si les utilisateurs savent localiser et comprendre le produit efficacement |
Améliorer le support | Aiguillage des incidents vers un responsable nommé et résolution dans le SLA | Si les défaillances passent vite de la détection à la remédiation |
Ces KPI répondent à des questions différentes. La fraîcheur dit si un rapport ou un modèle reçoit les données à l'heure. La propriété dit si quelqu'un peut agir quand ce n'est pas le cas. La couverture des contrats montre si les consommateurs sont protégés des surprises structurelles. La réutilisation indique que le produit offre une interface fiable plutôt qu'une réponse ponctuelle.
La chaîne causale compte. Si la livraison devient imprévisible, les consommateurs créent des copies privées. Si la propriété est floue, les incidents restent non résolus. Si les utilisateurs ne trouvent pas vite des produits certifiés, ils reviennent aux demandes manuelles. Avec le temps, ces comportements augmentent la duplication et affaiblissent la valeur de la gouvernance.
Les équipes peuvent utiliser les recommandations de mesure de la fiabilité pour concevoir un tableau de bord autour des engagements réels de leur produit envers ses consommateurs. La discipline importante est de choisir un petit ensemble de mesures qui déclenchent des décisions. Un KPI qui ne change jamais la priorisation est un rapport, pas un instrument de pilotage.
Workflows de gouvernance et observabilité qui gardent les produits fiables
Un pipeline de reporting peut livrer un fichier à l'heure et produire malgré tout des résultats peu fiables. Un champ renommé peut casser un tableau de bord, un déplacement soudain de distribution peut fausser un modèle, et une livraison tardive peut laisser les analystes travailler sur des informations périmées. La gouvernance devient utile quand ses règles opèrent aux côtés de la livraison, de la validation et de la réponse aux incidents.
L'observabilité des données fonctionne comme un pupitre de commande pour un produit de données. Elle surveille en continu la santé du système, la qualité, la fiabilité et la performance à travers ingestion, stockage et analytique. Ses signaux essentiels comprennent fraîcheur, volume, schéma, distribution et lineage, comme le décrit la recherche sur les signaux d'observabilité. Les équipes peuvent aussi explorer les pratiques d'observabilité des données pour voir comment ces signaux soutiennent la surveillance opérationnelle.
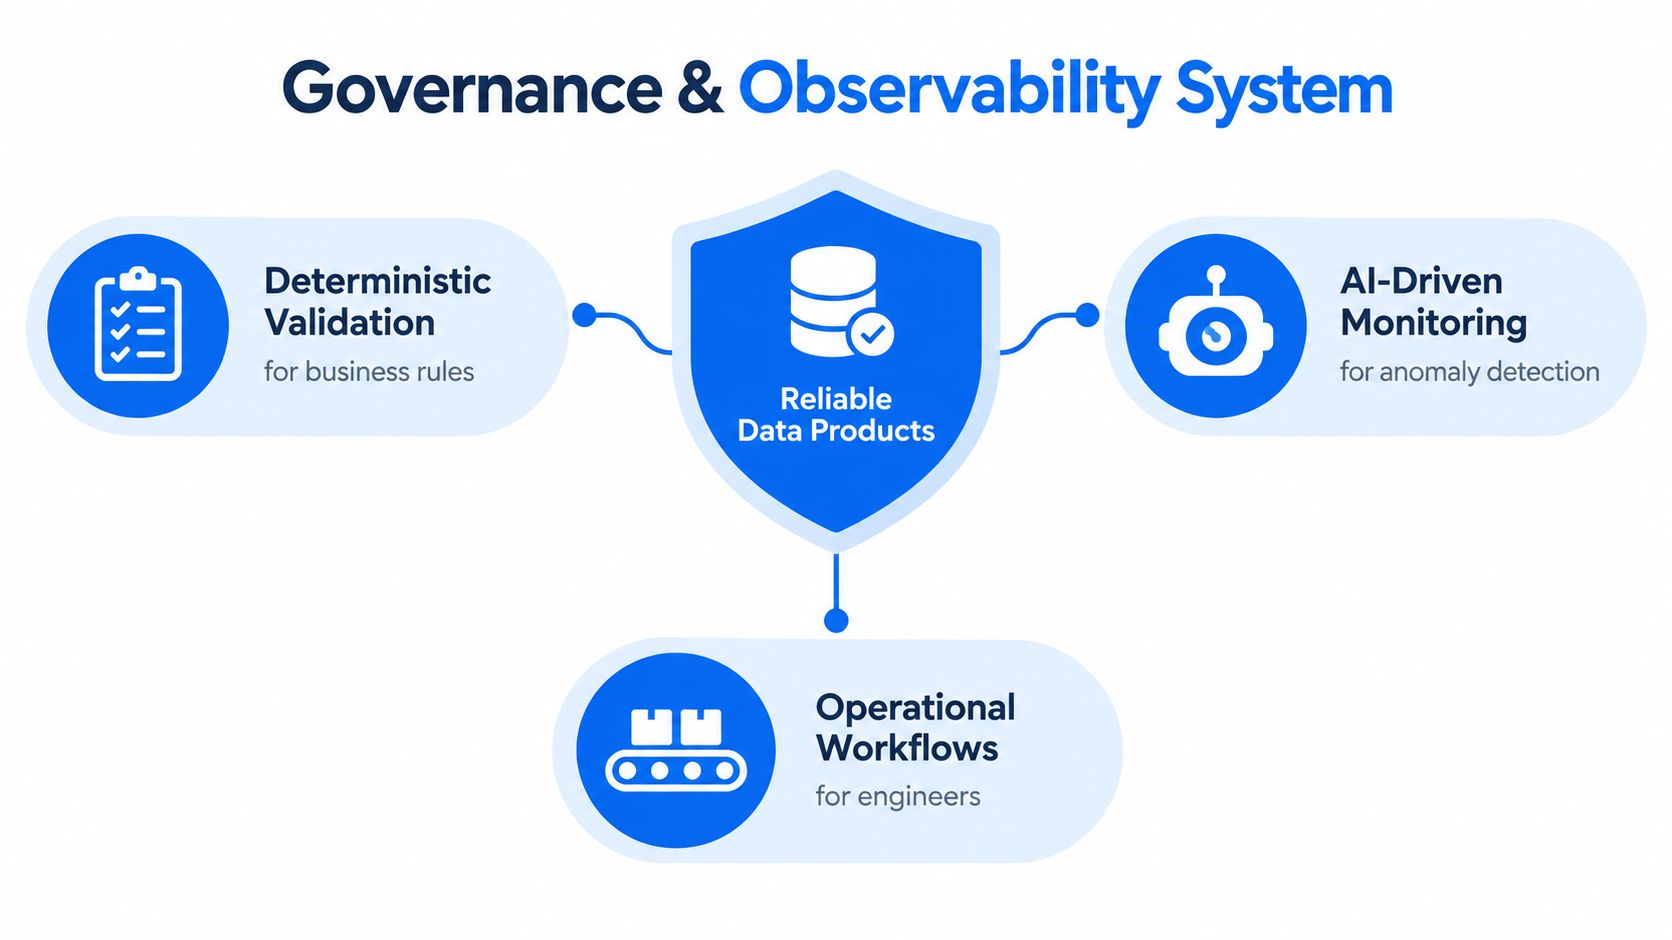
Quatre contrôles aux rôles distincts
La validation déterministe vérifie des règles que l'équipe comprend déjà. Valeurs de statut autorisées, identifiants obligatoires, règles de relation et conditions de reporting réglementaire en sont des exemples courants. Parce que chaque contrôle renvoie à une règle définie, son résultat peut être expliqué et audité.
La détection d'anomalies cherche des comportements inhabituels que des règles fixes peuvent manquer. Chaque ligne peut passer un contrôle de validité basique pendant que la distribution globale se déplace fortement. La surveillance de référence aide les équipes à repérer volumes, motifs de valeurs ou usages inhabituels avant qu'un consommateur ne signale une défaillance.
La surveillance Timeliness mesure l'écart entre disponibilité attendue et disponibilité réelle de l'information. Le guide des métriques de qualité cadre la ponctualité autour de l'accessibilité et de la disponibilité. Le retard devient ainsi un contrôle mesurable au lieu d'une plainte subjective.
Le suivi de schéma protège le contrat structurel du produit. Colonnes ajoutées ou supprimées, champs renommés et types modifiés peuvent casser transformations, tableaux de bord, pipelines de features et applications en aval, même quand la livraison se poursuit.
Un motif d'exploitation utile combine validation pour les règles connues, détection d'anomalies pour les comportements inhabituels, contrôles de ponctualité pour le risque de livraison et suivi de schéma pour le changement structurel. Il doit consigner les livraisons manquantes, tardives et étonnamment précoces, puis établir une fenêtre de livraison attendue à partir du comportement observé, comme le décrit le cadre qualité d'entreprise.
Transformer les signaux en action
Une alerte ne devient utile que lorsque quelqu'un peut agir dessus. Chaque événement a besoin d'un responsable nommé, d'une sévérité, des produits concernés, du contexte de dépendances, d'une voie d'escalade et d'un enregistrement de résolution. Si un changement de schéma menace un consommateur, l'équipe devrait identifier rapports, modèles et applications exposés avant que le changement n'atteigne la production.
Des plateformes comme digna mettent en œuvre ce motif en réunissant détection d'anomalies, validation, Timeliness et suivi de schéma dans une seule couche d'observabilité. Cette organisation donne aux ingénieurs, analystes et parties prenantes une vue partagée des incidents, des tendances et de l'état à travers qualité des données, surveillance métier et observabilité de plateforme.
La boucle d'exploitation est simple. La gouvernance définit le comportement acceptable, l'observabilité détecte les écarts, et la propriété du workflow transforme ces écarts en remédiation maîtrisée. Cette discipline fait de jeux de données réutilisables des systèmes fiables pour l'analytique et l'IA.
Applications concrètes et prochaines étapes pour vos produits de données
Dans les services financiers, un produit de données de transactions ou de risque a besoin de validation, de suivi de livraison et de surveillance du changement structurel pour que les équipes de reporting ne découvrent pas les défaillances après une échéance de déclaration. En santé, les produits de données cliniques et opérationnels ont besoin de définitions claires, de contrôles de ponctualité et de preuves de qualité traçables. Les équipes télécom peuvent surveiller des données client et réseau à fort volume pour détecter déplacements inhabituels, livraisons manquantes et changements de schéma. Les équipes du secteur public peuvent appliquer la même discipline aux jeux de données exigeant cohérence, auditabilité et accès fiable.
La différence entre l'avant et l'après est opérationnelle. Avant la discipline produit, un analyste remarque un chiffre étrange, fouille dans les messages, trouve plusieurs responsables possibles et reconstruit un rapport à partir d'un tableur familier. Après, le produit dispose d'un contrat documenté, de contrôles automatisés, d'un responsable visible, d'une voie d'incident et d'un processus de réponse connu.
Une évaluation pratique peut commencer par ces questions :
Consommateur : Qui utilise ce produit, et quelle décision soutient-il ?
Contrat : Que peuvent supposer les consommateurs sur le schéma, les définitions, l'accès et la livraison ?
Propriété : Quelle personne ou équipe peut approuver les changements et résoudre les incidents ?
Contrôles : Les vérifications de validation, d'anomalie, de ponctualité et de schéma couvrent-elles les modes de défaillance importants ?
Cycle de vie : Quelle preuve déclencherait amélioration, remplacement ou retrait ?
Utilisez le modèle d'exploitation de l'équipe qualité des données pour clarifier comment les responsabilités produit, ingénierie, analytique et gouvernance doivent s'articuler. Priorisez le produit dont la défaillance créerait le plus grand risque de décision, puis rendez ses promesses observables avant d'élargir le portefeuille.
digna aide les équipes data à surveiller les anomalies, valider les règles métier, suivre Timeliness, détecter les changements de schéma et examiner les signaux métier et plateforme dans leur propre environnement. Rendez-vous sur digna pour voir comment une approche d'observabilité en base peut soutenir des produits de données fiables pour l'analytique et l'IA.
Le contrat publié par un produit de données ne vaut que les contrôles qui le soutiennent : c'est là que se fait le pont entre la pensée produit et la gestion de la qualité des données.
Questions fréquentes
Qu'est-ce qui fait d'un jeu de données un produit de données ?
Réussir quatre tests : la découvrabilité via un catalogue ou un portail plutôt que par relations personnelles, l'adressabilité via un endpoint ou une vue documentés, la fiabilité via des attentes de qualité publiées et surveillées, et l'auto-description via des métadonnées couvrant propriété, lineage et usage autorisé.
Qui possède quoi dans une équipe produit de données ?
Le data product manager possède la vision, la priorisation et la feuille de route ; l'ingénieur de données possède l'ingestion, la fiabilité des transformations et le comportement d'exécution ; gouvernance et plateforme fournissent les garde-fous. Le goulot d'étranglement est un produit qui a un nom mais personne d'habilité à financer sa maintenance ou à le retirer.
Pourquoi appliquer maintenant la pensée produit aux données ?
Parce que publier ne suffit plus face à la prolifération des plateformes. Les organisations déclarent accumuler 10 à 15 plateformes ou plus, ce qui fragmente l'effort, et la discussion Thoughtworks de 2025 déplace la question de la publication du jeu de données vers son usage sûr et répétable par les personnes et les systèmes.
Quels KPI prouvent la fiabilité ?
Le respect du SLA de fraîcheur, la couverture de propriété, la couverture des contrats de données et la détection d'impact avant déploiement pour la fiabilité, plus le taux de réutilisation, la croissance des consommateurs actifs, le temps de découverte et les incidents résolus dans le SLA pour l'adoption et le support.
Pourquoi les produits de données se dégradent-ils après le lancement ?
Parce que les attentes bougent pendant que le produit reste figé. Seuls 41 % des professionnels produit maintiennent leurs feuilles de route alignées sur les attentes des parties prenantes, ce qui fait de la discipline de roadmap un élément de fiabilité et non une charge administrative.



