7 exemples de catalogues de données pour une meilleure gouvernance
|
7
minute de lecture

Un catalogue n’est utile que si les utilisateurs lui font confiance. Le conseil répandu consiste à traiter un exemple de catalogue de données comme un inventaire consultable, mais cela passe à côté du critère qui compte vraiment. Le catalogue le plus solide dépend des métadonnées qu’il capture, de la manière dont la responsabilité et le lignage sont appliqués, de l’organisation des actifs et de la capacité de chaque fiche à porter suffisamment de signaux de fiabilité pour que les équipes puissent agir en toute confiance. C’est pourquoi les meilleurs exemples diffèrent selon le modèle opérationnel : des plateformes axées sur la gouvernance aux systèmes de métadonnées actives, de la flexibilité de l’open source à l’observabilité respectueuse de la confidentialité au sein de votre propre environnement.
Cet angle d’analyse est important, car les catalogues modernes ont évolué de simples listes de schémas vers de véritables systèmes de gouvernance. Les premiers catalogues trouvent leurs racines dans les dictionnaires de données et les référentiels de métadonnées manuels, tandis que les plateformes plus récentes prennent en charge le lignage, les workflows de revue et la confiance sur de vastes patrimoines de données, comme le résument l’histoire de l’évolution des catalogues et les tendances d’adoption dans la gouvernance des données d’entreprise : l’histoire du catalogue de données par DataGalaxy et la synthèse 2026 de StatPit sur l’adoption. Pour les équipes qui recherchent un exemple de catalogue de données, la question clé n’est pas de savoir si un outil peut lister des tables. Il s’agit de savoir si le catalogue aide les utilisateurs à découvrir, valider, classer et utiliser les données avec moins de friction.
C’est là que l’observabilité à la manière de digna trouve sa place dans la comparaison, car digna combine une découverte de type catalogue avec la détection d’anomalies, la ponctualité, la validation et le suivi des schémas au sein de l’environnement du client. Les sept modèles ci-dessous montrent comment fonctionnent différentes conceptions de catalogue, dans quels contextes elles s’appliquent et quels compromis les équipes doivent anticiper.
Table des matières
1. digna
digna correspond au modèle d’exemple de catalogue de données axé sur la confidentialité, car il traite les métadonnées comme un élément de la fiabilité opérationnelle, et pas seulement de la découverte. La plateforme s’exécute dans votre propre cloud, VPC ou centre de données : les données de production restent dans votre environnement et les contrôles s’exécutent dans la base de données, ce qui réduit les déplacements de données et respecte les contrôles de sécurité. C’est donc une option pratique pour les équipes qui ont besoin à la fois de visibilité de type catalogue et de preuves d’observabilité fiables dans des contextes réglementés.

Le contexte de fiabilité compte davantage qu’un inventaire statique
La force de digna tient au regroupement de la détection d’anomalies, du suivi de la ponctualité, de la validation au niveau des enregistrements et de la surveillance des changements de schéma dans une seule interface. AWS distingue la gestion des métadonnées, le catalogue et la gouvernance : le catalogue soutient la découverte, tandis que la gouvernance définit la politique d’utilisation recommandations d’AWS sur la gestion des métadonnées. digna se situe plus près de la réalité opérationnelle, là où les équipes doivent voir si les données sont arrivées à temps, si un schéma a changé ou si une règle métier a échoué avant qu’un tableau de bord ou un modèle ne soit compromis.
La plateforme convient aux équipes de la finance, de la santé, des télécommunications et du secteur public qui ont besoin de traçabilité et de preuves prêtes pour la conformité. Elle intègre également dès le départ un planificateur, un catalogue, des intégrations et des fonctions de collaboration, de sorte que la fiche du catalogue et le workflow de surveillance restent liés au lieu de se disperser dans des outils distincts. Pour les équipes qui comparent des modèles de catalogue, cette combinaison est importante, car elle relie la gouvernance aux contrôles de fiabilité quotidiens au lieu de laisser les signaux de qualité dans un autre système. Son approche de l’observabilité des données illustre clairement ce modèle.
Règle pratique : si votre équipe passe plus de temps à expliquer pourquoi les données sont erronées qu’à les trouver, des métadonnées liées à l’observabilité seront généralement plus efficaces qu’un simple inventaire.
digna aide aussi des groupes aux profils techniques variés à travailler sur le même système, qu’il s’agisse d’ingénieurs, d’analystes, de responsables de la gouvernance ou d’utilisateurs métier. La contrepartie est la responsabilité du déploiement, puisque l’organisation doit gérer elle-même l’environnement. Pour les équipes capables de soutenir ce modèle, le résultat est un catalogue construit autour de la confiance et des preuves opérationnelles.
Site web : digna.ai
2. Alation Data Catalog
Un catalogue centré sur la recherche ne fonctionne que si les utilisateurs font confiance aux résultats qu’elle renvoie. Alation est l’exemple le plus clair de ce modèle. Il s’adresse aux grandes entreprises qui ont besoin de découverte, de lignage et d’une large couverture de connecteurs, mais le vrai critère est de savoir si les utilisateurs métier peuvent partir d’une question et aboutir malgré tout à un contenu gouverné.
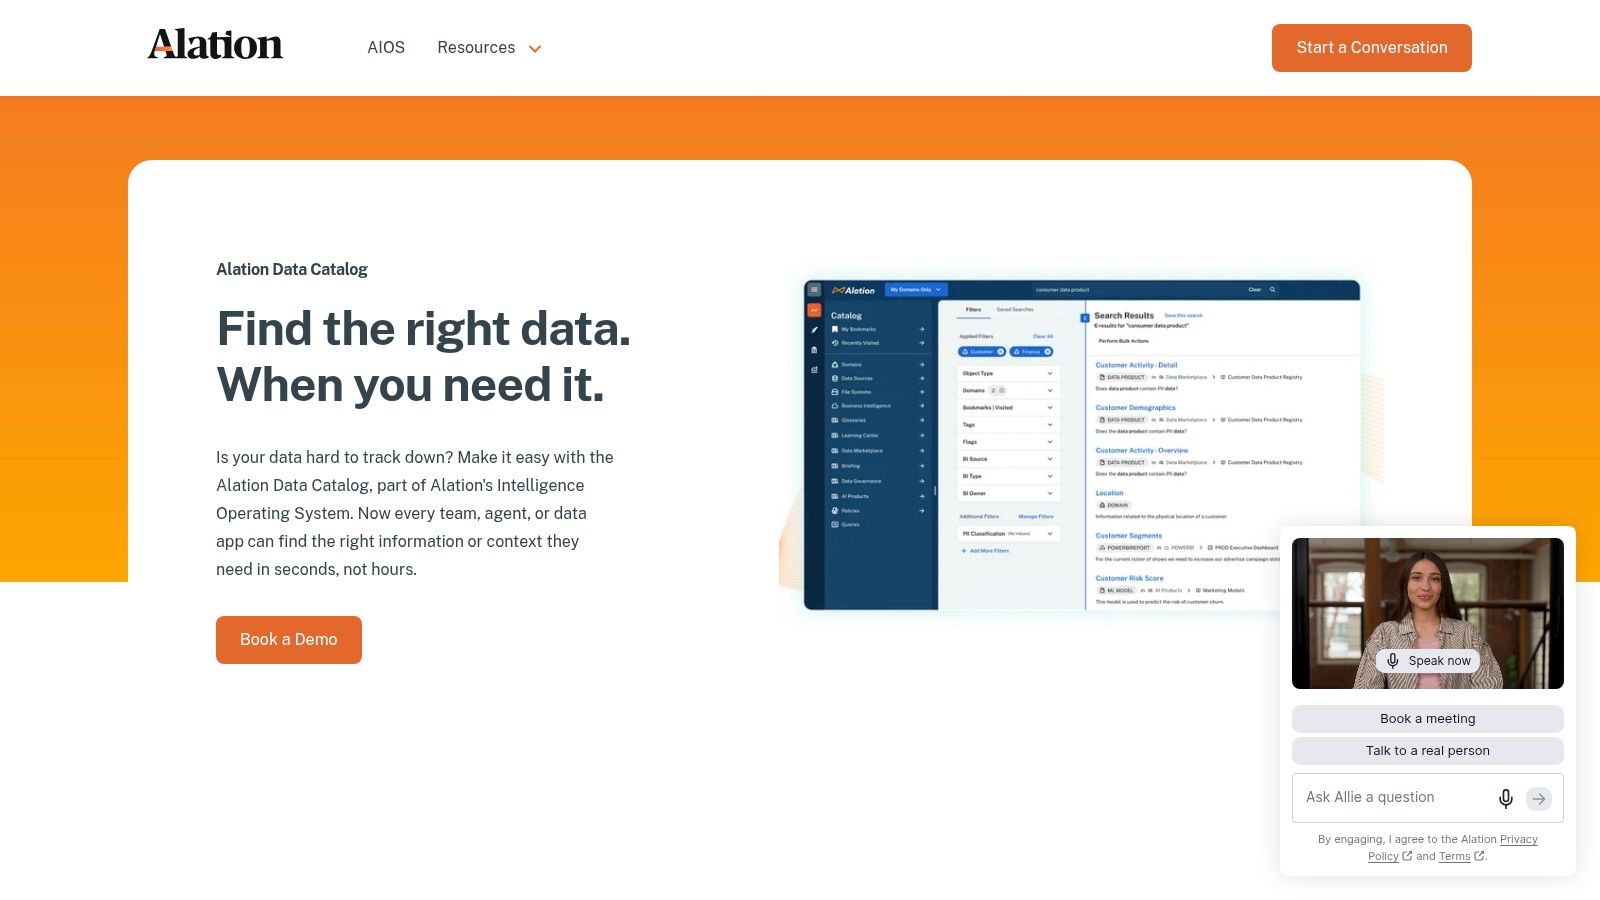
Une recherche performante dépend de la rigueur de l’intendance des données
La valeur ne se limite pas à l’indexation. Les termes du glossaire, le contexte des politiques, le lignage et les signaux d’usage doivent être suffisamment bien tenus pour que les résultats de recherche ne deviennent pas un amas d’actifs attrayants mais peu fiables. La page produit d’Alation met en avant la recherche en langage naturel, le lignage de bout en bout, plus de 120 connecteurs prêts à l’emploi et un framework de connecteurs ouvert. Cette combinaison est pertinente lorsque l’intendance des données est fédérée entre de nombreux systèmes et que la responsabilité du glossaire est explicite.
Cette condition est essentielle. Si une organisation dispose de nombreuses sources mais d’aucune règle de certification, une recherche classée par popularité peut faire remonter du contenu plus vite sans améliorer la confiance. Dans ce cas, la découverte devance la gouvernance et les utilisateurs doivent toujours procéder à une validation manuelle.
Ce modèle fonctionne mieux lorsque l’adoption constitue le goulot d’étranglement et que la discipline en matière de métadonnées existe déjà. Les utilisateurs métier bénéficient d’une expérience de recherche familière, tandis que les équipes data conservent une structure gouvernée sur un patrimoine fragmenté. La contrepartie est l’effort opérationnel. Une large couverture implique généralement davantage de travail d’accompagnement, surtout lorsque la responsabilité des actifs et les définitions métier restent incohérentes.
Comme exemple de catalogue de données, Alation montre comment une découverte gouvernée peut sembler naturelle sans devenir superficielle. Le catalogue est le plus performant lorsque recherche, intendance et certification sont déjà reliées. Il l’est moins lorsque l’organisation doit encore définir qui est responsable des actifs, lesquels sont fiables et comment les termes doivent être utilisés. À lire aussi : comment digna définit concrètement un catalogue de données
Site web : Alation Data Catalog
3. Collibra Data Catalog
Collibra correspond au modèle de gouvernance d’entreprise. Il est conçu pour les organisations qui ont besoin que la découverte, le lignage, la classification des données sensibles et les workflows pilotés par des politiques fonctionnent au sein d’un modèle plus large d’intelligence des données. C’est important lorsque les services juridique, risques et conformité ainsi que le data office doivent tous examiner la même fiche d’actif.
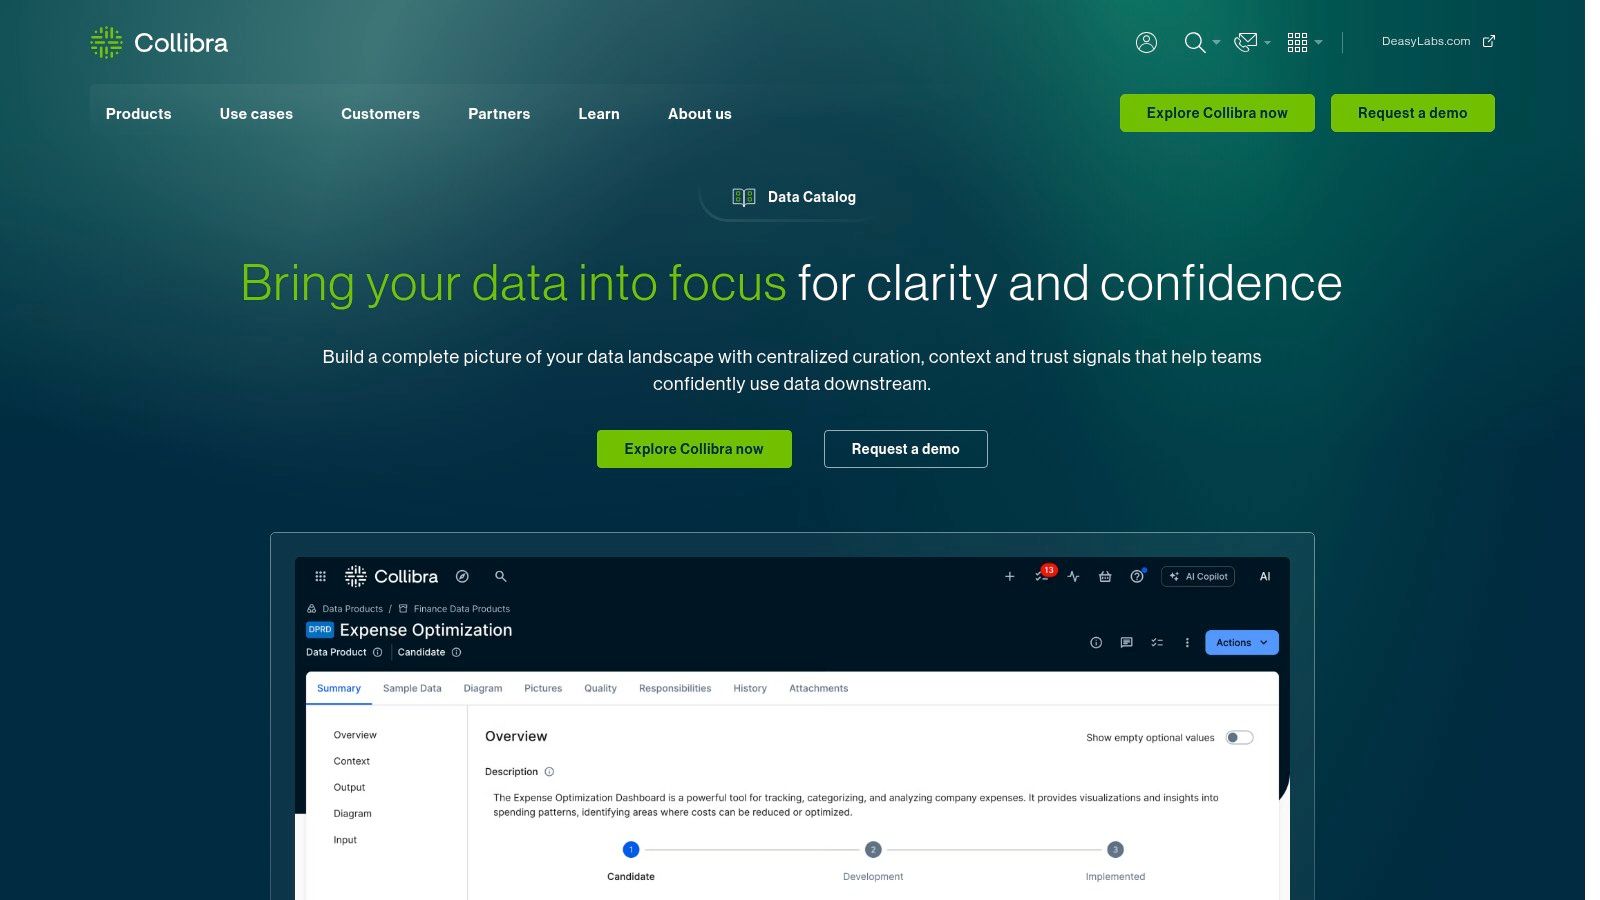
La profondeur de gouvernance est payante dans les modèles opérationnels complexes
L’avantage pratique, c’est le contrôle. La page produit de Collibra met en avant un inventaire centralisé, plus de 100 intégrations natives, une curation automatisée, l’étiquetage des données sensibles, un lignage interactif et un workflow d’accès de type marketplace. Cette combinaison fonctionne lorsque le catalogue doit montrer ce qu’est un actif, qui l’a approuvé, quelle politique s’applique et comment l’accès est gouverné.
Ce modèle est pertinent lorsque les services juridique, risques et conformité doivent approuver conjointement les actifs, et lorsque l’étiquetage des données sensibles est obligatoire. Il convient aussi aux organisations dotées de plusieurs niveaux d’intendance et de circuits de revue formels. Il l’est moins lorsque l’organisation compte moins de 3 niveaux d’intendance et a besoin d’une découverte légère. Dans ce contexte, la charge opérationnelle peut dépasser la valeur du contrôle supplémentaire.
Collibra convient également aux équipes qui transforment leurs produits de données en ressources réutilisables et gouvernées. L’accès de type marketplace et le contexte du glossaire aident à packager des données fiables, mais seulement si les responsabilités de propriété et de revue sont déjà claires. La contrepartie est évidente. Plus le modèle de contrôle est riche, plus les équipes ont besoin de rigueur en matière de rôles, d’administration et de gestion des exceptions.
Un catalogue axé sur la gouvernance doit faire apparaître la politique au moment de la découverte, afin que les utilisateurs voient la règle avant de demander l’accès à l’actif.
La manière dont digna définit une stratégie de gouvernance des données offre ici un point de référence utile. Collibra rend cette stratégie opérationnelle via la couche catalogue. Pour les organisations qui ont besoin de traçabilité, de gestion des données sensibles et de responsabilité partagée, c’est là toute la valeur de ce modèle.
Site web : Collibra Data Catalog
4. Atlan Active Metadata Catalog
Atlan correspond au modèle des métadonnées actives. Le catalogue est conçu pour les équipes qui veulent que les métadonnées évoluent au rythme des données, afin que la fraîcheur, le lignage, la certification et le contexte du domaine restent visibles dans le workflow. Il est donc utile pour les équipes analytiques et les programmes de data mesh, où la responsabilité change rapidement et où la maintenance manuelle prend du retard.
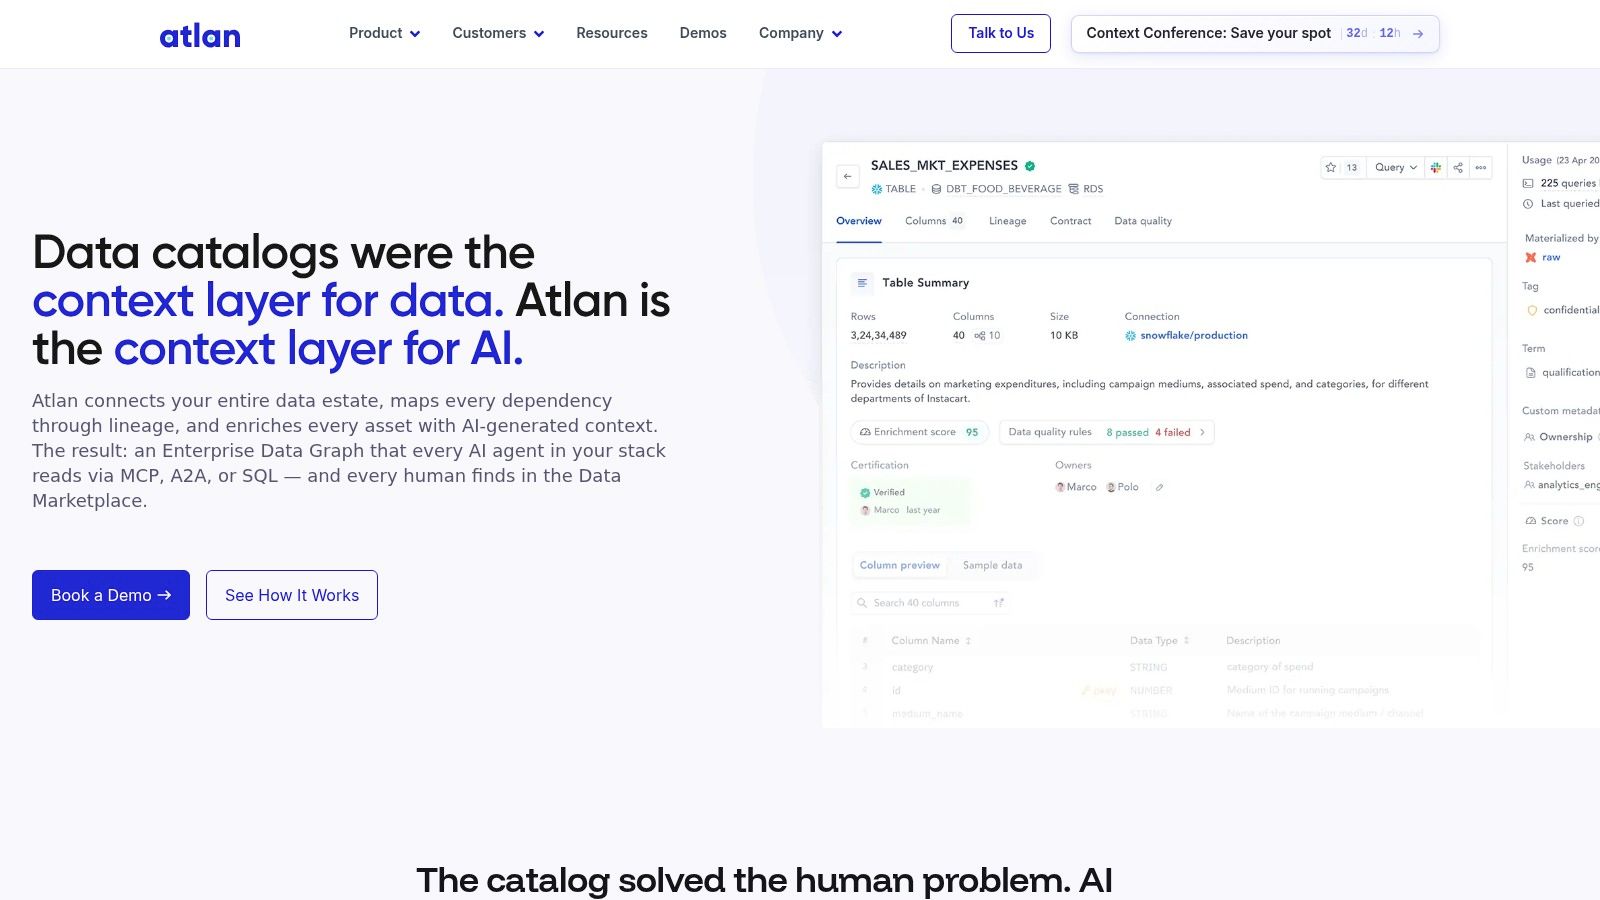
Les métadonnées actives fonctionnent lorsque le modèle opérationnel est déjà explicite
La page du catalogue de découverte de données d’Atlan met en avant la recherche en langage naturel, le lignage automatisé, les automatisations de métadonnées actives et la documentation assistée par l’IA. Ces fonctionnalités comptent surtout lorsque le catalogue doit refléter le contexte opérationnel en temps réel, et non une documentation ponctuelle. Si la responsabilité, la fraîcheur et la certification changent souvent, un catalogue statique devient rapidement obsolète.
Ce modèle fonctionne lorsque les frontières entre domaines sont définies, que les contrats de responsabilité existent dans le code et que les pipelines de métadonnées sont pilotés par les événements. Dans ce contexte, le catalogue peut mettre à jour le contexte au fil des changements et maintenir une intendance distribuée. Sans ces conditions, l’automatisation peut amplifier la confusion aussi facilement que la documentation.
Quand cela fonctionne : les équipes de domaine sont déjà responsables de leurs produits de données, les événements de métadonnées sont fiables et le catalogue peut publier des mises à jour sans intervention manuelle. Quand cela échoue : les frontières sont floues, la responsabilité est consignée dans des tableurs et des signaux obsolètes écrasent le contexte local.
Une note d’analyste de digna sur la découverte de données s’applique ici. La découverte ne devient exploitable que lorsque le catalogue reflète la manière dont les équipes travaillent déjà. Atlan excelle lorsque la rapidité de collaboration compte et que l’organisation souhaite une interface moderne qui encourage la participation, mais la contrepartie est claire : il exige une conception rigoureuse des domaines avant que l’automatisation puisse aider.
Site web : Atlan Data Discovery Catalog
5. Microsoft Purview Unified Catalog
Microsoft Purview correspond au modèle d’intendance cloud native, mais seulement dans les bonnes conditions opérationnelles. Il est le plus pertinent lorsqu’un patrimoine fortement ancré dans l’écosystème Microsoft couvre déjà Azure, Fabric et OneLake, et que l’équipe a besoin d’étendre la gouvernance par étapes plutôt que par une refonte complète de la plateforme. Dans cette configuration, le catalogue suit la plateforme que l’organisation exploite déjà.
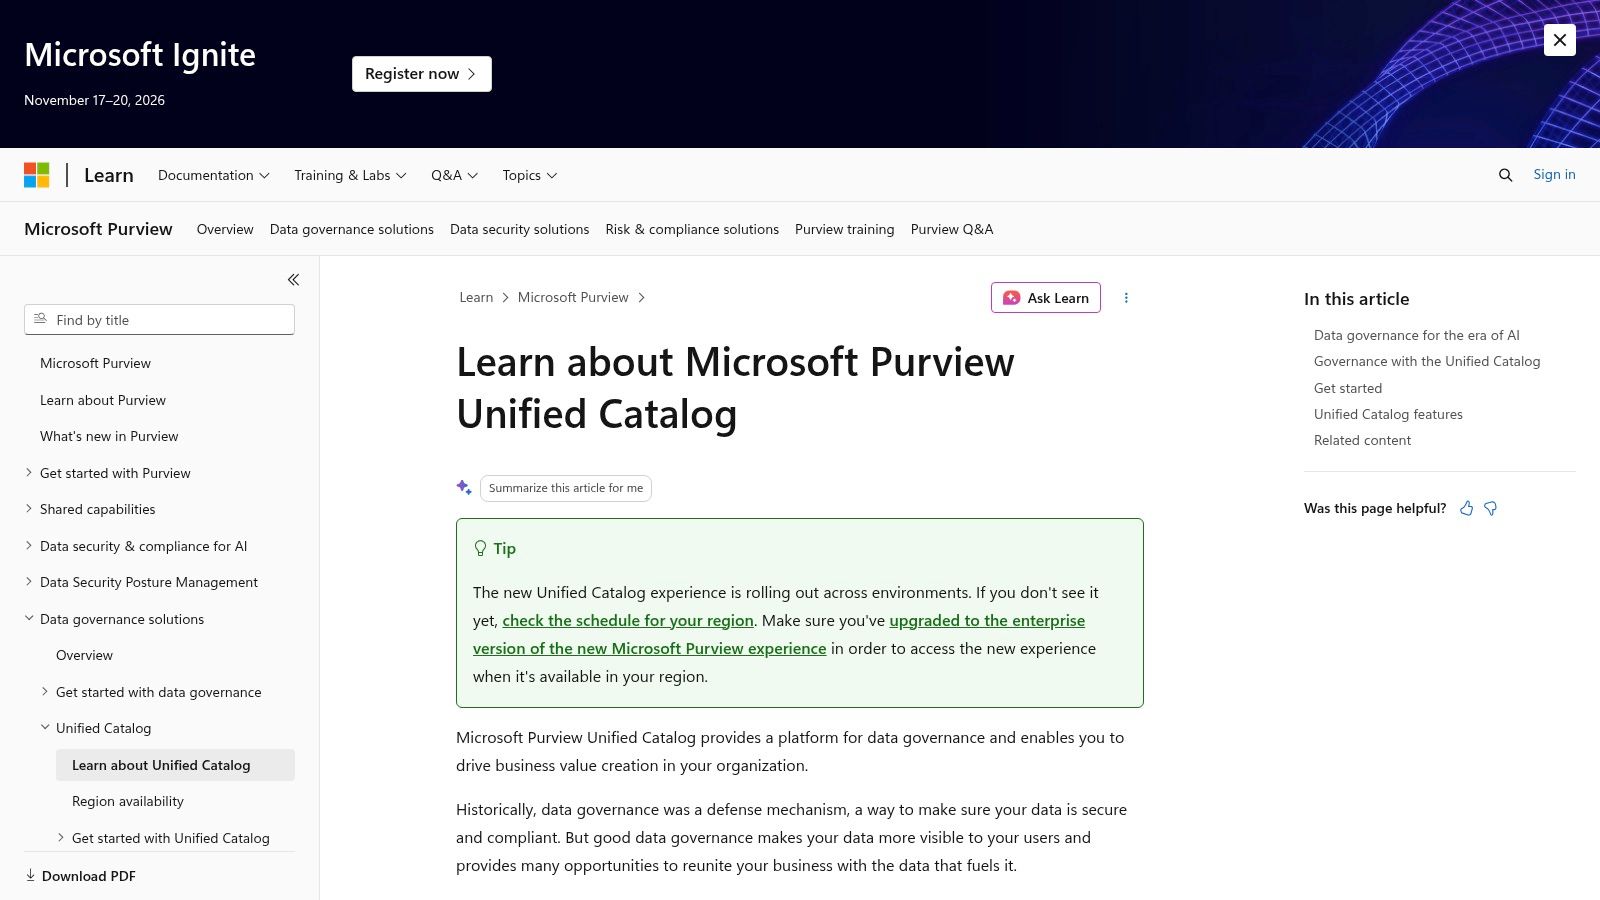
La gouvernance à l’usage convient aux déploiements progressifs
La documentation de l’Unified Catalog de Purview présente un modèle fondé sur l’analyse multicloud, des cartes de données centralisées, le lignage, les classifications et un traitement de la gouvernance facturé en DGPU. La valeur pratique ne réside pas dans une théorie générale du catalogue. Elle réside dans la possibilité de commencer avec un périmètre limité, de valider les connecteurs et d’étendre la gouvernance là où l’usage justifie la dépense.
Choisissez ce modèle lorsque vous avez besoin d’une gouvernance à la consommation et d’une intégration avec Fabric sans refonte de la plateforme. Prévoyez 2 à 3 sprints pour valider les connecteurs vers les sources non Microsoft, car la couverture varie selon le connecteur, ce qui influe sur l’adoption. Le modèle est pertinent lorsqu’environ 70 % ou plus des actifs se trouvent dans Azure, Fabric ou OneLake, et moins lorsque le patrimoine est multicloud avec une faible présence Microsoft.
La contrepartie est donc claire. Les équipes centrées sur Microsoft bénéficient d’une meilleure adéquation, de moins de friction d’intégration et d’une couche de gouvernance proche de la pile de sécurité qu’elles utilisent déjà. Les équipes aux sources hétérogènes peuvent toujours utiliser Purview, mais la variabilité des connecteurs peut laisser des actifs importants en dehors de la couverture la plus fiable du catalogue.
Comme exemple de catalogue de données dans un patrimoine fortement Microsoft, il s’agit d’un modèle réutilisable plutôt que d’un catalogue générique. Il fonctionne le mieux lorsque la maturité de la gouvernance peut progresser par phases et que l’organisation souhaite que le catalogue suive son modèle opérationnel Microsoft.
Site web : documentation de Microsoft Purview
À lire aussi : digna sur la gestion des métadonnées
6. DataHub Open Source et DataHub Cloud
DataHub incarne le modèle de flexibilité pilotée par l’ingénierie. Il convient aux équipes qui veulent le lignage, la recherche, des workflows de gouvernance et des signaux d’observabilité sans s’enfermer dans une pile de catalogue propriétaire. L’édition open source donne le contrôle aux équipes techniques. DataHub Cloud conserve le même modèle tout en allégeant une grande partie de la charge d’infrastructure.
Contrôle technique ou charge opérationnelle : ce que coûte réellement le contrat open source
La force de DataHub n’est pas l’étendue générique de son catalogue. C’est la capacité à façonner les métadonnées comme partie intégrante de la plateforme, et non simplement à les consommer via un outil frontal. Ce modèle est donc pertinent pour les équipes qui exploitent déjà des plateformes internes, des connecteurs personnalisés et des pipelines de métadonnées qu’elles peuvent maintenir au fil de l’évolution de la pile.
DataHub Cloud réduit la charge opérationnelle, mais la contrepartie ne disparaît pas. Le contrôle offert par l’open source exige toujours la gestion des mises à niveau, l’entretien des connecteurs et une personne capable de maintenir l’ingestion en bon état lorsque les systèmes en amont changent. Il convient lorsqu’une équipe plateforme peut assumer ce travail, et devient plus difficile à justifier lorsque l’organisation ne dispose pas de capacités dédiées en SRE ou en exploitation du catalogue.
Critère d’adéquation | Pertinent si | Moins pertinent si |
|---|---|---|
Modèle opérationnel | l’ingénierie est responsable des workflows de métadonnées | le catalogue doit fonctionner avec peu de support opérationnel |
Choix de déploiement | les extensions personnalisées et l’auto-hébergement comptent | l’équipe souhaite une responsabilité d’infrastructure minimale |
Priorité à la fiabilité | les pipelines d’ingestion sont surveillés et maintenus | les mises à niveau et les connecteurs sont laissés à des efforts ponctuels |
Pour les acheteurs qui comparent un exemple de catalogue de données selon les modes de déploiement, DataHub est le cas le plus clair de contrôle auto-hébergé assorti d’une option managée. Il fonctionne le mieux lorsque l’infrastructure de métadonnées est traitée comme un logiciel, avec une responsabilité définie, une discipline de release et une redevabilité opérationnelle claire.
Site web : DataHub
7. Informatica Cloud Data Governance and Catalog
Pour les patrimoines hybrides où l’étendue des scanners détermine l’exhaustivité du catalogue, Informatica privilégie la couverture plutôt qu’une expérience de découverte plus légère. Il convient aux organisations qui s’appuient déjà sur les outils Informatica et ont besoin que le catalogage soit relié aux travaux d’intégration, de qualité et de gouvernance.
L’étendue de la couverture compte lorsque le patrimoine de données est désordonné
La page produit du catalogue met en avant l’analyse automatisée, le profilage, le lignage, le glossaire, la gestion des politiques ainsi que des services connexes de qualité et d’intégration des données. Ce profil est pertinent lorsque des systèmes cloud et sur site doivent tous deux être couverts, et que les artefacts de gouvernance doivent rester alignés sur les métadonnées techniques. La valeur réside dans une couverture complète des métadonnées plutôt que dans une découverte légère.
Ce modèle convient aux entreprises qui ont besoin d’une large prise en charge des scanners et d’un couplage étroit avec une pile de gestion des données existante. La contrepartie est le poids opérationnel. Le périmètre, l’administration et l’accompagnement peuvent devenir considérables, surtout lorsque les équipes techniques et les utilisateurs de la gouvernance dépendent du même catalogue. L’adoption tend à être plus forte lorsque le travail de catalogage s’inscrit dans un modèle opérationnel plus large, et non comme un outil de recherche autonome.
Choisissez Informatica lorsque le patrimoine exige une large couverture des scanners et des services de qualité ou d’intégration liés à IDMC. Choisissez Collibra lorsque la gouvernance de type marketplace et les workflows destinés aux utilisateurs métier comptent davantage que la profondeur d’analyse. Pour les lecteurs qui comparent un exemple de catalogue de données offrant la plus grande étendue de plateforme, Informatica est le choix le plus évident pour les organisations qui veulent que le catalogage fasse partie d’un programme de gestion des données plus large.
Site web : Informatica Cloud Data Governance and Catalog
Comparatif des 7 meilleurs catalogues de données
Produit | Complexité de mise en œuvre (🔄) | Ressources et exploitation (⚡) | Résultats attendus (⭐📊) | Cas d’usage idéaux | Principaux avantages (💡) |
|---|---|---|---|---|---|
digna | Moyenne (🔄🔄), installation dans l’environnement et configuration des modules | Modérées à élevées ⚡, infrastructure gérée par le client ; le calcul dans la base de données réduit les déplacements de données | Élevés ⭐⭐⭐⭐, observabilité de niveau entreprise, délai de rentabilisation rapide (premiers enseignements en <2 h) | Entreprises réglementées ayant besoin de contrôles sur place, axés sur la confidentialité | Exécution dans l’environnement, contrôles dans la base de données, licences modulaires, anomalies par IA + validation déterministe |
Alation Data Catalog | Moyenne à élevée (🔄🔄🔄), travail de gouvernance et d’adoption | Modérées ⚡, connecteurs + accompagnement pour les patrimoines étendus | Élevés ⭐⭐⭐⭐, découverte performante, adoption de la recherche et de la gouvernance | Grandes entreprises recherchant une découverte et une recherche de données gouvernées | Recherche en langage naturel, lignage, plus de 120 connecteurs, workflows de gouvernance |
Collibra Data Catalog | Élevée (🔄🔄🔄), définition des rôles et du modèle à l’échelle de l’organisation requise | Élevées ⚡, effort important d’accompagnement et de modèle opérationnel | Élevés ⭐⭐⭐⭐, gouvernance complète, contrôles des données sensibles | Organisations complexes avec des besoins de conformité et de produits de données | Gouvernance centralisée, étiquetage des données sensibles, AI Copilot, marketplace/workflows |
Atlan, Active Metadata Catalog | Moyenne (🔄🔄), expérience plus rapide mais conception des domaines nécessaire | Modérées ⚡, l’interface moderne réduit les frictions ; une certaine configuration des domaines | Bons ⭐⭐⭐, adoption plus rapide et gestion collaborative des métadonnées | Équipes data mesh/de domaine, équipes analytiques axées sur la collaboration | Automatisations des métadonnées actives, documentation assistée par l’IA, workflows de domaine/produit |
Microsoft Purview, Unified Catalog | Faible à moyenne (🔄🔄), cloud native, déploiement progressif | Modérées ⚡, facturation à la consommation (DGPU) ; variabilité des connecteurs | Bons ⭐⭐⭐, catalogue unifié pour les écosystèmes Microsoft | Organisations centrées sur Microsoft/Azure/Fabric | Analyse multicloud, intégration Fabric/OneLake, tarification transparente à l’usage |
DataHub (open source) / DataHub Cloud | Moyenne (🔄🔄), l’OSS exige de l’ingénierie ; Cloud simplifie l’exploitation | Variables ⚡, élevées en auto-hébergement ; DataHub Cloud allège la charge opérationnelle | Bons ⭐⭐⭐, métadonnées adaptées aux développeurs, lignage/recherche performants | Équipes souhaitant la flexibilité de l’OSS ou une option SaaS managée | Communauté open source, déploiement flexible, tarif d’entrée transparent (Cloud) |
Informatica, Cloud Data Governance & Catalog (IDMC) | Élevée (🔄🔄🔄), déploiement et gouvernance à l’échelle de l’entreprise | Élevées ⚡, scanners étendus et administration continue | Élevés ⭐⭐⭐⭐, analyse approfondie, profilage et intégrations d’entreprise | Très grands patrimoines hybrides nécessitant une couverture étendue des sources | Étendue des scanners d’entreprise, lignage détaillé, intégration à l’écosystème IDMC |
Choisir le modèle que votre organisation peut soutenir
Le bon catalogue dépend moins du nombre de fonctionnalités que de la capacité de votre modèle opérationnel à soutenir les pratiques qu’exige l’outil. Si vous avez besoin de gouvernance d’entreprise et de preuves de conformité, Collibra ou Informatica sont pertinents. Si l’adoption repose sur une recherche rapide et intuitive, Alation est le choix le plus adapté. Si vos équipes travaillent par domaines et produits, Atlan offre un cadre concret aux métadonnées actives. Si votre patrimoine est centré sur Microsoft, Purview s’intègre naturellement. Si l’ingénierie veut du contrôle et de la flexibilité, DataHub est la voie ouverte. Si la fiabilité, la confidentialité et l’exécution dans votre environnement priment, digna est le modèle le plus ancré dans l’opérationnel.
Une manière utile de les comparer consiste à se poser six questions. Les utilisateurs trouvent-ils rapidement l’actif ? Voient-ils un lignage fiable ? Le glossaire ou la taxonomie maintient-il la cohérence des termes ? Des signaux d’observabilité ou de fraîcheur les avertissent-ils avant qu’ils n’utilisent des données obsolètes ? Le modèle de déploiement correspond-il à votre posture de sécurité ? Et votre équipe peut-elle assumer la charge opérationnelle liée à la conception choisie ?
Découverte : Alation et Atlan sont en tête pour la découverte par la recherche, tandis que Collibra, Purview, DataHub, Informatica et digna associent la découverte à différents niveaux de gouvernance ou de fiabilité.
Lignage : Collibra, Purview, DataHub, Informatica et Alation mettent l’accent sur la visibilité du lignage, tandis que digna relie les contrôles de fiabilité aux signaux de schéma et de ponctualité.
Prise en charge de la taxonomie ou du glossaire : Collibra, Alation, DataHub et Informatica offrent le contexte de glossaire et de politiques le plus riche, Atlan et Purview privilégiant le contexte opérationnel.
Contexte d’observabilité : digna est le choix le plus explicite, tandis que DataHub et Collibra apportent des signaux complémentaires dans la couche catalogue.
Modèle de déploiement : Purview et les fournisseurs cloud privilégient les approches managées ou cloud natives, DataHub propose l’auto-hébergement ou le cloud, et digna s’exécute dans l’infrastructure du client.
Charge opérationnelle : la flexibilité de l’open source comme la profondeur de la gouvernance d’entreprise exigent une prise en charge. La différence tient à l’endroit où repose la charge : dans l’ingénierie, dans l’administration, ou dans les deux.
La démarche pratique est simple. Définissez d’abord la fiche de métadonnées, choisissez ensuite les règles de responsabilité et de taxonomie, lancez en troisième lieu un pilote sur un jeu de données à forte valeur, associez ensuite des signaux de confiance comme le lignage, la fraîcheur ou la validation, puis mesurez si les utilisateurs trouvent l’actif et l’utilisent en toute confiance. Un catalogue gagne l’adhésion lorsqu’il aide les utilisateurs à décider plus vite, avec moins de débats sur la signification des données.
digna offre aux équipes une expérience de catalogue différente, dans laquelle découverte et observabilité restent liées au sein du même environnement. Si vous avez besoin d’une plateforme qui relie les métadonnées aux anomalies, à la ponctualité, à la validation et aux changements de schéma sans sortir les données de production de votre contrôle, rendez-vous sur digna et évaluez si ce modèle opérationnel correspond mieux à votre exemple de catalogue de données que ne pourrait jamais le faire un inventaire statique.
Si la fiche du catalogue doit porter des signaux de fraîcheur, de changement de schéma et de validation plutôt qu’un inventaire statique, découvrez comment digna gère l’observabilité des plateformes de données au sein de votre propre environnement.
Questions fréquentes
Qu’est-ce qu’un bon exemple de catalogue de données ?
Il n’existe pas d’exemple unique idéal ; l’article compare sept modèles. Alation illustre la découverte par la recherche, Collibra la gouvernance d’entreprise, Atlan les métadonnées actives, Microsoft Purview l’intendance cloud native, DataHub la flexibilité de l’open source, Informatica l’étendue des scanners, et digna un modèle axé sur la confidentialité qui relie les fiches du catalogue à des contrôles d’observabilité au sein de votre propre environnement.
Microsoft Purview est-il un bon catalogue de données pour un patrimoine multicloud hétérogène ?
Purview fonctionne le mieux lorsqu’environ 70 % ou plus des actifs se trouvent dans Azure, Fabric ou OneLake. Pour les sources non Microsoft, l’article conseille de prévoir 2 à 3 sprints pour valider les connecteurs, car la couverture varie selon le connecteur et des actifs importants peuvent échapper à la couverture la plus fiable du catalogue.
Quelle est la différence entre les catalogues de données Collibra et Informatica ?
Choisissez Informatica lorsque le patrimoine nécessite une large couverture des scanners et des liens avec les services de qualité ou d’intégration d’IDMC. Collibra est plus adapté lorsque la gouvernance de type marketplace, l’étiquetage des données sensibles et les workflows destinés aux utilisateurs métier comptent davantage que la profondeur d’analyse, même s’il est moins pertinent pour les organisations comptant moins de 3 niveaux d’intendance.
Quand un catalogue de métadonnées actives comme Atlan fonctionne-t-il ?
Les métadonnées actives fonctionnent lorsque les frontières entre domaines sont définies, que les contrats de responsabilité existent dans le code et que les pipelines de métadonnées sont pilotés par les événements. Elles échouent lorsque les frontières sont floues et que la responsabilité est consignée dans des tableurs, car l’automatisation amplifie alors la confusion aussi facilement que la documentation. La recherche en langage naturel et le lignage automatisé d’Atlan ne sont utiles qu’une fois ces bases posées.
Comment déployer un catalogue de données ?
Suivez une démarche en cinq étapes : définissez d’abord la fiche de métadonnées, fixez ensuite les règles de responsabilité et de taxonomie, puis lancez un pilote sur un jeu de données à forte valeur. Associez ensuite des signaux de confiance comme le lignage, la fraîcheur ou la validation, et mesurez enfin si les utilisateurs trouvent l’actif et l’utilisent en toute confiance avant d’étendre davantage le catalogue.



