Simulación de Montecarlo
|
10
minuto de lectura
Su previsión de ingresos superó la prueba de retroceso, el panel de control se mostró estable y el canal de datos se envió según lo programado. Luego, los datos de producción llegaron tarde, un campo ascendente presentó errores inesperados y varias transformaciones dependientes amplificaron la discrepancia. Para cuando el equipo de negocio preguntó por qué los ingresos reales habían divergido, las pruebas deterministas tenían poco que aportar porque habían probado entradas fijas, no la incertidumbre que rodea al canal de datos.
La Simulación Monte Carlo ofrece a los equipos de datos una forma práctica de modelar esa incertidumbre. En lugar de tratar cada entrada como un único valor, se representan las entradas inciertas como distribuciones, se ejecuta la lógica del canal de datos repetidamente y se inspecciona el rango de resultados resultante. El método ayuda a los equipos a razonar sobre los umbrales de calidad de los datos, la volatilidad de los KPI, la capacidad del canal de datos y el riesgo descendente sin pretender que la producción se comporte como un entorno de pruebas limpio.
Tabla de contenidos
Por qué los equipos de datos necesitan la simulación de Monte Carlo
Aplicaciones en el mundo real en calidad de datos y monitorización
Por qué los equipos de datos necesitan la simulación de Monte Carlo
Una plataforma de datos moderna rara vez produce una métrica a través de un único cálculo aislado. Una cifra de ingresos puede depender de la ingesta de eventos, la resolución de identidades, la conversión de moneda, los registros que llegan tarde, la deduplicación, las reglas de negocio y varias transformaciones de almacenamiento. Cada dependencia puede introducir incertidumbre y el efecto combinado puede ser no lineal.
Una estimación puntual oculta esa estructura. Si un equipo prueba una tasa de conversión con una sola entrada esperada, puede verificar si la fórmula funciona para esa entrada, pero no puede responder cómo cambia el resultado cuando fluctúan los recuentos de eventos, la atribución está incompleta o los datos de origen llegan fuera de su ventana esperada. Las pruebas deterministas validan una ruta. La simulación de Monte Carlo examina una distribución de rutas.
Esa distinción es importante para las decisiones operativas:
SLA de calidad de datos: Estimar con qué frecuencia los defectos de origen inciertos podrían empujar a una tabla descendente más allá de un umbral aceptable.
Monitorización empresarial: Separar la variación ordinaria de los KPI de los cambios que merecen investigación.
Planificación de capacidad: Explorar combinaciones de carga de trabajo en lugar de dimensionar la infraestructura frente a un único promedio.
Resiliencia del canal de datos: Identificar qué suposiciones ascendentes crean el rango más amplio de resultados descendentes.
Un equipo de datos puede emparejar el análisis probabilístico con prácticas establecidas de calidad de datos. Los controles deterministas siguen siendo importantes para el esquema, la nulidad, la integridad referencial y las reglas de negocio explícitas. Monte Carlo añade una capa diferente, una que se pregunta si una variación plausible en esas entradas podría crear un incidente operativo.
Regla práctica: Utilice Monte Carlo para cuantificar la incertidumbre en torno a una decisión, no para justificar una validación débil. Una simulación no puede reparar una transformación incorrecta o una dependencia de origen no observada.
El valor aparece cuando los equipos dejan de preguntarse únicamente: "¿Pasó esta ejecución?" y empiezan a preguntarse: "Dado lo que sabemos sobre este sistema, ¿qué probabilidad hay de que el resultado se mantenga dentro de los límites?" Esa pregunta se acerca mucho más a la naturaleza de las operaciones de datos empresariales.
Comprensión de la mecánica principal
Comience con un canal de datos como una función:
output = pipeline(input_1, input_2, input_3)
En las pruebas ordinarias, cada entrada recibe un valor fijo. En el trabajo de Monte Carlo, cada entrada incierta recibe una distribución de probabilidad. El canal de datos se ejecuta repetidamente con valores muestreados, produciendo una distribución de salida en lugar de una única respuesta.
Muestreo de entradas
El muestreo aleatorio es la operación atómica. Un generador de números aleatorios selecciona un valor plausible de cada distribución de entrada y el modelo procesa esa combinación como un estado posible del sistema.
La distribución debe reflejar el comportamiento de la entrada:
Las distribuciones normales pueden representar errores de medición cuando los valores se agrupan en torno a un promedio.
Las distribuciones de Poisson son útiles para el recuento de eventos, como las llegadas dentro de una ventana de observación definida.
Las distribuciones uniformes se ajustan a la incertidumbre acotada cuando no hay ninguna razón defendible para favorecer un valor sobre otro.
Las distribuciones empíricas suelen ser preferibles cuando las observaciones históricas muestran asimetría, multimodalidad o colas inusuales.
Los datos históricos pueden fundamentar la distribución, mientras que el conocimiento del dominio puede llenar los vacíos donde las observaciones son escasas. Lo importante es no seleccionar una distribución familiar por costumbre. La forma de la distribución de entrada influye directamente en la salida.
Para un ingeniero de datos, el proceso se asemeja a la generación de datos de prueba sintéticos a escala. Cada iteración crea un conjunto coherente de entradas inciertas, ejecuta la lógica de transformación y almacena o agrega el resultado. El resultado final se comporta como una vista materializada sobre muchas condiciones operativas plausibles.
Agregación de resultados
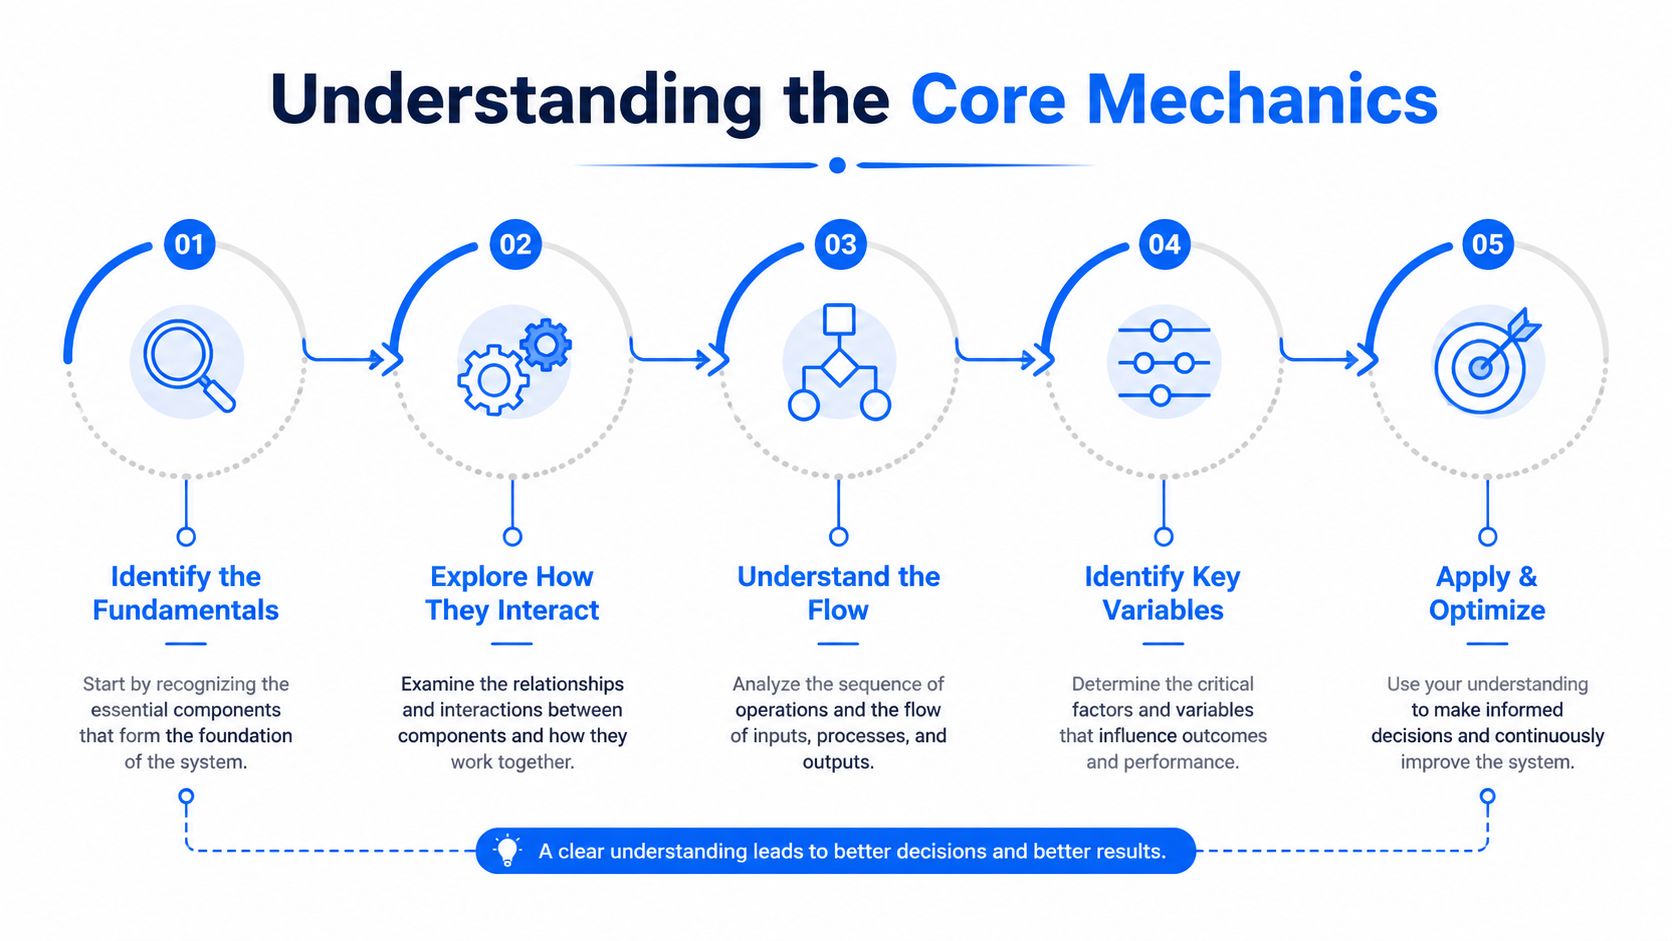
El bucle de simulación tiene tres etapas prácticas:
Definir distribuciones. Utilizar observaciones históricas, parámetros ajustados o suposiciones de dominio documentadas.
Muestrear y ejecutar. Extraer valores y ejecutar la misma lógica de modelo para cada iteración.
Agregar resultados. Calcular rangos, percentiles, intervalos de confianza y probabilidades de umbral.
La Ley de los Grandes Números explica por qué el muestreo repetido resulta útil. A medida que crece el número de muestras independientes, las estadísticas de resumen tienden a converger hacia la distribución subyacente. Esa convergencia no hace que el modelo sea verdadero, pero reduce la incertidumbre causada por el muestreo aleatorio.
El modelo sigue dependiendo de la calidad de sus entradas e implementación. Los equipos que busquen una explicación más profunda de cómo las distribuciones describen los valores observados pueden consultar esta guía sobre la distribución de datos.
Explicación de algoritmos y métodos de muestreo
El muestreo aleatorio simple debe ser la línea de base, no un valor predeterminado permanente. Funciona bien cuando las entradas son razonablemente independientes, la dimensionalidad es manejable y la pregunta comercial se refiere al comportamiento central más que a una cola delgada. Su principal ventaja es la simplicidad operativa, lo que facilita su prueba, explicación y reproducción.
El método se vuelve menos atractivo cuando la simulación debe cubrir poblaciones heterogéneas o resultados poco comunes. El diseño del muestreo debe responder a la pregunta, a la estructura de dependencia y al presupuesto de cómputo.
Elección de un método
Método | Ideal para | Complejidad | Coste de cómputo |
|---|---|---|---|
Muestreo aleatorio simple | Estimaciones de uso general con entradas sencillas | Bajo | Predecible |
Muestreo estratificado | Cobertura en todos los niveles de clientes, regiones o segmentos de calidad | Moderado | Moderado |
Muestreo hipercubo latino | Mejor cobertura del espacio de entrada en modelos multidimensionales | Moderado | A menudo menor para una precisión comparable |
Muestreo de importancia | Análisis de eventos raros y preguntas sobre riesgos de cola | Alto | Eficiente cuando la distribución propuesta está bien diseñada |
Monte Carlo por cadenas de Markov | Entradas con distribuciones conjuntas complejas | Alto | Potencialmente sustancial porque las cadenas requieren diagnósticos |
El muestreo estratificado divide la población en grupos significativos y toma muestras dentro de cada grupo. Esto evita que un segmento grande domine el resultado mientras que un segmento más pequeño pero operativamente importante recibe poca representación. Por ejemplo, un modelo de calidad de datos puede preservar la cobertura en todos los niveles de clientes o regiones geográficas en lugar de tratar todos los registros como intercambiables.
El muestreo hipercubo latino distribuye las muestras a lo largo de cada dimensión de entrada. Puede mejorar la cobertura cuando un canal de datos tiene muchas variables inciertas y cada ejecución es costosa. La sobrecarga está justificada cuando la dimensionalidad de la entrada hace que las extracciones aleatorias simples dejen gran parte del espacio sin explorar. No es necesario para un modelo pequeño donde cada ejecución es económica y la salida es estable.
El muestreo de importancia cambia el énfasis del muestreo hacia los resultados que importan pero ocurren con poca frecuencia. Se adapta a la detección de corrupción, infracciones graves de SLA u otras cuestiones de cola, siempre que el esquema de ponderación esté cuidadosamente validado. Sin esa validación, el método puede crear una estimación convincente pero sesgada.
El método de Monte Carlo por cadenas de Markov es apropiado cuando las variables tienen dependencias que impiden un muestreo independiente confiable. Ofrece flexibilidad para distribuciones conjuntas complejas, pero los equipos deben monitorizar el comportamiento de la cadena y la mezcla. Si las muestras independientes o estratificadas ya responden a la pregunta, no vale la pena llevar esa complejidad a producción.
Una regla de selección útil es sencilla: comience con algo simple, pase a la reducción de la varianza cuando el cómputo sea el cuello de botella y use métodos que tengan en cuenta la dependencia cuando se demuestre que la independencia es falsa. La orientación sobre la aplicación de métodos estadísticos para el análisis de datos puede ayudar a los equipos a alinear el método con el problema de datos en lugar de elegir un algoritmo porque suena avanzado.
Cuántas simulaciones son suficientes
Una instrucción fija como "ejecutar 10 000 simulaciones" es una política de producción deficiente. El número de replicaciones requerido depende de la varianza de la salida, la precisión que necesitan quienes toman las decisiones y el coste de cada ejecución del modelo. Una métrica estable y de baja varianza puede necesitar muchas menos ejecuciones que una estimación de cola volátil. Un modelo complicado puede seguir siendo poco fiable incluso después de muchas iteraciones.
Una revisión de 2022 encontró que los modeladores a menudo eligen el número de replicaciones sin justificación científica. Eso puede producir muy pocas ejecuciones, lo que hace que la media de la muestra no sea representativa, o demasiadas, desperdiciando un cómputo que podría respaldar un mejor análisis del modelo. Esa misma revisión se analiza en esta fuente sobre prácticas de replicación y parada.
Uso de una regla de parada
Defina una condición de parada medible antes de que comience la ejecución. Los criterios útiles incluyen:
Umbral de error estándar: Detener cuando el error estándar estimado de la métrica objetivo caiga por debajo de la tolerancia de decisión.
Ancho del intervalo de confianza: Detener cuando el intervalo alrededor de la estimación sea lo suficientemente estrecho para el caso de uso operativo.
Coeficiente de variación: Realizar un seguimiento de la dispersión relativa y detener cuando se estabilice dentro de un rango acordado.
Estabilidad de cuantiles: Para las estimaciones de cola, compare el percentil objetivo entre los puntos de control en lugar de monitorizar únicamente la media.
Verifique la convergencia después de cada lote fijo, no después de cada ejecución. Un programador puede agregar un lote, calcular diagnósticos y finalizar una vez que se cumpla la regla. Este patrón funciona para trabajos SQL de almacenamiento de datos, procesos de Python y ejecución distribuida. Establezca el tamaño del punto de control teniendo en cuenta la sobrecarga de la transacción y los costes de inicio del clúster.
La regla de parada pertenece a la decisión. Una alerta de calidad de datos puede tolerar un intervalo más amplio porque desencadena una investigación en lugar de una decisión financiera irreversible. Un cálculo de riesgo puede requerir límites más estrictos y una validación más sólida. Los equipos que documenten la medición de la confiabilidad de los datos deben registrar la tolerancia, el programa de puntos de control y la métrica utilizada para detener.
No agregue iteraciones automáticamente cuando falle la convergencia. Verifique primero las distribuciones de entrada, las correlaciones, la implementación y la generación de números aleatorios. Más muestras reducen el ruido de muestreo, pero no corrigen un modelo defectuoso.
La notificación de incertidumbre de Monte Carlo sigue siendo una debilidad en la práctica de la simulación. Una revisión metodológica identificó la falta de notificación como una de las principales deficiencias en los estudios de simulación. Un documento de 2024 argumentó que un diseño y una notificación deficientes pueden dar lugar a afirmaciones de superioridad espurias en simulaciones comparativas. Por lo tanto, los diagnósticos de convergencia y los informes transparentes pertenecen al flujo de trabajo de producción, junto con el código del modelo y los metadatos del canal de datos.
Aplicaciones en el mundo real en calidad de datos y monitorización
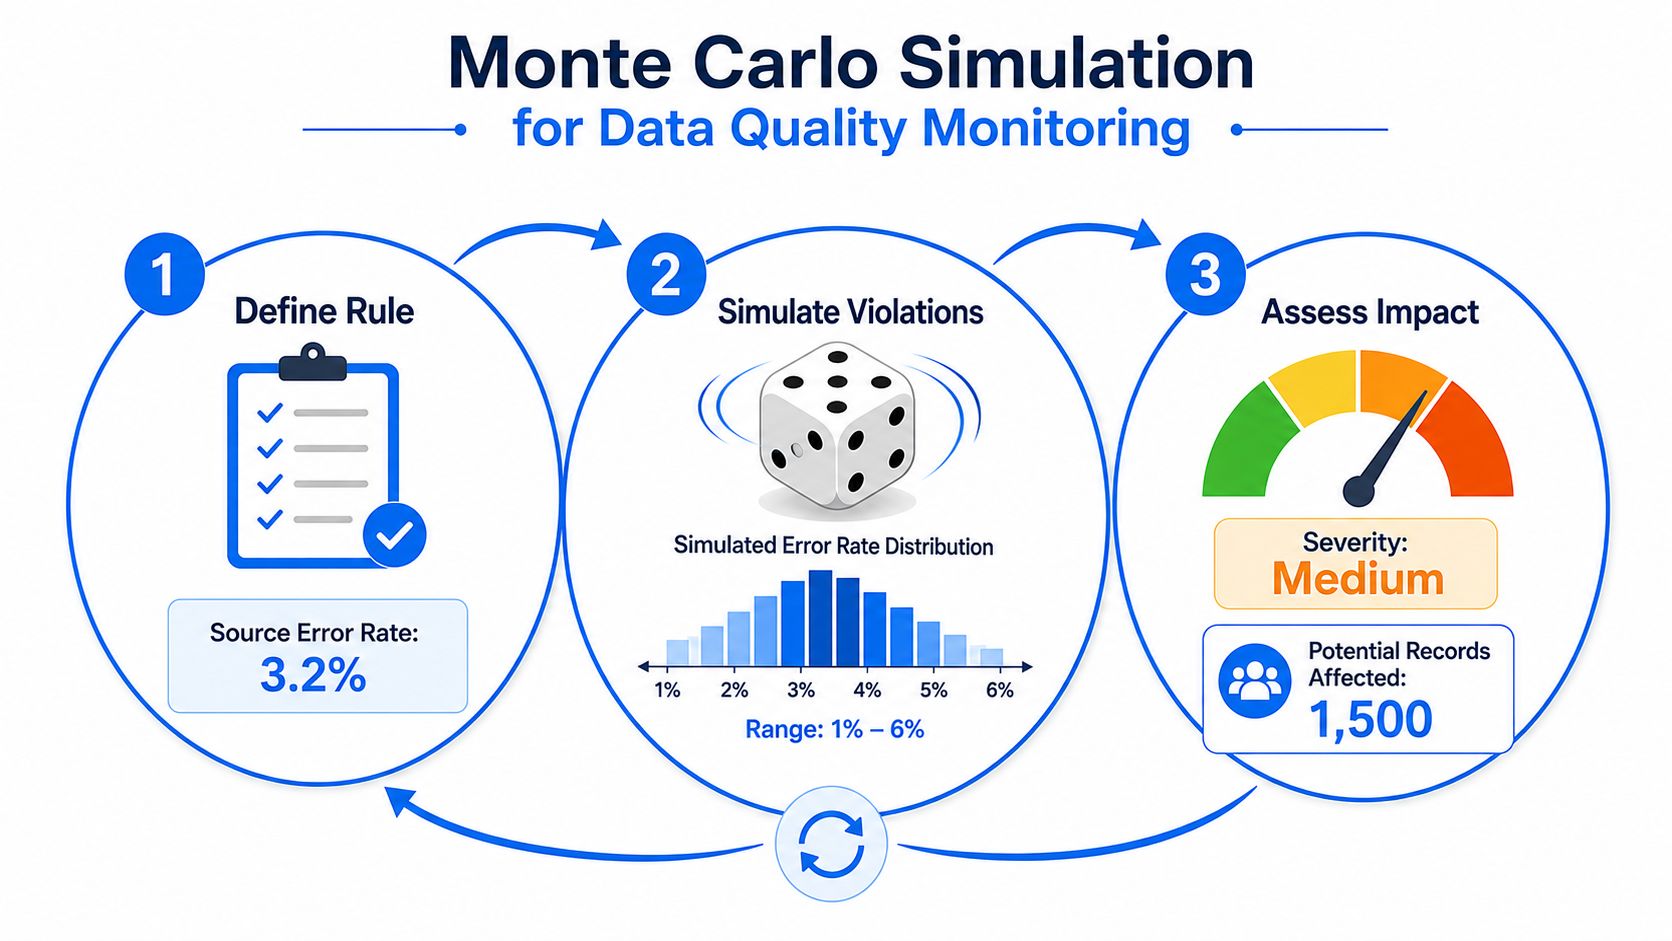
Monte Carlo se vuelve operativamente útil cuando su resultado alimenta una decisión de monitorización existente. Considere una tabla de origen con una tasa de defectos incierta. El equipo puede muestrear tasas de defectos plausibles, inyectar infracciones en un conjunto de datos representativo, ejecutar reglas descendentes y calcular la probabilidad de que los registros afectados superen un umbral acordado.
Ese cálculo no reemplaza una verificación nula o una prueba de unicidad. Responde a una pregunta diferente: dada la incertidumbre en el origen, ¿qué tan expuesto está el sistema descendente?
Escenarios de calidad de datos
Un flujo de trabajo práctico puede modelar:
Infracciones de reglas: Estimar el rango de registros que podrían fallar una regla de validación bajo condiciones de origen cambiantes.
Llegadas tardías: Propagar la incertidumbre del tiempo de entrega a la integridad de una ventana de informe.
Incertidumbre de KPI: Crear bandas de confianza en torno a métricas derivadas cuyas entradas se miden de forma imperfecta.
Anomalías: Comparar un resultado observado con una distribución simulada y marcar los valores en colas extremas.
Demanda de capacidad: Generar combinaciones de carga de trabajo para evaluar la presión del almacenamiento de datos o la orquestación.
Para una implementación orientada a SQL, una tabla de almacenamiento puede contener identificadores de simulación, parámetros muestreados y métricas de salida. Un patrón simplificado se ve así:
La versión de producción debe usar las funciones aleatorias admitidas por el almacenamiento de datos, conservar la semilla o la configuración de ejecución y mantener el umbral en una tabla de parámetros gobernada. La opción de diseño clave es hacer que el resultado sea consultable por los mismos paneles de control y trabajos de alerta que consumen comprobaciones deterministas.
Conexión de resultados con la Observability
Los resultados de la simulación deben convertirse en señales de Observability de primer nivel. Almacene la marca de tiempo de la ejecución, la versión del modelo, las suposiciones de entrada, los diagnósticos de convergencia, los percentiles relevantes y la probabilidad de cruzar cada umbral de alerta. Los paneles de control pueden mostrar el rango esperado, mientras que los sistemas de incidentes pueden dirigir solo los resultados materialmente inusuales al equipo propietario.
Los equipos que trabajan en simulaciones de Monte Carlo para la detección de anomalías de datos pueden usar este patrón para complementar la monitorización de línea de base. Una métrica observada fuera del rango simulado no es automáticamente prueba de un defecto de datos, pero proporciona un activador disciplinado para verificar la frescura del origen, los cambios de esquema, la latencia del canal de datos y los eventos comerciales.
Patrones de implementación y compromisos de rendimiento
La ubicación de la ejecución determina más que la velocidad. Afecta al movimiento de datos, al acceso a bibliotecas, a la revisión de seguridad, a la visibilidad de costes, a la reproducibilidad y a quién puede operar el trabajo después de que llegue a producción.
La ejecución en la base de datos mantiene los datos cerca de las transformaciones. SQL puede muestrear entradas, unir parámetros de simulación, ejecutar lógica nativa del almacenamiento de datos y conservar resultados sin exportar registros sensibles. Este patrón funciona bien cuando el modelo refleja transformaciones existentes y el almacenamiento de datos puede paralelizar la carga de trabajo.
Sus límites aparecen cuando el equipo necesita muestreadores avanzados, distribuciones de probabilidad personalizadas, cadenas iterativas o diagnósticos especializados. El SQL de procedimientos puede admitir más lógica, pero la complejidad puede resultar difícil de probar y costosa de ejecutar.
Los procesos externos de Python, R o Spark ofrecen un ecosistema más amplio. NumPy, SciPy, PyMC y los marcos de trabajo distribuidos pueden simplificar el muestreo avanzado y el diagnóstico de modelos. El compromiso es la sobrecarga de serialización, la gestión de credenciales, el movimiento de red, los canales de despliegue independientes y el trabajo de gobernanza adicional.
Patrón | Latencia | Flexibilidad | Gobernanza | Ideal para |
|---|---|---|---|---|
SQL de almacenamiento de datos | De baja a moderada para datos locales | Moderada | Sólida cuando se gobierna con controles de almacenamiento de datos | Modelos de calidad de datos y KPI cerca de tablas existentes |
Procedimientos almacenados | Moderada | Mayor que el SQL plano | Centralizada, pero la revisión del código es esencial | Flujos de trabajo de almacenamiento de datos iterativos o con estado |
Proceso de Python | Variable | Alta | Requiere controles de entorno y dependencia | Distribuciones avanzadas y diagnósticos |
Trabajo de Spark | Mayor sobrecarga de inicio | Alta a escala | Requiere gobernanza de clúster y acceso a datos | Conjuntos de datos grandes y modelos distribuidos |
Resultados precalculados | Baja para los consumidores | Limitada entre ejecuciones | Sólida con artefactos versionados | Paneles de control e informes programados |
Ejecución bajo demanda | Variable | Alta | Debe gobernar parámetros y acceso | Investigaciones y respuesta a incidentes |
Precalcule cuando las entradas cambien según un programa y los consumidores necesiten una latencia predecible. Ejecute bajo demanda cuando los analistas estén explorando suposiciones o respondiendo a un incidente. Guarde los resultados en caché cuando la instantánea de entrada, el conjunto de parámetros, la versión del modelo y la semilla aleatoria no hayan cambiado. Una caché sin esas claves puede devolver una respuesta rápida pero engañosa.
La reproducibilidad requiere controles deliberados. Establezca semillas para los generadores de números aleatorios, cree versiones del código y los parámetros del modelo, registre la instantánea de origen y conserve los metadatos de auditoría. Los entornos regulados también pueden necesitar registros de aprobación y una distinción clara entre ejecuciones exploratorias y de producción.
Errores comunes y cómo evitarlos
Los modelos de Monte Carlo a menudo fallan sin previo aviso. La distribución de salida se ve pulida, el gráfico de percentiles se representa correctamente y las suposiciones subyacentes siguen sin ser adecuadas para los datos.
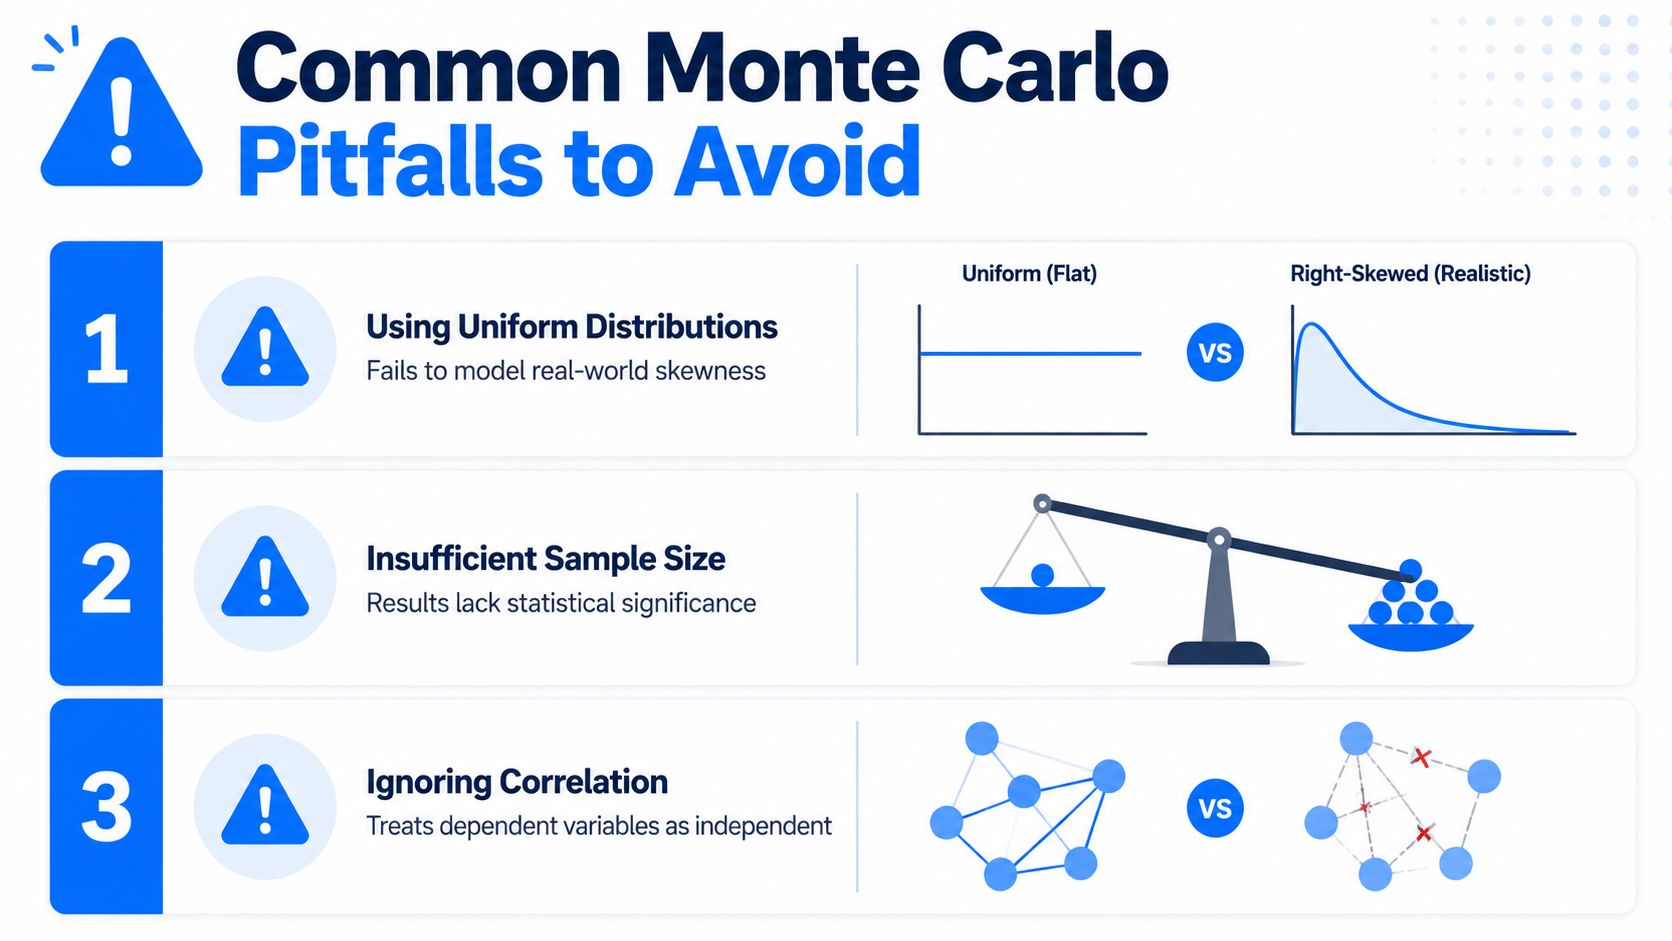
El primer error es seleccionar una distribución uniforme porque es fácil proporcionar un mínimo y un máximo. Los datos operativos reales pueden estar sesgados, agrupados, truncados o afectados por la estacionalidad. Ajuste las distribuciones candidatas con las observaciones históricas, inspeccione el comportamiento residual y use una distribución empírica cuando ninguna familia simple represente los datos adecuadamente.
El segundo es tratar las entradas dependientes como independientes. Una carga de origen tardía puede coincidir con una menor integridad del registro, mientras que una carga de trabajo alta puede aumentar la latencia del procesamiento. Si el modelo toma muestras de esas variables por separado, puede crear combinaciones que nunca ocurren o perder combinaciones que importan.
Modele relaciones, no solo columnas. Una distribución marginal plausible aún puede producir un sistema inverosímil cuando la estructura de correlación es incorrecta.
El tercer error es confundir un rango probabilístico con un pronóstico determinista. Un percentil simulado no es una promesa, y una observación de cola de una distribución débilmente muestreada no debería impulsar una decisión importante sin validación.
Utilice una rutina de validación compacta:
Ajuste de distribución: Aplique una prueba de Kolmogorov-Smirnov donde sus suposiciones se ajusten a los datos, luego inspeccione el ajuste visual en lugar de aceptar el resultado de una prueba de forma mecánica.
Análisis de sensibilidad: Identifique qué entradas explican la varianza de salida y enfoque la recopilación de datos o los controles allí.
Comprobaciones de semillas: Ejecute la misma configuración con una semilla documentada en CI/CD y verifique que las diferencias se mantengan dentro de una tolerancia aceptada.
Escenarios de estrés: Agregue combinaciones deliberadamente adversas pero plausibles para probar si el modelo se comporta de manera sensata fuera de su rango central.
Revisión de resultados: Compare el comportamiento simulado con los resultados históricos e investigue los desacuerdos sistemáticos.
La reducción de la varianza puede mejorar la eficiencia del cómputo, pero no debe agregarse como decoración. Úsela cuando los diagnósticos muestren que el muestreo simple dedica demasiado esfuerzo a regiones irrelevantes o no logra resolver el límite de decisión.
Integración de Monte Carlo en su plataforma de datos
Una arquitectura útil comienza con el producto de datos existente, no con la biblioteca de simulación. Mantenga la validación determinista cerca de los datos, luego agregue trabajos de simulación donde la incertidumbre cambie la decisión operativa.
Elección de la ruta de ejecución
Utilice una macro de dbt o SQL de almacenamiento de datos cuando el modelo use transformaciones relacionales, los datos deban permanecer en su lugar y los resultados programados sean suficientes. Use un proceso de Python dedicado orquestado por Airflow o Dagster cuando la simulación necesite muestreo avanzado, programación probabilística o diagnósticos más completos.
Cualquiera que sea la ruta que elija, conserve:
Identificadores de instantáneas de entrada: Para que el equipo pueda reconstruir lo que consumió el modelo.
Versiones de parámetros: Para que las suposiciones de distribución no cambien de forma invisible.
Versiones de modelo y código: Para que se puedan atribuir los cambios de salida.
Metadatos de convergencia: Para que los consumidores puedan distinguir una ejecución completada de una inestable.
Umbrales de decisión: Para que el comportamiento de alerta siga siendo auditable.
Guarde en caché los resultados para entradas y parámetros que no hayan cambiado. Invalide la caché cuando cambien los datos de origen, el código del modelo, los parámetros de distribución o los umbrales. Los sistemas de Observability pueden consumir las métricas resultantes junto con las señales de frescura, esquema, validación y anomalías.
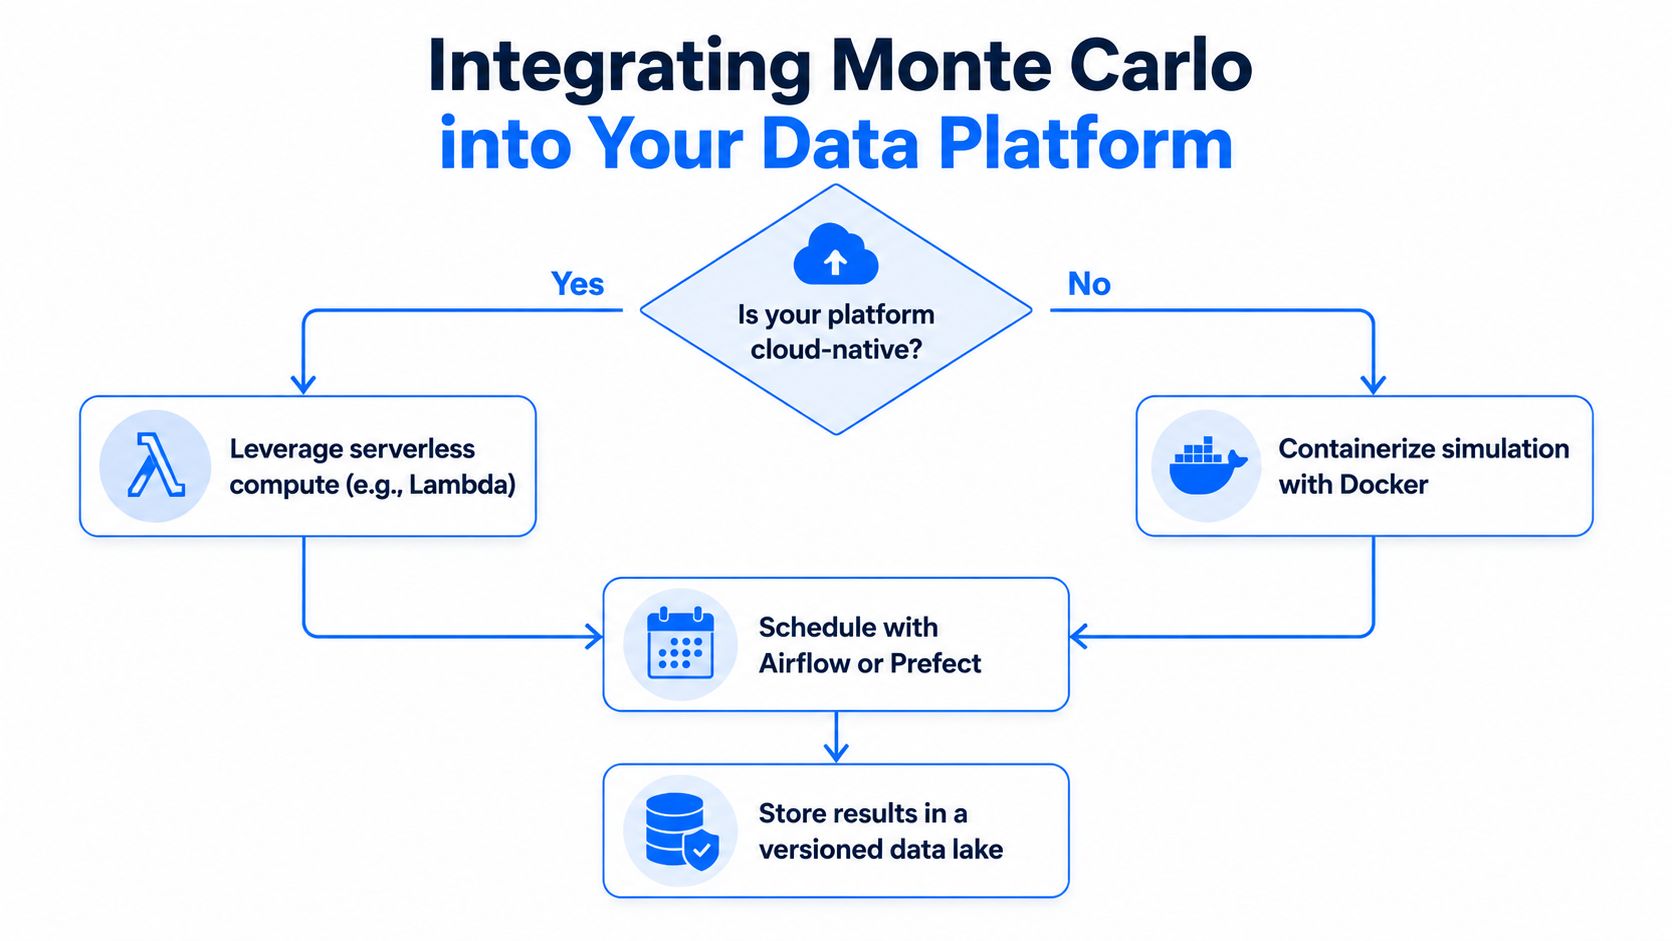
Despliegue por fases
Comience con una prueba retrospectiva histórica. Compare los rangos simulados con los resultados conocidos del canal de datos y documente dónde falla el modelo. A continuación, programe la simulación junto con los trabajos de calidad de datos existentes y envíe sus resultados a paneles de control, enrutamiento de alertas y registros de incidentes.
Solo después de que esas etapas sean estables, el equipo debe considerar la ejecución desencadenada por incidentes o casi en tiempo real. En ese momento, el éxito significa más que producir una distribución. El flujo de trabajo debe identificar los conjuntos de datos afectados, explicar qué suposiciones impulsaron la alerta, preservar el contexto de la ejecución y dar al propietario suficiente evidencia para actuar.
digna ofrece validación de calidad de datos en la base de datos, detección de anomalías, monitorización de la puntualidad, seguimiento de esquemas y Observability de métricas comerciales dentro del entorno de un cliente. Visite digna para evaluar cómo sus capacidades de Observability pueden complementar un flujo de trabajo de simulación de Monte Carlo en producción, luego comience con un conjunto de datos monitorizado, un modelo gobernado y una regla de parada que pueda defender.


