Método de Simulación de Montecarlo: Una Guía Práctica
|
9
minuto de lectura
Su equipo tiene un trabajo ETL diario que debe finalizar antes de la ventana de informes de la mañana. Los flujos ascendentes llegan a diferentes horas, algunas tablas necesitan reintentos y los volúmenes de filas cambian de una ejecución a otra. Alguien hace una pregunta comercial razonable: ¿cuál es la probabilidad de que el trabajo no cumpla con su SLA?
Una hoja de cálculo con un único valor de retraso promedio no la responderá bien. Las combinaciones posibles se multiplican rápidamente y los modos de falla interactúan. El método de simulación de Monte Carlo ofrece una alternativa práctica. Convierte la incertidumbre en experimentos computacionales repetidos, luego resume los resultados resultantes como probabilidades, rangos y medidas de riesgo.
Tabla de Contenidos
Por qué los ingenieros recurren al método de simulación de Monte Carlo
De una ecuación imposible a un experimento manejable
Los orígenes detrás del método de simulación de Monte Carlo
Por qué es importante el hito de ENIAC
Principios fundamentales que hacen que el muestreo aleatorio funcione
El algoritmo de cuatro etapas
Estimación de errores y convergencia con confianza
Un ejemplo práctico de conversión
Diagnóstico de convergencia para producción
Técnicas de reducción de varianza que vale la pena conocer
Cuatro enfoques y sus compensaciones
Pseudocódigo y patrones de implementación en la base de datos
Un modelo de referencia de Python
Mover el cómputo junto a los datos
Aplicación del método de simulación de Monte Carlo en la calidad de datos empresariales
Timeliness y frescura del pipeline
Deriva de esquema e impacto descendente
Monitoreo adaptativo de tasa de nulos y anomalías
Malentendidos comunes y una lista de verificación práctica
Una lista de verificación del manual de procedimientos
Por qué los ingenieros recurren al método de simulación de Monte Carlo
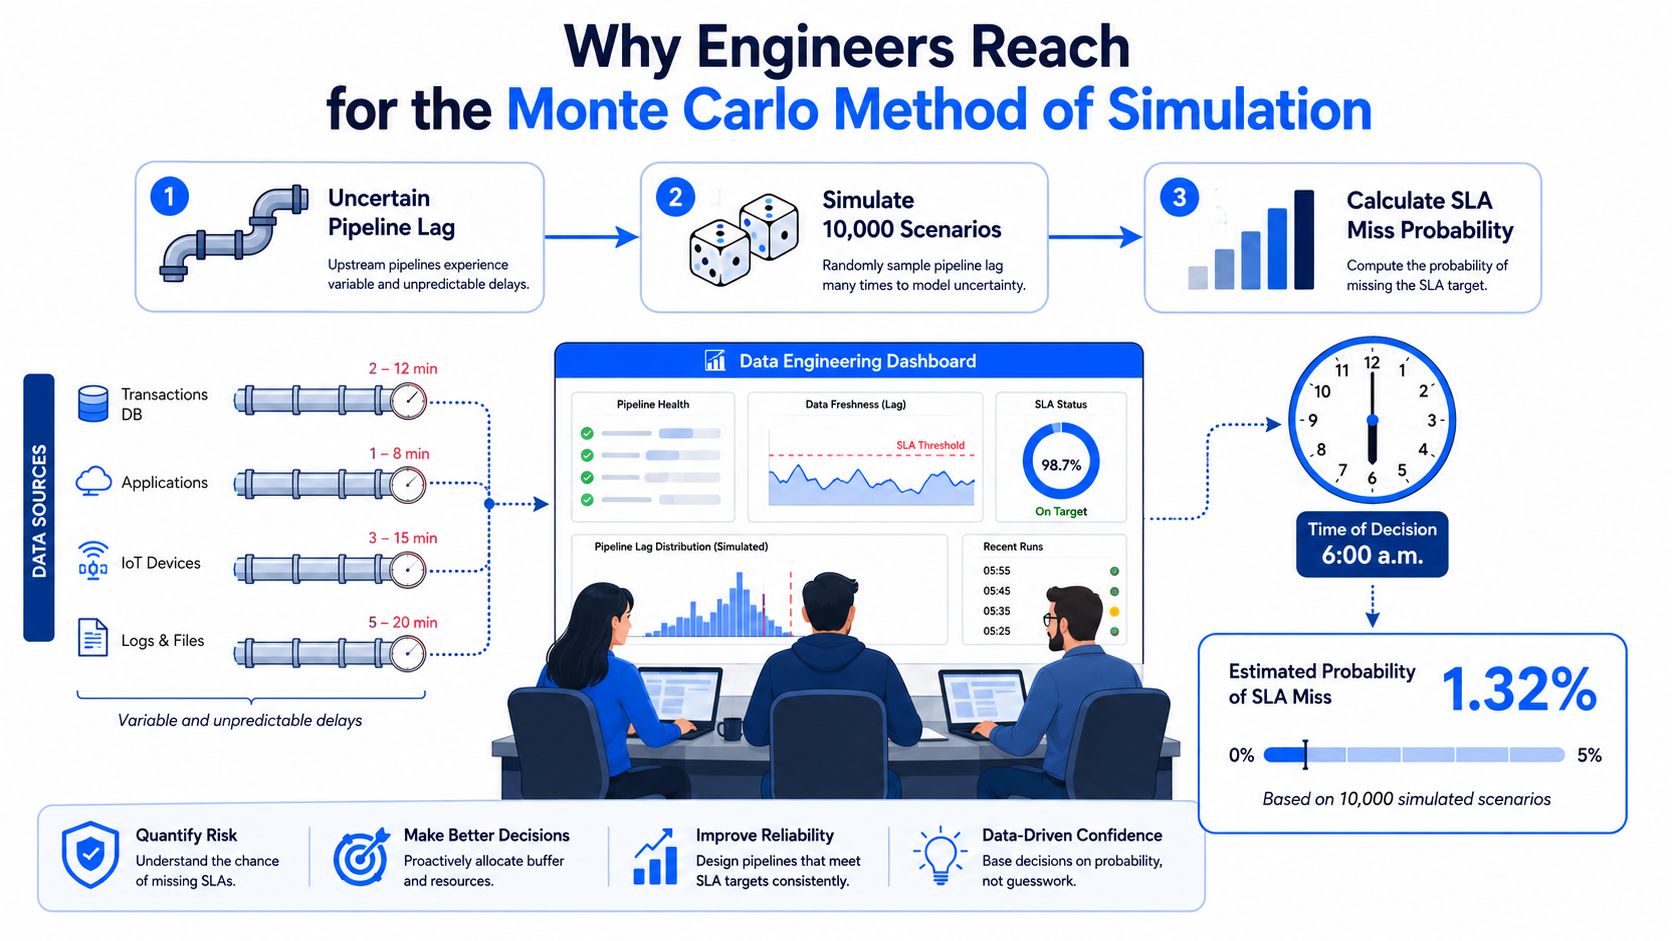
Un equipo de ingeniería de datos puede conocer el comportamiento histórico de cada fuente ascendente, pero aun así tener dificultades para calcular analíticamente la probabilidad de no cumplir con una fecha límite de entrega fija. Una fuente puede llegar tarde, otra puede fallar y reintentar, y una tercera puede entregar un lote inusualmente grande que extienda el tiempo de transformación. Cada rama cambia la siguiente, por lo que una única fórmula cerrada se vuelve difícil de mantener y más difícil de defender.
La simulación de Monte Carlo aborda el problema de manera diferente. El equipo representa entradas inciertas con distribuciones realistas, genera ejecuciones sintéticas de pipelines, evalúa si cada ejecución finaliza antes del SLA y agrega los resultados en una estimación de probabilidad. El resultado no es la promesa de que una ejecución en particular se retrasará. Es una vista basada en evidencia de cómo se comporta el sistema modelado en muchas condiciones plausibles.
De una ecuación imposible a un experimento manejable
El atractivo del método no es la aleatoriedad por sí misma. Es la capacidad de reemplazar un problema analítico intratable por un experimento computacional manejable. Los ingenieros pueden hacer preguntas como:
Planificación de capacidad: ¿Cuánto margen de procesamiento necesita la carga de trabajo en condiciones de llegada de gran volumen?
Revisión de riesgos: ¿Con qué frecuencia las combinaciones de retrasos ascendentes y comportamientos de reintento generan un incumplimiento del SLA?
Compromisos con las partes interesadas: ¿Qué tan defendible es el tiempo de entrega propuesto cuando las entradas siguen siendo variables?
Cada ejecución de simulación actúa como un día operativo sintético. Una ejecución puede generar un retraso ascendente corto y un volumen de filas moderado. Otra puede combinar varias llegadas tardías con reintentos adicionales. El modelo registra el tiempo de finalización y clasifica la ejecución como un éxito o un incumplimiento.
Regla práctica: Modele la incertidumbre que cambia la decisión. Agregar entradas aleatorias que no afectan al SLA solo aumenta la complejidad.
Si desea una guía detallada e independiente del flujo de trabajo básico, el tutorial de simulación de Polytreasury proporciona un contexto introductorio útil. Para los equipos de datos empresariales, el cambio importante es conceptual: dejar de pedir un tiempo de finalización supuestamente preciso y comenzar a preguntar cómo afecta a todo el rango de ejecuciones plausibles el riesgo operativo.
Los orígenes detrás del método de simulación de Monte Carlo
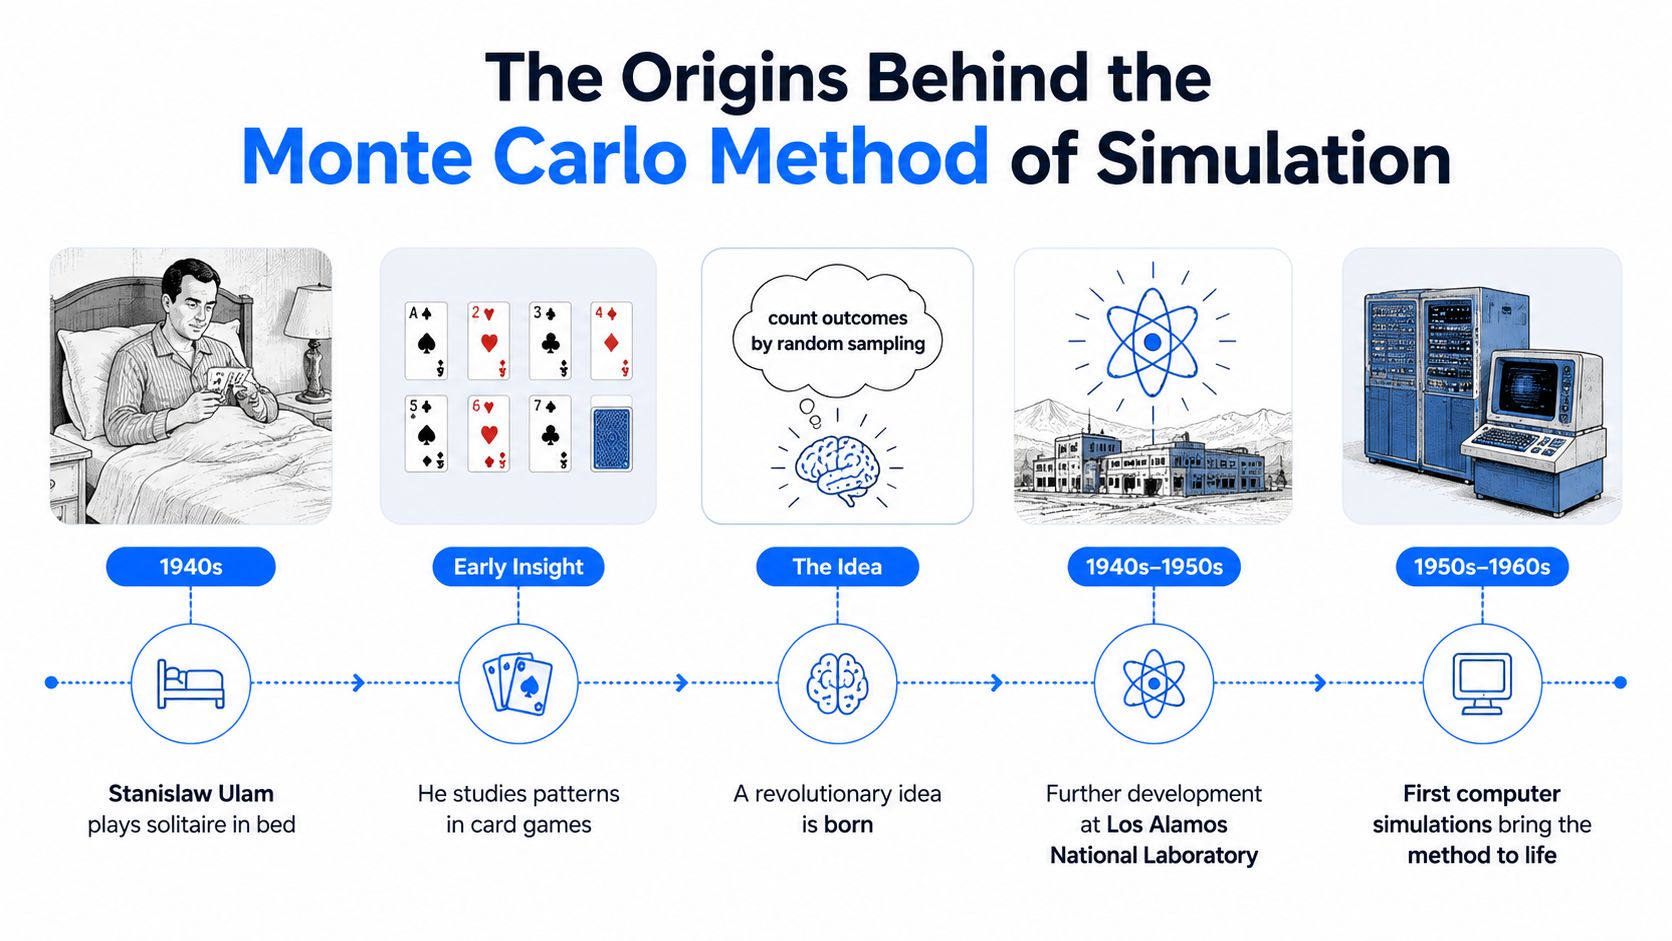
La historia moderna comienza con Stanisław Ulam, quien se estaba recuperando de una enfermedad y pensaba en el solitario. Se preguntó qué tan probable era que una disposición particular de cartas produjera una victoria. Contar cada disposición posible analíticamente sería poco práctico, pero repartir manos repetidamente y registrar el resultado era sencillo.
Esa idea cambió la pregunta. En lugar de enumerar cada resultado, Ulam podía usar pruebas aleatorias para estimar el porcentaje de victorias. La misma lógica podría aplicarse a sistemas con espacios de estado enormes, donde el cálculo directo se vuelve poco realista.
Ulam compartió la idea con John von Neumann en Los Álamos durante el Proyecto Manhattan. Von Neumann reconoció su relevancia para la difusión de neutrones y cálculos de física nuclear relacionados. La forma computacional moderna del método se desarrolló intencionalmente a mediados de la década de 1940, cuando los investigadores necesitaban una forma de razonar sobre comportamientos físicos complejos que resistían un tratamiento analítico más simple.
Por qué es importante el hito de ENIAC
Un hito importante llegó en 1948, cuando von Neumann, Nicholas Metropolis y otros utilizaron la computadora ENIAC para realizar los primeros cálculos de Monte Carlo totalmente automatizados. El primer artículo desclasificado siguió en 1949. Esa transición importa porque trasladó el método del razonamiento manual sobre el azar a la simulación a gran escala basada en computadoras.
Metropolis ayudó a darle al enfoque su memorable nombre en clave, basándose en el carácter probabilístico del casino de Monte Carlo en Mónaco. El nombre se mantuvo porque captura la intuición central: las pruebas aleatorias pueden revelar el comportamiento de un sistema complicado.
La historia tiene una lección directa para los ingenieros de datos. Monte Carlo no nació como un ejercicio académico desconectado de las operaciones. Surgió porque los investigadores se enfrentaron a un problema demasiado complicado como para resolverlo convenientemente mediante enumeración directa. Los equipos empresariales enfrentan el mismo patrón cuando cientos de tablas, programaciones, reintentos, dependencias y volúmenes de datos cambiantes interactúan dentro de una plataforma de producción.
Principios fundamentales que hacen que el muestreo aleatorio funcione
Suponga que desea estimar con qué frecuencia una moneda justa cae cara. Podría deducir la probabilidad matemáticamente, o podría lanzar la moneda repetidamente y calcular la proporción de caras. El segundo enfoque es menos elegante para una moneda simple, pero le brinda el modelo mental correcto para la simulación de Monte Carlo.
Para un pipeline empresarial, la
Preguntas frecuentes
¿Cuándo recurren los ingenieros al método de Monte Carlo?
Cuando la respuesta analítica queda fuera de alcance. Un equipo puede conocer el comportamiento histórico de cada fuente aguas arriba y aun así no poder calcular la probabilidad de incumplir un plazo fijo, así que representa las entradas como distribuciones, genera ejecuciones sintéticas y agrega los resultados en una probabilidad.
¿Cómo empezó el método?
Con Stanisław Ulam, que convaleciente pensaba en el solitario y se dio cuenta de que jugar repetidamente al azar podía estimar un resultado que la combinatoria directa volvía incómodo. Compartió la idea con John von Neumann en Los Álamos, y la forma computacional moderna se desarrolló a mediados de los años cuarenta.
¿Qué cuenta como una ejecución de simulación?
Un día operativo sintético. Cada ejecución extrae de las distribuciones de entrada, hace avanzar la canalización y registra si el resultado cumplió la condición que importa, por ejemplo terminar antes del SLA. Agregar miles de esos días produce la estimación de probabilidad.
¿Qué incertidumbres merecen modelarse?
Solo las que cambian la decisión. Añadir entradas aleatorias que no afectan al SLA solo aumenta la complejidad sin mejorar la respuesta, así que empiece por la decisión y retroceda hacia las variables que de verdad la mueven.
¿Para qué sirve la reducción de varianza?
Para obtener una estimación utilizable con menos ejecuciones. En lugar de simular simplemente más, las técnicas de reducción de varianza reestructuran el muestreo para que la estimación converja antes, lo que importa cuando cada ejecución es cara o cuando la simulación corre dentro de la base junto a cargas de producción.


