10 aplicaciones de la simulación de Montecarlo en la estrategia de datos
|
9
minuto de lectura

La simulación de Monte Carlo no predice un futuro garantizado. Convierte entradas inciertas en distribuciones de probabilidad, luego realiza muestreos repetidos de esas entradas para mostrar cómo pueden comportarse los resultados bajo diferentes condiciones. El método fue desarrollado en la década de 1940 por Stanislaw Ulam y posteriormente se convirtió en un estándar en finanzas, ingeniería, física, logística, atención médica, ciencia climática, manufactura y gestión de proyectos. Un artículo histórico de 1964 de Harvard Business Review escrito por David Hertz ayudó a establecer su papel en las finanzas corporativas, y los modelos modernos comúnmente ejecutan miles o millones de pruebas aleatorias para aplicaciones como la valoración de opciones de acciones, finanzas de proyectos y análisis de opciones reales (Corporate Finance Institute).
Eso hace que el método sea poderoso, pero también fácil de usar incorrectamente. Una simulación puede procesar la incertidumbre a gran escala y aun así producir una guía engañosa si sus entradas se retrasan, están incompletas, son anómalas, están distribuidas incorrectamente, están correlacionadas de manera errónea o han cambiado estructuralmente. Por lo tanto, las diez aplicaciones de simulación de Monte Carlo a continuación se centran en algo más que el modelo en sí. Cada una conecta la decisión con las condiciones de los datos que determinan si el resultado merece confianza.
Haga cuatro preguntas antes de tratar un resultado como listo para la toma de decisiones: ¿Qué variables necesitan distribuciones de probabilidad? ¿Qué datos históricos o en vivo respaldan esas distribuciones? ¿Dónde podrían fallar las suposiciones? ¿Cómo detectará la Observability entradas inválidas, tardías, anómalas o estructuralmente modificadas antes de que distorsionen el resultado?
Tabla de contenidos
4. Predicción de reclamaciones de seguros y modelos de precios
6. Planificación de la capacidad de la red de telecomunicaciones
8. Control de calidad de fabricación y predicción de la tasa de defectos
9. Planificación presupuestaria del sector público y análisis de impacto fiscal
1. Evaluación de riesgos financieros y modelado de carteras
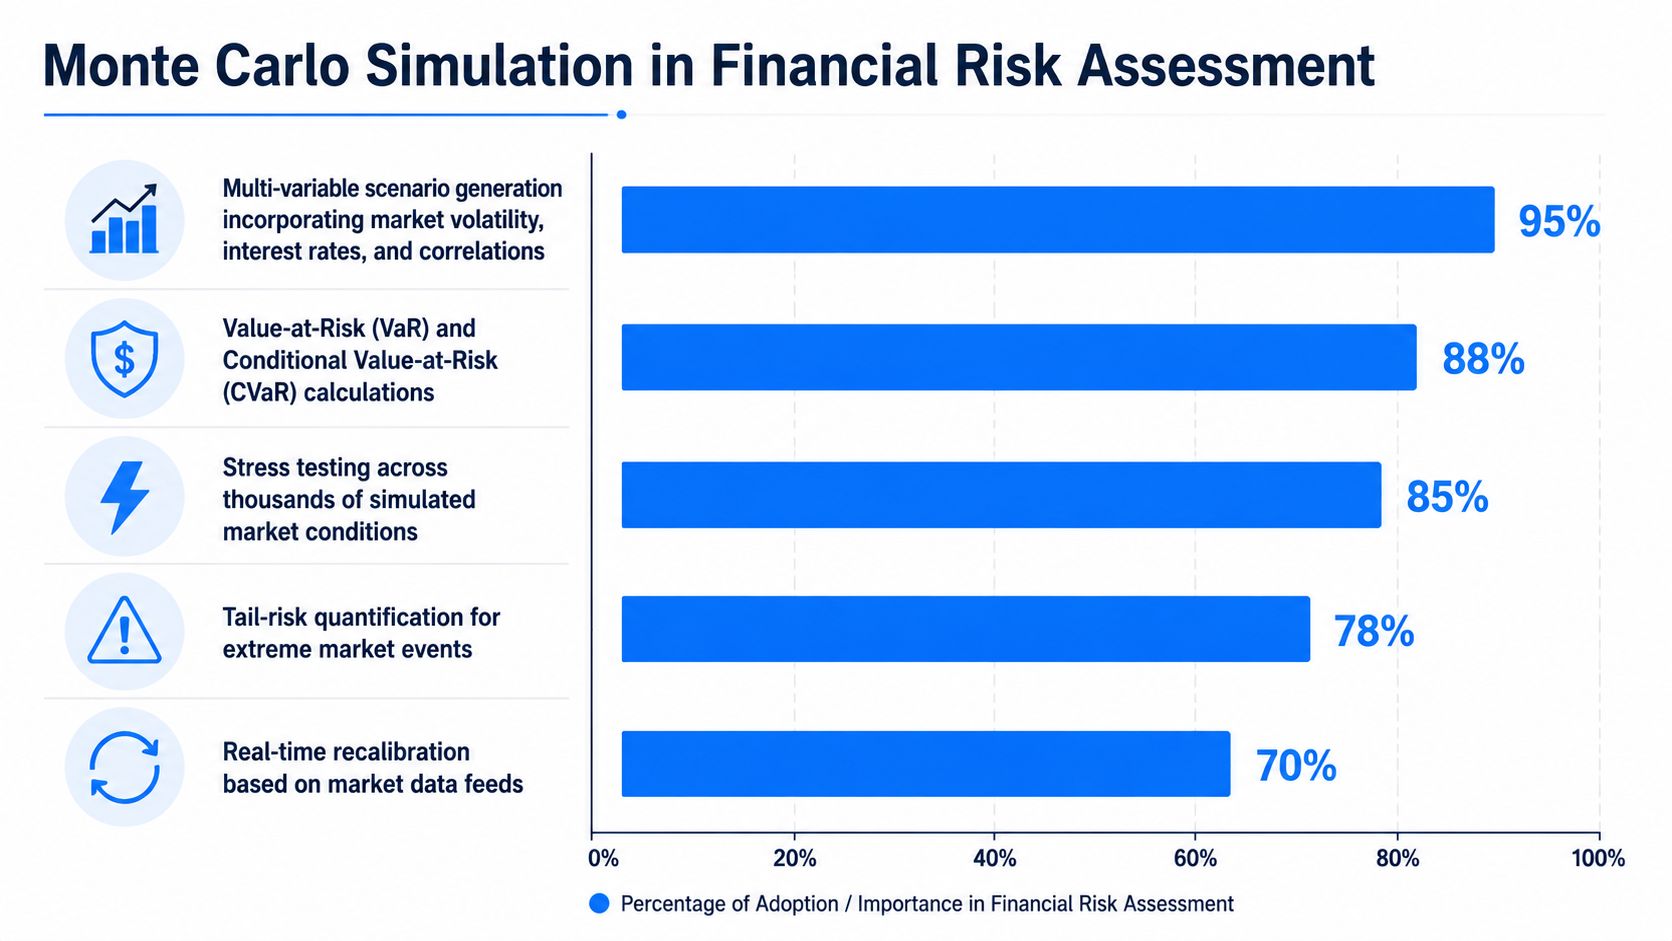
La simulación de Monte Carlo es más útil en finanzas cuando la decisión depende de muchas trayectorias de mercado posibles. Los analistas modelan la incertidumbre en los rendimientos del mercado, las tasas de interés, la inflación y los flujos de efectivo para la optimización de carteras, el Valor en Riesgo, el déficit esperado, la planificación de ingresos de jubilación, las pruebas de estrés, la valoración de derivados y el análisis de activos y pasivos (financial applications of Monte Carlo simulation). Los derivados que dependen de la trayectoria requieren un cuidado particular porque su valor depende de cómo evolucionan las condiciones, no solo del resultado final.
La confianza en el resultado comienza con las entradas. Los precios retrasados pueden crear escenarios obsoletos, las correlaciones inestables pueden distorsionar la diversificación y un tipo de campo modificado puede alterar los cálculos sin detener el modelo. Los datos históricos también necesitan suficiente continuidad y consistencia estructural para respaldar las distribuciones y relaciones seleccionadas.
Controles de datos que protegen los resultados de riesgo
Un flujo de trabajo práctico de Observability debería:
Validar registros de origen: Comprobar precios, posiciones, exposiciones y clasificaciones antes de cada ejecución de simulación.
Monitorear la entrega de fuentes de mercado: Marcar observaciones faltantes o retrasadas antes de que los valores obsoletos entren en los escenarios actuales.
Comparar el comportamiento esperado y observado: Establecer líneas de base para las métricas de riesgo e investigar movimientos inusuales en los resultados, incluidos los cambios que no se explican por las condiciones del mercado.
Rastrear la deriva estructural: Detectar columnas agregadas, eliminadas o con tipo cambiado antes de que se modifiquen los cálculos posteriores.
Para los bancos y otras instituciones reguladas, la financial data quality management for banks vincula la precisión, la trazabilidad y los controles de informes. El mismo principio se aplica al equity research AI analysis, donde las conclusiones dependen de datos que sigan siendo oportunos y aptos para su propósito.
La Observability debe cubrir tanto las entradas del modelo como las señales comerciales, tales como los totales de exposición, los incumplimientos de límites de riesgo y los cambios en la concentración de la cartera. Esas señales ayudan a los analistas a distinguir un movimiento real del mercado de un fallo en la canalización de datos o de una deriva en las suposiciones.
Regla práctica: Un motor de simulación estable no puede compensar datos de mercado inestables o suposiciones no documentadas.
2. Desarrollo de fármacos y simulación de ensayos clínicos
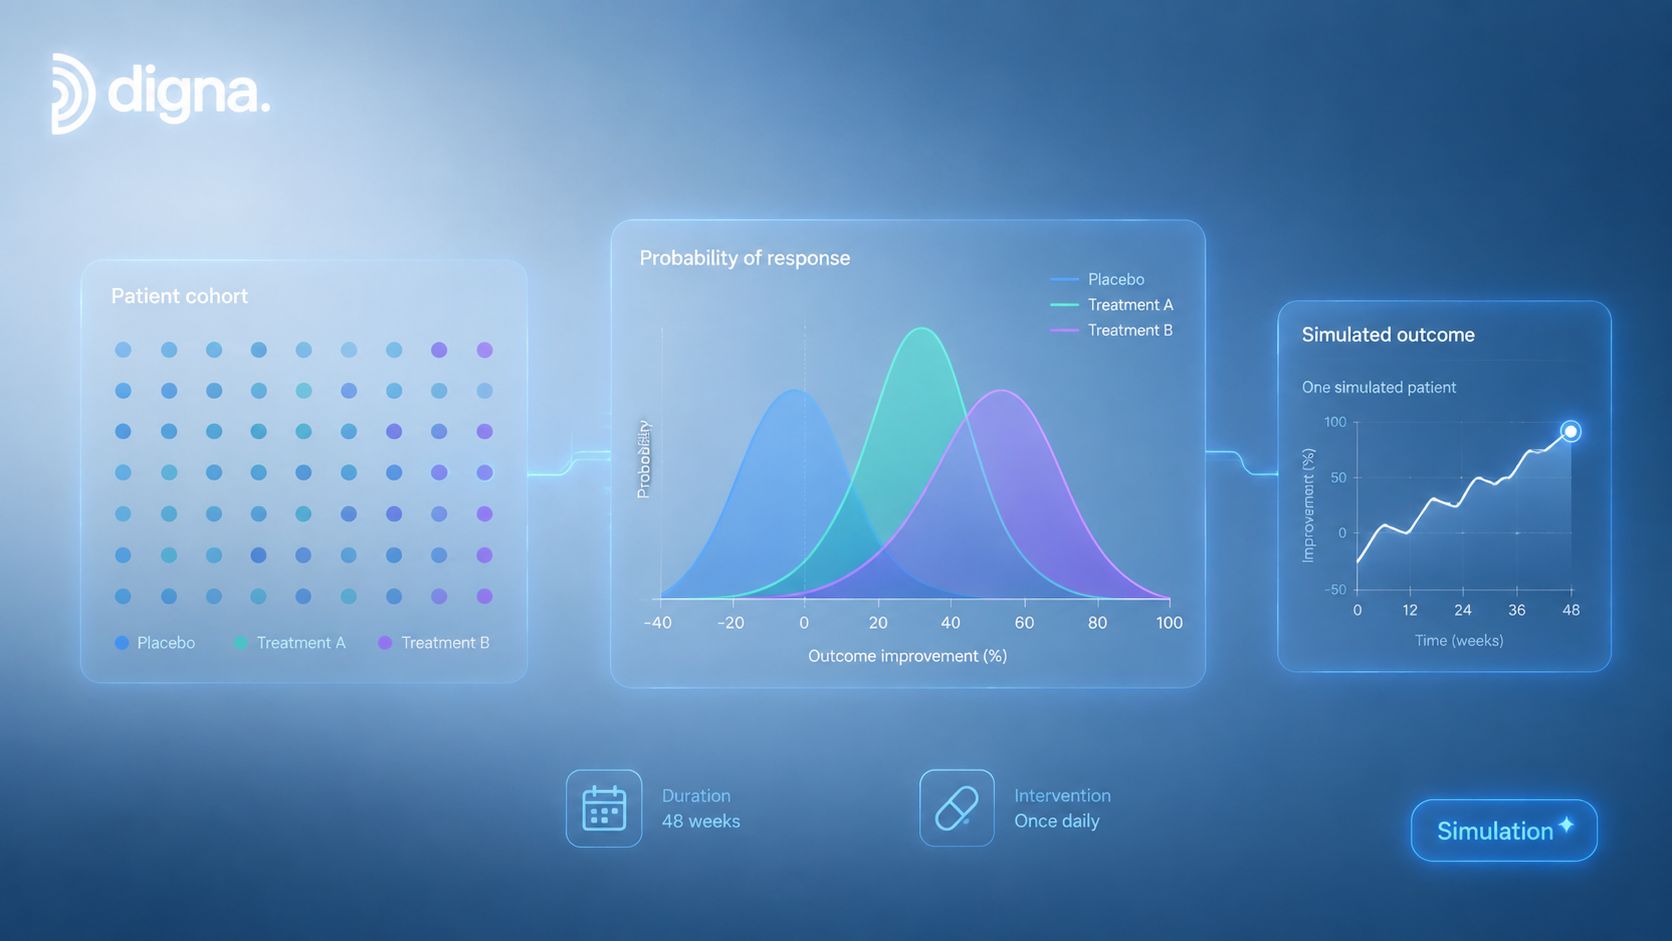
La atención médica utiliza los métodos de Monte Carlo para propagar la incertidumbre a través de las trayectorias de los pacientes, los resultados de los tratamientos, las evaluaciones económicas y las decisiones de riesgo-beneficio. Una revisión sistemática identificó cuatro propósitos generales en la atención médica: evaluación del riesgo para la salud y de la dosis-respuesta, evaluación económica, comparación de tecnologías o estrategias competidoras, y trabajos diversos de viabilidad o revisión de literatura. Esas categorías contenían 60, 18, 41 y 23 artículos respectivamente en la revisión (systematic review of healthcare Monte Carlo applications).
Los investigadores clínicos pueden usar cohortes simuladas para examinar cómo varía la respuesta al tratamiento según las características del paciente, cómo afecta la inscripción incompleta a las conclusiones del ensayo, o cómo se comportan las terapias competidoras a lo largo de una trayectoria prolongada. Los métodos de Monte Carlo son particularmente valiosos para la optimización de terapias contra el cáncer, la medicina personalizada, la predicción de resultados de enfermedades y la evaluación de beneficios y riesgos. Una revisión de atención médica también señala que las curvas terapéuticas de antibióticos simuladas pueden coincidir estrechamente con los resultados experimentales, mientras que la regresión bayesiana de Monte Carlo puede adaptarse a conjuntos de datos epidemiológicos limitados pero complejos (Monte Carlo in healthcare decision modeling).
El riesgo de los datos es inusualmente trascendental. Registros de pacientes faltantes, codificación inconsistente de eventos adversos, informes de resultados retrasados o un cambio en el esquema de la historia clínica electrónica pueden alterar la forma aparente de una distribución sin cambiar el código de simulación.
La confiabilidad depende del linaje de los datos clínicos
Los equipos de atención médica deben conectar cada entrada de modelo con controles que respondan:
¿Están completos los campos requeridos? Las reglas de Data Validation pueden comprobar registros de pacientes, tratamientos, inscripciones y resultados.
¿Se comportan de manera plausible los eventos adversos? La detección de anomalías puede revelar patrones de informes inusuales para su investigación.
¿Llegan los resultados a tiempo? El monitoreo de Timeliness distingue un cambio real de un retraso en los informes.
¿Cambió la estructura de origen? El seguimiento de esquemas puede identificar modificaciones en los registros electrónicos antes de que fallen las canalizaciones.
Ese es el propósito de clinical data validation and regulatory rules at scale. En este entorno, la Observability no es simplemente una conveniencia de ingeniería. Ayuda a preservar la pista de auditoría entre los registros de origen, la incertidumbre modelada y una decisión que puede afectar a los pacientes o a las presentaciones regulatorias.
3. Optimización de la cadena de suministro y logística
Los modelos de cadena de suministro rara vez fallan porque los planificadores hayan olvidado que la demanda es incierta. Fallan porque la incertidumbre se representó utilizando datos que ya no describen las operaciones actuales. La simulación de Monte Carlo puede combinar la demanda variable, los tiempos de entrega de los proveedores, los retrasos en el transporte, las posiciones de inventario y los costos logísticos para evaluar las políticas de existencias y las opciones de distribución bajo muchas condiciones posibles.
Un equipo de almacén podría usar el modelo para comparar estrategias de reabastecimiento. Un planificador de logística podría examinar cómo interactúan los envíos tardíos de los proveedores con los aumentos repentinos de la demanda y las interrupciones en el transporte. El resultado útil no es un único objetivo de inventario. Es una perspectiva de la relación de compromiso entre la disponibilidad, el capital de trabajo, el riesgo de servicio y la resiliencia operativa.
Observe las entradas que dan forma al rango de escenarios
Los datos de la cadena de suministro necesitan controles en varios puntos:
Validación de tiempos de entrega: Comprobar que los registros de proveedores y transportistas contengan valores plausibles y unidades consistentes.
Revisión de anomalías en la demanda: Investigar cambios abruptos en los pronósticos o pedidos antes de ajustar distribuciones a ellos.
Oportunidad en la entrega: Detectar eventos de envío faltantes y confirmaciones tardías que pueden hacer que el inventario actual parezca más saludable de lo que realmente está.
Seguimiento de cambios en el esquema: Monitorear los sistemas de logística y almacén en busca de cambios estructurales que puedan eliminar o reinterpretar campos.
La canalización general importa tanto como el cuaderno de simulación. Una data pipeline architecture built for reliable movement and transformation brinda a los equipos un lugar más claro para monitorear la ingesta, las transformaciones y el consumo posterior.
Amazon, Walmart y Unilever se citan a menudo en las discusiones de la industria sobre la planificación de inventarios, instalaciones y redes liderada por simulaciones, pero la lección operativa es más general. Un modelo no puede inferir si un aumento en el tiempo de entrega refleja un problema real del proveedor, una convención de marca de tiempo modificada o una transmisión retrasada. La Observability debe hacer visible esa distinción antes de que los planificadores actúen sobre el resultado.
4. Predicción de reclamaciones de seguros y modelos de precios
La simulación de seguros es tan confiable como los datos de reclamaciones detrás de ella. Los modelos de precios y reservas representan la incertidumbre en la frecuencia de las reclamaciones y la gravedad de las reclamaciones. La simulación de Monte Carlo permite a los actuarios estimar posibles pérdidas, probar la suficiencia de las reservas, comparar supuestos de precios y examinar la exposición a la solvencia en diversas condiciones. También respalda el análisis de catástrofes y de activos-pasivos, donde los promedios pueden ocultar el riesgo de cola (Monte Carlo uses in finance and insurance).
La clasificación de las reclamaciones determina si un cambio simulado refleja una exposición o un movimiento de datos. Un aumento en las pérdidas graves puede deberse a un riesgo real, a un cambio en la gestión de reclamaciones, a registros duplicados o a una codificación revisada. Si los analistas tratan cada cambio como un evento comercial, la aseguradora puede fijar precios basándose en un defecto en sus datos de origen.
Separar el movimiento actuarial del movimiento de datos
Antes de ejecutar simulaciones de precios o reservas, los equipos deben:
Validar la integridad de las reclamaciones: Comprobar los campos requeridos, las relaciones de las pólizas, las reglas de cobertura y la lógica de clasificación.
Investigar una gravedad inusual: Comparar los patrones de reclamaciones con la exposición y los registros históricos para identificar posibles problemas de calidad de los datos.
Monitorear los calendarios de procesamiento: Rastrear si las entradas de reclamaciones y los ajustes de reservas llegan a tiempo.
Registrar cambios en el esquema: Identificar modificaciones en el sistema de reclamaciones que podrían alterar los extractos actuariales o las fórmulas posteriores.
La Observability debe conectar estos controles de entrada con las señales comerciales. Un campo de cobertura faltante puede afectar la segmentación, mientras que las actualizaciones de reservas retrasadas pueden hacer que los pasivos actuales parezcan inferiores a lo que son. Por lo tanto, el monitoreo debe mostrar tanto la condición de los datos como el cambio resultante en los precios, las reservas o las medidas de riesgo.
State Farm, Lloyd's of London y Berkshire Hathaway están asociados con el modelado de seguros, incluidos los trabajos de reservas, catástrofes y precios. Sus ejemplos no reemplazan la validación local. Las definiciones de exposición, los procedimientos de reclamaciones y el comportamiento de los sistemas de origen difieren según la aseguradora, por lo que una distribución adecuada para una cartera puede no adaptarse a otra.
Para la solución de Servicios Financieros de digna, la conexión operativa es directa. La validación protege las reglas comerciales, la detección de anomalías desafía patrones de reclamaciones inesperados, el monitoreo de Timeliness expone reservas obsoletas y el seguimiento de esquemas ayuda a preservar la continuidad del modelo.
5. Exploración de petróleo y gas e estimación de reservas
Las decisiones sobre el subsuelo se construyen en torno a un conocimiento incompleto. Los geólogos e ingenieros utilizan la simulación de Monte Carlo para representar la incertidumbre en el tamaño del yacimiento, los factores de recuperación, los costos de perforación, el comportamiento de la producción y la economía del proyecto. La distribución resultante ayuda a los equipos a evaluar las estimaciones de reservas, la viabilidad de la perforación, las opciones de cartera y las consecuencias de diferentes interpretaciones geológicas.
Un modelo de reserva puede ser matemáticamente correcto y, aun así, operativamente engañoso. Los datos de interpretación sísmica pueden ser revisados, las mediciones de los pozos pueden llegar tarde o las lecturas de producción pueden cambiar porque el equipo se ha degradado. Si esos cambios no se distinguen de la variación ordinaria, la simulación puede asignar probabilidad a un problema de medición en lugar de a una posibilidad geológica.
Preservar el significado de los datos de campo
Los controles útiles incluyen:
Validación de interpretación: Comprobar las entradas sísmicas y los campos de confianza frente a umbrales de calidad definidos.
Oportunidad en la producción: Marcar informes de pozos retrasados o faltantes antes de que los modelos de actualización de reservas consuman un historial incompleto.
Detección de anomalías en las mediciones: Investigar patrones de producción inusuales que podrían indicar problemas en los equipos o errores en los sensores.
Seguimiento de esquemas de registros de pozos: Detectar cambios estructurales en los sistemas de registro antes de que fallen las herramientas de interpretación o los extractos.
Shell, ExxonMobil y Saudi Aramco son ejemplos asociados con la simulación en la estimación de reservas, la evaluación de proyectos y la planificación del desarrollo de campos. Su escala también ilustra por qué la Observability debe estar cerca de la plataforma de datos. Los grandes entornos operativos producen revisiones frecuentes, y un modelo necesita suposiciones versionadas y un linaje de entrada visible si se espera que los tomadores de decisiones defiendan sus resultados.
La relación de compromiso central es velocidad frente a escrutinio. Las actualizaciones de modelos más rápidas pueden respaldar una planificación más ágil, pero solo cuando los equipos pueden ver si los nuevos datos están completos, a tiempo y son estructuralmente comparables con la ejecución anterior.
6. Planificación de la capacidad de la red de telecomunicaciones
Los operadores de telecomunicaciones utilizan la simulación de Monte Carlo para explorar el crecimiento incierto del tráfico, las adiciones de suscriptores, las tasas de consumo de datos, la adopción de tecnologías y la demanda de infraestructura. El modelo ayuda a los planificadores a comparar las opciones de inversión en red frente a un rango de cargas posibles en lugar de comprometerse con una única trayectoria de crecimiento.
Esta aplicación expone una condición de datos particularmente difícil: el comportamiento de la red cambia con el tiempo. Es posible que un patrón de tráfico que era normal antes del lanzamiento de un producto, un corte, un ataque DDoS o una migración tecnológica ya no proporcione una base estable para el muestreo futuro. Tratar todas las observaciones históricas como intercambiables puede hacer que una simulación sea precisa pero esté mal calibrada.
Hacer visible el comportamiento cambiante de la red
Un flujo de trabajo de capacidad debería combinar:
Validación de mediciones: Comprobar las métricas de tráfico regional para asegurar su integridad, consistencia de unidades y rangos plausibles.
Oportunidad en la transmisión de datos: Detectar cargas de análisis retrasadas antes de que los planificadores dependan de proyecciones de tráfico obsoletas.
Detección de anomalías en el uso: Separar la demanda inusual de los clientes de los fallos de red, ataques y errores de medición.
Monitoreo de esquemas de gestión: Rastrear cambios en los sistemas de red que podrían romper las métricas o alterar su significado.
Verizon, Deutsche Telekom y China Mobile son ejemplos asociados con la simulación para la planificación del despliegue, la capacidad y el crecimiento de suscriptores. Sus entornos operativos difieren, por lo que la pregunta de implementación más importante no es si Monte Carlo puede ejecutarse, sino si los datos reflejan las mismas definiciones de servicio, geografía y lógica de medición en todos los períodos comparados.
La solución de Telecomunicaciones de digna puede conectar estos controles a través de datos operativos y de clientes de alto volumen. Eso respalda un flujo de trabajo más defendible, donde una alerta de capacidad incluye no solo el riesgo simulado sino también evidencia sobre la frescura e integridad de los registros detrás de él.
Una distribución de tráfico solo es útil si el equipo conoce qué régimen operativo la produjo.
7. Modelado de impacto ambiental y del cambio climático
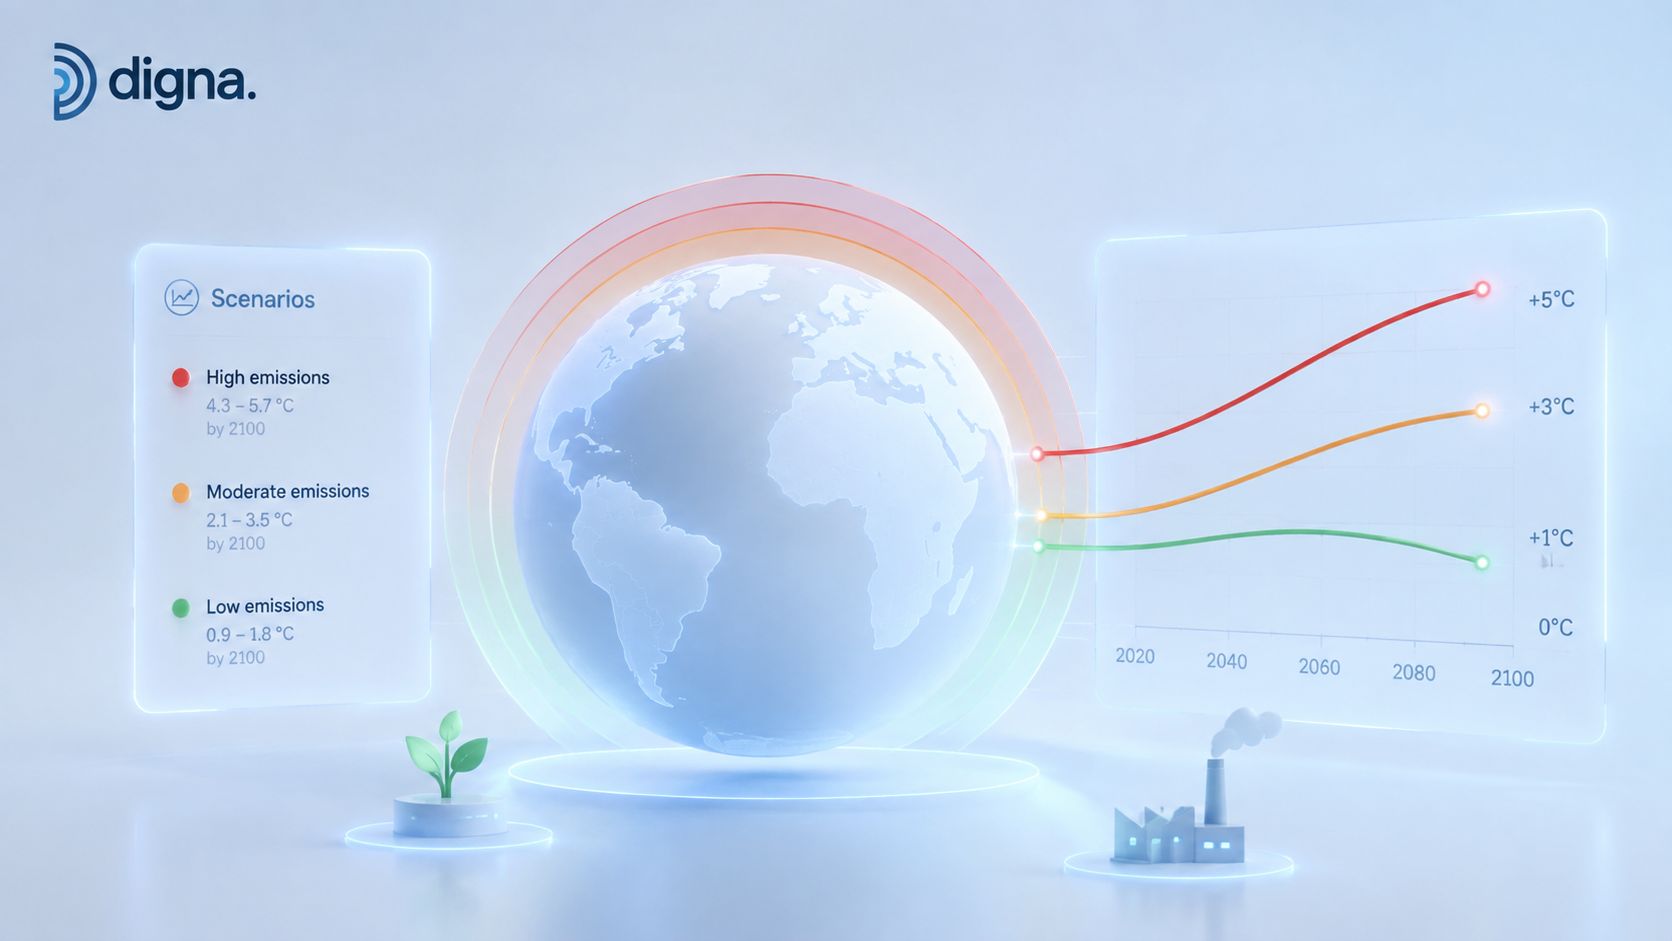
Las simulaciones climáticas son tan creíbles como las condiciones de los datos detrás de sus rangos de incertidumbre. Los modelos ambientales combinan observaciones, parámetros, trayectorias de emisiones, respuestas físicas y supuestos de políticas. Los métodos de Monte Carlo propagan la variación a través de esas entradas, lo que permite a los investigadores examinar una distribución de posibles impactos en lugar de reportar un único futuro determinista. Se utilizan en la ciencia del clima y en otros campos científicos para evaluar cómo las entradas inciertas afectan los resultados del modelo.
El principal riesgo de los datos es la inconsistencia estructural. Los sensores ambientales, los productos satelitales, los registros de estaciones y los conjuntos de datos modelados pueden diferir en resolución, calibración, marcas de tiempo y definiciones. Si esas diferencias no se documentan, una simulación puede interpretar un cambio en el sistema de observación como una señal climática. Por lo tanto, los resultados estables requieren tanto un análisis estadístico como controles sobre la procedencia, el versionado y el preprocesamiento.
Tratar la procedencia como parte del modelo
Los equipos ambientales pueden monitorear las entradas y decisiones comerciales conectadas a cada ejecución mediante:
Validación de observaciones: Comprobar la consistencia entre estaciones, períodos, unidades y métodos de recolección.
Monitoreo de patrones de llegada: Marcar transmisiones de sensores faltantes o retrasadas antes de que una ventana de tiempo incompleta entre en la ejecución del modelo.
Detección de anomalías en las mediciones: Investigar picos que puedan resultar de los instrumentos, el preprocesamiento o la transmisión en lugar de un cambio ambiental.
Seguimiento de la estructura de la canalización: Registrar cambios en el esquema, origen y transformación a lo largo de los flujos de trabajo de datos climáticos y satelitales.
Los statistical methods for data analysis utilizados en estos flujos de trabajo deben examinar la volatilidad de las entradas, identificar comportamientos inusuales y preservar evidencia sobre los registros detrás de cada resultado. El monitoreo también debe conectar los resultados de la simulación con decisiones tales como supuestos de inversión, prioridades de adaptación y escenarios de políticas.
El trabajo de evaluación del IPCC, el análisis de riesgo climático del Banco Mundial y el análisis de escenarios climáticos utilizados en las decisiones de inversión involucran a diferentes partes interesadas, pero comparten un requisito de gobernanza: los analistas deben separar la incertidumbre en las condiciones ambientales de la incertidumbre introducida por la canalización de datos.
8. Control de calidad de fabricación y predicción de la tasa de defectos
Los equipos de fabricación utilizan la simulación de Monte Carlo para estimar cómo afecta la variación en el rendimiento de las máquinas, las características de los materiales, las tolerancias, la configuración de los procesos y los resultados de las inspecciones a las tasas de defectos. Propagar estas distribuciones a través de un modelo de producción ayuda a los ingenieros a comparar estrategias de control de calidad y probar la confiabilidad bajo condiciones operativas cambiantes.
Las aplicaciones de ingeniería incluyen análisis de tolerancia, diseño de confiabilidad, incertidumbre de medición, análisis de errores robóticos y optimización de diseño (engineering applications of Monte Carlo methods). El método es útil porque los defectos pueden surgir de interacciones entre variables. Un componente puede cumplir con su especificación individual mientras que las tolerancias combinadas crean una falla en el producto terminado.
Detectar la deriva del proceso antes de que se convierta en una suposición del modelo
Los resultados de la simulación dependen de definiciones estables y mediciones oportunas. La Observability de producción debería incluir:
Validación de sensores: Comparar lecturas con rangos permitidos y relaciones de proceso conocidas.
Oportunidad en la inspección: Marcar informes de calidad retrasados antes de que los registros faltantes oculten un patrón de defectos recurrente.
Detección de anomalías en defectos: Investigar concentraciones inusuales por línea, turno, máquina, material o producto.
Seguimiento de esquemas: Detectar cambios en los registros de gestión de calidad antes de que las herramientas analíticas lean incorrectamente los campos de inspección.
Toyota, Intel y Siemens están asociados con la simulación para la optimización de la producción, el rendimiento de semiconductores y el aseguramiento de la calidad industrial. Estos ejemplos apuntan al mismo requisito de implementación: una distribución histórica de defectos es insuficiente cuando el sistema de medición, el proceso de inspección o la definición del producto han cambiado.
Monitorear las entradas del modelo y los resultados comerciales de manera conjunta. Las anomalías de entrada pueden explicar un cambio en el rango de defectos simulado, mientras que el monitoreo de resultados puede mostrar si las señales de chatarra, reproceso, rendimiento o garantía se han movido más allá del comportamiento establecido. Esta conexión ayuda a los equipos de calidad a distinguir un cambio real del proceso de un problema de datos o de canalización antes de modificar los controles de producción.
9. Planificación presupuestaria del sector público y análisis de impacto fiscal
Los presupuestos del sector público combinan ingresos, gastos, participación, condiciones económicas y efectos de políticas que son inciertos. La simulación de Monte Carlo ayuda a las agencias a examinar cómo interactúan esas variables en posibles futuros fiscales. En lugar de depender de una única estimación de ingresos o de un único supuesto de participación, los planificadores pueden evaluar el rango de resultados y las relaciones de compromiso asociadas con las opciones de políticas.
Este trabajo conlleva un requisito de rendición de cuentas distintivo. Los datos de impuestos, beneficios, pensiones e indicadores económicos a menudo alimentan análisis formales, informes públicos y procesos de auditoría. Un período de informe faltante o un campo de elegibilidad modificado pueden alterar la distribución fiscal aparente mientras dejan el cálculo técnicamente ejecutable.
Incorporar la auditabilidad en cada entrada modelada
Las agencias deberían utilizar:
Validación basada en reglas: Aplicar lógica de elegibilidad, impuestos, beneficios y conciliación antes de que se acepten las entradas de la simulación.
Monitoreo de Timeliness: Rastrear la entrega esperada para recaudaciones, participación y datos económicos.
Revisión de anomalías: Investigar patrones inusuales de impuestos o pagos que puedan indicar problemas operativos o de calidad de los datos.
Historial de esquemas: Preservar la evidencia cuando los sistemas de impuestos y beneficios cambian de estructura.
La Oficina de Presupuesto del Congreso, el FMI y la planificación de pensiones de California son ejemplos asociados con análisis fiscales, de deuda u obligaciones basados en Monte Carlo. La lección subyacente no es que cada agencia deba copiar el modelo de otra institución, sino que las decisiones públicas necesitan una cadena visible desde el registro de origen hasta el supuesto y el resultado simulado.
La solución para el Sector Público de digna puede respaldar esa cadena mediante validación, seguimiento de Timeliness, detección de anomalías y monitoreo de esquemas. Esos controles no deciden qué política es mejor. Ayudan a los tomadores de decisiones a comprender si la evidencia que respalda cada opción está completa, actualizada y estructuralmente estable.
10. Monitoreo comercial y detección de anomalías en KPIs
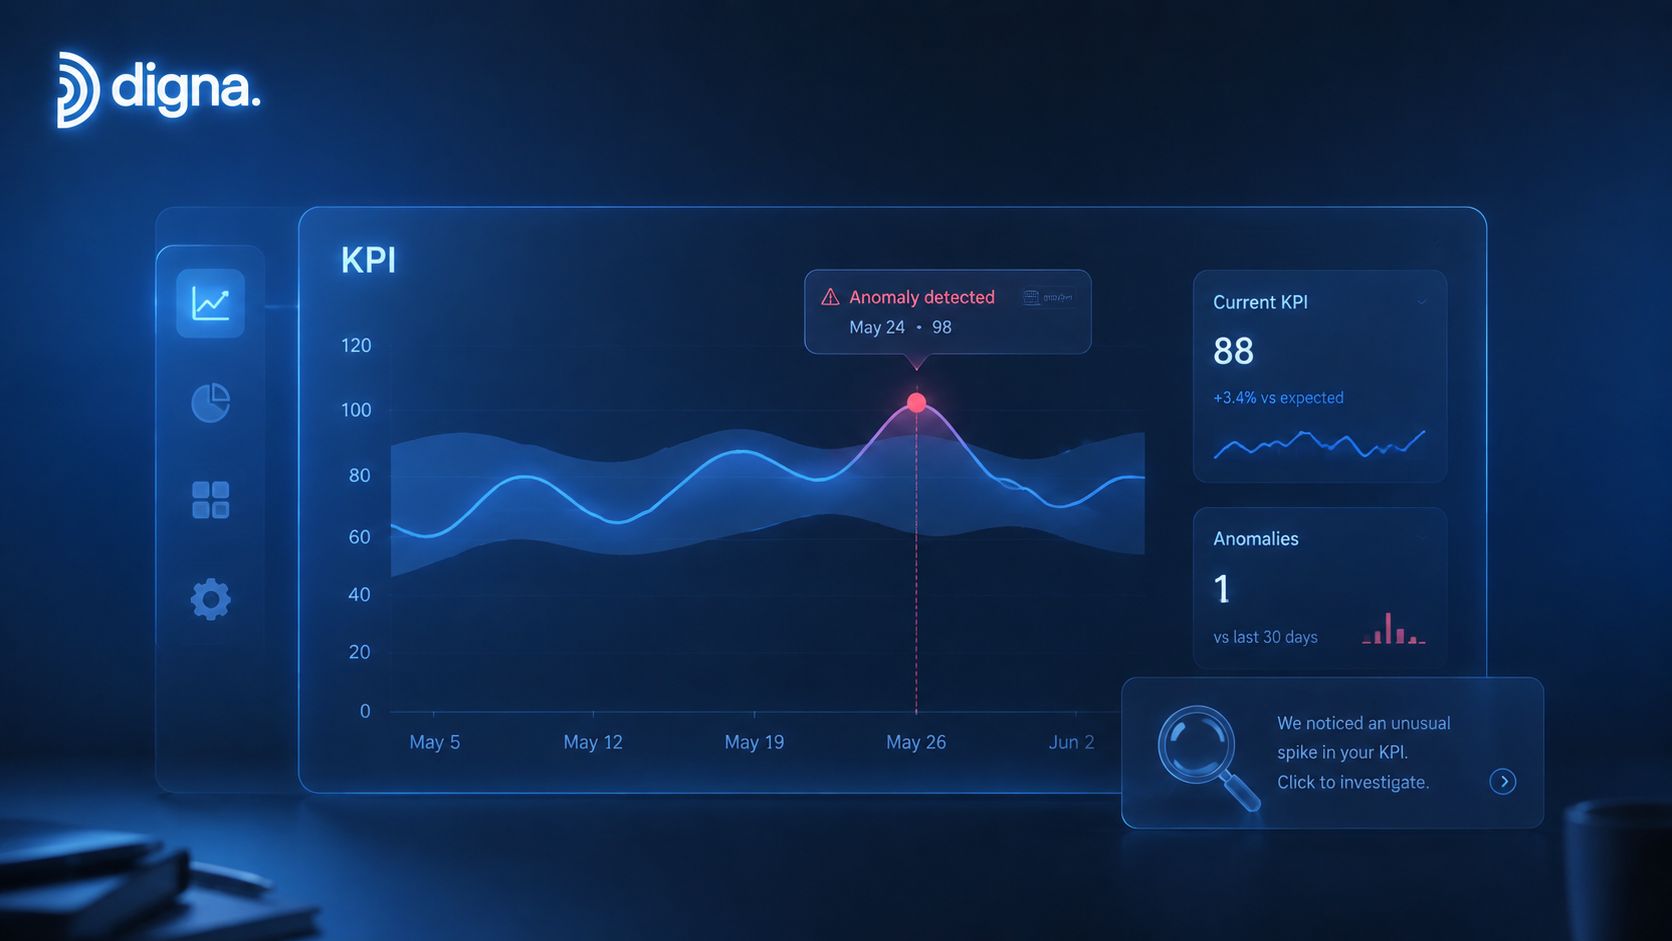
La simulación de Monte Carlo puede respaldar el monitoreo comercial al convertir la demanda incierta, la eficiencia operativa, el comportamiento del cliente y las condiciones del mercado en rangos esperados para los indicadores clave de rendimiento (KPIs). Los equipos pueden comparar los resultados reales con el comportamiento modelado e investigar aquellos resultados que queden fuera del rango que consideran plausible.
Esta aplicación traslada a Monte Carlo de la planificación periódica a la Observability operativa. Un equipo de comercio electrónico puede monitorear pedidos y devoluciones. Un equipo de servicios financieros puede examinar volúmenes de operaciones y diferenciales. Un equipo de SaaS puede vigilar la pérdida de clientes (churn) y el uso. En cada caso, la alerta solo es útil si el cálculo del KPI subyacente es correcto y está actualizado.
Monitorear tanto la métrica como su explicación
Un flujo de trabajo confiable debería:
Validar transacciones: Comprobar los registros utilizados para calcular ingresos, pedidos, devoluciones, pérdida de clientes o uso.
Rastrear la oportunidad del KPI: Alertar cuando una métrica llegue tarde o un cálculo programado no cumpla con su patrón de entrega esperado.
Comparar tipos de anomalías: Revisar las Data Anomalies estadísticas junto con las anomalías de KPIs comerciales.
Comprobar el impacto estructural: Usar el historial de esquemas para determinar si un campo modificado alteró la definición del KPI.
La time-series anomaly detection de digna es relevante para este modelo operativo porque los equipos necesitan distinguir el movimiento comercial real del comportamiento de datos que solo parece movimiento. Una fleet operations reporting guide compartida también ilustra por qué los informes operativos dependen de procesos confiables de origen y entrega.
La alerta más útil no dice simplemente que un KPI es inusual. Ayuda a responder si el negocio cambió, los datos cambiaron o las suposiciones del modelo ya no se ajustan.
Simulación de Monte Carlo: Comparación de 10 aplicaciones
Aplicación | 🔄 Complejidad de la implementación | ⚡ Requerimientos de recursos | 📊 Resultados esperados | Casos de uso ideales | ⭐ Ventajas clave e 💡 idea práctica |
|---|---|---|---|---|---|
Evaluación de riesgos financieros y modelado de carteras | Alta, modelos estocásticos avanzados y calibración | Alto, gran procesamiento, datos de mercado de alta frecuencia, experiencia cuantitativa | VaR/CVaR probabilístico, pruebas de estrés, estimaciones de riesgo de cola | Bancos, gestores de activos, valoración de derivados, informes regulatorios | ⭐ Captura el riesgo no lineal/de cola; respalda el Compliance. 💡 Valide la calidad y Timeliness de los datos de entrada. |
Desarrollo de fármacos y simulación de ensayos clínicos | Alta, modelos de población y farmacodinámicos complejos | Alto, grandes conjuntos de datos clínicos, controles de privacidad, procesamiento | Probabilidades de éxito del ensayo, optimización del tamaño de la muestra, reducción de costos/tiempo | I+D farmacéutico, diseño de ensayos, justificación regulatoria | ⭐ Predice los resultados de los ensayos; permite diseños adaptativos. 💡 Asegure la integridad de los datos clínicos y el cumplimiento de la privacidad. |
Optimización de la cadena de suministro y logística | Media‑Alta, redes multinodo e integraciones | Medio, demanda histórica, transmisiones de proveedores, esfuerzo de integración | Niveles de inventario optimizados, costos reducidos, niveles de servicio mejorados | Venta minorista, fabricación, 3PLs, planificación de redes de distribución | ⭐ Reduce los costos de almacenamiento e identifica vulnerabilidades en la red. 💡 Monitoree la calidad de los datos de tiempo de entrega del proveedor. |
Predicción de reclamaciones de seguros y modelos de precios | Alta, modelos actuariales y controles regulatorios | Medio‑Alto, historial de reclamaciones, bases de datos de exposición, experiencia actuarial | Suficiencia de primas, estimaciones de reservas, probabilidades de solvencia | Aseguradoras, reaseguradoras, fijación de precios de catástrofes, establecimiento de reservas | ⭐ Alinea los precios con el riesgo; valida reservas para los reguladores. 💡 Valide la integridad de las reclamaciones y monitoree picos anómalos. |
Exploración de petróleo y gas e estimación de reservas | Alta, modelado de incertidumbre en geociencia + ingeniería | Alto, datos sísmicos/de producción, expertos de dominio, procesamiento | Estimaciones de reservas P10/P50/P90, distribuciones de VAN, riesgo de cartera | Evaluación de carteras de exploración, informes de reservas, cribado de proyectos | ⭐ Cuantifica el riesgo de exploración para la asignación de capital. 💡 Verifique la Timeliness y calidad de los datos sísmicos y de producción. |
Telecommunications Network Capacity Planning | Media, modelos de tráfico variables en el tiempo y granularidad geográfica | Medio, telemetría de red, datos de suscriptores, integración | Pronósticos de capacidad, probabilidades de congestión, guía de CAPEX | Operadores de telefonía móvil/fija que planifican despliegues de 5G/fibra | ⭐ Optimiza el CAPEX; identifica cuellos de botella antes de los cortes. 💡 Valide las mediciones de tráfico y monitoree la Timeliness de las transmisiones. |
Modelado de impacto ambiental y del cambio climático | Alta, incertidumbre multimodelo de largo horizonte | Alto, conjuntos de datos satelitales/de sensores, conjuntos de modelos, procesamiento | Escenarios climáticos probabilísticos, comparaciones de efectividad de políticas | Ciencia del clima, agencias de políticas, análisis de finanzas sostenibles | ⭐ Cuantifica el riesgo climático y las relaciones de compromiso de las políticas. 💡 Asegure la consistencia de los datos de observación entre estaciones/fuentes. |
Manufacturing Quality Control and Defect Rate Prediction | Media, capacidad de procesos y modelado de escenarios de causa raíz | Medio, sensores de producción, datos históricos de ejecución, analítica | Pronósticos de tasas de defectos, muestreo optimizado, chatarra reducida | Automotriz, fábricas de semiconductores, líneas de fabricación discreta | ⭐ Reduce la chatarra y optimiza los planes de inspección. 💡 Valide las lecturas de los sensores y monitoree la Timeliness de la inspección. |
Planificación presupuestaria del sector público y análisis de impacto fiscal | Media‑Alta, diseño de escenarios macroeconómicos y supuestos | Medio, conjuntos de datos de impuestos, programas e indicadores económicos | Distribuciones de riesgo fiscal, sostenibilidad de la deuda, probabilidades de impacto de políticas | Oficinas de presupuesto del gobierno, análisis de políticas fiscales, previsión de pensiones | ⭐ Cuantifica de manera transparente los riesgos fiscales para las decisiones de políticas. 💡 Valide los datos del programa y rastree los calendarios de informes. |
Monitoreo comercial y detección de anomalías en KPIs | Media, líneas de base de series temporales y escenarios multidimensionales | Medio, datos transaccionales/operativos, infraestructura de monitoreo | Líneas de base dinámicas de KPIs, detección más temprana de anomalías, falsos positivos reducidos | Operaciones de diversas industrias, comercio electrónico, SaaS, monitoreo financiero | ⭐ Detecta anomalías antes y reduce las alertas falsas. 💡 Combine modelos de línea base con Data Validation y seguimiento de esquemas. |
De escenarios simulados a decisiones confiables
A través de estas diez aplicaciones de simulación de Monte Carlo, aparece el mismo patrón de implementación. El modelo comienza definiendo entradas inciertas como distribuciones, conectando esas entradas a través de una estructura matemática e interpretando los resultados como probabilidades en lugar de garantías. Pero esa es solo la capa analítica. La capa operativa determina si las distribuciones aún describen el sistema que se está gestionando.
Comience con los registros de origen. La Data Validation debe confirmar los campos requeridos, los valores permitidos, las relaciones, las unidades y las reglas comerciales antes de que las entradas lleguen al modelo. Esto importa en posiciones financieras, registros clínicos, tiempos de entrega de proveedores, clasificaciones de reclamaciones, producción de pozos, tráfico de red, observaciones climáticas, sensores de fábrica, registros fiscales y transacciones de KPIs. Una simulación no repara un registro roto, sino que propaga la influencia de ese registro a través de cada escenario resultante.
Luego, confirme los tiempos de entrega. Un conjunto de datos puede ser preciso al llegar y, aun así, no ser utilizable para una decisión urgente si llega después de la ejecución del modelo. El monitoreo de Timeliness debe aprender el comportamiento de entrega esperado, marcar cargas faltantes o retrasadas y distinguir un retraso operativo de una variación de calendario ordinaria. Esto es particularmente importante donde las simulaciones se actualizan con frecuencia o donde las decisiones dependen de las condiciones actuales.
A continuación, monitoree las anomalías tanto en las entradas como en los resultados. Una entrada inusual puede representar un evento real, un error de medición, un duplicado, un defecto de transformación o un cambio de régimen. Un resultado inusual puede reflejar una señal comercial real o un cálculo ascendente corrupto. Revisar ambos lados brinda a los analistas una mejor oportunidad de identificar la causa en lugar de reaccionar al síntoma.
Por último, rastree el cambio estructural. Columnas agregadas o eliminadas, modificaciones en el tipo de datos, definiciones modificadas y una lógica alterada del sistema de origen pueden invalidar una canalización sin producir un error de software obvio. Por lo tanto, el monitoreo estructural debe situarse junto al monitoreo estadístico, no detrás de él.
La investigación también destaca por qué importa esta disciplina. Un caso de estudio de evaluación del ciclo de vida del MIT utilizó la varianza como una aproximación para la incertidumbre y descubrió que su tasa de señal falsa/error falso cayó del 21% inicialmente al 6.1% después de resolver 20 parámetros, y luego se estabilizó en el 5.8% después de resolver 39 parámetros (MIT life-cycle assessment case study). El resultado respalda una conclusión práctica: el refinamiento iterativo de los parámetros inciertos puede mejorar materialmente la confiabilidad de las decisiones. Esto no significa que cada modelo vaya a producir la misma mejora.
El procesamiento también importa. En un punto de referencia de Monte Carlo cinético distribuido, la paralelización redujo el tiempo de ejecución normalizado de 19.7 horas por unidad de tiempo de KMC en una ejecución secuencial a 1.3 horas en 625 unidades de procesamiento, una aceleración de aproximadamente 15 veces. Un volumen de trabajo que habría tomado un poco más de 1.5 años secuencialmente se completó en 38 días (distributed kinetic Monte Carlo benchmark). Una ejecución más rápida puede hacer que un modelo sea operativo, pero la velocidad no resuelve las estructuras de dependencia incorrectas o los regímenes cambiantes.
Ese es el problema sin resolver en muchas implementaciones modernas. Las revisiones señalan la complejidad del código, los largos tiempos de cálculo y los datos de ajuste limitados en la terapia de partículas (review of Monte Carlo adoption constraints). Un artículo sobre riesgos de proyectos de 2025 también describe brechas en el análisis integrado de costos y cronogramas, la evolución diaria del riesgo y las dependencias explícitas en las que un evento cambia el tiempo y la probabilidad de eventos posteriores (2025 project-risk research). La lección contraria es importante: la parte más difícil a menudo no es ejecutar más pruebas, sino representar correctamente la correlación, la dependencia del tiempo, la evolución y el cambio de régimen.
digna puede respaldar este flujo de trabajo dentro del propio entorno del cliente a través de la ejecución en base de datos, implementaciones en la nube privada o en instalaciones locales, capacidades modulares de Observability y un panel compartido para ingenieros, analistas y partes interesadas. Sus módulos cubren la detección de anomalías, la validación, la Timeliness, el seguimiento de esquemas, el monitoreo comercial y la Observability de la plataforma, de modo que los equipos puedan comenzar con el control más cercano a un modelo crítico y expandirse a medida que crezca el uso.
Comience con un conjunto de datos o KPI crítico. Documente su comportamiento esperado, dependencias de origen, calendario de entrega, reglas de validación y supuestos estructurales. Luego, monitoree las entradas y salidas de manera conjunta antes de extender el mismo patrón a modelos de Monte Carlo adicionales.
digna proporciona Observability de datos en el entorno con validación, monitoreo de Timeliness, detección de anomalías, seguimiento de esquemas y monitoreo comercial para los datos que alimentan los modelos de simulación. Comience con un conjunto de datos o KPI crítico, luego visite digna para explorar cómo la plataforma puede ayudar a conectar los resultados de la simulación con evidencia operativa de confianza.


