Evaluación de riesgos de Montecarlo: una guía práctica
|
7
minuto de lectura
La mañana del lunes comienza con una anomalía en el tablero de control que nadie puede explicar. Los ingresos parecen haber aumentado drásticamente, finanzas convoca a una revisión urgente y los ingenieros comienzan a rastrear registros en los trabajos de ingesta, transformación y generación de informes. Hacia el mediodía, el equipo descubre que un retraso en una canalización ascendente hizo que las transacciones del sábado se contaran dos veces. La alerta funcionó, pero la respuesta seguía careciendo de la cifra que la dirección necesitaba: ¿qué tan probable era el error, qué tan grande podría llegar a ser la exposición y qué decisión debería cambiar debido a ello?
Esa distinción define la evaluación de riesgos de Monte Carlo. Una alerta de calidad de datos le indica que algo se ha salido de un patrón esperado. Una simulación estima el rango de resultados comerciales que podrían seguir, utilizando la incertidumbre de la latencia de la canalización, los volúmenes de registros, las fallas de validación y el uso descendente. El método conecta "los datos pueden ser incorrectos" con "esta es la probabilidad y el impacto contra el que debemos planificar".
Tabla de Contenidos
Cuando el verdadero riesgo son los datos detrás del tablero de control
Las alertas describen eventos, no la exposición
De datos rotos a una decisión defendible
La idea central detrás de la evaluación de riesgos de Monte Carlo
Traducir la pregunta en una simulación
Los tres ingredientes
Las cinco etapas de un flujo de trabajo de simulación confiable
Etapa uno: enmarcar la decisión
Etapa dos: buscar la fuente de la incertidumbre
Etapa tres: construir el modelo de propagación
Etapa cuatro: ejecutar y preservar
Etapa cinco: comunicar la distribución
Construir el modelo dentro de su plataforma de datos
Convertir la telemetría en entradas
Propagar la incertidumbre a través de la lógica de negocio
Leer los resultados como un analista de riesgos
Tres artefactos que merecen atención
Informar sobre el extremo de la distribución, no solo el centro
Errores que hacen que las simulaciones no sean auditables
La independencia suele ser una ficción conveniente
El extremo de la distribución desaparece cuando la forma es incorrecta
Dos ejemplos del mundo real de finanzas y calidad de datos
La calidad de los datos tiene la misma estructura
La Observability se convierte en la capa de muestreo
Elegir cuándo Monte Carlo es la herramienta adecuada
Cuando el verdadero riesgo son los datos detrás del tablero de control
A las 8 a.m., el director financiero observa un aumento inesperado en los ingresos y le pide a finanzas que lo valide antes de la reunión ejecutiva. Los analistas comparan el tablero de control con el almacén de datos, los ingenieros inspeccionan los registros de orquestación y los propietarios de datos verifican si el sistema de origen cambió. Cada persona tiene una parte de la historia, pero nadie puede cuantificar de inmediato la exposición.
Hacia el final de la mañana, la causa raíz está clara. Una carga ascendente retrasada duplicó las transacciones del sábado. El tablero de control no solo mostraba un valor inusual. Estaba presentando una decisión comercial basada en una ruta de datos comprometida.

Las alertas describen eventos, no la exposición
El equipo contaba con monitoreo. Podía identificar un trabajo retrasado, un cambio en el recuento de filas o una métrica inesperada. Lo que no podía responder era cómo podría propagarse la falla:
Duración: ¿Cuánto tiempo podría permanecer incorrecta la canalización antes de ser detectada?
Alcance: ¿Qué tablas, informes y modelos podrían heredar el defecto?
Efecto comercial: ¿Qué decisiones de ingresos, riesgo o Compliance podrían verse afectadas?
Respuesta: ¿Debería finanzas pausar la presentación de informes, aplicar una corrección o continuar con una advertencia documentada?
Ese es el fallo más profundo. Las alertas son observaciones. La evaluación de riesgos es el soporte para la toma de decisiones. Un programa de Data Observability puede ayudar a los equipos a comprender la salud y el comportamiento de los conjuntos de datos, como se describe en la presentación general de digna sobre Data Observability, pero el siguiente paso es traducir esas observaciones en resultados probables.
De datos rotos a una decisión defendible
Un modelo de Monte Carlo puede muestrear combinaciones plausibles de retraso en la entrega, volumen de duplicados, tiempo de corrección y uso del tablero de control. Cada ejecución representa un posible escenario operativo. El resultado se convierte en una distribución de la exposición en lugar de una única estimación.
Ese cambio es importante tanto durante la respuesta a incidentes como en la governance rutinaria. En lugar de decirle a la dirección que "la tabla de ingresos no es confiable", el equipo de datos puede presentar un rango, identificar los factores desencadenantes de la incertidumbre y señalar qué umbral es probable que se supere. El resto de esta guía convierte ese puente en un flujo de trabajo reutilizable para los equipos de almacenes de datos y canalizaciones, tratando la auditabilidad como parte del modelo y no como una idea de último momento.
La idea central detrás de la evaluación de riesgos de Monte Carlo
Se debe entregar un tablero de control de ingresos del viernes, pero su tabla de origen a veces llega tarde. Una ejecución puede mostrar una actualización normal, mientras que otra incluye un retraso ascendente, un trabajo fallido y una reparación lenta. La pregunta no es si ocurrirá un resultado específico. Es con qué frecuencia las combinaciones plausibles de eventos podrían llevar la frescura de los datos o la exposición comercial más allá de un umbral aceptable.
El lanzamiento de una moneda proporciona un punto de partida sencillo. Con diez lanzamientos, se pueden observar varias caras y cruces, pero el equilibrio sigue siendo incierto. Esa pequeña muestra ofrece un resultado, no una visión confiable del proceso.
Repita el experimento a lo largo de diez mil lanzamientos y los resultados respaldarán las declaraciones de probabilidad. Puede examinar la distribución, comparar su centro con sus extremos y estimar con qué frecuencia cruza un umbral elegido. La computadora no está adivinando. Las pruebas repetidas revelan la forma de la incertidumbre.

Traducir la pregunta en una simulación
Supongamos que un ingeniero de la plataforma de datos pregunta: "¿Con qué frecuencia estará desactualizada esta tabla por más de treinta minutos un viernes determinado?". Varias entradas inciertas afectan la respuesta:
El patrón normal de llegada del origen.
El retraso de las dependencias ascendentes.
La probabilidad de que un trabajo falle o se vuelva a intentar.
El tiempo necesario para detectar y reparar el problema.
El impacto comercial de los datos desactualizados durante ese ciclo de informes.
Un cálculo determinista asigna un único valor de latencia a cada entrada. Una simulación de Monte Carlo toma muestras de valores de distribuciones de probabilidad, los pasa a través de un modelo de sistema y registra la frescura resultante o el resultado financiero. Repetir ese proceso convierte una señal de Observability en un riesgo comercial cuantificado. Una plataforma como digna puede conectar este razonamiento con los métodos de Monte Carlo para una mejor Data Observability, de modo que los resultados de la simulación puedan revisarse como evidencia en lugar de tratarse como un pronóstico opaco.
Regla práctica: El valor proviene de la exploración estructurada de la incertidumbre, no solo de la aleatoriedad.
Los tres ingredientes
Cada simulación creíble consta de tres componentes.
Un modelo de sistema: Este mapea las entradas con un resultado. Puede ser una fórmula, un gráfico acíclico dirigido, lógica SQL o un entorno de simulación en Python.
Distribuciones de entrada: Cada variable incierta necesita un rango y una forma defendibles. La telemetría histórica, los compromisos de servicio y el juicio de expertos documentado pueden fundamentar esas distribuciones.
Suficientes iteraciones: El modelo se ejecuta repetidamente hasta que su resultado es lo suficientemente estable para la toma de decisiones. Más ejecuciones aclaran la distribución simulada, pero no pueden corregir suposiciones débiles.
Los métodos de Monte Carlo tienen una larga historia. Las primeras ideas probabilísticas incluyen el experimento de la aguja de Buffon. Las aplicaciones modernas de riesgo se desarrollaron a través de la computación científica en tiempos de guerra y el trabajo asociado con el Proyecto Manhattan. Stanisław Ulam concibió el enfoque en Los Álamos en 1946, John von Neumann ayudó a desarrollarlo en 1947 y el método se utilizó por primera vez para calcular las trayectorias de difusión de neutrones para la bomba de hidrógeno, como se documenta en este relato histórico de los métodos de Monte Carlo. El muestreo repetido facilitó posteriormente el abordaje de cantidades difíciles en campos como el análisis de seguridad nuclear y el modelado de la volatilidad financiera.
Para un equipo de datos, la traducción es directa: definir qué puede variar, describir cómo varía, pasar esas entradas a través de la lógica de negocio e inspeccionar la distribución resultante. Almacene las suposiciones, las entradas muestreadas, la versión del modelo y el resultado para que la simulación pueda respaldar la auditoría y la governance, en lugar de producir simplemente una advertencia.
Las cinco etapas de un flujo de trabajo de simulación confiable
Un histograma es solo un resultado intermedio. Un flujo de trabajo listo para la governance permite que otro ingeniero, auditor o comité de riesgos comprenda cómo se produjo el resultado y lo reproduzca a partir de la evidencia registrada.
Etapa uno: enmarcar la decisión
Comience con una pregunta comercial en lugar de un síntoma técnico. "¿Cuál es la probabilidad de que los ingresos reportados superen el umbral de corrección?" identifica un resultado, un umbral y un propietario de la decisión. "¿Qué tan inestable es la tabla de transacciones?" describe una condición pero no define una acción.
Registre el período del informe, los conjuntos de datos afectados, los consumidores descendentes, la incertidumbre aceptable y la respuesta para cada banda de riesgo antes de seleccionar una distribución. Este alcance mantiene la simulación vinculada a una decisión en lugar de convertirla en un ejercicio de datos abierto.
Etapa dos: buscar la fuente de la incertidumbre
Haga una lista de cada variable que pueda cambiar el resultado y conéctela con la evidencia. La telemetría histórica de llegada puede describir el comportamiento de la frescura de los datos. Los compromisos de los proveedores pueden proporcionar una referencia externa para los retrasos del servicio. Los resultados de la validación pueden mostrar con qué frecuencia ocurren registros no válidos y qué tan grande puede ser su efecto.
Documente el motivo de cada elección de distribución. Un parámetro sin su fuente deja a los revisores sin la capacidad de separar el comportamiento medido del juicio de un analista. Esa distinción es importante cuando cambian las suposiciones o cuando se debe defender un resultado más adelante.
Etapa tres: construir el modelo de propagación
El modelo puede ser una fórmula, un gráfico de dependencias o un entorno de simulación. Debe exponer la ruta desde cada entrada muestreada hasta el resultado comercial. Si los datos retrasados cambian una métrica del tablero de control, la lógica debe identificar los registros afectados, calcular el cambio de la métrica y mostrar dónde entra la ponderación descendente.
Etapa cuatro: ejecutar y preservar
Ejecute suficientes iteraciones para que el resultado seleccionado se estabilice. Capture la semilla aleatoria, la versión del modelo, las versiones de la biblioteca, la instantánea de entrada y los sorteos sin procesar. Un percentil final sin este registro no puede respaldar una reproducción confiable ni una depuración efectiva.
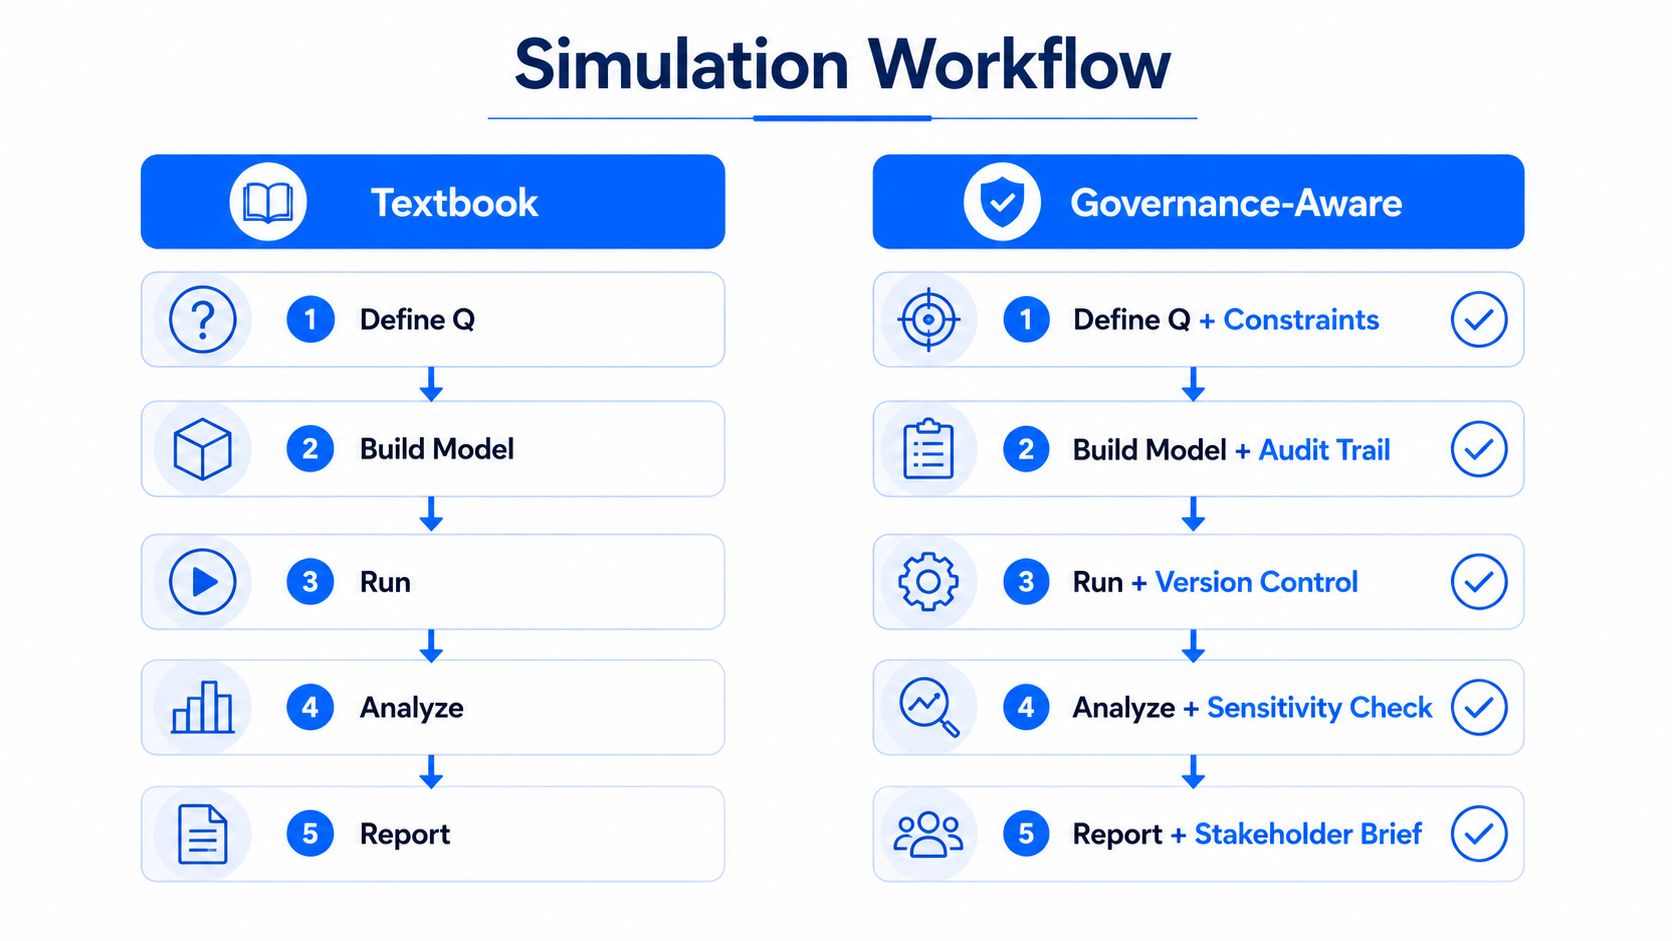
Etapa cinco: comunicar la distribución
La dirección de la empresa generalmente necesita el intervalo plausible, el extremo de la distribución relevante, los principales factores desencadenantes y la acción asociada con el resultado, en lugar de cada fila simulada. Presente bandas de percentiles y evidencia de sensibilidad, mientras conserva el registro completo del modelo para su revisión. Las herramientas como digna pueden convertir simulaciones repetidas en evidencia auditable y lista para la governance sobre el riesgo comercial creado por datos erróneos.
La governance proporciona el rastro de evidencia que hace que una cifra de riesgo simulada sea defendible durante una revisión regulatoria o ejecutiva, especialmente cuando las consecuencias financieras requieren un razonamiento defendible.
Construir el modelo dentro de su plataforma de datos
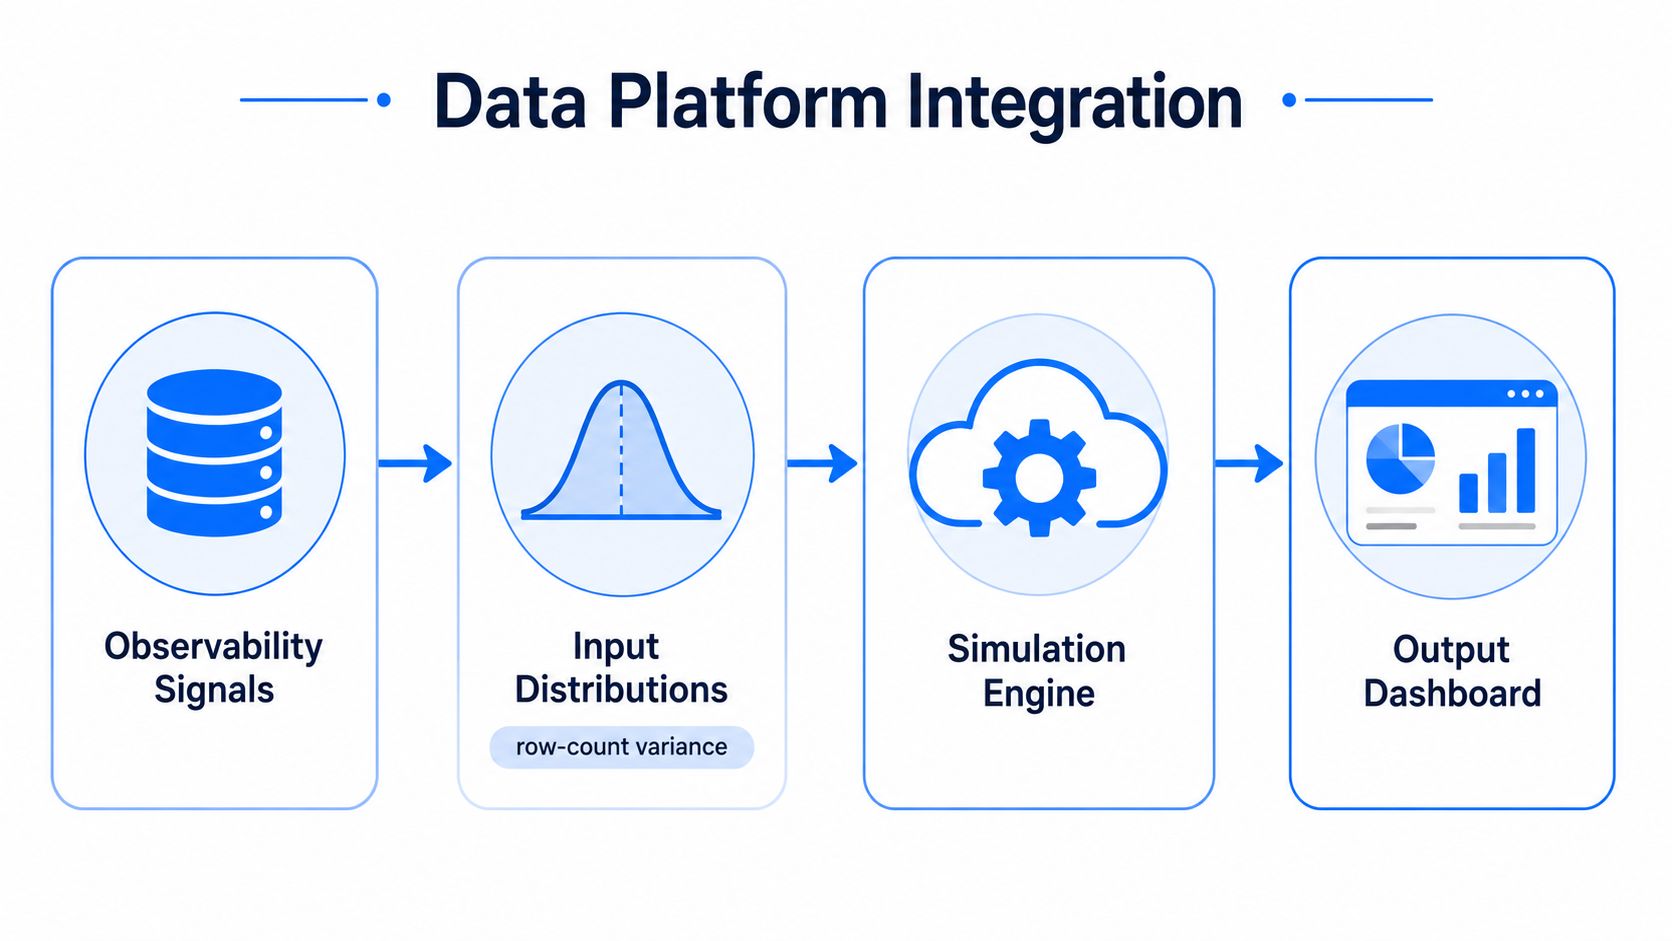
Un modelo nativo del almacén de datos comienza con señales de Observability que ya describen cómo se comporta el producto de datos. En lugar de exportar métricas a una hoja de cálculo secundaria, la plataforma puede recopilar distribuciones, ejecutar la simulación y almacenar los resultados junto con los metadatos de origen.
Convertir la telemetría en entradas
Diferentes señales describen diferentes tipos de incertidumbre:
La variación del recuento de filas puede fundamentar un modelo de recuento, como un modelo de tipo Poisson para la llegada de eventos o una aproximación normal cuando el proceso es lo suficientemente estable.
La desviación de la tasa de nulos se puede representar con una distribución beta porque las tasas son acotadas y pueden cambiar de forma asimétrica.
El retraso de la frescura puede utilizar una forma log-normal desplazada cuando los retrasos no son negativos y los retrasos prolongados ocasionales son importantes.
Los cambios de esquema y los fallos de validación pueden alimentar variables de escenario que alteran la población afectada o invalidan un cálculo descendente.
Estas elecciones no son verdades automáticas. El equipo debe comparar las distribuciones candidatas con el comportamiento histórico, inspeccionar los extremos de la distribución y registrar la justificación. Una distribución que parece conveniente pero representa incorrectamente el proceso de origen puede generar una falsa confianza.
Propagar la incertidumbre a través de la lógica de negocio
Considere un modelo de ingresos expresado como:
ingresos = transacciones × precio × (1 - tasa_de_reembolso)
La simulación toma muestras del volumen de transacciones, el precio y la tasa de reembolso para cada ejecución. Luego aplica la fórmula y almacena el resultado de ingresos resultante en una tabla de resultados. Una implementación en el almacén de datos podría usar SQL para la agregación y un trabajo ligero de Python para el muestreo de distribución, mientras que un modelo más complejo podría usar un motor de simulación dedicado.
El detalle operativo importa. Almacene la instantánea de origen, las definiciones de características, la versión del código del modelo, la semilla aleatoria, los parámetros de distribución y las versiones de dependencia con cada ejecución. Si una canalización cambia más adelante, los revisores deberían poder distinguir un nuevo estado de riesgo de un cambio en el propio modelo.
Un enfoque dentro de la base de datos también reduce el movimiento innecesario de datos sensibles. El enfoque de calidad de datos en la base de datos de digna describe un patrón donde las métricas y el análisis se ejecutan dentro del entorno de la base de datos del cliente. En un flujo de trabajo de Monte Carlo, las puntuaciones de anomalías, las señales de puntualidad, los resultados de validación y las diferencias de esquema pueden convertirse en entradas con versión en lugar de alertas desconectadas.
Leer los resultados como un analista de riesgos
Un histograma es evidencia, no una conclusión. El trabajo del analista es identificar el intervalo, el extremo de la distribución y las entradas que crean la dispersión.
Tres artefactos que merecen atención
Las bandas de percentiles limitan el rango plausible de resultados. Le permiten establecer qué cantidad de la masa de probabilidad simulada se encuentra por debajo o por encima de un umbral. Un socio financiero puede actuar sobre un intervalo de manera más efectiva que sobre un promedio no explicado.
Los gráficos de abanico muestran cómo se amplía la incertidumbre a lo largo del tiempo o en puntos de pronóstico sucesivos. En una plataforma de datos, pueden ilustrar el rango proyectado de frescura, la exposición acumulada de los informes o una métrica bajo retrasos de dependencia repetidos.
Los diagramas de tornado clasifican las variables de entrada según su contribución a la varianza del resultado. Son útiles porque redirigen la remediación hacia la incertidumbre que más importa. Si el retraso de la frescura domina la dispersión, ajustar una regla de validación de bajo impacto no cambiará sustancialmente el perfil de riesgo.
Informar sobre el extremo de la distribución, no solo el centro
Una distribución sesgada puede hacer que la media sea una cifra poco representativa. El promedio puede situarse cómodamente por debajo de un umbral mientras que un extremo significativo de la distribución se extiende hacia una exposición inaceptable. Para el reporte de riesgos, el percentil del extremo suele ser más auditable porque establece el límite que la organización decide gestionar.
Una declaración debidamente calificada podría verse así: "El noventa y cinco por ciento de las ejecuciones se sitúa entre 1.8 millones y 2.4 millones, mientras que el percentil cinco del extremo de ingresos es de 1.4 millones". Esos valores son un formato de reporte ilustrativo, no un resultado universal. Su modelo debe proporcionar el intervalo real y documentar las suposiciones detrás de él.
La distribución de datos proporciona la base para interpretar estas formas. La confianza pertenece a la declaración del intervalo o del percentil, no a una estimación de un solo punto. Acompañe siempre el titular con el alcance del modelo, la instantánea de entrada y el resultado de sensibilidad.
Errores que hacen que las simulaciones no sean auditables
Una simulación puede producir un gráfico refinado al mismo tiempo que codifica suposiciones débiles. Las fallas más peligrosas son las silenciosas, porque el resultado parece más riguroso que el proceso que lo generó.
La independencia suele ser una ficción conveniente
Tratar las entradas como independientes es fácil de implementar, pero las fallas en las canalizaciones a menudo comparten causas comunes. Un retraso en el origen puede aumentar el retraso de frescura, reducir los registros disponibles y activar reintentos descendentes al mismo tiempo. Un estudio de riesgo de proyectos de 2025 encontró que agregar dependencias probabilísticas y efectos de cascada temporal producía requisitos de contingencia significativamente más altos que los enfoques clásicos, mientras que una revisión sistemática de 2022 enfatizó el modelado de dependencia, el ajuste consciente de los extremos de la distribución y la validación transparente en esta revisión de métodos de riesgo de proyectos.
Utilice matrices de correlación o factores comunes de riesgo latente cuando la evidencia los respalde. Luego pruebe si el co-movimiento simulado se asemeja al comportamiento observado.
El extremo de la distribución desaparece cuando la forma es incorrecta
Una distribución normal puede subestimar retrasos o pérdidas poco comunes pero trascendentes cuando el proceso subyacente presenta extremos pesados. Inspeccione los extremos históricos, pruebe distribuciones alternativas y ejecute escenarios de estrés explícitos para riesgos que el modelo principal podría no representar adecuadamente.
Otras medidas de protección pertenecen a los metadatos de ejecución:
Registro de semillas: Preserve la semilla aleatoria para que una ejecución aprobada pueda ser reproducida.
Fijación de instantáneas: Vincule los parámetros de entrada a una instantánea de datos específica para que la desviación de origen no reescriba la historia.
Comprobaciones de convergencia: Compare los resultados clave en ejecuciones o semillas adicionales y registre la decisión de estabilidad.
Pruebas retrospectivas (Backtesting): Compare los rangos simulados con los resultados observados posteriormente y revise el modelo cuando falle de forma sistemática.
Revisión de fórmulas: Valide las restricciones comerciales, las exclusiones, los límites y las rutas condicionales en lugar de asumir que una ecuación simplificada es suficiente.
La explicación de digna sobre la procedencia de los datos y el linaje de datos es un contexto útil para separar el origen de un valor de cómo se movió a través de la plataforma. Una simulación confiable necesita ambos.
Two Real-World Examples From Finance and Data Quality
Finanzas ofrece una aplicación familiar. Un equipo de riesgo de cartera puede simular rendimientos diarios correlacionados para acciones y tasas de interés, agregar cada escenario muestreado en un resultado de pérdidas y ganancias, e inspeccionar la distribución de pérdidas. La pregunta no es "¿cuál será el rendimiento de mañana?". Es "¿con qué frecuencia la cartera supera el límite de pérdidas bajo la incertidumbre modelada?".
La correlación importa porque los activos y las tasas pueden moverse juntos bajo condiciones de mercado compartidas. Si el modelo toma muestras de cada rendimiento de forma independiente, puede producir una distribución ordenada que subestima el riesgo de caída conjunto. El informe final debe identificar el percentil del extremo seleccionado, la ventana de entrada, las suposiciones de dependencia y las limitaciones del modelo de cartera.
La calidad de los datos tiene la misma estructura
Ahora aplique el método a una tabla de tablero de control de ingresos. El equipo de datos modela la frescura y la desviación de la tasa de nulos a lo largo de un horizonte de simulación de 90 días, combina esas señales con ponderaciones de uso descendente y estima la probabilidad de que los ingresos trimestrales se informen de manera incorrecta. El resultado podría respaldar la decisión de retrasar la publicación, iniciar una conciliación o derivar el conjunto de datos a un propietario de control.
El modelo podría tratar una carga tardía como algo que afecta solo a una parte de la población del informe, mientras que un aumento en la tasa de nulos cambia la confiabilidad de una métrica más amplia. También puede incluir fallas de validación, cambios de esquema y tiempo de corrección como entradas condicionales. Cada ejecución produce una versión plausible del trimestre, no una afirmación de que se conoce el futuro exacto.
La Observability se convierte en la capa de muestreo
Una plataforma de datos difiere de una hoja de cálculo estática. El comportamiento de la frescura cambia a medida que cambian los cronogramas, las dependencias y los sistemas de origen. Los patrones de nulos cambian cuando los equipos de aplicaciones alteran formularios o contratos de eventos. Los resultados de las validaciones evolucionan a medida que maduran las reglas de negocio.
Por lo tanto, una simulación actualizada continuamente necesita telemetría actual, distribuciones con versiones y una propiedad clara. Una plataforma de Observability puede proporcionar las señales en bruto, pero el modelo de riesgo aún necesita suposiciones explícitas sobre cómo esas señales afectan los resultados comerciales. El valor radica en conectar la evidencia operativa con un umbral de decisión, y luego preservar la ruta entre ellos.
Elegir cuándo Monte Carlo es la herramienta adecuada
Monte Carlo se gana su lugar cuando la pregunta se refiere a una distribución, las entradas son inciertas pero limitadas o modelables, y un cálculo de forma cerrada no puede representar las interacciones. Es especialmente útil cuando varias condiciones de la canalización se combinan en una exposición que una simple alerta no puede expresar.
Utilice un método más sencillo cuando la decisión siga una regla determinista. Un umbral fijo, un SLA de frescura o una verificación de validación directa pueden ser suficientes cuando la única acción es "detener la carga si se cumple esta condición". La simulación agrega costos a través del modelado, la revisión, la ejecución y el mantenimiento, por lo que el resultado debería cambiar una decisión significativa.
Una prueba práctica de preparación incluye cuatro señales:
Entradas documentadas: El equipo puede explicar de dónde proviene cada distribución.
Ejecuciones reproducibles: Se conservan las semillas, el código, las dependencias y las instantáneas.
Revisión de governance: Los propietarios han cuestionado las suposiciones y aprobado el alcance.
Responsabilidad operativa: Alguien es responsable de actualizar el modelo y actuar en función de sus resultados.
Los equipos que evalúan este enfoque también deben distinguir el juicio cualitativo de los métodos de análisis cuantitativo. Monte Carlo no reemplaza la revisión de expertos en la materia. Le da a esa revisión una forma estructurada de expresar la incertidumbre y comparar escenarios.
Situación | Usar Monte Carlo | Usar un método más sencillo |
|---|---|---|
Interacción de varias entradas inciertas | Modelar el resultado combinado y las dependencias | Usar una regla cuando las entradas no interactúan sustancialmente |
La dirección necesita la probabilidad frente a un umbral | Informar sobre bandas de percentiles y la exposición en el extremo de la distribución | Informar sobre un estado determinista cuando el umbral está claro |
El comportamiento de la canalización cambia con el tiempo | Actualizar las distribuciones a partir de la telemetría con versiones | Usar una alerta estática para un comportamiento estable y bien comprendido |
La evidencia de las entradas es débil | Comenzar por mejorar la medición y las suposiciones | Evitar una simulación de apariencia precisa basada en suposiciones |
La acción es inmediata y binaria | Simular si el tamaño de la exposición afecta la escalada | Usar validación o monitoreo de umbrales si no es así |
digna puede servir como una opción de tiempo de ejecución para suministrar señales de Observability, incluyendo información sobre anomalías, puntualidad, validación y cambios de esquema, de modo que el modelo no quede atrapado en una hoja de cálculo desactualizada. Utilícelo únicamente dentro de un proceso operativo más amplio que asigne propietarios, revise las suposiciones y preserve la evidencia de las ejecuciones.
digna conecta Data Anomalies, puntualidad, validaciones, cambios de esquema y métricas de negocio dentro del propio entorno del cliente, lo que brinda a los modelos de Monte Carlo entradas auditables para estimar el riesgo detrás de tableros de control no confiables. Visite digna para ver cómo su plataforma de Observability puede ayudar a su equipo a convertir las señales de calidad de datos en evidencia de riesgo lista para la governance.
Preguntas frecuentes
¿Qué añade la evaluación de riesgo con Monte Carlo a la monitorización?
Exposición en lugar de eventos. Las alertas describen lo ocurrido; una evaluación de riesgo responde a la duración, cuánto pudo permanecer incorrecta la canalización antes de detectarse, al alcance, qué tablas y modelos heredan el defecto, al efecto de negocio y a la respuesta, si pausar el reporte, corregir o continuar con una salvedad documentada.
¿Qué muestrea realmente el modelo?
Combinaciones plausibles de las variables operativas que impulsan la exposición: retraso de entrega, volumen de duplicados, tiempo de corrección y uso del panel. Muestrearlas juntas es lo que convierte la descripción de un incidente en una afirmación defendible sobre cuánto daño era posible.
¿Por qué no basta con tener monitorización?
Porque el equipo del ejemplo sí la tenía. La alerta saltó y la causa raíz estaba clara a media mañana, pero nadie podía decir hasta dónde había viajado el defecto ni qué decisiones había tocado ya, y esa es la brecha que cubre la evaluación de riesgo.
¿Sirve fuera de un incidente?
Sí, en la gobernanza rutinaria. El mismo modelo que estima exposición durante un incidente puede ejecutarse por adelantado para mostrar qué productos de datos cargan la banda de riesgo más ancha, lo que justifica dónde deben ir primero los controles y la responsabilidad.
¿Qué hace defendible un resultado de riesgo?
Nombrar las entradas y la decisión que sostiene. Una cifra producida a partir de supuestos no revelados invita justo a la discusión que la simulación debía zanjar, así que supuestos, rangos muestreados y acción resultante deben viajar juntos.


