Qué es un archivo Parquet y por qué impulsa la analítica moderna
|
8
minuto de lectura

Apache Parquet es un formato de archivo de código abierto y orientado a columnas para datos analíticos. Su estructura empieza con un número mágico de 4 bytes PAR1 y termina con un pie que almacena el esquema, la ubicación de los row groups y estadísticas. Guarda los datos por columna dentro de row groups, column chunks y data pages, y por eso los motores de consulta pueden descartar columnas y saltarse row groups irrelevantes antes de realizar lecturas pesadas.
Si te preguntas qué es un archivo Parquet, probablemente estés en una de dos situaciones. O tus consultas al almacén escanean mucho más de lo que deberían, o tu lago se ha convertido en una mezcla desordenada de CSV, JSON y exportaciones a medio documentar en la que nadie confía del todo. En ambos casos, el formato de archivo no es un detalle menor de implementación. Determina el coste, la velocidad y la seguridad con la que los equipos posteriores pueden construir sobre esos datos.
Piensa en un flujo analítico habitual. Una desarrolladora de BI necesita los ingresos por región y mes. El conjunto de datos original tiene decenas de campos adicionales, atributos anidados y particiones históricas. Si esos datos están en archivos de texto orientados a filas, el motor suele tener que recorrerlo todo solo para responder una pregunta muy concreta. Parquet cambió ese modelo operativo al convertirse en un formato práctico de intercambio para sistemas analíticos, sobre todo en lagos de datos y almacenes modernos, porque se diseñó pensando en lecturas selectivas y no en escaneos completos.
Esto va más allá del rendimiento. Las decisiones sobre el formato también afectan a la fiabilidad. Si llegan cambios de esquema, si las carpetas de particiones se desvían de lo esperado o si las estadísticas dejan de ayudar al motor a saltarse rangos obsoletos, los equipos lo notan como paneles rotos, trabajos caros e incidencias difíciles de depurar. Por eso los equipos de plataforma de datos tratan Parquet como formato de almacenamiento y como estándar operativo a la vez.
Índice de contenidos
Codificación, compresión y metadatos que impulsan el rendimiento
Trabajar con Parquet en Spark, Presto, Pandas y lagos particionados
Garantizar datos Parquet fiables con observabilidad y controles de calidad
Introducción: qué es realmente un archivo Parquet
Un archivo Parquet es un formato de almacenamiento pensado para el trabajo analítico, sobre todo cuando los equipos consultan grandes conjuntos de datos pero solo necesitan unos pocos campos cada vez.
Empecemos por un problema conocido del almacén. Una desarrolladora de BI abre una consulta de panel para ingresos por canal y mes. Los datos de origen incluyen configuraciones de campaña, detalles de dispositivo, rasgos de usuario, cargas de eventos y varias columnas que nadie necesita para esa pregunta. Si esos registros están en CSV o JSON, el motor suele tener que leer todo ese material igualmente, porque cada fila mantiene todos los campos agrupados.
Parquet cambia ese modelo operativo. Almacena los datos por columna, de modo que los motores de consulta pueden centrarse en los campos que la consulta referencia en lugar de arrastrar cada atributo por la ruta de lectura. La documentación de Apache Parquet lo describe como un formato de código abierto orientado a columnas para datos analíticos, y su estructura incluye el número mágico PAR1 junto con metadatos de pie como la información de esquema y la ubicación de los row groups (documentación del formato de archivo Apache Parquet).
Esa elección de diseño afecta a más cosas que la velocidad.
En un lago de datos real, las decisiones de formato se ven en la factura mensual, en la latencia de los paneles y en la respuesta a incidencias. Un formato que admite lecturas selectivas ayuda a recortar los costes de escaneo. Un formato con esquema y metadatos integrados en el archivo da a las plataformas más material para validar, monitorizar y diagnosticar. Si un productor añade columnas, cambia tipos o escribe particiones de forma inconsistente, esos problemas se detectan antes cuando el formato lleva información estructural más sólida que el texto plano.
Por eso Parquet se convirtió en estándar en lagos y almacenes. Ofrece a Spark, Trino, Hive, Pandas, DuckDB y a los motores de almacén en la nube un formato común que encaja con los patrones de acceso analítico. Para los ingenieros de analítica, eso significa menos concesiones entre interoperabilidad y rendimiento. Para los equipos de plataforma, significa que Parquet no es solo una extensión de archivo. Es una decisión operativa sobre control de costes, poda de consultas, estabilidad de esquema y hasta qué punto los equipos posteriores pueden confiar en lo que leen.
Cómo funciona el almacenamiento columnar y por qué importa
La mayor confusión sobre Parquet empieza aquí. La gente oye columnar y supone que solo significa «comprime mejor». La compresión es parte de la historia, pero la idea de fondo es cómo se disponen físicamente los datos.
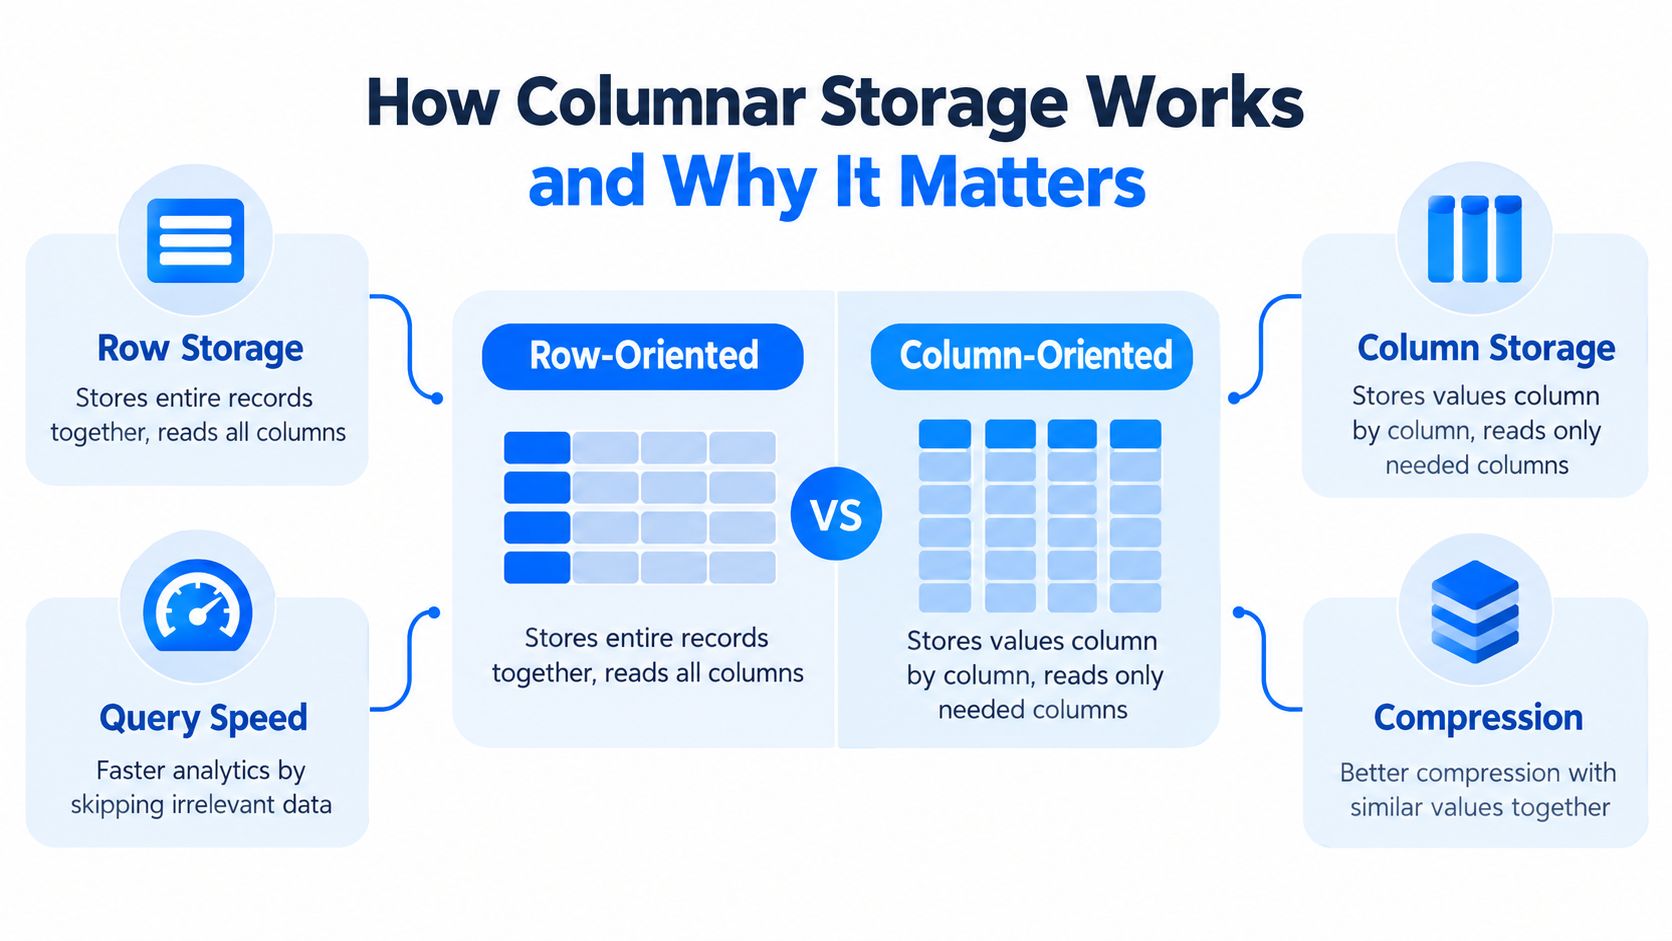
Las filas son para registros, las columnas para preguntas
Imagina una hoja de cálculo con columnas para order_id, country, order_date y amount.
En un formato orientado a filas, el almacenamiento se ve como registros empaquetados:
pedido 1: todos los campos juntos
pedido 2: todos los campos juntos
pedido 3: todos los campos juntos
En un formato orientado a columnas, el almacenamiento agrupa los valores por campo:
todos los valores de
order_idjuntostodos los valores de
countryjuntostodos los valores de
order_datejuntostodos los valores de
amountjuntos
Suena abstracto hasta que aplicas una consulta. Si tu herramienta de BI pide el importe total por país, no necesita todos los campos de todos los registros. Con almacenamiento columnar, el motor puede centrarse solo en las columnas relevantes.
Por qué se benefician los motores analíticos
Las consultas analíticas suelen escanear muchas filas pero referenciar relativamente pocas columnas. Ese es justo el patrón de acceso que favorece Parquet.
Un modelo mental práctico:
El planificador de consultas revisa las columnas solicitadas.
El motor lee solo esos segmentos de columna.
Los campos irrelevantes se quedan en disco o en el almacenamiento de objetos.
Esa lectura selectiva es una razón por la que los equipos dedican tiempo pronto a decisiones de arquitectura de sistemas de datos. La disposición del almacenamiento y el motor de consulta tienen que cooperar, o acabarás pagando escaneos que nunca quisiste ejecutar.
Cuando alguien dice que Parquet es rápido, suele querer decir que el motor evita trabajo antes de leer la mayor parte del archivo.
Por qué los valores similares también ayudan a la compresión
El almacenamiento columnar también agrupa tipos de datos similares y valores repetidos. Una columna country con muchos códigos repetidos se comprime de forma distinta a una fila mixta con marcas de tiempo, decimales, booleanos y cadenas entrelazados.
Esto importa porque a los sistemas analíticos no solo les preocupa el tamaño en disco. Segmentos de columna más pequeños y uniformes pueden reducir la E/S y facilitar el procesamiento de los escaneos. Así que la ventaja no es una sola cosa. Es la combinación de lecturas selectivas y datos que por naturaleza son más amables con la optimización de almacenamiento.
Usa esta regla práctica:
Elige formatos orientados a filas cuando necesites leer o escribir registros completos con frecuencia.
Elige formatos columnares cuando agregues, filtres y escanees pocos campos sobre muchos registros.
Por eso Parquet aparece tan a menudo en data marts, capas curadas del lago y pipelines cercanos al almacén.
Dentro de un archivo Parquet: de los row groups a las pages
Mucha gente sabe que Parquet es columnar pero no logra imaginar qué hay dentro del archivo. Ahí es donde el ajuste de rendimiento se vuelve difuso. Sin entender la jerarquía, cuesta explicar por qué un conjunto de datos se poda bien y otro escanea de más.
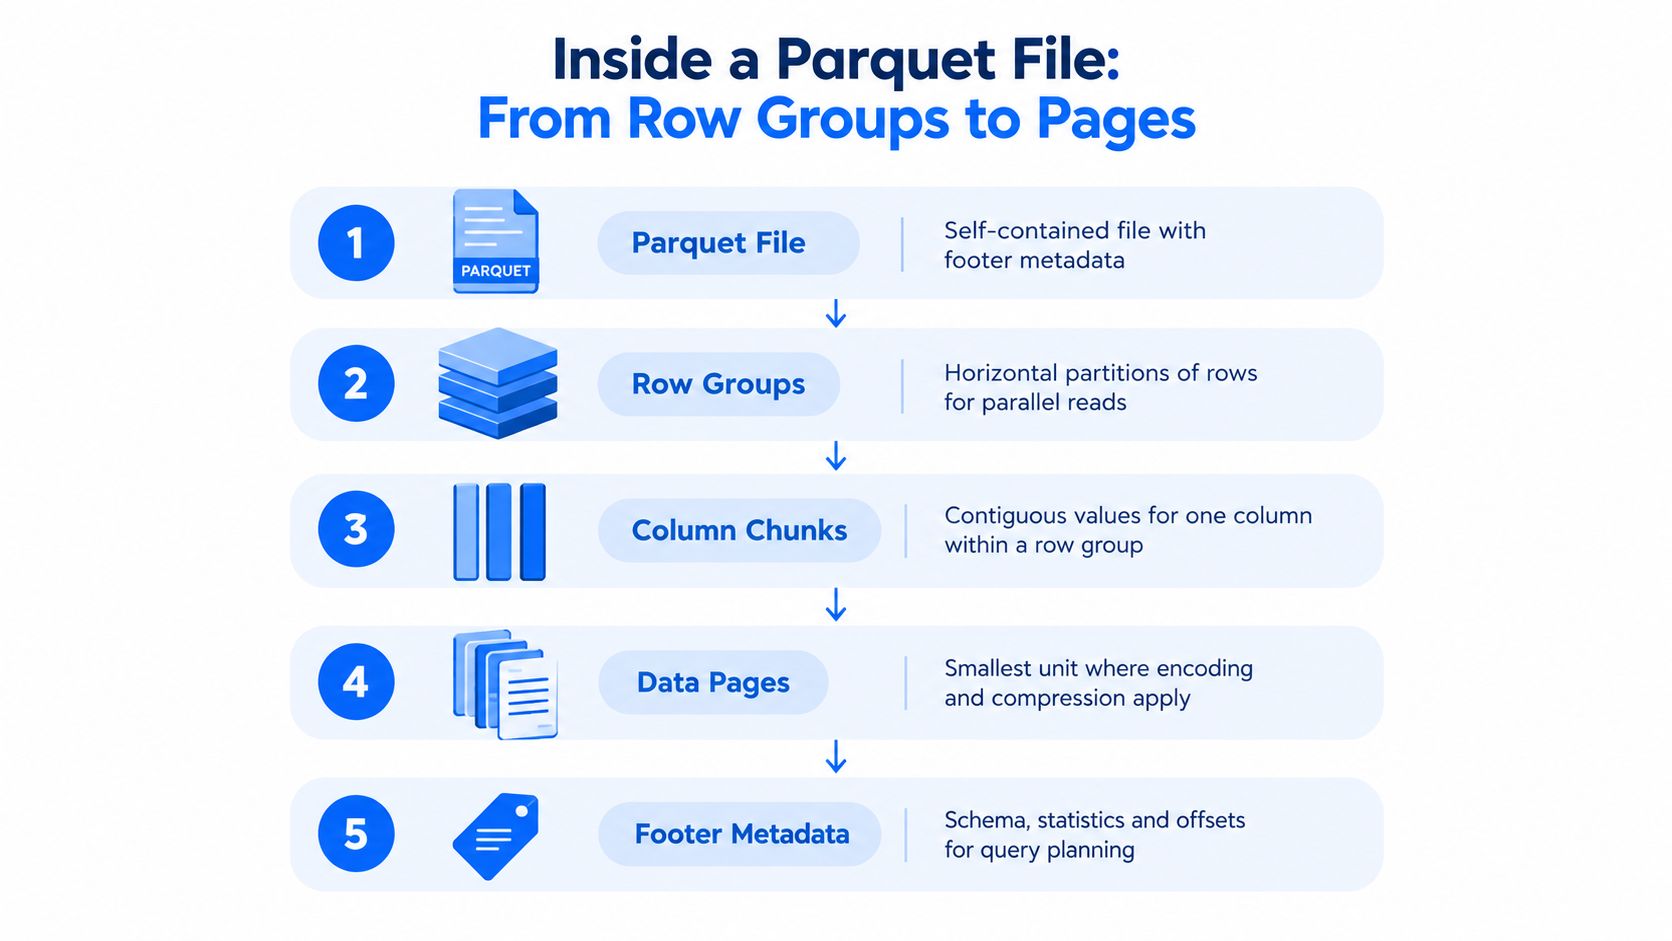
Empieza por el nivel de archivo
Un archivo Parquet es autocontenido. El proyecto Apache señala que el formato es abierto y que la especificación del formato y la definición Thrift deben leerse juntas para entender cómo funciona la estructura (documentación de Apache Parquet).
A grandes rasgos, el archivo contiene:
Secciones de datos que guardan los valores reales de las columnas
Un pie que describe lo que hay dentro
Desplazamientos y metadatos que ayudan a los lectores a localizar rápido las piezas adecuadas
Ese pie es el centro de control. Indica al motor el esquema, dónde viven los row groups y qué estadísticas están disponibles para planificar la lectura.
La jerarquía interna
La estructura de Parquet está organizada en capas muy concretas:
Row groups
Son particiones horizontales de filas dentro del archivo. Un row group contiene el mismo rango de filas en todas las columnas.Column chunks
Dentro de cada row group, cada columna recibe su propio bloque contiguo de datos.Data pages
Dentro de cada column chunk, los valores se almacenan en unidades menores llamadas pages.
En entornos de lago con muchos metadatos, esta jerarquía está estrechamente ligada a la gestión de metadatos. Cuanto más claramente registren los equipos esquemas, particiones y estructura de archivo, más fácil resulta diagnosticar el comportamiento de escaneo y las roturas por esquema.
Por qué los row groups importan en la operación
Los row groups son más que un detalle de almacenamiento. Influyen en cuántos datos puede saltarse un motor de consulta y en cómo se paraleliza el trabajo.
Supón que una consulta filtra un rango de fechas estrecho. Si las estadísticas del row group muestran que ciertos grupos solo contienen fechas antiguas, el motor puede saltárselos en lugar de escanearlos. Ese es el valor práctico de los metadatos incrustados: acortan las lecturas antes de que empiece la decodificación.
Un conjunto de datos Parquet sano no solo es válido. Está organizado para que los motores puedan decir «no» rápido a las lecturas innecesarias.
Qué le dice el pie al motor
El pie almacena metadatos como:
Información de esquema
Ubicación de los row groups
Estadísticas, incluidos mínimos/máximos y recuentos de nulos
Esas estadísticas son operativamente importantes porque permiten a los motores descartar datos irrelevantes antes de escanearlos, una de las razones por las que Parquet se convirtió en formato de intercambio de facto para analítica, tal y como describe la documentación del formato de archivo Apache Parquet enlazada antes.
Si alguna vez te has preguntado por qué una tabla se siente «ágil» en Trino o Spark y otra no, la respuesta suele esconderse aquí. Ambos archivos pueden ser Parquet, pero la disposición interna, los límites de los row groups y la calidad de los metadatos pueden dar comportamientos de ejecución muy distintos.
Codificación, compresión y metadatos que impulsan el rendimiento
Un archivo Parquet ahorra dinero y acelera las consultas por tres razones distintas. Almacena los valores de forma eficiente mediante codificación, reduce los bytes codificados con compresión y entrega a los motores metadatos que les permiten evitar leer datos irrelevantes desde el principio.
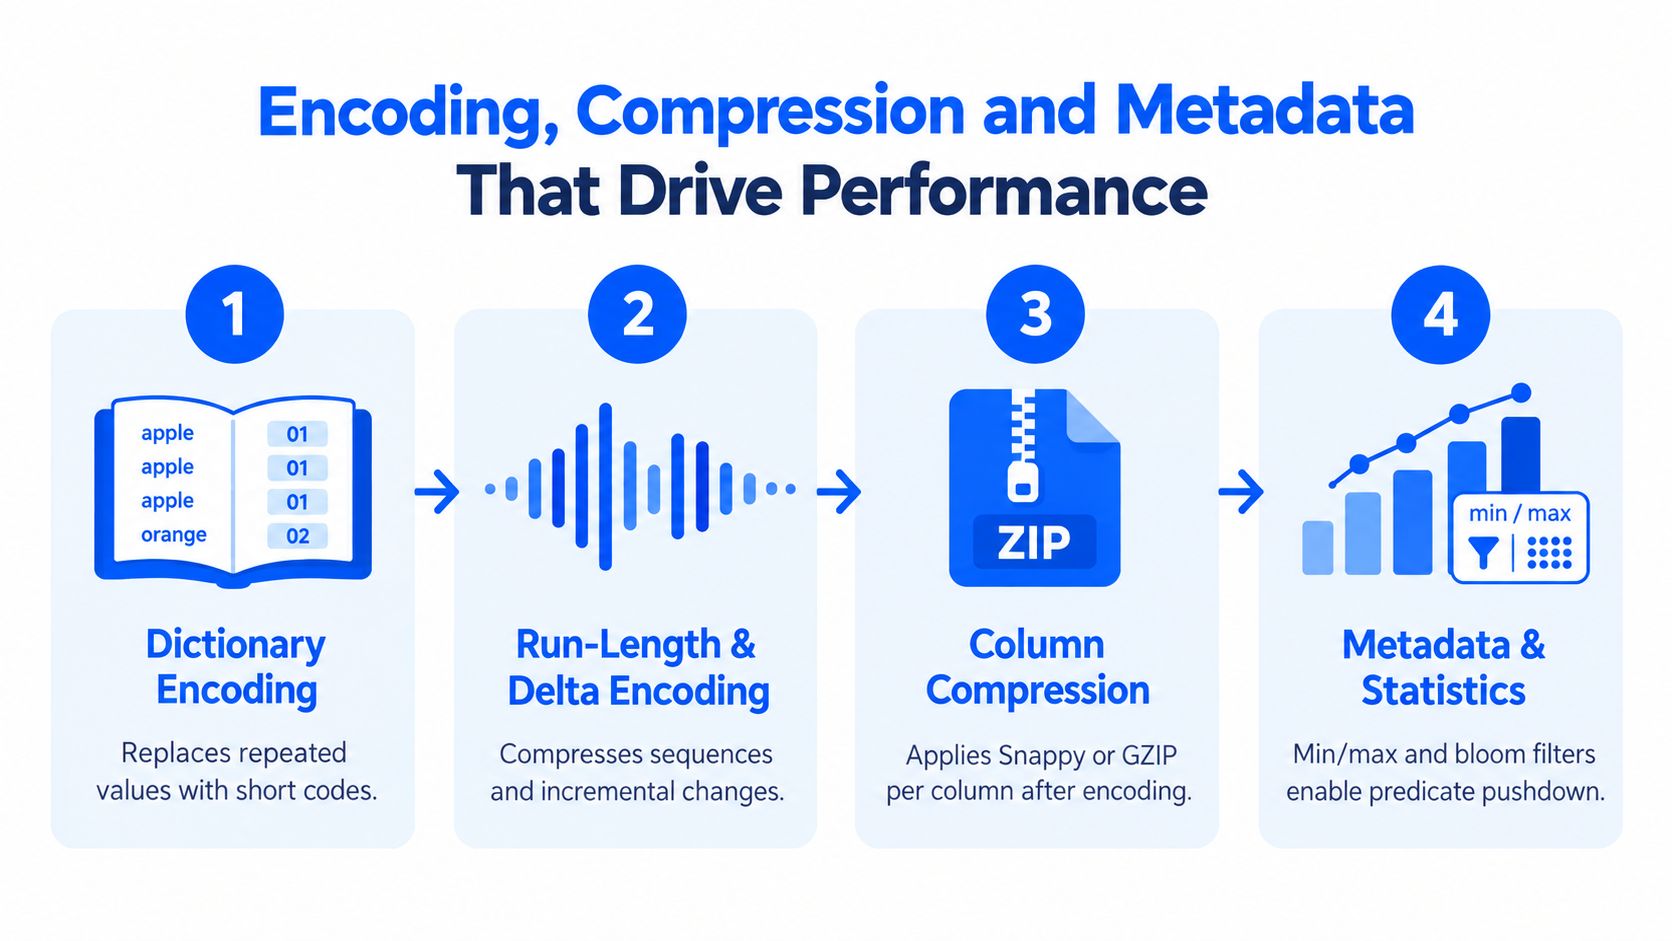
La codificación va primero
La codificación cambia cómo se representan los valores antes de que se ejecute cualquier códec de compresión. La documentación del formato Parquet enumera codificaciones como diccionario, run-length y delta como parte del diseño del archivo (especificación de codificación de Parquet).
Leído de forma sencilla:
La codificación por diccionario guarda los valores repetidos como referencias cortas en lugar de repetir el valor completo cada vez.
La codificación run-length guarda de forma compacta rachas largas del mismo valor.
La codificación delta guarda los cambios entre valores cercanos, lo que funciona bien en secuencias que suben o bajan de forma gradual.
Una desarrolladora de BI percibe esta diferencia sin ver los bytes directamente. Una columna de país con muchos valores repetidos o una columna de marca de tiempo con incrementos predecibles da a Parquet patrones que puede almacenar mucho más eficientemente que el texto plano.
La compresión reduce los bytes codificados
Una vez codificados los valores, Parquet puede comprimir por separado los datos de cada columna. Eso importa porque una sola columna suele contener un tipo de dato y un tipo de patrón. Una columna de estado se comporta distinto a una de precio, y Parquet permite que cada una se comprima en sus propios términos.
Por eso «Parquet está comprimido» es solo parte de la historia. La compresión reduce el almacenamiento y la E/S de red, pero suele ser la codificación la que crea la repetición que la compresión puede aprovechar. En plataformas de datos en la nube, eso se traduce en menor coste de almacenamiento y menos bytes leídos durante los escaneos.
Los metadatos guían las mayores decisiones de rendimiento
Con los metadatos, Parquet pasa de ser un formato de almacenamiento a una decisión operativa.
Si un analista filtra por order_date >= '2026-01-01', el motor puede saltarse grandes partes del archivo antes de decodificar un solo valor. Puede hacerlo porque Parquet almacena estadísticas y detalles estructurales que ayudan al motor a descartar row groups y pages que no pueden cumplir el filtro. Leer menos significa paneles más rápidos, menor gasto por consulta y un rendimiento más predecible con cargas compartidas.
Esos mismos metadatos afectan también a la fiabilidad. Si los detalles de esquema se desvían, si faltan estadísticas o si los valores de partición no concuerdan con el contenido del archivo, los equipos pierden velocidad y confianza a la vez. La poda de consultas se debilita. El diagnóstico se vuelve más lento. Los contratos de datos cuestan más de aplicar.
Por eso el trabajo con metadatos pertenece a las conversaciones sobre calidad de datos y no solo sobre almacenamiento. Los equipos que invierten en prácticas de metadatos que mejoran la calidad y la eficiencia de los datos suelen obtener dos beneficios a la vez: mejor comportamiento de escaneo y detección más temprana de problemas de esquema o partición.
En lagos empresariales, los archivos Parquet bien escritos hacen más que ocupar barato el almacenamiento de objetos. Ayudan a los motores a ahorrar trabajo, a los equipos a detectar desviaciones y a los responsables de plataforma a evitar que el rendimiento y la fiabilidad se degraden con el tiempo.
Parquet frente a CSV, JSON y ORC: compensaciones explicadas
Parquet es popular, pero no es la respuesta a toda pregunta de almacenamiento. Los equipos eligen mejor cuando comparan formatos por carga de trabajo en lugar de asumir que un formato debe ganar en todas partes.
Empieza por la distinción sencilla
CSV y JSON suelen ser más fáciles en las fronteras de ingesta. Son legibles, portables y familiares para casi todo el mundo. Pero esa comodidad puede salir cara cuando esos mismos archivos sostienen consultas analíticas repetidas.
Parquet es más fuerte cuando los lectores necesitan acceso selectivo, esquema tipado y escaneos eficientes. ORC también es columnar y suele entrar en la conversación en entornos muy orientados al almacén. La elección práctica depende de tus herramientas, tus patrones de escritura y de quién necesita inspeccionar los datos directamente.
Elegir entre formatos por filas y columnares
Formato | Mejor para | Eficiencia de almacenamiento | Patrón de consulta |
|---|---|---|---|
CSV | Exportaciones sencillas, inspección manual, intercambio ligero | Menor para cargas analíticas | Las lecturas suelen abarcar el contenido completo de la fila |
JSON | Intercambio semiestructurado flexible y cargas de API | A menudo menor para analítica porque la estructura se repite en el archivo | Bueno para el intercambio entre aplicaciones, menos eficiente en escaneos analíticos repetidos |
Parquet | Conjuntos de datos analíticos, capas curadas del lago, almacenamiento apto para BI | Alta para datos analíticos porque las columnas se almacenan por separado y se optimizan de forma individual | Lo mejor cuando las consultas leen un subconjunto de columnas sobre muchas filas |
ORC | Analítica columnar en ecosistemas que ya están estandarizados en él | Alta para cargas analíticas | Buen encaje para lecturas analíticas, sobre todo donde el soporte de ORC ya está establecido |
Cómo decidir en la práctica
Usa Parquet cuando se cumplan estas condiciones:
Tus consultas son selectivas: los analistas piden repetidamente unas pocas columnas sobre rangos de fechas amplios.
Necesitas un comportamiento de esquema más sólido: el almacenamiento tipado ayuda cuando los modelos y paneles posteriores dependen de campos consistentes.
El coste de almacenamiento importa: huellas analíticas más pequeñas pueden reducir la sobrecarga de escaneo.
Quédate con CSV o JSON cuando predominen estas condiciones:
Las personas necesitan inspeccionar archivos directamente: para echar un vistazo rápido, el texto sigue ganando.
Los sistemas de origen emiten registros en bruto primero: las zonas de aterrizaje suelen seguir orientadas a filas antes de la curación.
La simplicidad de escritura pesa más que la optimización de lectura: algunas pipelines quieren el formato de exportación más sencillo posible en el borde.
ORC entra en escena cuando tu stack ya se inclina en esa dirección. Si tus motores, estándares de gobierno o convenciones de plataforma favorecen ORC, puede ser la mejor decisión organizativa. La cuestión no es que Parquet gane a todo. Es que Parquet suele ganar cuando los equipos de analítica optimizan para lecturas repetidas, manejo predecible del esquema y amplia compatibilidad de ecosistema.
Trabajar con Parquet en Spark, Presto, Pandas y lagos particionados
Un formato se vuelve útil cuando encaja con las herramientas que la gente ya usa. Parquet lo hace. El ecosistema Apache Parquet y la Library of Congress lo describen como ampliamente soportado en muchos lenguajes de programación y herramientas analíticas, y el proyecto mantiene un histórico formal de versiones en el repositorio parquet-format (repositorio Apache parquet-format).
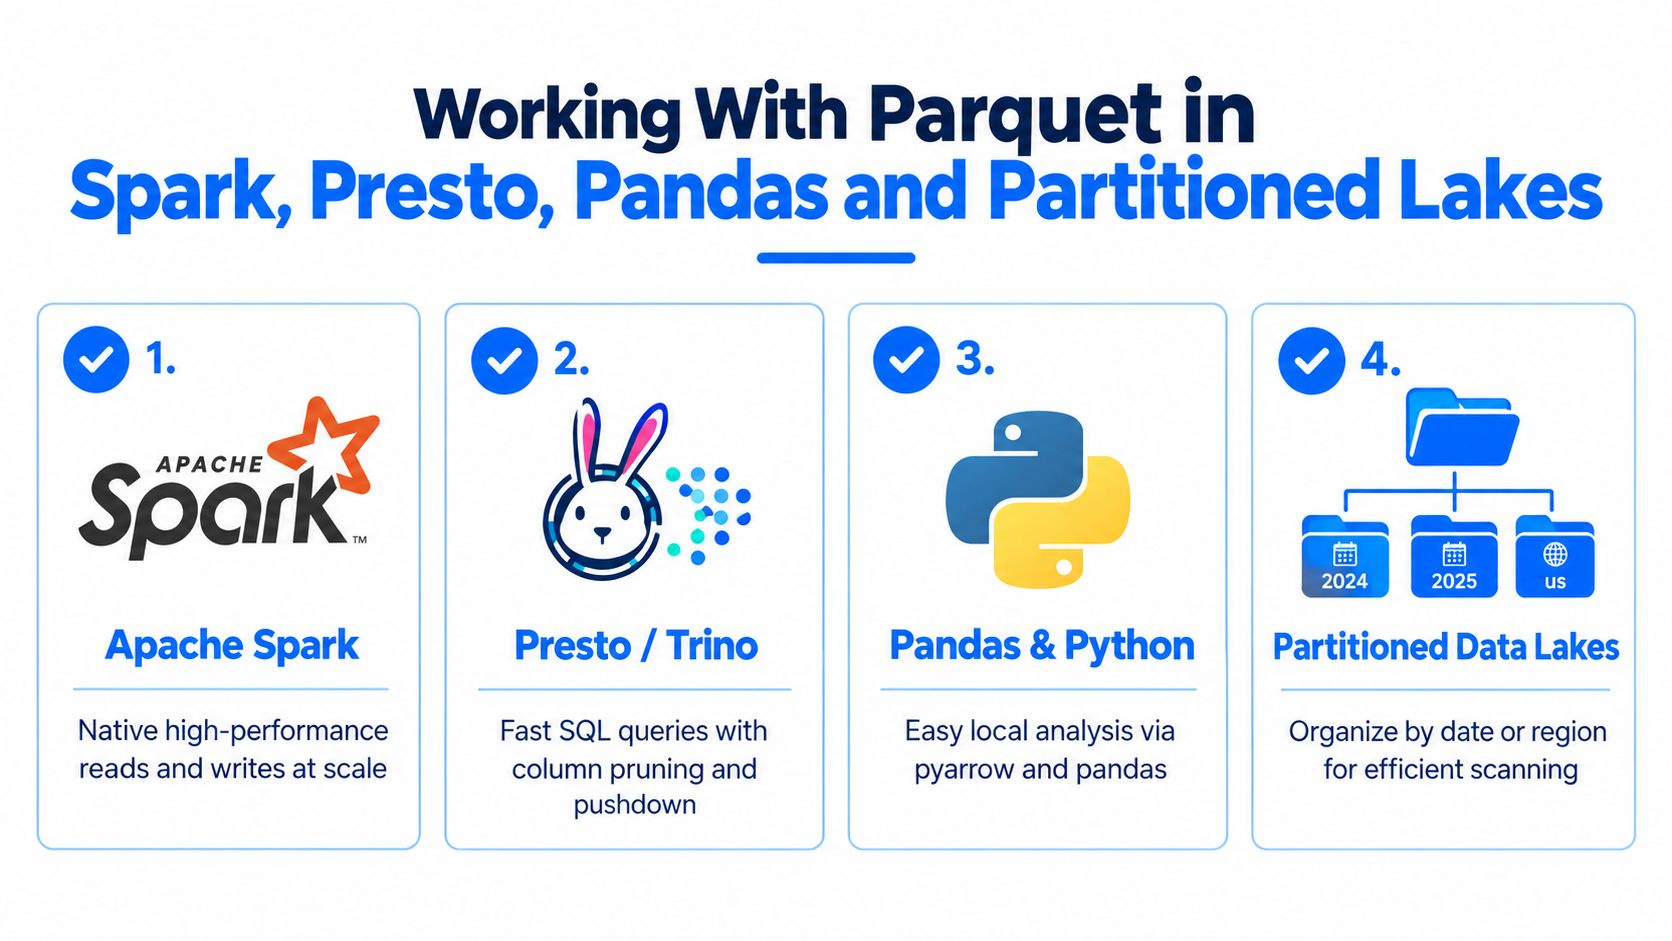
Cómo se ve esto en pipelines reales
En Spark, Parquet encaja de forma natural con lecturas y escrituras distribuidas de gran tamaño. En Presto o Trino, la poda de columnas y el predicate pushdown son centrales para un SQL rápido sobre datos del lago. En Pandas, los equipos suelen leer Parquet mediante herramientas basadas en Arrow para análisis local y flujos de desarrollo.
Ese soporte amplio es una razón por la que Parquet se convirtió en la opción por defecto para conjuntos de datos compartidos. Las herramientas no necesitan adaptadores especiales y puntuales solo para participar.
Para equipos con pipelines tipo lakehouse en Databricks, la observabilidad de plataforma de datos para entornos Databricks se vuelve relevante en cuanto crecen el número de conjuntos de datos y el volumen de trabajos. Los problemas de disposición de archivos, las particiones tardías y los desajustes de esquema tienden a aparecer primero como ruido operativo, no como errores evidentes de formato.
La lista de comprobación práctica
Parquet funciona mejor cuando los equipos gestionan el conjunto de datos, no solo el archivo individual.
Particiona con moderación: organiza los datos por campos que coincidan con los filtros habituales, como fecha o región, pero no fragmentes el árbol de directorios en pedazos diminutos.
Evita los archivos pequeños: demasiados archivos Parquet diminutos pueden anular las ventajas de un buen formato, porque los motores gastan tiempo abriendo y planificando muchos objetos.
Trata la evolución del esquema con cuidado: añadir columnas suele ser manejable. Los cambios de tipo incompatibles son donde empiezan a romperse pipelines y paneles.
Estandariza los patrones de escritura: las convenciones mezcladas entre productores generan fricción evitable para los lectores posteriores.
El formato de archivo puede ser correcto y el conjunto de datos seguir siendo difícil de operar. La mayor parte del dolor con Parquet viene de errores de disposición, particionado o gestión de esquema.
Un hábito operativo que compensa
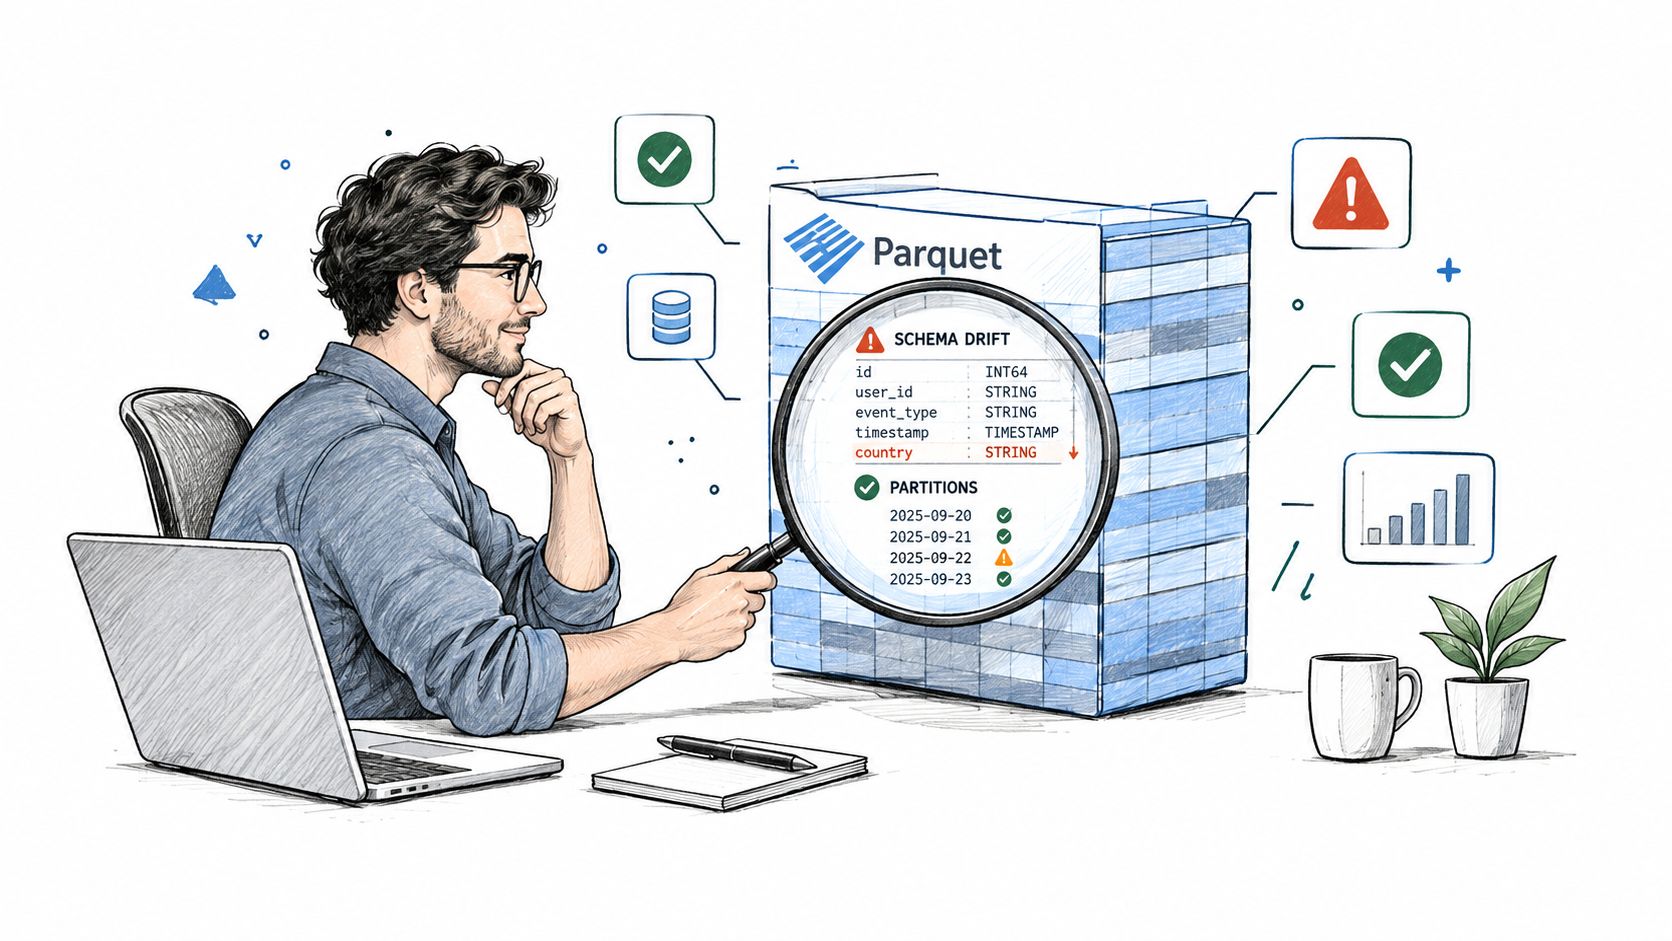
Sigue la desviación de esquema de forma deliberada. Si un productor escribe customer_id como cadena y otro lo hace distinto, el problema no siempre se manifiesta como una escritura fallida. A veces aparece más tarde como nulos desconcertantes, particiones omitidas o un modelo de BI que ya no compila.
Ahí es donde la observabilidad se une al conocimiento del formato. Una opción que usan los equipos es digna, que se ejecuta en el entorno del cliente y puede monitorizar cambios de esquema, Timeliness, anomalías y controles de validación en conjuntos de datos de lago y almacén. En plataformas con mucho Parquet, esos controles ayudan a detectar los casos en los que los archivos siguen siendo legibles técnicamente pero inseguros en la operación.
Garantizar datos Parquet fiables con observabilidad y controles de calidad
Un archivo Parquet puede ser perfectamente válido y aun así provocar un panel roto el lunes por la mañana. Esa es la parte que muchos equipos aprenden por las malas.
Dónde aparecen de verdad los problemas de fiabilidad
Los modos de fallo habituales no son exóticos:
Un productor añade o elimina columnas y las transformaciones posteriores no se adaptan con limpieza.
Una partición llega tarde, de modo que el panel de ayer parece completo pero no lo está.
Los valores de los datos se desplazan aunque la estructura del archivo siga pareciendo correcta.
El número de archivos se dispara y los motores gastan más tiempo gestionando objetos que leyendo datos útiles.
Ninguno de esos problemas se resuelve diciendo «usamos Parquet». El formato aporta almacenamiento eficiente y metadatos útiles. No garantiza que los productores escriban esquemas consistentes ni que los trabajos entreguen datos a tiempo.
Qué monitorizar en torno a los conjuntos de datos Parquet
Una operación fiable de Parquet suele incluir controles en varias categorías:
Seguimiento de esquema: detecta campos añadidos, eliminados o modificados antes de que fallen los lectores posteriores.
Controles de Timeliness: vigila si las particiones o cargas esperadas llegan cuando deben.
Validación de datos: confirma que las reglas de negocio siguen cumpliéndose tras transformaciones y reescrituras.
Detección de anomalías: advierte desplazamientos inusuales en recuentos de filas, patrones de nulos o métricas de negocio.
Los equipos que aplican prácticas de observabilidad de datos sobre los conjuntos del lago detectan estos problemas antes, sobre todo cuando los controles se ejecutan cerca de los datos y no después de que se rompan los informes.
Un formato de archivo válido no equivale a un conjunto de datos fiable. La fiabilidad viene de monitorizar comportamiento, estructura y entrega a lo largo del tiempo.
Si estás explicando a otros qué es un archivo Parquet, esa es la respuesta madura con la que conviene dejarlos. Parquet es un formato columnar potente para analítica. Sus row groups, column chunks, pages y metadatos hacen posibles las lecturas selectivas. Pero a escala empresarial, la métrica de éxito no es solo si las consultas van rápido. Es si los equipos pueden confiar en los datos que esas consultas devuelven.
digna ofrece a los equipos una forma de monitorizar, dentro de su propio entorno, el comportamiento en torno a los conjuntos de datos Parquet, incluidos cambios de esquema, Timeliness, anomalías y controles de validación en lagos, almacenes y pipelines. Si estás estandarizando en Parquet y quieres la eficiencia del formato sin puntos ciegos en fiabilidad, visita digna.
Ejecutar esos controles de forma continua, en lugar de muestrearlos cuando ya se ha roto un panel, es precisamente para lo que sirve la observabilidad de plataforma de datos.
Preguntas frecuentes
¿Qué es un archivo Parquet?
Apache Parquet es un formato de archivo de código abierto y orientado a columnas creado para cargas analíticas. Cada archivo empieza con un número mágico PAR1 de 4 bytes y termina con un pie que contiene el esquema, la ubicación de los row groups y las estadísticas de columna, que es lo que permite a los motores de consulta saltarse datos que nunca necesitan leer.
¿En qué se diferencia un archivo Parquet de un CSV?
CSV almacena los valores fila a fila, así que el motor analiza cada campo de cada fila aunque la consulta toque tres columnas. Parquet agrupa los valores de cada columna, de modo que los motores leen solo lo solicitado. CSV resulta más cómodo en las fronteras de ingesta; Parquet compensa con consultas analíticas repetidas.
¿Qué son los row groups, column chunks y pages en Parquet?
Son tres capas anidadas dentro del archivo. Un row group es una porción horizontal de la tabla; dentro de él, los valores de cada columna viven en un column chunk; cada chunk se divide en pages, las unidades que Parquet codifica y comprime realmente. El tamaño del row group determina cuánto puede saltarse una consulta.
¿La ventaja de velocidad de Parquet es solo compresión?
La compresión es solo una de tres razones. La codificación —diccionario, run-length, delta— reestructura los valores antes de que actúe cualquier códec, la compresión reduce después esos bytes codificados por columna, y los metadatos del pie permiten al motor no abrir siquiera los row groups irrelevantes. Los metadatos suelen ahorrar más tiempo que los bytes ahorrados en disco.
¿Qué herramientas pueden leer archivos Parquet?
Parquet está soportado en Spark, Presto y Trino, en Pandas mediante herramientas basadas en Arrow y en la mayoría de motores cercanos al almacén. Spark encaja con lecturas y escrituras distribuidas de gran tamaño, Presto y Trino se apoyan en la poda de columnas y el predicate pushdown, y Pandas sirve para el análisis local. Sigue la desviación de esquema entre productores, ya que los tipos discordantes afloran más tarde como nulos desconcertantes.



