Guía de patrones de diseño de datos para equipos modernos
|
8
minuto de lectura

Su equipo tiene un data warehouse, un pipeline de streaming y dashboards que no coinciden en la misma métrica de clientes. Un analista confía en la tabla de finanzas, otro en un data mart departamental y un tercero ha añadido un filtro para que el informe de ayer cuadre. El problema no es necesariamente la tecnología de base de datos. Es que nadie se puso de acuerdo sobre el patrón de diseño de datos, las reglas que determinan cómo se estructura, gobierna y comprueba la información una vez en producción.
Un patrón útil hace algo más que producir un diagrama de arquitectura atractivo. Ofrece a los ingenieros una forma repetible de capturar datos, conectar hechos relacionados, atender distintas cargas de trabajo y sacar a la luz los fallos antes de que los usuarios tomen decisiones con información errónea. Los patrones más sólidos también hacen explícita la responsabilidad, definen qué cambios son aceptables y conservan evidencias de lo que el sistema sabía en un momento determinado.
Índice de contenidos
Qué significa realmente un patrón de diseño de datos
Los equipos suelen recurrir a un patrón tras el primer desacuerdo doloroso. Un pipeline funciona para un departamento y luego otro equipo necesita los mismos datos con una definición, un calendario de entrega o un historial diferentes. Los ingenieros empiezan a añadir excepciones. Los analistas crean transformaciones duplicadas. Al final, la organización tiene varias respuestas a una pregunta que debería tener una sola.
Piense en un patrón de diseño de datos como en una receta de cocina. La receta no impone la marca del horno ni el color de los platos. Especifica los ingredientes, el orden de preparación, las relaciones entre los componentes y las comprobaciones que indican al cocinero si el resultado se puede servir con seguridad. Un patrón de datos hace lo mismo con los sistemas de información.

La estructura es solo la primera capa
Un patrón es una respuesta reutilizable a un problema de diseño recurrente. Puede organizar hechos y dimensiones analíticos, conservar cada evento de negocio, centralizar definiciones compartidas o permitir que los dominios publiquen productos de datos bajo estándares comunes. El patrón proporciona al equipo un vocabulario para tomar decisiones antes de que los detalles de implementación tomen el control.
Un diagrama de arquitectura muestra componentes y conexiones. Un patrón va más allá al explicar por qué existen esos componentes y cómo se comportan ante los cambios. Dos diagramas pueden parecer similares y producir resultados muy distintos si uno define la responsabilidad, el historial y la validación y el otro deja esas preguntas sin respuesta.
Un patrón práctico responde a tres preguntas:
¿Cómo se estructuran los datos? Identifique entidades, eventos, relaciones, granularidad, claves, historial y modelos de servicio.
¿Cómo se gobiernan los datos? Defina responsabilidad, nomenclatura, significado de negocio, acceso, linaje y reglas de compatibilidad.
¿Cómo se hacen visibles los fallos? Especifique expectativas de actualidad, comprobaciones de validación, monitorización del esquema, umbrales de anomalías y escalado.
Regla práctica: si un patrón no explica qué ocurre cuando una carga llega tarde o un campo cambia de tipo, es un boceto estructural, no un diseño operativo.
Esta distinción importa antes de elegir un data warehouse, un lakehouse, un message broker o una herramienta de orquestación. La tecnología puede implementar un patrón, pero no puede decidir si el historial de direcciones de un cliente pertenece a un flujo de eventos inmutable, a una tabla de estado actual o a ambos. El equipo debe tomar primero esa decisión y después codificarla de forma coherente.
Cómo el data warehousing empresarial nos dio los primeros patrones
A finales de la década de 1980, las empresas intentaban convertir la información dispersa en los sistemas operativos en algo que los directivos pudieran utilizar para el análisis. Un artículo del IBM Systems Journal publicado en 1988 utilizó la expresión «business data warehouse», un hito importante en la formalización de la idea de integrar información de varios sistemas operativos para el análisis de negocio. William Inmon desarrolló más tarde el patrón de data warehouse orientado a la empresa y publicó Building the Data Warehouse en 1992.
Pensemos en una organización sanitaria que intenta responder a una pregunta sencilla: ¿cuánto gastó cada departamento en un episodio asistencial de un paciente? Los sistemas de origen pueden registrar por separado las citas, las reclamaciones, los pagos y la información de los proveedores. Con el enfoque de Inmon, la organización lleva primero datos detallados, históricos e integrados a un data warehouse empresarial central. La capa de integración reduce las definiciones incoherentes antes de que los equipos posteriores reciban subconjuntos temáticos. El patrón de Inmon suele utilizar estructuras relacionales normalizadas, que favorecen la trazabilidad y reducen la redundancia en la capa compartida.
Este enfoque trata el data warehouse como el libro mayor del significado de la organización, gestionado con esmero. Un equipo de finanzas y un equipo de operaciones clínicas pueden seguir recibiendo vistas distintas, pero ambos heredan los mismos fundamentos gobernados.
El enfoque dimensional de Ralph Kimball parte de una pregunta diferente: ¿qué proceso de negocio deben analizar los usuarios? Su método, formalizado en The Data Warehouse Toolkit, publicado por primera vez en 1996, popularizó las tablas de hechos, las tablas de dimensiones, los esquemas en estrella y las dimensiones conformadas. El equipo sanitario podría construir una tabla de hechos de reclamaciones conectada a las dimensiones de paciente, proveedor, departamento, pagador y tiempo. Los analistas pueden consultar directamente el proceso de negocio sin tener que navegar por un modelo empresarial muy normalizado.
La mayoría de las organizaciones combinan ambas filosofías. Mantienen una capa canónica o integrada para el significado compartido, el linaje y la gobernanza, y después publican data marts dimensionales para los informes y el análisis de KPI. Ese modelo híbrido sigue presente en las arquitecturas modernas de data warehouse empresarial, incluso cuando la infraestructura subyacente es un data warehouse en la nube o un lakehouse.
La lección perdurable es sencilla. Dónde reside la verdad y cómo se consume son decisiones relacionadas, pero no son la misma decisión.
El modelado dimensional en la práctica
Un equipo de ventas rara vez pregunta: «¿Puedo explorar su modelo relacional normalizado?». Pregunta: «¿Cuánto vendimos, a quién, en qué tienda y en qué periodo?». El modelado dimensional funciona bien porque organiza los datos en torno a esas preguntas de negocio.
Empiece por un evento medible, como una línea de pedido. La tabla de hechos almacena los detalles numéricos y operativos del evento, como la cantidad, los ingresos, el descuento, la marca de tiempo del pedido, la clave de producto, la clave de cliente y la clave de tienda. Las tablas de dimensiones aportan el contexto descriptivo que hace útil cada fila. Producto describe el artículo, cliente describe al comprador, tienda describe la ubicación y tiempo aporta los atributos de calendario y de informes.
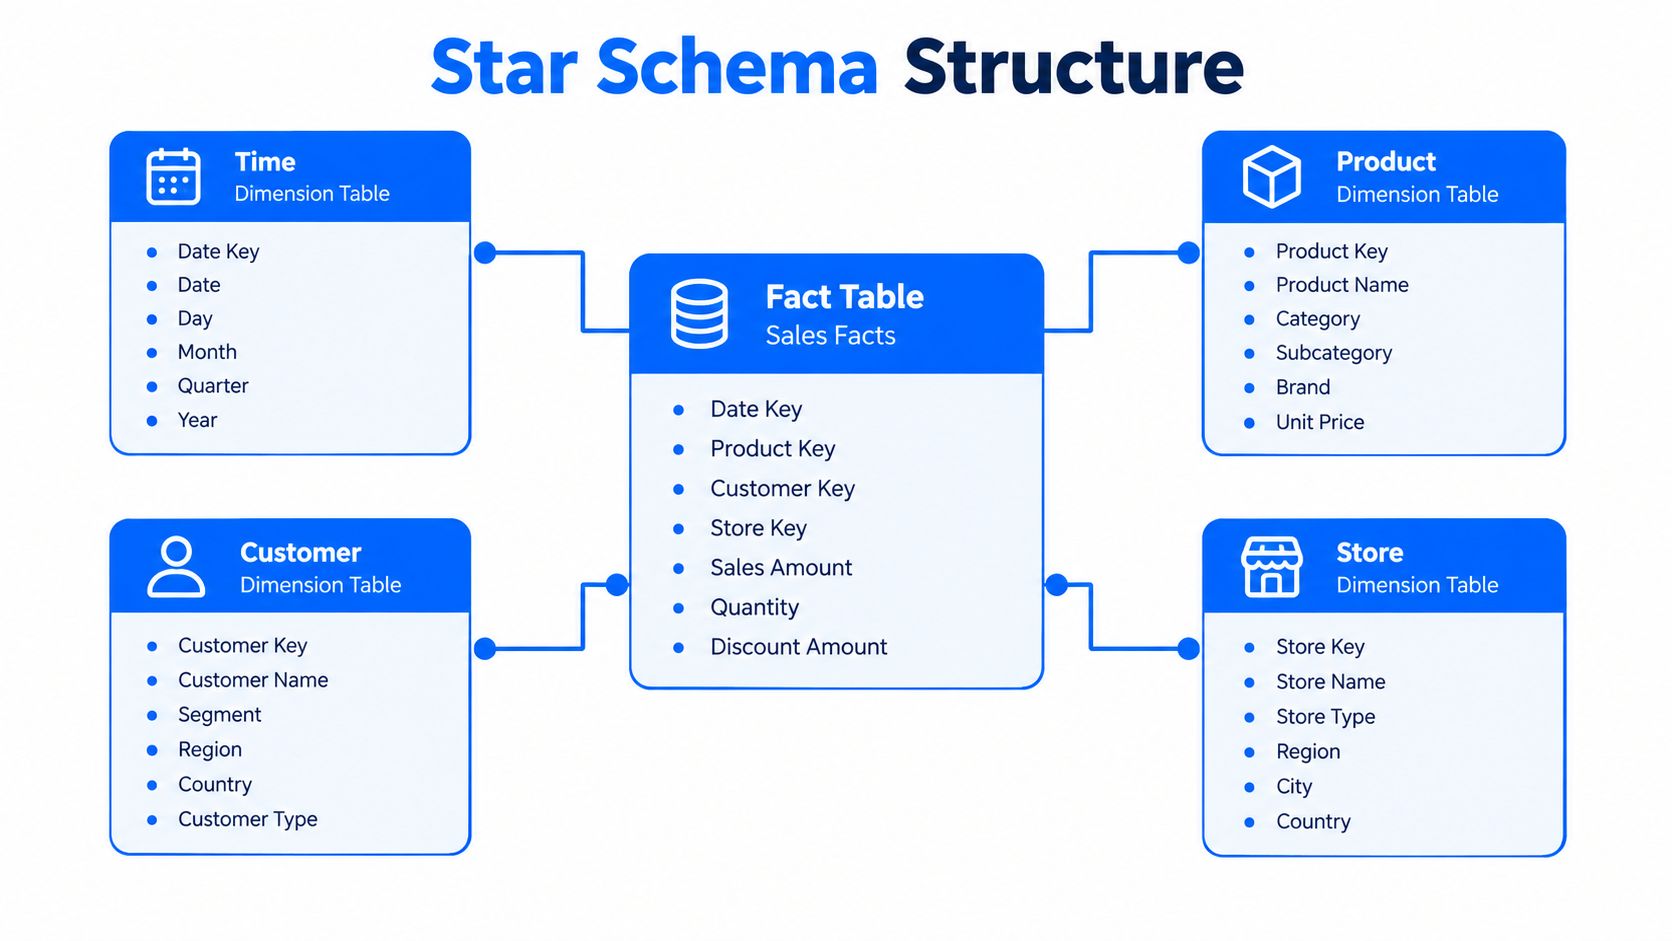
La granularidad va antes que las columnas
Antes de añadir campos, declare la granularidad en una frase: «Una fila representa un producto en un pedido». Esa frase evita un fallo habitual: mezclar valores a nivel de pedido y a nivel de línea en la misma tabla de hechos. Si los ingresos se repiten en varias filas de producto, una simple suma puede sobrestimar las ventas.
Una dimensión conformada utiliza la misma definición de negocio en todos los data marts. Si la dimensión de cliente significa «cliente de facturación» en finanzas pero «usuario final» en la analítica de producto, el nombre compartido crea una falsa coherencia. Los equipos deben definir el significado, las claves, el historial y las relaciones válidas, y después poner esas reglas a disposición de todos los consumidores. Una guía sobre tablas de hechos y dimensiones puede ayudar a los equipos a establecer este vocabulario antes de crear informes.
La exactitud histórica plantea otra decisión de diseño. Supongamos que un cliente cambia de segmento, de pequeña empresa a gran empresa. Una dimensión de estado actual mostrará el segmento más reciente, pero un informe histórico de ventas puede necesitar el segmento vigente cuando se produjo cada pedido. Las técnicas de dimensiones lentamente cambiantes conservan el historial adecuado, según si el negocio quiere conservar los valores anteriores, sobrescribirlos o registrar periodos de vigencia.
Dónde se gana su lugar el patrón
El modelado dimensional compensa cuando las preguntas dominantes son cuánto, con qué frecuencia, dónde, cuándo o quién. Los esquemas en estrella son accesibles para los analistas, admiten joins predecibles y facilitan compartir la lógica de los KPI. Un contrato estable entre hechos y dimensiones también ofrece a los equipos de calidad puntos claros para comprobar la integridad referencial, las tasas de nulos, las claves duplicadas y las medidas inesperadas.
El patrón se resiente cuando la carga de trabajo depende de documentos irregulares, eventos no estructurados de gran volumen o la reconstrucción con calidad de auditoría de cada cambio de estado. Puede representar esas entradas, pero forzar cada problema en un esquema en estrella suele ocultar el historial original de eventos. Por eso, muchas plataformas maduras conservan registros sin procesar o canónicos y exponen data marts dimensionales como capa de servicio.
Event sourcing y la lógica de solo anexar
Un saldo bancario parece un valor de estado actual, pero la conciliación depende del historial que hay detrás. Si un saldo se modifica de forma incorrecta y el sistema solo almacena la cifra más reciente, los investigadores no tienen una forma fiable de reconstruir cómo se obtuvo.
El event sourcing adopta el enfoque contrario. En lugar de actualizar una fila de saldo in situ, el sistema registra eventos como un depósito, una retirada, una transferencia o una corrección. El saldo actual pasa a ser una proyección calculada a partir de ese historial ordenado.

De los eventos a un estado utilizable
El patrón tiene tres partes prácticas:
Almacén de eventos de solo anexión: cada cambio de negocio se registra como un evento nuevo. Los eventos existentes no se sobrescriben.
Proyección: un consumidor lee los eventos y construye una representación consultable, como el saldo actual de la cuenta.
Reproducción y corrección: si cambia la lógica de proyección o el estado se corrompe, el equipo puede reconstruirlo a partir del historial de eventos.
Una corrección no borra la transacción original. Añade un evento compensatorio que preserva la cronología. Eso hace que el sistema sea útil para auditorías, depuración, análisis histórico y reproducción de incidentes.
Es posible que el modelo de lectura no se actualice exactamente en el mismo momento que el registro de eventos. Por ello, los equipos deben aceptar y comunicar la consistencia eventual allí donde encaje con el proceso de negocio. También necesitan versionado de eventos, consumidores idempotentes, reglas de ordenación, decisiones de retención y una estrategia de snapshots para cuando reproducir un historial largo resulte costoso.
Elíjalo por trazabilidad, no por moda
El event sourcing es una base sólida cuando el negocio debe responder: «¿Qué ocurrió, en qué orden y por qué el estado actual es así?». Los libros contables, los historiales de flujos de trabajo, los movimientos de inventario y los eventos de dominio distribuidos son candidatos naturales.
No es una buena opción por defecto para cualquier aplicación CRUD. Las lecturas se vuelven más complejas porque los usuarios suelen necesitar una proyección en lugar del registro de origen. Los equipos deben mantener el código de proyección y gestionar la convergencia diferida. Una tabla convencional de estado actual puede ser más clara cuando el negocio solo necesita el valor más reciente y no requiere un historial reconstruible.
Los equipos de lakehouse pueden combinar una ingesta orientada a eventos con un formato de tabla abierto y modelos de servicio materializados. La descripción general de los formatos de tabla abiertos ofrece un contexto útil para separar el historial duradero de los datos de los modelos que consultan los consumidores.
El registro de eventos es la evidencia. La proyección es la interpretación práctica.
Modelos canónicos frente a responsabilidad por dominios
Un modelo canónico sostiene que la organización debe acordar definiciones compartidas en una capa de integración. Un modelo basado en dominios sostiene que el equipo más cercano a una capacidad de negocio debe publicar un producto de datos utilizable y responsabilizarse de su calidad.
Ninguna de las dos posturas resuelve todos los problemas. Un modelo central puede evitar definiciones contradictorias, pero un equipo central puede convertirse en una cola para cada cambio. Un modelo por dominios puede acercar las decisiones al origen, pero equipos separados pueden publicar significados incompatibles de «cliente», «cuenta activa» o «pedido completado».
Dimensión | Modelo canónico | Data mesh |
|---|---|---|
Responsabilidad | Un equipo central de datos o de integración custodia las definiciones compartidas | Los equipos de dominio son responsables de los productos de datos creados a partir de sus capacidades de negocio |
Gobernanza | Las reglas empresariales coherentes son más fáciles de aplicar de forma centralizada | Los estándares federados coordinan a los equipos sin eliminar la responsabilidad de los dominios |
Velocidad de entrega | Los cambios entre dominios pueden requerir revisión y alineación centrales | Los dominios pueden iterar más rápido dentro de reglas de interoperabilidad compartidas |
Riesgo | El equipo central puede convertirse en un cuello de botella o alejarse del contexto de origen | Las definiciones, la calidad y las interfaces pueden divergir sin contratos sólidos |
Los argumentos a favor del modelo canónico
Los modelos canónicos son adecuados para organizaciones que necesitan un vocabulario regulatorio común, controles financieros compartidos o trazabilidad entre departamentos. La capa de integración actúa como un diccionario. Resuelve las diferencias entre sistemas de origen antes de que los analistas y las aplicaciones consuman los datos.
El coste es la coordinación. Un equipo central debe entender muchos dominios, gestionar solicitudes de cambio y mantener el modelo relevante a medida que evoluciona el negocio. Si se convierte en el único grupo autorizado a publicar datos útiles, la entrega se ralentiza y los expertos de dominio pierden la responsabilidad.
Los argumentos a favor de los dominios
Data mesh asigna la responsabilidad a dominios como facturación, logística o atención al cliente. Cada dominio publica datos como un producto, con documentación, expectativas de calidad, controles de acceso y un compromiso de servicio. Una capa de gobernanza federada sigue definiendo reglas compartidas de interoperabilidad, seguridad y descubrimiento.
Esto solo funciona cuando los equipos de dominio tienen las competencias y la capacidad para operar productos de datos. La organización debe proporcionar herramientas comunes y hacer cumplir los contratos; de lo contrario, la descentralización se convierte en pipelines duplicados con supuestos diferentes. A los equipos que trabajan con límites de dominio también les puede resultar útil esta guía sobre el modelado de agregados para SaaS, especialmente cuando la responsabilidad de negocio y los límites del sistema deben alinearse.
Un compromiso práctico mantiene una capa canónica para los conceptos compartidos de alto riesgo y permite que los dominios publiquen productos especializados a su alrededor. La gobernanza de datos federada puede respaldar ese equilibrio definiendo qué debe ser coherente en todas partes y qué pueden adaptar los dominios localmente.
Comparativa de los tres patrones principales
Los tres patrones resuelven problemas principales distintos. El modelado dimensional optimiza la navegación analítica. El event sourcing preserva una secuencia de cambios. El modelado canónico establece un significado compartido entre sistemas y equipos.
Sus diferencias se ven con más claridad cuando se evalúan en función de la carga de trabajo y no de las preferencias personales.
Criterio | Modelado dimensional | Event sourcing | Modelo canónico |
|---|---|---|---|
Rendimiento de las consultas | Sólido para consultas y agregaciones de BI repetidas | Suele requerir proyecciones o snapshots para lecturas cómodas | Depende de la capa de servicio; las estructuras normalizadas pueden necesitar modelos posteriores |
Encaje con la gobernanza | Contratos claros de métricas y dimensiones | Historial y trazabilidad sólidos, con más disciplina en la gestión de eventos | El más sólido para definiciones centrales, linaje y datos compartidos regulados |
Preparación para la IA | Útil para features seleccionadas y métricas de negocio etiquetadas | Valioso para la reproducción, features temporales e historiales de comportamiento | Útil para features coherentes y semántica compartida entre dominios |
Coste operativo | Moderado, con mantenimiento del modelado y de las dimensiones históricas | Más alto, porque hay que operar registros, proyecciones, versionado y reproducción | Mayor coste de coordinación, sobre todo cuando muchos dominios dependen de cambios centrales |
Mejor pregunta de partida | «¿Qué deben agregar y comparar los usuarios?» | «¿Qué secuencia produjo este estado?» | «¿Qué definición debe compartir cada sistema?» |
La tabla no señala un ganador universal porque una plataforma real a menudo necesita los tres. Una capa canónica puede establecer definiciones compartidas de cliente, producto y finanzas. Los data marts dimensionales pueden convertir esas definiciones en modelos de informes accesibles. Los registros de eventos pueden conservar la evidencia necesaria para reproducir o auditar los cambios importantes.
Diagnostique la carga de trabajo dominante
Pregunte al equipo qué fallo sería más perjudicial:
Un informe lento o confuso: empiece por el modelado dimensional y defina la granularidad de cada hecho.
Un cambio de estado imposible de rastrear: conserve los eventos y construya proyecciones a partir del historial de solo anexión.
Definiciones empresariales contradictorias: establezca conceptos canónicos, responsabilidades y control de cambios.
Entradas de IA que derivan sin previo aviso: añada monitorización del comportamiento y responsabilidades al patrón estructural que elija.
La preparación para la IA no es solo una cuestión de almacenamiento. Los embeddings, las distribuciones de features, los resultados de recuperación y la actualidad de las entradas del modelo pueden cambiar mientras el esquema de la tabla sigue siendo válido. Un patrón que solo gobierna columnas puede pasar por alto fallos semánticos.
Por qué un diagrama limpio no es suficiente
Una pizarra puede mostrar un flujo pulido desde los sistemas de origen hasta un data warehouse, un data mart, un dashboard y un modelo. Lo que no puede mostrar es quién recibe la alerta cuando el archivo de ayer llega tarde, qué regla valida el importe de una reclamación o cómo demuestra un auditor que un informe utilizó los datos correctos en un momento histórico.
Esa brecha convierte la arquitectura en riesgo operativo. Un patrón fiable define el comportamiento de entrega esperado, el punto de validación, la responsabilidad, la política de compatibilidad y la evidencia que se conserva tras cada carga importante.
Coloque los controles de confianza junto al movimiento de datos
Un equipo que elige un patrón debe especificar controles en tres puntos:
Ingesta: compruebe la llegada, el volumen, la estructura básica, los duplicados y los campos obligatorios.
Transformación: valide las reglas de negocio, las relaciones, los valores aceptados y la lógica de conciliación.
Consumo: monitorice el comportamiento de los KPI, la actualidad visible para los usuarios, los fallos posteriores y la idoneidad de las entradas del modelo.
La evolución del esquema necesita el mismo tratamiento. Los campos adicionales que admiten nulos pueden ser compatibles con los consumidores existentes, mientras que el estrechamiento de tipos o el cambio de nombre semántico pueden romperlos. La disposición de las particiones debería seguir siendo un detalle de implementación siempre que sea posible, de modo que los consumidores consulten tablas lógicas en lugar de rutas de directorio fijas. La evolución basada en metadatos, tal como se documenta en la guía de diseño de Apache Iceberg, permite cambiar la disposición física mientras los archivos históricos conservan sus especificaciones originales.
La evidencia cambia el estándar
Más del 56 % de los encuestados en analytics engineering señalaron la calidad de los datos como el reto mencionado con más frecuencia, mientras que el 38 % tenía previsto aumentar la inversión en calidad de datos u observabilidad al año siguiente, según el State of Analytics Engineering 2025 de dbt. Estas cifras respaldan una conclusión práctica: la gobernanza y la observabilidad forman parte del patrón, no de un backlog de operaciones posterior.
Un diseño fiable facilita encontrar, explicar, contener y corregir los datos erróneos.
Para cada conjunto de datos crítico, registre el responsable, el comportamiento de entrega esperado, la versión del esquema, los resultados de validación, el linaje y el historial de incidentes. Después, defina qué ocurre cuando falla una comprobación. ¿Se detiene el pipeline, se ponen los registros en cuarentena, se publica un aviso o se continúa con un estado degradado explícito? La respuesta correcta depende del impacto en el negocio, pero dejarla sin especificar garantiza respuestas incoherentes.
Cómo elegir y poner en marcha su patrón
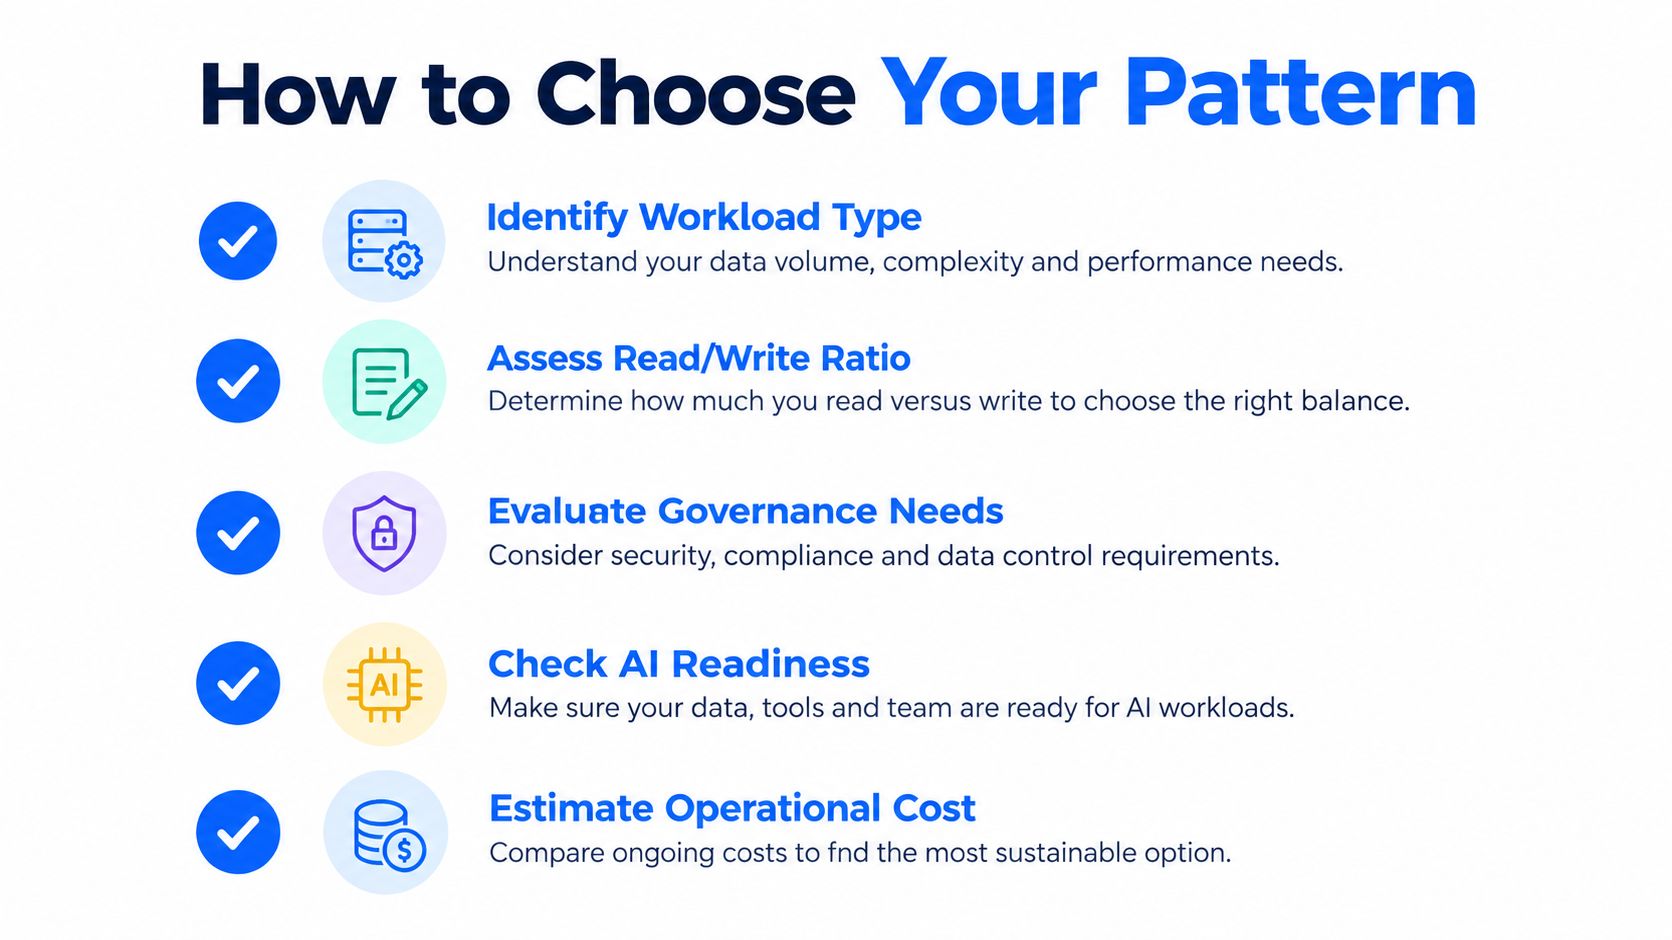
Lleve a cabo una breve revisión de diseño y anote cinco decisiones:
Identifique la carga de trabajo dominante. Los informes, la auditoría, el servicio operativo, la reacción en tiempo real y la generación de features para IA necesitan estructuras diferentes.
Elija el patrón principal. Seleccione el modelo que resuelve el problema más importante y añada después capas de apoyo de forma deliberada.
Defina contratos. Establezca la granularidad, las claves, los significados, las expectativas de actualidad, la compatibilidad del esquema y la responsabilidad.
Incorpore controles. Añada monitorización de llegadas, validación de registros, detección de anomalías, alertas de deriva del esquema, linaje y evidencia histórica.
Pruebe el comportamiento ante fallos. Simule datos tardíos, valores inesperados, cambios estructurales, eventos duplicados y reconstrucciones de proyecciones.
Para las cargas de trabajo de IA, amplíe la lista de comprobación más allá de las columnas. Decida cómo detectará el equipo la deriva de los embeddings, los cambios en la distribución de las features, la degradación de la recuperación y las entradas del modelo obsoletas. Una tabla técnicamente válida puede seguir produciendo un modelo poco fiable si su comportamiento cambia sin un responsable que rinda cuentas.
Una plataforma como el enfoque de gestión de productos de datos de digna puede encajar en esta capa operativa al combinar validación dentro de la base de datos, monitorización de la actualidad, detección de anomalías y seguimiento de cambios de esquema dentro del entorno del cliente. La decisión importante no es solo la herramienta. Es si el patrón proporciona a personas concretas evidencia suficiente para actuar cuando los datos dejan de comportarse como se espera.
digna ayuda a los equipos a monitorizar el comportamiento de los datos dentro de su propio entorno mediante validación dentro de la base de datos, monitorización de la actualidad, detección de anomalías y seguimiento de cambios de esquema. Si está convirtiendo un diagrama de arquitectura estático en un contrato operativo de confianza, visite digna para ver cómo la plataforma puede respaldar ese trabajo.
Como un estrechamiento de tipos o un cambio de nombre semántico pueden romper a los consumidores mientras todos los pipelines siguen funcionando, el Schema Tracker de digna registra los cambios estructurales en las tablas monitorizadas para que la política de compatibilidad de su patrón tenga una alerta que la respalde.
Preguntas frecuentes
¿Qué es un patrón de diseño de datos?
Un patrón de diseño de datos es una respuesta reutilizable a un problema de datos recurrente que abarca tres aspectos: cómo se estructuran los datos, cómo se gobiernan y cómo se hacen visibles los fallos. Como una receta, define los ingredientes, el orden y las comprobaciones, no la marca del horno, por lo que orienta las decisiones antes de elegir cualquier data warehouse o herramienta.
¿Cuál es la diferencia entre los enfoques de Inmon y Kimball?
Inmon parte de un data warehouse empresarial central y normalizado que integra el historial detallado antes de que los equipos reciban subconjuntos temáticos. Kimball parte del proceso de negocio y construye tablas de hechos, tablas de dimensiones y esquemas en estrella para el análisis directo. La mayoría de las organizaciones combinan ambos: mantienen una capa integrada para el significado compartido y publican data marts dimensionales para los informes.
¿Por qué hay que definir primero la granularidad de una tabla de hechos?
Declarar la granularidad, por ejemplo una fila por producto en un pedido, evita mezclar valores a nivel de pedido y a nivel de línea en la misma tabla. Sin ella, los ingresos repetidos en varias filas de producto se suman varias veces y sobrestiman las ventas. La frase que define la granularidad debe escribirse antes de añadir cualquier columna.
¿Cuándo conviene usar event sourcing en lugar de una tabla de estado actual?
Conviene usar event sourcing cuando el negocio debe explicar qué ocurrió, en qué orden y por qué el estado actual es el que es. Los libros contables, los historiales de flujos de trabajo y los movimientos de inventario encajan bien. Para aplicaciones CRUD que solo necesitan el valor más reciente, una tabla simple es más clara, ya que las proyecciones y la consistencia eventual suponen un coste operativo real.
¿Debe una plataforma de datos usar un modelo canónico o data mesh?
A menudo, ambos. Un compromiso práctico mantiene una capa canónica para los conceptos compartidos de alto riesgo, como las definiciones de cliente, producto y finanzas, mientras los equipos de dominio publican productos de datos especializados a su alrededor. La gobernanza federada decide entonces qué debe ser coherente en todas partes y qué pueden adaptar los dominios localmente, evitando tanto un cuello de botella central como definiciones divergentes.


