Análisis de peligros operacionales para equipos de datos
|
6
minuto de lectura

Muchos equipos siguen tratando el análisis de peligros operacionales como un trámite de aprobación. Redactan el checklist, aprueban la versión y dan por hecho que el panorama de riesgos se mantendrá estable hasta la siguiente revisión. Ese hábito no funciona en las operaciones modernas de datos e IA, donde los fallos más relevantes suelen aparecer después del despliegue, no antes.
Las revisiones estáticas pasan por alto las señales que cambian los resultados: la deriva de esquemas, las cargas tardías, las rutas de validación rotas, los cambios en la autoridad de la automatización y los atajos humanos que nunca aparecen en un documento previo al lanzamiento. El patrón más seguro es un análisis de peligros continuo y basado en datos, en el que las métricas de observability actúan como evidencia en vivo y cualquier cambio en el entorno operativo puede reabrir la cuestión del riesgo.
Índice de contenidos
Replantear el análisis de peligros operacionales en las operaciones de datos
El análisis de peligros operacionales solo funciona cuando sigue al sistema, no al calendario. Una revisión única puede detectar fallos de diseño evidentes, pero no puede seguir el ritmo de un pipeline cuyos datos de origen, lógica de orquestación o uso downstream cambian semana a semana. Esa brecha importa porque el peligro rara vez reside en un único síntoma. Normalmente se manifiesta como una cadena de pequeños fallos que coinciden en el peor momento.
Por qué fallan las revisiones puntuales
Un pipeline puede superar un checklist de lanzamiento y aun así volverse arriesgado más adelante. Un equipo upstream cambia un esquema, una transformación sigue ejecutándose, una tabla de reporting se llena de nulos y el negocio sigue actuando sobre datos obsoletos porque nadie ha relacionado esos eventos. Ahí es exactamente donde importa pensar en todo el ciclo de vida, porque el peligro no es solo el cambio de esquema, sino la ruta causal que va del cambio a una decisión errónea.
Regla práctica: si el entorno puede cambiar sin una versión formal, el análisis de peligros tiene que cambiar sin esperar a una revisión trimestral.
En este contexto, la data observability pasa a ser algo más que una comodidad para ingeniería. Cuando los retrasos, los fallos de validación, las discontinuidades en el recuento de filas o la deriva de esquemas se registran como evidencia operativa, se convierten en la materia prima del análisis de peligros, no en simple ruido en un dashboard. Un equipo que trata esas señales como entradas de seguridad puede reaccionar antes de que el problema se traduzca en pérdida de reporting, degradación del modelo o un fallo de control.
La data observability funciona mejor cuando se integra en la misma mentalidad de control que aplican los programas de seguridad en los sectores regulados. La pregunta útil no es si un pipeline “ha pasado”. Es si el sistema sigue comportándose como el análisis de peligros suponía que lo haría.
De los checklists cualitativos a los modelos cuantitativos

La disciplina moderna no nació con los dashboards. Nació cuando los ingenieros de seguridad dejaron de considerar suficientes los checklists genéricos y empezaron a modelar cómo se combinan los fallos. El análisis de árbol de fallos (FTA) surgió a principios de los años sesenta como un método deductivo que parte de un evento no deseado a nivel de sistema y trabaja hacia atrás hasta los fallos de componentes, las acciones humanas y las condiciones externas que podrían provocarlo. Bell Laboratories lo desarrolló entre 1961 y 1962 para el sistema de control de lanzamiento del misil Minuteman, y Boeing lo adoptó en 1963 para el análisis de seguridad de aviones comerciales, lo que llevó el análisis de peligros hacia modelos lógicos explícitos y cálculos de probabilidad. La revisión del FTA elaborada por la NASA traza esa evolución en sectores críticos para la seguridad como la energía nuclear, el procesamiento químico y la industria farmacéutica. Visión general del FTA de la NASA
Por qué la lógica clásica sigue siendo relevante
La lección central del FTA es estructural: los peligros se entienden mejor como combinaciones de condiciones observables que como incidentes aislados. En las operaciones de datos, un archivo de origen que llega tarde, una validación fallida y un cambio de esquema inadvertido forman un modelo de riesgo más útil que “el pipeline ha fallado”. La primera versión facilita la investigación y la prevención. La segunda sirve sobre todo para buscar culpables.
Un buen modelo de peligros nombra las condiciones que se pueden medir, no solo el resultado que todo el mundo percibe cuando el daño ya está hecho.
Esa lógica también ayuda a los equipos a identificar puntos únicos de fallo y conjuntos mínimos de corte, algo importante cuando una sola dependencia frágil puede romper toda una cadena de reporting. El objetivo no es convertir las plataformas de datos en sistemas aeroespaciales. El objetivo es aplicar la misma disciplina que hizo más fiable la ingeniería de alto riesgo.
Para los equipos que quieren trasladar esas ideas a la práctica analítica moderna, la simulación de Monte Carlo es un complemento útil cuando el espacio de entradas es incierto. No sustituye al análisis causal, pero permite someter a prueba de estrés cómo se comportan bajo carga las combinaciones de errores de tiempos, volumen y transformación.
Delimitar el sistema y trazar las cadenas causales

Un análisis de peligros es débil si los límites del sistema son difusos. Las directrices de gestión de la seguridad de la FAA exigen a los analistas definir el sistema y su contexto operativo, identificar los peligros con el detalle suficiente para determinar el riesgo, analizar la gravedad y la probabilidad, comparar el riesgo con los objetivos de rendimiento y reevaluar los controles con datos operativos. Esa visión de ciclo de vida encaja bien con las plataformas de datos, porque el sistema suele abarcar la ingesta, la transformación, el almacenamiento, la orquestación, la revisión humana y los consumidores downstream. Directrices de gestión de la seguridad de la FAA
Un mapa práctico de los límites
Empiece por la ruta completa de los datos, no solo por la tabla del data warehouse que todo el mundo consulta cada mañana. Incluya los feeds upstream, las ventanas de procesamiento por lotes, los procesadores de streaming, los modelos dbt, los pasos de aprobación, las intervenciones manuales y los equipos que consumen los datos para reporting o automatización. Si un riesgo puede entrar por un sistema upstream y aflorar tres capas después, pertenece al mismo análisis.
A continuación, redacte los peligros como cadenas causales. Una modificación del esquema puede romper una transformación, lo que puede generar un reporting regulatorio incompleto, lo que a su vez puede provocar un fallo de control en el proceso de revisión del negocio. Es un registro más sólido que “deriva de esquema”, porque identifica la condición desencadenante, la consecuencia y el contexto operativo en el que la pérdida se hace visible.
La arquitectura de sistemas de datos es importante en este punto, porque la arquitectura determina dónde hay evidencias disponibles y dónde se pueden colocar los controles. Si un equipo no puede señalar la etapa exacta en la que se detectan los retrasos, los picos de nulos o los registros no válidos, el análisis es abstracto.
La seguridad de los agentes de IA en finanzas es una referencia útil si se quiere ver cómo cambia el análisis de riesgos cuando la toma de decisiones automatizada entra en juego. El hilo común es sencillo: cuando el software puede actuar, los límites tienen que incluir tanto la acción como las condiciones que la vuelven insegura.
Qué debe contener cada registro de peligros
Un registro útil recoge el modo de operación, la condición desencadenante, la consecuencia, la gravedad, la probabilidad, las salvaguardas existentes, el responsable del control, la señal de detección y la autoridad de aceptación. Así, un peligro deja de ser un recuerdo y se convierte en un objeto gestionado. También facilita la reevaluación cuando el sistema cambia, porque el equipo sabe exactamente qué supuesto se ha incumplido.
Puntuar el riesgo con métricas de datos observables
Las puntuaciones de riesgo más sólidas surgen de combinar consecuencia y probabilidad, no de sumar síntomas. La política de la FAA define el riesgo de seguridad como la combinación de gravedad y probabilidad, y la práctica basada en MIL-STD-882 evalúa los peligros en el hardware, el software, las interfaces humanas y los entornos operativos. Esto es relevante en las operaciones de datos porque un mismo fallo técnico puede ser de bajo riesgo en un proceso de negocio y grave en otro. FAA Order 8040.4B
Convertir la observability en una señal de riesgo
Una carga tardía no es solo una molestia para ingeniería. Si el caso de uso downstream depende de datos actuales, el retraso aumenta la exposición al demorar una decisión o al alimentar un modelo con una puntuación obsoleta. Un desvío en la tasa de nulos puede indicar una captura incompleta en origen, un join fallido o una transformación rota, y cada uno de ellos afecta de forma distinta a la credibilidad del resultado.
Componente del riesgo | Definición abstracta | Métrica de datos observable |
|---|---|---|
Probabilidad | Con qué frecuencia puede producirse el peligro | Retraso de las cargas, tasas de validaciones fallidas |
Gravedad | Lo grave que podría ser el resultado | Impacto en los KPI de negocio, completitud del reporting regulatorio |
Detección | Con qué rapidez puede el equipo ver el problema | Latencia de las alertas, discontinuidades en el recuento de filas |
Solidez de los controles | En qué medida las salvaguardas bloquean o ponen de manifiesto el problema | Detección de cambios de esquema, cobertura de validación |
La tabla resulta más útil cuando los equipos dejan de tratarla como un artefacto de reporting y empiezan a usarla para priorizar el trabajo. Un feed que llega tarde de forma recurrente y con una detección débil merece un plan de control distinto al de un problema de formato aislado que se detecta antes de publicar. Esa es la diferencia entre un registro ordenado y un verdadero modelo de riesgos.
Regla operativa: clasifique la consecuencia creíble del escenario causal y, después, revise la puntuación una vez aplicados los controles.
Qué hace que la puntuación sea defendible
Una puntuación defendible es trazable. Si un conjunto de datos de siniestros llega tarde, el equipo debe poder señalar la frecuencia de los retrasos, la ruta de detección, la exposición del negocio y el control que redujo el riesgo residual. Solo así la aceptación del riesgo residual deja de ser un gesto vago y se convierte en una decisión documentada.
Para profundizar en la capa de métricas, las métricas de data observability son el puente práctico entre el comportamiento de la plataforma y la puntuación del riesgo. Aportan al análisis una superficie medible en lugar de una declaración tranquilizadora genérica.
Diseñar controles comprobables para la supervisión humana
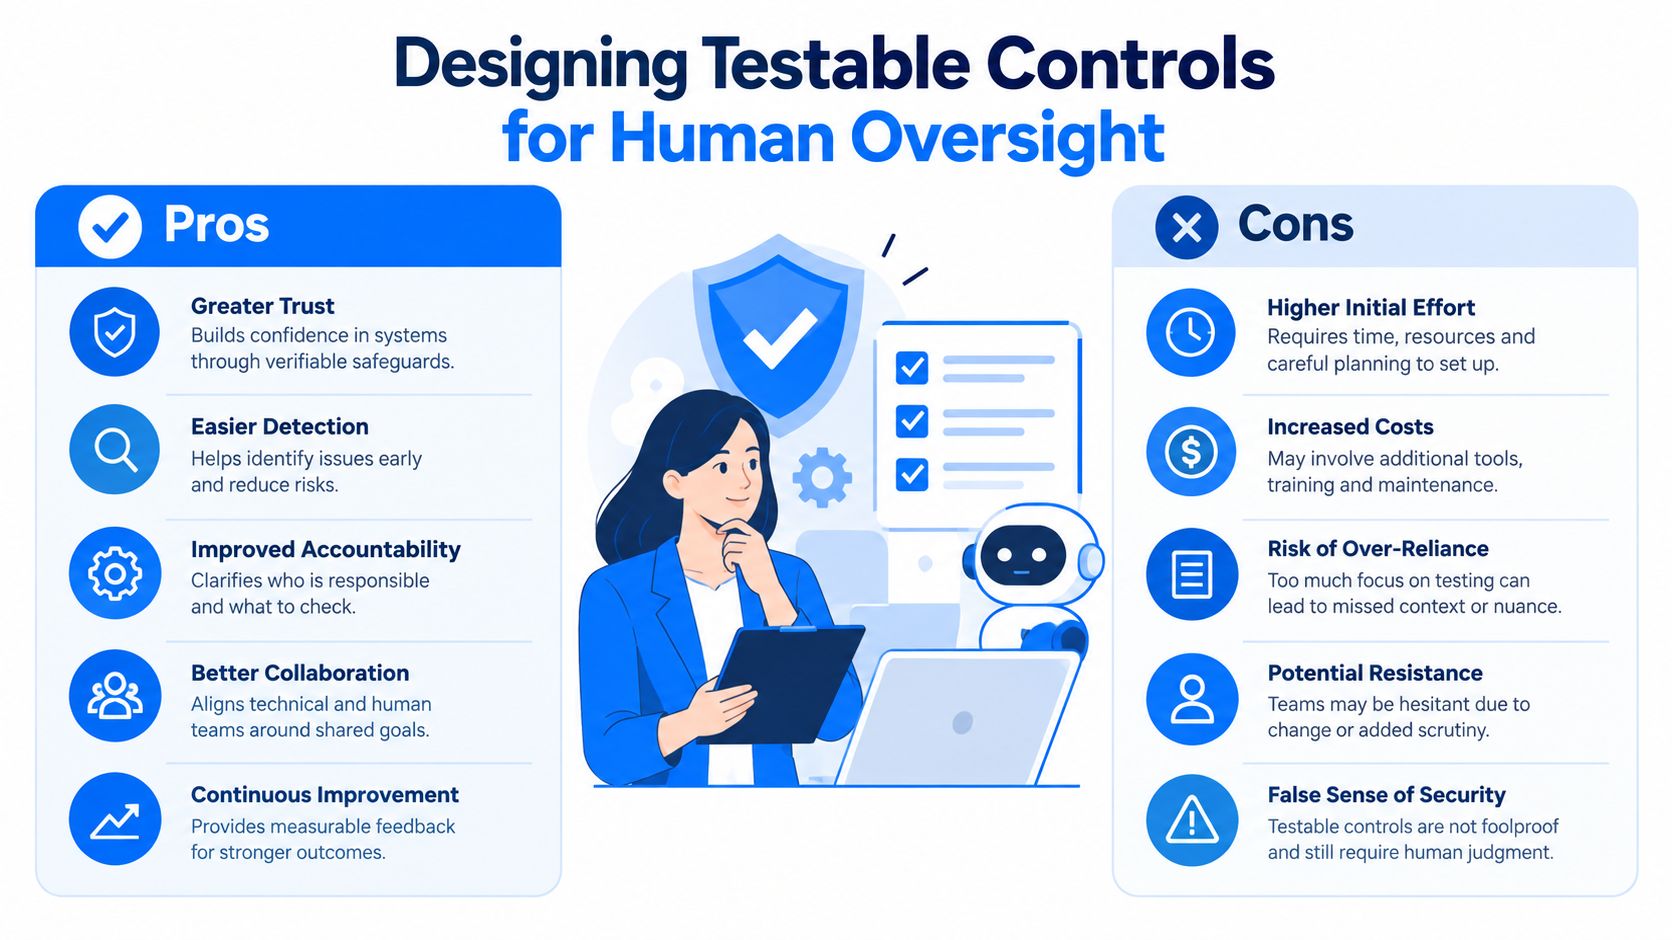
La revisión humana se añade a muchos planes de control porque suena segura. En la práctica, puede fallar de formas sutiles. Los reguladores y las organizaciones de seguridad insisten en que la responsabilidad humana no desaparece cuando interviene la IA, y recomiendan poner a prueba la carga de trabajo, la atención, la toma de decisiones, la claridad de roles, el comportamiento de escalado y las respuestas ante recomendaciones incorrectas u omitidas. Guía sobre factores humanos
El human-in-the-loop no es un control por sí solo
Un revisor que recibe demasiadas alertas empezará a hacer triaje, no a validar. Un revisor que ve explicaciones poco claras aceptará el resultado del sistema porque cuestionarlo lleva demasiado tiempo. Un revisor que no sabe quién es responsable del escalado puede detectar el problema y aun así dejarlo pasar.
Por eso la supervisión humana tiene que ser comprobable. Simule datos degradados, entradas retrasadas, cambios de esquema, señales contradictorias, caídas de la automatización y una carga de trabajo elevada, y mida después el tiempo de detección, la calidad de las intervenciones, la finalización de los escalados, el tiempo de recuperación y la recurrencia. Esos resultados indican si la persona tiene el tiempo, la información, la autoridad y la competencia necesarios para intervenir.
Añadir un revisor puede aumentar el riesgo si está saturado, no tiene la formación suficiente o no puede actuar.
Esta es la pieza que muchos equipos pasan por alto. Una capa humana no es automáticamente un control preventivo. En algunos entornos se convierte en un cuello de botella que añade retraso sin aportar seguridad, sobre todo cuando el flujo de alertas es ruidoso o la explicación del sistema es pobre.
Cómo hacer medible la supervisión
Registre cuándo vio el operador el problema, si lo cuestionó, qué medida tomó y si el sistema se recuperó correctamente. Conserve esa evidencia junto a la telemetría técnica, porque un flujo de trabajo aparentemente exitoso puede seguir ocultando un comportamiento humano inseguro. Si el operador tiene que adivinar, aplazar o sortear el proceso, el control todavía no está maduro.
Monitorización continua en sectores regulados
Un equipo de servicios financieros puede hacerlo todo bien sobre el papel y aun así pasar por alto el peligro en la práctica. Un feed transaccional que suele llegar a tiempo empieza a retrasarse más de lo normal, pero el cambio de volumen es tan pequeño que un umbral estático nunca se activa. El informe se sigue generando, el dashboard se sigue actualizando y los datos obsoletos fluyen sin que nadie lo note hacia un proceso de decisión que da por supuesta su actualidad.
La monitorización continua cambia ese modo de fallo. En un entorno regulado, los KPI de negocio, la deriva de esquemas, la puntualidad, la validación y las condiciones de la plataforma deben vigilarse de forma conjunta. El caso de uso de calidad de datos y compliance de digna encaja en ese modelo porque la plataforma permanece en el propio entorno del cliente mientras monitoriza el comportamiento de los datos in situ, lo que mantiene la evidencia operativa cerca del sistema que protege.
Por qué fallan los umbrales rígidos en entornos regulados
Una regla rígida solo ve aquello para lo que se escribió. No detecta una carga que está presente pero llega tarde, ni un cambio de esquema que sigue superando las comprobaciones de sintaxis mientras rompe un supuesto downstream. Además, se queda atrás cuando el contexto de negocio cambia más rápido que el conjunto de reglas.
La monitorización continua funciona mejor porque puede detectar combinaciones inusuales de comportamiento, no solo superaciones aisladas de umbrales. Esto es importante en las operaciones sanitarias, financieras, de telecomunicaciones y del sector público, donde un cambio sutil de volumen o de estructura puede convertirse en un problema de reporting o de servicio antes de que nadie abra un ticket de incidencia.
Las mejores alertas son tempranas, específicas y están vinculadas a una consecuencia de negocio que el responsable ya entiende.
Aquí se solapan la plataforma de datos y el sistema de control. Si la capa de observability puede validar reglas de negocio críticas, seguir los cambios estructurales y poner de manifiesto patrones anómalos sin sacar los datos de producción del entorno, la evidencia de riesgo sigue siendo útil tanto para operaciones como para auditoría. En las operaciones de datos reguladas, esa misma evidencia también respalda un rastro de compliance limpio, como se muestra en el caso de uso de calidad de datos y compliance de digna.
Qué necesita una buena monitorización operativa
Una buena monitorización hace tres cosas a la vez. Detecta el comportamiento del pipeline, valida el significado de negocio y conserva la evidencia de que el control ha funcionado. Cuando falta cualquiera de esas piezas, el equipo recibe ruido en lugar de garantías.
Desencadenar la reevaluación cuando los sistemas cambian

El análisis de peligros operacionales en operaciones con IA todavía se trata con demasiada frecuencia como un ejercicio único previo al despliegue, aunque los mayores riesgos suelen aparecer después del despliegue. Las directrices de seguridad recientes ponen el acento en la implantación incremental, la monitorización continua, el control de cambios, la validación local y la responsabilidad explícita, en lugar de suponer que un modelo o un sistema automatizado sigue siendo seguro tras su aprobación. Directrices de seguridad de la FAA sobre operaciones con IA
Qué debe desencadenar una nueva revisión
Una reevaluación debe iniciarse cuando el sistema cambia de un modo que puede alterar el riesgo. Esto incluye los cambios de versión de modelos o software, las alteraciones en la distribución de los datos de entrada, la nueva autoridad otorgada a la automatización, los patrones anómalos de intervención manual, los cambios de personal, los incidentes y los cuasiincidentes. También incluye los cambios de proceso que modifican quién ve una alerta, quién puede aprobar una decisión o con qué rapidez puede producirse la recuperación.
Para los equipos que trabajan con datos regulados o contenido automatizado, una referencia complementaria útil son las normas sobre vídeos generados por IA. El motivo es sencillo: si un sistema automatizado cambia lo que las personas ven, en lo que confían o lo que aprueban, el análisis de riesgos tiene que abarcar tanto el resultado como la respuesta humana.
Cómo mantener útil el rastro de evidencias
Registre la incertidumbre, la respuesta del usuario, la acción downstream, la gravedad, el subgrupo afectado, la acción correctiva y la recurrencia. Así, la siguiente revisión dispone de contexto suficiente para saber si el peligro se resolvió por completo o simplemente se ocultó. También evita el fallo habitual en el que un modelo parece preciso en conjunto pero sigue causando daños operativos porque las personas confían en exceso en él, lo ignoran o no pueden actuar sobre su resultado con la rapidez necesaria.
El proceso más sólido se basa en desencadenantes, no en el calendario. Cuando cambian los datos, el flujo de trabajo o el modelo de autoridad, el análisis de peligros debe reabrirse automáticamente y la evidencia de los controles debe actualizarse con él.
digna ayuda a los equipos a convertir las métricas de los pipelines, la deriva de esquemas, los resultados de validación y las señales de puntualidad en indicadores continuos de peligro dentro de su propio entorno. Si está sustituyendo los checklists estáticos por evidencia operativa en vivo, visite digna y descubra cómo la data observability puede contribuir a unas operaciones de datos más seguras y responsables.
Las cargas tardías son una de las condiciones desencadenantes más habituales en estas cadenas causales, por lo que la puntuación de probabilidad depende de detectarlas a tiempo. El módulo Timeliness de digna aprende el patrón de llegada habitual de cada tabla y señala los datos que llegan tarde o no llegan, lo que aporta al registro de peligros una señal de detección medible.
Preguntas frecuentes
¿Qué es el análisis de peligros operacionales en las operaciones de datos?
El análisis de peligros operacionales es la práctica de identificar cómo los fallos de un sistema en producción pueden combinarse hasta causar daños y, a continuación, controlarlos. En las operaciones de datos recorre toda la ruta de los datos, desde los feeds upstream y los modelos dbt hasta las intervenciones manuales y los consumidores downstream, y se reabre cada vez que el sistema cambia.
¿Por qué fallan las revisiones puntuales de peligros en los pipelines de datos?
Porque la mayoría de los fallos dañinos aparecen después del despliegue. Un pipeline puede superar su checklist de lanzamiento y, después, un cambio de esquema upstream llena de nulos una tabla de reporting mientras la transformación sigue ejecutándose, y el negocio actúa sobre datos obsoletos. Una revisión trimestral no puede detectar una cadena causal que se forma entre revisiones.
¿Cómo se pueden usar las métricas de observability para puntuar el riesgo de un peligro?
Asignando a cada componente del riesgo una señal medible. La probabilidad puede derivarse del retraso de las cargas y de las tasas de validaciones fallidas; la gravedad, del impacto en los KPI de negocio o de la completitud del reporting regulatorio; la detección, de la latencia de las alertas y de las discontinuidades en el recuento de filas; y la solidez de los controles, de la detección de cambios de esquema y de la cobertura de validación. Vuelva a puntuar una vez aplicados los controles.
¿Qué debe incluir un registro de peligros?
Un registro de peligros útil recoge el modo de operación, la condición desencadenante, la consecuencia, la gravedad, la probabilidad, las salvaguardas existentes, el responsable del control, la señal de detección y la autoridad de aceptación. Redactar los peligros como cadenas causales, por ejemplo cambio de esquema que rompe una transformación y deriva en un reporting regulatorio incompleto, muestra exactamente qué supuesto se ha incumplido cuando el sistema cambia.
¿Cuándo debe reevaluarse un análisis de peligros operacionales?
Cada vez que un cambio pueda alterar el riesgo, no según un calendario fijo. Entre los desencadenantes se incluyen los cambios de versión de modelos o software, las variaciones en la distribución de los datos de entrada, la nueva autoridad otorgada a la automatización, los patrones anómalos de intervención manual, los cambios de personal, los incidentes y los cuasiincidentes, así como los cambios de proceso que afectan a quién ve una alerta o quién puede aprobar una decisión.


