Formato de tabla abierto: guía completa para 2026
|
8
minuto de lectura

Apache Iceberg lo usa el 58 % de las organizaciones para analítica crítica de negocio, mientras que el 95 % lo utiliza o planea utilizarlo para cargas de IA y aprendizaje automático. Un formato de tabla abierto es una capa de especificación sobre archivos columnares que da a los motores una vista única y versionada de los archivos, el esquema y las particiones de una tabla, de modo que distintas herramientas puedan leer y escribir los mismos datos con garantías transaccionales.
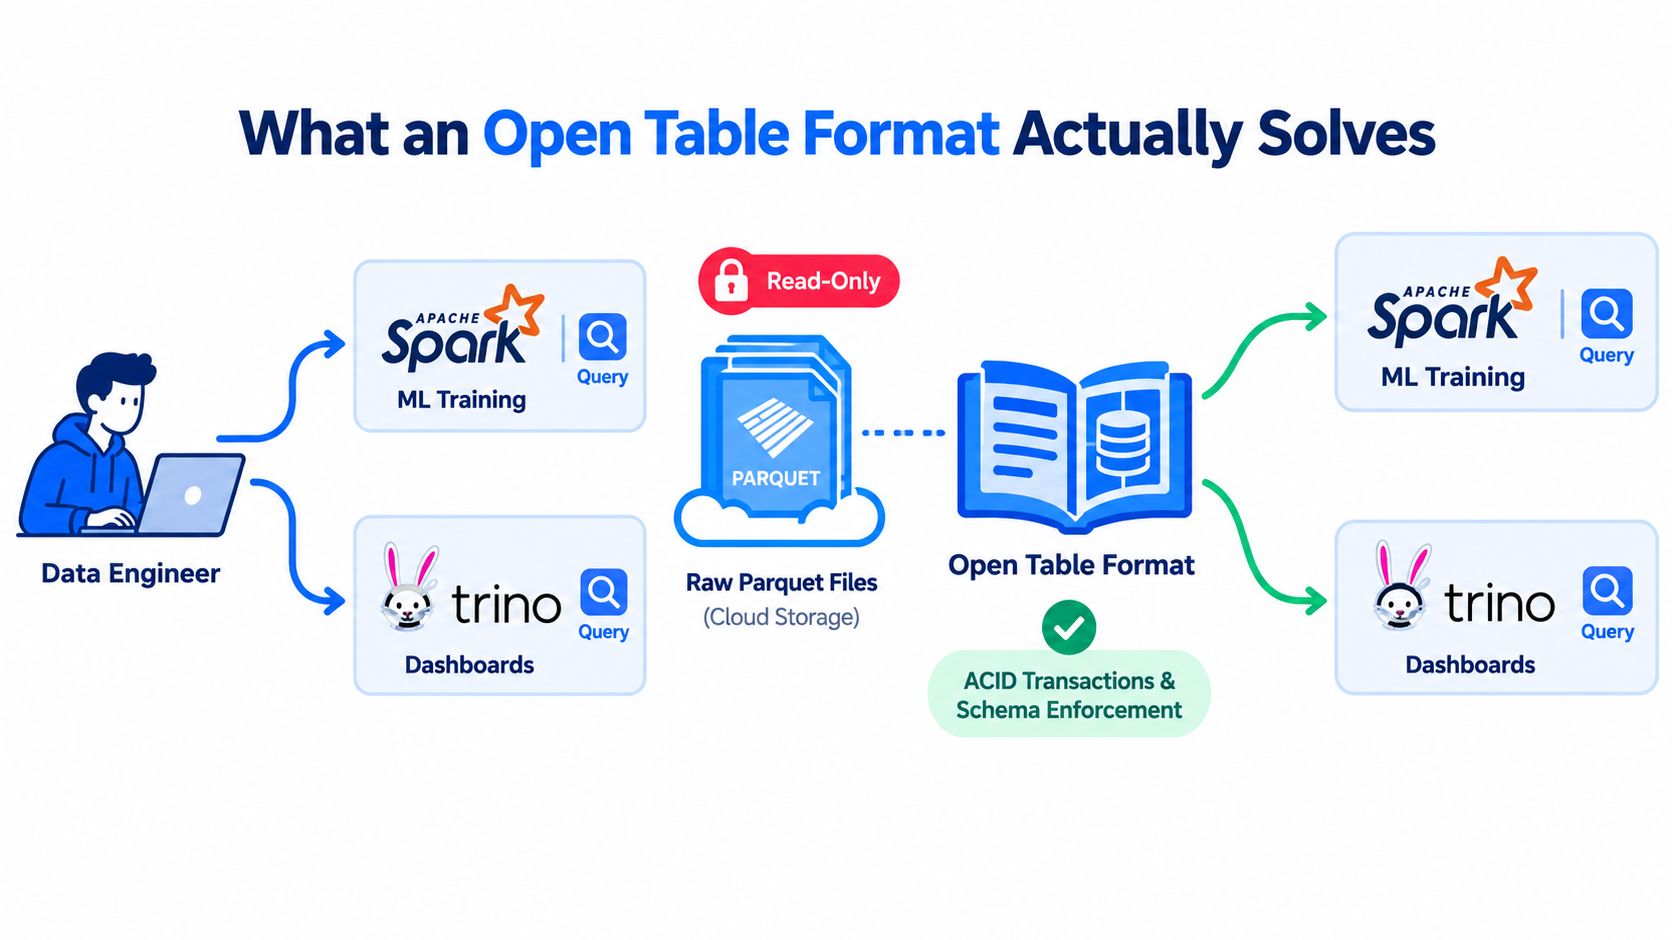
Puede que ya estés en medio de este problema. Un conjunto de datos de ventas reside en el almacenamiento de objetos en la nube como archivos Parquet. Spark lo necesita para entrenar modelos de aprendizaje automático, Trino lo necesita para paneles y una pipeline sigue escribiendo particiones nuevas mientras los analistas consultan los datos de ayer. Los archivos son baratos y legibles, pero la tabla en sí no tiene un contrato compartido fiable a menos que añadas uno.
Ese contrato es el formato de tabla abierto. No sustituye a Parquet ni a tus motores de consulta. Añade los metadatos, la gestión de transacciones, las reglas de esquema y el historial de tabla necesarios para que el almacenamiento analítico basado en archivos se comporte como una tabla gestionada.
Tabla de contenidos
Qué resuelve realmente un formato de tabla abierto
El contrato que falta
Lo que no resuelve
Los conceptos básicos detrás de la especificación
Los metadatos transaccionales como índice maestro
El particionado como regla de agrupación del catálogo
La evolución de esquema como historial del catálogo
Los snapshots como ediciones en un momento dado
Cómo abordan Iceberg, Delta Lake y Hudi el mismo problema
Beneficios, contrapartidas y selección guiada por la carga de trabajo
Dónde se notan los beneficios
Dónde permanecen las contrapartidas
Buenas prácticas para operar formatos de tabla abiertos a escala empresarial
Tratar el catálogo como infraestructura de producción
Haz que el particionado responda preguntas reales
Pon límites a los snapshots
Emite señales operativas en el momento de la escritura
Patrones de observabilidad e integración para lakehouses en producción
Cuatro señales que conviene conectar
Detalles de integración y despliegue
Consideraciones de despliegue y operación en entornos regulados
Controles que resolver antes de producción
Una lista de comprobación práctica antes de estandarizar un formato
Qué resuelve realmente un formato de tabla abierto
Una ingeniera de datos puede colocar datos de ventas particionados en el almacenamiento de objetos y apuntar Spark al directorio. Trino suele poder leer también los mismos archivos Parquet. La primera consulta puede funcionar, pero el modelo operativo se vuelve frágil en cuanto entran en escena varios escritores, esquemas cambiantes y lectores concurrentes.
Los archivos en bruto no dicen a cada motor qué archivos pertenecen a la tabla lógica. Un nombre de directorio puede sugerir una identidad de tabla, pero no registra de forma fiable si un archivo es actual, ha sido reemplazado, está incompleto o lo creó un proceso ajeno. Las carpetas de partición tampoco aportan un historial universal de cómo cambió la disposición de la tabla.
El contrato que falta
Un formato de tabla abierto se sitúa junto a los archivos de datos y registra la información sobre la que los motores necesitan ponerse de acuerdo:
Identidad de la tabla: la tabla lógica tiene una definición estable, independiente de un motor concreto o de un escaneo de directorio.
Inventario de archivos: los metadatos identifican los archivos de datos que pertenecen a la tabla y aquellos que ya no deben leerse.
Disposición de particiones: la tabla registra cómo se organizan las filas, lo que permite a los motores descartar datos irrelevantes.
Historial de esquema: las adiciones, eliminaciones, renombramientos y cambios compatibles de columnas pasan a formar parte de la definición gestionada de la tabla.
Snapshots atómicos: los lectores pueden elegir una versión coherente mientras un escritor confirma una versión nueva.
El resultado es una especificación compartida. Spark puede usar la tabla para preparar datos de ML, Trino puede servir SQL interactivo, y ambos pueden resolver el mismo estado lógico en lugar de adivinarlo por separado a partir de una estructura de carpetas.
Lo que no resuelve
Un formato de tabla abierto no crea automáticamente buenos modelos de datos, particiones sensatas, consultas rápidas ni valores de negocio fiables. Puede proteger la coherencia a nivel de tabla, pero los equipos todavía deben decidir cómo se escriben, validan, compactan, gobiernan y monitorizan los datos.
Esa distinción evita un error arquitectónico frecuente. El formato es el cimiento bajo el modelo operativo, no el modelo operativo en sí.
Los conceptos básicos detrás de la especificación
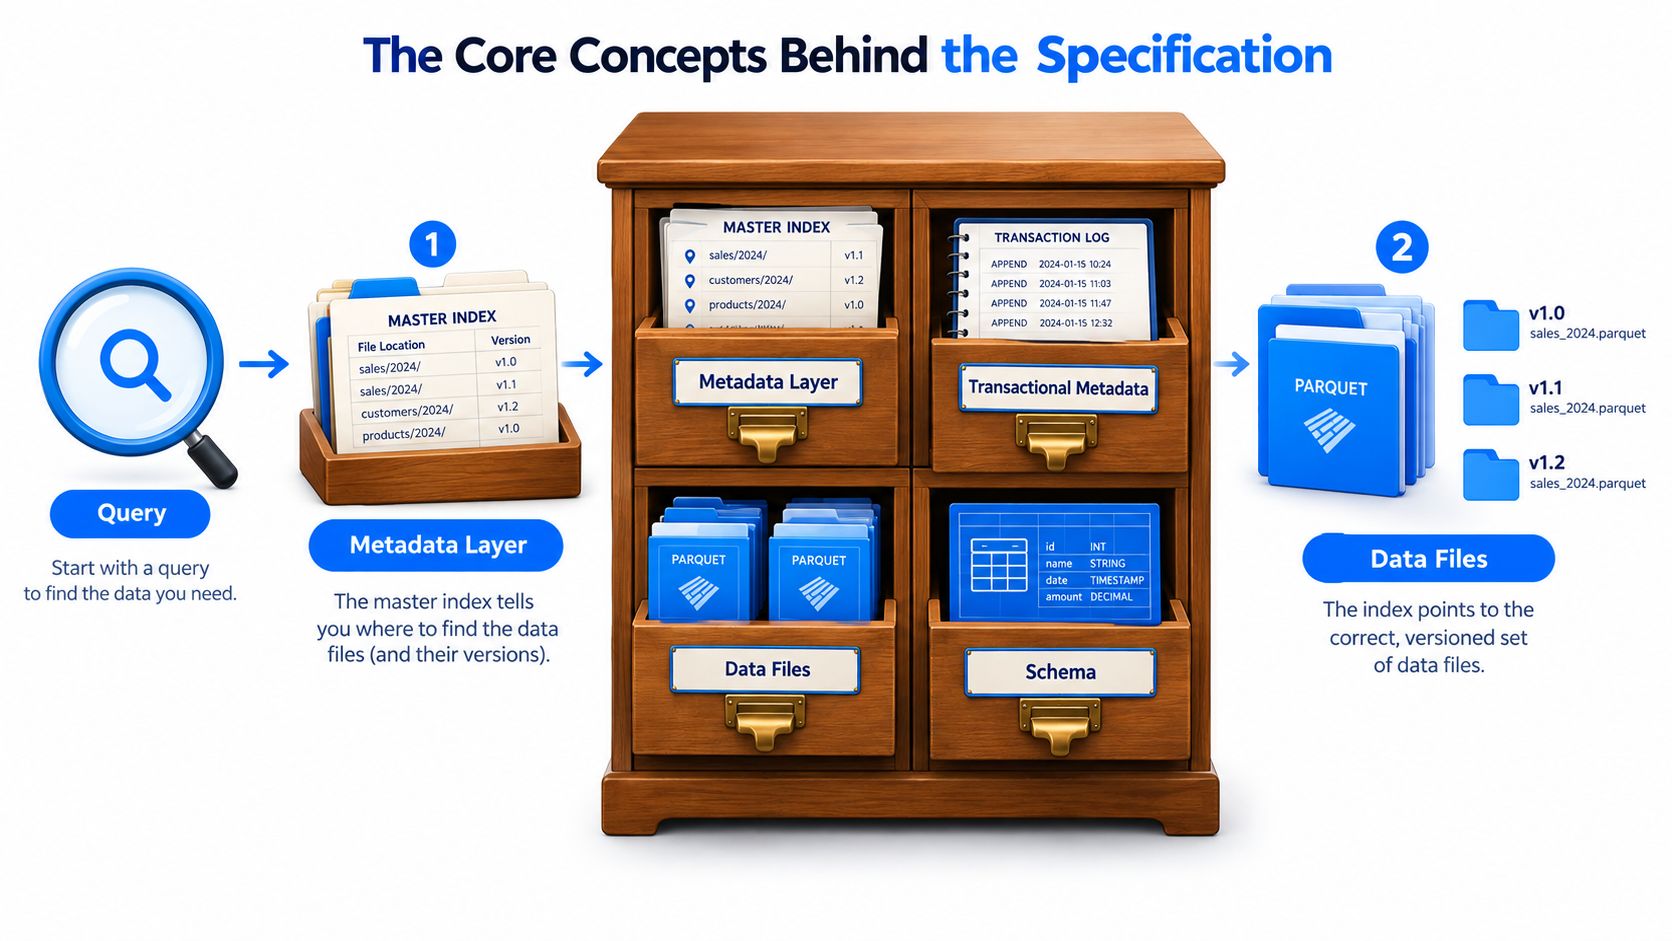
Un fichero de biblioteca ayuda a entender la capa de metadatos. Los libros son tus archivos de datos Parquet. El fichero es la especificación de la tabla. Quien busca consulta primero las fichas y luego camina hasta las estanterías con los libros solicitados.
Los metadatos transaccionales como índice maestro
La capa de metadatos registra qué archivos pertenecen a la tabla y cómo se relacionan esos archivos con un snapshot. En lugar de pedir a Spark o Trino que inspeccionen cada ruta del almacenamiento de objetos, el motor sigue el índice gestionado de la tabla.
Piensa en una ficha que dice: «Estas estanterías contienen la edición actual de la colección de ventas». Si un escritor sustituye archivos antiguos por archivos recién compactados, el catálogo cambia el inventario activo como un solo commit. Los lectores no tienen que deducir si vieron una actualización completa.
Ese es el propósito práctico de la gestión de metadatos. Los metadatos no son documentación decorativa. Dirigen la planificación, sostienen lecturas coherentes y dan a quien opera un registro de cómo cambió la tabla.
El particionado como regla de agrupación del catálogo
Una regla de partición agrupa datos relacionados para que un motor evite escanear archivos ajenos. Si los datos de ventas se organizan según un patrón de acceso temporal o regional, una consulta con un filtro coincidente puede estrechar su alcance de escaneo.
La regla debe corresponderse con cargas de trabajo reales. Un diseño de particiones que refleje cómo filtran los paneles puede reducir lecturas innecesarias, mientras que uno basado en un atributo inadecuado o demasiado granular puede generar sobrecarga operativa y muchos archivos pequeños.
La evolución de esquema como historial del catálogo
Un esquema es la descripción que hace el catálogo de lo que contiene cada libro. Cuando una pipeline añade una columna, la renombra o cambia un tipo, el formato de tabla puede registrar ese cambio en lugar de dejar que cada motor lo descubra por su cuenta.
Ese historial importa cuando conviven archivos antiguos y nuevos. Un lector necesita reglas para interpretar ambas versiones, y una pipeline necesita un modo de fallo claro cuando un cambio es incompatible. La evolución de esquema reduce los desacuerdos silenciosos, pero no decide si una columna nueva es semánticamente correcta.
Los snapshots como ediciones en un momento dado
Un snapshot es una versión coherente de la tabla. Conecta los metadatos de la tabla con el conjunto de archivos de datos que los lectores deben usar en ese momento. La documentación de Apache Iceberg describe el viaje en el tiempo como una forma de ejecutar consultas reproducibles contra un snapshot concreto, mientras que su especificación almacena los snapshots en el JSON de metadatos de la tabla, y no como objetos serializados aparte. Consulta la documentación de Apache Iceberg y la especificación de Iceberg para el modelo subyacente.
Juntos, estos cuatro conceptos permiten que Spark y Trino trabajen desde la misma colección catalogada. Un motor puede escribir una edición nueva mientras otro lee una edición anterior estable, según el comportamiento transaccional del formato y de la implementación del catálogo.
Cómo abordan Iceberg, Delta Lake y Hudi el mismo problema
Apache Iceberg, Delta Lake y Apache Hudi añaden gestión de tablas al almacenamiento analítico basado en archivos, pero su historia de diseño influye en cómo los equipos los usan. Iceberg empezó en Netflix en 2017, se donó a la Apache Software Foundation en 2018 y se convirtió en proyecto de primer nivel de Apache en mayo de 2020. Su diseño enfatiza los metadatos de tabla neutrales respecto al motor y una amplia interoperabilidad con sistemas como Spark, Trino, Flink, Hive e Impala, según describe el proyecto Apache Iceberg.
Delta Lake usa archivos de datos Parquet junto a un registro de transacciones en el directorio _delta_log. El registro contiene entradas JSON ordenadas y checkpoints Parquet periódicos, y un snapshot de tabla se obtiene leyendo el registro hasta una versión seleccionada, según el artículo de investigación sobre Delta Lake. Ese modelo convierte el registro de transacciones en la autoridad central del estado de la tabla.
Hudi se asocia especialmente con la ingesta incremental, los upserts, los borrados y las pipelines de datos casi en tiempo real. Sus enfoques copy-on-write y merge-on-read representan compromisos distintos entre la simplicidad de lectura y el comportamiento de escritura o ingesta. Hudi también pone más énfasis en los patrones de indexación a nivel de registro para dirigir las actualizaciones.
Dimensión | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Eje de diseño | Tablas analíticas neutrales respecto al motor y metadatos portables | Tablas Parquet transaccionales centradas en un registro ordenado | Escrituras incrementales, upserts, borrados e ingesta en streaming |
Estado de la tabla | Los metadatos apuntan a snapshots, manifiestos y archivos de datos |
| La línea temporal y las estructuras de metadatos siguen los commits y los grupos de archivos |
Particionado | Admite la evolución de la disposición de particiones al cambiar los patrones de consulta | Usa datos particionados con opciones de optimización propias del motor | Usa particionado junto con indexación y elección del modo de escritura |
Evolución de esquema | Gestionada mediante metadatos de tabla e identificadores de esquema | Gestionada mediante reglas de tabla y del registro de transacciones | Gestionada mediante metadatos de tabla y configuración del escritor |
Aislamiento por snapshot | Los lectores resuelven un snapshot de metadatos coherente | Los lectores resuelven una versión de tabla desde el registro de transacciones | Los lectores usan la línea temporal de Hudi y el estado de commit seleccionado |
Fortaleza típica | Acceso analítico con motores mixtos | Flujos de lakehouse transaccional centrados en Databricks | Cambios incrementales frecuentes e ingesta a nivel de registro |
Énfasis operativo | Catálogo, manifiestos, planificación y mantenimiento de metadatos | Retención del registro, checkpoints, compactación e integración de plataforma | Compactación, indexación, clustering y gestión de modos de escritura |
La comparación no es una lista de funciones. Es una pista sobre el estilo operativo. Iceberg suele encajar en una plataforma donde varios motores deben compartir tablas. Delta puede ser la elección natural cuando dominan los flujos orientados a Databricks y Spark. Hudi merece una evaluación detenida cuando los upserts continuos y el procesamiento incremental pesan más que una amplia interoperabilidad de lectura.
Elijas lo que elijas, la calidad de los datos sigue siendo una responsabilidad aparte. Una plataforma puede gestionar commits y reglas de esquema y aun así aceptar valores incorrectos, así que las prácticas de calidad de datos en Databricks pertenecen a la revisión de arquitectura y no al periodo posterior al despliegue.
Beneficios, contrapartidas y selección guiada por la carga de trabajo
La elección de formato debería partir de la carga de trabajo, no de una preferencia universal. En una comparativa al estilo TPC-DS, Iceberg y Delta estuvieron cerca en varias consultas de lectura intensiva mientras Hudi fue más lento en esas mismas cargas. La consulta interactiva 19 se ejecutó en 1,45 segundos en Iceberg, 1,38 segundos en Delta y 2,92 segundos en Hudi, mientras que la consulta de informes 27 tardó 8,70 segundos en Iceberg, 8,45 segundos en Delta y 12,10 segundos en Hudi. Para analítica profunda, la consulta 64 tardó 184,20 segundos en Iceberg, 181,90 segundos en Delta y 210,50 segundos en Hudi, según recoge este benchmark de formatos de tabla abiertos.
Esos resultados no establecen un ganador permanente. Muestran por qué los paneles, uniones, filtros, escrituras y operaciones de mantenimiento representativos importan más que un único titular de benchmark.
Patrón de carga de trabajo | Formato recomendado | Factor decisivo |
|---|---|---|
Upserts frecuentes en streaming y cambios incrementales | Apache Hudi | Comportamiento de ingesta a nivel de registro, gestión de actualizaciones y elección entre merge-on-read y copy-on-write |
Lecturas analíticas con motores mixtos | Apache Iceberg | Portabilidad entre motores e integración con el catálogo |
Flujos de lakehouse centrados en Databricks | Delta Lake | Integración del registro de transacciones y alineación estrecha con la plataforma |
BI interactivo y paneles SQL | Iceberg o Delta tras probarlos | Eficiencia de la ruta de lectura, coste de planificación y comportamiento real de los paneles |
Conjuntos de datos de IA y ML compartidos entre herramientas | Depende de la carga de trabajo | Compatibilidad de motores, gobernanza, reproducibilidad y patrones de acceso para el entrenamiento |
Dónde se notan los beneficios
La interoperabilidad permite a los equipos usar un único conjunto de datos gobernado desde varios motores en lugar de mantener copias para cada consumidor. Los commits transaccionales protegen a los lectores de escrituras parciales y ayudan a las pipelines a publicar estados de tabla completos. Los metadatos del catálogo sostienen permisos, localización, linaje y flujos de auditoría cuando el catálogo se trata como un servicio de plataforma real.
Las tablas abiertas también pueden apoyar la preparación para la IA. Las pipelines de entrenamiento se benefician cuando los estados históricos son reproducibles y cuando los mismos datos gobernados están disponibles para las cargas de preparación, evaluación y analítica.
Dónde permanecen las contrapartidas
La dependencia del catálogo crea un modo de fallo real. Si el catálogo o el servicio de metadatos no está disponible, las lecturas y escrituras pueden detenerse aunque los archivos subyacentes sigan en el almacenamiento de objetos. Las transacciones entre tablas y el comportamiento de claves foráneas no equivalen a los de una base de datos relacional tradicional, y la cobertura reciente subraya que las garantías ACID suelen limitarse a tablas individuales.
Las operaciones también continúan después de la primera escritura exitosa. La compactación, la expiración de snapshots, la limpieza de archivos huérfanos, el mantenimiento de particiones y la revisión de esquema requieren un responsable. El formato reduce la ambigüedad, pero no elimina el trabajo de plataforma ni impone la corrección de negocio.
Buenas prácticas para operar formatos de tabla abiertos a escala empresarial
La especificación te da un vocabulario fiable para el estado de la tabla. No aporta la disciplina operativa necesaria para mantener sano ese estado. Cuatro prácticas merecen un responsable explícito antes de que lleguen las cargas de producción.
Tratar el catálogo como infraestructura de producción
El metastore, el catálogo REST o el catálogo de gobernanza unificada es un plano de control. Dale objetivos de disponibilidad, revisiones de acceso, pistas de auditoría, procedimientos de copia de seguridad y un runbook de incidentes. Una tabla puede vivir en el almacenamiento de objetos, pero los motores siguen dependiendo del catálogo para resolver su identidad, metadatos, permisos y estado actual.
Regla práctica: si una caída del catálogo detendría el trabajo analítico, monitorízalo y recupéralo como un plano de control de base de datos, no como un archivo de configuración.
Haz que el particionado responda preguntas reales
Elige las particiones a partir de los filtros de consulta observados y del comportamiento de escritura. Iceberg admite la evolución de la disposición de particiones, así que los equipos pueden cambiarla cuando varían el volumen de datos o los patrones de consulta, pero una función de evolución no elimina el coste de unas malas decisiones iniciales.
Comprueba si se crean archivos pequeños tras cada cambio importante de pipeline. Las claves de partición de alta cardinalidad pueden dispersar los datos en muchos archivos, mientras que unas particiones demasiado amplias pueden forzar a los motores a escanear más datos de los necesarios. Ordenar y compactar puede mejorar la localidad, pero añade trabajo de mantenimiento.
Pon límites a los snapshots
Los snapshots históricos ayudan con la reproducibilidad, el rollback y la depuración. Una retención ilimitada genera más metadatos que planificar y más objetos que gestionar, así que define una política basada en las necesidades de recuperación, los requisitos de auditoría y las reglas de ciclo de vida del almacenamiento.
Combina la expiración de snapshots con la limpieza de archivos huérfanos. Eliminar referencias de metadatos sin identificar con seguridad los datos no referenciados puede crear otro fallo, así que la limpieza debe ser deliberada, observable y estar probada.
Emite señales operativas en el momento de la escritura
Los escritores saben cuándo empieza un commit, cuántos archivos crean, cuánto tarda el commit y si se ejecutó la compactación. Captura esos hechos como eventos estructurados en lugar de intentar reconstruirlos después a partir de registros dispersos.

Sigue el número de archivos, sus tamaños, la latencia de commit, la antigüedad de los snapshots, los commits fallidos y la salud de la compactación. Estas señales conectan las operaciones del formato con los síntomas que notan los usuarios, como paneles lentos, conjuntos de datos obsoletos y cargas incompletas.
La madurez operativa determina si un lakehouse se comporta de forma fiable. La especificación abierta es necesaria para una semántica compartida, pero tus políticas de catálogo, trabajos de mantenimiento, enrutamiento de alertas y modelo de responsabilidad determinan si esa semántica sobrevive a la presión de producción.
Patrones de observabilidad e integración para lakehouses en producción
Una tabla puede ser transaccionalmente válida y aun así estar operativamente mal. Puede tener una columna nueva que rompe un modelo posterior, un commit exitoso que llegó tarde para un plazo de reporte, o un conjunto de archivos válido cuyo volumen de registros difiere marcadamente de su línea base establecida.
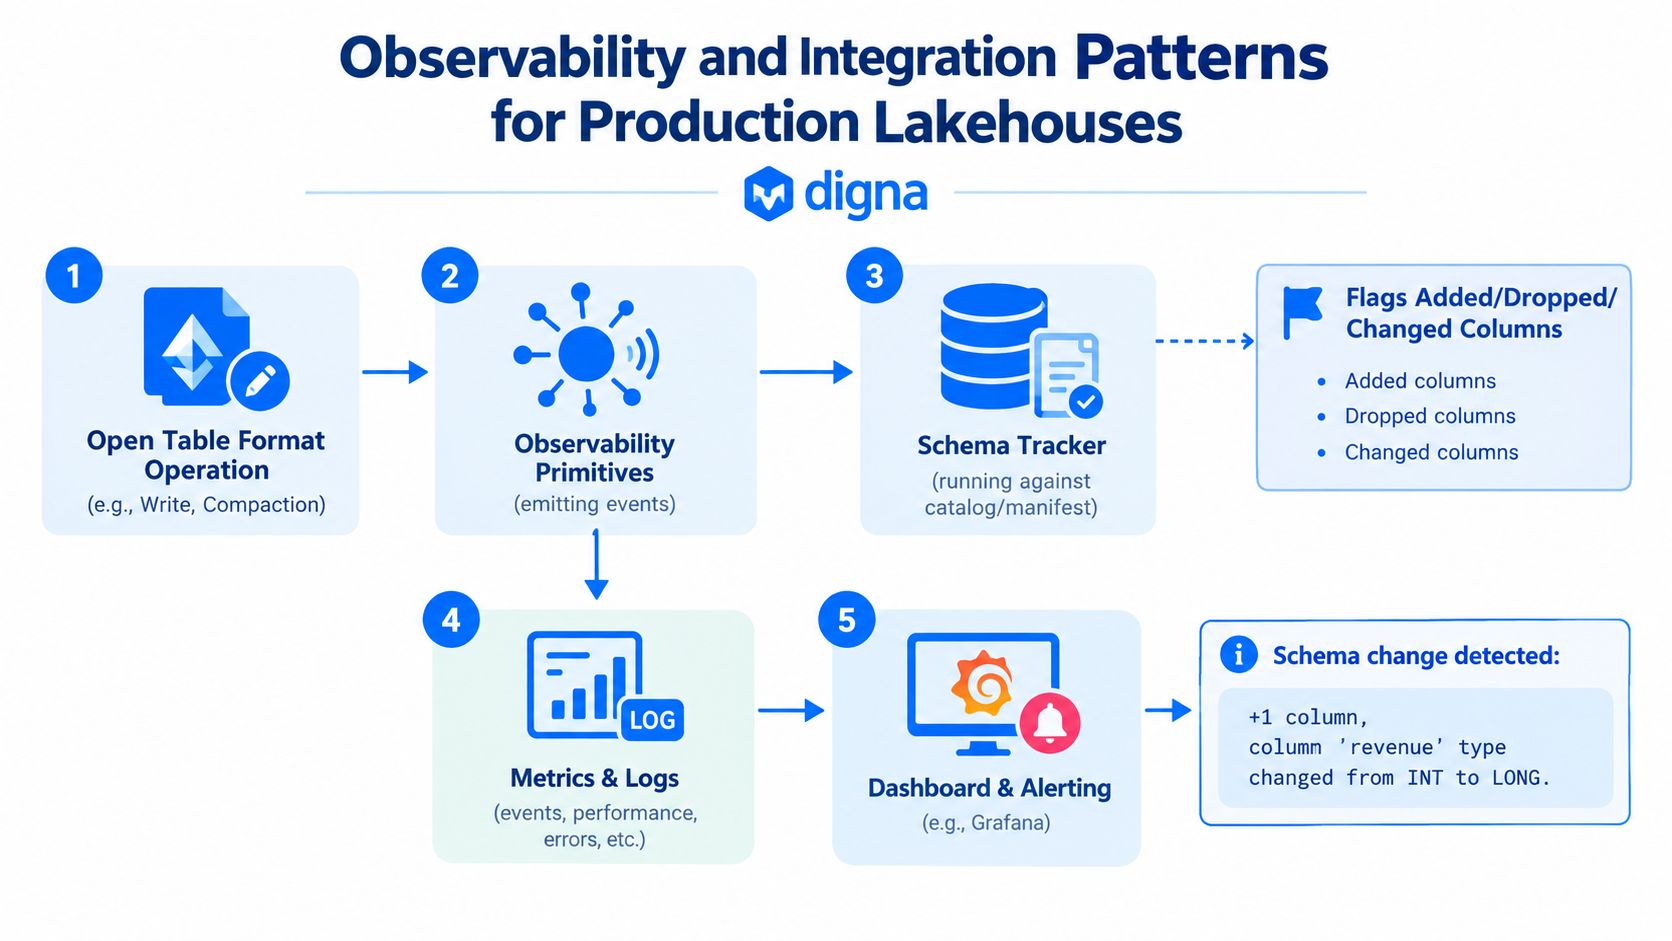
La observabilidad debería corresponderse directamente con las operaciones de tabla. El seguimiento de esquema inspecciona los metadatos del catálogo o la información de manifiestos en busca de columnas añadidas, eliminadas o con cambio de tipo. Las comprobaciones dentro de la base de datos evalúan los registros donde ya residen, lo que evita exportar muestras y permite a los equipos probar recuentos de filas, comportamiento de nulos, reglas de negocio y relaciones seleccionadas.
Cuatro señales que conviene conectar
Detección de cambios de esquema: señala una columna añadida, eliminada o con cambio de tipo antes de que un consumidor posterior falle o fuerce valores.
Validación de datos: ejecuta aserciones contra la tabla para campos obligatorios, valores aceptados, reglas de negocio a nivel de registro y condiciones de integridad.
Líneas base de anomalías: compara los recuentos de registros por partición, los tamaños de archivo, el comportamiento de los commits y otras métricas con el historial del conjunto de datos.
Monitorización de Timeliness: compara la creación de snapshots y la llegada de datos con el calendario de entrega esperado, para que una pipeline técnicamente exitosa no oculte un incidente de frescura.
La unidad útil de monitorización no es solo el trabajo. Es el estado de la tabla que leen los consumidores. Una tarea exitosa puede publicar igualmente un periodo de negocio incompleto, introducir un esquema incompatible o crear una disposición de archivos patológica.
Detalles de integración y despliegue
Una plataforma de observabilidad puede conectarse a las API de Iceberg REST o Unity Catalog para acceder al esquema y los metadatos, ingerir eventos estructurados de escritura para el análisis de anomalías y enviar alertas a los mismos canales de incidentes usados en la monitorización del almacén. La ubicación de los agentes también importa. Los equipos deben decidir si los componentes de monitorización se ejecutan junto al entorno de cómputo, dentro de una red privada o en otra frontera de servicio controlada.
Los permisos deben alinearse con el RBAC del catálogo. La monitorización debería ver suficientes metadatos y contenido de tabla para calcular las señales necesarias sin eludir la capa de gobernanza. Una plataforma como la solución de observabilidad de datos de digna puede encajar como una opción, con capacidades de seguimiento de esquema, validación dentro de la base de datos, detección de anomalías y monitorización de puntualidad dentro del entorno del cliente.
El principio más amplio es sencillo: cada commit debería producir evidencia sobre qué cambió, cuándo llegó y si su comportamiento se mantiene dentro de una línea base aceptada.
Consideraciones de despliegue y operación en entornos regulados
Elegir Iceberg, Delta Lake o Hudi rara vez es la decisión más difícil en un entorno regulado. Las preguntas complicadas tienen que ver con dónde se ejecuta el catálogo, cómo se autentican los motores, cómo se asignan los permisos a columnas sensibles y cómo aparecen las operaciones de metadatos en una pista de auditoría.
Un despliegue de tipo bring-your-own-cloud mantiene el almacenamiento, los servicios de catálogo, el cómputo y la monitorización dentro de la frontera de nube de la organización. El equipo controla las rutas de red y la retención, pero también asume la disponibilidad, las actualizaciones, la gestión de claves y las pruebas de recuperación. Un diseño multirregión añade decisiones de replicación y residencia. Quien opere debe definir qué metadatos y snapshots se replican, cómo cruza regiones el linaje y qué procedimiento de rollback aplica cuando las regiones divergen.
Un despliegue on-premise aislado cambia de nuevo las restricciones. Los servicios gestionados externos pueden no estar disponibles, así que las actualizaciones de catálogo, las pruebas de compatibilidad de formato, la observabilidad y la evidencia de incidentes deben funcionar dentro del entorno aislado.

Controles que resolver antes de producción
Ubicación del catálogo: elige un servicio gestionado, un catálogo autoalojado o una plataforma de gobernanza unificada según los requisitos de recuperación, residencia y auditoría.
Identidad y acceso: asigna los permisos del catálogo a las políticas RBAC o ABAC existentes, incluidas las identidades de servicio usadas por la ingesta y la monitorización.
Tratamiento de datos sensibles: etiqueta y gobierna los datos personales en las capas de catálogo y plataforma en vez de suponer que el formato de archivo impone la política.
Garantía en tiempo de ejecución: verifica de forma continua la frescura, la compatibilidad de esquema, el comportamiento de los datos y los eventos de acceso, en lugar de confiar en una validación puntual.
Los equipos deberían documentar estas decisiones junto a los requisitos de residencia de datos. El formato puede hacer más explícitos el historial de la tabla y el estado de los archivos, pero la madurez operativa determina si el lakehouse puede aportar evidencia de auditoría duradera.
Una lista de comprobación práctica antes de estandarizar un formato
Usa estas frases en tu próxima revisión de arquitectura:
Encaje del catálogo: verifica que el catálogo soporta tus motores, tu modelo de identidad, tus requisitos de auditoría y tu diseño de recuperación.
Compatibilidad de motores: prueba las combinaciones reales de Spark, Trino, Flink, almacén y BI que leerán o escribirán las tablas.
Estrategia de particionado: ajusta el particionado y la ordenación a los patrones de acceso observados y al comportamiento de escritura.
Política de snapshots: define los procedimientos de retención, rollback, compactación y limpieza de archivos huérfanos antes del uso en producción.
Control de acceso: confirma que las columnas sensibles, las identidades de servicio y los permisos de monitorización siguen las políticas de gobernanza existentes.
Alertas de esquema: monitoriza las columnas añadidas, eliminadas, renombradas y con cambio de tipo antes de que se rompan los consumidores posteriores.
SLA de frescura: compara la llegada de snapshots con los tiempos de entrega esperados para consumidores por lotes y en streaming.
Líneas base de anomalías: sigue el número de archivos, los volúmenes de registros, la latencia de commit y el comportamiento de las particiones a lo largo del tiempo.
Procedimiento de rollback: prueba cómo identifica quien opera un snapshot defectuoso y restaura un estado de tabla seguro.
Revisa la lista después de cada actualización importante de motor, cambio regulatorio o refactorización de pipeline. Un formato de tabla abierto reduce la ambigüedad, pero no elimina la responsabilidad operativa.
digna ayuda a los equipos de datos a monitorizar cambios de esquema, validar registros dentro de la base de datos, detectar comportamientos anómalos de tabla y seguir la puntualidad dentro de su propia nube o centro de datos. Visita digna para conectar esos controles con las operaciones de formato de tabla abierto de las que ya depende tu lakehouse.
Estandarizar un formato resuelve dónde viven los metadatos de la tabla; no resuelve si los valores que contiene son correctos, y ahí es donde empieza la gestión de la calidad de datos.
Preguntas frecuentes
¿Qué resuelve realmente un formato de tabla abierto?
El contrato que falta entre los archivos y los motores. Los archivos en bruto no dicen a cada motor qué archivos pertenecen a la tabla lógica, así que un formato de tabla abierto se sitúa junto a los datos y registra aquello sobre lo que los motores deben ponerse de acuerdo.
¿Qué registra ese contrato?
Cinco cosas: una identidad de tabla independiente de cualquier motor, un inventario de archivos que indica cuáles pertenecen y cuáles ya no deben leerse, la disposición de particiones para que los motores puedan descartar datos, el historial de esquema con adiciones, eliminaciones y renombramientos, y snapshots atómicos para que los lectores obtengan una versión coherente mientras un escritor confirma.
¿Qué tan extendido está Iceberg?
Apache Iceberg lo usa el 58 % de las organizaciones para analítica crítica de negocio, mientras que el 95 % lo utiliza o planea utilizarlo para cargas de IA y aprendizaje automático. Esas dos cifras explican por qué la elección de formato se ha vuelto una decisión de plataforma y no un detalle de almacenamiento.
¿Resuelven Iceberg, Delta Lake y Hudi problemas distintos?
Abordan el mismo problema de forma distinta en lugar de resolver problemas diferentes. Los tres proporcionan el contrato de tabla; divergen en los patrones de escritura, el tratamiento de los borrados y el acoplamiento al ecosistema, por lo que la elección debería seguir a la carga de trabajo y no a la marca.
¿Qué deberías confirmar antes de estandarizar uno?
Que sobreviva a tu despliegue regulado, no solo a tu benchmark. Operar a escala empresarial trae consigo higiene de metadatos, coordinación entre motores y restricciones de despliegue que una prueba de concepto sobre un solo motor no revelará.



