Error de Data Validation: Causas, Ejemplos y Soluciones
|
9
minuto de lectura
Probablemente lo haya visto: la actualización del cuadro de mando finaliza, los números parecen plausibles y, de repente, alguien pregunta por qué ha cambiado el churn de forma inesperada. El analista revisa el visual, el SQL y la tarea programada. Horas más tarde, resulta que el problema es un único valor mal formado que entró temprano en el pipeline y alteró la forma en que un sistema posterior interpretó el registro.
Un error de Data Validation es más que una celda de hoja de cálculo rechazada. Puede tratarse de un campo ausente, una fecha no válida, un código fuera del dominio permitido o una relación inexistente. El reto práctico consiste en encontrar dónde falló el contrato, decidir si es seguro reparar la fila y evitar que vuelva a aparecer el mismo defecto.
Índice de contenidos
Cuando una sola fila incorrecta rompe todo el cuadro de mando
Qué significa realmente un error de Data Validation
La comprobación superficial
La comprobación profunda
Los patrones principales detrás de los fallos de validación
Valores faltantes
Errores de formato
Violaciones de rango
Errores de codificación y de dominio
Rupturas de consistencia
Ejemplos a nivel de registro que puede identificar en sus propios datos
Exportaciones de hojas de cálculo
Ingesta de API
Registros de almacén de datos
Por qué la mayoría de los errores de validación comienzan en origen
Reparar el contrato, no solo la salida
Un flujo de trabajo práctico para detectar y solucionar errores
Captura
Ingesta
Almacén de datos (Warehouse)
Consumo
Puntos clave para operaciones de datos fiables
Cuando una sola fila incorrecta rompe todo el cuadro de mando
Un equipo de finanzas recibe un CSV nocturno desde el portal de un proveedor. Los registros parecen normales hasta que un campo de cancelación contiene una fecha mal formada. El cargador del almacén de datos no puede convertirlo en fecha, por lo que escribe NULL en lugar de detener la carga.
El modelo de churn trata una fecha de cancelación ausente como una condición propia. Esa única conversión cambia la asignación de cohorte del cliente y el cuadro de mando ejecutivo muestra un incremento inesperado. El pipeline informa que finalizó con éxito, el gráfico se renderiza y, aun así, el resultado es incorrecto.
El analista comienza en el cuadro de mando y rastrea el resultado a través de tres informes, dos vistas SQL y una tarea de Airflow. La fila de origen mal formada finalmente aparece en el registro de valores rechazados. El cuadro de mando era solo el primer síntoma visible.
Regla práctica: Una ejecución exitosa del pipeline demuestra que el procesamiento terminó. No demuestra que cada registro cumpla con las reglas en las que confía el negocio.
Por lo tanto, la validación debe llegar al nivel de registro. Un solo valor no válido puede alterar agregados, características de aprendizaje automático, informes financieros o flujos de trabajo operativos sin provocar una interrupción del servicio. El punto de referencia ampliamente citado de Gartner estima que la mala calidad de los datos cuesta a las organizaciones un promedio de 12,9 millones de dólares al año (Gartner benchmark), mientras que la investigación de IBM de 2025 reveló que más de una cuarta parte de las organizaciones estiman pérdidas anuales superiores a los 5 millones de dólares, y un 7% informa pérdidas superiores a los 25 millones de dólares (IBM research). El DCI whitepaper on the hidden cost of bad data ofrece un análisis más detallado sobre el coste operativo de una calidad de datos deficiente.
La investigación también necesita contexto. Un/a Data Anomalies puede representar un comportamiento genuino del cliente, mientras que un fallo de validación significa que un valor infringe una estructura o regla esperada. Una hoja de cálculo puede marcar un valor a través de un menú desplegable, una importación empresarial puede rechazarlo frente a un esquema gobernado y un pipeline de almacén de datos puede forzarlo a convertirse en un engañoso NULL. Los fallos repetidos en estas capas suelen apuntar a un defecto de mapeo de origen, de transformación o de contrato, más que a una serie de filas desafortunadas. Para obtener información sobre cómo distinguir los valores inusuales de los fallos de reglas, consulte la guía de digna sobre Data Anomalies.
Para los equipos que publican cuadros de mando a través de Power BI, la guía del conector de Power BI de Tutorial AI puede aclarar la capa de informes. La configuración del conector no puede reparar un valor de origen no válido. La solución fiable comienza donde el registro infringe su contrato por primera vez.
Qué significa realmente un error de Data Validation
Un error de Data Validation ocurre cuando un valor observado no cumple con una regla, esquema, relación o expectativa empresarial. La regla puede ser simple, como “este campo debe contener una fecha”, o relacional, como “este pedido debe hacer referencia a un cliente existente”.
Piense en la validación como en el contrato de entrada a un club. Un portero puede comprobar primero si su identificación tiene el formato correcto. Una comprobación más profunda confirma que el nombre aparece en la lista de invitados, que el evento es válido para esa entrada y que la reserva coincide con la persona que la presenta. Los sistemas de datos funcionan de la misma manera.
La comprobación superficial
Una comprobación de formato pregunta si un valor se puede interpretar correctamente:
2025-04-18parece una representación de fecha válida.jdoe@se parece a un campo de correo electrónico pero no cumple con un patrón de correo completo.42puede ser un valor numérico válido.Closed Wonpuede fallar de todos modos si el código permitido esclosed_won.
Estas comprobaciones evitan fallos de análisis sintáctico, pero no establecen que el registro tenga sentido en su contexto.
La comprobación profunda
La validación a nivel de registro examina relaciones y reglas de negocio:
¿Identifica
customer_ida un cliente en la dimensión de clientes?¿Se permite el descuento para este segmento de clientes?
¿Es el total del pedido igual a la suma de sus artículos de línea?
¿Ocurre la fecha del evento después de que se creara la cuenta?
¿Pertenece el estado al dominio aprobado para este flujo de trabajo?
Un menú desplegable de hoja de cálculo, una respuesta de API como HTTP 422, una violación de restricción en el almacén de datos y un conjunto de pruebas de Great Expectations implementan la misma idea subyacente en diferentes capas. Cada uno compara los datos con un contrato acordado.
El Banco Mundial describe la validación a través de técnicas como comprobaciones de rango, comprobaciones de consistencia interna y detección de valores atípicos, y hace hincapié en documentar la validación en los metadatos. Esa orientación aparece en su conferencia sobre validación de datos. Por lo tanto, un error de validación no es simplemente un mensaje molesto. Es la evidencia de que un registro, archivo o conjunto de datos ya no coincide con las suposiciones realizadas por el siguiente sistema.
Obtendrá mejores resultados cuando se plantee dos preguntas por separado:
¿Qué regla ha fallado?
¿Qué capa permitió que el valor no válido llegara tan lejos?
La primera pregunta repara el registro. La segunda evita que se repita.
Para una explicación más amplia de la validez, las dimensiones y la medición, compare esta definición con la explicación de digna sobre la validez de los datos.
Los patrones principales detrás de los fallos de validación
La mayoría de las incidencias de validación se encuadran en un pequeño conjunto de patrones estructurales. Clasificar el fallo primero ayuda a elegir la solución correcta en lugar de tratar cada fila rechazada como un misterio sin relación.
El Banco Mundial identifica los valores faltantes, los problemas de formato, los problemas de codificación, las comprobaciones de rango, las comprobaciones de consistencia y la detección de valores atípicos como partes importantes de la práctica de validación. Investigaciones anteriores de la Sociedad de Actuarios también revelaron que los errores de validez son más comunes y están más extendidos que los errores de precisión, situando a los valores faltantes, los errores de formato de datos y los errores de codificación entre los principales problemas de validez. La orientación se resume en el estudio sobre calidad de datos de la Sociedad de Actuarios.
Patrón | Ejemplo de valor incorrecto | Regla infringida |
|---|---|---|
Valor faltante |
| El identificador requerido debe estar presente |
Error de formato |
| El valor debe utilizar un formato de fecha analizable |
Violación de rango |
| La edad debe mantenerse dentro del rango permitido |
Error de codificación o de dominio |
| El valor debe coincidir con un dominio aprobado |
Ruptura de consistencia |
| El total de cabecera debe ser igual al total detallado |
Valores faltantes
Un valor faltante se convierte en un error cuando el campo es obligatorio para el procesamiento o la interpretación. Una extensión de teléfono en blanco puede ser aceptable, mientras que un identificador de cliente ausente puede hacer que sea imposible asociar el registro. Estos fallos suelen aflorar en los registros de ingesta, en las comprobaciones NOT NULL o en informes con poblaciones inesperadamente incompletas.
Format errors
Los errores de formato ocurren cuando el sistema no puede analizar el valor como el tipo declarado. Una fecha almacenada como texto libre, una cantidad numérica que contiene un símbolo inesperado o un correo electrónico al que le falta el dominio pueden pasar a través de una exportación poco controlada y fallar dentro de una API o una conversión en el almacén de datos.
Violaciones de rango
Las comprobaciones de rango detectan valores que son estructuralmente numéricos pero lógicamente imposibles o no permitidos. Una edad negativa, una fecha de nacimiento futura o un porcentaje superior a su máximo permitido pueden ser números sintácticamente válidos. La referencia sobre validación de datos del Banco Mundial explica cómo las comprobaciones de rango y de consistencia interna ayudan a localizar errores antes del análisis o del uso en producción.
Errores de codificación y de dominio
Un dominio es el conjunto de valores aceptados para un campo. Los campos de país, estado, tipo de producto y categoría de riesgo a menudo fallan porque diferentes sistemas utilizan ortografías, mayúsculas, abreviaturas o códigos heredados distintos. Es posible que estos errores no provoquen un fallo en el analizador, pero fragmentan los recuentos y rompen los filtros.
Rupturas de consistencia
Las reglas de consistencia comparan campos dentro del mismo registro o entre registros relacionados. Un país de envío que entra en conflicto con la región asignada, una factura cuyas líneas de detalle no coinciden con su total de cabecera o una transacción vinculada a un cliente desconocido pertenecen a esta categoría. Los usuarios de negocio suelen notar estos errores primero porque el resultado contradice lo que saben sobre el proceso.
Hábito de diagnóstico: No comience editando el valor. Comience por nombrar el patrón infringido. El patrón suele apuntar a la capa responsable.
Ejemplos a nivel de registro que puede identificar en sus propios datos
El mismo defecto se ve diferente según dónde se encuentre. Una hoja de cálculo puede mostrar una cadena sospechosa, una API puede devolver un rechazo estructurado y una prueba de almacén de datos puede informar de una relación fallida. Sin embargo, el problema subyacente puede ser idéntico.
Exportaciones de hojas de cálculo
Una exportación de CRM contiene esta fila:
customer_email | phone | stage |
|---|---|---|
|
|
|
El correo electrónico falla en una comprobación estructural básica porque carece de un dominio completo. El número de teléfono puede ser utilizable para un proceso pero inconsistente con otro que espera un formato normalizado como (555) 123-4567. Los valores de etapa closed-won, Closed Won y CLOSED_WON pueden representar el mismo estado de negocio para una persona mientras que aparecen como tres categorías distintas para una tabla dinámica.
Un menú desplegable podría detener nuevas variaciones, pero no normalizará los valores históricos ya exportados. Tampoco explicará si la diferencia fue introducida por el CRM de origen, la plantilla de exportación o una edición manual.
Ingesta de API
Una API recibe este payload:
Aquí, customer_id infringe una regla de campo obligatorio. order_total es una cadena de texto a pesar de que el contrato receptor espera un número. created_at no es una fecha válida porque la combinación de mes y día no se puede interpretar como una fecha real del calendario.
Una respuesta HTTP 422 es útil cuando identifica el campo exacto y la regla que falló. Si solo indica “entidad no procesable”, inspeccione el cuerpo de la solicitud, el cuerpo de la respuesta, el tipo de contenido y la especificación de la API. La guía de Postman para errores HTTP 422 proporciona un contexto práctico de depuración para estos casos.
Registros de almacén de datos
Una tabla de hechos de un almacén de datos contiene una fila con tres problemas distintos:
order_dateocurre antes decustomer_signup_date.customer_idno apunta a ninguna fila endim_customer.discount_percent = 150, fuera del rango permitido.
El primero es un fallo de consistencia temporal. El segundo es un fallo de integridad referencial. El tercero es una violación de rango. Ninguno es un mero problema de formato, y corregir el formato de visualización no hará que el registro sea de confianza.
Entorno | Ejemplo de campo | Valor de registro incorrecto | Clase de defecto |
|---|---|---|---|
Hoja de cálculo |
|
| Formato |
Payload de API |
|
| Campo obligatorio |
Payload de API |
|
| Incompatibilidad de tipo |
Tabla de hechos del almacén de datos |
| Clave de dimensión desconocida | Referencial |
Tabla de hechos del almacén de datos |
| Anterior a la fecha de registro | Temporal |
Tabla de hechos del almacén de datos |
|
| Rango |
Es más fácil razonar sobre estos ejemplos cuando se separa la validez de la razonabilidad. Un valor puede coincidir con un tipo de datos y, aun así, parecer poco plausible en su contexto. La guía de digna sobre la razonabilidad de los datos analiza esta distinción.
Por qué la mayoría de los errores de validación comienzan en origen
Corregir celdas incorrectas de una en una parece productivo porque el recuento de errores disminuye inmediatamente. Sin embargo, a menudo se trata el síntoma dejando inalterados al productor, al contrato o al esquema.
Un menú desplegable de hoja de cálculo solo regula lo que un usuario puede introducir a través de esa interfaz. No controla los valores generados por una integración de CRM, una exportación masiva, un cliente de API, una migración de base de datos o una tarea de transformación. La validación más sólida se sitúa cerca del punto en el que se crean e intercambian los datos.
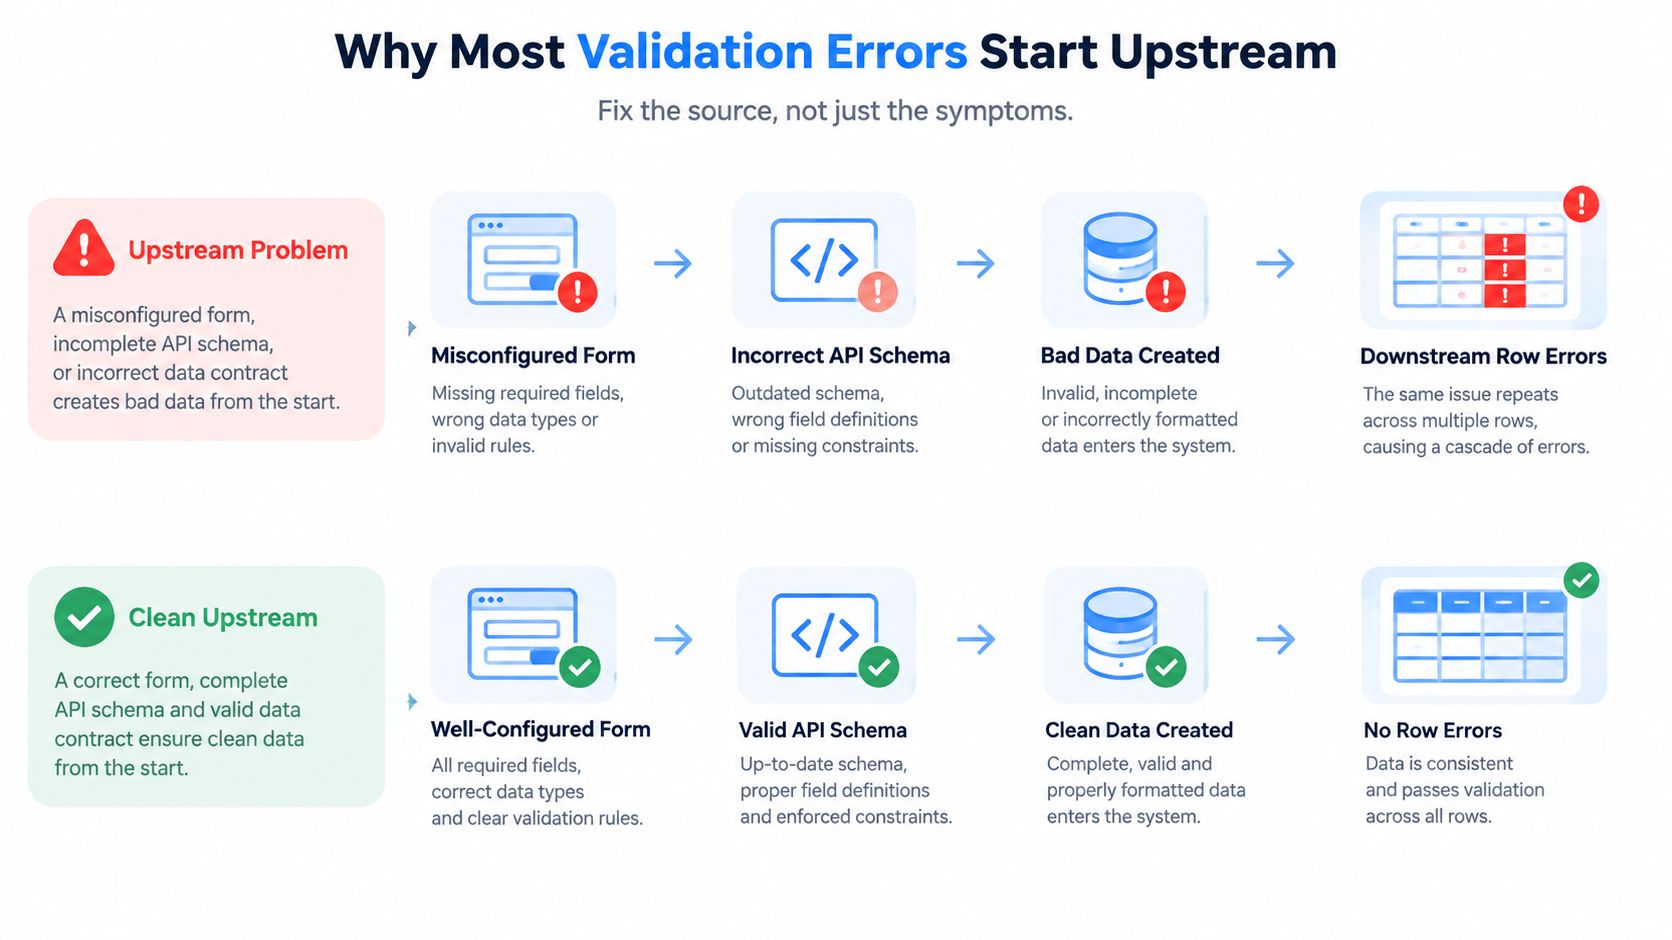
Piense en un campo de API que cambia de customer_id a account_id sin un contrato versionado. La transformación receptora puede rellenar customer_id con NULL en cada registro entrante. El almacén de datos informa entonces de identificadores ausentes, las asociaciones de cuadros de mando pierden filas y los analistas comienzan a parchear manualmente las salidas. Este fallo repetido no es evidencia de una introducción de datos descuidada; es evidencia de que dos sistemas no están de acuerdo con el esquema.
El mismo patrón aparece cuando cambia una plantilla de exportación de CRM, se relaja una restricción de base de datos o una migración elimina una regla de campo obligatorio. Un cambio en el origen puede crear miles de fallos posteriores que parecen filas individuales incorrectas.
Reparar el contrato, no solo la salida
Utilice el patrón de fallo para elegir la intervención:
Nombre de campo cambiado: Versione el payload y actualice el consumidor de manera deliberada.
Campo opcional que debe existir: Haga que el campo sea obligatorio en el contrato de origen y rechace las solicitudes incompletas.
Valor numérico no válido: Añada una restricción
CHECKen el nivel de origen o una validación equivalente.Estado no reconocido: Mantenga un dominio o enumeración compartidos en lugar de confiar en texto libre.
Relación incorrecta: Valide los identificadores referenciados antes de cargar el registro dependiente.
La guía de digna sobre ingesta de datos proporciona un contexto útil para tratar la ingesta como un movimiento controlado de datos en lugar de un mero paso de transferencia de archivos.
Prueba de causa raíz: Si el mismo fallo de validación aparece en muchas filas después de un cambio en el origen, investigue el contrato antes de limpiar los registros.
Rechazar datos no válidos en la ingesta suele ser más seguro que permitir que se registren como NULL, una cadena vacía o un valor predeterminado forzado. Si el rechazo no es factible, ponga la fila en cuarentena con su identificador de origen, el fallo de la regla y la marca de tiempo de ingesta, para que los consumidores posteriores no confundan un valor dañado con uno real.
A Practical Workflow to Detect and Fix Errors
Un flujo de trabajo fiable coloca los controles allí donde proporcionan la señal más clara y la menor cantidad de retrabajo. Comience en la captura, luego continúe con la ingesta, las comprobaciones del almacén de datos y el consumo.
Captura
Valide tipos, campos obligatorios, valores permitidos y rangos en formularios, API y bases de datos de origen. Las máscaras de entrada pueden guiar a los usuarios, mientras que las restricciones de esquema evitan que los productores envíen valores que los sistemas posteriores no puedan interpretar.
Una base de datos de origen debe aplicar reglas que importen independientemente de quién escriba el registro. Una API debe devolver errores a nivel de campo que indiquen al cliente qué debe corregir. Un formulario debe evitar un valor no válido antes de su envío, en lugar de confiar en que un analista lo encuentre más tarde.
Ingesta
Trate cada archivo o payload entrante como un contrato. Valide cada registro frente al esquema esperado, ponga en cuarentena los fallos y emita eventos de error estructurados que contengan el archivo de origen, el identificador del registro, el campo, el valor observado y la regla infringida.
No sobrescriba el valor original durante la limpieza. Presérvelo junto al valor normalizado para que el equipo pueda auditar qué llegó y qué transformación se llevó a cabo.
Almacén de datos (Warehouse)
Ejecute comprobaciones continuas de valores nulos, unicidad, integridad referencial, frescura, cambios en la distribución y lógica entre campos. Una prueba de almacén de datos debe distinguir una única fila rechazada de un fallo de esquema generalizado, y debe preservar el contexto suficiente para que el propietario pueda reproducir el problema.
La orientación del Banco Mundial sobre la introducción y validación de datos destaca controles como la restricción de opciones de respuesta y el uso de comprobaciones basadas en recuentos para reducir elementos omitidos o no válidos. Esos principios se aplican más allá de las encuestas. Aplique las restricciones temprano y luego verifique el conjunto de datos resultante de forma independiente.
Consumo
Los cuadros de mando y los modelos necesitan sus propias aserciones. Compare los recuentos de filas esperados, detecte particiones ausentes, compruebe la cobertura de las asociaciones y marque las métricas que cambien de forma repentina sin una explicación correspondiente de calidad de datos.
Cuando se editan fórmulas en hojas de cálculo, la validación puede comportarse de manera inesperada. Microsoft Q&A señala que los errores de fórmula como #REF! o #DIV/0! pueden hacer que la validación se ignore, mientras que las operaciones de copiar y rellenar pueden eludir o alterar el comportamiento esperado. Revise la discusión de Microsoft sobre errores de validación impulsados por fórmulas cuando un menú desplegable parezca correcto pero las celdas transformadas sigan fallando.
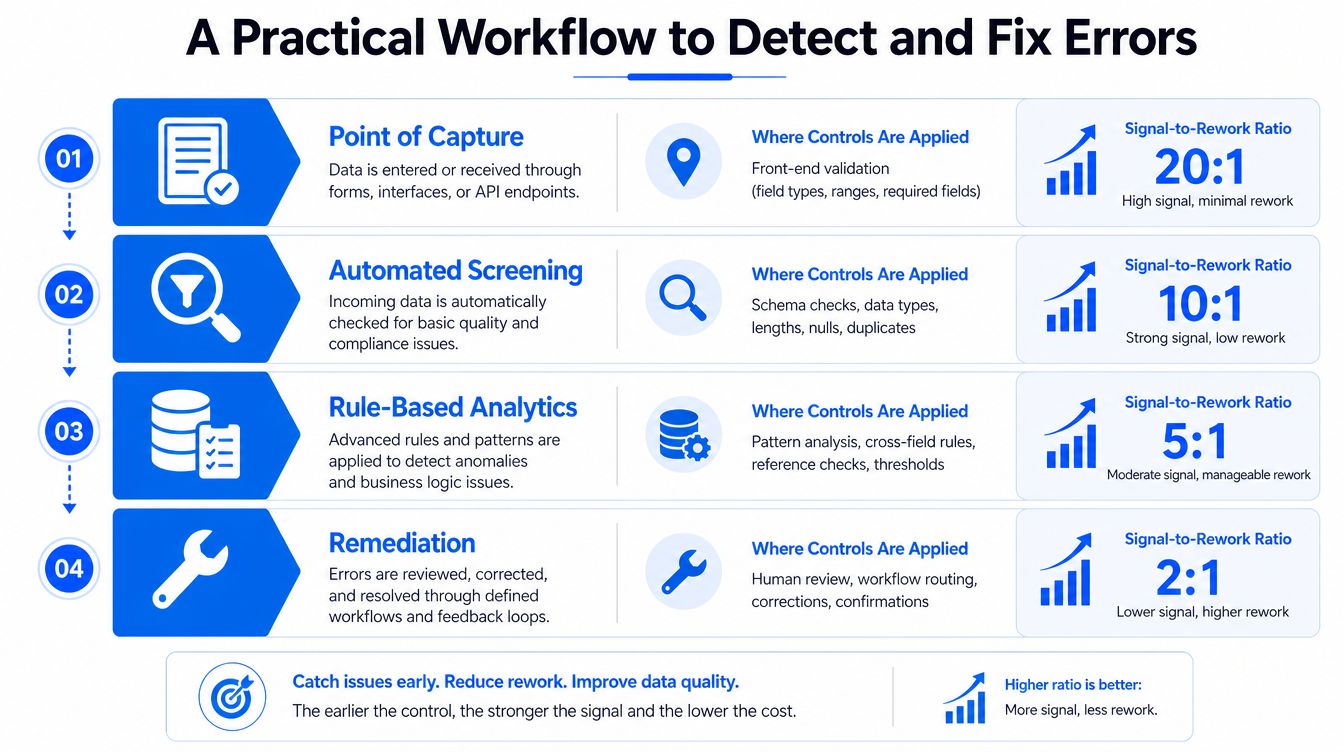
Utilice este orden de solución:
Corrija primero los contratos de origen. Corrija la regla de origen, el esquema, el mapeo o el comportamiento del productor.
Parchee el almacén de datos en segundo lugar. Aísle, complete retroactivamente o normalice los registros cuando el origen no se pueda cambiar de inmediato.
Limpie en la analítica solo cuando sea necesario. Haga que la transformación sea visible, documentada y reversible.
Para realizar comprobaciones continuas que combinen reglas a nivel de registro con una observabilidad más amplia, consulte la guía de digna sobre Data Validation y calidad de datos continua. La plataforma se ejecuta dentro del entorno del cliente, realiza el cálculo de métricas en las bases de datos del cliente y puede supervisar la validación, la Timeliness, las anomalías y los cambios de esquema sin mover los datos de producción fuera de ese entorno.
Puntos clave para operaciones de datos fiables
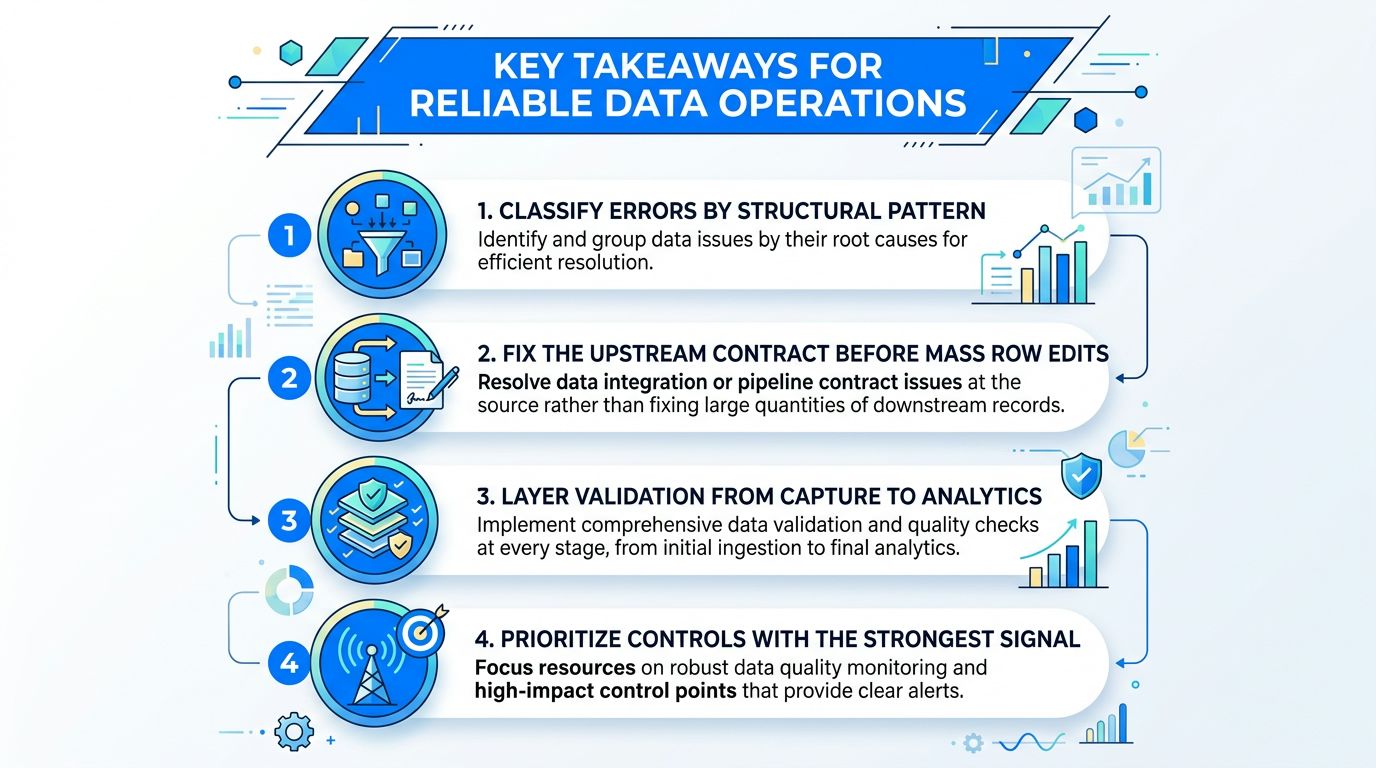
Las operaciones de datos fiables dependen menos de un único ejercicio de limpieza perfecto y más de una respuesta repetible ante fallos recurrentes. Utilice esta lista de verificación cuando aparezca una alerta de validación:
Clasifique el defecto. Decida si falta, está mal formado, fuera de rango, fuera del dominio, si es inconsistente, temporalmente imposible o referencialmente no válido.
Rastree el primer punto de fallo. Identifique al productor, la exportación, el mapeo de la API, la migración o la transformación que introdujo la discrepancia.
Repare el contrato de origen. Modifique el esquema, la regla de campo obligatorio, la restricción, el mapeo o el payload versionado antes de editar grandes cantidades de filas posteriores.
Establezca controles por capas. Valide en la captura, ingesta, almacén de datos y consumo para que una conversión silenciosa no pase desapercibida.
Haga un seguimiento de la recurrencia. Registre el campo, la regla, el origen, el pipeline y la tendencia del fallo. Los fallos repetidos merecen un trabajo de ingeniería, no una limpieza manual recurrente.
Conserve la evidencia. Guarde los registros rechazados, los resultados de las reglas, las marcas de tiempo y las decisiones de solución para investigación y auditabilidad.
La lección central es sencilla: los errores de validación recurrentes suelen apuntar a un proceso defectuoso, no a un usuario descuidado. Una sola fila puede ser el fallo visible, pero las filas repetidas revelan una debilidad en el contrato, el esquema, el mapeo o la supervisión en fases previas.
Por lo tanto, la validación debe ser observable. Los equipos necesitan saber qué reglas fallan, dónde fallan, si los fallos son aislados o sistémicos, y qué recursos posteriores dependen de los datos afectados. Esa visibilidad convierte una discrepancia confusa en un cuadro de mando en una incidencia de ingeniería sobre la que se puede actuar.
digna ayuda a los equipos de datos a definir reglas de Data Validation a nivel de registro, supervisar cambios de esquema, realizar un seguimiento de la Timeliness y detectar comportamientos inusuales en almacenes de datos y pipelines, manteniendo al mismo tiempo los datos dentro del entorno del cliente. Visite digna para ver cómo puede sustituir la limpieza manual recurrente fila por fila por controles trazables de calidad de datos y Observability.
Preguntas frecuentes
¿Qué es un error de validación de datos?
Se produce cuando un valor observado incumple una regla, un esquema, una relación o una expectativa de negocio. Es más que una celda rechazada en una hoja: una ejecución correcta de la canalización demuestra que el procesamiento terminó, no que cada registro cumpliera las reglas de las que depende la empresa.
¿Qué diferencia hay entre una comprobación de formato y la validación a nivel de registro?
La profundidad. La comprobación de formato pregunta si un valor puede interpretarse, de modo que 2025-04-18 se lee como fecha mientras jdoe@ falla un patrón de correo. La validación a nivel de registro examina relaciones: ¿customer_id identifica a un cliente real?, ¿el total del pedido coincide con sus líneas?
¿Cuáles son los patrones de fallo de validación más comunes?
Se repite un conjunto pequeño: valores ausentes, problemas de formato, errores de codificación, comprobaciones de rango fallidas, violaciones de consistencia y valores atípicos. El Banco Mundial identifica esas mismas categorías y subraya documentar la validación en metadatos para que la regla y su razón sobrevivan a quien la escribió.
¿Cuánto cuesta realmente un error de validación?
El punto de referencia más citado de Gartner sitúa la mala calidad de datos en una media de 12,9 millones de USD por organización y año. La investigación de IBM de 2025 halló que más de una cuarta parte de las organizaciones estima pérdidas anuales superiores a 5 millones de USD, y un 7 % por encima de 25 millones.
¿Cómo se investiga un error de validación?
Haga dos preguntas por separado. Qué regla falló, lo que repara el registro, y qué capa permitió que el valor inválido llegara tan lejos, lo que repara la canalización. Responder solo a la primera deja al mismo defecto libre para volver mañana.


