Datos listos para IA: de entradas crudas a IA fiable
|
8
minuto de lectura

Un proyecto de IA suele parecer saludable hasta el momento en que toca datos de producción.
El equipo tiene una idea de modelo, presupuesto, un entorno en la nube y gente que sabe construir pipelines. Entonces el trabajo se frena. Los campos significan cosas distintas en sistemas distintos. El cambio de esquema de ayer rompió una tabla de características. Las etiquetas vinieron de un proceso manual en el que nadie confía del todo. Los datos existen, pero nadie puede afirmar con seguridad si son seguros para recuperación, predicción o acción automatizada.
Ahí es donde muchos equipos comprenden que no les bloqueaba la elección de modelo. Les bloqueaba la madurez de los datos.
Una encuesta global de 2024 captó esta brecha con claridad. Solo el 12 % de las organizaciones dijo que sus datos tenían calidad y accesibilidad suficientes para una implantación eficaz de IA, aunque el 60 % afirmó que la IA se había vuelto una influencia clave en los programas de datos, un 46 % más que en 2023. La misma encuesta halló que el 64 % señaló la calidad de datos como su principal reto de integridad, mientras que el 77 % calificó su calidad de datos como media o peor (investigación global sobre madurez para la IA).
Tabla de contenidos
Introducción: por qué los proyectos de IA se atascan antes del modelo
¿Listos para qué? Definir la aptitud para tu caso de uso de IA
Cómo la observabilidad mantiene los datos listos para IA en ejecución
Introducción: por qué los proyectos de IA se atascan antes del modelo
En muchos equipos de datos se repite un patrón conocido. Producto quiere un copiloto de soporte. Riesgos quiere detección de anomalías. Operaciones quiere previsiones. Ingeniería monta el stack bastante rápido, pero la primera prueba seria destapa el problema. Nadie se pone de acuerdo sobre qué tabla es la autorizada, si la última carga está completa o si las etiquetas reflejan el resultado de negocio que el modelo debería aprender.
Por eso datos listos para IA es una expresión más útil que «datos limpios». La limpieza suena a tarea de higiene puntual. La madurez es más estricta. Pregunta si un conjunto sirve para una tarea concreta de IA, en las condiciones actuales de operación, con suficiente confianza para sostener decisiones.
Si has visto experimentos de modelo rendir bien en un notebook y fallar al conectarse a sistemas vivos, ya conoces este problema. El fallo no suele ser misterioso. Está en entidades duplicadas, entradas rancias, transformaciones sin documentar o traspasos frágiles entre equipos. Una base práctica empieza por entender por qué la calidad de datos importa a una organización, pero la IA sube el listón porque los datos tienen que funcionar para personas y para máquinas.
El atasco suele empezar aguas arriba
Muchos equipos no empiezan haciendo la pregunta equivocada. Hacen una pregunta demasiado amplia: «¿Están nuestros datos listos para IA?». Suena sensato, pero esconde los detalles importantes. Listos para buscar en documentos es distinto de listos para prever demanda. Listos para un asistente con persona en el bucle es distinto de listos para un agente que dispara acciones.
Los proyectos de IA rara vez se atascan por falta de datos. Se atascan porque los datos disponibles no son lo bastante fiables para el flujo exacto que se está construyendo.
Esa distinción cambia cómo evalúas la madurez. Dejas de tratar el volumen como prueba. Empiezas a comprobar aptitud, trazabilidad y seguridad en ejecución.
La confianza tiene que sobrevivir al contacto con sistemas vivos
Las comprobaciones históricas de calidad importan, pero no bastan. Un conjunto de entrenamiento puede parecer bien preparado y volverse inseguro en cuanto cambian esquemas, llegan cargas tarde o la lógica aguas arriba se mueve sin avisar. En la práctica, la madurez para IA vive en dos sitios a la vez:
La calidad de preparación significa que el conjunto está definido, validado y documentado lo bastante para usarse.
La confianza en ejecución significa que puedes detectar cuándo ese estado deja de cumplirse.
Esa es la lente que conviene usar. No «¿tenemos muchos datos?», sino «¿pueden estos datos sostener este comportamiento de IA, hoy, con controles que detecten la deriva antes de que el modelo actúe?».
Qué significan de verdad los datos listos para IA
Los datos listos para IA no son solo datos con menos nulos y valores más limpios. Son datos que una máquina puede interpretar, rastrear y usar correctamente para un flujo definido.
Ayuda una analogía de cocina. Los ingredientes crudos en la nevera no son lo mismo que ingredientes preparados para una receta. Puedes tener cebollas, tomates y especias, pero eso no significa que la cena esté lista. Alguien aún debe lavar, cortar, medir, etiquetar y organizarlo todo para el plato exacto que se cocina. Con los datos pasa igual. Almacenar no es estar listo. Estar listo significa que el conjunto se ha preparado para un tipo concreto de cómputo.
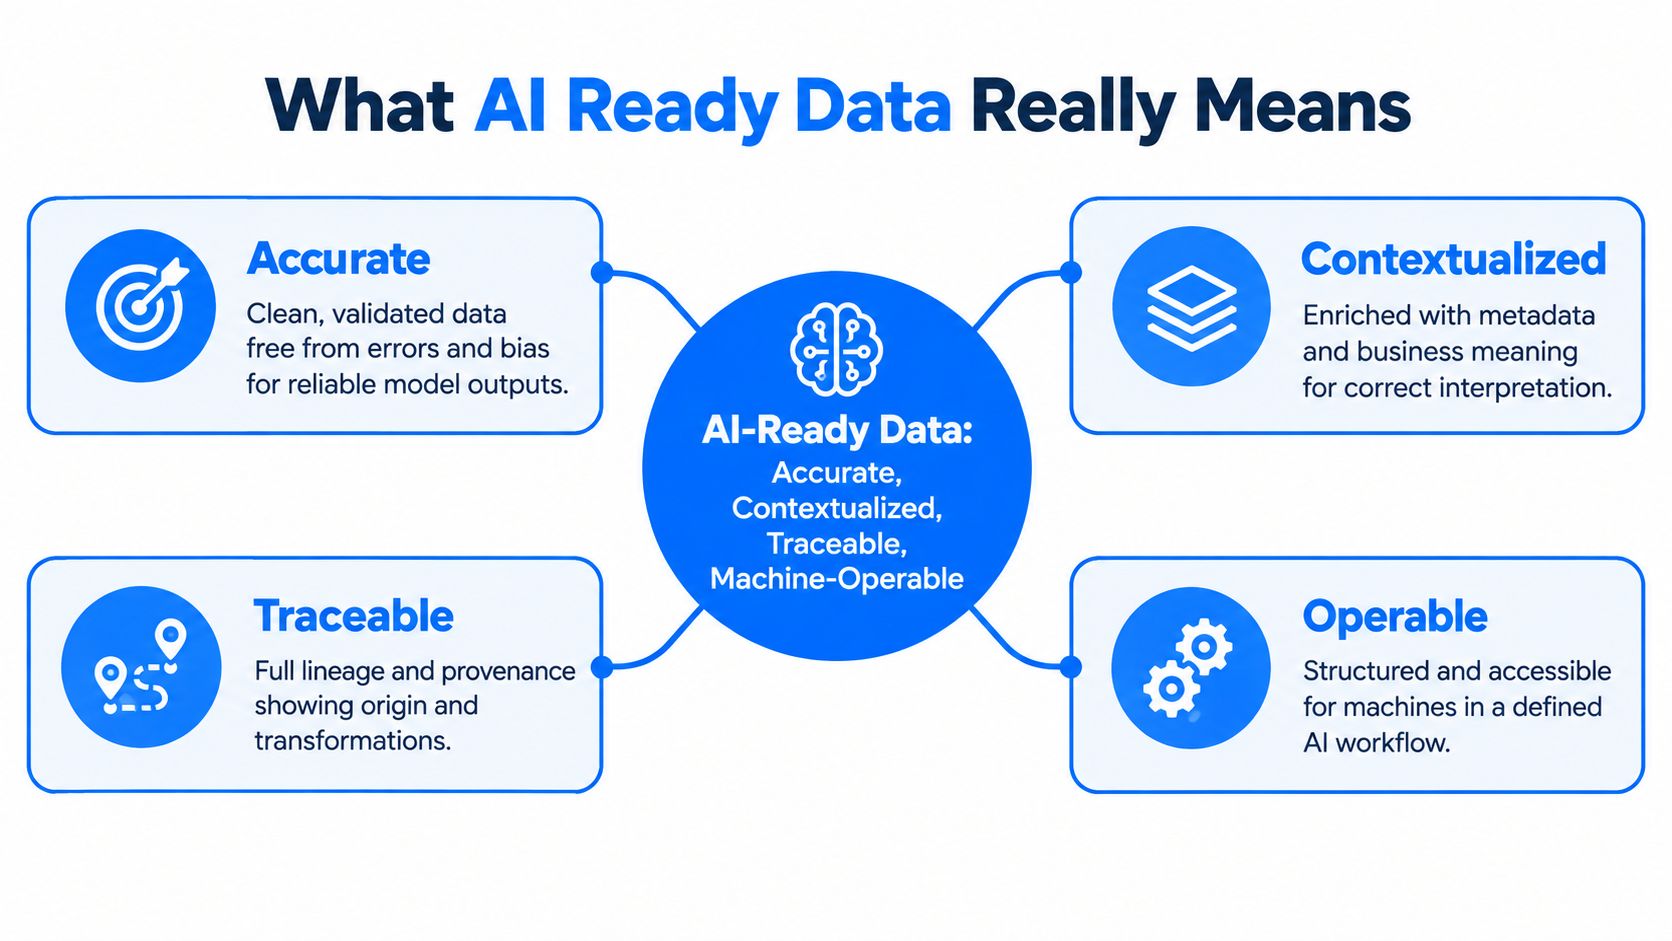
La exactitud es solo la primera capa
Empieza por la calidad de los valores, y deberías. Los valores malos rompen modelos de formas evidentes. Las marcas de tiempo erróneas distorsionan las características de secuencia. Los clientes duplicados inflan la exposición. Las etiquetas inconsistentes envenenan los objetivos de entrenamiento. Si necesitas un buen repaso de los componentes que hay detrás, las dimensiones de la calidad de datos son la base adecuada.
Pero la exactitud por sí sola no hace los datos listos para IA. Una columna perfectamente válida falla igualmente si el modelo no puede saber qué significa, de dónde vino o si aplica a la tarea actual.
El contexto convierte valores en señal utilizable
Los datos se vuelven más útiles cuando llevan metadatos que las máquinas pueden analizar, no solo comentarios que las personas pueden leer. Guías independientes de la comunidad estadística de Naciones Unidas y del gobierno del Reino Unido subrayan que los conjuntos listos para IA necesitan metadatos legibles por máquina, aseguramiento de calidad, formatos interoperables y controles de gobernanza. El marco de la ONU destaca metadatos accionables por máquina, control de calidad, licencias abiertas, acceso responsable habilitado por IA y colaboración estructurada. La guía británica de 2026 dice que un conjunto listo para IA debe cumplir estándares de optimización técnica, exactitud, completitud, consistencia, metadatos, monitorización de calidad en vivo y cumplimiento legal (guías de la ONU y el Reino Unido sobre datos listos para IA).
Suena abstracto hasta que lo llevas al trabajo de ingeniería:
El significado de negocio dice al equipo de modelado qué representa un campo.
Los metadatos técnicos dicen a los sistemas cómo analizarlo y unirlo.
El contexto de uso dice a los usuarios posteriores cuándo es apropiado usarlo.
Trazable y operable por máquinas significa seguro en producción
Un artículo experto de 2026 describe los datos listos para IA como datos respaldados por metadatos estructurados que permiten el descubrimiento automatizado, la alineación semántica, el seguimiento de la procedencia y un uso computacional reproducible. También señala que los metadatos a nivel de conjunto deben ir adjuntos y ser analizables por máquinas, porque la interoperabilidad y la trazabilidad dependen de ello (discusión experta sobre metadatos estructurados y procedencia).
Regla práctica: trata los metadatos, el linaje y la procedencia como parte del contrato de entrada del modelo, no como papeleo opcional de gobernanza.
Esa es la definición central que uso en el trabajo de plataforma: los datos listos para IA son exactos, contextualizados, trazables y operables por máquinas para una tarea concreta de IA. Si falta alguna de esas piezas, el modelo puede seguir funcionando. Simplemente no será fiable.
Los seis pilares que hacen los datos listos para IA
Una lista práctica va más allá de «limpio y gobernado». Seis pilares resultan útiles porque cubren tanto el rendimiento del modelo como la confianza operativa.
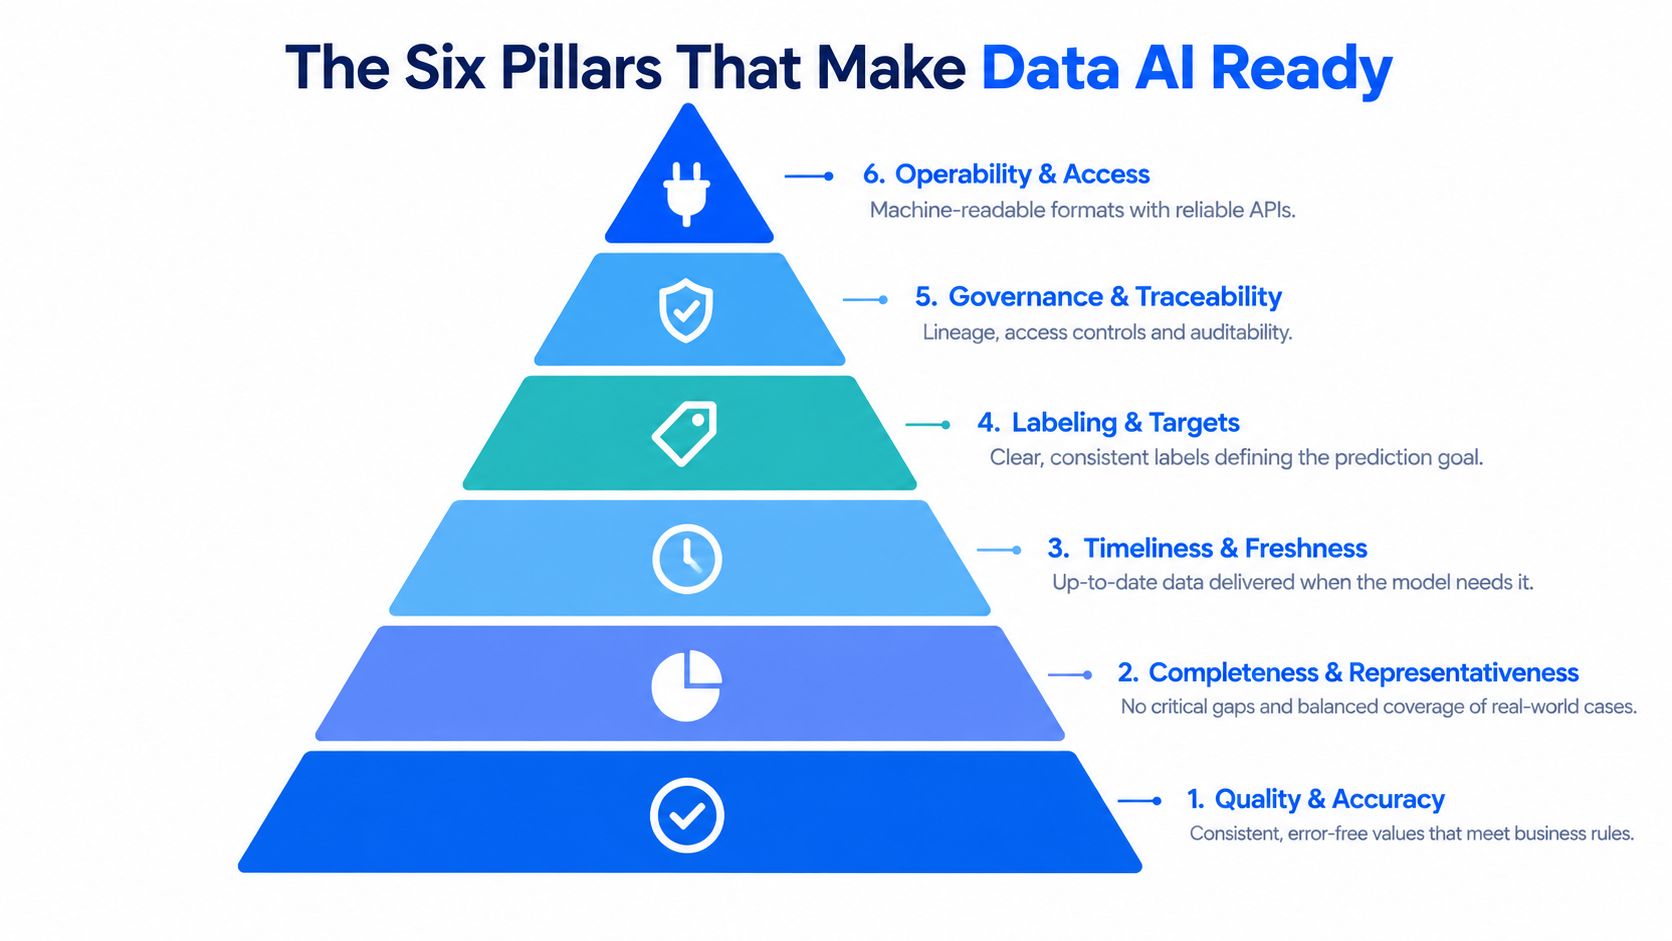
Calidad y exactitud
Empieza por los valores en sí. ¿Son válidos los registros? ¿Son coherentes los formatos? ¿Obedecen fechas, identificadores y campos categóricos a las reglas de negocio?
Esto no es solo ortodoxia de la gestión de datos. Una investigación empírica examinó seis dimensiones de calidad de datos en 19 algoritmos de aprendizaje automático populares para clasificación, regresión y agrupamiento, precisamente para explicar el rendimiento a través de la calidad de los datos. Un artículo posterior de IA centrada en datos revisó seis dimensiones: representación consistente, completitud, exactitud de características, exactitud del objetivo, unicidad y equilibrio de clases objetivo (investigación sobre dimensiones de calidad de datos y resultados de ML).
La implicación práctica es sencilla. Los duplicados, los objetivos mal etiquetados y las representaciones inconsistentes cambian el comportamiento del modelo.
Completitud y representatividad
Un conjunto completo puede aun así no representar el mundo al que se enfrentará tu modelo. Ahí es donde los equipos tropiezan a menudo. Validan recuentos de filas y tasas de nulos, y luego descubren que el modelo flojea en casos raros pero importantes.
La representatividad pregunta si los datos incluyen los eventos, usuarios, casos límite y condiciones operativas que el sistema de IA debe manejar. Si entrenas un clasificador de soporte con tickets bien formados pero producción incluye abreviaturas, registros pegados y texto multilingüe, tu muestra limpia no es suficientemente representativa.
Una lista útil en la empresa suele incluir:
Cobertura de casos límite que importan al negocio, no solo del camino habitual
Ejemplos equilibrados cuando el desequilibrio de clases distorsionaría el entrenamiento
Diversidad de fuentes cuando la misma entidad aparece en sistemas fragmentados
Timeliness y frescura
Algunos datos son correctos y aun así inservibles porque llegan tarde. Eso importa a la IA más de lo que muchos equipos esperan.
Un modelo de recomendación basado en el inventario de ayer puede sugerir artículos no disponibles. Una señal de fraude construida sobre transacciones retrasadas pierde utilidad justo cuando la velocidad importa. En sistemas de recuperación, el conocimiento rancio puede ser más peligroso que el conocimiento ausente, porque la salida sigue sonando segura.
La frescura no es una nota al pie del SLA. Para muchos flujos de IA, forma parte de la corrección.
Etiquetado e integridad del objetivo
Las etiquetas de entrenamiento merecen pilar propio porque definen lo que el modelo aprende a optimizar. Si los equipos no coinciden en qué significa «abandonó», «aprobado» o «riesgo alto», el modelo codificará esa ambigüedad.
Un buen etiquetado no va solo de consistencia. Va también de alineación operativa. El objetivo debe reflejar la decisión que el negocio quiere sostener. De lo contrario, el modelo se vuelve excelente prediciendo un sustituto que nadie debería usar.
Gobernanza y trazabilidad
Cuando una salida del modelo necesita explicación, los equipos necesitan linaje rápido. ¿Qué sistema de origen aportó el valor? ¿Qué transformaciones lo cambiaron? ¿Quién aprobó el conjunto para este uso?
Un marco de calidad de datos empresarial es útil aquí porque la gobernanza se vuelve práctica cuando se ata a controles concretos: propiedad, reglas de acceso, evidencia de validación e historial de linaje. Sin trazabilidad, incluso un conjunto sólido es difícil de auditar y difícil de confiar.
Operabilidad y acceso
El último pilar suele infravalorarse. Los datos pueden ser de alta calidad y fallar igualmente porque están atrapados en formatos incómodos, patrones de almacenamiento mal documentados o traspasos frágiles.
Operabilidad significa que los datos están disponibles en formatos legibles por máquina, accesibles mediante interfaces estables y estructurados para que las pipelines los consuman con fiabilidad. En términos de producción, esquemas, API, tablas y servicios de metadatos dejan de ser fontanería y pasan a ser parte de la propia madurez para IA.
¿Listos para qué? Definir la aptitud para tu caso de uso de IA
Una lista genérica de madurez se desmorona en cuanto comparas trabajos de IA distintos.
Un sistema de recuperación necesita documentos buscables, estrategia de fragmentación, etiquetas de metadatos y procedencia. Un modelo de previsión necesita series temporales estables, granularidad coherente y marcas de tiempo fiables. Un flujo autónomo necesita controles aún más fuertes, porque puede actuar sobre los datos sin revisión humana.
Gartner lo dice directamente. Los responsables deben definir primero qué cuenta como datos listos para IA, y esos datos deben ser representativos del caso de uso, incluidos casos límite, valores atípicos y patrones inesperados necesarios para entrenar o ejecutar el modelo. La misma discusión señala que las organizaciones confunden a menudo escala con calidad de señal adecuada al propósito, mientras la orientación actual subraya datos buscables, contextuales y fiables en activos estructurados, no estructurados y de streaming (Gartner sobre definir datos listos para IA por caso de uso).
Más datos no responden a la pregunta correcta
Los equipos suelen decir: «tenemos datos de sobra». Puede ser cierto y aun así irrelevante.
La mejor pregunta es: ¿qué fallo dañaría más a este sistema de IA? Si el sistema resume documentos de política, las versiones obsoletas son un riesgo mayor. Si puntúa eventos de crédito, la procedencia y el estado de aprobación importan más que el volumen de texto. Si impulsa un agente operativo, la frescura en ejecución y los límites de permisos pasan al centro.
Caso de uso de IA | Criterios de madurez más críticos | Fallo común si faltan |
|---|---|---|
Recuperación sobre documentos | Metadatos buscables, procedencia, versionado, controles de acceso | El sistema recupera contenido obsoleto o pobre en contexto |
Modelado predictivo | Cobertura representativa, integridad del objetivo, consistencia, completitud | El modelo aprende patrones distorsionados y se pierde casos importantes |
Apoyo a la decisión en tiempo real | Frescura, Timeliness, esquemas estables, acceso de baja latencia | La salida refleja eventos tardíos o incompletos |
Flujos autónomos | Gobernanza, trazabilidad, controles de política, detección de cambios | El sistema toma acciones inseguras basadas en entradas poco fiables |
Usa los elementos de datos críticos para ponderar la lista
A muchos equipos les conviene definir elementos de datos críticos antes de empezar a afinar modelos. No todo campo merece los mismos controles. El identificador de cliente en un flujo de deduplicación importa de forma distinta a un campo descriptivo de comentarios en una búsqueda semántica.
Una forma práctica de puntuar la aptitud es hacerse tres preguntas:
¿Qué decisión o salida exacta depende de estos datos?
¿Qué modo de fallo es el menos aceptable?
¿Qué campos, metadatos y rutas de actualización impulsan ese riesgo?
Una vez que las respondes, la madurez deja de ser un eslogan y se convierte en una especificación de ingeniería.
Cómo preparar datos para IA en la práctica
La preparación funciona mejor como flujo conectado, no como un montón de tareas de limpieza aisladas. El orden importa porque las decisiones tempranas de diseño determinan cuánta confianza podrás conservar después.
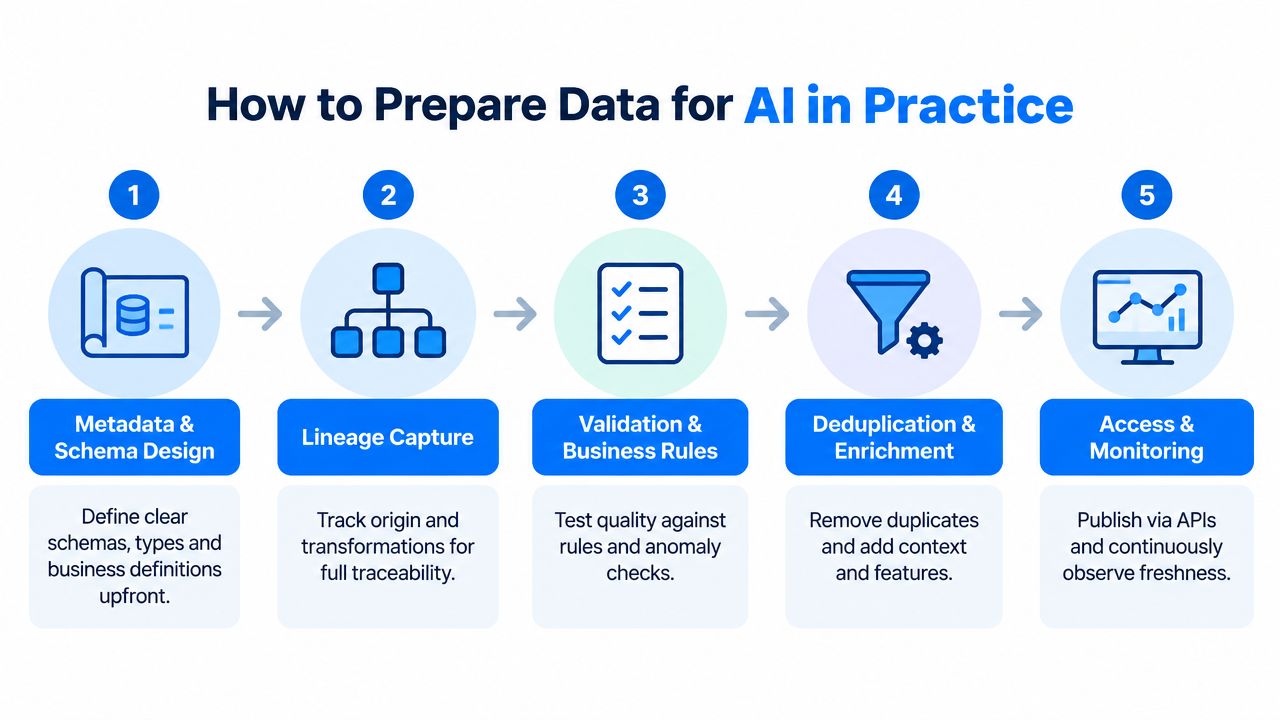
Empieza por esquemas y metadatos
Antes de validar valores, define qué se supone que es el conjunto. Eso significa nombres de campo, tipos, definiciones de negocio, propiedad, uso aprobado y expectativas de actualización. Si un campo cambia de significado sin cambiar de nombre, todos los modelos posteriores operan ya con un riesgo silencioso.
Unos buenos metadatos deberían responder tanto a preguntas humanas como a preguntas de máquina. Una persona debería entender el significado de negocio. Una pipeline debería poder analizar estructura, relaciones y restricciones de uso de forma automática.
Captura el linaje mientras las transformaciones siguen visibles
El linaje es más fácil de registrar en el momento en que los datos se mueven, no meses después durante una auditoría. Sigue de dónde vinieron los datos, qué uniones y filtros los tocaron y qué trabajo o persona los promovió a una capa de servicio para IA.
La forma más rápida de perder la confianza en un modelo es descubrir una salida sospechosa y no tener un camino limpio de vuelta a los registros de origen.
Esto no requiere un programa de gobernanza enorme. Requiere disciplina en el diseño de pipelines, el registro de transformaciones y el alta de conjuntos de datos.
Valida reglas de negocio antes de escalar el entrenamiento
Una vez que existen definiciones y linaje, aplica comprobaciones basadas en reglas. Valida identificadores, impone rangos permitidos, confirma la integridad referencial e inspecciona las etiquetas frente a la verdad de origen cuando sea posible.
Después atiende los problemas que suelen tener un impacto desmedido en los modelos:
Deduplicación: elimina o reconcilia registros que describen la misma entidad de formas contradictorias.
Revisión de ausencias: separa los nulos aceptables de los que señalan un flujo roto.
Verificación de etiquetas: comprueba si los valores objetivo coinciden con el resultado operativo que te importa.
Revisión del equilibrio de clases: mira si categorías importantes están ausentes, son raras o están sesgadas.
Enriquece el conjunto sin ocultar la verdad de origen
El enriquecimiento de características es útil, pero también puede difuminar la procedencia si los equipos no etiquetan con claridad los campos derivados. Mantén separados los campos en bruto, los campos estandarizados y las características construidas. Eso facilita la depuración cuando el comportamiento del modelo se vuelve difícil de explicar.
Publica rutas de acceso y puntos de monitorización
Un conjunto preparado debería ser localizable y consumible. Eso suele significar una tabla estable, una API o una ruta de servicio documentada con propiedad clara.
También significa instrumentar el conjunto antes del despliegue, no tras el primer incidente. Si no puedes observar cambios en Timeliness, estructura o comportamiento de los valores, el conjunto no está listo para IA en producción.
Cómo la observabilidad mantiene los datos listos para IA en ejecución
La preparación lleva un conjunto a la línea de salida. La observabilidad lo mantiene allí.
Esto importa sobre todo en entornos regulados o sensibles a la privacidad, donde los equipos no pueden exportar datos a herramientas de IA externas. La cobertura independiente del sector plantea cada vez más los datos listos para IA como datos localizables, gobernados, seguros y utilizables entre sistemas fragmentados, con la confianza en ejecución volviéndose central para escalar la IA empresarial, en especial en finanzas, sanidad, telecomunicaciones y sector público (IBM sobre datos listos para IA fiables y gobernados).

Cómo se ve la confianza en ejecución
En ejecución ya no preguntas si el conjunto histórico se veía bien durante la preparación. Preguntas si la entrada de hoy sigue coincidiendo con las condiciones bajo las que el modelo o el agente se consideran seguros.
Eso suele requerir varios controles trabajando juntos:
Monitorización de frescura para detectar cargas tardías, ausentes o inesperadamente tempranas
Seguimiento de esquema para detectar cambios estructurales antes de que fallen los sistemas posteriores
Comprobaciones de validación para imponer reglas de negocio sobre registros en vivo
Monitorización de comportamiento para detectar desplazamientos inusuales en distribuciones de valores o patrones de filas
Una plataforma como el software de observabilidad de datos de digna es un ejemplo de este patrón. Se ejecuta dentro del entorno del cliente, calcula comprobaciones dentro de la base de datos y combina detección de anomalías, monitorización de Timeliness, validación y seguimiento de esquema sin que el proveedor acceda a los datos de producción. Ese modelo de despliegue importa cuando los datos no pueden salir de la propia infraestructura de la organización.
Las métricas operativas son concretas
La deriva de esquema no es una preocupación vaga. Un diseño de referencia define un contador de cambios de esquema por tabla, incluidas altas, bajas, renombrados, cambios de tipo y de nulabilidad de columnas, y lo combina con señales estadísticas de deriva como la proporción de nulos y el número de valores distintos para separar el cambio estructural del de distribución (métricas de deriva de esquema y atributos).
La frescura también es medible. Un diseño de observabilidad sigue la latencia de detección de deriva como el tiempo medio entre que ocurre un cambio de esquema y el sistema lo detecta. También sigue la tasa de pérdida de datos y la tasa de fallo de pipelines como porcentajes de registros malformados o perdidos, o de trabajos fallidos (monitorización de la latencia de deriva y señales de calidad de pipelines).
La monitorización asistida por IA reduce el trabajo manual de umbrales
Los umbrales manuales escalan mal en cientos de conjuntos de datos. Bigeye afirma que su detección de anomalías aprende el comportamiento histórico de un conjunto y determina automáticamente umbrales para cada atributo de calidad, usando umbrales de desviación estándar basados en la media histórica para generar alertas sin esfuerzo manual (enfoque de detección de anomalías de Bigeye).
Databricks describe una dirección empresarial similar. Su monitorización analiza automáticamente patrones históricos para detectar anomalías en la frescura y completitud de las tablas, y además vigila tendencias estadísticas y anomalías a lo largo del tiempo en un sistema unificado (monitorización de lakehouse de Databricks).
La limpieza histórica ayuda al entrenamiento. La observabilidad en ejecución decide si las salidas de IA en vivo siguen siendo fiables.
Ese es el giro que muchos equipos están dando ahora. La madurez para IA ya no es solo un hito de preparación de datos. Es una condición de operación.
Conclusión: tu camino hacia datos fiables listos para IA
Los datos listos para IA no son un montón más grande de registros. Son datos aptos para un caso de uso concreto y que siguen siendo fiables cuando los sistemas vivos empiezan a cambiar a su alrededor.
Eso implica que deben encontrarse dos disciplinas. Primero, preparar los conjuntos para que sean exactos, contextualizados, trazables y operables por máquinas. Segundo, mantener ese estado con controles en ejecución que detecten entradas rancias, cambios de esquema, registros ausentes y anomalías de comportamiento antes de que lleguen a un modelo, un agente o un flujo de decisión.
Si estás evaluando tu propio entorno, mantén práctica la primera pasada:
Define el caso de uso con claridad: recuperación, predicción, apoyo a la decisión o acción autónoma
Identifica los campos y etiquetas críticos: sobre todo los ligados al riesgo de negocio
Revisa duplicados, ausencias e integridad de etiquetas: suelen romper la calidad del modelo antes de lo que los equipos esperan
Verifica frescura y estabilidad de esquema: en particular para sistemas en vivo o casi en tiempo real
Exige linaje y metadatos legibles por máquina: para que los equipos puedan confiar y auditar lo que el modelo consume
Prefiere observabilidad dentro del entorno cuando los datos no pueden moverse: especialmente en contextos regulados
El mayor error es tratar la madurez como un proyecto de limpieza puntual. Está más cerca de la ingeniería de fiabilidad. Estableces controles, defines condiciones de operación aceptables y sigues vigilando. Así las entradas en bruto se convierten en IA fiable.
digna ofrece una plataforma empresarial de calidad y observabilidad de datos que ayuda a los equipos a mantener fiables los datos de IA dentro de su propio entorno, con comprobaciones dentro de la base de datos para anomalías, Timeliness, validación y cambios de esquema. Si tus cargas de IA dependen de la confianza en ejecución tanto como de la preparación inicial, visita digna para ver cómo funciona ese modelo operativo en la práctica.
La madurez es un objetivo móvil, no un certificado: la gestión de la calidad de datos es lo que mantiene un conjunto apto para el modelo que ya depende de él.
Preguntas frecuentes
¿Qué significan realmente los datos listos para IA?
La exactitud es solo la primera capa. Los datos están listos para IA cuando además llevan contexto que convierte valores en señal utilizable, y cuando son trazables y operables por máquinas, es decir, cuando un modelo puede consumirlos en producción sin que una persona los ensamble antes. Los datos exactos pero sin contexto siguen atascando un proyecto.
¿Cuáles son los pilares de la madurez para IA?
Seis: calidad y exactitud, completitud y representatividad, Timeliness y frescura, etiquetado e integridad del objetivo, gobernanza y trazabilidad, y operabilidad y acceso. La integridad del etiquetado es la que más se salta, y una columna objetivo corrompida invalida todo lo entrenado sobre ella.
¿Por qué se atascan los proyectos de IA que parecían sanos?
Porque el atasco empieza aguas arriba, no en el modelo. Un proyecto parece bien hasta que toca datos de producción y la confianza tiene que sobrevivir al contacto con sistemas vivos: flujos tardíos, esquemas desviados, muestras poco representativas. El modelo suele ser el último lugar donde se origina el problema.
¿Son más datos la respuesta a la madurez para IA?
No. Más datos no responden a la pregunta correcta. La madurez es aptitud para un caso de uso concreto, así que lo útil es identificar los elementos de datos críticos y ponderar la lista hacia ellos, en vez de ampliar el volumen en campos que ningún modelo consume.
¿Cómo se mantienen los datos listos para IA en ejecución?
La madurez se degrada, así que necesita monitorización y no una certificación puntual. Vigila la frescura frente a la ventana prometida, la estabilidad del esquema, el desplazamiento de distribuciones y la integridad de las etiquetas de forma continua. La monitorización asistida por IA ayuda porque reduce el ajuste manual de umbrales que deja rancias a las reglas estáticas.



