Métricas de Data Observability: El catálogo de referencia
|
7
minuto de lectura

Estás mirando un panel de control que parece normal, pero una tabla ascendente cambió el nombre de una columna ayer por la tarde y nadie se dio cuenta hasta que el informe de ingresos se quedó congelado en el número del lunes. La canalización no falló con estridencias, los gráficos no se rompieron y el modelo siguió produciendo valores NULL. Ese es el tipo de fallo que se supone que deben detectar las métricas de Data Observability, pero solo si tu equipo puede identificar la señal, calcularla de la misma manera y ponerse de acuerdo sobre qué ocurre cuando se cruza una línea.
Los equipos ya tienen fragmentos de la respuesta. Tienen comprobaciones de actualización en una herramienta, alertas de recuento de filas en otra, registros de esquemas en una tercera y algunas reglas internas escritas en las notas de guardia. Lo que no suelen tener es un catálogo de referencia listo para la navegación, un mapa compartido de las propias métricas, cómo se calcula cada una y qué umbral vale la pena para despertar a alguien. Un catálogo claro convierte una monitorización desordenada en algo que la gente puede usar durante un incidente, no solo algo para admirar en una demostración. Para un punto de partida práctico, digna's data observability overview es un ejemplo útil de cómo los equipos abordan el problema en producción.
Tabla de contenidos
Por qué las métricas de Data Observability necesitan un catálogo compartido
El vocabulario compartido evita la dispersión de incidentes
Qué son las métricas de Data Observability
Las métricas son continuas, las comprobaciones son puntuales
Las cinco categorías principales de un vistazo
Actualización, volumen, esquema, distribución y linaje
Métricas de actualización y Timeliness en detalle
Cuatro métricas que hacen que la actualización sea accionable
Establecer la ventana por clase de activo
Puntuaciones de anomalías y medidas de desviación o volatilidad
Tres formas de detectar un comportamiento inusual
Recuentos de cambios de esquema y señales de desviación estructural
Cuatro métricas que hacen visible la estructura
Monitores de KPI de negocio como capa de nivel de decisión
Construir el KPI a partir de los activos subyacentes
Matriz de referencia rápida para el catálogo
Referencias cruzadas entre categorías de métricas
Actualización a volumen, esquema a distribución, linaje a desviación
Elegir el conjunto más pequeño de métricas que importa
Why Data Observability Metrics Need a Shared Catalog
La peor parte de una desviación de esquema silenciosa no es la desviación en sí. Es la media jornada que pierde tu equipo discutiendo sobre cómo llamarla. Un ingeniero dice que la tabla estaba desactualizada, otro dice que la extracción falló y un tercero señala que el resultado del modelo fue incorrecto porque se había cambiado el nombre de una columna de entrada. El panel de control se siguió representando, por lo que el fallo pareció inofensivo hasta que alguien lo usó para tomar una decisión.
Un catálogo cambia esa conversación. En lugar de un montón de comprobaciones sueltas, obtienes métricas de Observability designadas, cada una con una fórmula conocida, un propietario claro y una postura de alerta que se puede revisar a posteriori. Eso importa porque la misma condición se puede describir de tres maneras diferentes si nadie se ha puesto de acuerdo sobre si están hablando de retraso de actualización, conformidad de esquema o pérdida de volumen descendente.
Shared vocabulary prevents incident drift
Cuando un líder de datos, un analista y un ingeniero se refieren a lo mismo con "datos retrasados", dejan de perder el tiempo traduciendo. Un catálogo de métricas les brinda una definición para cada señal, una ruta de cálculo y una regla de escalado. Eso es especialmente útil cuando una tabla se comporta de manera diferente durante el horario laboral que durante la noche, porque la misma palabra puede describir modos de fallo muy diferentes.
Un catálogo también reduce la proliferación de umbrales. Sin él, cada ingeniero de guardia inventa un nuevo límite para cada activo, y el resultado son alertas de guardia inconsistentes, severidad inconsistente y confianza inconsistente. Con él, el equipo puede revisar si una señal pertenece al nivel de advertencia, al nivel de alerta de guardia o al nivel de "monitorizar pero no despertar a nadie".
Regla práctica: si dos personas pueden no estar de acuerdo sobre si el problema es de actualización, volumen o esquema, tu catálogo aún no es lo suficientemente específico.
El valor se vuelve más claro en un incidente real. Un panel de control puede mostrar que los ingresos se mantienen estables a las 9:00 a. m., pero la métrica de actualización puede mostrar que la tabla de pedidos dejó de actualizarse a las 2:14 a. m. Ese es el primer eslabón roto, y es lo que hay que solucionar antes de que nadie discuta sobre los informes descendentes. Para un punto de partida práctico, digna's data observability overview muestra cómo los equipos abordan el problema en producción.
What Data Observability Metrics Are
Las métricas de Data Observability son mediciones de series temporales tomadas de los activos de datos y de las canalizaciones que los mueven. Incluyen recuentos de filas, tasas de nulos, huellas dactilares de esquemas, resúmenes de distribución, brechas de linaje e indicadores derivados como puntuaciones de anomalías o puntuaciones de desviación. En la práctica, son las señales de las que sigues la tendencia a lo largo del tiempo para poder saber cuándo una tabla deja de comportarse como debería.
Un catálogo útil hace que esas señales sean legibles de un vistazo. Una métrica llamada null_rate_email_hourly le dice a un analista mucho más que check_7 porque el nombre ya contiene el tema, la medida y la cadencia. Las convenciones de nomenclatura estructuradas, como el patrón de las etiquetas de datos para la creación de contenido de IA, funcionan de la misma manera: las etiquetas deberían ayudar a las personas a reconocer lo que están mirando antes de abrir la definición.
Metrics are continuous, checks are point-in-time
Una comprobación básica de calidad de datos suele responder a una pregunta de sí o no. ¿Es nula esta columna? ¿Es único este ID? ¿El valor cae dentro del rango? Esas comprobaciones son útiles, pero solo verifican una regla conocida en un momento dado.
Las métricas de Observability funcionan de manera diferente. Se miden de forma continua, se comparan con una línea base para ese activo específico y alertan sobre la desviación en lugar de solo sobre el fallo de la regla. Una comprobación de tasa de nulos en un campo de correo electrónico es una prueba de calidad estática. Una serie de tasa de nulos por hora con una línea base móvil es una métrica de Observability, porque puede revelar un problema lento de extracción ascendente mucho antes de que alguien note campañas rotas.
Esa distinción importa para la forma en que los equipos documentan el catálogo. Cada entrada debe responder a tres cosas, de manera constante y sin conjeturas.
Definición: qué significa la métrica en un lenguaje sencillo.
Método de cálculo: la fórmula o agregación detrás de ella.
Postura de alerta: si advierte, envía una alerta de guardia o solo alimenta el análisis.
Distinción útil: si el equipo solo ejecuta la comprobación cuando alguien sospecha de un problema, es una prueba. Si se sigue la tendencia de la métrica, se establece una línea base y se pueden generar alertas, es Observability.
La forma más clara de pensar en el catálogo es como una capa entre la telemetría sin procesar y la acción humana. Los recuentos y las marcas de tiempo sin procesar se convierten en métricas. Las métricas se convierten en umbrales. Los umbrales se convierten en decisiones de manual de instrucciones.
The Five Core Categories at a Glance
El campo generalmente se organiza en torno a cinco bloques de medición, y cada bloque detecta una clase diferente de fallo. No son taxonomías competidoras, son vistas superpuestas del mismo activo. Un catálogo saludable nombra las cinco para que los equipos no se limiten a la única señal que ya saben recopilar.
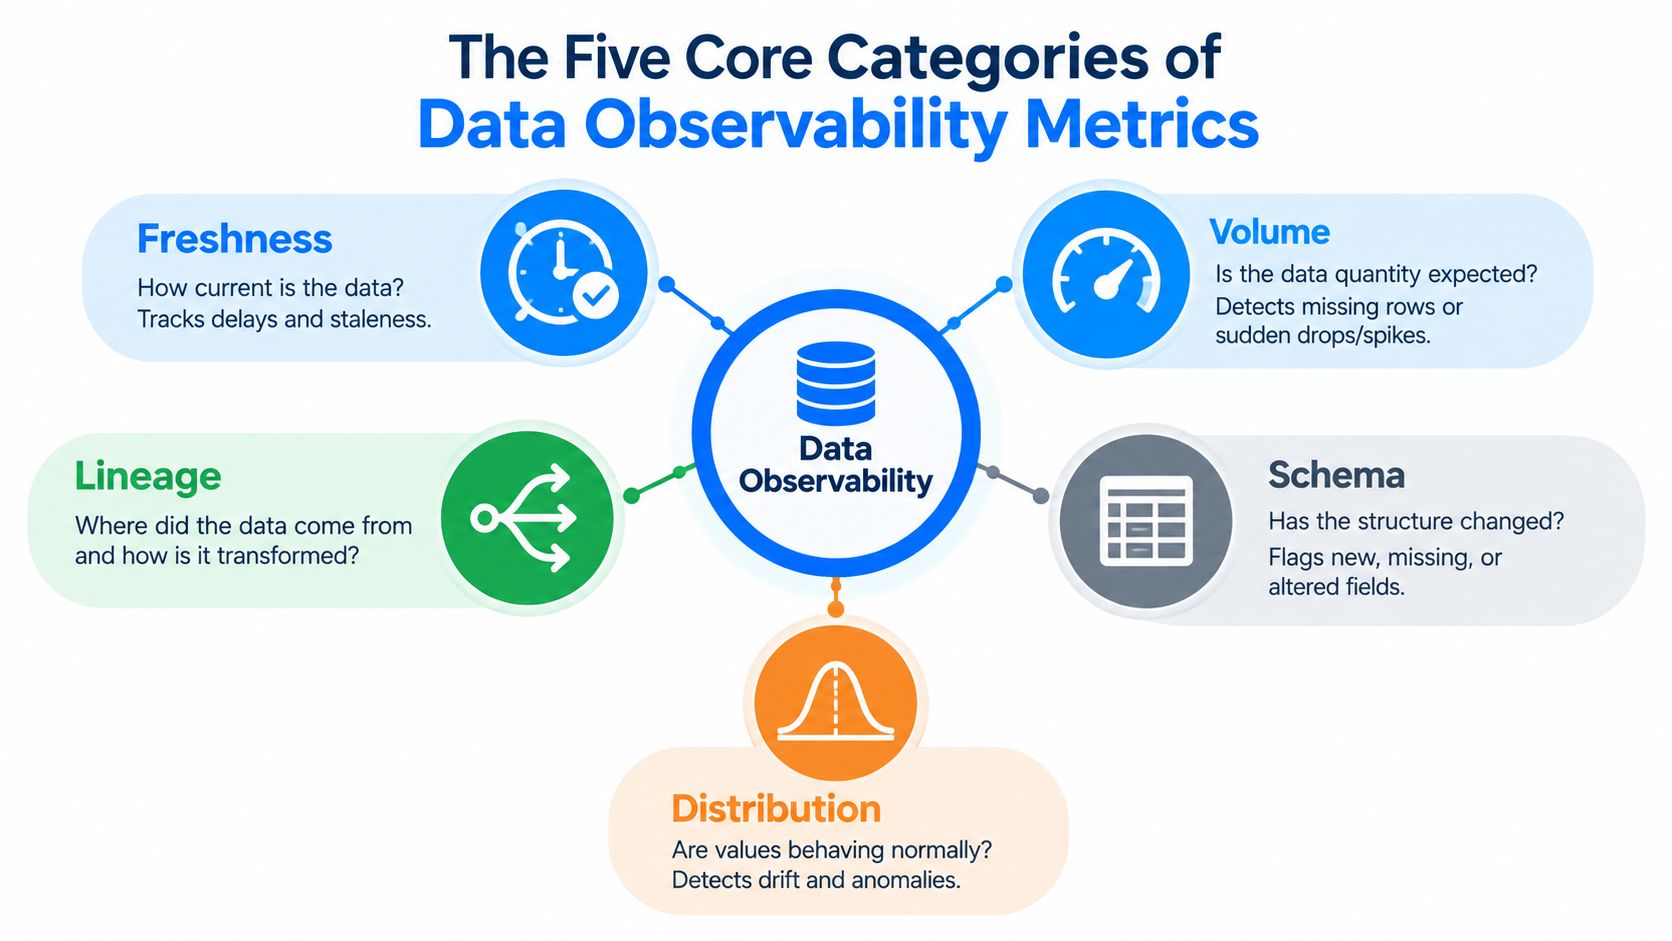
Freshness, volume, schema, distribution, lineage
La actualización (Freshness) pregunta si los datos están lo suficientemente actualizados para el caso de uso del negocio. Detecta particiones que llegan tarde y trabajos de ELT estancados, del tipo que deja un panel de control desactualizado.
El volumen comprueba si la cantidad de registros es aproximadamente la que esperabas. Es la primera línea de defensa contra cargas vacías, cargas truncadas e ingestas duplicadas.
El esquema vigila los cambios estructurales, como nuevas columnas, campos faltantes, campos renombrados y cambios de tipo. Detecta las roturas que hacen que los modelos descendentes comiencen a devolver NULL incluso cuando la tabla todavía se carga.
La distribución analiza el comportamiento del valor, no solo los recuentos. Los cambios en las tasas de nulos, la cardinalidad, los rangos o la forma de los datos a menudo aparecen antes de que un usuario de negocio note la respuesta incorrecta.
El linaje (Lineage) mapea las rutas de dependencia. Te dice qué panel de control, modelo o tabla descendente depende del activo que cambió, y es la categoría que evita que una sola fuente rota se convierta en una hora de búsqueda a ciegas.
La parte útil de agruparlos como bloques es que cada uno tiene una firma de fallo diferente. Un trabajo retrasado a menudo parece primero un problema de actualización y luego de volumen. Una migración de API de un proveedor a menudo se manifiesta como una desviación de esquema y picos de nulos juntos. Una interrupción de la fuente puede propagarse a través del linaje y finalmente aparecer como una desviación de distribución descendente.
Usa el bloque que coincida con el síntoma que puedas medir primero, luego confirma los demás antes de escalar.
Freshness and Timeliness Metrics in Detail
La actualización se trata del retraso, no solo de si se ejecutó un trabajo. Una canalización puede tener éxito y aun así entregar datos demasiado tarde para que importen. Para eventos de productos, canales de pedidos y paneles operativos, el retraso en sí es el incidente.
La forma clara de expresar la actualización es medir la brecha entre la disponibilidad esperada y la disponibilidad real. Eso te da una métrica de la que puedes establecer una línea base, alertar y entregar a la persona propietaria de la canalización. digna's timeliness definition and monitoring notes se adaptan bien a este caso de uso si deseas un ejemplo de plataforma que trate el tiempo de entrega como una señal de primera clase.
Four metrics that make freshness actionable
max_event_lag_seconds es la medida de retraso más simple. Una fórmula práctica es now() - max(event_time), que te dice cuánto se retrasa el evento más reciente con respecto al momento actual.
row_arrival_rate realiza un seguimiento del rendimiento a lo largo del tiempo, generalmente como filas ingeridas por minuto. Una caída repentina puede significar que la fuente dejó de enviar, un filtro se volvió demasiado agresivo o el trabajo ascendente está atascado.
pipeline_completion_lag compara una hora de finalización programada con la hora de finalización real. Captura cuando el trabajo se completa técnicamente, pero no antes de que ya se haya incumplido el SLA.
sla_breach_minutes mide cuánto tiempo permaneció el activo más allá de su presupuesto de actualización. Ese es el número que convierte un retraso técnico en la duración de un incidente.
Métrica | Fórmula | Ejemplo | Advertencia | Alerta de guardia |
|---|---|---|---|---|
max_event_lag_seconds |
| El evento más reciente está por detrás de la hora actual | Al 50 por ciento del SLA | Al 100 por ciento del SLA |
row_arrival_rate |
| La tasa de ingesta cae por debajo de la cadencia esperada | Al 50 por ciento del rendimiento esperado | Al 100 por ciento del rendimiento esperado |
pipeline_completion_lag |
| El trabajo termina después de que se cierra la ventana | Al 50 por ciento del presupuesto de actualización | Al 100 por ciento del presupuesto |
sla_breach_minutes | Tiempo por encima del presupuesto de actualización | El activo se retrasa más allá de la ventana del SLA | Al 50 por ciento del retraso permitido | Al 100 por ciento y escalar al 200 por ciento |
Set the window by asset class
Usa diferentes presupuestos de actualización para diferentes productos de datos. Los eventos de productos generalmente necesitan ventanas de menos de un minuto. Los mercados transaccionales a menudo toleran unos 5 minutos. Los agregados nocturnos a menudo se sitúan en el rango de 15 a 60 minutos. Los extractos de Compliance se pueden medir en ventanas de 24 horas cuando el proceso de negocio lo permite.
Es por eso que los límites globales son un mal hábito. Un único umbral de actualización no puede servir a un flujo de clics de alta frecuencia y a una tabla de liquidación diaria sin crear ruido en alguna parte. Las alertas escalonadas son más estables: advertir al 50 por ciento del SLA, enviar alerta de guardia al 100 por ciento y escalar al 200 por ciento si el activo sigue retrasado.
Regla operativa: escribe el SLA junto al nombre de la métrica. Si el presupuesto de actualización no es obvio en el manual de instrucciones, la alerta no será accionable.
Anomaly Scores and Drift or Volatility Measures
No todos los conjuntos de datos rotos están retrasados o faltan. A veces, los datos llegan a tiempo y, aun así, se comportan de una manera que no tiene sentido. Ahí es donde las puntuaciones de anomalías y las medidas de desviación demuestran su valor, porque convierten el "esto parece extraño" en una señal que puedes comparar con el historial.
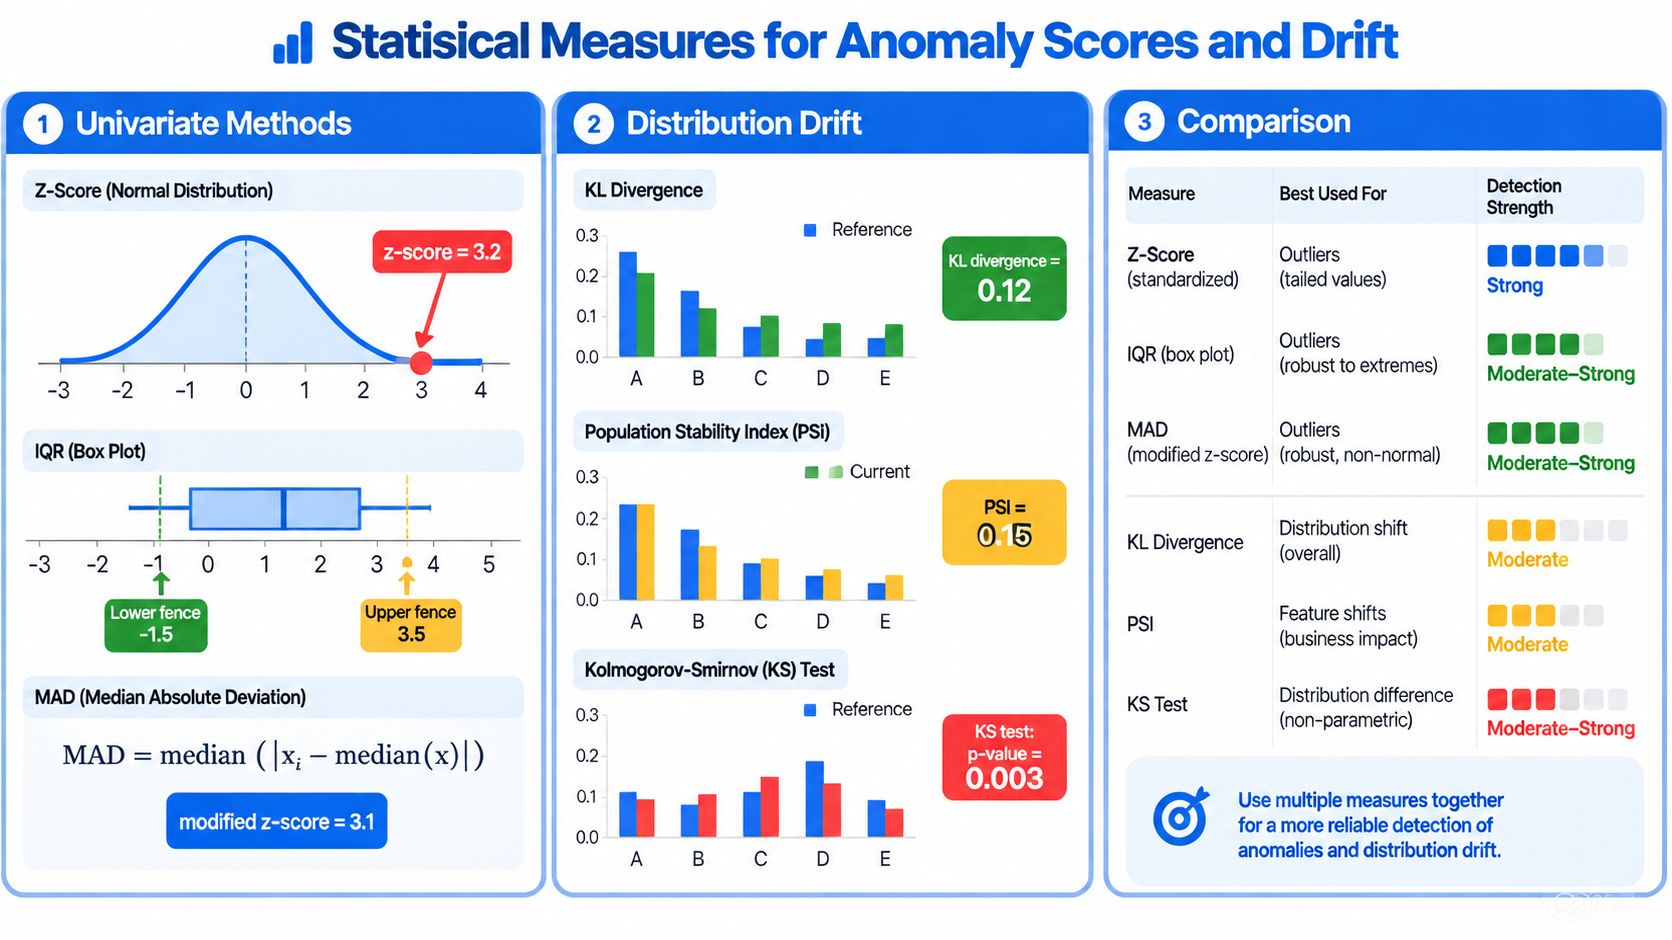
Three ways to detect unusual behavior
Los métodos univariados analizan una métrica a la vez. Una puntuación z indica qué tan lejos se encuentra el valor de hoy de la media en desviaciones estándar. Una puntuación z modificada utiliza la mediana y la MAD (desviación absoluta de la mediana), lo que ayuda cuando los datos tienen valores atípicos. Los límites de rango intercuartílico (IQR) también son sencillos, porque marcan los valores que van más allá de la dispersión media de la distribución.
Los métodos basados en la distribución comparan la forma de una muestra con otra. La divergencia KL, el PSI y la prueba KS son opciones comunes cuando se desea saber si el histograma de una columna ha cambiado de manera significativa.
Las líneas base conscientes del tiempo manejan la estacionalidad. Una métrica diaria puede parecer alarmante si comparas el lunes por la mañana con el domingo por la noche, por lo que las líneas base móviles por día de la semana, hora del día o calendario de negocios suelen ser más seguras que un único umbral fijo.
Para un ejemplo concreto, toma daily_active_users. Si calculas una media móvil de 14 días y la desviación estándar, el volumen de hoy se puede comparar con esa línea base móvil. Se puede activar una alerta simple cuando el valor se eleva por sobre 3 sigma o cae por debajo de la línea base del percentil 10. Esa configuración de doble cara importa porque tanto los picos como las caídas pueden romper los supuestos descendentes.
El mayor error aquí es utilizar umbrales unidireccionales para datos estacionales. Una serie de tráfico minorista, un lote de liquidación y un flujo de inicio de sesión de una aplicación B2B no comparten la misma forma, por lo que una regla universal tiende a crear fatiga por alertas en lugar de claridad. El costo de demasiados falsos positivos es real, porque los equipos de guardia dejan de confiar en las alertas que se suponía que debían protegerlos.
The data drift detection guidance es un compañero útil si deseas ver cómo se traduce el monitoreo de desviación en patrones de producción. La idea clave es la misma: medir la desviación de la línea base correcta, no de una idea abstracta de lo normal.
Schema Change Counts and Structural Drift Signals
La desviación del esquema se vuelve manejable una vez que dejas de tratarla como un problema vago de compatibilidad y comienzas a medirla. Un campo renombrado, un cambio de tipo o una columna eliminada es más fácil de enrutar cuando la alerta nombra el evento estructural exacto y señala al propietario antes del despliegue (Release).
Four metrics that make structure visible
schema_change_count cuenta las adiciones, eliminaciones y cambios de tipo por ejecución de canalización. Si una fuente comienza a agregar columnas cada semana, el recuento mostrará el patrón mucho antes de que se rompa el modelo descendente.
backward_incompatible_change_rate es la proporción de ediciones de esquema que pueden romper a los consumidores existentes. Te dice si el cambio está ocurriendo de una manera segura o peligrosa.
drift_detection_latency_minutes mide el tiempo desde una confirmación (commit) o Release ascendente hasta la alerta. Si no sabes cuánto tiempo se tarda en notar la desviación, realmente no sabes qué tan expuestos están tus consumidores.
orphaned_column_rate realiza un seguimiento de los campos que ya no lee ningún modelo o panel de control descendente. Esas columnas suelen ser un signo de dependencias obsoletas, lógica olvidada o un contrato que ya nadie mantiene.
Métrica de desviación | Definición | Cálculo | Ejemplo | Propietario |
|---|---|---|---|---|
schema_change_count | Recuento de ediciones estructurales por ejecución | Adiciones + eliminaciones + cambios de tipo | Aparece una columna renombrada en la carga | Ingeniero de plataforma de datos |
backward_incompatible_change_rate | Proporción de ediciones que pueden romper a los consumidores | Cambios incompatibles / cambios totales | Un cambio de tipo trunca los valores descendentes | Propietario del código |
drift_detection_latency_minutes | Tiempo desde el commit hasta la alerta | Hora de alerta menos hora de cambio | Una migración se nota solo después de que falla un panel de control | Propietario de la canalización |
orphaned_column_rate | Campos no utilizados por los consumidores descendentes | Columnas no leídas / columnas totales | Un campo permanece en la tabla pero nada lo lee | Ingeniero de analítica |
Las líneas base por tabla importan aquí. Una tabla de eventos de alta velocidad no debe juzgarse con la misma medida que una tabla de referencia que cambia lentamente, porque una de ellas siempre parecerá ruidosa si las fuerzas a entrar en la misma regla. Enruta los cambios que provocan roturas al propietario del código antes de implementarlos, no después de que el panel de control ya falle.
Business KPI Monitors as a Decision Grade Layer
Las métricas de Observability sin procesar te dicen qué se rompió. Los monitores de KPI de negocio le dicen al liderazgo qué significa. Esa capa se sitúa por encima de la actualización, el volumen, el esquema, la distribución y el linaje, y conecta esas señales con resultados como la precisión de los ingresos, el comportamiento de los reembolsos, la pérdida de clientes y el cumplimiento de pedidos.

Build the KPI from the underlying assets
Un monitor de nivel de decisión comienza con una métrica de negocio confiable y luego rastrea esa métrica hasta sus activos de datos contribuyentes. Una vez que conoces las dependencias, puedes adjuntar métricas de Observability a cada activo y permitir que el KPI agregado herede esas señales. Si los ingresos por pago cambian, no te limitas a mirar el gráfico de ingresos. Compruebas la actualización de los eventos de pedidos, las anomalías de volumen de los artículos de línea y la estabilidad del esquema del catálogo de productos de forma conjunta.
Esa es la diferencia entre un panel de control de vanidad y un monitor de negocio real. Un gráfico de vanidad puede permanecer en verde incluso cuando una de las entradas falta o está mal formada. Un monitor de nivel de decisión busca la ruta de fallo debajo del KPI y enruta el problema al equipo propietario del proceso de negocio.
Un buen modelo de propiedad es sencillo. Finanzas u operaciones deben ser propietarios de la definición del KPI, el equipo de plataforma de datos debe ser propietario de las señales de Observability sin procesar y la ingeniería de analítica debe mantener el mapa de dependencias. Eso evita que la alerta rebote entre equipos que solo poseen una parte del problema.
digna es una plataforma que combina el monitoreo de negocio con la medición de timeliness, la detección de anomalías, la validación y el seguimiento de esquemas dentro del propio entorno del cliente. El punto importante no es la marca, es el patrón, porque el KPI solo se vuelve accionable cuando las señales subyacentes son visibles y están vinculadas a un propietario claro.
Los monitores de KPI deben ser pocos, porque cada uno necesita tener asociada una decisión humana.
Quick Reference Matrix for the Catalog
Un catálogo de referencia debería caber en una sola pantalla cuando alguien está escaneando un ticket de incidente. El objetivo no es mostrar cada métrica posible, sino ayudar a un líder a responder una pregunta rápidamente: ¿sobre qué debería alertar para este activo?
La siguiente matriz comprime las categorías comunes en una sola vista de trabajo. Los umbrales son puntos de partida, no verdades universales, y deben ajustarse por activo después de establecer una línea base del comportamiento real.
Categoría de métrica | Cálculo primario | Umbral de alerta recomendado | Propietario típico | Nivel de gravedad |
|---|---|---|---|---|
Actualización |
| Incumplimiento absoluto del SLA en minutos | Ingeniero de plataforma de datos | Alto |
Anomalía de volumen | Media móvil y desviación estándar, o puntuación z | Desviación basada en la distribución con respecto a la línea base | Ingeniero de analítica | Medio a Alto |
Recuento de cambios de esquema | Recuento de adiciones, eliminaciones y cambios de tipo por ejecución | Recuento absoluto de cambios que provocan roturas | Propietario del código | Alto |
Desviación de distribución | PSI, prueba KS o cambio de histograma | Cambio relativo con respecto a la distribución de línea base | Líder de calidad de datos | Medio |
Ruptura de linaje | Dependencia ascendente o descendente faltante | Ruptura absoluta en el gráfico de dependencias | Ingeniero de plataforma | Alto |
Tasa de nulos | Nulos divididos por el total de registros | Aumento relativo sobre la línea base | Ingeniero de analítica | Medio |
Unicidad | Recuento de distintos dividido por el recuento de filas | Caída absoluta o relativa en la unicidad | Administrador de datos | Medio |
Monitor de KPI de negocio | KPI derivado de múltiples señales | Desviación de la banda de tolerancia comercial | Propietario del negocio | Crítico |
Si deseas una tabla de plataforma que refleje este tipo de pensamiento de catálogo, digna's metrics system table muestra cómo se pueden organizar las familias de métricas para su uso operativo. La mejor matriz es la que tu equipo puede mantener durante un incidente, no la que tiene más filas.
Cross-References Between Metric Categories
Una canalización retrasada a menudo comienza con una falta de actualización y luego se manifiesta como una anomalía de volumen porque llegaron menos filas de las que indica la línea base. Trata ese par como una única ruta de incidente, no como dos alertas no relacionadas.

Freshness-to-volume, schema-to-distribution, lineage-to-drift
Un cambio de esquema y un pico en la tasa de nulos a menudo llegan juntos después de una migración de API de un proveedor. Un solo cambio en la carga útil puede crear tanto un problema de campo faltante como un problema de forma de valor, por lo que una alerta de esquema debe verificarse con el monitor de distribución antes de cerrar el ticket.
Las rupturas de linaje también pueden activar alertas de desviación descendente cuando una fuente faltante cambia cada tabla dependiente. Las líneas base por activo mantienen la comparación honesta, porque una tabla de liquidación diaria y un flujo de eventos de alta frecuencia pueden estar saludables y, al mismo tiempo, comportarse de manera muy diferente.
Codifica estos tres emparejamientos como comprobaciones de seguimiento en tu herramienta de alertas para que la segunda señal se consulte automáticamente cuando se active la primera.
Choosing the Smallest Set of Metrics That Matters
Un conjunto de métricas solo ayuda cuando cambia una decisión. Si una alerta no señala a un propietario o una solución probable, se convierte en ruido.
Comienza con un SLA de actualización para cada nivel crítico, una puntuación de anomalía en los volúmenes vinculados a los ingresos, recuentos de cambios de esquema en las tablas que pueden romper a los consumidores descendentes y un monitor de KPI por cada proceso de negocio principal. Para una plataforma de pagos, ese conjunto inicial podría ser un SLA de actualización en la tabla de transacciones, una puntuación de anomalía de 3 sigma en el volumen de liquidación diario, recuentos de cambios de esquema en la tabla de clientes y un monitor de KPI en la tasa de reembolso.
Elige las métricas por propiedad, historial de incidentes y radio de impacto. Revisa la lista cada trimestre, porque los activos cambian, los modos de fallo cambian y el catálogo debe cambiar con ellos.
Preguntas frecuentes
¿Qué son las métricas de observabilidad de datos?
Mediciones de series temporales tomadas de los activos de datos y de las canalizaciones que los mueven. Un nombre como null_rate_email_hourly dice mucho más a un analista que check_7, porque ya lleva el sujeto, la medida y la cadencia antes de abrir la definición.
¿En qué se diferencian de las comprobaciones de calidad?
Una comprobación responde una pregunta de sí o no en un instante; una métrica se trenda, se le fija una línea base y se puede alertar sobre ella. La prueba útil es sencilla: si el equipo solo la ejecuta cuando alguien sospecha un problema, es un test y no observabilidad.
¿Cuáles son las cinco categorías de métricas?
Frescura, volumen, esquema, distribución y linaje. Cada una tiene su firma de fallo: la frescura trata del retardo y no de si un trabajo se ejecutó, el volumen comprueba si el número de registros se parece al esperado y la distribución observa el comportamiento de los valores más que los recuentos.
¿Por qué necesita un equipo un catálogo de métricas compartido?
Para frenar la deriva en los incidentes. Cuando el responsable de datos, el analista y el ingeniero entienden lo mismo por «datos tardíos», dejan de traducir y empiezan a arreglar. Si dos personas pueden discrepar sobre si el problema es de frescura, volumen o esquema, el catálogo aún no es bastante específico.
¿Qué debe documentar cada entrada del catálogo?
Tres cosas: la definición en lenguaje claro, el método de cálculo que hay detrás y la postura de alertado, es decir si la métrica avisa, despierta a alguien o solo alimenta el análisis. Ese último campo es lo que evita que un catálogo se convierta en ruido indiferenciado.



