Clases de datos: guía práctica para equipos modernos
|
7
minuto de lectura

El consejo habitual es clasificar los datos una sola vez, asignarles etiquetas como público o confidencial y dar por resuelto el problema de gobernanza. Ese enfoque confunde la descripción con el control. Una etiqueta que no modifica el acceso, la validación, la retención, la monitorización ni la respuesta ante incidencias es documentación, no gobernanza.
Un marco útil de clases de datos debe describir qué contiene un activo, cómo se comporta y qué debe hacer la organización cuando cambia su riesgo. Eso implica combinar el tipo analítico, el significado estadístico, la representación, el contexto de negocio y el impacto en la seguridad. El trabajo difícil empieza después de publicar la taxonomía, porque los equipos deben vincular cada clase con controles que funcionen en bases de datos, pipelines, almacenes de datos, data lakes y repositorios de documentos reales.
Índice
El riesgo oculto de las etiquetas de datos estáticas
Muchos programas de clasificación fracasan sin hacer saltar ninguna alarma: un equipo de gobernanza crea una política, los responsables etiquetan los conjuntos de datos importantes y los auditores reciben una exportación del catálogo, mientras los permisos siguen igual. La monitorización sigue tratando todas las tablas por igual, y los equipos de respuesta ante incidencias no disponen de una señal fiable cuando un conjunto de datos operativo corriente se convierte en un activo de mayor riesgo.
Categorías como público, interno, confidencial y regulado siguen ofreciendo un vocabulario común útil. El fallo empieza cuando los equipos suponen que ese vocabulario hace cumplir algo por sí mismo. Una etiqueta estática no enmascara un campo, no acorta la retención, no aumenta la frecuencia de validación ni escala una alerta.
La brecha entre clasificar y aplicar controles
La evidencia apunta a una brecha operativa medible. El 55 % de las organizaciones encuestadas no había logrado una clasificación automatizada en todos sus sistemas principales, y solo el 47 % tenía una clasificación que aplicaba controles posteriores en lugar de limitarse a asignar etiquetas, según el Kiteworks 2026 Data Security and Compliance Risk Report.
Esas cifras separan dos resultados que los equipos suelen mezclar. La precisión de la clasificación pregunta si la clase asignada es correcta. La eficacia de la clasificación pregunta si esa clase cambia el comportamiento de los sistemas que almacenan, procesan, monitorizan y protegen los datos.
Un equipo puede identificar correctamente una tabla de clientes como confidencial y, aun así, mantener un acceso amplio para los analistas. Puede etiquetar un informe regulatorio como de alta integridad y luego permitir que un cambio de esquema sin revisar altere sus datos de entrada. Puede clasificar un pipeline como de alta disponibilidad y monitorizar solo si un trabajo ha terminado, no si los datos esperados han llegado a tiempo.
Regla práctica: trate cada clase como el detonante de una decisión de control. Si no cambia ningún control, cuestione si la clase tiene valor operativo.
Por qué añadir categorías rara vez resuelve el problema
Una aplicación débil de los controles suele llevar a los equipos a ampliar la taxonomía. Añaden etiquetas para datos personales, financieros, críticos, restringidos, aprobados para IA, de archivo y para excepciones locales. El resultado parece preciso, pero responsables y herramientas se enfrentan a más ambigüedad sobre qué etiqueta prevalece y qué acción debe seguir.
Un conjunto más reducido de clases fiables vinculadas a acciones explícitas suele funcionar mejor. Cada clase debería responder a preguntas prácticas:
¿Quién puede acceder al activo? Defina la política de acceso y las excepciones permitidas.
¿Qué hay que validar? Especifique los controles de campos, registros, conciliación o reglas de negocio.
¿Con qué rapidez deben aflorar los fallos? Fije la gravedad de las alertas y las expectativas de respuesta.
¿Cómo deben documentarse los cambios? Conserve el linaje, los eventos de auditoría y la responsabilidad.
¿Qué ocurre cuando cambia el contexto? Inicie una revisión en lugar de dejar que la etiqueta antigua se mantenga indefinidamente.
La clase de datos demuestra su valor cuando un proceso automatizado puede detectar una discrepancia entre la etiqueta y el comportamiento actual. Un cambio de esquema, un patrón de entrega inesperado, un nuevo uso posterior o un cambio en el significado de negocio pueden requerir una reclasificación.
Sin ese ciclo de retroalimentación, la taxonomía se queda obsoleta mientras las partes interesadas siguen confiando en ella. La gobernanza produce entonces un catálogo que describe el riesgo de ayer, aunque los permisos, los pipelines y los usos de negocio hayan cambiado. Por eso la clasificación debe conectarse con la monitorización y la respuesta; de lo contrario, sus etiquetas se convierten en un pasivo en lugar de una salvaguarda.
Las tres dimensiones de las clases de datos
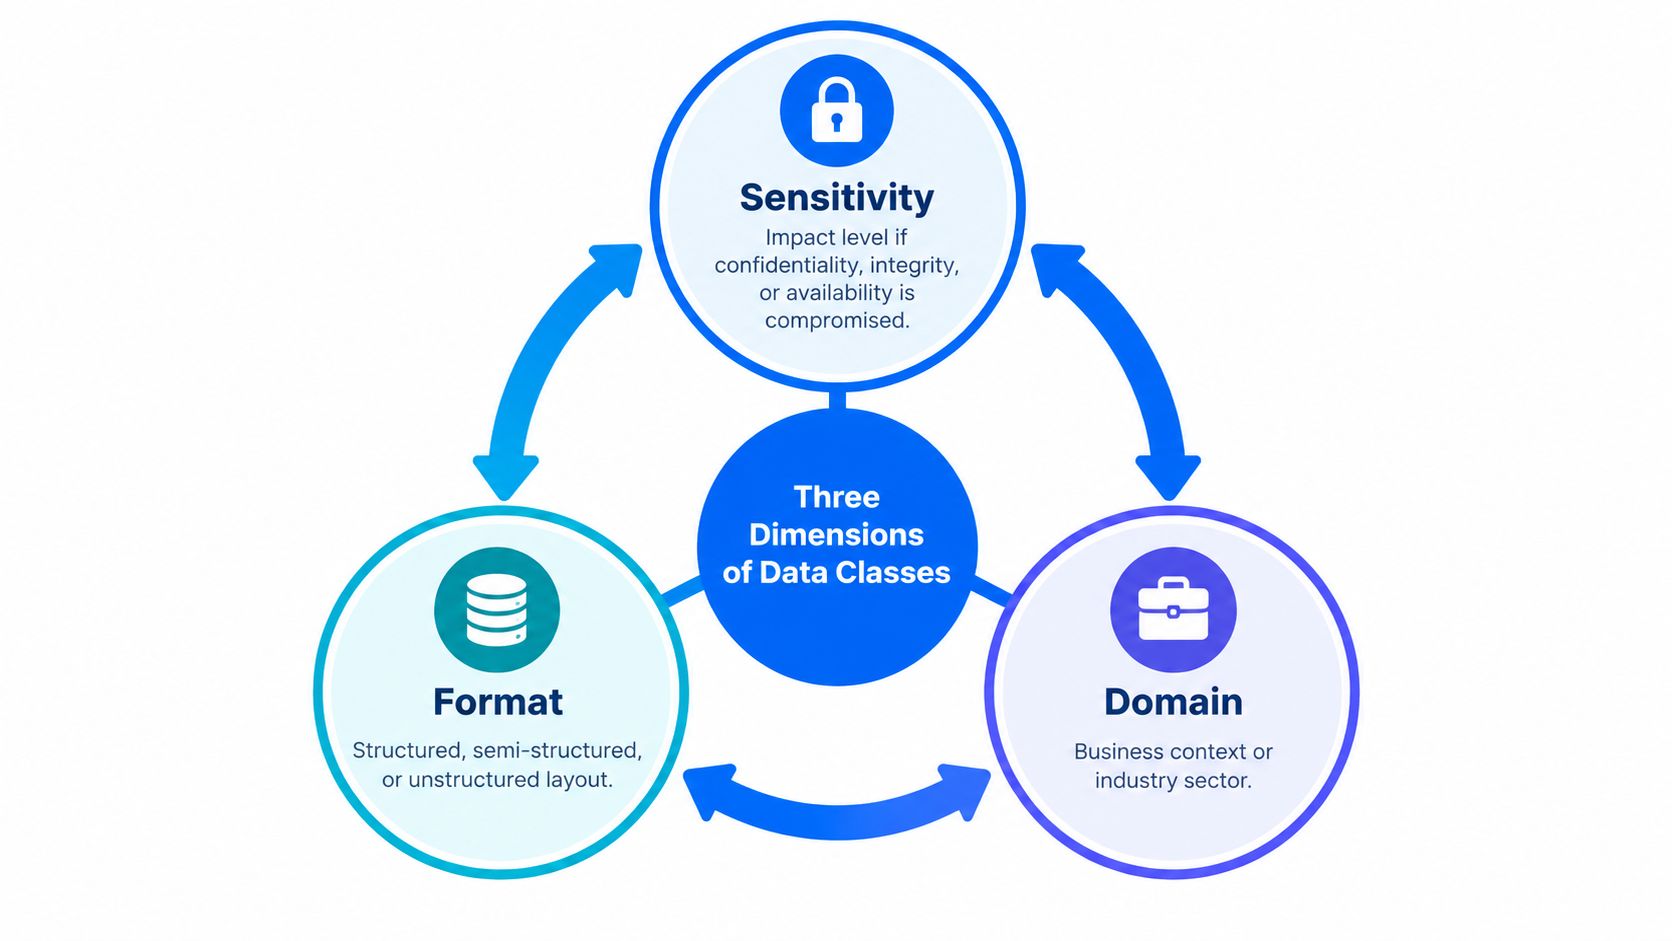
Un sistema de clasificación fiable necesita algo más que una escala de sensibilidad. Debe evaluar conjuntamente la sensibilidad, el formato y el dominio, porque cada dimensión cambia el significado de las demás.
La sensibilidad describe la consecuencia de que el activo se vea comprometido. El formato describe cómo se representa el activo y qué se puede comprobar. El dominio aporta el contexto de negocio, la responsabilidad y las expectativas regulatorias. La clase de un conjunto de datos debe surgir de la interacción entre las tres, no de una única etiqueta elegida de forma aislada.
La sensibilidad cambia la consecuencia
La clasificación de seguridad evalúa cada tipo de información de forma independiente en cuanto a confidencialidad, integridad y disponibilidad. Una clase puede ser baja en una dimensión y alta en otra. Un flujo público de KPI puede no contener información confidencial y, sin embargo, unos valores incorrectos podrían influir en decisiones regulatorias u operativas, lo que da a la integridad una consecuencia alta.
Esa distinción evita un error habitual: tratar “público” como sinónimo de “bajo riesgo”. Los datos públicos pueden seguir necesitando un control de cambios estricto, conciliación, linaje o monitorización de la frescura. A la inversa, los datos privados no tienen por qué necesitar controles idénticos en todas las dimensiones.
El formato cambia la prueba
Una tabla relacional admite controles sobre columnas, tipos de datos, unicidad, relaciones y reglas a nivel de registro. Un flujo de eventos JSON exige atención a las rutas anidadas, los atributos opcionales, las variantes de payload y los errores de parseo. Un repositorio de documentos puede necesitar controles del estado de extracción, de los metadatos y la confirmación de que los archivos almacenados siguen siendo utilizables.
La representación determina qué fallos son visibles. Una prueba genérica de valores ausentes puede pasar aunque haya desaparecido un atributo JSON anidado o aunque un trabajo de ingesta de documentos almacene archivos sin contenido extraíble.
El dominio cambia la decisión
El mismo campo puede requerir controles distintos en contextos distintos. Una marca de tiempo en un flujo sanitario puede determinar la puntualidad clínica. El mismo tipo de campo en un flujo de informes públicos puede servir para los calendarios de publicación y la rendición de cuentas. Los equipos de finanzas, telecomunicaciones, sanidad y sector público asocian consecuencias diferentes a los retrasos, las alteraciones y los registros incompletos.
Por tanto, un modelo práctico registra el responsable de negocio del activo, el caso de uso, la criticidad, el formato y el impacto CIA. Los equipos que quieran profundizar en cómo influyen las dimensiones de la calidad en estas decisiones pueden usar esta guía para entender las dimensiones de la calidad de datos.
El resultado es una clase que indica a los ingenieros no solo qué son los datos, sino cómo deben monitorizarlos.
Cómo aplicar la tríada CIA a la clasificación de datos
La clasificación orientada a la seguridad debe evaluar cada tipo de información de forma independiente en cuanto a confidencialidad, integridad y disponibilidad, asignando un nivel de impacto según el daño que causaría perder cada objetivo. Este principio está documentado en la guía de clasificación de datos empresariales de la Organización de los Estados Americanos.
El error práctico es reducir las tres dimensiones a una única puntuación de sensibilidad. Una sola puntuación oculta el motivo por el que un conjunto de datos importa y dificulta elegir el control adecuado. El principio de máximo nivel (high-watermark) resuelve ese problema: la dimensión CIA con mayores consecuencias determina el requisito global de protección.
La confidencialidad exige controles de exposición
Los datos confidenciales causan daño cuando personas no autorizadas pueden verlos, copiarlos o deducirlos. Los registros de clientes, la información sanitaria, los datos de empleados y el material comercialmente sensible necesitan controles como acceso restringido, enmascaramiento, cifrado y monitorización de la exposición.
La clasificación debe identificar el tipo de información y el uso permitido, no solo el nombre de la tabla. Una tabla llamada customer_summary puede contener valores agregados en un entorno y registros directamente identificables en otro. El control debe seguir al contenido y al contexto reales.
La integridad exige pruebas de exactitud
La integridad tiene que ver con las alteraciones no autorizadas o incorrectas. Los registros financieros, las cifras regulatorias y las métricas para la toma de decisiones pueden ser públicos y, aun así, exigir una protección rigurosa frente a cambios silenciosos.
Eso conduce a un conjunto de controles diferente:
Validación de registros: compruebe los valores frente a las reglas de negocio y las relaciones permitidas.
Conciliación: compare totales relacionados o resultados de origen y destino.
Linaje: conserve el recorrido desde los registros de origen hasta las métricas publicadas.
Evidencia de manipulación: registre los cambios y haga visibles las alteraciones sin explicación.
Así, un flujo de datos público puede recibir un impacto de integridad alto y seguir siendo bajo en confidencialidad. La clase debe transmitir esa distinción a los ingenieros de datos y a los equipos de respuesta ante incidencias.
La disponibilidad exige vigilar la entrega
La disponibilidad consiste en poder acceder a los datos cuando los usuarios y los sistemas los necesitan. Los conjuntos de datos operativos, los flujos y las dependencias de la plataforma pueden fallar por entregas retrasadas, cargas ausentes o caídas, aunque su contenido siga siendo correcto y esté protegido.
Por tanto, la monitorización debe hacer seguimiento de la frescura, la latencia de entrega, los patrones de llegada esperados y las cargas ausentes. Que una tarea del pipeline haya terminado no prueba que hayan llegado datos utilizables. El control debe observar el evento de datos del que realmente dependen los consumidores posteriores.
Una clase basada en la tríada CIA debe corresponderse directamente con la gravedad de las alertas, la frecuencia de validación, la retención y los objetivos de respuesta ante incidencias. También debe poder revisarse. Los usos de negocio cambian, las dependencias crecen y los esquemas evolucionan. Una clasificación que no puede absorber esos cambios se convierte en una suposición desfasada en lugar de una señal de seguridad fiable.
Cómo estructurar la clasificación según el formato de los datos
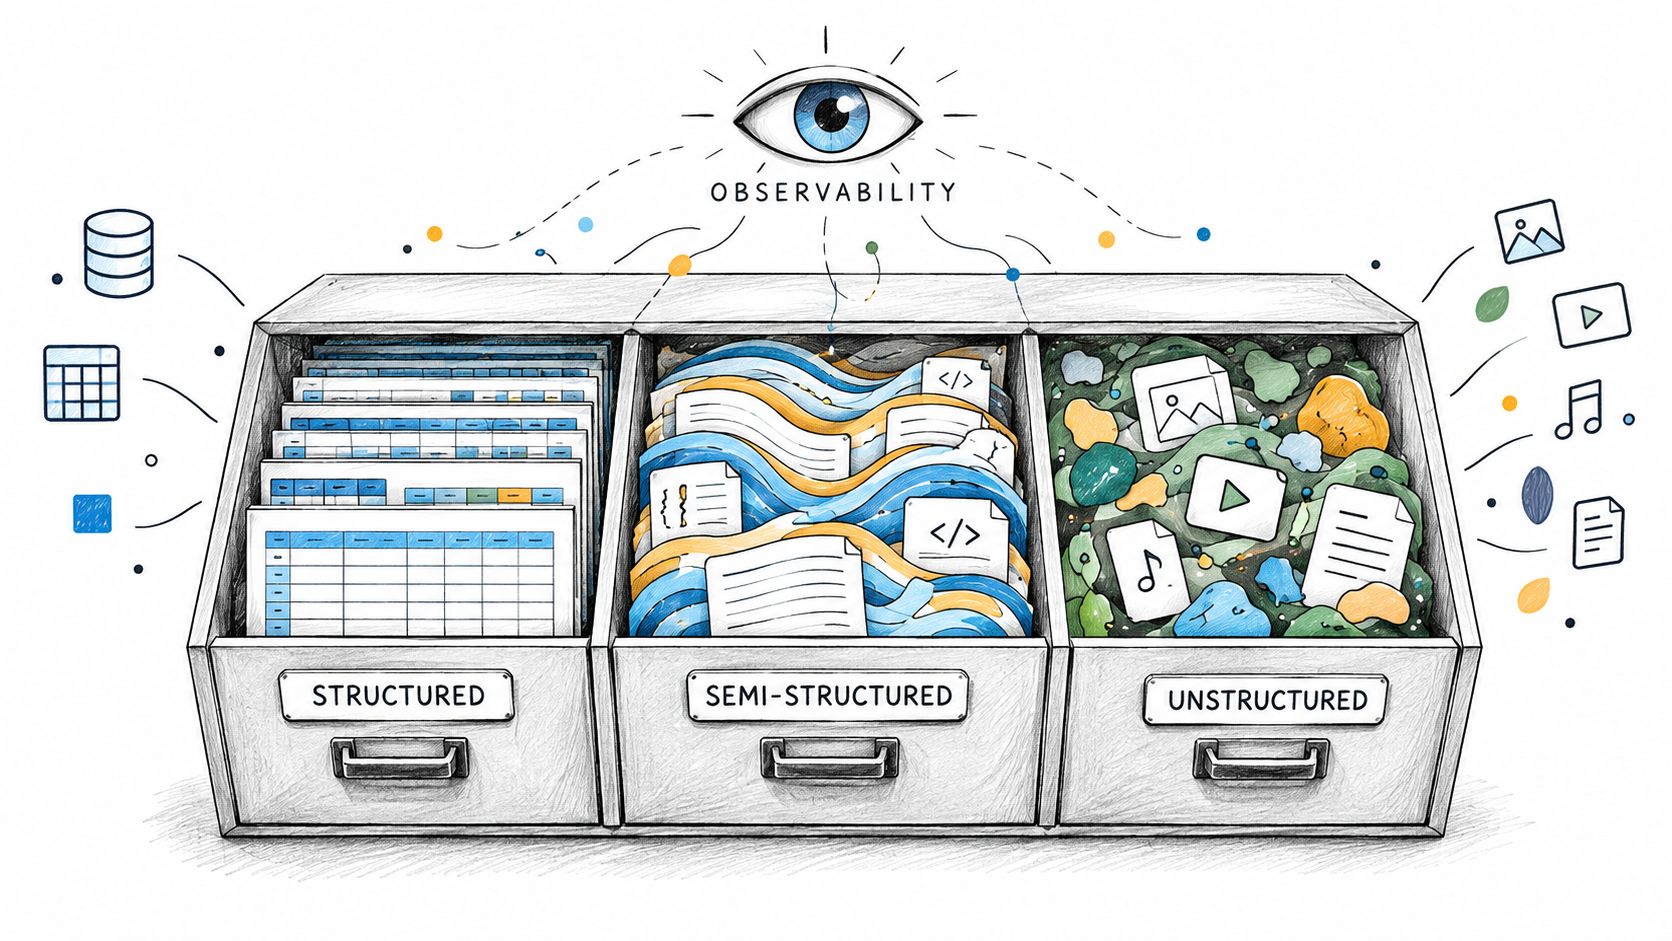
La primera pregunta estructural no es si un conjunto de datos es sensible, sino cómo se representan los datos. Los activos estructurados, semiestructurados y no estructurados presentan modos de fallo distintos, por lo que necesitan controles de observabilidad diferentes. La Comisión Europea señala la calidad, la estructura, la interoperabilidad, la autenticidad y la integridad como condiciones importantes para extraer valor de los datos, sobre todo en contextos de IA, tal como resume su documento sobre gobernanza de datos y políticas de datos.
Activos estructurados
Las tablas estructuradas siguen un modelo definido. Eso las hace adecuadas para controles específicos:
Conformidad con el esquema: detecte columnas ausentes, añadidas o renombradas.
Validación de tipos: confirme que los valores coinciden con la expectativa analítica.
Unicidad: identifique claves duplicadas o repeticiones inesperadas.
Integridad referencial: verifique las relaciones entre tablas.
Reglas de negocio: compruebe condiciones a nivel de registro y combinaciones permitidas.
Aun así, el tipo de almacenamiento no es lo mismo que el significado analítico. Un campo numérico puede codificar una categoría, como un código de estado, en lugar de representar una cantidad medible. Los datos estadísticos suelen dividirse en clases categóricas y cuantitativas, y esa distinción determina si los equipos deben usar recuentos de frecuencia y detección de valores inesperados, o bien distribuciones, medias, percentiles, varianza y análisis de valores atípicos. El glosario de términos estadísticos de la OCDE documenta esta diferencia.
Payloads semiestructurados
Los eventos JSON y payloads similares pueden tener una forma reconocible sin un esquema aplicado de manera coherente. La monitorización debe revisar la presencia de campos anidados, las estructuras variantes, los errores de parseo, los cambios en arrays y la deriva semántica.
Un control de tasa de nulos puede pasar por alto un fallo en el que un productor mueve un valor a otra ruta o cambia su significado manteniendo el campo relleno. Los equipos que trabajan con almacenamiento columnar también deberían conocer el formato de archivo Parquet, incluido cómo afecta su estructura a la validación posterior y al seguimiento del esquema.
Documentos y contenido multimedia no estructurados
Los documentos, las imágenes y otros contenidos multimedia requieren un modelo de control distinto. Que un archivo se suba correctamente no demuestra que la extracción haya funcionado, que los metadatos estén completos ni que el procesamiento posterior pueda interpretar el contenido.
Haga seguimiento del estado de ingesta, la completitud de la extracción, la validez de los metadatos y los resultados del procesamiento del contenido. Clasificar un activo como no estructurado debería seleccionar automáticamente estos controles en lugar de aplicar supuestos propios de las bases de datos relacionales.
Los catálogos más eficaces registran la representación, el rigor del esquema, la responsabilidad, el comportamiento de actualización esperado y la criticidad para los procesos posteriores. El formato no es una nota descriptiva a pie de página. Determina qué señales pueden demostrar que el activo sigue siendo utilizable.
Cómo vincular la clasificación con controles ejecutables
Una vez asignadas las clases, la pregunta es qué hace un sistema en función de cada clase. La tabla relaciona cuatro clases habituales con un control principal y con la evidencia que demuestra que el control se ha activado.
Compare las opciones operativas
Clase de datos | Control principal | Métrica de monitorización |
|---|---|---|
Datos confidenciales de clientes | Restricción de acceso, enmascaramiento y revisión de la exposición | Accesos no autorizados, estado del enmascaramiento y exposición de campos sensibles |
Datos financieros de alta integridad | Validación de registros, conciliación, linaje y evidencia de manipulación | Fallos de reglas, diferencias de conciliación y cambios estructurales |
Datos operativos de alta disponibilidad | Detección de frescura, entrega y caídas | Hora de llegada, cargas ausentes, latencia y disponibilidad |
Métricas públicas pero críticas para la toma de decisiones | Gobernanza de la publicación y validación de la integridad | Deriva de valores, conciliación con la fuente y cambios sin explicación |
Cada fila vincula una etiqueta con una respuesta operativa. Los responsables no tienen que interpretar “crítico” de forma distinta en cada sistema. Pueden identificar el control necesario, asignar la responsabilidad e inspeccionar la evidencia generada cuando ese control funciona o falla.
Una clase solo tiene valor cuando su política llega a los sistemas que la aplican. Los metadatos del catálogo pueden tener que impulsar restricciones de acceso, enmascaramiento, retención, monitorización, enrutamiento de incidencias o revisión de publicaciones. Si esos destinos están desconectados, la etiqueta sigue siendo descriptiva y puede generar una falsa sensación de seguridad.
Mapee las clases en todo el patrimonio de datos
Empiece por los activos de mayor impacto, no por todos los objetos de la organización. Asigne la clase multidimensional, identifique al responsable, defina el destino del control y verifique que la clasificación llega a cada sistema relevante. Compruebe que cada sistema registra evidencias, como un resultado de validación, un evento de acceso, un resultado de conciliación o una alerta, cuando se ejecuta el control.
La guía sobre reglas de validación de datos y calidad de datos continua ayuda a traducir las clases en controles a nivel de registro, reglas de negocio y controles de calidad recurrentes. La opción práctica es definir controles que correspondan al riesgo, no asignar una puntuación de calidad genérica a cada activo.
La responsabilidad debe incluir la reclasificación. Un conjunto de datos puede ganar un nuevo consumidor, cambiar de esquema, pasar de un dominio a otro o entrar en un flujo regulado. Cada uno de estos eventos debería desencadenar una revisión de la clase y una actualización de las políticas posteriores.
Pruebe la cadena con regularidad. Una clasificación que actualiza un catálogo pero no cambia la monitorización, el acceso ni el comportamiento de los flujos de trabajo no es gobernanza. Es una intención sin verificar.
Cómo integrar la observabilidad en la infraestructura
La clasificación se puede hacer cumplir cuando la monitorización se ejecuta cerca de los datos y puede actuar sobre el mismo contexto que definió la clase. Trasladar registros de producción a un servicio de análisis externo puede crear una exposición innecesaria, complicar los requisitos de residencia y separar las decisiones de gobernanza de la evidencia operativa.
Una arquitectura integrada mantiene el análisis dentro de una infraestructura controlada por el cliente. Esto es importante para organizaciones con requisitos estrictos de seguridad, cumplimiento o residencia, incluidos los equipos que operan on-premises o en entornos de nube privada.

Mantenga los controles cerca de la fuente
La ejecución dentro de la base de datos permite a los equipos calcular métricas y ejecutar validaciones sin extraer los datos de producción a un entorno separado alojado por un proveedor. También facilita vincular una clase con las señales que importan:
Comportamiento del esquema: detecte campos añadidos, eliminados o modificados.
Comportamiento de los registros: aplique controles de reglas de negocio a cada registro.
Puntualidad: identifique retrasos, cargas ausentes y patrones de llegada inesperados.
Métricas de negocio: monitorice el comportamiento de las medidas críticas.
Estado de la plataforma: observe la carga de trabajo, la disponibilidad y los cambios operativos.
Este es el papel arquitectónico que se describe para la plataforma de observabilidad de datos de digna, diseñada para funcionar dentro del propio entorno de la organización. La documentación de digna describe una plataforma de calidad y observabilidad de datos basada en IA que admite despliegues on-premises y en nube privada, mantiene la monitorización dentro de una infraestructura controlada por el cliente y reduce la necesidad de extraer datos de producción a un servicio externo.
Use el comportamiento aprendido donde los umbrales se vuelven frágiles
Los umbrales manuales son útiles para límites de negocio estrictos, pero se vuelven difíciles de mantener cuando cada conjunto de datos tiene una volatilidad, una estacionalidad, unos tiempos de entrega o un comportamiento operativo distintos. Una línea base basada en IA puede aprender el comportamiento normal de cada conjunto de datos e identificar cambios inesperados sin que los equipos tengan que configurar un umbral para cada métrica.
El análisis histórico aporta el contexto que falta. Los ingenieros pueden examinar tendencias, volatilidad y patrones estadísticos para distinguir una desviación puntual de un problema en desarrollo. Esa distinción mejora el triaje de incidencias y evita que los equipos traten cada alerta como un fallo aislado.
La decisión de diseño importante no es “IA frente a reglas”. Una gobernanza fiable usa validación determinista para los requisitos explícitos y detección de comportamientos para los patrones difíciles de codificar manualmente. La clase determina qué combinación es la adecuada, mientras que la infraestructura determina si la evidencia sigue siendo segura, puntual y utilizable.
Cómo construir un marco de clasificación operativo
Un marco práctico empieza con un inventario acotado de activos críticos. Seleccione los conjuntos de datos que respaldan informes importantes, trabajo regulatorio, operaciones con clientes, procesos clínicos, servicios de telecomunicaciones o decisiones del sector público. No empiece intentando clasificar cada archivo y cada tabla con la misma precisión.
Asigne a cada activo seleccionado un registro multidimensional:
Describa la sensibilidad: registre por separado el impacto en confidencialidad, integridad y disponibilidad.
Describa el formato: identifique si la representación es estructurada, semiestructurada o no estructurada y cómo se comporta su esquema.
Describa el dominio: recoja el responsable de negocio, la finalidad, el contexto regulatorio y las dependencias posteriores.
Asigne los controles: relacione la clase con los requisitos de acceso, validación, frescura, esquema, retención y respuesta.
Verifique la ejecución: confirme que los sistemas de monitorización y de políticas han aplicado los controles esperados.
Revise los cambios: vuelva a evaluar la clase cuando cambien el comportamiento, el esquema, la responsabilidad o el uso de negocio.
El registro de clasificación debe ser útil tanto para los equipos de gobernanza como para los de ingeniería. Un responsable de seguridad necesita conocer la consecuencia de una exposición. Un ingeniero de datos necesita saber qué pruebas deben ejecutarse. Un equipo de respuesta ante incidencias necesita saber con qué rapidez debe escalarse el problema y qué evidencia debe recopilar.
Una clase solo está vigente cuando sus controles siguen correspondiendo a la forma en que se usan los datos.
Este modelo operativo también respalda las decisiones sobre soberanía de datos. A los equipos que evalúan requisitos de residencia y gobernanza les puede resultar útil el artículo sobre cómo cumplir la normativa de datos con Stoa al analizar cómo interactúan las obligaciones legales, la ubicación de la infraestructura y las prácticas de tratamiento de datos.
Revise la clasificación frente al comportamiento observado en lugar de confiar en un trámite anual. Un conjunto de datos puede seguir siendo confidencial mientras sus requisitos de integridad aumentan tras convertirse en una entrada regulatoria. Una tabla estructurada puede incorporar payloads semiestructurados a través de una nueva vía de ingesta. Un flujo de baja disponibilidad puede volverse crítico a nivel operativo cuando un proceso de negocio empieza a depender de él.
La guía de digna para implementar la gobernanza de datos puede ayudar a los equipos a conectar la responsabilidad, los controles de calidad, la monitorización y los flujos de gobernanza. El objetivo no es tener la taxonomía más grande, sino un conjunto de clases que cambie de forma coherente lo que los sistemas miden, protegen, conservan y escalan.
digna ayuda a los equipos a convertir una clase de datos en controles ejecutables mediante validación dentro de la base de datos, seguimiento del esquema, monitorización de la puntualidad, monitorización de negocio y detección de anomalías basada en IA en entornos de nube privada u on-premises. Visite digna para ver cómo su equipo puede monitorizar datos críticos sin trasladar registros de producción a un servicio externo.
La clasificación también decide dónde pueden almacenarse y procesarse los datos. Nuestra guía sobre requisitos de residencia de datos explica cómo interactúan las normas de ubicación con las clases que asigna y los controles que estas activan.
Preguntas frecuentes
¿Qué es una clase de datos?
Una clase de datos es la categoría a la que pertenece un activo según su sensibilidad, su formato y su dominio de negocio. Una clase útil hace algo más que describir los datos: decide qué controles de acceso, validación, retención y monitorización se aplican, de modo que una etiqueta que no cambia nada en los procesos posteriores es documentación y no gobernanza.
¿Cuáles son las tres dimensiones de la clasificación de datos?
Sensibilidad, formato y dominio. La sensibilidad describe la consecuencia si los datos se ven comprometidos, el formato describe cómo se representan y, por tanto, qué se puede comprobar, y el dominio aporta el contexto de negocio, la responsabilidad y las expectativas regulatorias. Evaluar las tres a la vez da una clase más fiable que una simple escala de sensibilidad.
¿Cómo se aplica la tríada CIA a la clasificación de datos?
Cada tipo de información se valora por separado en confidencialidad, integridad y disponibilidad, según el daño que causaría perder cada una. Un flujo público de KPI puede no necesitar controles de confidencialidad y, aun así, exigir controles de integridad estrictos, porque unos valores incorrectos podrían influir en decisiones regulatorias u operativas. Reducir las tres a una sola puntuación oculta esa diferencia.
¿Por qué fracasan los programas de clasificación de datos?
La mayoría fracasa en silencio porque las etiquetas nunca cambian los controles. Los responsables etiquetan los conjuntos de datos y los auditores reciben una exportación del catálogo, pero los permisos y la monitorización siguen igual. Un informe de 2026 citado concluyó que solo el 47 % de las organizaciones tenía una clasificación que aplicaba controles posteriores, y añadir más categorías suele aumentar la ambigüedad en lugar de mejorar la aplicación.
¿Cómo deben monitorizarse de forma diferente los datos estructurados y los no estructurados?
Las tablas estructuradas se prestan a controles de esquema, tipo, unicidad, integridad referencial y reglas de negocio. El JSON semiestructurado necesita monitorizar rutas anidadas, variantes y errores de parseo, porque los valores pueden cambiar de lugar sin quedar nulos. Los documentos y el contenido multimedia no estructurados necesitan controles de ingesta, completitud de la extracción y metadatos, ya que una subida correcta no demuestra que el contenido sea utilizable.


