Proceso de monitorización de KPI: guía completa paso a paso
|
6
minuto de lectura

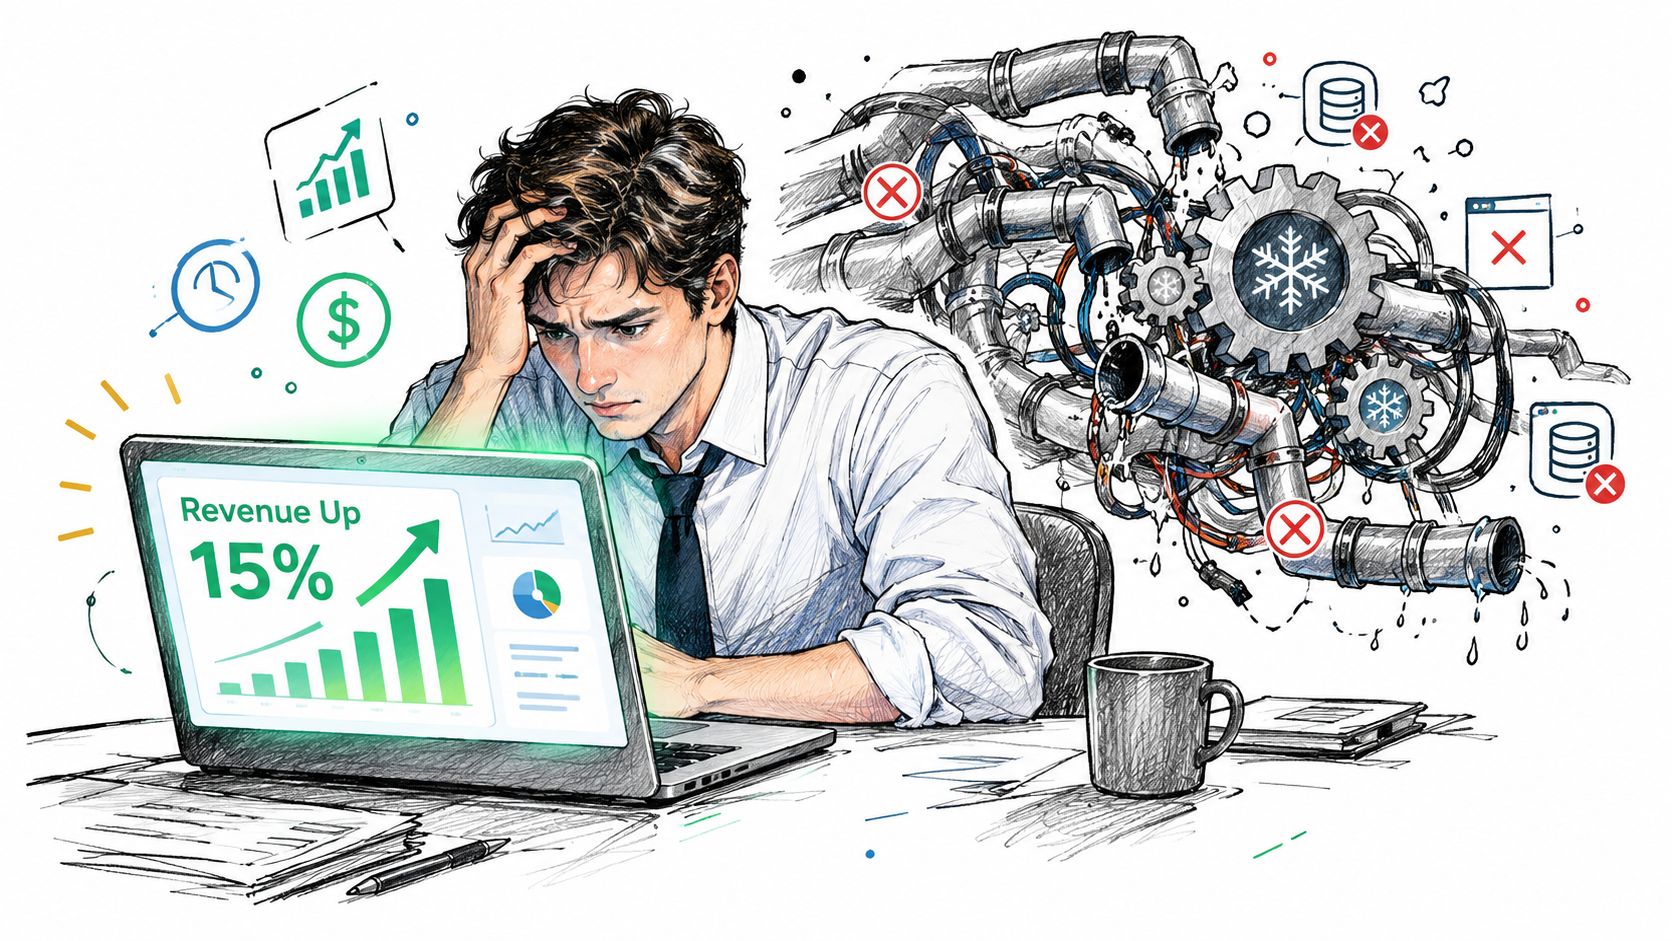
A las 9 de la mañana, una persona interesada llama porque el panel de ingresos ha subido un 15 %. El equipo lo celebra un momento, hasta que alguien revisa el flujo de transacciones y descubre que el pipeline se cargó tarde y omitió los dos últimos días. El KPI no reflejaba un mejor rendimiento. Reflejaba datos incompletos.
Por eso un proceso de monitorización de KPI fiable debe vigilar algo más que los valores de las métricas. Tiene que determinar si los datos están actualizados, completos, son estructuralmente válidos y son aptos para su interpretación. Un panel puede tener un aspecto impecable y, aun así, dar una falsa seguridad a quienes toman decisiones.
Índice
Por qué su panel de KPI le está engañando
Las seis etapas de un proceso de monitorización de KPI
Defina la decisión y el responsable
Establezca una línea base representativa
Valide el linaje antes de interpretar los cambios
Calcule en la fuente autorizada
Detecte límites y comportamientos inusuales
Enrute, resuelva y mejore las alertas
Separar el rendimiento del negocio de la idoneidad de los datos
Use dos vías de alerta
Haga que el resultado sea auditable
Reglas tradicionales frente a detección de anomalías basada en IA
Dónde funcionan las reglas deterministas
Dónde ayuda la detección adaptativa
Roles, responsabilidades y prácticas operativas
Asigne las responsabilidades de forma explícita
Fije la cadencia según la capacidad de actuar
Errores comunes y cómo evitarlos
Patrones de fallo habituales
Cómo construir su estrategia de monitorización de KPI con digna
Por qué su panel de KPI le está engañando
El fallo suele empezar con un diseño razonable. Un ingeniero de analítica define los ingresos, conecta el cálculo a una tabla del almacén de datos, añade una línea objetivo y publica el resultado en Power BI u otra plataforma de BI. Desde el punto de vista de la herramienta de informes, la actualización del panel se completa correctamente, pero la carga de transacciones de origen llegó tarde o contenía solo una parte de los datos esperados.
La persona interesada ve una evolución positiva. El ingeniero de datos ve una incidencia de entrega. Ambos miran el mismo KPI, pero solo uno tiene el contexto necesario para interpretarlo.
Regla práctica: no considere fiable el valor de un KPI hasta que su frescura, completitud, linaje y estado de validación estén disponibles junto a él.
La monitorización tradicional suele vigilar solo la cifra final. Un umbral puede alertar cuando los ingresos caen por debajo de un objetivo fijo, pero no necesariamente señalará una carga retrasada, una partición ausente, un cambio en el tipo de una columna o una extracción parcial. Los equipos reciben entonces alertas que no explican si ha cambiado el negocio o si ha fallado la medición.
Esa distinción afecta a toda respuesta operativa. Un descenso real puede requerir una investigación comercial. Un conjunto de datos retrasado requiere reparar el pipeline. Un cambio de esquema puede requerir actualizar las transformaciones. Si el proceso de monitorización envía la misma alerta en los tres casos, la responsabilidad se difumina y los equipos pierden tiempo diagnosticando el problema equivocado.
Los paneles siguen siendo importantes, sobre todo cuando los equipos necesitan crear visualizaciones accionables en Power BI. Pero la visualización es la última capa, no el sistema de monitorización en sí. El proceso subyacente debe conectar el KPI mostrado con las condiciones de los datos que lo produjeron.
Por tanto, un panel de monitorización de KPI práctico debería mostrar la señal de negocio y la evidencia que respalda su validez. Eso implica registrar los tiempos de entrega esperados y reales, los recuentos de filas, los resultados de validación, las versiones del esquema y el estado del cálculo. Sin esos controles, un panel en verde solo significa que el panel se ha mostrado correctamente.
Las seis etapas de un proceso de monitorización de KPI
Un proceso defendible es un ciclo cerrado. El modelo operativo detallado incluye ocho etapas diferenciadas, desde definir la decisión y el responsable hasta revisar los umbrales frente a falsos positivos y condiciones cambiantes, tal como se describe en el NIST AI Risk Management Framework Playbook. En la práctica, esas actividades pueden organizarse en seis etapas de implementación que los equipos pueden gestionar en el día a día.
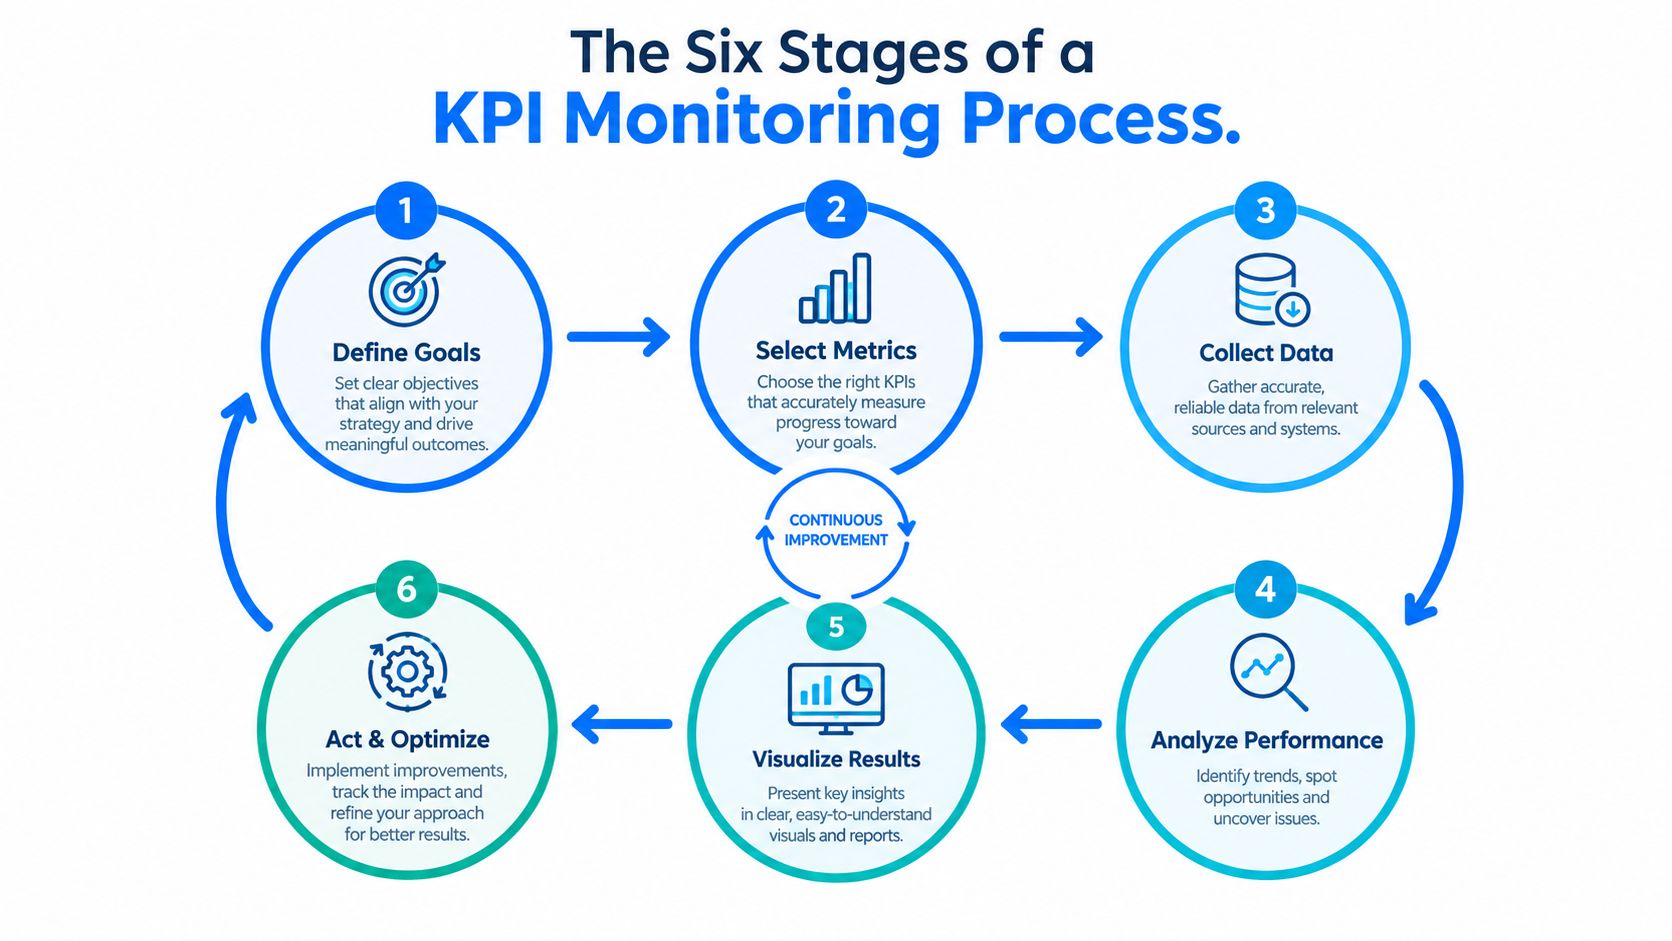
Defina la decisión y el responsable
Empiece por la decisión, no por el gráfico. Anote qué acción debe influir el KPI, quién es responsable del resultado y quién investiga una desviación. Defina el numerador, el denominador, la granularidad del cálculo, los filtros, la frescura esperada, el rango operativo aceptable y la ruta de escalado.
Un equipo de servicios financieros podría asignar un KPI de volumen de liquidaciones a un responsable de operaciones, mientras que una organización sanitaria podría asignar un KPI de completitud de reclamaciones a un responsable de gobernanza de datos. En ambos casos, el responsable necesita suficiente detalle semántico para determinar si un cambio es significativo.
Establezca una línea base representativa
Un objetivo no es lo mismo que una línea base. Construya el comportamiento histórico a partir de periodos representativos y separe la estacionalidad normal, los efectos de calendario, las promociones, el mantenimiento planificado y las caídas conocidas de los cambios reales. Un límite fijo puede ser útil para una frontera de cumplimiento estricta, pero no describe la variación normal.
Valide el linaje antes de interpretar los cambios
Compruebe que las tablas de origen, las transformaciones, los joins, los filtros y los trabajos de entrega funcionan como se espera. Un KPI debe llevar asociado su linaje hasta la fuente autorizada, junto con los resultados de validación y el estado de idoneidad de los datos. Si la fuente está incompleta, etiquete o suprima el resultado de negocio en lugar de presentarlo como actual.
Calcule en la fuente autorizada
Calcular dentro de la base de datos reduce el movimiento innecesario y mantiene la lógica cerca de los datos gobernados. También facilita la auditoría del cálculo, porque el equipo puede asociar el resultado con la marca de tiempo de la fuente, la versión de la consulta, el estado del esquema y el resultado de la validación.
Detecte límites y comportamientos inusuales
Use controles deterministas para límites definidos y fallos de integridad. Añada monitorización estadística para niveles inusuales, cambios en la tasa de variación, volatilidad y cambios de distribución. La combinación detecta tanto las infracciones conocidas como los comportamientos que no encajan con la línea base histórica.
Enrute, resuelva y mejore las alertas
Envíe las alertas según su gravedad a un responsable claro. Una desviación sostenida de baja gravedad puede generar un ticket, mientras que un fallo de integridad grave puede requerir un aviso inmediato a la guardia. Cada alerta debería incluir un runbook, una ventana de supresión, una ruta de escalado, el diagnóstico, la remediación y el impacto en el negocio.
El proceso solo se vuelve fiable cuando los equipos revisan su rendimiento. Haga seguimiento de los falsos positivos, las incidencias no detectadas, el tiempo de detección, el tiempo de reconocimiento y el tiempo de remediación, y recalibre los umbrales cuando cambien las condiciones operativas.
Separar el rendimiento del negocio de la idoneidad de los datos
Una alerta de rendimiento del negocio responde a la pregunta: “¿Se ha comportado el negocio de forma diferente?”. Una alerta de idoneidad de los datos responde a otra: “¿Podemos fiarnos de la medición?”. Ambas preguntas están relacionadas, pero no deberían compartir el mismo estado ni la misma respuesta.
Una carencia importante de las guías de monitorización de KPI es que explican cómo seleccionar métricas sin especificar cómo actuar cuando los datos subyacentes llegan tarde, están incompletos o han cambiado estructuralmente. Los consejos convencionales suelen ajustar la frecuencia de monitorización a la capacidad de actuar, pero rara vez definen qué ocurre cuando una actualización programada no llega a tiempo o cuando se añade, elimina o cambia el tipo de una columna, como se describe en esta guía de diseño de KPI.
Use dos vías de alerta
Imagine que un KPI de telecomunicaciones muestra una caída repentina de la actividad de los clientes. Hay al menos dos explicaciones plausibles:
Señal de negocio: el comportamiento de los clientes ha cambiado, así que el equipo comercial o de operaciones debe investigar.
Señal de entrega: falta la última partición de eventos, así que el equipo de la plataforma de datos debe reparar la carga.
Señal estructural: una columna de origen ha cambiado de tipo o ha desaparecido, así que los responsables de transformación y gobernanza deben evaluar el impacto.
Un único indicador en rojo no puede distinguir entre estos casos. El sistema debería asociar al cálculo del KPI el estado de frescura, completitud, esquema y validación. Si los datos llegaron tarde, el resultado puede marcarse como afectado y la alerta de negocio suprimirse hasta que la fuente esté en buen estado.
Haga que el resultado sea auditable
Cada ejecución de un KPI debería conservar la marca de tiempo de los datos, el tiempo de entrega esperado frente al real, el recuento de filas, la versión del esquema, el estado del cálculo, la versión del umbral y el identificador de la incidencia. Estos campos permiten a un analista explicar por qué ha cambiado un valor sin reconstruir todo el historial del pipeline en plena incidencia.
La distinción es especialmente importante en sanidad y en el sector público, donde un informe aparentemente actualizado puede influir en decisiones operativas o regulatorias. Un resultado basado en datos parciales no debería parecer idéntico a uno generado a partir de una carga completa y validada.
El enfoque de observabilidad de la calidad de datos de digna refleja este modelo operativo al conectar las métricas de negocio con controles de puntualidad, validación, anomalías y cambios de esquema dentro del entorno de datos del cliente. La ventaja práctica no es otro panel más. Es una respuesta más clara a la primera pregunta que deberían hacerse los equipos de respuesta: ¿el movimiento del KPI es real o la medición ha dejado de ser fiable?
Reglas tradicionales frente a detección de anomalías basada en IA
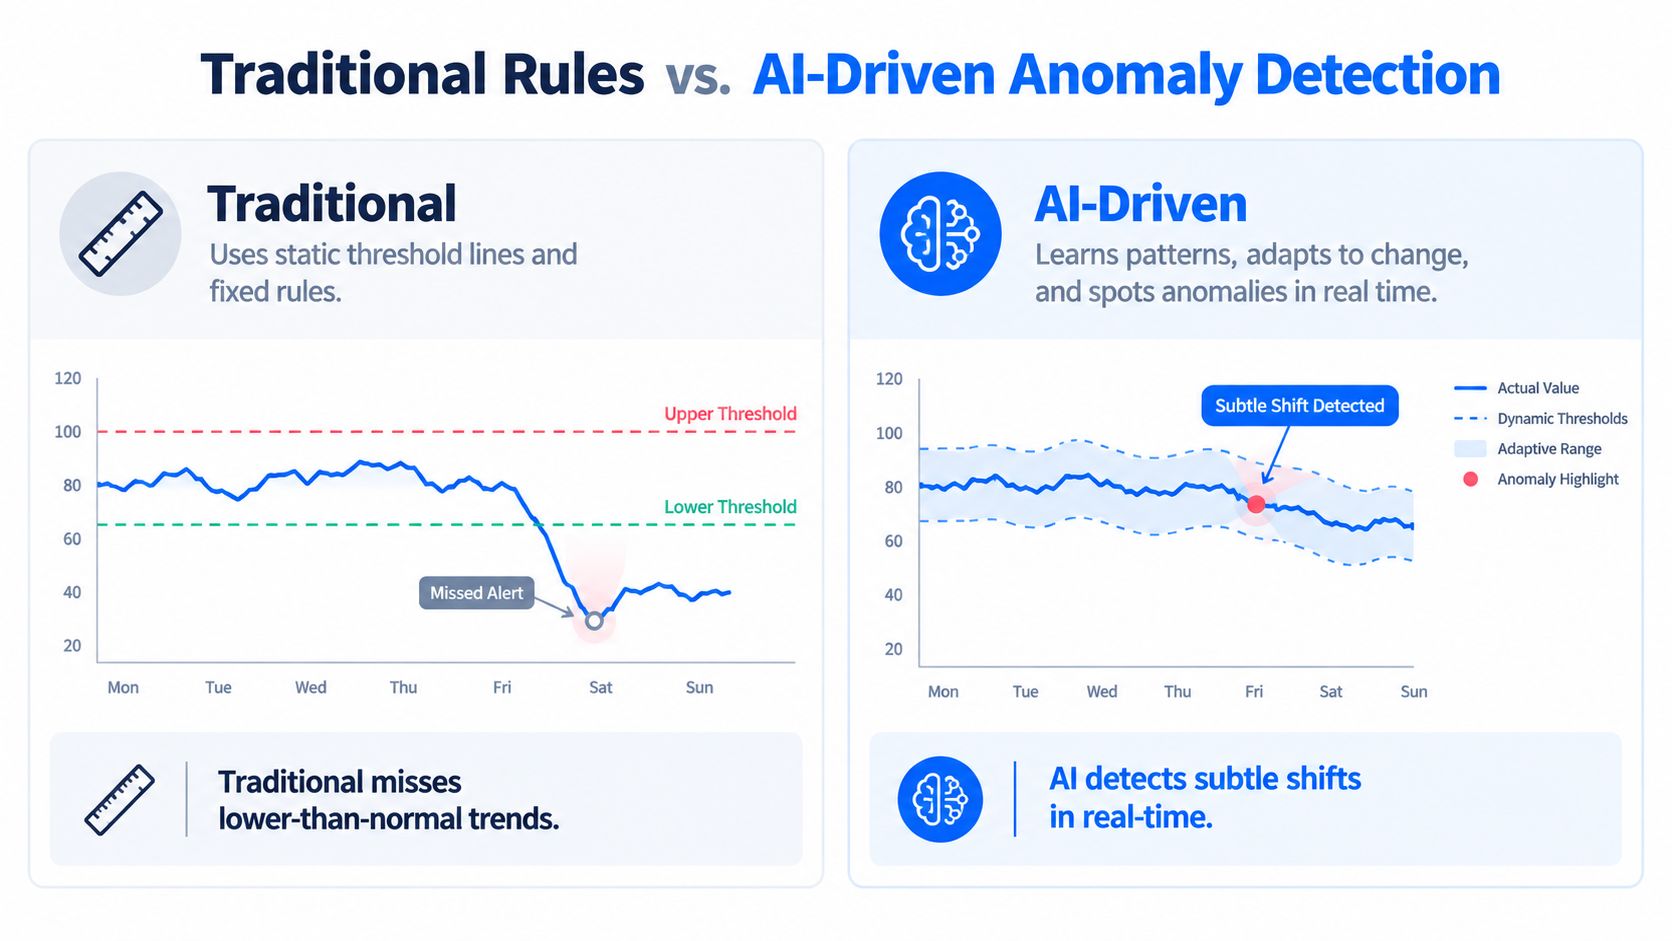
Un umbral fijo puede proteger un límite de negocio claro, por ejemplo alertando cuando las transacciones caen por debajo de un límite aprobado. Pero no puede describir todas las condiciones operativas normales. Los fines de semana, la demanda estacional, los periodos de poco tráfico, la deriva gradual y la volatilidad cambiante pueden hacer que el mismo umbral resulte engañoso.
Eso provoca dos fallos operativos. Un umbral demasiado sensible genera ruido, mientras que uno demasiado amplio pasa por alto una caída significativa. Los equipos empiezan a optimizar el volumen de alertas en lugar de la calidad de las decisiones, un problema que se analiza en esta guía sobre la monitorización de las señales doradas de SRE.
Dónde funcionan las reglas deterministas
Los controles deterministas encajan con condiciones explícitas y verificables:
Controles de nulos: los campos obligatorios deben contener valores.
Controles de unicidad: los identificadores no deben duplicarse dentro de la granularidad definida.
Controles de integridad referencial: los registros hijos deben corresponder a registros padre válidos.
Controles de esquema: las columnas obligatorias y los tipos de datos deben seguir siendo compatibles.
Controles de frescura: los datos esperados deben llegar dentro de su ventana de entrega definida.
Controles de límites: no se debe superar un límite regulatorio u operativo.
Estos controles son transparentes, explicables y fáciles de conectar con un runbook. Sustituirlos por detección de anomalías debilitaría los controles allí donde la condición esperada ya se conoce.
Dónde ayuda la detección adaptativa
La monitorización estadística compara el comportamiento actual con el propio historial del conjunto de datos. El resumen de los tipos de detección de anomalías describe cómo este enfoque puede identificar un nivel inesperado, una tasa de variación, un patrón de volatilidad o un cambio de distribución sin que los ingenieros tengan que codificar manualmente cada condición normal. Resulta útil cuando una métrica cambia durante periodos de poco tráfico o deriva antes de cruzar un límite fijo.
El módulo Data Anomalies de digna aplica aprendizaje de líneas base basado en IA y detección continua de anomalías sin configurar reglas manualmente. Su ejecución dentro de la base de datos mantiene los cálculos en el entorno del cliente, lo que reduce el movimiento de datos y evita que el proveedor acceda a los datos de producción. Ese diseño también ayuda a relacionar una alerta sobre una métrica de negocio con el problema de idoneidad de los datos subyacente, en lugar de tratar el KPI como una señal aislada.
Use un modelo híbrido. Las reglas deterministas deben hacer cumplir los contratos conocidos y las condiciones de cumplimiento, mientras que la monitorización adaptativa debe cubrir el comportamiento que ningún umbral único puede representar. Envíe ambos tipos de alerta por el mismo flujo de gestión de incidencias, pero conserve el método de detección, la evidencia y el KPI afectado para que los equipos de respuesta puedan distinguir un cambio real del negocio de un problema de medición.
Roles, responsabilidades y prácticas operativas
Un proceso de monitorización de KPI fracasa cuando la responsabilidad termina en el panel. Los ingenieros de datos se ocupan de la entrega y el cálculo, los ingenieros de analítica protegen la exactitud semántica, los equipos de gobernanza definen las expectativas de calidad y los responsables de negocio deciden qué acción requiere un cambio.
NIST recomienda seleccionar métricas que ofrezcan indicaciones significativas del estado en los niveles relevantes, definir las frecuencias de monitorización y de evaluación de controles, y automatizar la recogida, el análisis y la generación de informes siempre que sea posible, tal como se expone en su publicación sobre monitorización continua.
Asigne las responsabilidades de forma explícita
El ingeniero de datos es responsable del estado del pipeline, los calendarios de entrega, los cambios en las fuentes y los procedimientos de recuperación. El ingeniero de analítica es responsable de las definiciones de los KPI, los joins, los filtros, la lógica de agregación y la exactitud del panel. El equipo de gobernanza o de calidad de datos define las reglas de validación, los requisitos de evidencia y las condiciones aceptables de los datos.
El responsable de negocio interpreta el KPI y decide qué debe ocurrir cuando se desvía. Esa persona puede aprobar una respuesta comercial, aceptar una excepción conocida o escalar una incidencia operativa. Un modelo compartido de roles y responsabilidades de calidad de datos ayuda a evitar la situación habitual en la que todo el mundo recibe una alerta pero nadie es responsable de la decisión.
Fije la cadencia según la capacidad de actuar
Los indicadores operativos de alta volatilidad pueden necesitar una evaluación frecuente, mientras que las medidas estratégicas más lentas pueden revisarse con menos frecuencia. Lo importante es registrar la cadencia de forma explícita, incluidos el intervalo de medición, el calendario de actualización esperado, la marca de tiempo y el grupo de destinatarios.
Cada ejecución debería incluir:
Metadatos de entrega: horas de llegada esperadas y reales.
Evidencia de los datos: recuento de filas, marca de tiempo de la fuente y estado de completitud.
Contexto técnico: versión del esquema y estado del cálculo.
Contexto de control: versión del umbral y resultado de la validación.
Trazabilidad operativa: identificador de la incidencia, responsable y estado de resolución.
Antes de activar una alerta en producción, exija una gravedad, un runbook, una ventana de supresión, un responsable y una ruta de escalado. La automatización debe recoger y analizar la evidencia, pero las personas deben seguir siendo responsables del criterio y de la remediación.
Errores comunes y cómo evitarlos
Más alertas no significa mejor monitorización. Si cada pequeña desviación genera una notificación, los equipos aprenden a ignorar el canal y una incidencia importante puede perderse entre los avisos rutinarios.
El error más dañino es optimizar el volumen de alertas en lugar de la calidad de las decisiones. Mida si las alertas conducen a acciones mediante la precisión, la cobertura de incidencias o exhaustividad, el tiempo medio de detección, el tiempo medio de reconocimiento y el tiempo medio de remediación. Un sistema de alertas silencioso puede estar sano o puede estar pasando por alto incidencias. Necesita evidencia.
Patrones de fallo habituales
Fatiga de alertas: el exceso de notificaciones acostumbra a los equipos a ignorar las alertas. Combine niveles de gravedad, suprima duplicados durante las ventanas de mantenimiento conocidas y envíe solo eventos accionables.
Métricas de vanidad: una métrica puede parecer impresionante sin servir para tomar ninguna decisión. Vincule cada KPI a un objetivo de negocio e identifique la acción que sigue a un cambio significativo.
Sin responsable: una alerta sin una persona designada para responder se convierte en ruido de fondo compartido. Asigne un único responsable, aunque varios equipos contribuyan al diagnóstico.
Umbrales estáticos: los límites fijos pasan por alto la estacionalidad, los fallos fuera de horas punta y la deriva gradual. Combine los límites con una monitorización que tenga en cuenta la línea base.
Datos no verificados: un KPI puede moverse porque la fuente llega tarde o está incompleta. Mantenga el estado de idoneidad de los datos junto al valor de negocio y separe las vías de respuesta.
Cada alerta necesita una respuesta predefinida antes de activarse en producción. Si el equipo no puede explicar quién investiga, qué evidencia necesita, cuánto dura la supresión y cuándo se escala, la alerta no está lista para operar.
Cómo construir su estrategia de monitorización de KPI con digna
Empiece por los KPI que impulsan decisiones reales, no por todas las métricas disponibles en el almacén de datos. Defina responsables y lógica de cálculo, establezca líneas base representativas, valide el linaje, añada metadatos de idoneidad de los datos y combine controles fijos con detección adaptativa de anomalías.
Un despliegue práctico puede comenzar con un único conjunto de datos crítico o un dominio de negocio. Después, añada monitorización de la puntualidad para el riesgo de entrega, validación para las reglas de negocio, seguimiento del esquema para los cambios estructurales y observabilidad de la plataforma allí donde la carga de trabajo o el rendimiento afecten a los informes. Las herramientas de monitorización de KPI deben adaptarse al modelo operativo, en lugar de obligar a todos los equipos a seguir el mismo patrón de alertas.
digna se ejecuta dentro del propio entorno del cliente, con controles que se realizan en la base de datos sobre almacenes de datos, data lakes y pipelines. Los equipos pueden aprovechar su licencia modular para empezar con un solo módulo y ampliar después, mientras que el SDK de Python permite la integración programática en los flujos de trabajo existentes. Un panel compartido y centrado en el usuario ofrece a ingenieros de datos, analistas y demás partes interesadas un único lugar donde revisar incidencias, tendencias y estado.
La implementación más sólida conecta el diseño de las métricas con la recogida, la interpretación, el escalado y la remediación. Con digna, los equipos pueden pasar de la instalación a los primeros resultados en menos de dos horas y, después, afinar umbrales y flujos de trabajo a medida que aprenden cómo se comportan sus datos en producción.
digna conecta la monitorización de KPI de negocio con la calidad de los datos, la puntualidad, la validación, la detección de anomalías y el seguimiento del esquema dentro de su propio entorno. Visite digna para ver cómo puede construir un proceso de monitorización auditable que distinga los cambios reales de rendimiento de los datos poco fiables.
Para poner cifra a lo que realmente le cuesta al negocio un flujo de KPI retrasado o incompleto, introduzca sus propios datos en la calculadora del coste del tiempo de inactividad de los datos antes de decidir cuánta monitorización merece cada métrica.
Preguntas frecuentes
¿Qué es un proceso de monitorización de KPI?
Un ciclo cerrado que define la decisión y el responsable de cada KPI, establece una línea base representativa, valida el linaje, calcula en la fuente autorizada, detecta límites y comportamientos inusuales y dirige las alertas a una persona responsable. El objetivo es saber tanto lo que dice la métrica como si se puede confiar en los datos que la sustentan.
¿Por qué un panel de KPI puede mostrar cifras engañosas?
La herramienta de informes puede actualizarse correctamente aunque la carga de origen haya llegado tarde o solo en parte. En el ejemplo del artículo, los ingresos parecían un 15 % más altos porque el pipeline omitió las transacciones de los dos últimos días. Sin controles de frescura y completitud, los datos incompletos parecen exactamente un mejor rendimiento del negocio.
¿Cuál es la diferencia entre una alerta de negocio y una alerta de idoneidad de los datos?
Una alerta de rendimiento del negocio pregunta si el negocio se ha comportado de forma diferente, así que investiga el responsable comercial o de operaciones. Una alerta de idoneidad de los datos pregunta si se puede confiar en la medición, así que el equipo de la plataforma de datos repara una partición ausente o un esquema modificado. Mantener dos vías de alerta envía cada problema al equipo adecuado.
¿La monitorización de KPI debe usar umbrales fijos o detección de anomalías?
Ambos. Los umbrales fijos sirven para límites estrictos y explícitos, como controles de nulos, unicidad, integridad referencial, compatibilidad del esquema y ventanas de entrega. La detección adaptativa de anomalías compara una métrica con su propio historial, por lo que detecta niveles inusuales, cambios en la tasa de variación y derivas que un único límite estático pasaría por alto o marcaría como ruido.
¿Quién debe ser responsable de la monitorización de KPI?
La responsabilidad está repartida. Los ingenieros de datos se ocupan del estado del pipeline y de los calendarios de entrega, los ingenieros de analítica de las definiciones de los KPI y la lógica del panel, los equipos de gobernanza fijan las reglas de validación y los requisitos de evidencia, y el responsable de negocio decide qué acción requiere una desviación. Un KPI sin una persona designada para responder suele acabar siendo un problema de todos y una tarea de nadie.


