Comparativa de 10 herramientas de validación de big data
|
10
minuto de lectura

Las mejores herramientas de validación de big data no son las que tienen la lista de funciones más larga. Una plataforma puede ofrecer perfilado, alertas, linaje y decenas de conectores y, aun así, dejar a un equipo financiero sin poder demostrar si se ejecutó una regla crítica sobre transacciones, dónde se ejecutó un control fallido o quién es responsable de la excepción.
La validación a gran escala abarca problemas distintos. Las reglas de negocio a nivel de registro comprueban si los valores y las relaciones tienen sentido. La detección estadística de anomalías identifica distribuciones inusuales. La monitorización de la frescura detecta cargas tardías o ausentes. El seguimiento del esquema detecta cambios estructurales. Las pruebas de migración comparan resultados entre sistemas, mientras que el linaje y la monitorización del estado de la plataforma explican el impacto y el contexto operativo. Estos controles se solapan, pero no son intercambiables. Esa distinción es clave para entender por qué importan las pruebas de validación.
Esta comparativa evalúa diez herramientas según el alcance de la validación, el modelo de ejecución, el despliegue, la responsabilidad operativa, el esfuerzo de implementación, la gobernanza, la transparencia de precios y la adecuación a cada caso de uso. Además, trata las pruebas basadas en reglas y la observabilidad automatizada como enfoques complementarios, no rivales. digna es una opción relevante para equipos que necesitan validación y observabilidad dentro de la base de datos y en su propia infraestructura, pero no es la ganadora universal para cualquier patrimonio de datos.
Índice
1. Data Validation
Dónde encaja digna a nivel operativo
Puntos fuertes y compromisos
2. Great Expectations, GX Cloud y código abierto
3. Soda, Soda Core y Soda Cloud
4. Monte Carlo
5. Anomalo
6. Bigeye
7. Datafold
8. AWS Deequ
9. Acceldata
10. Talend Data Quality, ahora dentro de Qlik Talend Cloud y Talend Data Fabric
Comparativa de las 10 mejores herramientas de validación de big data
Elija la herramienta según el fallo que necesita evitar
1. Data Validation
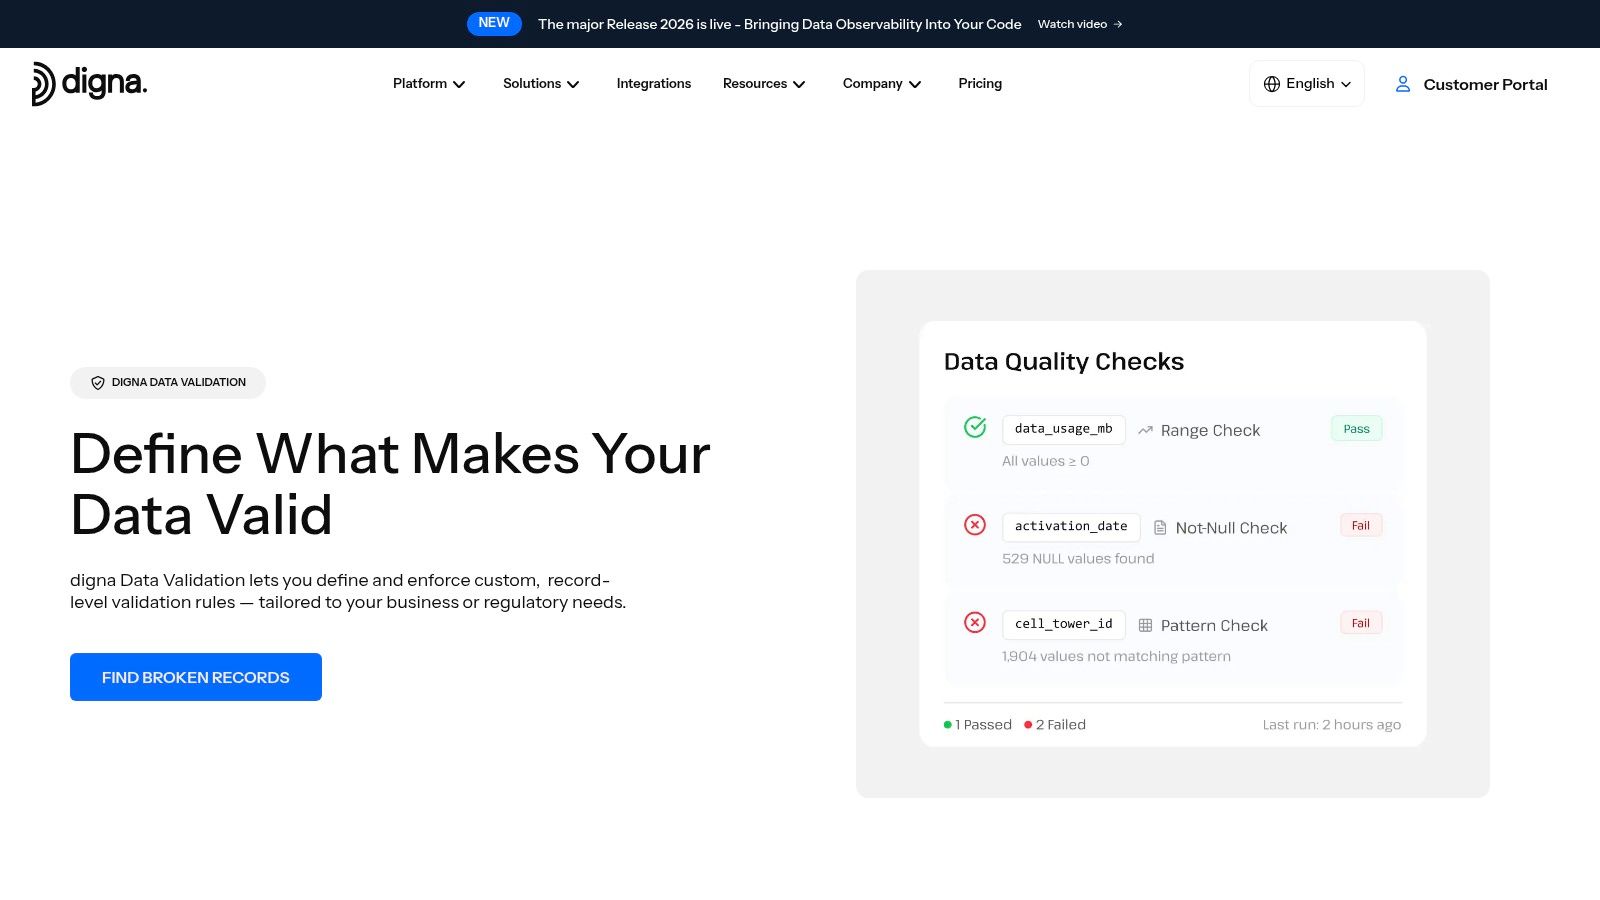
El módulo Data Validation de digna está pensado para el problema que las puntuaciones de anomalías no pueden resolver por sí solas: demostrar que cada registro cumple una lógica de negocio explícita. Los equipos pueden definir controles para valores exactos, umbrales, rangos, tratamiento de nulos, listas de referencia y coherencia entre columnas, y después usar los resultados para respaldar la analítica, los informes, los flujos operativos y la revisión regulatoria. La distinción importa porque un conjunto de datos puede seguir un patrón estadístico habitual y, aun así, incumplir una regla de negocio crítica.
Dónde encaja digna a nivel operativo
digna realiza la validación y el cálculo de métricas dentro de las bases de datos del cliente, en lugar de trasladar los datos de producción a un entorno de procesamiento externo. Se ejecuta en la nube, la VPC o el centro de datos del cliente, por lo que su modelo de despliegue es relevante para organizaciones con requisitos estrictos de residencia, acceso o gobernanza. Su documentación de producto describe la ejecución en bases de datos como Teradata, Snowflake, Databricks y PostgreSQL, con registro de resultados correctos y fallidos y pistas de auditoría.
El módulo también vincula los fallos a nivel de registro con la detección de anomalías basada en IA, la monitorización de la puntualidad y el seguimiento del esquema. Esa correlación puede ser más útil que una alerta aislada. Una regla fallida acompañada de una carga tardía o de un cambio estructural reciente ofrece al investigador un punto de partida mucho más sólido que una regla fallida sin contexto.
Regla práctica: elija digna cuando la evidencia que respalda un control fallido importe tanto como la propia alerta.
Puntos fuertes y compromisos
Ejecución dentro de la base de datos: los datos de producción permanecen donde están, lo que reduce su movimiento y alinea la validación con los requisitos de despliegue privado.
Controles listos para auditoría: los resultados a nivel de fila aportan evidencia sobre reglas de negocio, gestión de excepciones y revisiones de cumplimiento.
Incidencias correlacionadas: las anomalías, los retrasos en la entrega y los cambios de esquema pueden revisarse junto con los fallos de validación.
Ampliación modular: los equipos pueden empezar por las tablas prioritarias y añadir módulos de monitorización a medida que crece la cobertura.
El compromiso está en la responsabilidad de la implementación. digna requiere despliegue e integración con las bases de datos del cliente, por lo que puede exigir más trabajo de infraestructura que un servicio exclusivamente SaaS. La creación y el mantenimiento de reglas siguen siendo necesarios, y el precio por tabla activa implica que el coste y el esfuerzo operativo pueden crecer a medida que aumenta la cobertura. Los equipos que lo evalúen deberían definir responsables de tablas, responsables de reglas, caducidad de excepciones y niveles de servicio de remediación antes de un despliegue amplio.
Para conocer en detalle los patrones de implementación, consulte la guía de digna sobre reglas de validación de datos, controles y calidad de datos continua. Visite la página de producto de digna Data Validation para obtener información actualizada sobre despliegue y licencias.
2. Great Expectations, GX Cloud y código abierto
Great Expectations encaja bien cuando un equipo quiere validación declarativa basada en reglas sobre una base de código abierto. Su modelo de Expectations permite a los ingenieros definir aserciones sobre conjuntos de datos, columnas, distribuciones y valores, y ejecutar esas suites en almacenes SQL, data lakes, archivos o dataframes. La separación entre la creación de pruebas y la gestión de ejecuciones resulta útil para equipos que quieren controles revisados como código, pero también necesitan una visión operativa compartida.
La versión de código abierto de GX encaja mejor con equipos acostumbrados a mantener flujos de trabajo en Python, repositorios e infraestructura de ejecución. GX Cloud añade colaboración alojada, historial de validaciones, alertas y flujos de gobernanza. Por eso el producto es menos una decisión de despliegue única que un camino desde las pruebas centradas en código hacia las operaciones gestionadas.
La principal limitación es el esfuerzo de cobertura. Un catálogo amplio de expectativas no elimina la necesidad de decidir qué reglas son críticas para el negocio, cómo funcionan las excepciones y dónde se ejecutan las suites en producción. La creación de reglas puede requerir mucho trabajo cuando un gran patrimonio de datos necesita cobertura explícita en muchas tablas. Además, GX no es principalmente una plataforma de observabilidad automatizada, así que los equipos que buscan aprendizaje de líneas base, inteligencia sobre la frescura o correlación amplia de incidencias pueden necesitar capacidades complementarias.
Para tener contexto práctico sobre el panorama de la calidad de datos de código abierto, compare el framework con el análisis de digna sobre las funciones de las herramientas de calidad de datos de código abierto. Revise las opciones actuales del producto en Great Expectations, sobre todo si el precio, los límites del servicio alojado o el empaquetado en la nube van a influir en la compra.
3. Soda, Soda Core y Soda Cloud
Soda separa el motor de ejecución del plano de control operativo. Soda Core y Soda Library permiten a los desarrolladores expresar controles en SodaCL, una sintaxis basada en YAML diseñada para integrarse en los pipelines. Soda Cloud añade una interfaz compartida para resultados, alertas, tendencias, acceso basado en roles y triaje.
Esa división conviene a equipos que quieren la validación cerca del almacén de datos y, al mismo tiempo, ofrecer a analistas y propietarios de datos una interfaz en la nube para la revisión. Las integraciones de Soda con plataformas como Snowflake y Databricks, junto con las conexiones CI/CD, permiten controles que se ejecutan como parte de los flujos de entrega y no solo como escaneos programados de un panel.
La diferencia útil está en la accesibilidad. YAML puede reducir la barrera para los ingenieros que no quieren que cada control esté incrustado en el código de la aplicación, mientras que el perfilado y las sugerencias automáticas pueden ayudar a establecer una línea base inicial de calidad. Aun así, el producto exige decisiones sobre gravedad, responsabilidad y escalado. Un control que se ejecuta correctamente pero no tiene un responsable es solo un evento técnico, no un control operativo.
El lugar de ejecución importa más que la pantalla de alertas. Una interfaz en la nube muy pulida no significa automáticamente que los datos de producción hayan salido del almacén.
El mejor caso de uso de Soda es un programa de calidad centrado en el almacén de datos que combina controles escritos por desarrolladores con un triaje colaborativo. Su limitación es el empaquetado. Algunas capacidades avanzadas solo están disponibles en la SKU Cloud y los precios no son públicos, por lo que los compradores deben confirmar directamente los límites actuales de funciones y las condiciones del presupuesto. Los equipos que lo comparen con digna deberían centrarse en si necesitan un plano de control SaaS, una instalación privada o una monitorización correlacionada más amplia. La plataforma Soda ofrece el alcance actual del producto, los detalles de despliegue y la información comercial. Si busca alternativas orientadas a la validación y la observabilidad sin mover los datos, consulte las alternativas a Soda de digna.
4. Monte Carlo
Monte Carlo aborda un patrón de fallo distinto al de una biblioteca de reglas. Su propuesta central es la observabilidad de datos sobre frescura, volumen, esquema, linaje y BI, respaldada por monitores basados en machine learning y flujos de gestión de incidencias. Eso lo convierte en una opción natural para equipos de datos grandes que necesitan identificar comportamientos inesperados sin escribir una regla para cada tabla y cada métrica.
El análisis de linaje y de impacto de la plataforma es especialmente importante durante la investigación. Un problema de frescura se vuelve más accionable cuando el equipo puede ver los activos, paneles o flujos posteriores afectados. Las capacidades de triaje de incidencias y de runbooks también orientan el producto hacia la respuesta operativa y no solo hacia la creación de pruebas.
Monte Carlo suele evaluarse a través de canales de compra empresariales, incluido AWS Marketplace. Su modelo de consumo basado en créditos puede simplificar la compra para organizaciones que ya usan esa vía, pero plantea preguntas sobre costes variables. Los equipos deberían modelar cómo afectan al consumo los activos monitorizados, la frecuencia de escaneo, la retención histórica y el volumen de incidencias, en lugar de considerar la vía del marketplace como una respuesta completa sobre precios.
La limitación es la cobertura determinista. La observabilidad puede detectar que una distribución ha cambiado o que una carga ha llegado tarde, pero no sustituye a una regla explícita para una condición con relevancia legal u operativa. Una buena implementación combina los monitores automatizados de Monte Carlo con pruebas específicas a cargo del equipo de dominio correspondiente.
Revise el alcance actual y las opciones de compra en Monte Carlo. Los compradores deberían pedir un modelo de costes basado en su patrimonio monitorizado real y comparar la respuesta con herramientas que ejecutan los controles en su propia infraestructura. Para una perspectiva de producto distinta, consulte el análisis de digna sobre alternativas a Monte Carlo.
5. Anomalo
Anomalo está diseñado para equipos que quieren que la detección automatizada de anomalías establezca rápidamente una cobertura amplia. Analiza el comportamiento de tablas, columnas, métricas y distribuciones, y admite validación configurable a nivel de tabla, columna y fila. Esa combinación resuelve una tensión habitual en la implementación: los equipos necesitan controles explícitos, pero a menudo no pueden definir a mano todas las líneas base útiles antes de empezar a monitorizar.
La interfaz pone el acento en la revisión a escala. Las conexiones nativas con almacenes de datos modernos y catálogos como Alation ayudan a mostrar el estado de los datos allí donde ya trabajan los consumidores y los responsables de datos. La detección automatizada puede revelar cambios inusuales que un umbral elegido manualmente pasaría por alto, sobre todo en entornos de almacén amplios donde la línea base relevante no es evidente en la fase de diseño.
El compromiso es la calibración de alertas. Los monitores basados en machine learning siguen necesitando políticas de triaje, decisiones de supresión y responsables. Si los equipos tratan cada desviación como un defecto, generan ruido. Si suprimen demasiado, el sistema pierde cobertura. El modelo operativo adecuado clasifica los problemas según su consecuencia para el negocio y mantiene controles deterministas para las condiciones que nunca deben ser ambiguas.
La cobertura automatizada reduce el esfuerzo de creación de reglas, pero no elimina la necesidad de tomar decisiones con responsables claros.
Anomalo encaja con organizaciones que priorizan una observabilidad rápida en grandes almacenes de datos y un flujo visual para revisar incidencias. Puede ser menos adecuado cuando el despliegue privado, la evidencia dentro de la base de datos o pistas de auditoría estrictas a nivel de registro son los criterios principales de selección. El precio se negocia con ventas y no es público, así que los compradores deberían validar durante la evaluación el alcance de los conectores, los límites de acceso a los datos y el soporte de ajuste. Consulte la oferta actual en Anomalo y compare su enfoque centrado en anomalías con la guía de digna para detectar problemas de datos a tiempo mediante la detección de anomalías.
6. Bigeye
Bigeye plantea la observabilidad como parte de un modelo operativo de AI Trust. Su monitorización cubre frescura, volumen, esquema y distribuciones, mientras que el análisis de linaje y de impacto vincula un conjunto de datos anómalo con sus consumidores posteriores. Ese enfoque lo hace relevante cuando los equipos de gobernanza necesitan algo más que una notificación: necesitan contexto sobre qué ha cambiado y qué cargas de trabajo podrían verse afectadas.
Su punto fuerte práctico es el triaje basado en el linaje. Los investigadores pueden usar las relaciones ascendentes y descendentes para acotar la búsqueda de la causa raíz, mientras que las capacidades de seguridad empresarial y una amplia cartera de conectores dan soporte a patrimonios heterogéneos. Bigeye también ofrece guías y documentación que ayudan a los equipos a estandarizar el despliegue, en lugar de que cada dominio invente su propio proceso de monitorización.
Su mayor alcance también puede ser una desventaja. Un equipo que busque una pequeña biblioteca de controles deterministas puede encontrar una plataforma de AI Trust más grande de lo que necesita en ese momento. Más capacidad implica más decisiones sobre responsabilidades, integración, gravedad de incidencias y procedimientos operativos. El equipo de compra debería separar la necesidad de observabilidad de la necesidad de controles de gobernanza de modelos y confirmar qué componentes del producto son necesarios.
Bigeye es un buen candidato cuando el linaje es central para la investigación y la organización quiere una implementación empresarial estructurada. No es la primera opción evidente para una biblioteca nativa de Spark orientada a desarrolladores ni para un flujo de comparación en migraciones. Los precios no están publicados y la compra se basa principalmente en demostraciones, por lo que la evaluación debería incluir los límites del despliegue, el tratamiento de datos sensibles y la retención de evidencias. La información actual del producto está disponible en Bigeye.
7. Datafold
Datafold resuelve excepcionalmente bien un problema más acotado: la comparación a nivel de valor y las pruebas de regresión. Su función Data Diff compara resultados en grandes conjuntos de datos, mientras que el linaje a nivel de columna conecta los cambios entre almacenes de datos, proyectos dbt y activos de BI. Eso lo hace útil antes de fusionar una pull request, durante una migración de almacén o cuando se ha reescrito una transformación y el equipo necesita ver el impacto real en los datos.
Esto no es lo mismo que la observabilidad continua. Datafold destaca cuando alguien tiene un cambio conocido y necesita evidencia de que el nuevo resultado coincide con el anterior, lo mejora o difiere de él de forma intencionada. Las integraciones de CI convierten esa comparación en parte del flujo de desarrollo, donde los ingenieros pueden detectar regresiones antes de que lleguen a los consumidores en producción.
Una opción de despliegue en VPC da soporte a organizaciones que necesitan ejecución privada. La pregunta clave de la implementación es el diseño de la comparación. Los equipos deben definir qué filas, columnas, agregados, tolerancias y exclusiones constituyen una prueba de paridad significativa. Una comparación mecánicamente completa puede dar un resultado operativamente inútil si los cambios aprobados por el negocio no están reflejados en la prueba.
Datafold encaja en entornos con muchas migraciones, centrados en dbt y sensibles a las regresiones. No sustituye la monitorización de la frescura, las líneas base de anomalías ni las reglas de cumplimiento a nivel de registro. El precio de la plataforma completa es personalizado y se negocia con ventas, y el proyecto de código abierto data-diff se ha discontinuado en favor del producto en la nube, así que los compradores deberían confirmar la vía comercial actual. Descubra las capacidades más recientes en Datafold.
8. AWS Deequ
AWS Deequ es una biblioteca de Scala y Apache Spark, no una plataforma completa de observabilidad. Esa distinción determina tanto su atractivo como su coste operativo. Los equipos de datos que trabajan directamente en el ecosistema JVM y Spark pueden expresar restricciones de completitud, unicidad, distribuciones y métricas relacionadas, y ejecutarlas junto con trabajos ETL o ELT a gran escala.
El patrón Metrics Repository de Deequ permite a los equipos conservar perfiles a lo largo del tiempo. Eso sienta una base para el análisis de tendencias, pero toda la experiencia que lo rodea sigue siendo responsabilidad del cliente. Los ingenieros tienen que construir la planificación, las alertas, la presentación de resultados, los flujos de responsabilidad y la retención de incidencias si la plataforma existente no los proporciona.
La biblioteca resulta atractiva cuando importa evitar la dependencia de un proveedor y Spark ya es el entorno de ejecución. Puede integrarse en trabajos ETL y flujos de CI, y existen bindings de Python de la comunidad para equipos que necesitan una interfaz en Python. Su flexibilidad exige conocimiento experto. Los equipos sin un dominio sólido de la operación de Scala o Spark pueden dedicar más esfuerzo a mantener la capa de validación que a escribir las propias restricciones.
Deequ es un componente con el que se construye un sistema de validación. No es un flujo de gobernanza listo para usar.
Use Deequ para pruebas de restricciones nativas de Spark cuando el control de ingeniería y la licencia de código abierto pesen más que la necesidad de una interfaz integrada. Elija en cambio una plataforma cuando analistas, responsables de datos o auditores necesiten un contexto de incidencias compartido sin desarrollo a medida. El código y la documentación actuales del proyecto están disponibles en el repositorio de AWS Deequ.
9. Acceldata
Acceldata combina la fiabilidad de los datos con la optimización de costes y el estado de la plataforma. Eso lo convierte en candidato para patrimonios complejos donde los equipos no quieren que las alertas de calidad de datos estén aisladas del comportamiento de las cargas de trabajo, las señales de rendimiento y los cambios de consumo. Su alcance va más allá de los controles de filas e incluye las condiciones operativas que determinan si las plataformas de datos siguen siendo utilizables y económicamente controladas.
La plataforma admite monitores de fiabilidad, alertas y controles del tipo contrato de datos en stacks heterogéneos. Sus capacidades de despliegue empresarial y seguridad son relevantes para organizaciones que operan tanto on-premises como en la nube, especialmente cuando los ingenieros de plataforma y los equipos de gobernanza comparten la responsabilidad de los niveles de servicio.
La amplitud puede ser valiosa, pero también amplía el alcance de la implementación. Un equipo que solo busque controles de nulos, validación contra listas de referencia o un pequeño conjunto de controles de esquema puede acabar evaluando capacidades que no llegará a poner en operación. El proceso de selección debería identificar el fallo que justifica la plataforma y comprobar después si las señales de coste y de estado serán responsabilidad del mismo equipo o de funciones de plataforma separadas.
Acceldata conviene a patrimonios donde calidad, fiabilidad y economía de la plataforma deben revisarse conjuntamente. El precio se negocia con ventas y se basa en presupuestos, así que los compradores deberían pedir un desglose claro de módulos, activos monitorizados, despliegue y soporte. El posicionamiento actual del producto y los detalles de la plataforma están disponibles en Acceldata.
10. Talend Data Quality, ahora dentro de Qlik Talend Cloud y Talend Data Fabric
Talend Data Quality es la opción empresarial consolidada de esta lista, con capacidades que abarcan perfilado, limpieza, estandarización, enriquecimiento, gestión de datos (stewardship) y puntuación de confianza. Tiene más sentido para organizaciones que ya se están estandarizando en Qlik o Talend para integración, gobernanza y gestión de datos, porque el valor procede tanto del ecosistema que lo rodea como de las reglas de validación individuales.
El conjunto de herramientas admite reglas de calidad y perfilado junto con flujos de stewardship. Hay planes de suscripción disponibles a través de Qlik Talend Cloud, mientras que las opciones on-premises y gestionadas por el cliente existen dentro de la familia Data Fabric. Esa variedad puede ayudar a organizaciones con requisitos de despliegue mixtos, pero también hace importante verificar el empaquetado del producto.
Talend no es tanto una biblioteca ligera para desarrolladores como una forma de institucionalizar los flujos de calidad entre distintos roles. Los responsables de datos pueden participar en la remediación, mientras que los equipos de integración conectan los procesos de calidad con el movimiento de datos y la gobernanza en general. El compromiso es la complejidad. No hay una lista pública de precios, los niveles y las SKU pueden ser difíciles de comparar y el cambio de marca bajo Qlik obliga a los compradores a confirmar qué capacidades pertenecen a cada paquete actual.
Talend encaja muy bien en empresas que ya han invertido en el ecosistema de Qlik y Talend. Puede resultar excesivo para una comparación de migración concreta, una biblioteca de restricciones de Spark o un despliegue centrado solo en anomalías. Confirme el empaquetado, el despliegue, el soporte y las licencias actuales en Qlik Talend Data Fabric.
Comparativa de las 10 mejores herramientas de validación de big data
Herramienta | Capacidades principales | UX y calidad (★) | Ventajas diferenciales (✨ / 🏆) | Público objetivo (👥) | Precio / valor (💰) |
|---|---|---|---|---|---|
Data Validation (digna) | Validación a nivel de registro dentro de la base de datos, integrada con anomalías, puntualidad y esquema | ★★★★★ Interfaz compartida, nivel empresarial | ✨ Se ejecuta en la infraestructura del cliente; incidencias correlacionadas → análisis de causa raíz más rápido 🏆 | 👥 Empresas reguladas (finanzas, sanidad, telecomunicaciones, sector público) | 💰 Licencia modular + por tabla activa; transparente y estable según el uso |
Great Expectations (GX) | Suites de expectativas declarativas, perfilado, compatibilidad con múltiples backends | ★★★★ UX centrada en código; GX Cloud añade una interfaz gestionada | ✨ Amplia biblioteca de expectativas, documentación y linaje de pruebas 🏆 | 👥 Ingenieros de datos, equipos que trabajan con código | 💰 OSS gratuito; niveles de pago en GX Cloud (variable) |
Soda (Core + Cloud) | Controles YAML (SodaCL), perfilado, interfaz en la nube, ejecución local a los datos | ★★★★ Pensado para desarrolladores; Cloud para triaje y RBAC | ✨ YAML + fácil integración en pipelines, sugerencias automáticas 🏆 | 👥 Equipos de desarrollo que quieren CI/CD + UX en la nube | 💰 Core OSS gratuito; Cloud = ventas/presupuesto |
Monte Carlo | Monitores de ML (frescura, volumen, esquema), linaje, monitorización de BI | ★★★★★ Triaje de incidencias y runbooks maduros | ✨ Monitorización ML empresarial + flujos de triaje completos 🏆 | 👥 Grandes organizaciones con operaciones de datos maduras | 💰 Vía ventas; modelo de créditos/consumo (variable) |
Anomalo | Detección de anomalías con IA, validaciones declarativas, integraciones con catálogos | ★★★★ Cobertura rápida; interfaz de revisión de incidencias | ✨ Controles automatizados para una cobertura rápida 🏆 | 👥 Equipos que necesitan detección rápida de anomalías a escala | 💰 Precios empresariales vía ventas |
Bigeye | Monitorización automatizada (frescura/volumen/esquema), linaje profundo | ★★★★ Triaje basado en linaje y UX de gobernanza | ✨ Linaje + observabilidad para la gobernanza 🏆 | 👥 Equipos centrados en gobernanza/cumplimiento | 💰 Basado en demo/presupuesto (empresarial) |
Datafold | Comparación de datos a nivel de valor, pruebas de regresión en CI, linaje de columnas | ★★★★ Sólida UX de validación previa a la fusión | ✨ Data diff + integración CI para PR y migraciones 🏆 | 👥 Equipos de ingeniería, flujos con dbt y migraciones | 💰 Vía ventas; opción de despliegue en VPC |
AWS Deequ (OSS) | Restricciones declarativas en Spark, repositorio de métricas, controles a escala Spark | ★★★ Biblioteca (sin interfaz integrada), código/nativo | ✨ Gratuito y nativo de Spark a escala para equipos JVM 🏆 | 👥 Ingenieros de big data JVM/Spark | 💰 Código abierto (gratuito); solo costes de infraestructura/desarrollo |
Acceldata | Monitores de fiabilidad, optimización de costes, estado de la plataforma | ★★★★ Paneles empresariales y herramientas de SLO | ✨ Combina calidad de datos con información de costes/plataforma 🏆 | 👥 Empresas complejas con múltiples plataformas | 💰 Precios empresariales según presupuesto |
Talend Data Quality (Qlik) | Perfilado, limpieza, stewardship, puntuación de confianza | ★★★★ UX madura de gobernanza y stewardship | ✨ Larga trayectoria en calidad de datos + integración 🏆 | 👥 Empresas que se estandarizan en Talend/Qlik | 💰 Niveles de suscripción (vía ventas) |
Elija la herramienta según el fallo que necesita evitar
La elección de la herramienta se aclara cuando el equipo identifica el fallo antes de comparar funciones. Si el riesgo principal es un importe no válido, un estado prohibido, un valor de referencia ausente o un par de campos incoherente, empiece por la validación determinista de registros. digna, Great Expectations, Soda, Talend y Deequ admiten controles basados en reglas, pero difieren en la ejecución, las interfaces, el despliegue y la cantidad de flujo de trabajo adicional que el equipo debe construir.
Si la preocupación es un cambio inesperado en un patrimonio de datos amplio, priorice la detección automatizada de anomalías. Monte Carlo, Anomalo, Bigeye, Acceldata y digna abordan ese problema mediante monitorización y contexto de comportamiento. La pregunta importante no es si una herramienta usa machine learning. Pregunte cómo ajustan los equipos las alertas, asignan responsables, explican una desviación y conectan el evento con su impacto posterior.
Los fallos de frescura y de esquema requieren su propia evaluación. Una suite de reglas puede pasar mientras una carga llega tarde, o un cambio de esquema puede ser técnicamente aceptado por un formato de tabla y, a la vez, romper una suposición en un proceso posterior. La documentación de Apache Iceberg muestra por qué la evolución del esquema necesita un seguimiento activo: los campos pueden añadirse, eliminarse, actualizarse o renombrarse como cambios de metadatos, y los datos antiguos pueden seguir bajo especificaciones de partición anteriores. Un cambio estructuralmente válido sigue necesitando un registro operativo de qué cambió, cuándo entró en vigor y qué consumidores dependen de él.
Los cambios de migración y de transformación requieren comparación de datos y evidencia de regresión, un terreno en el que Datafold encaja mejor que una plataforma de observabilidad general. Los equipos centrados en Spark pueden preferir Deequ porque los controles se ejecutan en el mismo entorno de procesamiento. Las organizaciones que necesitan un triaje guiado por el linaje deberían valorar Monte Carlo, Bigeye, Acceldata o Talend según la profundidad del análisis de impacto y los roles implicados en la remediación.
Siga esta secuencia durante la evaluación:
Defina el fallo: distinga entre infracciones en registros, comportamiento anómalo, entregas tardías, deriva estructural, discrepancias de migración y degradación de la plataforma.
Localice la ejecución: confirme si los controles se ejecutan en el almacén de datos, en el entorno Spark, en una VPC, en una nube privada, en infraestructura on-premises o en un servicio controlado por el proveedor.
Asigne responsabilidades: identifique quién crea las reglas, investiga las alertas, aprueba las excepciones y confirma la remediación.
Ponga a prueba la evidencia: exija resultados reproducibles, registros o métricas afectados, marcas de tiempo, contexto de linaje y un historial de excepciones auditable.
Modele el coste operativo: compare tablas activas, comportamiento de escaneo, consumo de cómputo, créditos, módulos, soporte y esfuerzo de implementación en lugar de basarse en el número de licencias.
Haga un piloto representativo: incluya una tabla crítica, una carga tardía, un cambio de esquema, una infracción conocida de una regla de negocio y un cambio deliberado en una transformación.
La mala calidad de los datos es un riesgo de negocio material. En un informe de 2025 del IBM Institute for Business Value, el 43 % de los directores de operaciones señaló los problemas de calidad de datos como su prioridad de datos más importante. El mismo informe concluyó que más del 25 % de las organizaciones estimaba pérdidas anuales superiores a 5 millones de dólares, mientras que el 7 % declaró pérdidas de al menos 25 millones de dólares. Son estimaciones basadas en encuestas, no una medida contable universal, pero explican por qué la validación debe tratarse como un control de gobernanza y operativo.
Una encuesta de 2025 a más de 200 profesionales de datos reveló que el 23,4 % usaba herramientas específicas de observabilidad de datos, frente al 39,2 % que usaba pruebas automatizadas y el 22,6 % que usaba herramientas de validación como Great Expectations. Este patrón de adopción respalda un enfoque por capas. Los equipos no deberían elegir entre reglas y observabilidad cuando los datos críticos necesitan tanto restricciones de negocio explícitas como avisos tempranos de cambios de comportamiento. Mida la cobertura en producción, el tiempo de investigación, la carga de falsos positivos, la responsabilidad de la remediación y la evidencia conservada.
digna es especialmente relevante cuando la ejecución dentro de la base de datos, el despliegue privado, la monitorización correlacionada y la ampliación modular son requisitos centrales. Ofrece a los equipos una forma de combinar la validación a nivel de registro con controles de anomalías, puntualidad y esquema dentro de su propio entorno. Para otras prioridades, Great Expectations, Soda, Monte Carlo, Anomalo, Bigeye, Datafold, Deequ, Acceldata o Talend pueden encajar de forma más directa.
digna combina la validación de registros dentro de la base de datos con detección de anomalías, monitorización de la puntualidad y seguimiento del esquema en su nube, VPC o centro de datos. Si su equipo necesita controles listos para auditoría sin mover los datos de producción, descubra digna y evalúe la plataforma con un conjunto de datos crítico representativo.
Si el presupuesto descarta por ahora una plataforma comercial, nuestra selección de herramientas gratuitas de validación de datos recoge las opciones de código abierto que merece la pena probar antes de decidirse por uno de los productos anteriores.
Preguntas frecuentes
¿Qué es una herramienta de validación de big data?
Un software que comprueba si grandes conjuntos de datos cumplen las reglas y el comportamiento esperados. Algunas herramientas verifican reglas de negocio a nivel de registro, como rangos, nulos y valores de referencia; otras detectan anomalías de frescura, volumen o distribución, y unas pocas comparan resultados entre versiones para detectar regresiones antes de fusionar un cambio.
¿Qué herramientas de validación de big data son de código abierto?
Great Expectations, Soda Core y AWS Deequ tienen bases de código abierto. Great Expectations usa Expectations declarativas, Soda Core usa la sintaxis SodaCL basada en YAML y Deequ es una biblioteca de Scala y Apache Spark. Cada una cuenta con una capa de pago o gestionada, como GX Cloud o Soda Cloud, para compartir resultados y gestionar alertas.
¿Cuál es la diferencia entre validación de datos y observabilidad de datos?
La validación demuestra que cada registro cumple una lógica de negocio explícita, como un estado permitido o un importe válido. La observabilidad vigila la frescura, el volumen, el esquema y las distribuciones para detectar comportamientos inesperados sin una regla para cada tabla. Monte Carlo y Bigeye se orientan más a la observabilidad, mientras que Great Expectations y Soda se orientan más a las reglas.
¿Se puede validar datos sin sacarlos del almacén de datos?
Sí. digna calcula métricas y ejecuta la validación dentro de las bases de datos del propio cliente, en su nube, VPC o centro de datos, de modo que los datos de producción no se mueven. Deequ también se ejecuta junto a los trabajos de Spark donde ya residen los datos, mientras que varias plataformas SaaS procesan los resultados en un entorno alojado por el proveedor.
¿Cómo elijo la herramienta de validación de big data adecuada?
Identifique el fallo que necesita evitar antes de comparar funciones. Los valores no válidos y las relaciones rotas entre campos requieren validación determinista de registros, los cambios inesperados de volumen o distribución requieren detección de anomalías, y los cambios de código arriesgados requieren una comparación a nivel de valor, como la de Datafold, antes de fusionar una pull request.


