Cómo evaluar la calidad de los datos: guía práctica para equipos
|
6
minuto de lectura

Se nota que la calidad de los datos se deteriora mucho antes de que alguien abra un ticket. El dashboard se actualizó, el pipeline indicó éxito y, aun así, las cifras no cuadran con finanzas, ventas o lo que el negocio esperaba ver. Ese suele ser el momento en que los equipos se dan cuenta de que el problema no es si los datos llegaron, sino si es seguro confiar en ellos.
La mayoría de los equipos empieza con comprobaciones de actualidad y tasas de nulos porque son fáciles de automatizar. Esas comprobaciones importan, pero no indican si una columna cambió de significado de la noche a la mañana, si una fuente empezó a duplicar registros o si un conjunto de datos de aspecto limpio sigue siendo incorrecto para la decisión que respalda. Por eso evaluar la calidad de los datos debe tratarse como un flujo de trabajo de diagnóstico, no como una luz de estado, y por eso un informe erróneo puede proceder de una carga “exitosa”.
Índice
Por qué la mayoría de las comprobaciones de calidad de datos pasan por alto el problema real
Definir los conjuntos de datos críticos y las dimensiones de calidad
Elegir la combinación adecuada de herramientas y automatización
Informar los resultados y operacionalizar el flujo de trabajo
Por qué la mayoría de las comprobaciones de calidad de datos pasan por alto el problema real
Una mañana típica empieza con un pipeline en verde y un hilo de Slack en rojo. La carga terminó, las tablas del warehouse están pobladas y el dashboard de ingresos parece correcto a primera vista, hasta que alguien nota que el total no cuadra porque una fuente cambió el tipo de una columna o una regla de negocio dejó de coincidir con el nuevo formato. El pipeline no falló, pero la capa de decisión sí.
Esa brecha es exactamente la razón por la que el éxito del pipeline y la calidad de los datos no son lo mismo. Un job completado solo demuestra que se movieron bytes, no que los registros sigan significando lo mismo que ayer. Si sus comprobaciones se limitan a la actualidad y al recuento de nulos, se le escaparán problemas de exactitud, contradicciones entre tablas y desviaciones de esquema que rompen el reporting posterior sin previo aviso.
Regla práctica: si una métrica puede ser incorrecta mientras parece presente, necesita una comprobación de calidad que vaya más allá de su existencia.
Los equipos salen escaldados cuando confunden la observabilidad con la evaluación de la calidad. La observabilidad le dice que algo cambió en el flujo, mientras que la evaluación pregunta si los datos siguen siendo aptos para su uso. La diferencia importa en entornos regulados y en flujos de trabajo de IA, donde datos técnicamente limpios pueden ser operativamente inseguros.
El mejor modelo mental interno es sencillo: datos presentes no son datos fiables. Esa es la línea que sus alertas deben defender. Si está analizando la brecha entre dashboards ruidosos y controles accionables, este enfoque de ricos en datos y pobres en información es un complemento útil, porque recoge exactamente el modo de fallo con el que muchos equipos conviven a diario.
Definir los conjuntos de datos críticos y las dimensiones de calidad
Empiece por decidir qué importa antes de escribir una sola comprobación. No todas las tablas merecen el mismo escrutinio y no todos los campos conllevan el mismo riesgo. El alcance adecuado es la intersección entre impacto en el negocio y dependencia aguas abajo, por lo que la primera pregunta siempre es: “¿Qué se rompe si este valor es incorrecto?”
En un entorno regulado, yo delimitaría primero el conjunto de datos en torno a los flujos de trabajo críticos y después identificaría los atributos que realmente controlan esos flujos. Eso suele significar identificadores, marcas de tiempo, claves foráneas, campos de estado, códigos regulatorios y cualquier valor que se agregue en un KPI, un informe o un modelo. Una vez nombrados, defina las seis dimensiones como requisitos medibles, no como ideales abstractos.
Dimensión | Qué mide | Tipo de umbral habitual | Ejemplo de fallo |
|---|---|---|---|
Completitud | Los valores obligatorios están presentes | Estricto en campos obligatorios, más flexible en texto opcional | Falta un ID de cliente obligatorio |
Unicidad | Los registros no están duplicados | Normalmente tolerancia cero en campos clave | La misma transacción llega dos veces |
Consistencia | Los valores no se contradicen entre sistemas o tablas | Comprobaciones de conciliación entre fuentes | El estado del pedido difiere entre el warehouse y la facturación |
Validez | Los valores cumplen los formatos, rangos o reglas permitidos | Aprobado o fallido estricto según patrones definidos | Un identificador fiscal tiene un formato incorrecto |
Exactitud | Los valores coinciden con datos de referencia fiables o con la realidad | Conciliación con fuentes autorizadas | Un código de producto existe, pero apunta al artículo equivocado |
Actualidad | Los datos son lo bastante recientes para su uso previsto | Ventanas de actualidad o compromisos de entrega | Un archivo diario llega después del cierre del reporting |
La trampa es reducir todo eso a una única puntuación. Un conjunto de datos puede estar casi completo y aun así ser inutilizable si los valores válidos son incorrectos u obsoletos. Por eso los umbrales deben estar ponderados por riesgo, con tolerancia cero para algo como un identificador regulatorio no válido y cierta flexibilidad para un campo descriptivo no esencial.
Un buen documento de alcance cabe en una página. Si no puede decir qué tablas importan, qué campos son críticos y por qué se comprueba cada dimensión, el programa derivará en un teatro de casillas marcadas.
Si necesita una forma práctica de identificar los campos críticos y vincularlos a sus responsables, los elementos de datos críticos son el punto de partida adecuado. Para los equipos que definen el alcance conjuntamente entre gobierno de datos e ingeniería, esa alineación ahorra mucho debate posterior.
Aplicar la metodología de evaluación por etapas
La forma más limpia de evaluar la calidad de los datos es secuenciar el trabajo, no improvisarlo. El orden importa porque cada etapa alimenta la siguiente y saltarse una convierte todo el proceso en conjeturas. Empiece por el profiling, luego defina reglas, después fije umbrales y, por último, ejecute consultas e inspeccione los resultados.

Perfilar antes de prescribir
Perfile primero el conjunto de datos. Observe tasas de nulos, tasas de duplicados, rangos de valores, formatos y relaciones referenciales, porque esos patrones le indican dónde están los defectos reales. Sin esa línea base, acabará escribiendo reglas basadas en suposiciones en lugar de evidencias.
Después traduzca los requisitos en pruebas específicas para la dimensión que mide. Un campo de fecha necesita una regla de formato y una regla de rango. Una clave foránea necesita una comprobación referencial. Un código regulatorio puede necesitar un patrón estricto más una conciliación con la fuente de verdad.
Fijar umbrales que reflejen el riesgo
Los umbrales de advertencia y de fallo no deberían ser lo mismo. Un campo que alimenta un dashboard puede tolerar una pequeña tasa de defectos, mientras que un campo que impulsa el reporting de cumplimiento normalmente no. En esa distinción fracasan demasiados programas, porque tratan todos los defectos por igual.
Calcule los resultados a nivel de registro, campo, tabla y dominio, y siga su tendencia en el tiempo. Una sola pasada no dice casi nada. Una tasa de defectos que empeora le indica que una fuente cambió, que un contrato se rompió o que un equipo aguas arriba cambió su comportamiento. Ahí es donde la metodología se vuelve operativa en lugar de decorativa.
Se trata de detectar pronto el caso feo, aquel en el que un conjunto de datos está completo al 99 % pero sigue siendo sustancialmente incorrecto. Si necesita una referencia sobre la terminología de este enfoque, la definición de evaluación de la calidad de los datos es un complemento útil.
Muestreo, validación y reporting honesto
Un resultado sin contexto es un riesgo. Si muestreó 100 registros, nunca debería informar la métrica como si procediera de un análisis completo de la población, porque la incertidumbre forma parte del hallazgo. Conserve el numerador, el denominador, la ventana de observación, la definición de la población y el método de muestreo de cada métrica, e informe intervalos de confianza cuando el resultado se estime a partir de una muestra, como subraya la guía de medición del NIST en su tratamiento de la incertidumbre (NIST SP 800-55).

Informar la distribución, no solo la puntuación
Una estimación de completitud a partir de 100 registros muestreados no es lo mismo que el mismo porcentaje a partir de 100.000 registros. La primera puede ser útil, pero es mucho menos estable y mucho más fácil de malinterpretar. Siga la media, la desviación estándar, los cuantiles y los valores ausentes por segmento para ver dónde se concentra el problema.
Esa segmentación importa porque las puntuaciones agregadas ocultan fallos locales. Una tabla puede parecer correcta en conjunto mientras un país, un sistema de origen o un segmento de clientes se desploma. Si no conserva el desglose, pasará por alto la causa raíz operativa y perderá tiempo discutiendo la cifra global.
No confundir los modos de fallo habituales
Validez no es exactitud. Un valor puede tener el formato correcto y seguir siendo erróneo. Los datos tardíos tampoco son datos ausentes, y la imputación automática puede hacer que la completitud parezca mejor mientras daña la trazabilidad.
Por eso el informe debe declarar la incertidumbre, no ocultarla. Un buen resultado de calidad le dice qué se comprobó, cómo se comprobó, cuánta confianza puede tener y qué partes de la población necesitan atención.
Para los equipos que construyen la parte de captura de este flujo, explorar bloques de captura de datos es una referencia útil para pensar en la disciplina y la estructura de las entradas, sobre todo cuando los sistemas de origen son caóticos. El problema operativo no suele ser la matemática, sino conseguir entradas fiables desde el principio.
También puede asignar las comprobaciones a reglas explícitas y a una lógica de revisión con reglas de validación de datos, comprobaciones y calidad de datos continua, que es donde el reporting deja de ser abstracto y empieza a respaldar una remediación real.
Elegir la combinación adecuada de herramientas y automatización
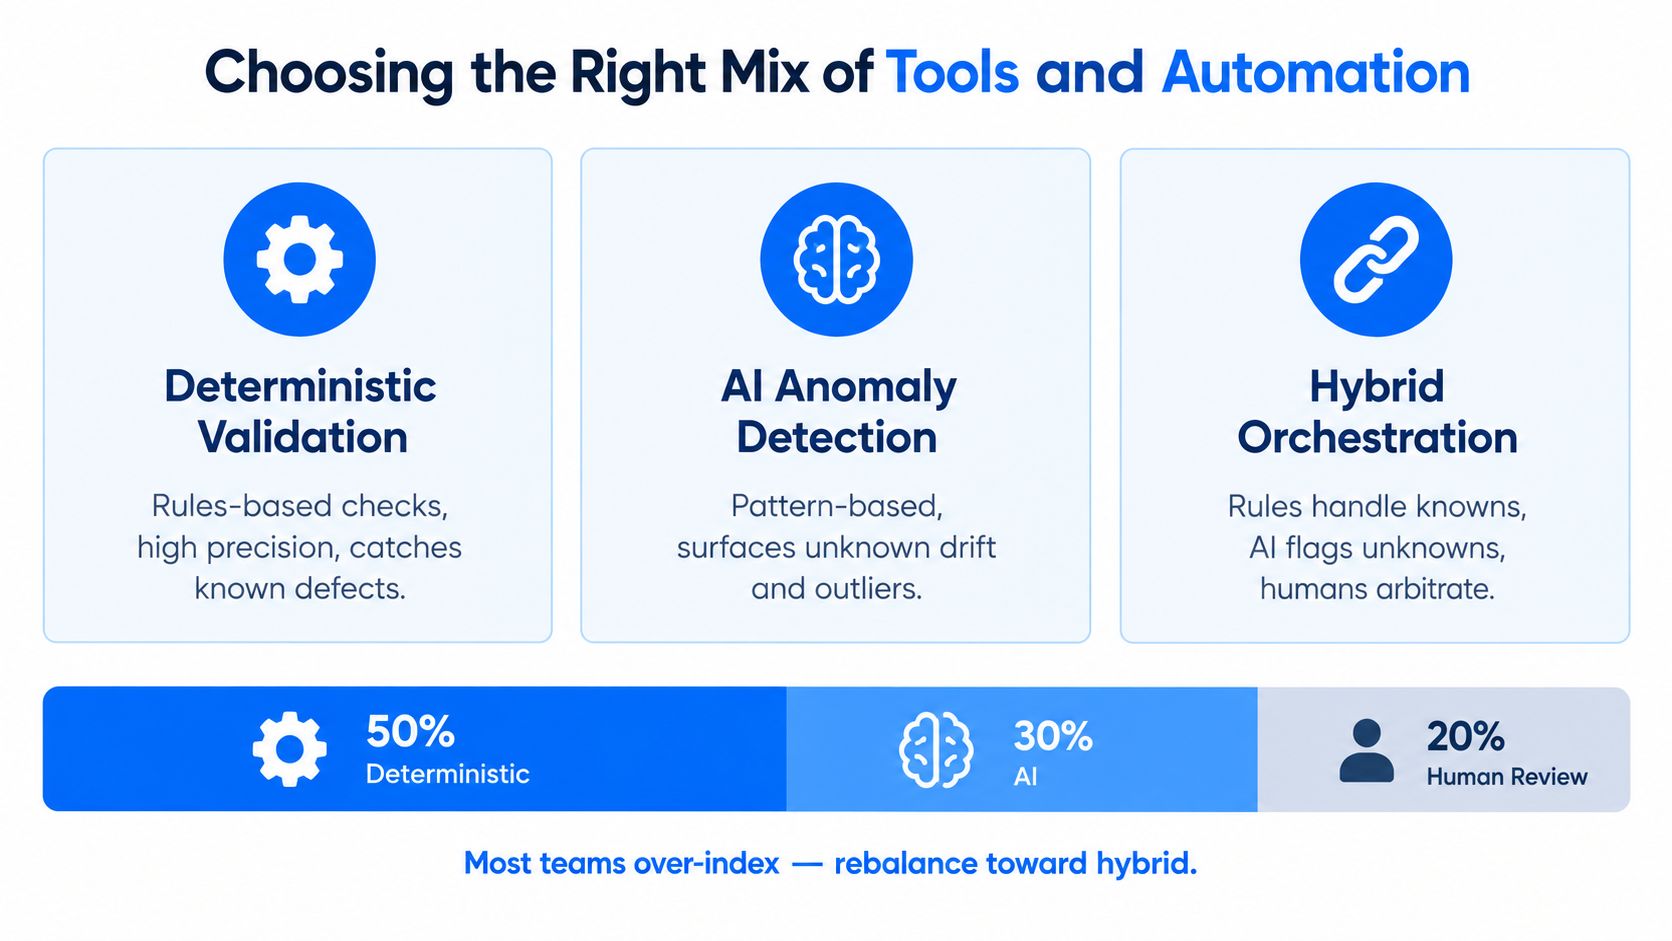
Los buenos programas no lo apuestan todo a un solo tipo de señal. La validación determinista detecta defectos conocidos, la detección de anomalías basada en IA detecta patrones desconocidos, y las comprobaciones de esquema y de actualidad detectan fallos silenciosos antes de que se propaguen. Use las tres, pero asigne cada una al problema que mejor resuelve.
Ajustar la señal al modo de fallo
La validación basada en reglas es la herramienta adecuada cuando el requisito es explícito y auditable. Si un código fiscal debe seguir un formato o una clave foránea debe existir, escriba la regla y haga que el resultado sea reproducible. Esa es la evidencia que quieren los auditores y la forma más rápida de impedir que defectos conocidos entren en su entorno de datos.
La detección de anomalías estadística o basada en IA corresponde allí donde el problema es una deriva de comportamiento. Un cambio de patrón en volumen, distribución o tiempos puede no violar ninguna regla estricta, pero aun así indicar un cambio en la fuente, un problema en un proceso aguas arriba o una suposición rota. Las líneas base aprendidas superan a las comprobaciones estáticas en estos casos, porque el conjunto de reglas no puede anticipar cada nuevo modo de fallo.
No ignorar la monitorización de estructura y de entrega
Los cambios de esquema y las comprobaciones de actualidad merecen su propio lugar en el stack. Un cambio de tipo de columna, un campo añadido o una entrega retrasada pueden romper a los consumidores posteriores antes de que se active cualquier regla a nivel de fila. Estas comprobaciones son básicas, pero ahorran muchos problemas en producción.
La disyuntiva está en el gobierno y la ubicación. La ejecución dentro de la base de datos reduce el movimiento de datos y mantiene el control más cerca de ellos, algo importante en entornos regulados. La adopción modular también ayuda, porque los equipos necesitan empezar con una ruta crítica y ampliarla en lugar de comprar una plataforma gigante que nunca llegan a operar del todo.
No necesita una única herramienta milagrosa. Necesita un stack que se ajuste al perfil de riesgo de los datos, a la carga de cumplimiento del equipo y al tipo de fallos que encuentra su negocio. Si está comparando proveedores o definiendo un estándar interno, las herramientas de calidad de datos son un ancla práctica para esa evaluación.
Cuando datos limpios no son lo mismo que datos seguros
Un conjunto de datos puede superar todas las comprobaciones convencionales y seguir siendo inseguro para la decisión que alimenta. Eso se vuelve evidente muy rápido en el trabajo con IA, porque la pregunta no es solo si los datos están limpios, sino si son relevantes, representativos y adecuados para el grupo afectado. El artículo 10 de la Ley de IA de la UE exige que los datos de entrenamiento, validación y prueba de alto riesgo sean relevantes, suficientemente representativos, lo más completos y libres de errores posible, y estadísticamente adecuados para los grupos y contextos afectados (Ley de IA de la UE, artículo 10).
La limpieza técnica no demuestra la aptitud para el uso
El modelo estándar de seis dimensiones se queda corto aquí. Puede tener datos completos, válidos y únicos que aun así infrarrepresenten a un grupo minoritario, omitan una zona geográfica relevante o reflejen un contexto operativo obsoleto. Ese conjunto de datos puede parecer técnicamente sólido y seguir siendo operativamente inseguro.
La solución práctica es añadir al registro de evaluación la cobertura de subgrupos, el desplazamiento de la distribución y la documentación del uso previsto. En sanidad, finanzas, telecomunicaciones y servicios públicos, esto no es una preocupación teórica. Las puntuaciones de calidad agregadas pueden parecer aceptables mientras la cobertura o las tasas de error de grupos concretos siguen siendo inaceptables.
Tratar la representatividad como un requisito operativo
La representatividad tiene que volverse medible o se queda en vaguedades. Los equipos necesitan umbrales explícitos de cobertura de subgrupos, reglas claras sobre cuándo una deriva es un cambio legítimo de la población y un registro de por qué el conjunto de datos es apto para una decisión concreta. Es la única forma de distinguir una población que cambia de verdad de un sesgo de muestreo dañino.
Aquí también importa la responsabilidad. Alguien tiene que asumir la decisión de si los datos siguen correspondiendo al caso de uso, no solo de si las comprobaciones se superaron. Si el conjunto de datos está limpio pero no es adecuado, la respuesta correcta es detener el flujo de trabajo, no celebrar el dashboard.
Informar los resultados y operacionalizar el flujo de trabajo
El informe debe decir a las partes interesadas qué se comprobó, qué falló, cuánta confianza tiene el equipo en el resultado y quién es responsable de la siguiente acción. Incluya el alcance, las dimensiones evaluadas, los umbrales, los desgloses por segmento, los resultados con su incertidumbre, el estado de la remediación y un responsable claro para cada problema sin resolver. Si necesita una referencia práctica de patrones de documentación operativa, las guías prácticas de Trupeer Inc. son un modelo útil para hacer legibles los pasos de un proceso sin complicarlos en exceso.
Mantener el flujo de trabajo repetible
Los programas más fiables convierten la evaluación en un calendario, no en un proyecto puntual. Programe evaluaciones recurrentes, versione reglas y umbrales, genere alertas ante el deterioro y revise los resultados con las partes interesadas con una cadencia regular. Esto encaja con el modelo de gobierno de la ISO 8000, en el que las normas se revisan cada cinco años y el control de calidad forma parte de la gestión continua, no de un único evento de certificación (ISO 8000-1:2022).
Checklist para el runbook: delimitar los conjuntos de datos críticos, perfilar los datos, definir las reglas, fijar umbrales de advertencia y de fallo, ejecutar las consultas, seguir la tendencia de los resultados, informar la incertidumbre y volver a evaluar según un calendario.
Evite los dashboards de vanidad. Evite las avalanchas de alertas. Ambos producen el mismo resultado: la gente deja de confiar en el programa. Un flujo de trabajo de calidad solo funciona cuando las señales son lo bastante concretas para actuar y lo bastante estables para respaldar a la vez la auditoría, la ingeniería y la analítica.
Si busca una plataforma que se ejecute dentro de su propio entorno y combine validación a nivel de registro, monitorización de la actualidad, seguimiento de esquemas y detección de anomalías, digna es una opción a evaluar para este modelo operativo. Visite digna para ver cómo su enfoque de calidad de datos y observabilidad encaja con conjuntos de datos críticos, entornos regulados y flujos de trabajo preparados para IA.
Para la parte de este stack basada en líneas base aprendidas, vea cómo el módulo digna Data Anomalies detecta cambios en volumen, distribución y tiempos que ninguna regla escrita a mano había previsto.
Preguntas frecuentes
¿Cómo se evalúa la calidad de los datos paso a paso?
La calidad de los datos se evalúa en una secuencia fija: delimitar los conjuntos de datos críticos, perfilar los datos, definir reglas por dimensión, fijar umbrales de advertencia y de fallo, ejecutar las consultas y seguir la tendencia de los resultados. El profiling va primero porque las tasas de nulos, los duplicados y los rangos de valores muestran dónde están los defectos, de modo que las reglas se basan en evidencias.
¿Cuáles son las seis dimensiones para medir la calidad de los datos?
Las seis dimensiones son completitud, unicidad, consistencia, validez, exactitud y actualidad. Cada una debe ser un requisito medible con su propio tipo de umbral, por ejemplo tolerancia cero ante campos clave duplicados o una ventana de actualidad para un archivo diario que debe llegar antes del cierre del reporting.
¿Por qué un pipeline exitoso puede entregar datos erróneos?
Un job completado solo demuestra que se movieron bytes, no que los registros sigan significando lo mismo que ayer. Una fuente puede cambiar el tipo de una columna o empezar a duplicar registros mientras la carga sigue en verde, así que las comprobaciones limitadas a la actualidad y al recuento de nulos no detectan problemas de exactitud, contradicciones entre tablas ni desviaciones de esquema.
¿Cómo deben informarse los resultados de calidad obtenidos por muestreo?
Los resultados muestrales siempre deben indicar su incertidumbre. Conserve el numerador, el denominador, la ventana de observación, la definición de la población y el método de muestreo de cada métrica, e informe intervalos de confianza, ya que una estimación de completitud a partir de 100 registros muestreados es mucho menos estable que el mismo porcentaje a partir de 100.000 registros.
¿Los datos limpios son siempre seguros para la IA?
No, los datos limpios pueden ser inseguros si infrarrepresentan a un grupo, omiten una zona geográfica o reflejan un contexto obsoleto. El artículo 10 de la Ley de IA de la UE exige que los datos de entrenamiento de alto riesgo sean relevantes y suficientemente representativos, por lo que las evaluaciones deben añadir cobertura de subgrupos, desplazamiento de la distribución y documentación del uso previsto.


