De timestamp a datetime: guía completa de conversión
|
6
minuto de lectura

1700000000 no es un datetime, es un timestamp de máquina. Para convertirlo con seguridad, primero identificas la unidad, normalizas a UTC y luego presentas el resultado con un contexto de zona horaria explícito; de lo contrario, corromperás el registro.
Un dashboard roto a las 8:05 de la mañana normalmente no parece roto en absoluto. El gráfico carga, el batch termina y la exportación de facturación llega a tiempo, pero un equipo lee segundos como milisegundos, otro asume la hora local y un tercero formatea un instante sin conservar el valor original. Esa brecha entre los timestamps de máquina y los datetimes legibles por humanos es donde se esconden la mayoría de los problemas de producción.
Índice
Por qué fallan las conversiones de timestamps en producción
Un dashboard que muestra las cifras de ayer, una ejecución ETL que desplaza registros un día o un extracto de facturación que acaba en la región equivocada suelen apuntar a un mismo problema de fondo: el significado ambiguo del timestamp. Un timestamp Unix identifica un instante relativo a la época Unix, que es las 00:00:00 UTC del 1 de enero de 1970, pero el número por sí solo no dice cómo mostrarlo. Los mismos dígitos pueden convertirse en el momento equivocado si un sistema lee segundos y otro milisegundos, o si la zona horaria local de un servidor se cuela en el paso de conversión. La convención Unix trata además cada día civil como exactamente 86.400 segundos lógicos, de modo que la aritmética sigue siendo sencilla, pero los segundos intercalares y las reglas de zona horaria siguen importando cuando el resultado se muestra a personas. (Referencia de la NASA sobre segundos intercalares)
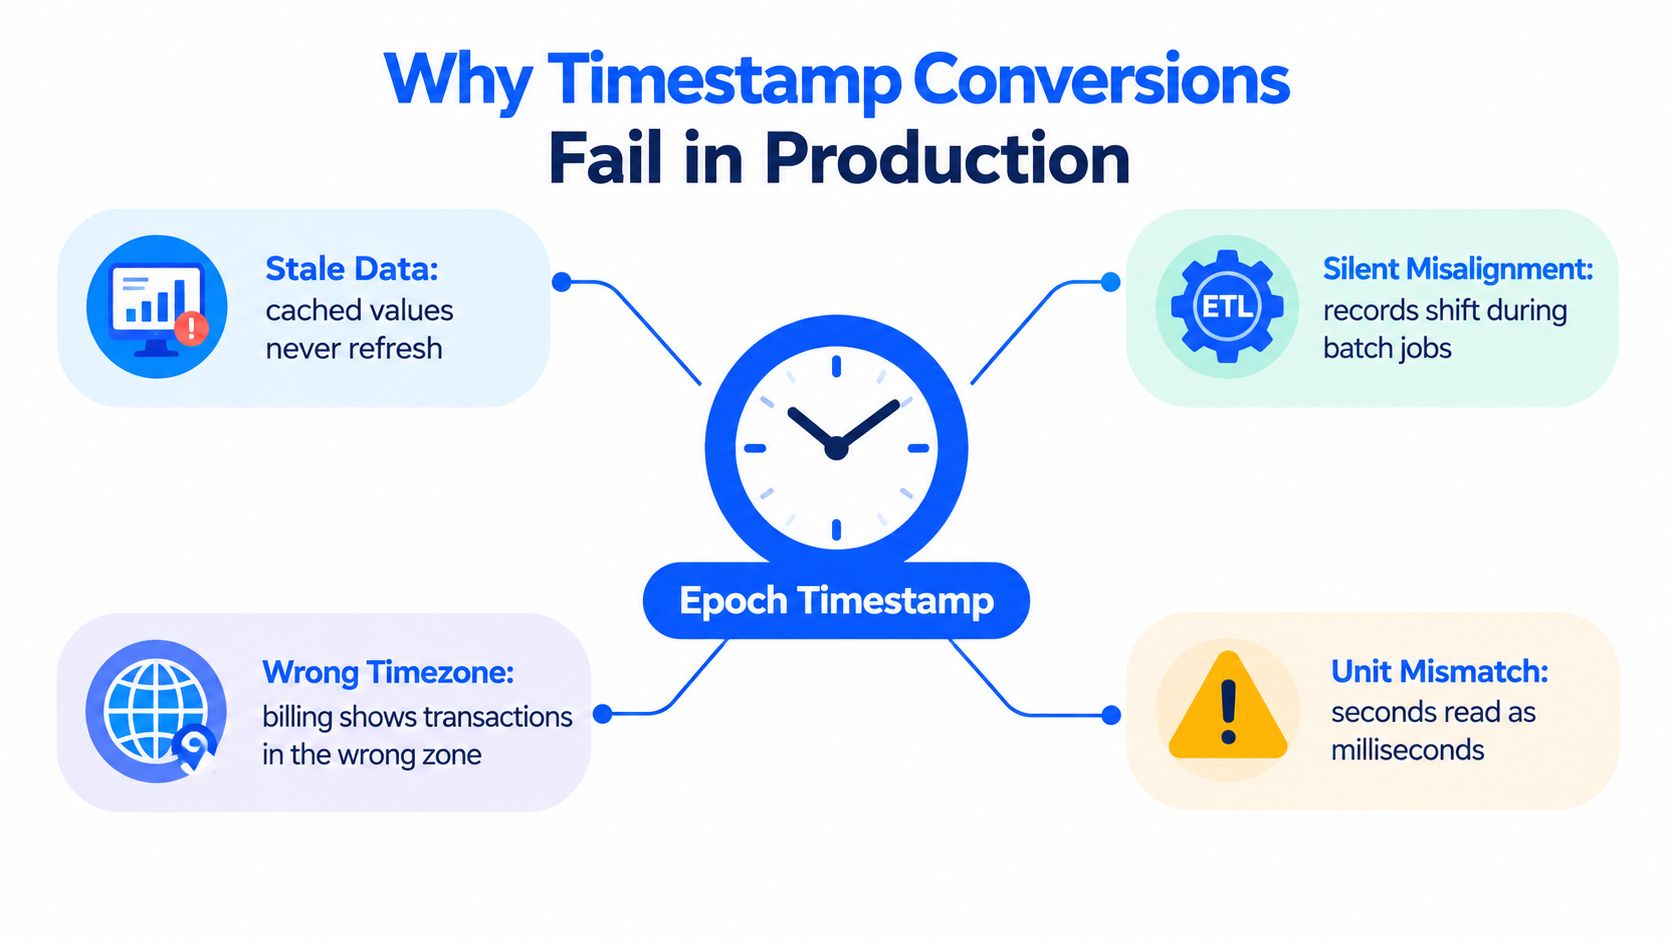
Qué se rompe primero
El primer fallo suele ser un desajuste de unidades. Un valor que debería interpretarse como segundos se lee como milisegundos, y el datetime resultante cae cerca de 1970 o muy fuera del rango esperado. El segundo fallo es la deriva de zona horaria: el timestamp se decodifica correctamente, pero se muestra en el contexto local equivocado.
Regla práctica: trata el valor numérico bruto como fuente de verdad y el datetime formateado como una capa de presentación.
El tercer fallo se oculta en el intercambio entre sistemas. Un servicio escribe UTC, otro lee un valor naive como hora local, y el pipeline sigue «funcionando» porque el resultado parece lo bastante plausible para superar un vistazo rápido. El cuarto fallo es la política de segundos intercalares, porque el tiempo POSIX ordinario ignora los segundos UTC insertados y no puede representar 23:59:60 de forma única. El riesgo no se limita a las visualizaciones bonitas. Aparece en los cortes de facturación, en las cronologías de incidentes y en cualquier conjunto de datos donde el orden importe. Por qué los fallos tempranos de un pipeline suelen ser invisibles al principio ofrece una forma útil de pensar en esos fallos silenciosos en flujos de datos adyacentes.
Cómo es un modelo mental correcto
La secuencia correcta es sencilla, pero cada paso cuenta. Primero, identifica la unidad y el contrato semántico. Segundo, normaliza a un instante absoluto. Tercero, presenta ese instante en UTC o en una zona civil con nombre solo cuando se necesite la salida. Si te saltas alguno de esos pasos, ya no estás convirtiendo un timestamp en un datetime, estás adivinando.
Conversión de timestamps en los sistemas más comunes
Las conversiones más seguras son las que hacen evidentes la unidad y la zona horaria en el código. Python, JavaScript y SQL tienen cada uno sus propios valores por defecto, y es justo en esos valores por defecto donde empiezan los bugs de producción. Si estandarizas una conversión explícita y consciente de la zona horaria, el mismo valor bruto se mantiene reproducible entre servidores, jobs y notebooks.
Python
La biblioteca estándar de Python ofrece un patrón limpio: datetime.fromtimestamp(value, tz=timezone.utc) para una conversión consciente de UTC y, después, astimezone(target_zone) solo cuando se requiere una zona local con nombre. Si omites tz, Python usa la hora local de la plataforma y devuelve un datetime naive, y así es como el mismo código empieza a comportarse de forma distinta según el host. Por eso el paso explícito a UTC es el valor por defecto más seguro. La documentación oficial de datetime también describe la diferencia entre naive y aware y el uso recomendado de timezone.utc. (Documentación de datetime de Python)
JavaScript
El objeto Date de JavaScript almacena milisegundos desde la época Unix, así que los segundos Unix deben multiplicarse por 1000 antes de la conversión. La operación inversa requiere dividir entre 1000, y conviene conservar la precisión fraccionaria cuando importa. La otra trampa es la elección del accessor, porque el almacenamiento basado en UTC no impide que los accessors locales lean a través de la zona horaria de la máquina host. La referencia de MDN sobre Date (en inglés) es un buen recordatorio para mantener explícita esa distinción.
SQL y motores de data warehouse
Los motores SQL varían, así que el hábito más seguro es verificar el tipo de destino y el comportamiento de zona horaria en lugar de suponer que un motor se comporta como otro. PostgreSQL distingue la precisión de los timestamps y admite resolución fraccionaria, mientras que ClickHouse expone funciones separadas para segundos, milisegundos y microsegundos. En la práctica, lo importante no es memorizar cada nombre de función, sino asegurarse de que el tipo almacenado coincide con la unidad de origen y de que la zona horaria de visualización se elige de forma intencionada. La documentación de PostgreSQL sobre fechas y horas es especialmente útil cuando necesitas razonar sobre la precisión y las fracciones de segundo. (Tipos de fecha y hora de PostgreSQL)
Para los equipos que trabajan con distintos formatos de archivo e ingesta en el warehouse, los formatos de archivo Parquet importan porque los campos de timestamp suelen atravesar sistemas con expectativas de precisión diferentes. Un datetime que parece correcto en un motor puede perder su significado cuando un parser posterior asume otra unidad o trunca las fracciones de segundo.
Gestión de zonas horarias más allá de la conversión básica
La decodificación del epoch y la conversión de zona horaria resuelven problemas distintos. La decodificación responde a qué instante representa el registro. La conversión responde a cómo debe aparecer ese instante en un lugar y un contexto histórico concretos. Los sistemas que mezclan esos pasos generan fechas locales que parecen correctas en un entorno y erróneas en otro. La base de datos de zonas horarias de IANA existe porque la historia de las zonas horarias cambia según el lugar y con el tiempo. Registra las reglas de hora local y las actualiza cuando los gobiernos cambian los offsets y las políticas de horario de verano.
Por qué fallan los offsets fijos
Un offset fijo captura un momento, pero no las reglas que hay detrás de ese momento. America/New_York no es lo mismo que UTC-5, porque la zona con nombre incluye el comportamiento del horario de verano y los cambios históricos, y el offset no. Si guardas solo el offset, pierdes la identidad de la ubicación junto con los cambios de reglas asociados.
Python lo gestiona correctamente con tzinfo, que mantiene juntos el offset y el comportamiento de la zona. El patrón más seguro es decodificar primero en UTC y convertir a una zona con nombre en el límite de presentación. Asignar una etiqueta de zona horaria a un datetime naive es una reinterpretación, no una conversión.
Una hora local de reloj puede repetirse en el cambio al horario de invierno y desaparecer en el cambio al horario de verano.
Por qué JavaScript exige más cuidado
El objeto Date de JavaScript se basa internamente en UTC, pero sus accessors de componentes habituales usan la zona horaria local de la máquina host. Un notebook de depuración en un portátil y un contenedor de producción en otra región pueden mostrar campos locales distintos para el mismo instante. El timestamp sigue siendo correcto. Lo que cambia es la ruta de visualización, y eso basta para crear bugs confusos. Para pipelines deterministas, usa accessors UTC o una biblioteca consciente de las zonas horarias, y no dependas de los valores por defecto de la máquina.
La trazabilidad forma parte de la gestión de zonas horarias
Trabajar con zonas horarias no es solo formatear. Los sistemas de finanzas, sanidad o reporting transfronterizo necesitan conservar juntos el instante original, la zona elegida y el estado de la conversión, como campos de metadatos que viajan con el registro y no al lado, en una nota de notebook o en un comentario de ticket.
Esa separación importa en producción. Si falta el instante original, no puedes demostrar qué se recibió. Si falta el estado de la conversión, no puedes saber si un valor se normalizó, se mostró o se reinterpretó más tarde.
Precisión, detección de unidades y pérdida silenciosa de datos
Una conversión de timestamp a datetime puede cambiar algo más que la visualización. Puede destruir precisión, colapsar el orden de los eventos y ocultar la diferencia entre dos registros que ocurrieron en el mismo segundo mostrado pero no en el mismo instante. Por eso la detección de unidades debe tratarse como un contrato de esquema y no como una suposición basada en el número de dígitos. Las prácticas de exactitud en la calidad de datos son especialmente relevantes aquí, porque una elección de precisión equivocada sigue pareciendo «válida» para los sistemas posteriores.
Por qué contar dígitos es una trampa
Un entero largo no te dice si la fuente usa segundos, milisegundos, microsegundos o nanosegundos. Un valor de 13 dígitos puede ser milisegundos en un feed, mientras que otro sistema puede usar una escala completamente distinta. Si divides entre 1000 porque el número «parece» estar en milisegundos, puedes crear un datetime plausible pero sutilmente erróneo.
PostgreSQL admite una precisión de timestamp de cero a seis dígitos fraccionarios, lo que basta para mostrar por qué esto importa. Si tu fuente lleva microsegundos y tu destino solo almacena valores al segundo, pierdes información de orden aunque el resultado se muestre limpiamente. Esa pérdida puede afectar a la deduplicación, la medición de latencia, la correlación de incidentes y las pistas de auditoría.
Qué conservar
Guarda el valor numérico original. Guarda la unidad de origen. Guarda la precisión de destino. Después, presenta el datetime legible solo cuando esos valores sean explícitos. Si la fuente usa fracciones de segundo, consérvalas en una forma que no redondee mediante coma flotante, a menos que tu sistema pueda tolerar esa pérdida.
La salida legible por humanos es útil para las personas, pero puede ocultar la verdad operativa de que dos eventos eran distintos.
Los timestamps de estilo POSIX también merecen una redacción cuidadosa. Son cómodos para la aritmética porque cada día se trata como 86.400 segundos, pero no son un reloj físico perfecto y no cuentan por separado los segundos intercalares. Esa distinción importa en los sistemas de observabilidad, donde el pipeline puede necesitar distinguir entre «el mismo segundo mostrado» y «el mismo evento subyacente».
Cómo construir un pipeline de timestamps para producción
Un pipeline de producción debería avanzar siempre en el mismo orden. Primero, parsear el valor bruto y confirmar la unidad de origen. Validar magnitud, precisión y nulabilidad frente al contrato. Normalizar a UTC. Convertir a una zona horaria local con nombre solo para la presentación. Emitir un formato explícito como ISO 8601 con Z o un offset. Esa secuencia evita que el mismo registro cambie de significado al pasar de un servicio a otro.

El flujo de trabajo que resiste en producción
Empieza por el contrato antes de tocar el formateador. Un campo de timestamp debe declarar si está en segundos, milisegundos u otra unidad, y si representa UTC o una hora civil local. Incluye esa declaración en la documentación del esquema, en los checks del pipeline y en los fixtures de prueba, para que el parser y el revisor juzguen lo mismo.
Normaliza el instante antes de cualquier formateo de visualización. JavaScript necesita una multiplicación o división explícita alrededor del almacenamiento en milisegundos de Date. Python debe crear primero datetimes UTC aware. SQL debe usar tipos conscientes de la zona horaria y evitar casts silenciosos que dependan de la configuración de sesión. Solo después conviene convertir a la zona horaria del negocio, y solo si un consumidor posterior necesita una presentación local.
Los equipos que comparan piezas de orquestación y warehousing pueden usar los componentes de un pipeline de datos moderno como referencia de las partes móviles. La regla práctica es más sencilla: cada salto debe llevar el valor bruto, la unidad de origen, la zona horaria de presentación y el resultado de la validación. Así se puede seguir depurando sin volver a ejecutar todo el pipeline.
El timestamp numérico original nunca debería desaparecer solo porque se haya mostrado un datetime en un informe. Conserva ambos. Uno es el campo de auditoría y el otro la capa de visualización. Los controles de calidad de los pipelines de datos son más sólidos cuando ambos sobreviven a cada salto.
Validar conversiones con pruebas de casos límite
Los bugs de timestamps aparecen en los extremos. Valores que se ven bien en una demo rápida suelen fallar en producción, así que la batería de pruebas debe atacar a propósito los casos incómodos. Incluye cero, valores negativos anteriores al epoch, fracciones de segundo, nulos, cadenas no numéricas y timestamps cercanos a los cambios de horario de verano. La misma batería debe cubrir también las fechas máximas admitidas cerca de los límites del sistema y verificar que los accessors UTC de JavaScript se mantienen coherentes con los locales en distintos entornos. Las prácticas de pruebas de calidad de datos son más sólidas cuando exploran los casos feos y no solo el camino feliz.
Qué probar primero
Cero y valores anteriores al epoch: confirma que el pipeline gestiona
0y los timestamps negativos de forma coherente, o que los rechaza con un motivo claro.Precisión fraccionaria: verifica que los microsegundos o milisegundos sobreviven a la conversión cuando el contrato de origen los exige.
Momentos de cambio de horario: prueba horas locales repetidas y omitidas para que la capa de visualización no etiquete mal el instante.
Entradas nulas y no numéricas: confirma que el pipeline rechaza los registros erróneos sin adivinar.
Timestamps en el límite superior: comprueba el mayor rango de datetime que admiten tu base de datos, tu runtime o tu formato de serialización.
Qué registrar
Registra la unidad de origen, los metadatos de zona horaria de origen, el instante UTC normalizado, el estado de validación y cualquier motivo de error. Esos metadatos hacen reproducible la revisión de incidentes, sobre todo cuando un entorno actualiza sus datos de zonas horarias mientras otro se queda atrás. La base de datos de IANA cambia con el tiempo, así que la reproducibilidad depende tanto de conocer la versión como de que el código sea correcto.
Una conversión que no se puede reproducir a partir de los logs no ha sido validada.
Una comprobación final debería comparar el valor original con el datetime mostrado tras un viaje de ida y vuelta, cuando esté soportado. Si el instante devuelto cambia, la ruta de conversión sigue perdiendo información. Conservar el timestamp bruto junto al datetime facilita mucho la revisión de auditoría, porque un campo preserva el valor de máquina y el otro muestra la forma legible.
Si quieres que esos contratos de timestamp - unidad, rango plausible, precisión y nulabilidad - se apliquen en cada carga y no solo en las baterías de pruebas, digna Data Validation los ejecuta como reglas directamente dentro de tu base de datos.
Preguntas frecuentes
¿Cómo convierto un timestamp Unix en un datetime en Python?
Usa datetime.fromtimestamp(value, tz=timezone.utc) para obtener un datetime consciente de UTC y llama a astimezone() con una zona ZoneInfo como America/New_York solo cuando necesites mostrarlo en hora local. Si omites tz, Python usa la hora local del host y devuelve un datetime naive, por lo que los resultados varían entre servidores.
¿Por qué mi timestamp convertido muestra una fecha de 1970?
Una fecha cercana a 1970 casi siempre indica un desajuste de unidades: un valor en segundos se leyó como milisegundos, así que el instante cae justo después de la época Unix, las 00:00:00 UTC del 1 de enero de 1970. Confirma la unidad de origen en el contrato del esquema en lugar de deducirla por el número de dígitos.
¿America/New_York es lo mismo que UTC-5?
No. UTC-5 es un offset fijo que describe un único momento, mientras que America/New_York es una zona IANA con nombre que incluye las reglas de horario de verano y los cambios históricos. Si guardas solo el offset, pierdes la identidad de la ubicación y cada cambio de regla asociado, y las horas locales se desvían.
¿Qué debe guardar un pipeline de timestamps además del datetime formateado?
Conserva el valor numérico original, la unidad de origen, la precisión de destino, la zona horaria usada para mostrarlo y el resultado de la validación. El valor bruto es el campo de auditoría y el datetime es solo la capa de presentación, así que ambos deben viajar con el registro en cada salto del pipeline.
¿Qué casos límite deben cubrir las pruebas de conversión de timestamps?
Empieza por cero y los valores negativos anteriores al epoch, las fracciones de segundo, los nulos y las cadenas no numéricas, además de los momentos de cambio de horario en los que las horas locales se repiten o desaparecen. Añade fechas cercanas a los límites de tu base de datos o runtime y comprueba que un viaje de ida y vuelta devuelve el mismo instante.


