Wie man die Datenvollständigkeit misst: 8 praktische Methoden
|
8
min. Lesezeit
Die Datenvollständigkeit wird gemessen, indem die tatsächlich vorhandenen erforderlichen Daten mit den erwarteten Daten verglichen werden. Die grundlegende Formel lautet Vollständigkeitsrate = (Datensätze mit Daten / Datensätze insgesamt) × 100. Wenn also 9.800 Telefonnummern von 10.000 erwarteten Werten ausgefüllt sind, ergibt dies eine Vollständigkeitsrate von 98 % (Data Quality Sense erklärt die Standardberechnung).
Eine Transaktions-Pipeline kann ein erfolgreiches Laden melden, während dem Unternehmen dennoch unvollständige Daten vorliegen. Die Anzahl der Datensätze kann drastisch sinken, erforderliche Kundenfelder können mehr NULL-Werte als gewöhnlich enthalten oder eine gesamte Berichtsdatei kommt gar nicht erst an. Die Pipeline lief, aber der Datensatz ist für die nachgelagerte Entscheidung möglicherweise nicht vollständig genug.
Datenvollständigkeit ist der Grad, in dem alle für eine beabsichtigte Verwendung erforderlichen Daten vorhanden sind. Dazu gehören fehlende Feldwerte, fehlende Datensätze, fehlende Transaktionen, fehlende Datensätze, fehlende historische Perioden und fehlende erforderliche Attribute. Ein Kundendatensatz mit gültigem Namen und gültiger Adresse, aber ohne Kunden-ID, ist für jeden Prozess, der von dieser Kennung abhängt, unvollständig.
Eine zuverlässige Überwachung muss daher über einen einzigen Prozentsatz hinausgehen. Sie sollte ausgefüllte Felder, vollständige Datensätze, Datensatzvolumen, erwartete Datensätze, Bereitstellungszeiten und ungewöhnliche historische Änderungen untersuchen. Die acht praktischen Methoden unten bauen diese Ansicht Schritt für Schritt auf und verknüpfen jede Messung mit Validierung, Anomalieerkennung, Aktualität und historischer Analyse in digna.
Inhaltsverzeichnis
6. Anomalieerkennung und historische Trendanalyse für Vollständigkeit
7. Datenvollständigkeit versus Genauigkeits- und Gültigkeitsbewertung
1. Feld-Vollständigkeitsrate
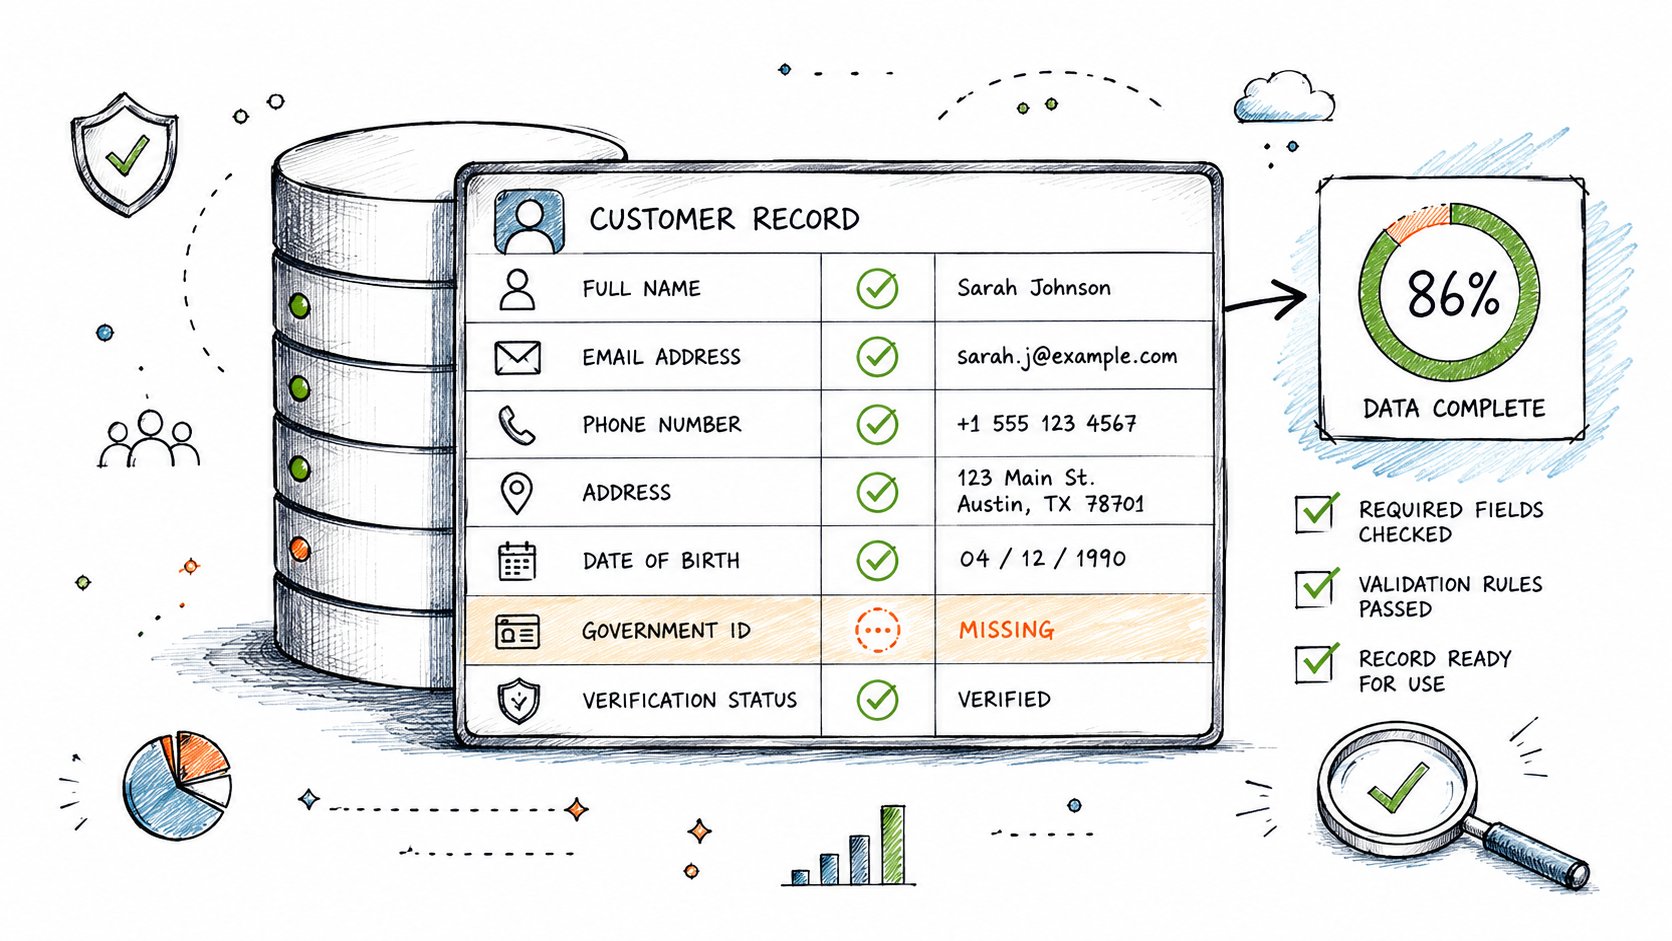
Ein Kundenprofil kann Namen und Adresse enthalten, bleibt aber unbrauchbar, wenn die erforderliche Kunden-ID leer ist. Die Feld-Vollständigkeitsrate misst diese erste Ebene der Vollständigkeit: Wie viele der in einer Spalte erwarteten Werte sind ausgefüllt. NULLs, leere Zeichenfolgen und andere definierte Markierungen für fehlende Werte gehören in die Prüfung.
Verwenden Sie die folgende Berechnung:
Vollständigkeitsrate = ausgefüllte Werte / erwartete Werte × 100
Wenn beispielsweise eine Kontotabelle 4.500 erwartete E-Mail-Adressen enthält und 4.365 davon ausgefüllt sind, beträgt die Feld-Vollständigkeitsrate 97 %. Diese prozentuale Methode folgt den Richtlinien zur Vollständigkeit von Data Quality Sense.
Der Nenner muss der Geschäftsregel entsprechen. Eine Kunden-ID kann für jede Transaktion erforderlich sein, sodass alle Transaktionszeilen in den Nenner gehören. Ein Feld, das nur für berechtigte Kunden gilt, sollte an dieser berechtigten Population gemessen werden. Die Einstufung nicht zutreffender Zeilen als fehlend würde das Ergebnis schlechter aussehen lassen, als der Prozess tatsächlich ist.
Schwellenwerte nach geschäftlicher Nutzung festlegen
100 % ist der ideale Referenzpunkt für viele regulierte Felder. Service-Levels für Pflichtfelder können über 95 % festgelegt werden, je nach Geschäftsrisiko und den Folgen fehlender Werte, wie SailPoint diese Praktiken zur Zielsetzung beschreibt. Eine Transaktionskennung erfordert möglicherweise eine vollständige Abdeckung, während ein beschreibendes Attribut mit geringerem Risiko eine begrenzte Unvollständigkeit zulassen kann, wenn die nachgelagerten Benutzer die Einschränkung kennen.
Legen Sie einen Schwellenwert für jedes wichtige Feld fest, anstatt sich auf den Durchschnitt eines einzelnen Datensatzes zu verlassen. Ein Durchschnitt kann eine schwerwiegende Lücke in einer Kennungsspalte verbergen. Data Quality Sense empfiehlt, die Null-Rate als zentrales Vollständigkeitssignal zu behandeln. Kombinieren Sie die Rate daher mit expliziten NULL- und Leerwertprüfungen.
In digna kann die digna Data Validation diese Prüfungen für Kunden-IDs, Transaktionsbeträge, Zeitstempel, Kontonummern und andere Pflichtattribute ausführen. Speichern Sie die Ergebnisse nach Feld und Quellsystem. Dieser Verlauf unterstützt die Validierung beim Erfassen, die Anomalieerkennung nach einer Änderung und den späteren Vergleich der Vollständigkeit über verschiedene Zeiträume hinweg.
Praktische Regel: Dokumentieren Sie, welche Felder für jeden Geschäftsprozess erforderlich sind, bevor Sie Schwellenwerte festlegen. Ein Prozentsatz ist nur dann aussagekräftig, wenn die erwartete Population und der Verwendungszweck klar sind.
2. Überwachung der Datensatzanzahl
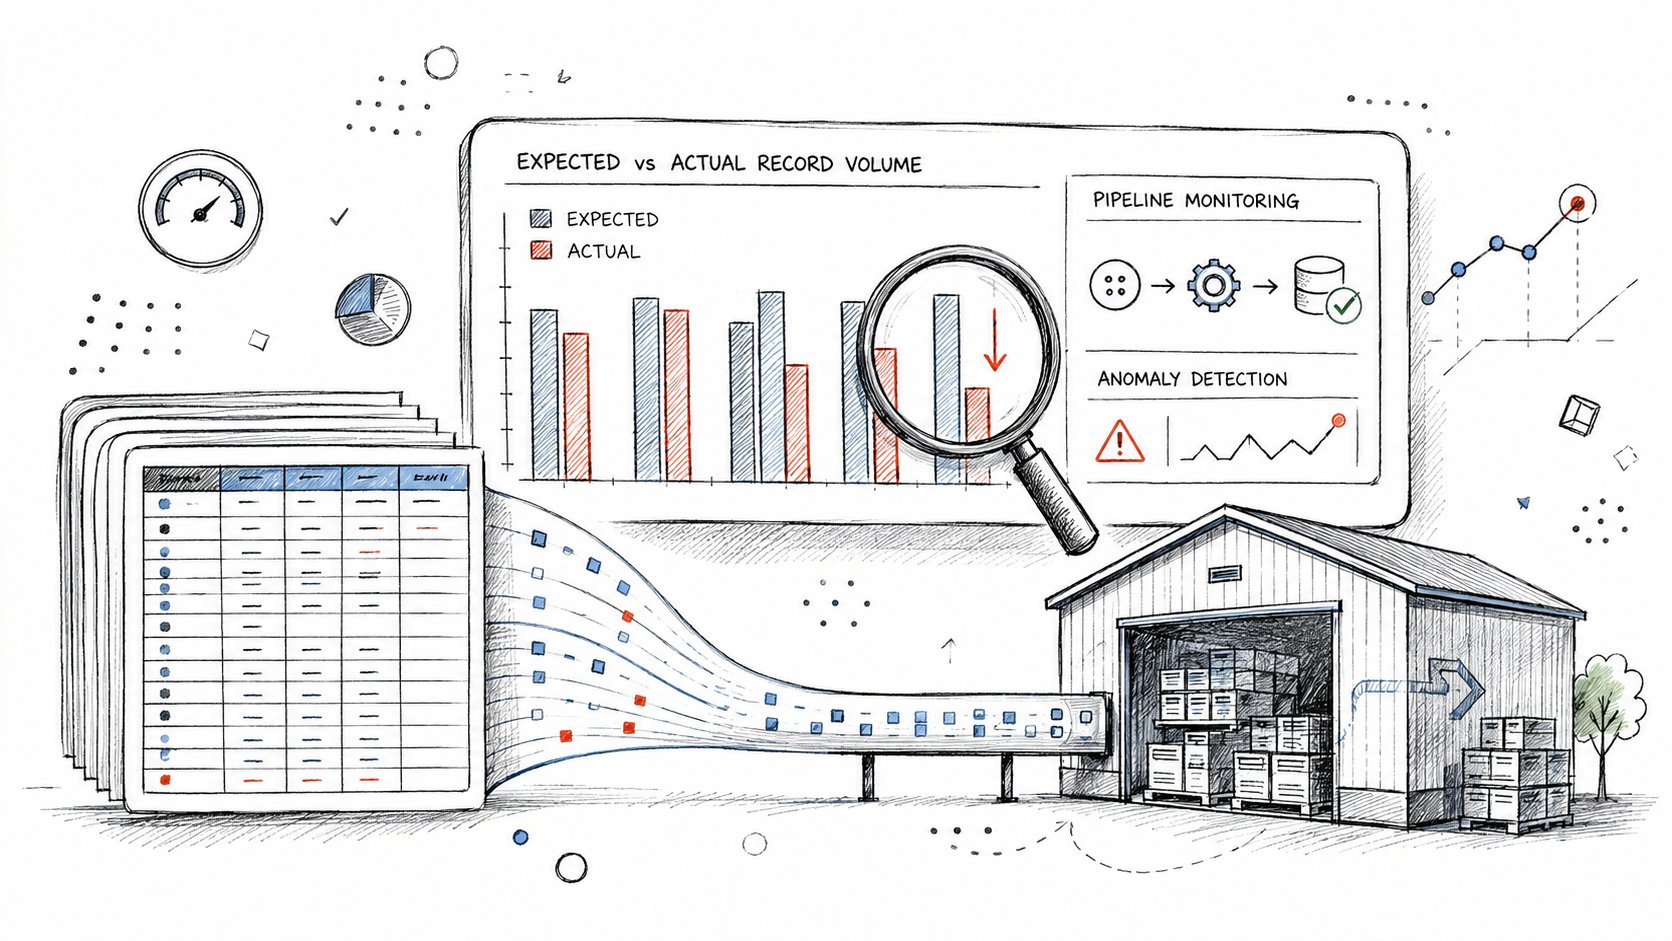
Ein Datensatz kann gut gefüllte Felder enthalten und dennoch unvollständig sein, weil ganze Datensätze gar nicht erst angekommen sind. Die Überwachung der Datensatzanzahl vergleicht die Anzahl der geladenen Zeilen mit einem erwarteten Volumen, einem definierten Minimum oder dem historischen Verhalten desselben Datensatzes.
Betrachten Sie eine tägliche Transaktionstabelle, die normalerweise 10 Millionen Datensätze empfängt, sich plötzlich aber nur noch auf 7 Millionen beläuft. Diese Änderung kann auf einen unvollständigen Datenladevorgang oder fehlende Quelldatensätze hinweisen. Dieses Beispiel ist Teil des bereitgestellten Betriebsszenarios und veranschaulicht, warum ein erfolgreicher Pipeline-Status nicht beweist, dass alle erwarteten Geschäftsereignisse übermittelt wurden.
Prüfungen der Datensatzanzahl funktionieren auf zwei Ebenen. Eine absolute Regel kann eine Anzahl kennzeichnen, die unter einem geschäftlich definierten Minimum liegt. Eine vergleichende Prüfung kann eine ungewöhnliche Änderung im Vergleich zum historischen Verlauf des Datensatzes selbst kennzeichnen. Der zweite Ansatz ist wertvoll, wenn das tatsächliche Volumen je nach Wochentag, Saison, Region oder Buchungszyklus variiert.
Rückgänge und Anstiege untersuchen
Ein plötzlicher Rückgang ist eine offensichtliche Warnung, aber ein unerwarteter Anstieg kann ebenfalls auf Duplikate, erneut abgespielte Dateien, eine Join-Explosion oder eine Änderung des Quellsystems hinweisen. Teams sollten die Anzahl zusammen mit der Ladezeit, der Partition, der Quelle und dem Geschäftsdatum aufbewahren, damit Ermittler den betroffenen Bereich schnell eingrenzen können.
Vermeiden Sie es, einen generischen Bereich von einem anderen Datensatz zu kopieren. Ermitteln Sie das erwartete Verhalten aus dem Verlauf der Tabelle selbst und berücksichtigen Sie bekannte Geschäftszyklen wie die Monatsendverarbeitung oder saisonale Nachfrage. Die Quelldaten können auch in Batches ankommen, sodass die Prüfung zu einem Zeitpunkt durchgeführt werden sollte, an dem der Ladevorgang voraussichtlich abgeschlossen ist.
digna Data Anomalies kann ungewöhnliches Verhalten beim Datensatzvolumen identifizieren, ohne dass Ingenieure für jede Tabelle einen eigenen Schwellenwert pflegen müssen. Setzen Sie das Volumensignal in Relation zur Feldvollständigkeit. Eine geringere Zeilenanzahl in Kombination mit einem Anstieg fehlender Kunden-IDs deutet auf ein umfassenderes Erfassungsproblem hin, während eine geringere Anzahl bei stabiler Feldabdeckung auf eine fehlende Partition oder ein fehlendes Geschäftssegment hindeuten kann.
Die Überwachung der Datensatzanzahl gilt auch für fehlende Zeilen innerhalb eines Zeitraums. Wenn ein Quellsystem Transaktionen für jede Region oder Geschäftseinheit liefern soll, vergleichen Sie die Zahlen anhand dieser Dimensionen und nicht nur auf Ebene der Gesamttabelle. Eine vollständig aussehende Gesamtsumme kann einen fehlenden regionalen Auszug verbergen, der durch höhere Aktivitäten an anderer Stelle ausgeglichen wird.
3. Überwachung der NULL-Rate
Die Überwachung der NULL-Rate misst den Anteil der erwarteten Werte, die fehlen, und verfolgt diesen Anteil im Zeitverlauf. Auf Feldebene wird er wie folgt berechnet:
NULL-Rate = Null- oder leere Werte / erwartete Werte insgesamt × 100
Vollständigkeit und NULL-Rate beschreiben zwei Seiten desselben Zustands. Die Vollständigkeit zeigt, was ausgefüllt ist; die NULL-Rate zeigt, was fehlt. Data Quality Sense identifiziert die NULL-Rate als zentrales Vollständigkeitsmaß.
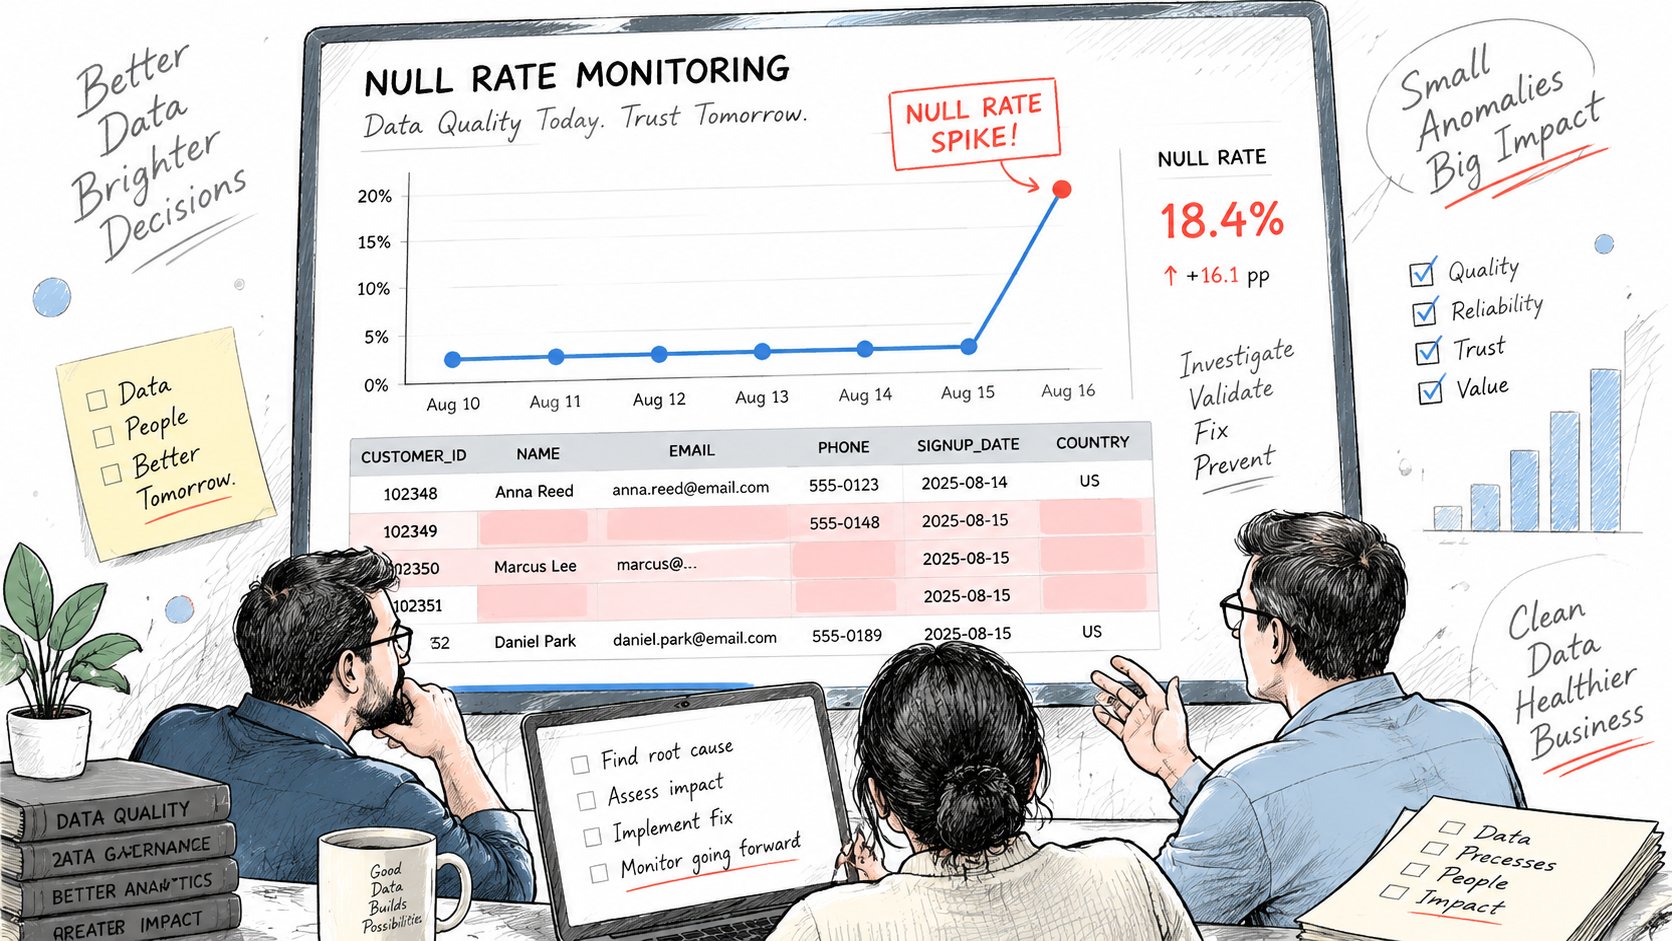
Die aktuelle Rate ist nur ein Teil der Bewertung. Ein Feld mit stabiler, akzeptierter Unvollständigkeit kann den beabsichtigten Prozess unterstützen, während ein plötzlicher Anstieg auf eine fehlerhafte Schnittstelle, eine geänderte Zuordnung, eine fehlgeschlagene Transformation oder ein verändertes Quellverhalten hindeuten kann. Vergleichen Sie das aktuelle Ergebnis mit der eigenen Baseline des Feldes und verknüpfen Sie es mit Validierungsergebnissen, Ladezeiten und Quelländerungen.
Fehlende Werte als Kontext betrachten, nicht nur als Anzahl
Ein NULL-Wert bedeutet nicht immer dasselbe. Er kann für einen nicht erfassten Wert stehen, für ein Feld, das nicht zutrifft, für eine absichtliche Auslassung oder für einen speziellen Status, der in verschiedenen Systemen unterschiedlich codiert ist. Klassifizieren Sie NULLs, leere Zeichenfolgen, Platzhaltertext und spezielle Codes, bevor Sie ein qualifiziertes Vollständigkeitsmaß berechnen. Unabhängige Dokumentationen zur Datenqualität warnen davor, dass eine ungenaue Erfassung von fehlenden Werten irreführend sein kann, wenn diese schlecht codiert sind.
Berechtigungsregeln verhindern, dass zulässige Nicht-Anwendbarkeit als Fehler erscheint. Vergleichen Sie beispielsweise ein Feld für den Rechnungskontakt nur bei Datensätzen, für die ein Rechnungskontakt erforderlich ist. Trennen Sie auch Quellen und Erfassungspfade, da ein Kundenstamm und ein manuell gepflegtes Servicesystem unterschiedliche normale Muster aufweisen können.
Ein praktisches Überwachungsmodell kombiniert vier Prüfungen:
Statische Anforderung: Warnung ausgeben, wenn ein Pflichtfeld seine akzeptierte NULL-Rate überschreitet.
Historische Änderung: Warnung ausgeben, wenn die aktuelle Rate ungewöhnlich von der Baseline des Feldes abweicht.
Quellenvergleich: Verhalten nach Quellsystem, Region oder Erfassungspfad untersuchen.
Änderungskorrelation: Bereitstellungen, Schnittstellenänderungen und Zuordnungsaktualisierungen neben Verschiebungen der NULL-Rate überprüfen.
Die Vollständigkeitsreferenz von Data Quality Sense beschreibt ausgefüllte, Null- und unvollständige Anzahlen als nützliche Überwachungsansichten. Diese Anzahlen verknüpfen eine Warnung mit der Untersuchung. Analysten können die betroffenen Datensätze, Quellen, Zeiträume und Geschäftsbedingungen identifizieren und dann das Muster der fehlenden Werte mit Validierungsfehlern oder verzögerten Ladevorgängen vergleichen.
4. Bewertung der Datensatzvollständigkeit
Die Feldvollständigkeit fragt, ob einzelne Spalten ausgefüllt sind. Die Datensatzvollständigkeit fragt, ob jeder Datensatz den vollständigen Satz an Attributen enthält, die für einen bestimmten Prozess erforderlich sind. Dieser Unterschied ist wichtig, da mehrere Felder jeweils akzeptabel aussehen können, während dieselben Kundendatensätze nur teilweise ausgefüllt sind.
Angenommen, ein Kundendatensatz erfordert eine Kunden-ID, einen Namen, eine E-Mail-Adresse und eine Anschrift. Die Datensatzvollständigkeit zählt, wie viele Kundendatensätze alle vier erforderlichen Attribute enthalten. Ein Ergebnis wie 97 % der Kundendatensätze enthalten alle erforderlichen Attribute liefert Prozesseigentümern andere Erkenntnisse als vier separate Feldprozentsätze. Die Definition und Berechnung auf Datensatzebene werden in den Richtlinien zur Vollständigkeit der Pedowitz Group beschrieben.
Die richtigen Anforderungen hängen von der nachgelagerten Verwendung ab. Ein Prüfungsprozess benötigt vor der Überprüfung möglicherweise einen vollständigen Kreditantrag. Ein Abrechnungsprozess benötigt eventuell eine Kontonummer, eine Serviceadresse und einen Rechnungskontakt. Ein Berichtsdatensatz erfordert möglicherweise einen Zeitstempel und einen Business Key, selbst wenn ein beschreibendes Feld optional ist.
Das Muster hinter unvollständigen Datensätzen finden
Beginnen Sie mit einer Regel auf Datensatzebene, die alle Pflichtfelder zusammen bewertet. Behalten Sie dann die einzelnen Fehlergründe bei. Das kombinierte Ergebnis zeigt Ihnen, wie viele Datensätze verwendbar sind, während die Gründe auf Feldebene zeigen, was die Verwendung der verbleibenden Datensätze verhindert.
Beispielsweise kann ein E-Commerce-Kaufdatensatz eine Bestell-ID, eine Kunden-ID, eine Produkt-ID, eine Menge, einen Preis und einen Zeitstempel erfordern. Ein Datensatz, bei dem einer dieser Werte fehlt, sollte die Regel für vollständige Datensätze nicht bestehen, wenn die Umsatzanalyse von der vollständigen Kombination abhängt.
Nutzen Sie die digna Data Validation für Prüfungen auf Datensatzebene anhand expliziter Geschäftsanforderungen. Trennen Sie Datensatztypen, wenn sich ihre Anforderungen unterscheiden. Ein Kunde, eine Transaktion, ein Schadensfall und ein Serviceauftrag sollten nicht automatisch dieselbe Vollständigkeitsdefinition teilen.
Ein vollständiger Datensatz ist nicht dasselbe wie ein vollständiger Datensatzbestand. Sie benötigen beide Ansichten, um zu verstehen, ob einzelne Zeilen verwendbar sind und ob die erwartete Population überhaupt angekommen ist.
Verfolgen Sie zwei Ergebnisse:
Abdeckung vollständiger Datensätze: Der Anteil der Datensätze, die alle Anforderungen für den beabsichtigten Prozess erfüllen.
Fehlerzusammensetzung: Die Felder, die in unvollständigen Datensätzen am häufigsten fehlen.
Diese Kombination unterstützt die Fehlerbehebung. Wenn eine kleine Anzahl von Feldern in vielen Datensätzen fehlt, beheben Sie die Quelle oder die Zuordnung. Wenn viele Felder in einer kleinen Gruppe von Datensätzen fehlen, untersuchen Sie eine bestimmte Quelle, einen bestimmten Datensatztyp oder eine bestimmte Erfassungspartition.
5. Verifizierung der Datensatz- und Periodenvollständigkeit
Einige Vollständigkeitsfehler treten oberhalb der Zeilen- und Spaltenebene auf. Der gesamte erwartete Datensatz fehlt möglicherweise, ein Berichtszeitraum ist unvollständig oder eine Quelle liefert keine Daten mehr für eine bestimmte Region. Die Verifizierung der Datensatz- und Periodenvollständigkeit fragt, ob die erwarteten Dateien, Tabellen, Partitionen und Geschäftsdaten überhaupt existieren.
Typische Prüfungen umfassen:
Erwarteter Dateieingang: Bestätigen, dass die tägliche Verkaufs- oder Abrechnungsdatei eingegangen ist.
Abdeckung des Zeitraums: Überprüfen, ob alle erwarteten Tage, Monate oder Quartale vertreten sind.
Quellenabdeckung: Überprüfen, ob jede Geschäftsregion oder jedes vorgelagerte System Daten geliefert hat.
Vorhandensein von Partitionen: Bestätigen, dass das Warehouse die erwarteten Datums- und Entitätspartitionen enthält.
Ein Datensatz kann die Validierung auf Feldebene bestehen, weil die eingetroffenen Zeilen perfekt ausgefüllt sind. Dieses Ergebnis rechtfertigt jedoch immer noch nicht die Veröffentlichung eines Berichts, wenn ein ganzer Berichtszeitraum fehlt. Die Vollständigkeit muss im Abgleich mit dem Berichtskalender und dem Geschäftsumfang bewertet werden.
Lieferzeitpunkt zur Vollständigkeitsdefinition hinzufügen
Der Lieferzeitpunkt liefert ein betriebliches Signal. Wenn eine tägliche Datei innerhalb eines definierten Zeitfensters erwartet wird und nicht angekommen ist, steht der Datensatz für den Prozess nicht zur Verfügung, selbst wenn er später noch auftauchen sollte. digna Timeliness kann Eingangsmuster überwachen, fehlende oder verzögerte Ladevorgänge kennzeichnen und erwartete Lieferzeiten aus dem beobachteten Verhalten berechnen.
Definieren Sie für ein praktisches Framework für Datenvollständigkeitsprüfungen eine Erwartung für jeden Datensatz:
Nennen Sie die Quelle und das Ziel.
Geben Sie das erwartete Geschäftsdatum oder die erwartete Partition an.
Definieren Sie das Lieferzeitfenster und die Zeitzone.
Erfassen Sie Abhängigkeiten von vorgelagerten Dateien oder Jobs.
Legen Sie eine Wiederherstellungsmaßnahme für eine fehlende oder verspätete Lieferung fest.
Dieser Ansatz hilft Teams, eine fehlende tägliche Verkaufsdatei zu bemerken, bevor ein Dashboard mit einer unbemerkten Lücke ausgeführt wird. Er unterstützt auch die Datenerfassung für IEP-Teams, bei der erwartete Zeiträume und erforderliche Datensätze explizit nachverfolgt werden müssen, anstatt sie aus den zufällig verfügbaren Daten abzuleiten.
Dokumentieren Sie Fallback-Quellen und Verfahren zur erneuten Ausführung. Ein fehlender Datensatz kann die Folge eines Quellenausfalls, eines Planungsfehlers, einer abgelehnten Datei oder einer verspätet abgeschlossenen Abhängigkeit sein. Die Warnung sollte Ermittler auf diese Möglichkeiten hinweisen, anstatt jedes Fehlen als denselben Defekt zu behandeln.
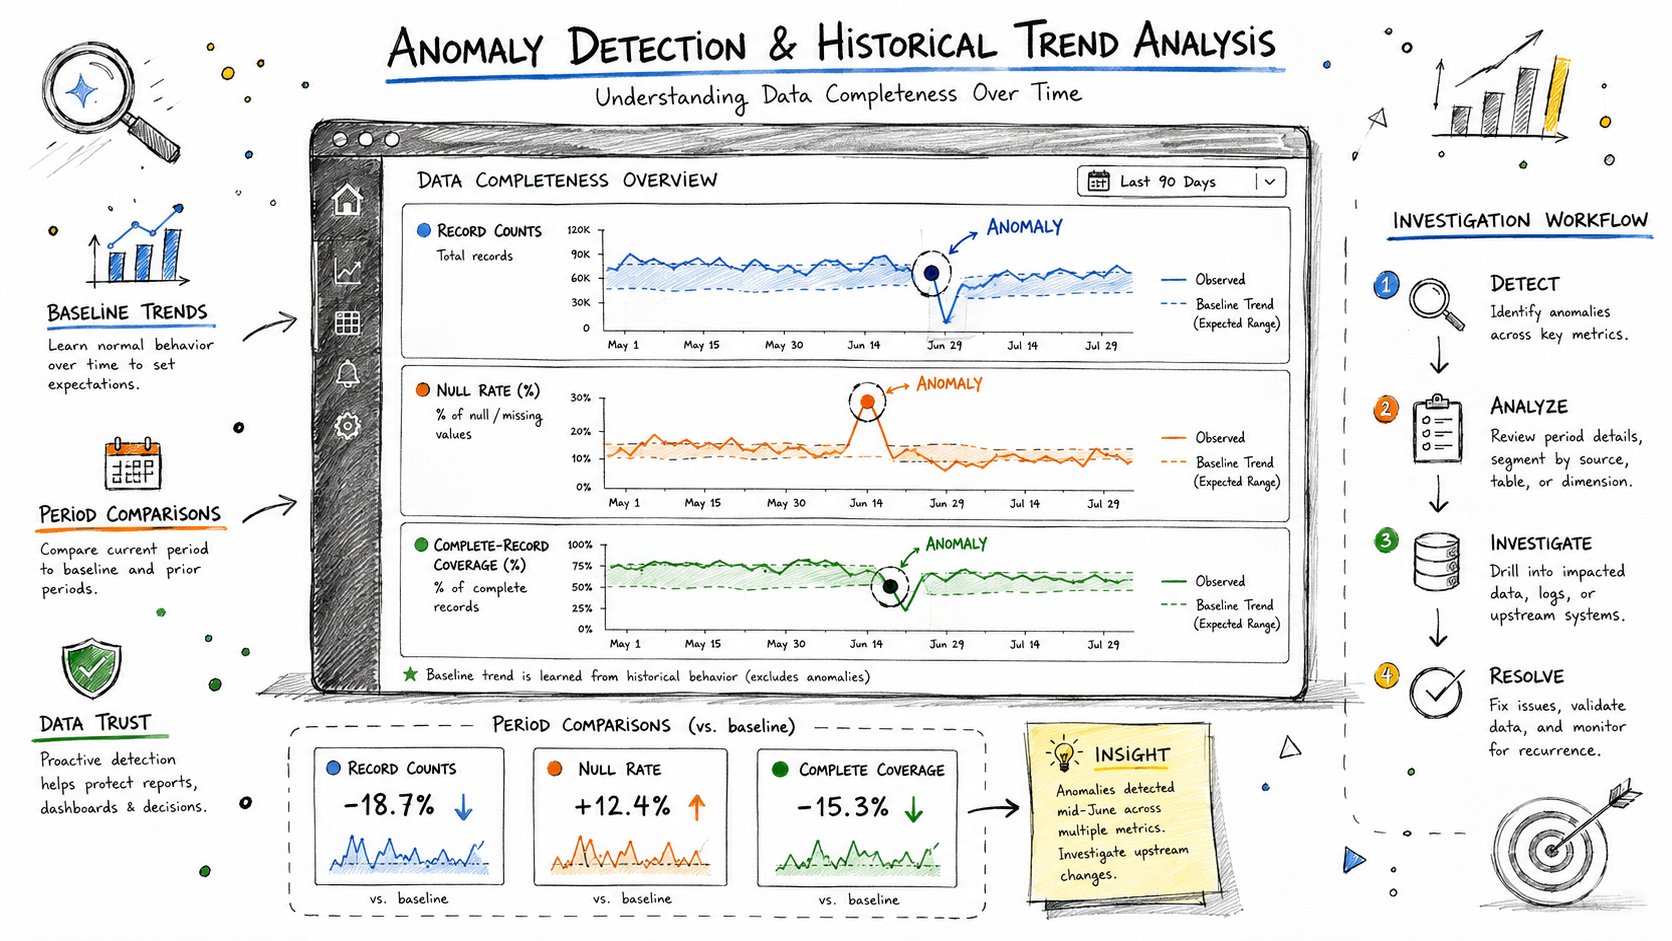
6. Anomalieerkennung und historische Trendanalyse für Vollständigkeit
Feste Regeln identifizieren bekannte Anforderungen. Anomalieerkennung und historische Trendanalysen identifizieren Vollständigkeitsmuster, die sich ohne eine vordefinierte Fehlerbedingung ändern. Nützliche Signale sind NULL-Raten, ausgefüllte Werte, Datensatzanzahlen, die Abdeckung vollständiger Datensätze, Lieferzeiten und das Vorhandensein erwarteter Zeiträume.
Ein Datensatz kann sich schleichend verschlechtern. Die Anzahl der Datensätze kann über mehrere Ladevorgänge hinweg sinken, oder ein Pflichtfeld wird nach einer Systemänderung weniger ausgefüllt. Jede Metrik kann über ihrem Warnschwellenwert bleiben, während das Gesamtrisiko wächst. Der historische Vergleich macht diese Richtung sichtbar, ähnlich wie der Vergleich des heutigen Werts mit der etablierten Baseline eines Patienten, anstatt ihn isoliert zu beurteilen.
Nutzen Sie dignas Ansatz zur Anomalieerkennung in Zeitreihen, um das aktuelle Vollständigkeitsverhalten mit gelernten Mustern zu vergleichen. Ziel ist es, signifikante Änderungen zur Überprüfung zu kennzeichnen, nicht jede Abweichung als Defekt einzustufen.
Baselines mit Fachbereichsbeurteilung kombinieren
Eine Anomalie wird erst nützlich, wenn ihr Kontext geprüft wurde. Ein Abstimmungsprozess am Monatsende kann ein wiederkehrendes Muster erzeugen. Ein neuer Registrierungsworkflow kann absichtlich ändern, welche Felder ausgefüllt werden. Eine Quellenmigration kann einen vorübergehenden Übergang schaffen, der eine separate Handhabung erfordert.
Überprüfen Sie Signale in einem regelmäßigen Rhythmus und halten Sie die Beobachtungen fest. digna Data Analytics bietet historischen Kontext für Trends, Volatilität, wiederkehrende Fehler und Unterschiede zwischen Zeiträumen. Analysten können fragen, wann die Änderung begann, ob sie alle Quellen betrifft und ob sie einem Zeitplan folgt.
Nutzen Sie diese Abfolge:
Erkennen: Finden Sie eine ungewöhnliche Änderung des Volumens, der NULL-Rate oder der Abdeckung vollständiger Datensätze.
Lokalisieren: Brechen Sie das Signal nach Quelle, Region, Partition, Datensatztyp oder Prozess auf.
Korrelieren: Vergleichen Sie es mit Bereitstellungen, Schemaänderungen, betrieblichen Ereignissen und Lieferverzögerungen.
Validieren: Fragen Sie den Fachbereichsverantwortlichen, ob die Änderung erwartet wird.
Beheben: Reparieren Sie die Quelle oder Pipeline und bestätigen Sie, dass die Metrik wieder einen akzeptablen Zustand annimmt.
Speichern Sie Vollständigkeitsbeobachtungen konsistent. Eine tägliche Erfassung eignet sich für viele betriebliche Datensätze, während Pipelines mit hohem Volumen möglicherweise häufigere Prüfungen erfordern. Eine Trendanalyse ist nur dann zuverlässig, wenn die Metrikdefinition, der Umfang und das erwartete Verhalten stabil bleiben. Bewahren Sie diese Details bei jeder Beobachtung auf, damit spätere Vergleiche eine Messwertänderung nicht mit einer Änderung der Datenqualität verwechseln.
7. Datenvollständigkeit versus Genauigkeits- und Gültigkeitsbewertung
Vollständigkeit ist notwendig, beantwortet aber nicht jede Frage zur Datenqualität. Vollständigkeit fragt, ob die erforderlichen Daten vorhanden sind. Genauigkeit fragt, ob sie die Realität korrekt abbilden. Gültigkeit fragt, ob sie den definierten Regeln entsprechen.
Eine Telefonnummer verdeutlicht den Unterschied anschaulich:
Fehlender Wert: Ein Vollständigkeitsproblem.
Vorhanden, aber falsch formatiert: Ein Gültigkeitsproblem.
Richtig formatiert, gehört aber einer anderen Person: Ein Genauigkeitsproblem.
Die gleiche Unterscheidung gilt für eine Kunden-ID. Eine ausgefüllte ID kann eine Feldvollständigkeitsprüfung bestehen, während sie die Gültigkeit verfehlt, wenn sie gegen das erwartete Format oder die erwartete Beziehung verstößt. Sie kann auch die Genauigkeit verfehlen, wenn sie den falschen Kunden identifiziert.
Dimensionen zusammen überwachen
Nutzen Sie die digna Data Validation, um explizite Prüfungen für erforderliche Werte, Formate, Bereiche, Beziehungen und Geschäftslogik anzuwenden. Dieser Leitfaden für Tools zur Gültigkeitsprüfung bietet nützlichen Kontext, um die Validierung als umfassender als die bloße NULL-Erkennung zu behandeln.
Eine gemeinsame Qualitätsansicht sollte die Dimensionen separat und zusammen zeigen. Der Weg zur Fehlerbehebung unterscheidet sich:
Vollständigkeitsfehler: Finden Sie heraus, warum der Wert, Datensatz oder Zeitraum fehlt.
Gültigkeitsfehler: Korrigieren Sie das Format, die Domäne, den Typ oder die Beziehungsregel.
Genauigkeitsfehler: Vergleichen Sie den Wert mit einer vertrauenswürdigen Quelle oder einem realen Ereignis.
Bedingte Anforderungen spielen ebenfalls eine Rolle. Ein Attribut ist möglicherweise nur dann zwingend erforderlich, wenn ein anderes Feld anzeigt, dass der Datensatz berechtigt ist. Eine einfache globale Vollständigkeitsbewertung kann gültige Design-Auslassungen bestrafen, es sei denn, die Regel enthält diese Bedingung.
Die trügerische Sicherheit eines hohen Scores vermeiden
Ein Datensatz, bei dem jedes erforderliche Feld ausgefüllt ist, kann dennoch falsche Adressen, ungültige Kontonummern oder falsche Transaktionsbeträge enthalten. Umgekehrt kann ein Datensatz genaue Werte für die empfangenen Zeilen enthalten, während ein ganzer Quellzeitraum fehlt.
Vollständigkeit ist ein Beweis dafür, dass die erforderlichen Informationen vorhanden sind. Sie ist kein Beweis dafür, dass die Informationen korrekt, gültig, zeitnah oder für jede Analyse ausreichend sind.
Priorisieren Sie Probleme nach geschäftlichen Auswirkungen. Ein konsistent ausgefülltes Feld mit falschen Werten kann ein größeres Risiko darstellen als ein optionales Attribut mit gelegentlich fehlenden Werten. Geschäftsanwender sollten helfen, diese Priorität zu definieren, da sie verstehen, wie sich jeder Fehler auf Berichte, Betrieb, Compliance und Entscheidungen auswirkt.
8. Kontinuierliche Überwachungsstrategie
Ein zuverlässiges Vollständigkeitsprogramm kombiniert deterministische Validierung, Anomalieerkennung, Aktualitätsüberwachung und historische Analysen. Jede Ebene beantwortet eine andere Frage. Die Validierung fragt, ob bekannte Anforderungen erfüllt sind. Die Anomalieerkennung fragt, ob das aktuelle Verhalten von der normalen Baseline abweicht. Die Aktualitätsüberwachung prüft, ob die erwarteten Daten bei Bedarf eintreffen, während die historische Analyse zeigt, ob eine Lücke isoliert, wiederkehrend, saisonal oder sich verschlimmernd ist.
Definieren Sie zunächst, was einen Datensatz verwendbar macht und was einen Datensatzbestand verwendbar macht. Verknüpfen Sie dann jede Definition mit der richtigen Messung:
Pflichtfeldvalidierung: Fehlende Pflichtwerte wie eine Kunden-ID oder einen Transaktionsbetrag erkennen.
Validierung auf Datensatzebene: Bestätigen, dass ein berechtigter Datensatz alle für seine beabsichtigte Verwendung erforderlichen Attribute enthält.
Überwachung der Datensatzanzahl: Fehlende oder unerwartet duplizierte Populationen identifizieren.
Aktualitätsüberwachung: Verspätete, vorzeitige oder fehlende Lieferungen erkennen.
Anomalieerkennung: Ungewöhnliche Änderungen des Volumens, der NULL-Raten, des Lieferverhaltens oder der Abdeckung vollständiger Datensätze kennzeichnen.
Historische Analyse: Die Vollständigkeit über verschiedene Zeiträume hinweg vergleichen, um Wiederholungen und langfristige Änderungen zu identifizieren.
Schemaüberwachung: Strukturelle Änderungen erfassen, die neue fehlende Werte verursachen können.
Diese Ebenen funktionieren wie verschiedene Instrumente auf demselben Kontrollpanel. Eine Feldprüfung kann zeigen, dass Werte vorhanden sind, während eine Prüfung der Datensatzanzahl offenbart, dass eine gesamte Quellpopulation nie angekommen ist. Eine Aktualitätswarnung kann dann erklären, warum sich beide Signale geändert haben.
digna unterstützt dieses Betriebsmodell durch Data Validation, Data Anomalies, Data Analytics, Timeliness und Schema Tracker. Metrikberechnung und -analyse werden direkt in den Datenbanken des Kunden ausgeführt. Bereitstellungsoptionen für die Private Cloud und On-Premises unterstützen die Kontrollanforderungen von Unternehmen.
Signale korrelieren, bevor Zuständigkeiten zugewiesen werden
Angenommen, die Validierungsfehler steigen, während die Datensatzanzahl sinkt und eine Quelle verspätet eintrifft. Zusammen können diese Signale auf einen einzigen unvollständigen vorgelagerten Auszug hindeuten. Behandeln Sie das Ereignis als eine einzige Untersuchung, anstatt separate Tickets zu öffnen, die den Zusammenhang verschleiern.
Eine praktische Routine sieht so aus:
Erforderliche Felder und berechtigte Datensätze gemeinsam mit den Fachbereichsverantwortlichen definieren.
Erwartungen an Volumen, Periodenabdeckung und Eingangszeitpunkt festlegen.
Deterministische Prüfungen auf bekannte Anforderungen anwenden.
Baselines für wichtige Vollständigkeitsmetriken etablieren.
Warnungen über Validierung, Anomalien, Aktualität und Schemaänderungen hinweg korrelieren.
Wiederkehrende Probleme und Trends mit den Datenverantwortlichen überprüfen.
Regeln überarbeiten, wenn sich Geschäftsprozesse oder Quellsysteme ändern.
Interpretieren Sie fehlende Werte anhand von Berechtigung, Codierung, Quellkontext und nachgelagerter Verwendung. Ein fehlender Wert kann bei einem nicht berechtigten Datensatz erwartet werden, während ein fehlender Zeitraum oder ein fehlender Datensatzbestand auf einen Lieferfehler hindeuten kann. Forschungen zu Mechanismen fehlender Daten zeigen, dass reine Vorhandenseinsindikatoren allein möglicherweise nicht zeigen, ob das Fehlen strukturell informativ oder verzerrt ist.
8-Punkte-Vergleich: So messen Sie die Datenvollständigkeit
Methode | 🔄 Komplexität der Implementierung | ⚡ Ressourcenanforderungen | 📊 Erwartete Ergebnisse | 💡 Ideale Anwendungsfälle | ⭐ Hauptvorteile |
|---|---|---|---|---|---|
Feld-Vollständigkeitsrate | Gering, einfache SQL-/NULL-Prüfungen | Gering, minimaler Rechen-/Speicheraufwand | % Vollständigkeit auf Feldebene; fehlende Felder lokalisieren | Einhaltung von Pflichtfeldern, Audits, grundlegende Validierungen | Transparent, einfach zu implementieren, direkt umsetzbar |
Überwachung der Datensatzanzahl | Gering, periodische Zählungen und Baselines | Gering, leichtgewichtige Aggregationen, historische Zählungen | Erkennt fehlende Ladungen und Volumenanomalien | Überwachung von Batch-/Stream-Ladungen, Erkennung von Pipeline-Fehlern | Schnelle Erkennung fehlender Datensätze; geringe Kosten |
Überwachung der NULL-Rate | Mittel, Trendverfolgung & Baselining | Mittel, historische Metriken & Überwachung | Trends/Spitzen bei NULL-Anteilen im Zeitverlauf | Felder, bei denen fehlende Werte Änderungen in Quellen signalisieren | Sensibel für neu auftretende Probleme; Frühwarnungen |
Bewertung der Datensatzvollständigkeit | Mittel–Hoch, feldübergreifende Regeln pro Datensatz | Mittel, Berechnungsaufwand pro Datensatzvalidierung | % der Datensätze, die alle erforderlichen Attribute enthalten | Nachgelagerte Prozesse, die vollständige Datensätze benötigen (Prüfung, Abrechnung) | Geschäftsrelevante Metrik; priorisiert die Fehlerbehebung |
Verifizierung der Datensatz- & Periodenvollständigkeit | Gering, Vorhandenseins-/Zeitplanprüfungen | Gering, minimale Prüfungen + Zeitplan-Metadaten | Bestätigt den Eingang von Datensätzen/Dateien und die Periodenabdeckung | Geplante Batches, regulatorische/periodische Berichterstattung | Verhindert Berichte über unvollständige Zeiträume; einfach durchzusetzen |
Anomalieerkennung & historische Trendanalyse | Hoch, ML-Baselines & Zeitreihenanalyse | Hoch, historischer Speicher, ML-Berechnungen | Erkennt ungewöhnliche Abweichungen und schleichende Verschlechterung | Komplexe Pipelines, saisonale Muster, Unternehmensüberwachung | Erfasst subtile/schleichende Probleme; weniger Fehlalarme |
Vollständigkeit vs. Genauigkeits- & Gültigkeitsbewertung | Hoch, integriert mehrere Qualitätsdimensionen | Hoch, dimensionsübergreifende Prüfungen und Tools | Ganzheitliches Qualitätsprofil (Vollständigkeit+Genauigkeit+Gültigkeit) | Data Governance, Priorisierung der Fehlerbehebung, Audits | Verhindert einseitige Fehlerbehebungen; fokussiert auf geschäftliche Auswirkungen |
Kontinuierliche Überwachungsstrategie (Integriert) | Hoch, kombiniert Regeln, Anomalien, Analysen | Hoch, mehrere Module, Korrelation von Warnungen | Umfassende Abdeckung mit korrelierten Warnungen & Kontext | Unternehmen mit kritischen Pipelines und heterogenen Quellen | Kombiniert die Stärken aller Methoden; reduziert unerkannte Probleme |
Vom Vollständigkeitsprozentsatz zum Datenvertrauen
Keine einzelne Metrik beweist, dass ein Datensatz für jeden Zweck vollständig ist. Eine Feld-Vollständigkeitsrate kann zeigen, dass erforderliche Werte ausgefüllt sind, aber sie zeigt keine fehlende Datei, eine fehlende Geschäftsregion, eine verspätete Lieferung oder einen schleichenden Rückgang des Datensatzvolumens. Ein Prozentsatz vollständiger Datensätze kann zeigen, dass Zeilen verwendbar sind, beweist jedoch nicht, dass die erwartete Population überhaupt angekommen ist.
Das robusteste Messmodell durchläuft mehrere Ebenen:
Feldebene: Sind die erforderlichen Werte ausgefüllt?
Datensatzebene: Enthält jeder verwendbare Datensatz alle erforderlichen Attribute?
Volumenebene: Ist die erwartete Anzahl an Datensätzen eingetroffen?
Datensatzebene (global): Sind die erwarteten Dateien, Tabellen und Partitionen vorhanden?
Periodenebene: Decken die Daten jedes erforderliche Geschäftsdatum oder jeden Berichtszeitraum ab?
Aktualitätsebene: Sind die Daten innerhalb des erwarteten Zeitfensters eingetroffen?
Verhaltensebene: Verhalten sich NULL-Raten, Anzahlen und ausgefüllte Werte normal?
Qualitätsdimensionsebene: Sind die vorhandenen Daten auch genau und gültig?
Diese vielschichtige Ansicht verhindert, dass ein erfolgreicher Pipeline-Status fälschlicherweise als Beruhigungssignal gewertet wird. Sie hilft Teams auch, den richtigen Verantwortlichen zuzuweisen. Ein fehlender erforderlicher Wert liegt möglicherweise im Verantwortungsbereich des Quellanwendungsteams. Eine fehlende Partition gehört eventuell zur Datenerfassung. Eine verspätete Datei erfordert möglicherweise eine Untersuchung der Pipeline oder des Schedulers. Eine Schemaänderung erfordert unter Umständen die Abstimmung mit den nachgelagerten Konsumenten.
„Vollständig“ für die Entscheidung definieren
Das akzeptable Maß an Vollständigkeit hängt von der beabsichtigten Verwendung ab. Richtlinien zur Datenqualität der Universität Greifswald weisen darauf hin, dass es keine universelle Grenze für akzeptable Unvollständigkeit gibt. Die relevante Frage ist, ob die verbleibenden vollständigen Datensätze die Entscheidung, den Bericht, das Modell oder den betrieblichen Prozess unterstützen.
Das bedeutet, ein Governance-Team sollte Folgendes dokumentieren:
Welche Attribute obligatorisch sind.
Welche Datensätze für die jeweilige Anforderung berechtigt sind.
Welche Quellen und Zeiträume erwartet werden.
Welches Lieferzeitfenster gilt.
Welche Vollständigkeitslücken die Veröffentlichung oder Verarbeitung blockieren.
Welche Muster fehlender Werte eine Untersuchung erfordern, selbst wenn ein Schwellenwert eingehalten wird.
Messen Sie dann sowohl den Score als auch den Grund dahinter. Ein einzelner Durchschnittswert kann eine kritische Spalte, Quelle, Region oder Periode verschleiern. Brechen Sie die Metriken nach den Dimensionen auf, die für den Prozess von Bedeutung sind, und bewahren Sie genügend Historie auf, um wiederkehrende Fehler zu identifizieren.
Überwachung in eine betriebliche Praxis umwandeln
Eine praktische Implementierung beginnt mit deterministischen Regeln für bekannte Anforderungen. Fügen Sie Prüfungen für das erwartete Volumen und die Lieferung hinzu. Etablieren Sie historische Baselines für NULL-Raten und Datensatzpopulationen. Wenn eine Warnung ausgelöst wird, untersuchen Sie korrelierte Signale, anstatt jede Metrik unabhängig zu behandeln. Überprüfen Sie Trends mit den Fachbereichsverantwortlichen, damit legitime Prozessänderungen nicht mit Fehlern verwechselt werden.
digna bietet einen modularen Weg für diese Aufgabe. Data Validation kann erforderliche Werte und Geschäftsregeln auf Datensatzebene durchsetzen. Data Anomalies kann ungewöhnliche Änderungen im Vollständigkeitsverhalten identifizieren. Data Analytics kann historischen Kontext liefern. Timeliness kann Eingangsmuster und fehlende Ladevorgänge überwachen. Schema Tracker kann strukturelle Änderungen erkennen, die neue Vollständigkeitsprobleme verursachen könnten.
Die Plattform führt Prüfungen und Metrikberechnungen in den Datenbanken des Kunden aus, mit Private-Cloud- und On-Premises-Bereitstellungsoptionen für Organisationen, bei denen die Daten in ihrer eigenen Umgebung verbleiben müssen. Diese Architektur unterstützt einen kontrollierten Ansatz über Warehouses, Lakes und Pipelines hinweg, während ein gemeinsames Dashboard Ingenieuren, Analysten und Stakeholdern eine einheitliche Sicht auf Vorfälle und Trends bietet.
Datenvollständigkeit ist nicht nur ein Prozentsatz. Sie ist eine Aussage darüber, ob die für einen realen Geschäftszweck erforderlichen Informationen vorhanden, zum richtigen Zeitpunkt verfügbar und stabil genug sind, um darauf zu vertrauen. Messen Sie die einzelnen Werte, vollständigen Datensätze, Datensatzvolumen, erwarteten Zeiträume, das Lieferverhalten und historische Änderungen. Verknüpfen Sie diese Signale dann mit Genauigkeit und Gültigkeit, damit Teams nicht nur wissen, was fehlt, sondern auch, ob die eingetroffenen Daten die Entscheidung unterstützen können.
digna kombiniert Data Validation, Data Anomalies, Data Analytics, Timeliness und Schema Tracker, um Teams bei der Überwachung der Vollständigkeit von Unternehmensdaten zu unterstützen. Besuchen Sie digna, um eine modulare Observability-Plattform kennenzulernen, die in Ihrer Umgebung läuft und Ihnen hilft, fehlende Werte, fehlende Ladevorgänge, ungewöhnliche Änderungen und damit verbundene Probleme mit der Datenqualität zu untersuchen.


