Was ist ein offenes Tabellenformat und warum es zählt
|
9
min. Lesezeit

Wenn Ihr Lake bereits Parquet-Dateien speichert, warum ergibt das nicht automatisch eine Tabelle?
An dieser Lücke stolpern viele Teams. Sie haben Dateien, Ordner, Partitionen und SQL-Engines, die sie lesen können. Doch sie haben noch keine verlässliche Antwort auf grundlegende Produktionsfragen wie: Welche Dateien bilden die aktuelle Version dieser Tabelle? Was passiert, wenn zwei Jobs gleichzeitig schreiben? Kann ich ein fehlerhaftes Laden zurückrollen, ohne Daten von Hand neu aufzubauen?
Inhaltsverzeichnis
Was ein offenes Tabellenformat ist
Wenn Ihr Lake bereits Parquet-Dateien speichert, warum brechen Produktionspipelines dann noch an etwas so Einfachem wie „was ist die aktuelle Tabelle“?

Teams, die nebenläufige Spark-Schreibvorgänge auf ein partitioniertes Parquet-Präfix fahren, lernen die Antwort oft auf die harte Tour. Dateien existieren, doch der Tabellenzustand ist unklar. Eine Engine liest womöglich eine teilweise aktualisierte Partition, eine andere übersieht neu hinzugekommene Dateien, und jemand im Bereitschaftsdienst inspiziert am Ende Speicherpfade von Hand, um herauszufinden, was „aktuell“ überhaupt heißt.
Ein offenes Tabellenformat löst dieses Problem auf der Metadatenebene. Es definiert, wie eine Tabelle ihre Dateien, Versionen, Schemaänderungen und Schreibvorgänge nachhält, sodass mehrere Engines Daten im Object Storage wie eine echte Tabelle behandeln können statt wie eine lose Verzeichniskonvention.
Diese Unterscheidung zählt, weil die Kernentscheidung architektonisch ist und nicht die Wahl eines neuen Dateityps. Die Datendateien sind oft weiterhin Parquet oder ORC. Wenn Sie eine Auffrischung zur darunterliegenden Speicherschicht wollen, deckt diese Erläuterung zum Parquet-Dateiformat die Grundlage ab. Das offene Tabellenformat sitzt über diesen Dateien und hält die Regeln für den Tabellenzustand fest.
Eine nützliche Analogie ist ein Lager mit beschrifteten Inventarfächern. Parquet-Dateien sind die Kisten auf dem Boden. Ein offenes Tabellenformat ist das Inventarsystem, das sagt, welche Kisten zur aktuellen Lieferung gehören, welche ersetzt wurden, wer die Einträge aktualisiert hat und wie das Lager vor der letzten schlechten Änderung aussah. Ohne dieses Inventarsystem muss jeder Leser aus dem raten, was er im Speicher sieht.
In der Praxis liefert Ihnen diese Metadatenarchitektur Tabellenverhalten, das reine Dateien allein nicht sauber bieten. Sie erhalten ACID-Transaktionen, Schemaevolution und Time Travel, weil das Format einen konsistenten Nachweis von Tabellenzustand und Änderungen über die Zeit führt. Deshalb werden Apache Hudi, Apache Iceberg und Delta Lake meist gemeinsam besprochen. Sie sind verschiedene Wege, dasselbe zugrunde liegende Problem zu bewältigen.
Die operativen Ergebnisse sind der Teil, den Engineers spüren. Schema-Drift lässt sich leichter kontrollieren, weil die Tabelle eine maßgebliche Schemahistorie hat. Abfragekosten sinken, weil Engines Metadaten nutzen können, statt jede Datei zu scannen, nur um herauszufinden, was existiert. Observability verbessert sich, weil Sie Snapshots, Commits und Änderungen auf Dateiebene inspizieren können, statt ein Speicherpräfix wie eine Blackbox zu behandeln.
Die kürzeste zutreffende Definition lautet also: Ein offenes Tabellenformat ist eine offene Spezifikation zur Verwaltung von Tabellenmetadaten und Tabellenverhalten über Dateien im Object Storage. Die Dateien halten die Daten. Das Format definiert, wie Systeme sich darauf einigen, was die Tabelle ist.
Die Metadatenschicht, die alles verändert
Warum lesen zwei Engines manchmal denselben Lake und liefern unterschiedliche Antworten?
Die Ursache liegt oft nicht in den Dateien selbst. Es fehlt ein gemeinsamer, maßgeblicher Nachweis des Tabellenzustands. Deshalb versteht man offene Tabellenformate am besten als Entscheidung über die Metadatenarchitektur. Die Dateien zählen weiterhin, doch das Produktionsverhalten hängt meist davon ab, wie die Metadatenschicht Wahrheit definiert.
Ein Bibliothekskatalog ist hier ein nützliches Modell. Die Bücher in den Regalen sind Ihre Parquet-Dateien. Der Katalog entscheidet, welche Bücher zur Sammlung gehören, welche Ausgabe aktuell ist, welche entfernt wurden und wie die Sammlung gestern aussah. Ohne diesen Katalog läuft jeder Leser die Regale ab und rät für sich.
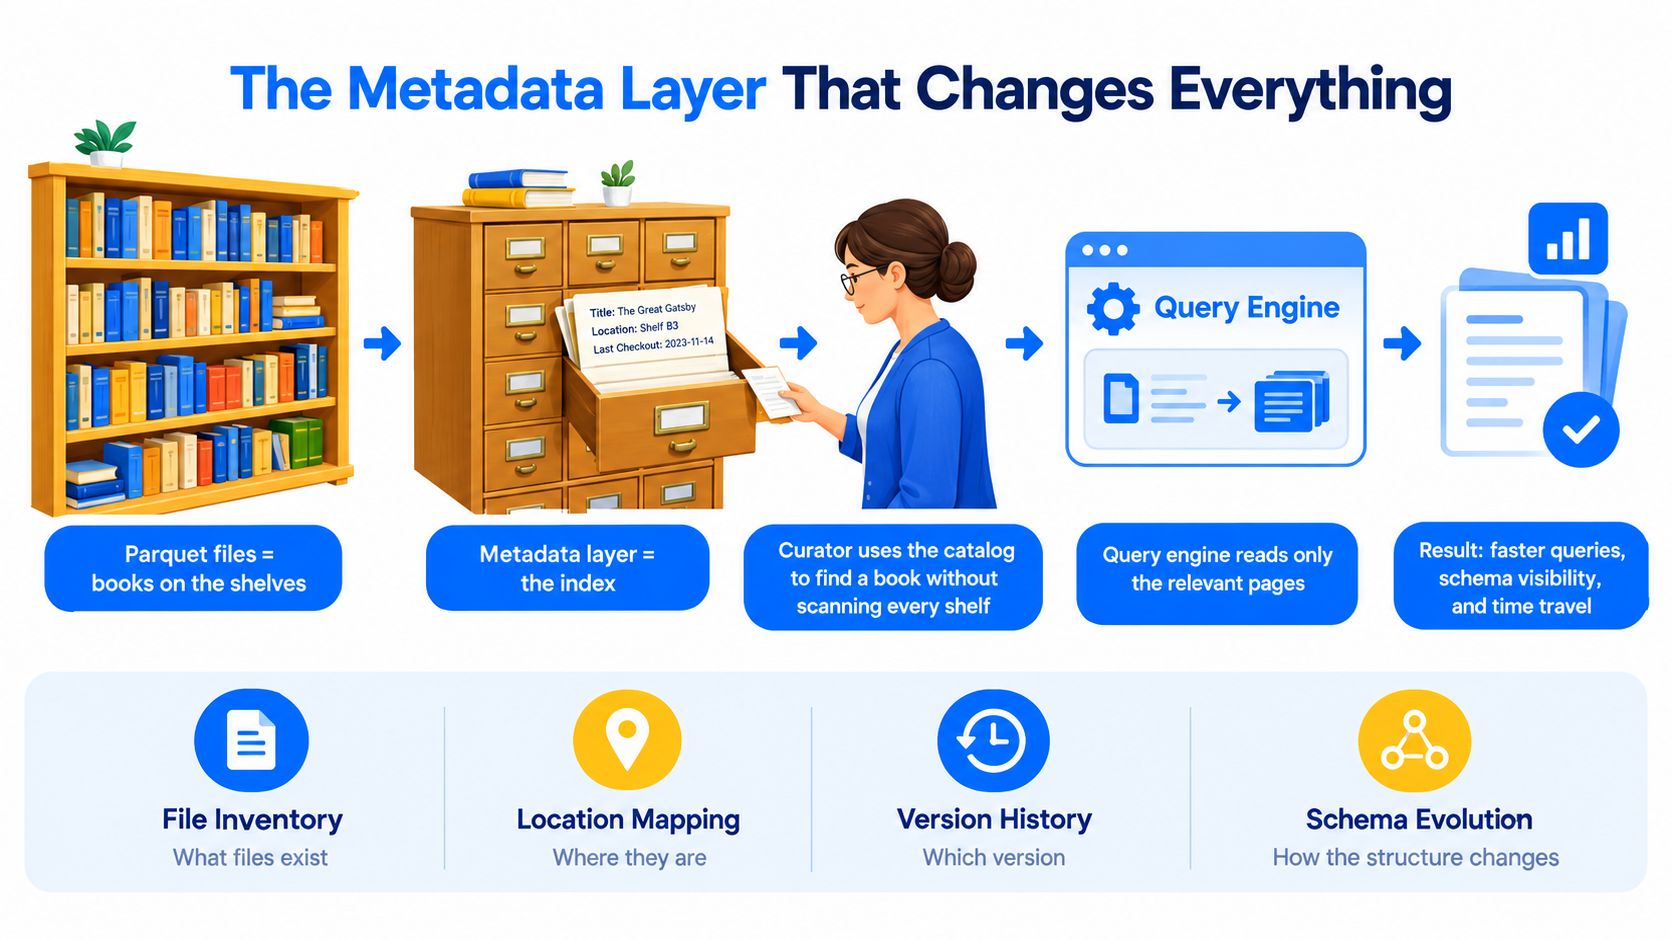
Diese Unterscheidung zeigt sich schnell im Betrieb. Abfragekosten steigen, wenn Engines Verzeichnisse listen und Dateien inspizieren müssen, nur um die Tabelle zu entdecken. Schema-Drift wird schwerer einzudämmen, wenn kein System die Schemahistorie besitzt. Observability bleibt schwach, wenn ein Speicherpräfix das Einzige ist, was Sie inspizieren können.
Für den breiteren Zusammenhang, wie Teams Metadaten organisieren und steuern, deckt dignas Leitfaden zum Metadatenmanagement die umgebende Disziplin ab.
Sechs Dinge, die die Metadatenschicht verändert
Snapshots schaffen eine konsistente Tabellensicht
Reader deuten nicht „welche Dateien gerade existieren“ als die Tabelle. Sie lesen aus einem definierten Snapshot, der jeder Engine dieselbe Antwort über den aktuellen Zustand in diesem Moment gibt.Dateiverfolgung macht die Planung billiger
Statt einen ganzen Verzeichnisbaum zu scannen, kann die Engine Metadaten konsultieren, die relevante Datendateien und ihre Statistiken bereits auflisten. Praktisch bedeutet das geringere Abfragekosten und vorhersehbarere Planung, besonders wenn Tabellen wachsen.Transaktionen verhindern teilweise Sichtbarkeit
Ein Schreibvorgang wird sichtbar, wenn der Commit gelingt. Scheitert ein Job auf halbem Weg, bleiben Reader auf dem vorherigen gültigen Snapshot, statt eine Mischung aus alten und neuen Dateien zu sehen.Schemaevolution wird explizit
Spaltenergänzungen, Umbenennungen und Typänderungen werden als Änderungen der Tabellenmetadaten erfasst. Das gibt Ihnen eine Quelle der Wahrheit für die Schemahistorie, statt sich darauf zu verlassen, dass jede Engine die Struktur aus Dateien erschließt.Partitionierung wird zur Tabellenregel
Das Verzeichnislayout trägt nicht mehr so viel Bedeutung. Die Tabellenmetadaten können die Partitionslogik direkt beschreiben, was Layoutänderungen über die Zeit leichter handhabbar macht.Historie wird inspizierbar
Ältere Snapshots bleiben Teil des Tabellennachweises. Das hilft bei Rollback, Fehlersuche, Prüfungsfragen und einfachen Fragen wie „was hat sich zwischen diesen beiden Läufen geändert?“
Ein konkretes Fehlerbild macht das anschaulicher.
Eine Batch-Pipeline schreibt einen neuen Tag an Daten in den Object Storage. Eine Query-Engine beginnt zu lesen, während der Schreibvorgang noch läuft. Eine andere Engine liest wenige Minuten später, nachdem weitere Dateien gelandet sind. Beide Teams sagen, sie hätten „dieselbe Tabelle“ abgefragt. Haben sie nicht. Sie haben zu unterschiedlichen Zeitpunkten unterschiedliche Dateilisten abgefragt.
Mit einem offenen Tabellenformat veröffentlicht der Commit erst dann einen neuen Tabellenzustand, wenn er vollständig ist. Bis dahin nutzen Reader weiterhin den vorherigen Snapshot. Das ist die operative Verschiebung. Sie hören auf, die Ordnerauflistung als Vertrag zu behandeln, und beginnen, die Metadaten als Vertrag zu behandeln.
Praxisregel: Wenn Ordnerinhalte Ihre Tabelle zur Lesezeit definieren, beruht Ihr Tabellenverhalten weiterhin auf Speicherkonventionen.
Apache Iceberg macht diesen Vertrag besonders deutlich. Seine Tabellenspezifikation definiert Tabellenmetadaten als JSON-Objekt, das Schema, Partitionsspezifikationen, Eigenschaften und Snapshots nachhält, wobei die Snapshots in den Tabellenmetadaten selbst erfasst werden, wie in der Iceberg-Tabellenspezifikation beschrieben.
Deshalb verändert diese Schicht in der Produktion so viel. Sie bestimmt, wie Systeme sich auf die Tabellenwahrheit einigen, und diese Entscheidung wirkt auf Korrektheit, Kosten und darauf, wie schnell Ihr Team ein schlechtes Ergebnis erklären kann.
Apache Iceberg, Delta Lake und Apache Hudi im Vergleich
Wenn offene Tabellenformate wirklich eine Entscheidung über die Metadatenarchitektur sind und nicht nur über das Dateiformat, ändert sich der Vergleich. Sie wählen nicht zwischen drei Arten, Parquet zu speichern. Sie wählen drei Arten, Tabellenwahrheit zu definieren, Änderungen zu veröffentlichen und Reader und Writer in der Produktion zu koordinieren.
Diese Rahmung zählt, weil der operative Schmerz an verschiedenen Stellen auftritt. Ein Format senkt vielleicht die Reibung zwischen Engines. Ein anderes passt natürlicher zu einer Spark-zentrierten Plattform. Ein drittes macht häufige Updates und CDC-Pipelines leichter betreibbar. Die praktische Frage ist schlicht: Wo soll das Metadatensystem die schwerste Last tragen?
Iceberg, Delta Lake und Hudi auf einen Blick
Dimension | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Ursprung | 2018 bei Netflix entwickelt, 2019 an Apache gespendet | 2019 quelloffen veröffentlicht | 2016 bei Uber entstanden |
Kernschwerpunkt | Portable Metadatenspezifikation über Engines hinweg | Starkes Spark-zentriertes Tabellenprotokoll und Plattformintegration | Upserts, inkrementelle Verarbeitung und streaming-lastige Tabellenwartung |
Metadatenmodell | Metadatenbaum aus Snapshots und Manifesten | Transaktionslog rund um | Commit-Zeitachse mit Tabellendiensten und satzorientierter Wartung |
Beste Passung | Lakehouse-Umgebungen mit mehreren Engines | Databricks- oder Spark-lastige Landschaften | CDC- und Streaming-Pipelines mit häufigen Updates |
Betriebsgefühl | Saubere Trennung zwischen Dateien und Tabellenmetadaten | Enger Ablauf für Teams, die bereits auf Delta-Werkzeuge standardisiert sind | Mehr Tabellendienste, stärkerer Fokus auf den Schreibpfad |
Die Entstehungsgeschichte ist weniger wichtig als der Entwurfsschwerpunkt. Jedes Format beantwortet dieselbe Frage anders: Wie soll eine Tabelle Änderungen erfassen, den aktuellen Zustand offenlegen und Compute-Engines sich darauf einigen lassen, was sie lesen?
Wo sich die Entwürfe unterscheiden
Apache Iceberg stellt die Tabelle um einen Metadatenbaum herum auf. Das spricht meist Teams an, die mehrere Engines betreiben, weil der Tabellenvertrag als portable Spezifikation definiert ist und nicht durch das Verhalten eines einzelnen Verarbeitungsstacks. Praktisch heißt das oft weniger Überraschungen, wenn Spark, Trino, Flink und andere Engines dieselben Daten lesen müssen, ohne eigene Konventionen zu erfinden.
Delta Lake stellt die Tabelle um ein Transaktionslog herum auf. Für Teams, die bereits auf Spark und Databricks standardisiert sind, fühlt sich das oft natürlich an, weil Schreibpfad, Governance-Kontrollen und Betriebswerkzeuge eng zusammenpassen. Die Metadatenwahl zeigt sich im Alltag. Schemaänderungen, Rollback und Tabellenwartung können sich integrierter anfühlen, wenn die breitere Plattform Delta-Semantik ohnehin voraussetzt.
Apache Hudi richtet weit mehr des Entwurfs auf schreiblastigen Betrieb aus. Wenn Ihr Schmerz nicht „viele Engines müssen sich einig sein“ ist, sondern „Datensätze ändern sich ständig und nachgelagerte Konsumenten brauchen inkrementelle Bewegung“, kommt Hudi früh ins Gespräch. Seine Architektur spiegelt diese Neigung. Die technische Spezifikation von Hudi erklärt, dass Metadaten in einer intern verwalteten Tabelle unter dem Pfad der technischen Hudi-Spezifikation .hoodie/metadata liegen und dass diese Metadatentabelle selbst eine Hudi-Tabelle mit Merge-on-Read ist.
Eine nützliche Analogie ist ein Lagerinventarsystem. Iceberg ist so entworfen, dass viele Abteilungen demselben Katalogeintrag trauen können. Delta ist so entworfen, dass Lager und Betriebssystem eng zusammenarbeiten. Hudi ist für ein Lager entworfen, in dem Artikel ständig korrigiert, ersetzt oder nachgefüllt werden und das Inventarsystem mit dieser Bewegung Schritt halten muss.
Was diese Entscheidungen in der Produktion bedeuten
Teams spüren den Unterschied zuerst.
Ist Schema-Drift ein wiederkehrendes Problem, zählt das Metadatenmodell, weil Schemaevolution nicht nur ein Häkchen in einer Funktionsliste ist. Es entscheidet, ob nachgelagerte Jobs laut scheitern, gemischte Annahmen lesen oder engine-spezifische Behandlung brauchen.
Steigen die Abfragekosten weiter, zählt das Metadatenlayout, weil die Tabelle der Engine helfen muss, unnötige Dateien zu vermeiden. Ein sauberer Planungspfad bedeutet meist weniger gescannte Dateien und weniger teure Überraschungen zur Laufzeit.
Sind Observability-Lücken das Problem, zählt die Formatwahl, weil die Metadatenhistorie bestimmt, wie leicht Ihr Team grundlegende Betriebsfragen beantworten kann. Welcher Snapshot brachte die schlechten Datensätze? Welcher Commit änderte das Partitionsverhalten? Welcher Writer veröffentlichte inkompatible Dateien?
Auch deshalb hängen Entscheidungen zum Tabellenformat und Qualitätskontrollen zusammen. In Databricks-lastigen Umgebungen müssen Praktiken für Datenqualität in Databricks oft gemeinsam mit dem Verhalten der Delta-Tabellen entworfen werden und nicht als später ergänzte Schicht.
Ein praktischer Weg zur Wahl
Nutzen Sie Iceberg, wenn Interoperabilität zwischen Engines eine Anforderung erster Ordnung ist und die Tabellenspezifikation so unabhängig wie möglich von einer Anbieter-Laufzeit bleiben soll.
Nutzen Sie Delta Lake, wenn Ihre Plattform ohnehin stark auf Spark oder Databricks läuft und Sie enge Integration über Schreibpfad, Governance und Tagesbetrieb schätzen.
Nutzen Sie Hudi, wenn häufige Updates, CDC-Ingestion und inkrementeller Konsum den Workload stärker prägen als breite Engine-Portabilität.
Kein Format gewinnt jede Kategorie. Jedes rückt den Metadatenvertrag in eine etwas andere Rolle. Diese Entwurfsentscheidung prägt, wie Sie Korrektheit, Kosten und Vorfallsanalyse handhaben, sobald die Tabelle in Produktion ist.
Wie eine Abfrage tatsächlich die Daten erreicht
Warum fühlt sich dieselbe SQL-Abfrage bei einer Tabelle günstig und bei einer anderen schmerzhaft teuer an, obwohl beide auf denselben Object Store zeigen?
Die Antwort liegt meist in den Metadaten, nicht in Parquet selbst.
SELECT * FROM sales WHERE order_date = current_date
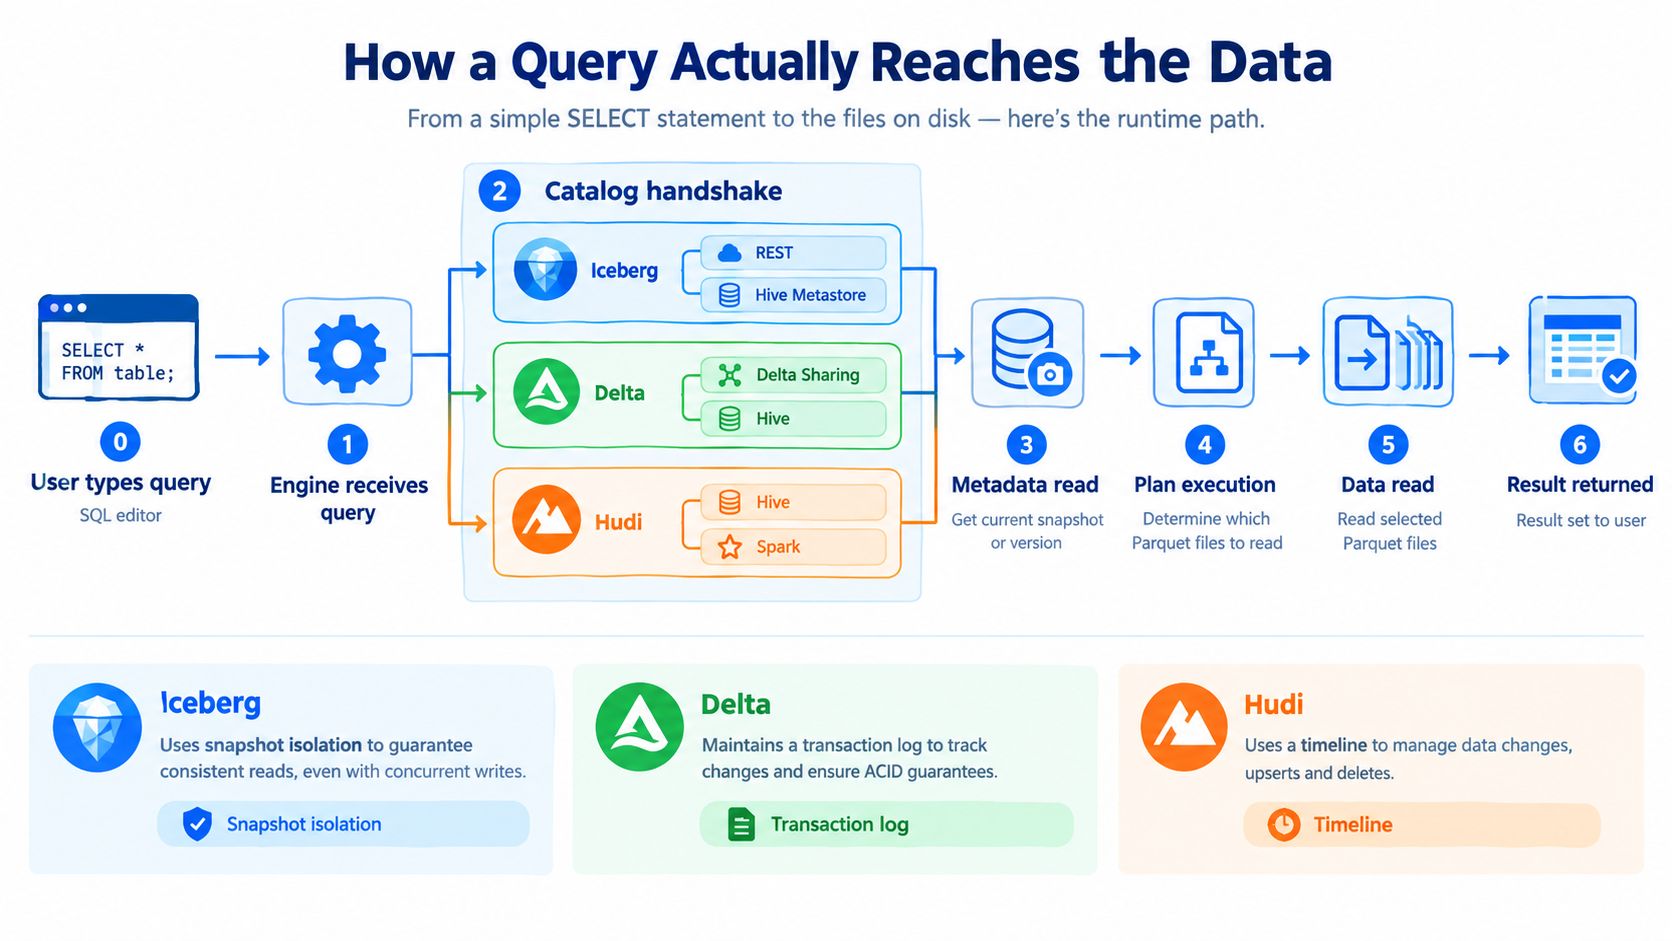
Eine solche Abfrage beginnt nicht damit, Ordner zu scannen. Sie beginnt mit der Frage „Was bedeutet diese Tabelle gerade?“. Das ist das entscheidende Denkmodell. Ein offenes Tabellenformat ist eine Metadatenarchitektur, um diese Frage verlässlich zu beantworten.
Zuerst fragt die Engine nach dem aktuellen Tabellenzustand
Die Query-Engine löst sales über einen Katalog wie Hive Metastore, AWS Glue, Unity Catalog oder Nessie auf. Der Katalog wirkt wie eine Empfangskraft mit der aktuellen Adresse, nicht wie das Lager, das jede Kiste hält. Seine Aufgabe ist, die Engine auf den aktuellen Tabellenmetadaten-Eintrag zu verweisen.
Dieses Detail hat echte operative Folgen. Zeigt der Katalog auf veraltete Metadaten, plant die Engine gegen einen veralteten Tabellenzustand. Legt ein Ingestion-Job Dateien ohne gültigen Commit direkt im Speicher ab, mögen diese physisch existieren und logisch dennoch unsichtbar bleiben.
Für einen breiteren Architekturblick hilft diese Übersicht zur Datensystemarchitektur, einzuordnen, wo der Katalog zwischen Speicher und Compute sitzt.
Dann liefert das Tabellenformat die Dateikarte
Sobald die Engine den Metadateneintrag hat, übernimmt das offene Tabellenformat:
Iceberg liest Tabellenmetadaten, Manifeste und den aktiven Snapshot.
Delta Lake liest das Transaktionslog plus etwaigen Checkpoint-Zustand.
Hudi liest seine Zeitachse und Tabellenmetadaten, um die aktuelle Sicht zu bestimmen.
Verschiedene Mechanik, gleicher Zweck. Die Engine braucht eine maßgebliche Dateikarte, bevor sie irgendwelche Datendateien liest.
Das ist die praktische Verschiebung vom einfachen Data Lake zum offenen Tabellenformat. Ohne diese Metadatenschicht muss die Engine den Tabellenzustand oft aus Ordnern und Dateinamen erschließen. Mit ihr wird der Tabellenzustand ausdrücklich erklärt.
Die Planung geschieht vor dem Scannen
Die Abfragekosten beginnen auseinanderzulaufen.
Nachdem die Engine erfahren hat, welche Dateien zum aktuellen Snapshot gehören, kann sie die Arbeit mit Partitionsdaten, Dateistatistiken und Commit-Metadaten eingrenzen. Statt jede Datei unter einem Pfad zu öffnen und spät zu klären, kann sie irrelevante Dateien schon bei der Planung ausschließen.
Das verändert das Produktionsverhalten auf Weisen, die Data Engineers schnell bemerken:
Geringere Abfragekosten, weil weniger Dateien geöffnet werden müssen
Weniger Verwirrung durch Schema-Drift, weil der Lesepfad committeten Tabellenmetadaten folgt und nicht dem, was zufällig im Speicher gelandet ist
Bessere Vorfallsanalyse, weil Sie Snapshots, Commits und Dateizugehörigkeit direkt inspizieren können
Weniger blinde Flecken bei Observability, weil der Tabellenzustand als Metadaten erfasst und nicht in Ordnerkonventionen versteckt ist
Wirkt ein Dashboard plötzlich falsch, wird die Debugging-Frage präziser. Welchen Snapshot hat die Engine gelesen? Welcher Commit fügte diese Dateien hinzu? Welche Metadatenänderung veränderte Partitions- oder Schemaverhalten?
Deshalb versteht man offene Tabellenformate besser als Steuerungsebene für Tabellen. Die Abfrage erreicht Daten erst, nachdem Metadaten definiert haben, was die Tabelle ist, welche Dateien dazugehören und welche ignoriert werden können.
Echte Vorteile und die Kompromisse, auf die Sie stoßen
Der erste Sprint nach Einführung eines offenen Tabellenformats fühlt sich meist gut an. Schreibvorgänge werden verlässlicher. Tabellenänderungen fühlen sich nicht mehr wie Ordnerchirurgie an. Teams gewinnen Zuversicht, dass eine Tabelle zu einem Zeitpunkt eine kohärente Sache bedeutet.
Dann taucht die Produktionsrealität auf.
Vorteile und Kompromisse offener Tabellenformate auf einen Blick
Vorteil | Was Sie bekommen | Kompromiss, den Sie erben |
|---|---|---|
ACID-Schreibvorgänge | Reader sehen keine halbfertigen Batches | Sie hängen nun von Commit-Koordination und Metadatengesundheit ab |
Schemaevolution | Kontrollierte Spaltenänderungen ohne ständige Neuschreibungen | Sie brauchen weiterhin Disziplin bei Kompatibilität und nachgelagerten Verträgen |
Time Travel | Einfacheres Rollback und Debugging | Die Aufbewahrung der Historie muss bewusst gesteuert werden |
Engine-Portabilität | Mehr Flexibilität über Spark, Trino, Flink und andere hinweg | Portabilität auf Formatebene garantiert keine offene Governance |
Bessere Abfrageplanung | Wirksameres Datei-Pruning und sauberer Tabellenzustand | Metadatenpflege wird Teil des Plattformbetriebs |
Jeder Vorteil schafft eine neue Verantwortung
Verlässliche Schreibvorgänge beseitigen eine Klasse von Lake-Fehlern, schaffen aber auch eine neue Ausfallgrenze rund um Metadatenpfad und Katalog.
Time Travel hilft, wenn jemand schlechte Daten veröffentlicht, doch historische Snapshots verwalten sich nicht selbst. Wenn Sie alte Snapshots nie ablaufen lassen oder Metadaten nie bereinigen, wachsen Speicher- und Planungsaufwand.
Schemaevolution senkt den Bedarf an brachialen Neuschreibungen, macht Datenverträge aber nicht überflüssig. Eine umbenannte Spalte kann weiterhin einen nachgelagerten Konsumenten brechen, der den alten Namen erwartete.
Für Teams, die Lakehouse-Muster breiter vergleichen, ist dieser Vergleich von Data Lake und Data Mart nützlich, weil er zeigt, wie Speicherflexibilität und kuratierter Konsum unterschiedlichen operativen Zielen dienen.
Der versteckte Preis ist Wartungsarbeit
Das ist der Teil, den viele Architekturdiagramme auslassen. Selbst verwaltete offene Tabellen brauchen weiterhin Kompaktierung, Snapshot-Ablauf, Metadatenbereinigung und laufende Wartung. Ohne diese Arbeit verschlechtert sich die Leistung und die Speicherkosten wachsen, wie in der Analyse von CDO Magazine zu offenen Tabellen und Interoperabilität erörtert.
Derselbe Beitrag macht einen weiteren wichtigen Punkt. Offene Tabellenformate verbessern die Portabilität, lösen aber nicht automatisch Verlässlichkeit oder Observability, besonders in schnell wechselnden Umgebungen mit mehreren Engines.
Operative Realität: Offene Tabellenformate reduzieren das Dateichaos. Sie machen Plattformdisziplin nicht überflüssig.
Es gibt außerdem einen Governance-Haken. Teams feiern oft, dass das Tabellenformat offen ist, und belassen Katalog, Zugriffsrichtlinien, Maskierungsregeln und Prüfverhalten unter der Kontrolle eines Anbieters. Aktuelle Kommentare argumentieren, dass die Architektur praktisch nicht vollständig offen ist, wenn diese Schichten anbietergesteuert bleiben, selbst wenn Dateien und Tabellenformat es sind, wie in Onehouses Perspektive auf offene Tabellenformate und offene Lakehouse-Architektur ausgeführt.
Praktische Umsetzung und Migrationsüberlegungen
Migrationsentscheidungen laufen glatter, wenn Sie sie in der Reihenfolge treffen, in der Betriebsteams ihnen begegnen.
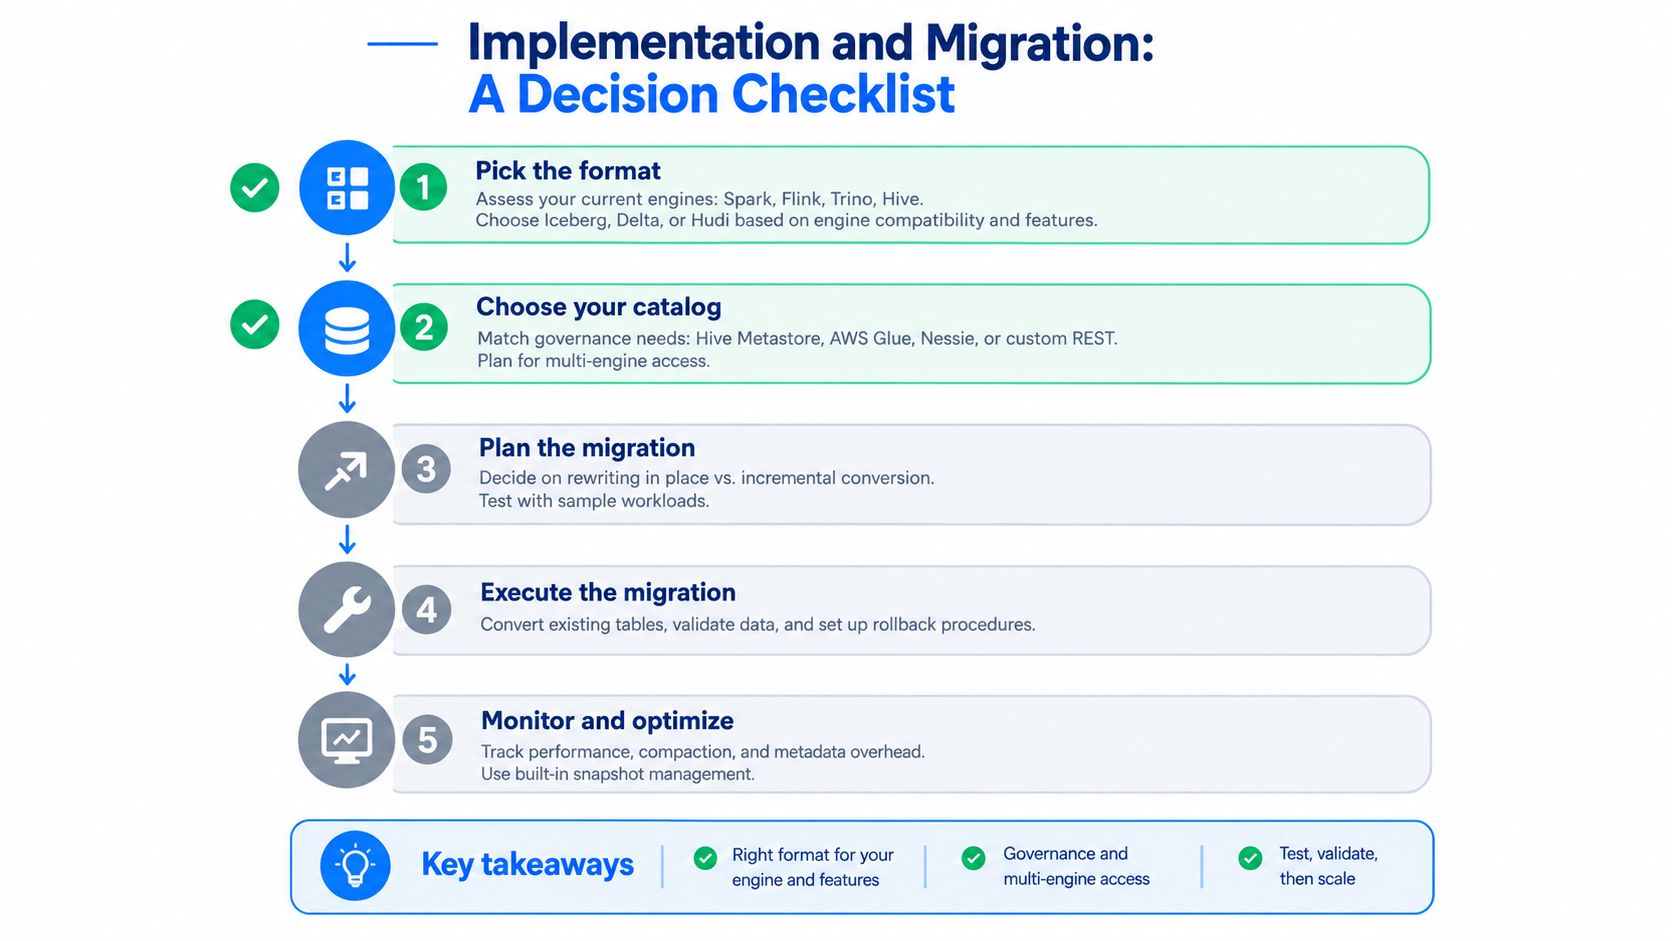
Beginnen Sie mit den Engines, die Sie schon betreiben
Dominiert Spark und hängt Ihr Team bereits an Delta-nativen Abläufen, ist Delta womöglich der am wenigsten störende Weg.
Ist Ihre Umgebung engine-übergreifend, passt Iceberg oft sauberer zum Betriebsmodell.
Ist Ihre härteste Anforderung häufige Upserts aus CDC- und Streaming-Quellen, verdient Hudi eine ernsthafte Prüfung.
Wählen Sie den Katalog wie Infrastruktur
Viele Teams behandeln den Katalog als Implementierungsdetail. Ist er nicht. Er wird Teil Ihrer Steuerungsebene.
Nutzen Sie einen einfachen Katalog, wenn Einfachheit Vorrang hat. Nutzen Sie einen cloud-integrierten oder plattformgesteuerten Katalog, wenn Sicherheit, Lineage und zentrale Richtlinien wichtiger sind. Erwarten Sie mehrere Engines über Clouds hinweg, wählen Sie eine Katalogstrategie, die Governance nicht in einer Laufzeit einsperrt.
Migration ist meist unspektakulärer als die Ankündigung
Gängige Migrationsmuster sind:
Neuschreiben in neue Tabellen: Sauberste Semantik, höchster anfänglicher Aufwand
Doppeltes Schreiben für eine Zeit: Sicherere Umstellung, mehr temporäre Komplexität
Klonen oder Konvertieren, wo möglich: Schneller, aber Annahmen sorgfältig prüfen
Stufenweiser Domänen-Rollout: Besser für große Landschaften mit unterschiedlichen Workloads
Das stille Risiko ist meist nicht die Dateikonvertierung selbst. Es ist, die Wartung ab Tag eins zu vergessen.
Sie brauchen Jobs oder verwaltete Dienste für Kompaktierung, Aufbewahrung und Bereinigung, bevor die erste wichtige Tabelle live geht. Überspringen Sie das, beginnt die Plattform sofort zu driften.
Eine praktische Standardwahl
Eine vernünftige Standardwahl ist schlicht:
Wählen Sie Iceberg für engine-übergreifendes SQL und governance-orientiertes Lakehouse-Design.
Wählen Sie Delta Lake, wenn Ihre Plattform stark auf Databricks und Spark setzt.
Wählen Sie Hudi, wenn der Schreibpfad von CDC, Upserts und Streaming-Korrekturmustern bestimmt wird.
Und wenn Sie die Tabellengesundheit ab Tag eins instrumentieren, ist eine Option digna, das in der Umgebung der Kundin oder des Kunden läuft und Schemaänderungen, Timeliness, Anomalien und Satzvalidierung über Lakes, Warehouses und Pipelines hinweg überwacht.
Was offene Tabellenformate für Data Observability bedeuten
Offene Tabellenformate verbessern nicht nur die Speichersemantik. Sie legen auch eine Metadatenfläche offen, die Observability-Werkzeuge direkt lesen können.
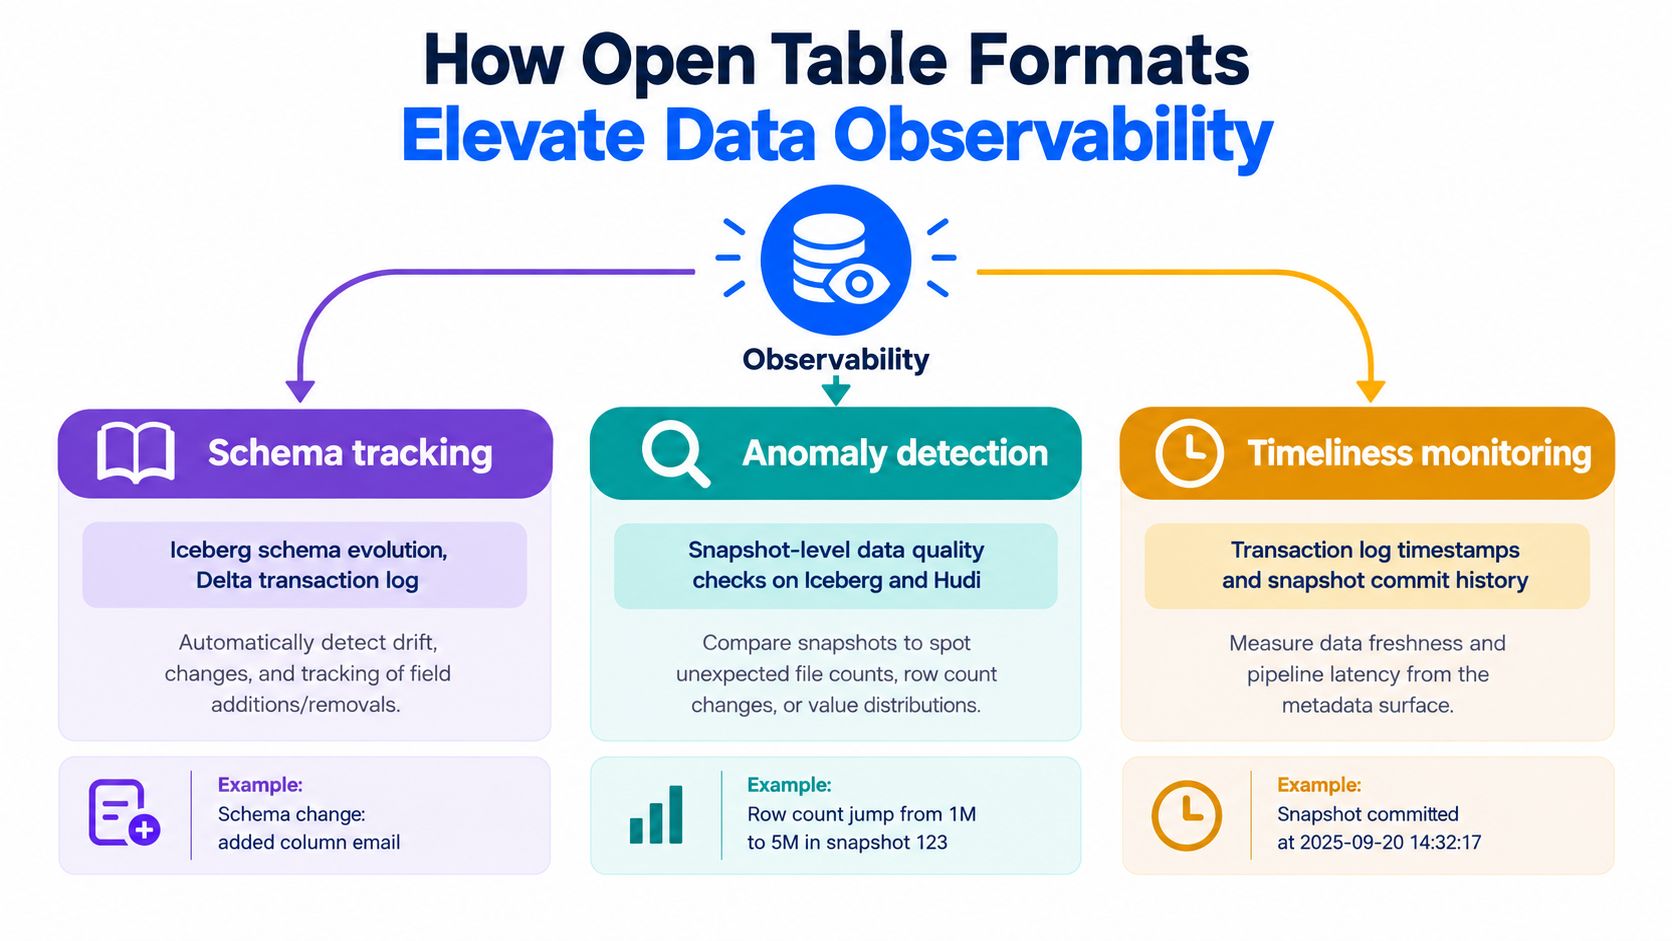
Metadaten werden zur Telemetrie
Iceberg-Snapshots, Delta-Transaktionslogs und Hudi-Commit-Metadaten erzeugen alle maschinenlesbare Belege für Tabellenänderungen. Das zählt, weil viele Qualitäts- und Verlässlichkeitsprüfungen nicht erst vollständige Datensätze scannen müssen.
Eine Plattform kann die Commit-Historie inspizieren und fragen:
Kam unerwartet eine Schemaänderung an?
Landete die heutige Partition später als üblich?
Veröffentlichte ein Schreibvorgang weit weniger Dateien, als die Pipeline sonst erzeugt?
Blieb die Tabelle stehen, obwohl vorgelagerte Jobs liefen?
Observability rückt näher an den Schreibpfad
Das verändert das Betriebsmodell der Überwachung. Statt sich nur auf nachgelagerte Abfragefehler oder Beschwerden über Dashboards zu verlassen, können Teams Probleme dort erkennen, wo sich der Tabellenzustand ändert.
Wenn Metadaten Ihnen sagen, dass sich die Tabelle geändert hat, kann Observability die Änderung prüfen, bevor Nutzer den Bruch entdecken.
Das ist ein Grund, warum offene Tabellenformate über Speicherung und Abfragegeschwindigkeit hinaus zählen. Sie schaffen eine gemeinsame Steuerungsfläche, die Engines, Governance-Systeme und Observability-Werkzeuge alle lesen können.
Der Vorbehalt ist wichtig. Metadaten helfen, Signale offenzulegen. Sie deuten sie nicht für Sie. Teams brauchen weiterhin Regeln, Baselines und Vorfallsabläufe, die Tabellenänderung mit Geschäftsauswirkung verbinden.
Wie es von hier aus weitergeht
Ein offenes Tabellenformat ist nicht die Ziellinie. Es ist das Fundament für ein besser beherrschbares Lakehouse.
Bevor Sie die Architektur für produktionsreif erklären, prüfen Sie einige Punkte:
Katalog-Resilienz: Stellen Sie sicher, dass der Katalog hochverfügbar genug ist, um Teil Ihrer Steuerungsebene zu werden.
Wartungsjobs: Bestätigen Sie, dass Kompaktierung, Snapshot-Ablauf und Metadatenbereinigung ab Tag eins geplant sind.
Aufbewahrungsrichtlinie: Richten Sie die Time-Travel-Historie an Compliance- und Rollback-Bedarf aus.
Engine-Verhalten: Prüfen Sie, dass Engines Tabellenmetadaten direkt lesen und nicht auf Abkürzungen über Verzeichnislisten setzen.
Observability-Verdrahtung: Überwachen Sie Commit- und Snapshot-Signale, nicht nur Abfrageergebnisse.
Wenn Sie Iceberg auf einem bestehenden Lake evaluieren, beginnen Sie mit einer Tabelle, die bereits unter Schema-Drift oder Zugriff durch mehrere Engines leidet.
Wenn Sie Delta in einen Spark-lastigen Betrieb einziehen, starten Sie dort, wo Transaktionssicherheit mehr zählt als Portabilitätsdebatten.
Wenn Sie Hudi für CDC-lastige Workloads testen, wählen Sie eine Tabelle, bei der Upserts und inkrementeller Konsum bereits der operative Schmerzpunkt sind.
Die nützliche Frage lautet nicht nur, was ein offenes Tabellenformat ist. Sie lautet, ob Ihr Team bereit ist, die Metadatenarchitektur zu betreiben, die damit kommt.
digna gibt Datenteams eine Plattform für Datenqualität und Observability in der eigenen Umgebung, was natürlich zu offenen Tabellenformaten passt, weil so viel nützliches Signal in Commits, Schemaänderungen und Frische-Metadaten steckt. Wenn Sie rohe Lake-Dateien in gesteuerte, produktionsnahe Tabellen verwandeln, besuchen Sie digna, um zu sehen, wie es Schema-Drift, Timeliness, Anomalien und Validierung überwacht, ohne Ihre Daten aus Ihrer Umgebung zu bewegen.
Die Metadatenschicht macht dem Query-Planer die Arbeit leichter; dieselben Metadaten operative Fragen beantworten zu lassen, ist das, was Data Platform Observability obendrauf legt.
Häufig gestellte Fragen
Was speichert die Metadatenschicht eigentlich?
Schema und seine Historie, die Liste der Datendateien, die jede Version der Tabelle bilden, Partitionsdefinitionen und Statistiken je Datei wie Wertebereiche und Null-Anzahlen. Genau dieser letzte Teil erlaubt einem Query-Planer, Dateien zu verwerfen, bevor er sie überhaupt öffnet.
Wie erreicht eine Abfrage die Daten?
Die Engine fragt den Katalog nach dem aktuellen Metadatenzeiger, liest das Manifest, um die Dateiliste mit Statistiken zu erhalten, verwirft Dateien, deren Statistiken den Filter nicht erfüllen können, und öffnet erst dann die verbleibenden Parquet-Dateien. Der Großteil der Geschwindigkeit kommt aus den Dateien, die sie nie öffnet.
Verbessert ein offenes Tabellenformat die Datenqualität?
Es verbessert die Konsistenz, nicht die Korrektheit. Das Format garantiert, dass jede Engine dieselbe committete Version der Tabelle mit demselben Schema sieht; es behauptet nichts darüber, ob die Werte genau, vollständig oder frisch sind. Das bleiben getrennte Prüfungen, die darüber liegen.
Was lässt sich aus Tabellenmetadaten beobachten?
Die Commit-Häufigkeit zeigt, ob Ladevorgänge planmäßig eintreffen, Snapshot-Diffs zeigen, welche Dateien eine Änderung berührt hat, und die Schemahistorie zeigt, wann sich der Typ einer Spalte verschoben hat. Diese Signale fangen eine Klasse von Problemen früher ab als Prüfungen auf Zeilenebene, weil sie auftauchen, bevor jemand die Daten abfragt.
Kostet die Einführung etwas?
Ja, allerdings operativ und nicht als Lizenz. Sie erben Snapshot-Ablauf, Dateikompaktierung und Katalogverfügbarkeit als Dinge, die gepflegt werden müssen, und die Abfrageplanung gewinnt einen Metadaten-Roundtrip. Für kleine, selten veränderte Datensätze kann schlichtes Parquet mit stabilem Layout weiterhin die richtige Antwort sein.



