Was ist Datenplausibilität? Ein praktischer Leitfaden
|
7
min. Lesezeit
Data reasonableness bewertet, ob Daten innerhalb ihrer erwarteten geschäftlichen, logischen, statistischen oder kontextuellen Bedingungen sinnvoll sind. Gültige Daten folgen einer definierten Regel. Plausible Daten verhalten sich so, dass es im Kontext Sinn ergibt.
Ein Datensatz kann eine Typprüfung bestehen, in einen zulässigen Bereich passen und dennoch für jeden, der das Geschäft versteht, falsch aussehen. Ein akzeptiertes Patientenalter von 187 Jahren, eine Transaktion von 500.000 €, wenn typische Transaktionen unter 500 € liegen, oder ein plötzlicher Anstieg der täglichen Kundenregistrierungen um 400 % beweisen vielleicht keinen Fehler, aber jeder dieser Fälle verdient eine Untersuchung. Diese Lücke zwischen dem Bestehen der Validierung und dem Sinn ergeben ist der Bereich, in dem die Plausibilität der Datenqualität unverzichtbar wird.
Inhaltsverzeichnis
Wie sich Plausibilität von Gültigkeit, Genauigkeit und Konsistenz unterscheidet
Warum Plausibilität für Data Analytics und KI entscheidend ist
Wie digna ein kontinuierliches Plausibilitätsmonitoring unterstützt
Was ist Data Reasonableness und warum ist es wichtig?
Ein Abrechnungssystem im Krankenhaus akzeptiert möglicherweise ein Patientenalter von 150 Jahren, weil das Feld numerisch ist und der konfigurierte Bereich dies zulässt. Der Datensatz ist strukturell gültig, aber ein Kliniker, ein Abrechnungsspezialist oder ein Data Steward würde sofort hinterfragen, ob der Wert auf einem Tippfehler, einer verschobenen Spalte oder einem ungewöhnlichen, aber echten Datensatz beruht.
Data Reasonableness bewertet, ob ein Wert innerhalb seiner erwarteten Bedingungen plausibel erscheint. Diese Bedingungen können Geschäftsregeln, logische Beziehungen, statistische Muster, historisches Verhalten, Vergleichsgruppen-Normen oder Domänenwissen sein. Die Frage ist nicht: „Kann dieser Wert im Feld existieren?“ Sie lautet vielmehr: „Ergibt dieser Wert hier Sinn?“
Praktische Regel: Ein Plausibilitätshinweis ist eine Aufforderung zur Untersuchung, kein automatischer Beweis dafür, dass der Datensatz falsch ist.
Diese Unterscheidung hat ein langes Fundament in der amtlichen Statistik. Statistics Canada beschreibt Qualität anhand von sechs Dimensionen – Relevanz, Genauigkeit, Timeliness, Zugänglichkeit, Interpretierbarkeit und Kohärenz – und verknüpft Qualität mit der „Eignung für die Verwendung“ und nicht nur mit der reinen Korrektheit. Die Qualitätsrichtlinien von Statistics Canada zeigen, warum ein Datensatz zwar vorhanden und technisch korrekt sein kann, aber dennoch seinen Zweck verfehlen kann, wenn er zu spät eintrifft, die Vergleichbarkeit verliert oder erwartete Beziehungen verletzt.
Warum deterministische Regeln nicht ausreichen
Eine deterministische Regel kann prüfen, ob ein Feld eine Zahl enthält, ob ein Datum das richtige Format verwendet oder ob ein Betrag unter einer konfigurierten Obergrenze bleibt. Sie kann jedoch nicht automatisch jeden legitimen geschäftlichen Kontext verstehen.
Plausibilität fügt diese kontextuelle Ebene hinzu durch:
Historische Baselines, die zeigen, ob die heutigen Werte dem früheren Verhalten ähneln.
Peer-Vergleiche, die eine Filiale, ein Produkt, einen Kunden oder eine Region mit ähnlichen Gruppen vergleichen.
Feldübergreifende Beziehungen, wie z. B. ob die Lieferung auf den Versand folgt.
Statistisches Profiling, das Verteilungsverschiebungen und ungewöhnliche Konzentrationen hervorhebt.
Fachliche Überprüfung, die hilft, seltene Ereignisse von fehlerhaften Daten zu unterscheiden.
Die historische Entwicklung der statistischen Qualitätskontrolle stützt diesen Ansatz ebenfalls. Ein Review der National Academies zu Datenqualität und Stichprobenfehlern führt moderne Qualitätspraktiken auf Messkontrolle, Erfassungsprozesskontrolle, Stichprobenziehung und Fehleranalyse zurück. Plausibilität ist die Fortführung dieser Disziplin im Unternehmen, angewendet auf Data Warehouses, Data Lakes, Pipelines, Dashboards und Modelle.
Die praktische Konsequenz ist klar. Plausibilität bietet eine späte, aber wichtige Schutzmaßnahme, bevor verdächtige Daten Einfluss auf Data Analytics, Finanzberichterstattung, operative Entscheidungen oder automatisierte Systeme nehmen. Teams, die diese Prüfungen mit einer umfassenderen Pipeline-Überwachung verknüpfen möchten, können sie in einen Data Observability-Ansatz integrieren.
Wie sich Plausibilität von Gültigkeit, Genauigkeit und Konsistenz unterscheidet
Plausibilität ist mit anderen Datenqualitätsdimensionen verwandt, ersetzt diese jedoch nicht. Die Gültigkeit prüft explizite Regeln, die Genauigkeit prüft die Übereinstimmung mit der Realität und die Konsistenz prüft die Übereinstimmung zwischen Darstellungen. Plausibilität fragt, ob das Ergebnis im Kontext plausibel ist.
Ein Versandgewicht von 9.999 kg für einen Laptop passt vielleicht in ein numerisches Feld und ein großzügiges technisches Maximum. Ein realer Zeitstempel einer Einzelhandelstransaktion um 3:00 Uhr morgens spiegelt möglicherweise genau das wider, was das Quellsystem aufgezeichnet hat, selbst wenn das Geschäft um 21:00 Uhr schließt. Wenn jeder Mitarbeiter ein Jahr lang jeden Tag genau 8,00 Stunden einträgt, stimmen die Datensätze systemübergreifend vielleicht perfekt überein, deuten aber dennoch auf ein Prozess- oder Erfassungsmuster hin, das eine genauere Untersuchung verdient.
Ein nützlicher Vergleich sieht wie folgt aus:
Dimension | Was geprüft wird | Beispielregel | Bestanden? | Plausibilitäts-Urteil |
|---|---|---|---|---|
Validity | Ob ein Wert einer expliziten Regel folgt | Betrag ist numerisch und liegt unter dem zulässigen Maximum | Ja | Kann dennoch unplausibel sein |
Accuracy | Ob ein Wert die Realität widerspiegelt | Erfasste Adresse stimmt mit der verifizierten Kundenadresse überein | Ja | Genaue Daten können dennoch ungewöhnlich sein |
Consistency | Ob Darstellungen übereinstimmen | Kundenstatus stimmt in zwei Systemen überein | Ja | Übereinstimmung beweist keinen kontextuellen Sinn |
Reasonableness | Ob das Verhalten in den erwarteten Kontext passt | Kauf passt zu Kunde, Produkt, Zeit und Historie | Erfordert Kontext | Markiert Werte für Untersuchungen |
Plausibilität versus Gültigkeit
Gültigkeit fragt: „Erfüllt der Wert eine definierte Regel?“ Ein Transaktionsbetrag von 900.000 € ist möglicherweise gültig, wenn das technische Maximum höher liegt, er kann jedoch unplausibel sein, wenn normale Transaktionen unter 5.000 € liegen.
Aus diesem Grund ist ein Datenqualitäts-Leitfaden nützlich, um das grundlegende Vokabular zu etablieren, während Teams dennoch eine separate kontextuelle Bewertung benötigen. Bei der Entwicklung von Kontrollen können Sie zudem Plausibilität von Data Validity und wie man sie misst abgrenzen.
Plausibilität versus Genauigkeit
Genauigkeit fragt, ob der Wert die Realität widerspiegelt. Plausibilität fragt, ob der Wert angesichts des verfügbaren Kontextes plausibel erscheint. Ein ungewöhnlicher Wert kann absolut korrekt sein, wie z. B. ein echter High-Value-Kauf, eine Notaufnahme oder ein Mitarbeiter, der eine außergewöhnliche Schicht leistet.
Jeden Ausreißer abzulehnen, würde valide seltene Ereignisse ausschließen. Ein besseres Design markiert die Beobachtung, bewahrt den ursprünglichen Wert, dokumentiert den Grund der Besorgnis und leitet sie an einen entsprechenden Workflow weiter.
Plausibilität versus Konsistenz
Konsistenz konzentriert sich auf die Übereinstimmung zwischen Datendarstellungen oder Systemen. Plausibilität konzentriert sich auf das erwartete Verhalten. Ein Wert kann in jeder nachgelagerten Tabelle konsistent sein und dennoch unplausibel sein, weil der ursprüngliche Wert ein Geschäftsmuster verletzt, das durch keinen System-zu-System-Vergleich geprüft wird.
Praxisbeispiele für unplausible Daten
Unplausible Daten kommen in jeder Domäne vor, da Systeme in der Regel die zulässige Struktur besser kennen als den umgebenden geschäftlichen Kontext. Ein Finanzsystem kann einen korrekt formatierten Betrag akzeptieren, ohne die Händlerkategorie zu verstehen, während ein Gesundheitssystem eine Dosierung speichern kann, ohne zu prüfen, ob sie zum Profil des Patienten passt.
Im Finanzbereich könnte eine Kreditkartentransaktion über 0,01 $ bei einem Luxusautohändler Formatierungs-, Währungs- und Mindestwertprüfungen bestehen. Es könnte sich um eine Testgebühr, eine Anzahlung, ein Abrechnungsartefakt oder eine verdächtige Transaktion handeln. Die Markierung sollte zu einer Überprüfung führen, nicht den Betrug beweisen.
Im Gesundheitswesen führt eine pädiatrische Dosierung bei einem Patienten, der als 72 Jahre alt erfasst ist, zu einem schwerwiegenden kontextuellen Konflikt. Das Alter, die Dosierung und das Medikament können jeweils gültige Felder sein, aber ihre Beziehung erfordert eine sofortige klinische oder datenqualitätstechnische Untersuchung.
In der Lieferkette ist ein Lager, das zwölf Monate in Folge keinen Inventurschwund meldet, zwar denkbar, aber dieses ununterbrochene Muster ist ungewöhnlich genug, um es zu prüfen. In der Personalabteilung deutet ein Eintrittsdatum eines Mitarbeiters, das drei Jahre vor dem erfassten Geburtsdatum liegt, auf eine feldübergreifende Anomalie hin, die eine einfache Prüfung des Datumsformats nicht erkennt.
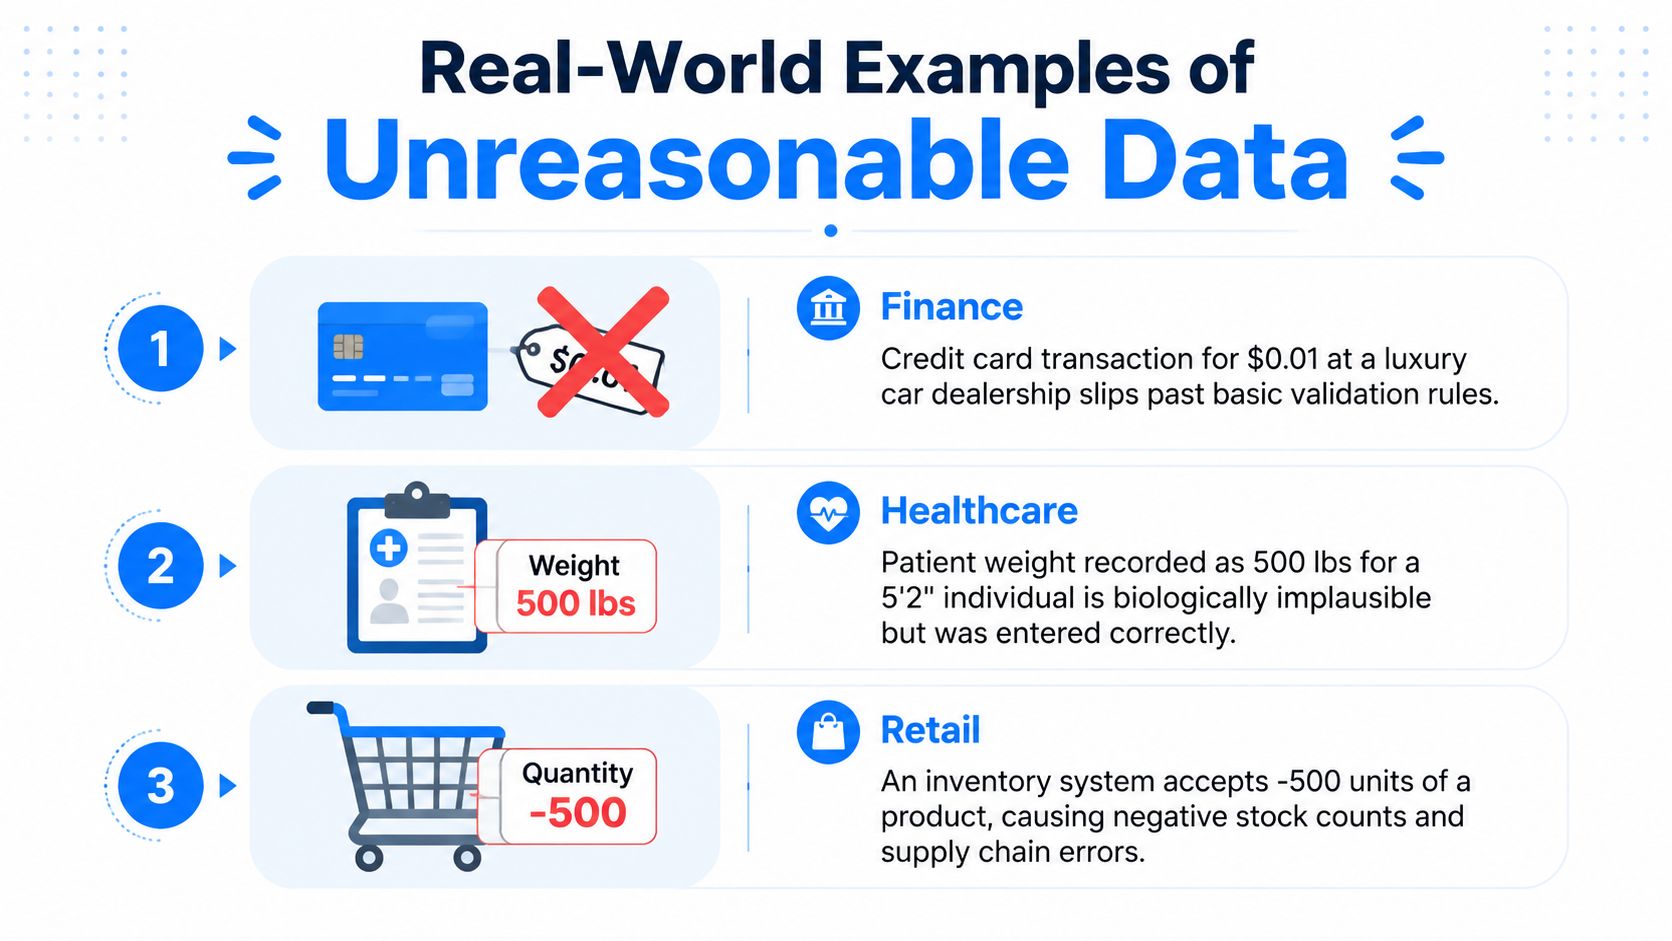
Die bereitgestellten Beispiele veranschaulichen zudem ein wichtiges Funktionsprinzip: Ein ungewöhnlicher Datensatz ist nicht automatisch falsch. Ein Patientengewicht, das biologisch unplausibel erscheint, könnte auf ein Problem bei der Einheitenumrechnung, eine echte Messung oder einen Eintrag zurückzuführen sein, der dem falschen Patienten zugeordnet wurde. Eine negative Lagerbestandsmenge könnte eher eine Anpassung als eine fehlgeschlagene Transaktion darstellen.
Plausibilität unterstützt die Untersuchung von Datenqualitätsproblemen, indem sie die Erkennung von der Behebung trennt. Das System identifiziert ein Verhalten, das Aufmerksamkeit verdient, während ein Mensch oder ein fachlicher Workflow entscheidet, ob es korrigiert, genehmigt, unter Quarantäne gestellt oder dokumentiert werden soll.
Wie Unternehmen Data Reasonableness messen
Unternehmen messen Plausibilität, indem sie explizites Fachwissen mit beobachtetem Datenverhalten kombinieren. Es gibt keine einzelne, universelle Plausibilitätsmetrik. Die richtige Methode hängt von der Branche, der Population, der Entscheidung und den Kosten ab, die entstehen, wenn eine Anomalie übersehen wird.
Starten Sie mit bekannten Erwartungen
Geschäftsregeln und Schwellenwerte sind der klarste Ausgangspunkt. Ein Team könnte ein Alter von 187 Jahren, einen Produktpreis außerhalb der Kategoriegrenzen oder einen Transaktionsbetrag über einer genehmigten Obergrenze markieren. Kennzahlen liefern zusätzlichen Kontext, wie z. B. Schadensfälle pro Police, Rücksendungen pro Bestellung oder Umsatz pro aktivem Kunden.
Diese Kontrollen funktionieren gut, wenn die erwartete Bedingung bekannt ist. Sie werden jedoch unzuverlässiger, wenn sich das Verhalten je nach Saison, Kundensegment, Standort oder Produkttyp ändert.
Fügen Sie Baselines und Peer-Vergleiche hinzu
Historische Baselines vergleichen das aktuelle Verhalten mit früheren Beobachtungen. Teams können Änderungen des Volumens, des Mittelwerts, des Medians, der Perzentile, der Verteilung oder des Anteils der Werte außerhalb eines erwarteten Bereichs untersuchen. Ein plötzlicher Anstieg der Registrierungen, eine neue Häufung ungewöhnlich großer Bestellungen oder eine Verschiebung der Kundenaktivität können auf einen Pipeline-Fehler oder ein echtes geschäftliches Ereignis hindeuten.
Peer-Group-Vergleiche reduzieren Fehlalarme. Eine große Transaktion kann für einen Firmenkunden normal und für einen Privatkunden ungewöhnlich sein. Eine regionale Umsatzveränderung sollte im Vergleich zu ähnlichen Regionen interpretiert werden und nicht anhand eines universellen Schwellenwerts.
Nutzen Sie statistische und systemübergreifende Analysen
Verteilungsanalysen können Veränderungen aufdecken, die Regeln für einzelne Datensätze übersehen. Teams können Ausreißer überwachen, Verteilungen im Zeitverlauf vergleichen und Änderungen der Streuung oder der zentralen Tendenz untersuchen. Die Anomalieerkennung erweitert diesen Prozess, indem sie erwartete Muster lernt und Abweichungen hervorhebt.
Feldübergreifende Prüfungen liefern logischen Kontext. Versanddaten sollten auf Bestelldaten folgen, die Patientendosierung sollte zu den Patientenmerkmalen passen und ein Produktpreis sollte für seine Kategorie sinnvoll sein. Systemübergreifende Prüfungen können operative Datensätze mit vertrauenswürdigen Referenzdaten oder verwandten internen Systemen vergleichen.
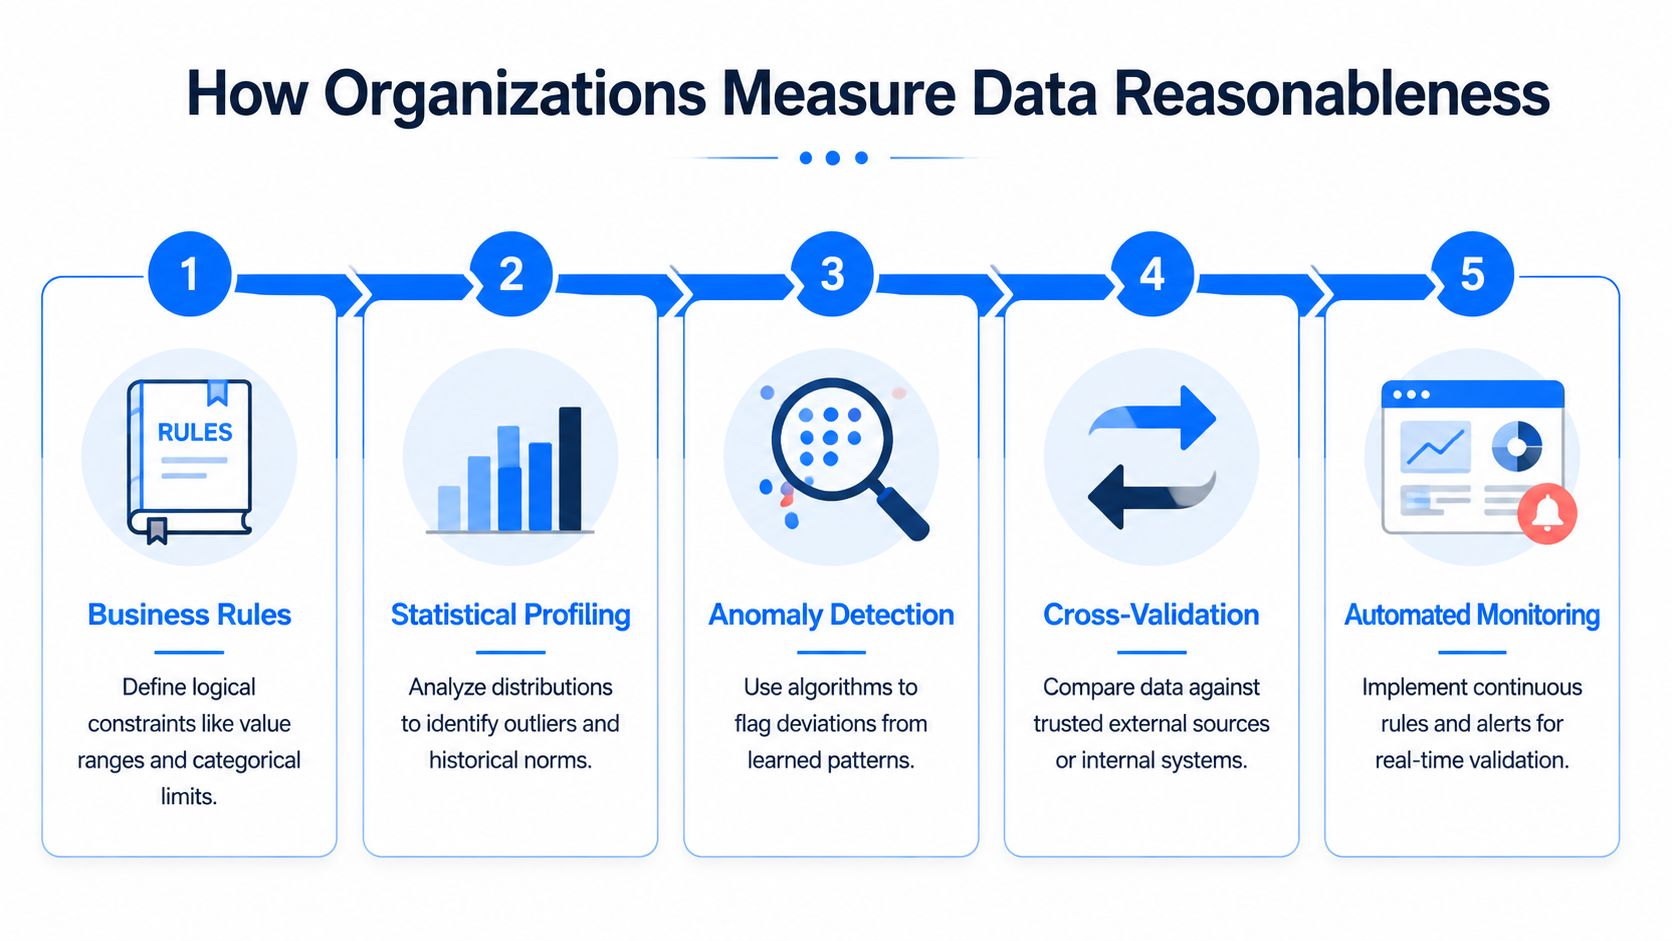
Ein praktisches Messprogramm kann den Prozentsatz der Werte außerhalb der erwarteten Bereiche, den Prozentsatz der zur Untersuchung markierten Datensätze, Abweichungen von einer historischen Baseline, Verteilungsänderungen und Volumenverschiebungen verfolgen. Diese Kennzahlen beschreiben Signale, keine Urteile. Ein Datenqualitäts-Framework für CDOs kann helfen, diese Signale mit Zuständigkeiten, governance und Entscheidungsrisiken zu verknüpfen, während Datenqualitätsmetriken einen Rahmen bieten, um das Überwachungsmodell zu formalisieren.
Die überarbeitete Ausgabe DAMA-DMBOK® 2.0 Revised Edition behandelt Reasonableness als Standarddimension der Datenqualität. DAMA erklärt, dass das überarbeitete Framework 9 Dimensionen enthält, Währung (Currency) hinzufügt und Reasonableness anstelle des früheren Begriffs Reasonability verwendet. Diese Positionierung unterstreicht die Notwendigkeit, die Plausibilität getrennt von Genauigkeit, Gültigkeit und Konsistenz zu überwachen.
Warum Plausibilität für Data Analytics und KI entscheidend ist
Unplausible Daten können Data Analytics verfälschen, ohne eine herkömmliche Validierungsprüfung auszulösen. Eine große Transaktion kann Umsatz-Dashboards verzerren, ein künstlicher Anstieg von Registrierungen kann eine Wachstums-KPI verändern und eine falsche Maßeinheit kann operative Durchschnittswerte verschieben. Führungskräfte könnten dann auf Basis eines Berichts agieren, der zwar technisch vollständig, aber im Kontext irreführend ist.
KI- und Machine-Learning-Systeme stehen im großen Stil vor dem gleichen Problem. Ein Datensatz kann isoliert betrachtet statistisch normal wirken, während er der geschäftlichen Realität widerspricht, die er darstellt. Eine hochpreisige Lebensmittelbestellung, die als routinemäßiges Kaufverhalten eingestuft wird, kann Segmentierung, Prognose, Betrugserkennung oder Empfehlungslogik beeinflussen, ohne einen offensichtlichen Schema- oder Typfehler zu erzeugen.
Plausibilität ist die Ebene, die hinterfragt, ob die Daten für die Entscheidung, die sie beeinflussen sollen, vertretbar bleiben.
Risiko- und Betrugsteams sind auf kontextuelle Signale angewiesen, da sich verdächtiges Verhalten oft innerhalb zulässiger Werte verbirgt. Eine Forderung kann unter einem formalen Limit liegen, sich aber drastisch von der Historie des Antragstellers unterscheiden. Ein Standort kann ein gültiges Koordinatenformat verwenden, während er ein unplausibles Bewegungsmuster impliziert. Eine synthetische Identität kann vollständige, konsistente Felder enthalten, während sie Beziehungen kombiniert, die nicht zum normalen Kundenverhalten passen.
Unternehmen müssen auch erklären können, warum automatisierte Entscheidungen auf bestimmten Daten beruhten. Ein Datensatz, der für ein Modell, einen aufsichtsrechtlichen Bericht oder eine Risikobewertung verwendet wird, benötigt mehr als nur strukturelle Gültigkeit. Teams sollten in der Lage sein aufzuzeigen, was sie überwacht haben, welche Muster Überprüfungen ausgelöst haben, wer die Ausnahme bewertet hat und ob der Wert als legitimer Ausreißer beibehalten oder als Fehler korrigiert wurde. Die KI-Datenqualitätsperspektive ist daher praktischer Natur und nicht bloß technisch.
Untersuchungen zur KI-Bereitschaft verdeutlichen das Ausmaß dieser Herausforderung. Eine weltweite Umfrage ergab, dass nur 12 % der Befragten ihre Daten für KI als ausreichend qualitativ hochwertig und zugänglich erachteten, während 64 % die Datenqualität als ihre größte Herausforderung für die Datenintegrität nannten und 77 % die Qualität als durchschnittlich oder schlechter einstuften, wie aus den Planungserkenntnissen für 2025 von Precisely hervorgeht. Plausibilität trägt zur KI-Eignung bei, kann jedoch unzugängliche, schlecht verwaltete oder inkonsistent definierte Daten nicht im Alleingang beheben.
Wie digna ein kontinuierliches Plausibilitätsmonitoring unterstützt
Kontinuierliches Monitoring behandelt Plausibilität als operatives Signal und nicht als periodisches Audit. digna Data Anomalies ist die primäre Funktion zur Identifizierung unerwarteter Verteilungsänderungen, plötzlicher Spitzen oder Einbrüche, ungewöhnlicher Werte, Änderungen des historischen Verhaltens und Abweichungen von etablierten Mustern.
Betrachten Sie einen Workflow für Finanztransaktionen. Das Unternehmen definiert einen gültigen Transaktionsbetrag zwischen 0 € und 1 Million €. Eine Transaktion von 800.000 € besteht diese Regel, aber die historischen Transaktionen desselben Kunden liegen normalerweise zwischen 50 € und 500 €.
Die Module dienen unterschiedlichen Zwecken:
digna Data Validation bestätigt, dass der Betrag die explizite technische und geschäftliche Regel erfüllt.
digna Data Anomalies markiert den Betrag, da er vom etablierten Verhalten des Kunden abweicht.
digna Data Analytics liefert historische Trends und Kontext für den Prüfer.
Ein Benutzer oder Workflow entscheidet, ob die Transaktion legitim ist, eine Eskalation erfordert oder auf ein Datenproblem hindeutet.
Die Validierung prüft, was Sie explizit definiert haben. Die Erkennung von Anomalien kann Verhaltensweisen identifizieren, die Sie nicht explizit vorhergesehen haben.
digna Data Analytics unterstützt historische Analysen, Baseline-Überprüfungen, Trendanalysen, Volatilitätsbewertungen und Untersuchungen. digna Data Validation verarbeitet explizite Plausibilitätsbedingungen, einschließlich Bereichen, Domänen, feldübergreifenden Beziehungen und bekannten geschäftlichen Einschränkungen. Zusammen unterstützen diese Funktionen sowohl deterministische als auch verhaltensbasierte Kontrollen, ohne jeden ungewöhnlichen Wert sofort als Fehler zu behandeln.
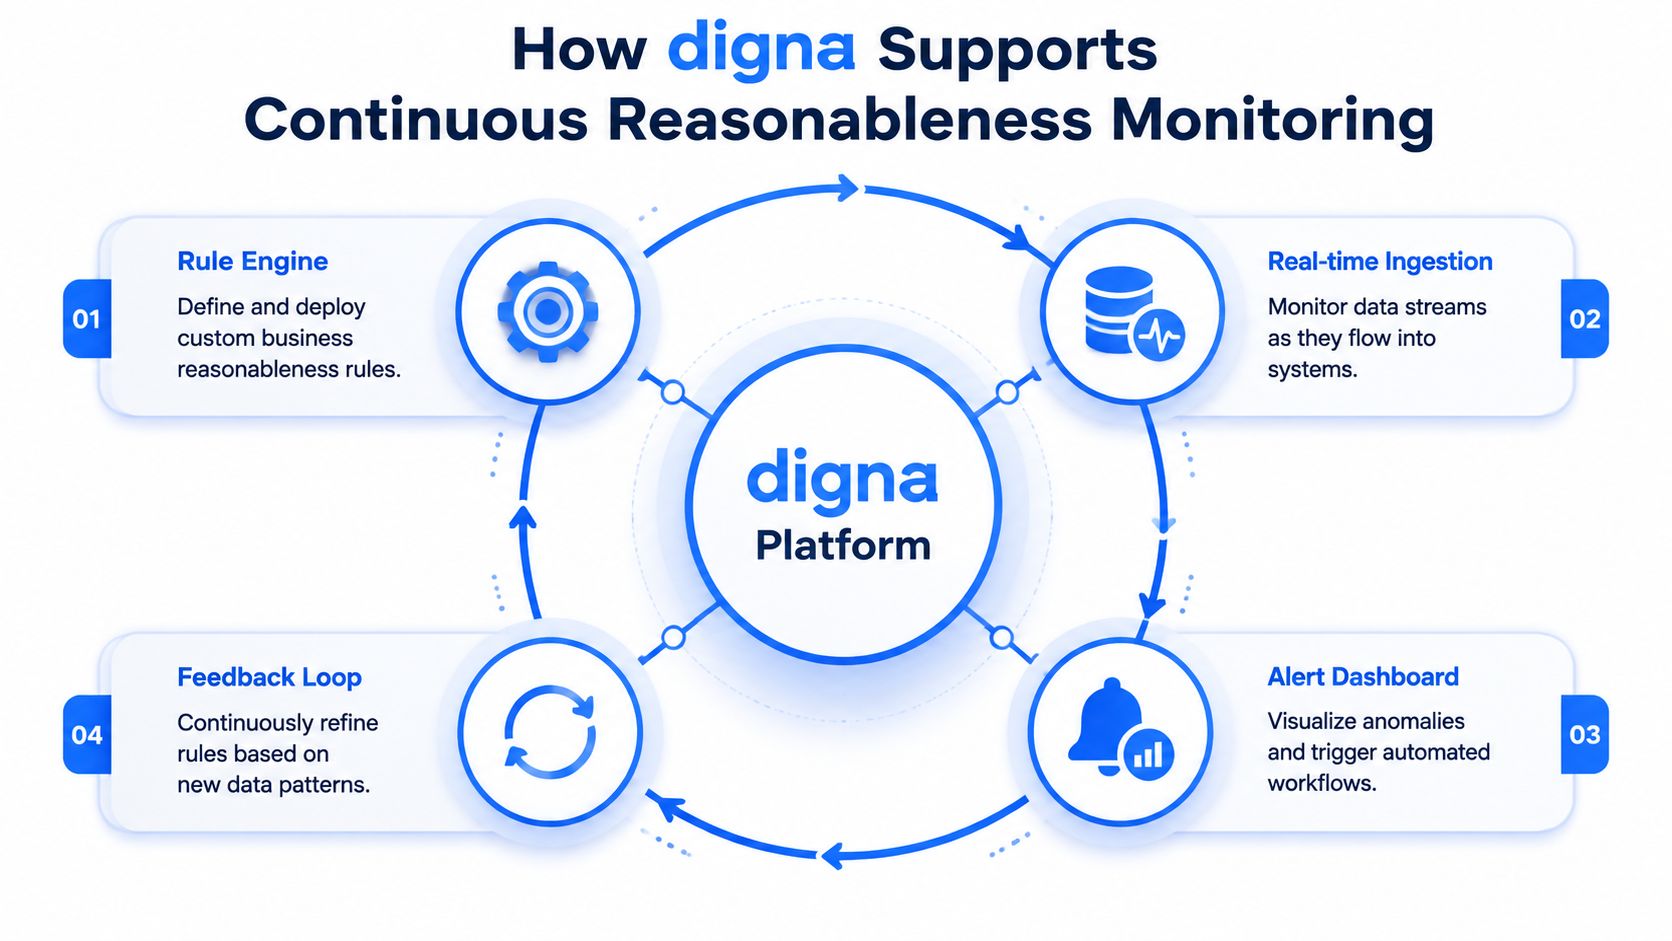
Die Plattform führt Metrikberechnungen und Analysen innerhalb der Datenbanken des Kunden durch, sodass Unternehmen ihre Daten nicht verschieben müssen. Die Bereitstellung kann in einer Private Cloud oder einer On-Premises-Installation in der Cloud, VPC oder im Rechenzentrum des Kunden erfolgen. Diese Architektur ist wichtig, wenn Finanz-, Gesundheits-, Behörden- oder andere sensible Daten innerhalb einer kontrollierten Infrastruktur verbleiben müssen.
Ein kontinuierlicher Workflow sollte auch aus Entscheidungen lernen. Wenn Prüfer bestätigen, dass ein ungewöhnliches Muster legitim ist, können Teams Schwellenwerte, Peer-Groups oder die Prüfungslogik verfeinern. Wenn sie einen Fehler bestätigen, kann das Unternehmen das Problem bis zur Quelle zurückverfolgen und eine gezielte Regel hinzufügen. Dieses Feedback verhindert, dass das Plausibilitätsmonitoring zu einer Flut störender Warnmeldungen führt.
Häufig gestellte Fragen zu Data Reasonableness
Was ist Data Reasonableness?
Data Reasonableness bewertet, ob Daten innerhalb ihrer erwarteten geschäftlichen, logischen, statistischen oder kontextuellen Bedingungen sinnvoll sind.
Was bedeutet Plausibilität in der Datenqualität?
Es ist eine eigenständige Dimension der Datenqualität, die Plausibilität und erwartetes Verhalten bewertet, nicht nur das Format oder die Korrektheit.
Was ist ein Beispiel für unplausible Daten?
Ein Betrag, der einen technischen Bereich zwar besteht, sich aber drastisch vom normalen Transaktionsmuster eines Kunden unterscheidet, ist ein Beispiel.
Wie misst man Plausibilität?
Verwenden Sie Geschäftsregeln, Schwellenwerte, Kennzahlen, erwartete Bereiche, historische Baselines, Peer-Vergleiche, Verteilungsanalysen, Trendanalysen und Anomalieerkennung.
Was ist der Unterschied zwischen Plausibilität und Gültigkeit?
Die Gültigkeit prüft eine explizite Regel. Die Plausibilität prüft, ob der Wert im Kontext Sinn ergibt.
Können Daten gültig, aber unplausibel sein?
Ja. Ein Wert kann seine Format- und Bereichsregeln erfüllen, während er dem normalen geschäftlichen Verhalten widerspricht.
Können unplausible Daten dennoch genau sein?
Ja. Ein seltener oder ungewöhnlicher Wert kann die Realität genau widerspiegeln, weshalb er oft untersucht statt automatisch abgelehnt werden sollte.
Wie kann die Plausibilität kontinuierlich überwacht werden?
Kombinieren Sie deterministische Validierung mit automatischer Anomalieerkennung, Baseline-Überwachung, Warnmeldungen und manuellen Überprüfungsprozessen.
Welches digna-Modul unterstützt Data Reasonableness?
digna Data Anomalies ist die Kernfunktion, unterstützt von digna Data Analytics für den Kontext und digna Data Validation für explizite Regeln.
digna bietet modulare Anomalieerkennung, historische Analysen und Validierung auf Datensatzebene, um zu überwachen, ob sich Unternehmensdaten wie erwartet verhalten. Besuchen Sie digna, um zu erfahren, wie kontinuierliches Plausibilitätsmonitoring zuverlässigere Data Analytics und KI unterstützen kann.
Häufig gestellte Fragen
Was ist Data Reasonableness?
Sie bewertet, ob Daten innerhalb ihrer erwarteten fachlichen, logischen, statistischen oder kontextuellen Bedingungen Sinn ergeben. Ein Datensatz kann eine Typprüfung bestehen, in einen zulässigen Bereich passen und dennoch jedem falsch erscheinen, der das Geschäft versteht.
Wie sieht ein unplausibler Wert aus?
Plausibel, bis man ihn liest. Ein akzeptiertes Patientenalter von 187, eine Transaktion über 500.000 Euro, wo typische Transaktionen unter 500 Euro liegen, oder ein plötzlicher Anstieg der täglichen Registrierungen um 400 % bestehen jeweils ihre Feldbedingungen und verdienen dennoch eine Untersuchung.
Bedeutet eine Plausibilitätsmarkierung, dass der Datensatz falsch ist?
Nein. Eine Plausibilitätsmarkierung ist eine Aufforderung zur Untersuchung und kein automatischer Beweis für einen Fehler. Sie als Beweis zu behandeln erzeugt genau jene Fehlalarmmüdigkeit, wegen der Teams den Kanal irgendwann nicht mehr lesen.
Warum genügen deterministische Regeln nicht?
Weil sie Form statt Plausibilität prüfen. Eine Regel kann bestätigen, dass ein Feld eine Zahl enthält, ein Datum das richtige Format nutzt oder ein Betrag unter einer konfigurierten Obergrenze bleibt, und ein Abrechnungssystem im Krankenhaus akzeptiert ein Patientenalter von 150 in allen drei Punkten anstandslos.
Was liefert die kontextuelle Schicht?
Historische Baselines, die zeigen, ob die heutigen Werte früherem Verhalten ähneln, und Peer-Vergleiche, die Filiale, Produkt, Kundin oder Region mit ähnlichen Gruppen vergleichen. Beide beantworten Fragen, die ein einzelner Datensatz über sich selbst nicht beantworten kann.


