Ungleiche Datenquellen: Ein praktischer Leitfaden zur Integration
|
7
min. Lesezeit
Wahrscheinlich haben Sie das schon selbst erlebt. Ein Montags-Standup beginnt damit, dass eine Person berichtet, das CRM weise ein starkes letztes Quartal aus, die Finanzabteilung meint, die Margenentwicklung sehe anders aus, und das Product Warehouse zeigt eine völlig dritte Zahl. Niemand lügt, aber im Raum wird es trotzdem still, weil jeder Bericht eine leicht andere Version des Unternehmens beschreibt.
Genau das macht disparate sources of data so frustrierend. Der Bruch beginnt selten mit einem dramatischen Ausfall, er beginnt mit winzigen Entscheidungen – einem Zeitstempel, der in einer Pipeline so und in einer anderen anders interpretiert wird, einer Erstattungsregel, die in einer anderen aktualisiert wurde, oder der Definition von „aktiven Kunden“, die sich gerade so weit verschoben hat, dass das Dashboard verzerrt wird. Wenn Sie einen Berichts-Stack geerbt haben, der durch frühere Initiativen, Fusionen, Anbieterwechsel und „temporäre“ Lösungen, die nie verschwunden sind, gewachsen ist, wissen Sie bereits, wie normal sich das anfühlt.
Inhaltsverzeichnis
Vier praktische Herausforderungen, auf die Sie zuerst stoßen werden
Integrationsstrategien, zwischen denen es sich zu wählen lohnt
Eine Arbeits-Checkliste für Ihr nächstes Integrationsprojekt
Wenn Ihre Berichte nicht mehr übereinstimmen
Ein Finanzverantwortlicher kommt mit einer Tabellenkalkulation herein, ein Produktanalyst öffnet das Warehouse-Dashboard und das CRM-Team verweist auf seine eigene Umsatzansicht. Alle drei Zahlen sehen auf den ersten Blick plausibel aus, was die Unstimmigkeit eher verschlimmert als verbessert. Das Team erhält kein klares Fehlersignal, sondern drei plausible Geschichten, die nicht alle gleichzeitig wahr sein können.
Das ist meist der Moment, in dem die Schuld dem Warehouse, dem BI-Layer oder dem letzten angefassten ETL-Job gegeben wird. Die Ursache liegt jedoch oft weiter oben (upstream). Eine Pipeline hat möglicherweise Zeitstempel in die lokale Zeit umgerechnet, eine andere hat vielleicht eine neue Erstattungsrichtlinie angewendet und eine dritte zählt „aktive Kunden“ immer noch nach einer Definition, die nach dem letzten Launch niemand dokumentiert hat.
Deshalb geht es bei der Datenabstimmung weniger darum, „Berichte passend zu machen“, sondern vielmehr darum, nachzuverfolgen, welches System welche Version der Realität besitzt. Ein nützlicher Ausgangspunkt ist ein einfaches Denkmodell: Jede Quelle hat ihre eigenen Regeln, und diese Regeln können voneinander abweichen, ohne dass ein einzelnes Team die Absicht hatte, Probleme zu verursachen. Eine leicht verständliche Definition dieses Abstimmungsproblems finden Sie in dignas Übersicht zur Datenabstimmung.
Praktische Regel: Wenn drei Berichte nicht übereinstimmen, fangen Sie nicht damit an, das Dashboard neu zu schreiben. Fragen Sie stattdessen zuerst, welches Feld, welche Regel oder welcher Zeitstempel sich zuerst geändert hat.
Die Verwirrung ist deshalb so weit verbreitet, weil moderne Daten-Stacks aus historisch gewachsenen Strukturen bestehen und nicht aus einem einzigen, sauberen Architekturdiagramm. Das bedeutet, dass dasselbe Geschäftsereignis in einem CRM, einem Finanzsystem, einem Warehouse und einem Support-Tool jeweils mit einer eigenen Frequenz und einem eigenen Vokabular dargestellt werden kann. Sobald das passiert, hört „die Zahl“ auf, eine einzige Zahl zu sein, und wird zum Verhandlungsobjekt zwischen den Systemen.
Was disparate Datenquellen wirklich bedeuten
„Disparat“ klingt nach einem Formatproblem, aber das ist nur die erste Ebene. Eine Quelle kommt als JSON an, eine andere als CSV, eine weitere als Parquet, und ein Export eines Drittanbieters ist in seiner eigenen Struktur gefangen. Schon auf dieser Ebene verändert die Form der Daten, wie Sie diese aufnehmen, parsen und validieren.
Die nächste Ebene ist die Frequenz (Cadence). Eine nächtliche Batch-Datei, ein Streaming-Event-Feed und eine manuell gepflegte Tabellenkalkulation verhalten sich in einer Pipeline völlig unterschiedlich. Wenn Sie sie gleich behandeln, kann die aktuellste Quelle dennoch die am wenigsten vertrauenswürdige sein, weil sie zur falschen Zeit mit den falschen Erwartungen eintrifft.
Dann kommt die Ebene, die die meisten Anleitungen überspringen: die Semantik. Zwei Systeme können beide eine Spalte namens customer_id enthalten, aber bei dem einen handelt es sich um den Primärschlüssel des führenden Systems (System of Record), während es beim anderen ein Marketing-Identifikator ist, der für das Kampagnen-Reporting anonymisiert wurde. Die Bezeichnungen stimmen überein, die Bedeutung nicht – und genau hier führen naive Joins in die Irre.

Der Stapel der Abweichungen
Eine gute Metapher für disparate sources of data ist ein Stapel. Formatunterschiede liegen ganz unten, Systemgrenzen darüber, und semantische Unterschiede bilden die Spitze, wo die geschäftliche Bedeutung lebt. Jede Schicht verstärkt die darunter liegende, weshalb ein Join technisch erfolgreich aussehen und analytisch dennoch völlig falsch sein kann.
Wenn Teams nach einem besseren Discovery-Prozess über Warehouses, APIs und Legacy-Tools hinweg suchen, benötigen sie in der Regel eine Möglichkeit, diese Schichten frühzeitig sichtbar zu machen. Ein praktischer Ausgangspunkt sind die Empfehlungen zur Data Discovery von digna, da die Bestandsaufnahme der Quellen und die Überprüfung der Bedeutung stattfinden müssen, bevor Transformationen fehlerhafte Annahmen zementieren.
Ein Datensatz kann perfekt formatiert und dennoch falsch für die Frage sein, die Sie stellen.
Das ist das zentrale Missverständnis. Oft wird angenommen, dass es bei der Datenintegration hauptsächlich darum geht, Bytes von einem Ort an einen anderen zu verschieben. In der Praxis geht es darum, Format, Frequenz, Systemdesign und geschäftliche Bedeutung aufeinander abzustimmen, damit die finale Ansicht nicht nur erfolgreich geladen wird, sondern auch die Wahrheit wiedergibt.
Vier praktische Herausforderungen, auf die Sie zuerst stoßen werden
Die ersten Integrationsprobleme zeigen sich schnell und wirken meist alltäglich. Ein Stripe-Webhook-Payload kommt als verschachteltes JSON an, während ein Legacy-ERP immer noch nächtliche Dateien mit fester Breite ausgibt. Die Abweichung der Form ist offensichtlich, aber die tatsächlichen Kosten liegen in der ständigen Schema-Inferenz und der Arbeitszeit, die darauf verwendet wird, zu entscheiden, welches Feld autoritativ ist.
Die vier frühzeitig auftretenden Fehlermuster
Herausforderung | Wie es aussieht | Typisches Symptom |
|---|---|---|
Format-Heterogenität | Verschachteltes JSON auf der einen Seite, Exporte mit fester Breite auf der anderen | Load-Jobs brechen ab oder inferieren das falsche Schema |
Frequenz-Abweichung | Echtzeit-Tickets gemischt mit wöchentlichen Umfragedateien | Dashboards veralten unbemerkt und verwirren Nutzer |
Qualitätsunterschiede | Anreicherung durch Drittanbieter neben unvollständigem First-Party-Clickstream | Nullwerte, Duplikate und instabile Aggregate |
Semantischer Konflikt | „Land“ bedeutet ISO-Code in einem System und Freitext in einem anderen | Joins gelingen, aber die KPI ist falsch |
Frequenz-Abweichungen führen Teams am häufigsten in die Irre. Support-Tickets können nahezu in Echtzeit einfließen, während Kundenzufriedenheitsumfragen in einer wöchentlichen CSV-Datei eintreffen. Das bedeutet, dass jede Ansicht der „letzten 24 Stunden“ unvollständig sein kann, ohne fehlerhaft zu wirken. Wenn der Analyst das Verzögerungsprofil der jeweiligen Quelle nicht kennt, wird er Aktualitätsunterschiede fälschlicherweise für geschäftliche Veränderungen halten.
Qualitätsunterschiede sind der lautlose Killer. Datenanreicherungen von Drittanbietern können neben First-Party-Clickstream-Daten mit fehlenden Sitzungen, doppelten Identifikatoren oder inkonsistenten Datensätzen stehen – und die zusammengeführte Ausgabe sieht dennoch sauber genug aus, um eine flüchtige Prüfung zu bestehen. Diese Art von Instabilität ist genau der Grund, warum die Quellenqualität als Teil des Designs behandelt werden muss und nicht als Aufräumarbeit im Nachhinein.
Semantische Konflikte sind am schwersten zu lösen, da sie sich hinter vertrauten Feldnamen verbergen. Eine Quelle, die country für ISO-Codes verwendet, eine andere, die Freitext speichert, und eine dritte, die eine veraltete Abkürzung nutzt, sind in ihren jeweiligen Systemen alle „richtig“. In dem Moment, in dem Sie sie vergleichen, bricht die geschäftliche Bedeutung in sich zusammen.
Für Teams, die verstehen wollen, wie sich struktureller Drift in fehlerhafte Pipelines verwandelt, helfen die Empfehlungen zum Schema-Drift von digna, das Problem als ein operationales und nicht nur als ein lästiges Modellierungsproblem zu betrachten.
Wenn Ihnen der Feldname bekannt vorkommt, werden Sie hellhörig. Hinter vertrauten Namen verstecken sich semantische Fehler.
Das ist der Grund, warum Integrationsprojekte so oft ins Stocken geraten. Die ersten Probleme sind nicht exotisch, sie sind gewöhnlich und wiederholen sich. Sie zwingen Teams dazu, sich zwischen Schnelligkeit und Vertrauen zu entscheiden, noch bevor die Struktur des Stacks überhaupt feststeht.
Integrationsstrategien, zwischen denen es sich zu wählen lohnt
ETL, ELT, CDC und kanonische Modellierung lösen unterschiedliche Probleme, und man kann sie leicht falsch einsetzen, wenn man sie wie eine Ideologie behandelt. ETL funktioniert, wenn Konsumenten aufbereitete, kuratierte Daten benötigen und die Quellsysteme so stabil sind, dass man sie vor dem Laden transformieren kann, ohne ständige Nacharbeiten leisten zu müssen. Es eignet sich gut für Legacy-Konsumenten, Compliance-Feeds und Berichts-Layer, die nur geprüfte Strukturen sehen sollten.
ELT ist sinnvoller, wenn das Warehouse schnell ist und Analysten zuerst Rohdatenintegrität und erst danach die Transformation wünschen. So können Teams die Details der Quelle bewahren und die Logik später anpassen, ohne die Daten erneut abrufen zu müssen. Das ist besonders nützlich, wenn sich geschäftliche Fragen schneller ändern als die Quellsysteme.
CDC gehört in die operative Schiene. Wenn nachgelagerte Systeme Änderungen an den Quellen schnell widerspiegeln müssen, hält die Change Data Capture die Verzögerung so gering, dass Produkt-, Support- oder Finanz-Workflows stets mit den aktuellen Ereignissen synchron bleiben. Der Nachteil ist, dass CDC Unsicherheiten schneller weitertragen kann und daher beim Eintreffen der Daten dennoch validiert werden muss.
Die kanonische Modellierung löst ein ganz anderes Problem: die Einigkeit. Wenn Vertrieb, Produkt und Finanzen alle dieselbe Definition von Kunde oder Produkt benötigen, bevor nachgelagerte Arbeiten beginnen, bietet ihnen ein kanonisches Modell einen gemeinsamen Vertrag. Das erfordert anfangs mehr Zeit, verhindert aber, dass jedes Team nachgelagert seine eigene Wahrheit erfindet.
Die intelligentesten Stacks kombinieren diese Muster meist. Ein Team könnte CDC in eine Staging-Zone laden, ELT innerhalb des Warehouses nutzen, ein kanonisches Modell in BI einspeisen und dennoch ETL verwenden, um Exporte für ein Altsystem aufzubereiten. Das ist keine Inkonsistenz, sondern eine zweckmäßige Architektur.
Wenn Sie Integrationsoptionen für Analysen und datenschutzrelevante Anwendungsfälle vergleichen, kann eine Privacy-First BI-Lösung ein nützlicher Kontext sein, da das Integrationsmuster und der Konsum-Layer meist zusammen entworfen werden müssen.
Für Warehouse-zentrierte Projekte ist dignas Integrationsseite für Data Warehouses eine nützliche Referenz dafür, wie die Lade- und Bereitstellungsebenen in der Praxis zusammenhängen.
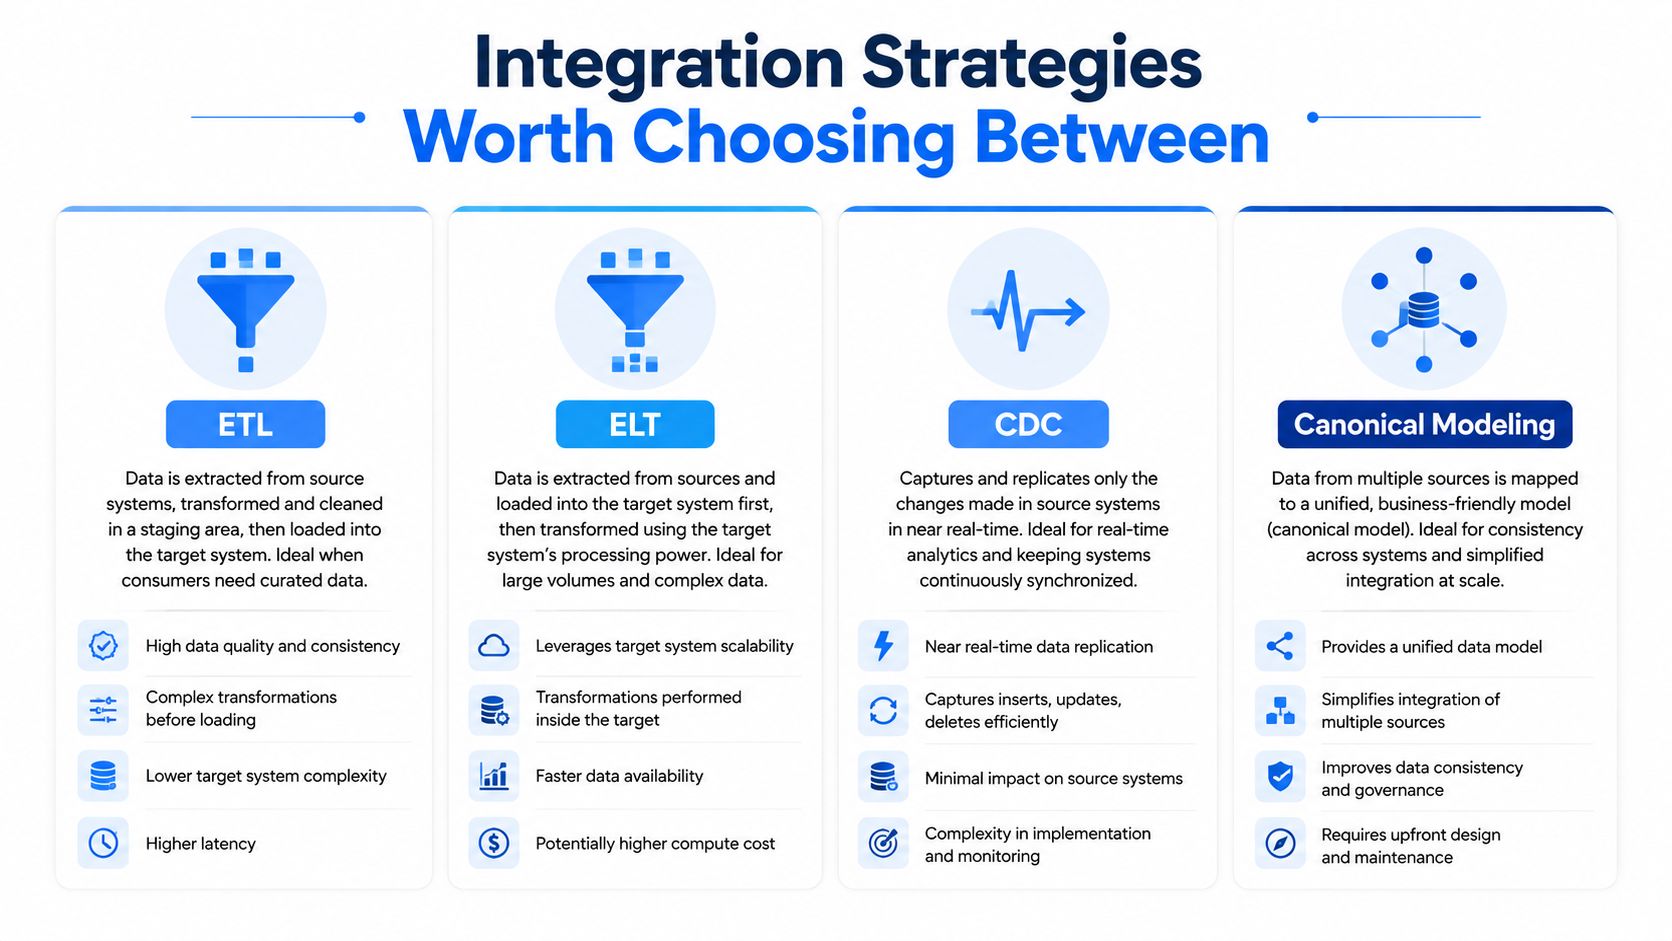
Die richtige Integrationsstrategie ist diejenige, die zum Konsumenten, den Latenzanforderungen und dem Maß an Vertrauen passt, das Sie an den Systemgrenzen durchsetzen können.
Viele Teams verlieren Wochen mit der Diskussion darüber, welches Muster „modern“ ist. Diese Diskussion geht am Kern vorbei. Die entscheidende Frage ist, welches Muster den semantischen Vertrag so klar hält, dass nachgelagerte Teams die Daten nutzen können, ohne sie mühsam rekonstruieren zu müssen.
Harmonisierung und Validation That Hold Up
Die Harmonisierung beginnt mit der Deduplizierung, aber nicht mit der vereinfachten Variante, die davon ausgeht, dass bereits exakte Schlüssel existieren. Unabhängige Systeme teilen selten perfekte Identifikatoren, weshalb Blocking-Keys und probabilistisches Matching oft notwendig werden, um festzustellen, welche Datensätze sich wahrscheinlich auf dieselbe Entität beziehen. Dieser Schritt sollte erfolgen, bevor die Merge-Logik doppelte Zählungen in eine Scheinsicherheit zementiert.
Normalize the meaning before the number
Sobald die Datensätze aufeinander abgestimmt sind, normalisieren Sie die Einheiten. Währungen, Zeitzonen, Maßsysteme und Geschäftsjahreskalender führen zu unsichtbaren Abweichungen, wenn Teams davon ausgehen, dass ein Wert überall dasselbe bedeutet. Eine Umsatzsumme in Lokalzeit und eine Umsatzsumme in UTC können beide korrekt und dennoch nicht vergleichbar sein.
Als Nächstes folgt die semantische Abstimmung. Mapping-Tabellen und autoritative Definitionen sind hier wichtig, da Feldnamen oft Unterschiede in den Geschäftsregeln verbergen, die keine Typprüfung aufdecken kann. Ein sauberer Spaltenname hilft nicht, wenn eine Quelle „Kunde“ als Konto, eine andere als Nutzer und eine dritte als Abrechnungseinheit behandelt.
Dasselbe Prinzip zeigt sich bei der Arbeit am „Golden Record“, bei der Teams entscheiden müssen, welche Version eines Kunden, Produkts oder Standorts fortgeführt werden soll. Wenn Sie eine weitere praktische Formulierung dieses Problems wünschen, ist der BatchData Golden Record-Ansatz eine nützliche externe Referenz dafür, wie eine gemeinsame Datensatzebene die nachgelagerte Konsistenz verändert.
Die Validierung sollte auf der Harmonisierung aufsetzen und nicht erst danach erfolgen. Schema-Prüfungen gehören an die Grenze, Prüfungen der referentiellen Integrität gehören zwischen die Systeme, Geschäftsregeln wie nicht-negative Mengen gehören in die Pipeline und Abstimmungen auf Zeilenebene sollten Kontrollsummen aus jeder Quelle vergleichen. Für eine strukturierte Herangehensweise an diese Prüfungen ist dignas Leitfaden für Validierungsregeln relevant, da die Validierung mit den Daten mitreisen muss und nicht erst warten darf, bis sich ein Dashboard beschwert.
Wo Validierung hingehört
Validierung ganz am Ende kommt zu spät. Bis das Dashboard fehlerhaft aussieht, ist der Kontext, der den Fehler erklären würde, bereits veraltet.
Das beste Muster ist die Validierung bei jeder Übergabe, da bei jeder Übergabe noch der Kontext der Quelle, der Eigentümer und die ursprüngliche Erwartung vorhanden sind. Das macht die Fehlerbehebung schneller und Diskussionen kürzer. Es verhindert auch, dass Teams zusammengeführte Daten als vertrauenswürdig behandeln, nur weil sie einen Ladejob überstanden haben.
Monitoring as an Early Warning System
Monitoring hilft nur, wenn es die Ursache erfasst, bevor sich der Bericht in ein Rätsel verwandelt. Der sauberste Weg dorthin ist, Timeliness, Anomalien und Schema-Änderungen gemeinsam und nicht in getrennten Warteschlangen zu verfolgen. Wenn eine Quelle verspätet eintrifft, veraltet das Dashboard bereits – selbst wenn die Zahlen immer noch poliert aussehen.
Das Timeliness-Monitoring ist die erste Verteidigungslinie, da Probleme mit der Aktualität oft upstream beginnen und sich downstream ausbreiten, ohne dass ein sichtbarer Fehler auftritt. Wenn eine SLA verletzt wird, muss das Team dies wissen, bevor geschäftliche Nutzer Entscheidungen auf der Grundlage veralteter Daten treffen. Das ist besonders dort wichtig, wo eine verspätet eintreffende Quelle eine KPI verändern kann, ohne die Form des Diagramms zu beeinflussen.
Die Anomalieerkennung deckt eine andere Fehlerklasse ab. Volumenverschiebungen, Verteilungsverschiebungen und Spitzen bei der Nullwert-Rate können einen fehlerhaften Filter, einen fehlenden Join oder ein fehlerhaftes Upstream-Deployment aufdecken, lange bevor jemand einen Umsatzeinbruch bemerkt. Das ist der Wert, wenn man das Verhalten der Quelle beobachtet und nicht nur das Ergebnis im Dashboard.
Das Schema-Tracking schließt den Kreis. Hinzugefügte Spalten, Typänderungen und Abweichungen bei der Nullwert-Zulässigkeit (Nullability Drift) sind die leisen strukturellen Änderungen, die nachgelagerte Konsumenten beeinträchtigen, nachdem eine Pipeline scheinbar „funktioniert“. Für Datensysteme, die auf sich ändernde Klassifizierungs- und Schutzanforderungen reagieren müssen, stellt das NIST fest, dass das Monitoring Änderungen an der Ressource selbst erfassen und bei Bedarf angepasste Kontrollen auslösen sollte. Deshalb gehört das Schema-Tracking in den operativen Kreislauf und nicht nur in die Dokumentation.
Eine praktische Monitoring-Ansicht ist ein nach Quellen gruppiertes Dashboard, bei dem jedem Alarm Lineage-Verweise beigefügt sind. So kann ein Bereitschaftstechniker eine verspätete Datei, eine Volumenanomalie oder eine Schema-Änderung bis zum Ursprungssystem zurückverfolgen, ohne zwischen verschiedenen Tools wechseln zu müssen. Die besten Teams fragen nicht mehr: „Welcher Bericht ist falsch?“, sondern: „Welche Quelle hat sich zuerst geändert?“
Monitoring-Signale und was sie abfangen
Signalkategorie | Was es verfolgt | Frühzeitig erkannter Fehler |
|---|---|---|
Timeliness | Ankunftsverzögerung, fehlende Ladungen, verfrühte Ankünfte | Veraltete Dashboards und unbemerkte Verzögerungen |
Anomalieerkennung | Verschiebungen bei Volumen, Verteilung und Nullwert-Rate | Fehlerhafte Filter, fehlende Joins, Brüche im Upstream |
Schema-Tracking | Hinzugefügte Spalten, Typänderungen, Drift der Nullwert-Zulässigkeit | Pipeline-Ausfälle durch strukturelle Änderungen |
Der Unterschied zwischen reaktivem und proaktivem Monitoring liegt im Timing. Reaktive Teams erfahren von dem Problem, nachdem sich Benutzer beschwert haben. Proaktive Teams fangen die Ursache ab, solange sie noch klein ist, was sowohl Vertrauen als auch Zeit bei der Störungsbeseitigung spart.
Eine Arbeits-Checkliste für Ihr nächstes Integrationsprojekt
Beginnen Sie, bevor Sie die erste Transformation schreiben. Katalogisieren Sie jede Quelle, klassifizieren Sie ihre Frequenz und identifizieren Sie den Eigentümer, der Fragen zu Schema und Bedeutung schnell beantworten kann. Machen Sie semantische Konflikte frühzeitig kenntlich, insbesondere bei Feldern wie Kunde, Umsatz, Land und Produkt.
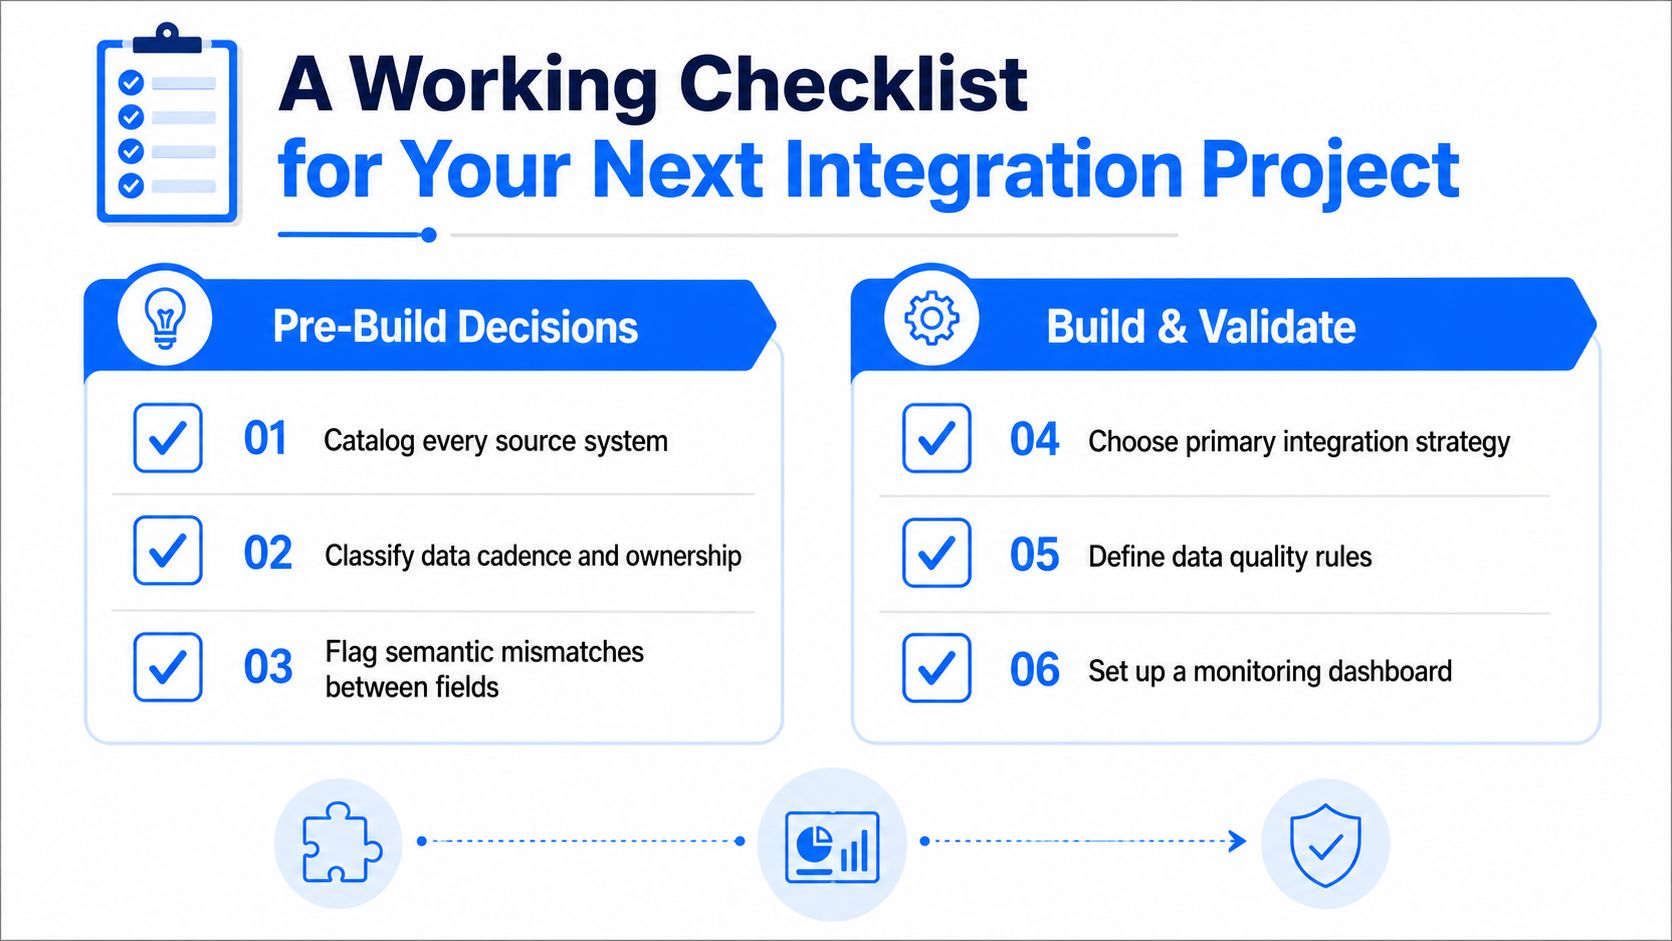
Entscheidungen vor dem Aufbau
Katalogisieren Sie jedes Quellsystem, damit Sie nach dem Go-Live nicht plötzlich eine versteckte Excel-Tabelle entdecken.
Klassifizieren Sie Frequenz und Eigentümerschaft, damit verspätete Dateien und unklare Übergaben nicht zu überraschenden Vorfällen werden.
Kennzeichnen Sie semantische Abweichungen, damit Teams nicht denselben Feldnamen für unterschiedliche geschäftliche Bedeutungen wiederverwenden.
Aufbauen und validieren
Wählen Sie das primäre Integrationsmuster (ETL, ELT oder CDC) basierend auf dem Konsumenten und dem Latenzbedarf.
Dokumentieren Sie zuerst das kanonische Modell, damit Transformationen keine konkurrierenden Definitionen festschreiben.
Legen Sie Validierungsschwellenwerte und Aktualitätsalarme fest, damit fehlerhafte Ladungen schnell fehlschlagen, anstatt in die BI zu sickern.
Fügen Sie Monitore für Schema-Drift und Zeilenzahl-Prüfungen hinzu, damit ausgefallene Quellen und strukturelle Änderungen sichtbar werden, bevor es die Benutzer bemerken.
Wenn Sie eine konkrete Abfolge benötigen: Führen Sie ein eintägiges Quellenaudit durch, entwerfen Sie das kanonische Schema an einem Whiteboard und integrieren Sie eine Observability-Prüfung in die Pipeline mit dem höchsten Datenaufkommen. Das reicht aus, um die erste Welle unbemerkter Fehler zu stoppen, ohne darauf warten zu müssen, dass ein Gremium die Architektur absegnet.
Wenn Ihr Team mit abweichenden Berichten, semantischem Drift oder Pipelines zu kämpfen hat, die erst dann fehlerhaft auffallen, wenn das Dashboard bereits falsch ist, bietet Ihnen digna eine Möglichkeit, Timeliness, Validierung, Schema-Änderungen und Anomalien innerhalb Ihrer eigenen Umgebung zu überwachen. Besuchen Sie digna, um zu sehen, wie sich das in einen echten Integrations-Stack einfügt, und nutzen Sie es als Ausgangspunkt für den Aufbau von Daten, denen Ihre Teams vertrauen können.
Häufig gestellte Fragen
Was bedeutet „disparate Quellen“ tatsächlich?
Mehr als ein Formatproblem. Format ist nur die erste Schicht; darunter liegen unterschiedliche Definitionen, unterschiedliche Aktualisierungstakte und unterschiedliche Vorstellungen davon, welches System welche Version der Wirklichkeit besitzt, und genau das lässt Berichte auseinandergehen.
Wo beginnt man, wenn drei Berichte widersprechen?
Nicht mit dem Umschreiben des Dashboards. Fragen Sie zuerst, welches Feld, welche Regel oder welcher Zeitstempel sich zuerst geändert hat, denn Abstimmung heißt weniger, Berichte zur Deckung zu bringen, als nachzuvollziehen, welches System welche Version der Wirklichkeit besitzt.
Warum erzeugen moderne Stacks dieses Problem?
Weil sie aus angesammelter Geschichte entstehen und nicht aus einem sauberen Architekturdiagramm. Jedes System kam, um ein bestimmtes Problem zu einer bestimmten Zeit zu lösen, und die Überschneidungen dazwischen wurden selten bewusst entworfen.
Wer wird zuerst beschuldigt?
Das Warehouse, die BI-Schicht oder der zuletzt angefasste ETL-Job. Dieser Reflex ist verständlich und meist falsch, denn die Abweichung begann in der Regel weiter vorn in einer Definition und nicht in der Schicht, in der sie sichtbar wurde.
Was verlangt Harmonisierung über Mapping hinaus?
Einigkeit über Verantwortung. Felder zwischen Systemen zu mappen erledigt den mechanischen Teil, während die Entscheidung, welches System für welchen Begriff maßgeblich ist, jener Teil ist, der dieselbe Diskussion nicht jedes Quartal wiederkehren lässt.


