Suchen mit Wildcards: Ein praktischer Leitfaden für 2026
|
9
min. Lesezeit

Die meisten Ratschläge zu Platzhaltern (Wildcards) raten Ihnen dazu, sich Symbole einzuprägen und weiterzugehen. Diese Abkürzung scheitert in der Produktion, da der Fehler meist genau dann auftritt, wenn die Engine Ihr Muster an dem Punkt, an dem Sie es am dringendsten benötigen, nicht mehr als Platzhalter behandelt. Das Ergebnis sind ausbleibende Treffer, ungenaue Suchergebnisse oder eine Abfrage, die harmlos aussieht, aber einen langsamen Scan im gesamten System erzwingt.
Inhaltsverzeichnis
Warum die Platzhaltersuche eine betriebliche Entscheidung ist und nicht nur ein Syntax-Trick
Die vier kanonischen Platzhaltersymbole und was sie abgleichen
Sequenzen beliebiger Länge
Einzelne Zeichen und Zeichenklassen
Alternierung und Regex-ähnliche Strukturen
Plattformübergreifende Platzhalter-Syntax auf einen Blick
Echte Abfragemuster für Datenexploration und -validierung
Einige Muster, die sich bezahlt machen
Performance, Indexierung und die Kosten eines führenden Platzhalters
Zwei Abmilderungen, die tatsächlich helfen
Wo Platzhalter nicht mehr funktionieren und wie man das erkennt
Schnelle Überprüfungen, die die Fehlerquellen aufdecken
Eine praktische Platzhalter-Checkliste vor dem Ausführen
Warum die Platzhaltersuche eine betriebliche Entscheidung ist und nicht nur ein Syntax-Trick
Ein Support-Ingenieur gibt *error* in ein Suchfeld ein, erwartet, dass jede laute Protokollzeile angezeigt wird, und erhält nichts, ein Timeout oder eine Ergebnisliste, die den Platzhalter völlig ignoriert. Diese Art von Fehler kommt häufiger vor, als viele Teams zugeben, da sich das Verhalten von Platzhaltern je nach Plattform, Index und Analyzer-Pipeline ändert. Dasselbe Muster kann sich in SQL auf eine Weise verhalten, in einer Shell auf eine andere und in einer Suchmaschine auf eine dritte Weise.
Die Platzhaltersuche wird am besten als eine betriebliche Entscheidung behandelt, nicht als Komfortfunktion. Die SQL Server-Dokumentation von Microsoft zeigt, dass % am Anfang, in der Mitte oder am Ende eines Musters stehen kann, und dass _ genau ein Zeichen matcht, während Klammerbereiche wie [a-f] ebenfalls in LIKE-Mustern gültig sind, wie von Microsoft dokumentiert. Enterprise-Tools halten dieselbe Idee in benutzerorientierten Suchen lebendig, da Teilübereinstimmungen nützlich sind, wenn man die genaue Schreibweise nicht kennt, aber der Kompromiss ist immer derselbe: Eine breitere Trefferquote bedeutet in der Regel mehr Last und mehr Raum für unbemerkte Fehlzuordnungen.
Praktische Regel: Fragen Sie nicht, ob Platzhalter unterstützt werden. Fragen Sie, ob sich die Abfrage nach Tokenisierung, Anführungszeichen, Maskierung (Escaping) und Indexauswahl immer noch wie ein Platzhalter verhält.
Der Rest des Problems lässt sich einfacher formulieren als lösen. Sie müssen die Kernsymbole kennen, wissen, wie sie sich auf den einzelnen Plattformen unterscheiden, wo die Performance einbricht und welche Systeme die Erweiterung des Musters überhaupt stoppen. Das ist der Teil, den die meisten Platzhalter-Leitfäden überspringen, und es ist der Teil, auf den es ankommt, wenn Ihr Abfrage-Editor mit der Produktion verbunden ist. Für Teams, die die Zuverlässigkeit von Daten verwalten, ist dies dieselbe Art von Disziplin, die Sie bei Datenherkunfts- (Lineage) und Aktualitätsprüfungen anwenden. Deshalb gehört ein Tool wie die Data Observability-Plattform von digna in dieselbe Diskussion, selbst wenn das Suchproblem selbst an anderer Stelle liegt.
Die vier kanonischen Platzhaltersymbole und was sie abgleichen
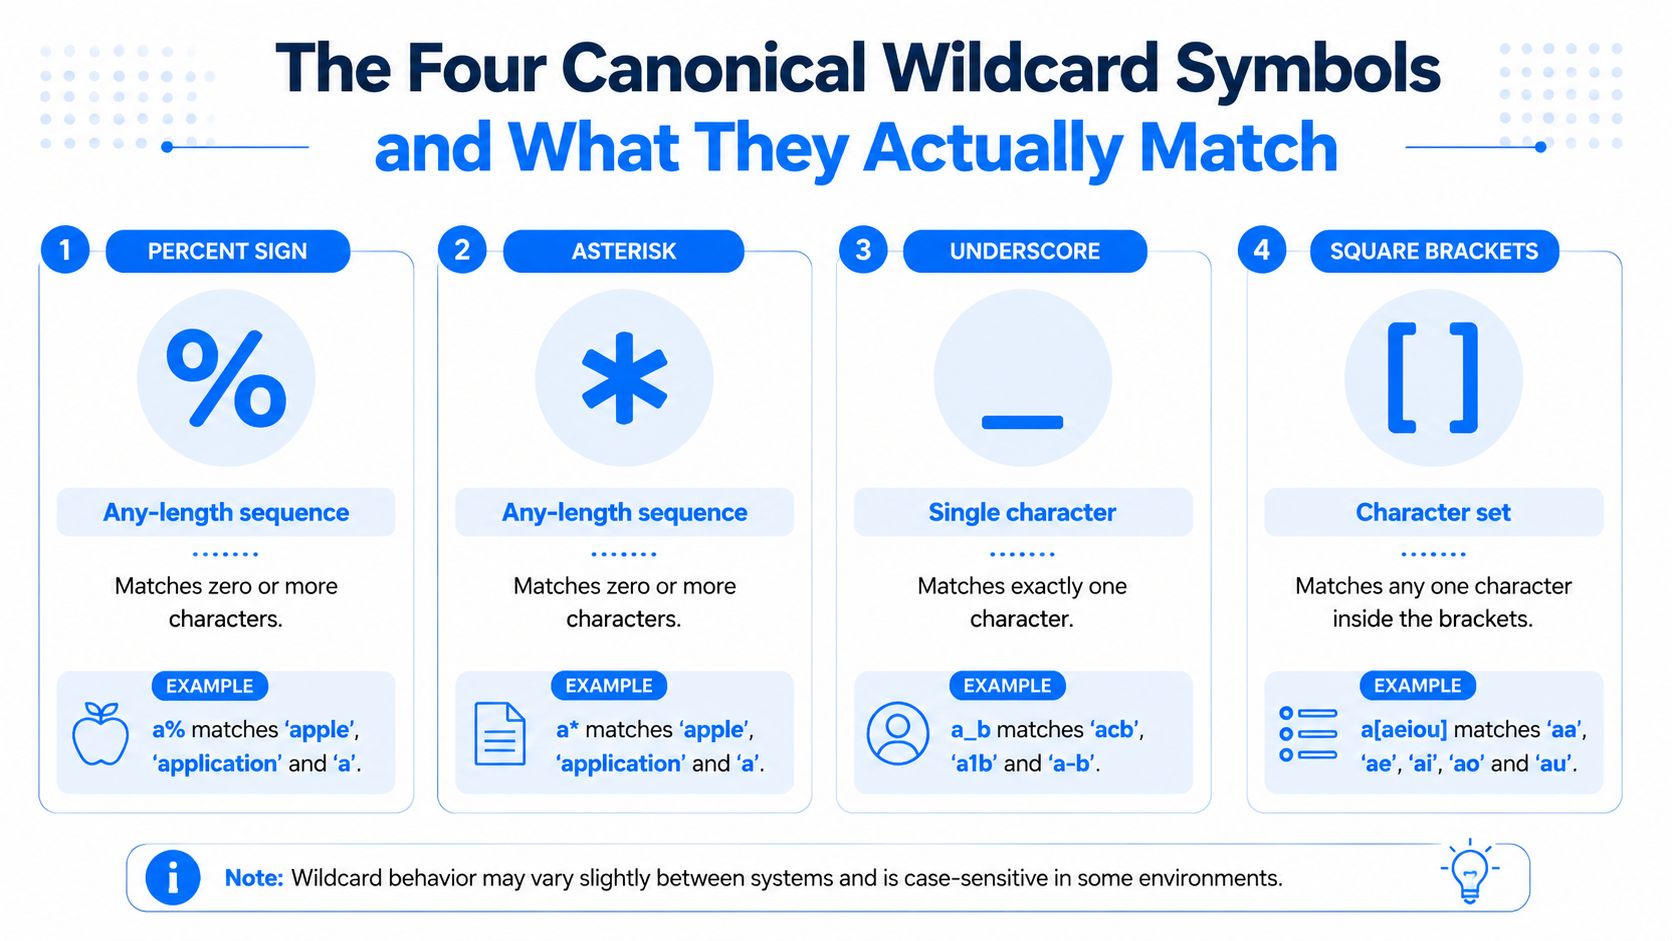
Der sicherste Weg, über die Platzhaltersyntax nachzudenken, ist nach ihrer Bedeutung, nicht nach dem Symbol. Über SQL, Shell-Globs und Suchmaschinen hinweg taucht dieselbe Absicht unter verschiedenen Zeichen auf, und die Engine hört möglicherweise auf, dieses Zeichen als Platzhalter zu behandeln, sobald Tokenisierung, Anführungszeichen oder Maskierung ins Spiel kommen.
Sequenzen beliebiger Länge
In SQL entspricht % null oder mehr Zeichen. Ein Muster wie LIKE 'cust%' matcht customer_id, cust und custodian, da es beim Abgleich nur darauf ankommt, dass der Text mit cust beginnt. In einer POSIX-Shell ist die entsprechende Absicht normalerweise *, sodass ls /var/log/*.log Dateien auswählt, die auf .log enden.
Suchmaschinen nutzen oft dieselbe Idee mit * oder %, je nach Abfragesprache. Die Verlaufssuche von Redgate's SQL Prompt verwendet * für null oder mehr Zeichen, und der Verlaufsfilter von Teradata nutzt % in derselben Rolle. Deshalb fühlt sich die Platzhaltersyntax vertraut an, selbst wenn sich die Produktoberfläche ändert Dokumentation zum Teradata-Platzhalterfilter.
Einzelne Zeichen und Zeichenklassen
_ in SQL und ? in Shells sowie vielen Suchwerkzeugen entsprechen genau einem Zeichen. Das ist wichtig, wenn Sie die Form des Wertes kennen, aber nicht das genaue Zeichen an einer bestimmten Position. status_1 und status?1 sind beides Präzisionswerkzeuge, keine unscharfen.
Eckige Klammern ermöglichen es Ihnen, eine Zeichenklasse zu definieren. SQL Server unterstützt Klammerbereiche wie [a-f], und Teradata unterstützt geklammerte Mengen wie [xyz] und [0-5] in seinem Verlaufsfilter Microsoft SQL Server-Dokumentation zu Platzhaltern.
Alternierung und Regex-ähnliche Strukturen
Vertikale Striche tauchen häufiger in regulären Ausdrücken (Regex) auf als in reiner Platzhaltersyntax. In einem Suchfeld ist status:[active|pending] ein gängiges Muster für Alternierung in Systemen im Query-String-Stil, während ein E-Mail-Muster eher auf Regex-artige Zeichensätze zurückgreift, wenn die Platzhaltersyntax nicht ausdrucksstark genug ist. Die nützliche Regel ist einfach: Platzhalter sind für die Form, Regex ist für die Struktur.
Verwenden Sie einen Platzhalter, wenn der unbekannte Teil breit gefächert, aber einfach ist. Verwenden Sie eine exakte Übereinstimmung, wenn Sie den Wert kennen. Nutzen Sie vollständige Regex nur dann, wenn Sie Alternierungen, Gruppierungen oder Validierungen benötigen, die ein Glob nicht sauber ausdrücken kann.
Für einen schnellen Vergleich, bevor Sie tippen, ist die Datenprofilierung-Übersicht von digna ein nützliches mentales Modell, da sie dieselbe Gewohnheit fördert: Überprüfen Sie die Form, bevor Sie dem Ergebnis vertrauen.
Plattformübergreifende Platzhalter-Syntax auf einen Blick
Dieselbe Absicht – das Finden von Identifikatoren, die mit INV beginnen – führt je nach Plattform zu einer unterschiedlichen Syntax. Dieser Unterschied ist wichtig, da dieselbe Abfrageform zu sehr unterschiedlichen Ergebnissen bei Abruf, Ranking und Belastung führen kann, sobald Sie zwischen SQL, Suchmaschinen und Shells wechseln.
Plattform | Beliebige Zeichenkette | Einzelnes Zeichen | Zeichensatz | Literal maskieren | Beispiel, beginnt mit |
|---|---|---|---|---|---|
SQL Server |
|
|
|
|
|
Teradata Verlaufsfilter |
|
|
| Das Literal |
|
PostgreSQL Musterabgleich |
|
| Regex-Klassen für fortgeschrittenen Abgleich |
|
|
Elasticsearch Query String |
|
| Regex-Stil nur bei Verwendung von Regex-Abfragen | Reservierte Abfragezeichen maskieren |
|
OpenSearch Platzhalter |
|
| kein Klassensystem, stattdessen Regex oder andere Abfragetypen verwenden | Reservierte Zeichen sorgfältig maskieren |
|
Splunk SPL | Suchoperatoren, nicht | n. v. | Regex-Funktionen oder Parsing zur Suchzeit | hängt vom Suchbefehl ab |
|
POSIX-Shell |
|
|
| Muster in Anführungszeichen setzen, um die Erweiterung zu verhindern |
|
Die Reibungspunkte sind wichtiger als die Symbole. Der Filter von Teradata behandelt Platzhaltertreffer als unabhängig von der Groß-/Kleinschreibung und unterstützt die Handhabung von Prozentzeichen als Literal in dokumentierten Beispielen wie %[%]%, was eine gute Erinnerung daran ist, dass Enterprise-Tools die Grammatik oft über das Standard-SQL hinaus erweitern. SQL Server behält LIKE als Basismodell bei, während OpenSearch und Elasticsearch * und ? in der Abfragesyntax reservieren und standardmäßig führende Platzhalter blockieren können. Für eine breitere Perspektive darauf, wie sich die Abfrageform auf die Ausführungskosten auswirkt, ist der SQL-Optimierungsleitfaden von digna eine nützliche Lektüre.
Ein Platzhalter ist als Idee portabel, nicht als Zeichen. Jede Engine ordnet diese Idee an den Grenzen neu zu, und die Fehlerquelle ist meist eine Abfrage, die korrekt aussieht, aber Datensätze übergeht oder den Index weitaus stärker beansprucht als erwartet.
Echte Abfragemuster für Datenexploration und -validierung
Die Abfragen, die sich hier auszahlen, sind meist diejenigen, die man einmal schreibt, prüft und nach der Überprüfung wieder löscht. Die besten Abfragen an dieser Stelle sind bewusst einfach gehalten und lassen sich nach der Validierung leicht entfernen.
Einige Muster, die sich bezahlt machen
Für die E-Mail-Validierung in SQL Server reicht ein eingeklammertes Muster oft für eine schnelle Sichtung aus, selbst wenn es sich nicht um einen vollständigen RFC-Validator handelt. Ein praktisches Beispiel sieht aus wie LIKE '%@[A-Za-z0-9.-]%\.com', was eine grobe Filterung für Adressen darstellt, die auf .com enden und eine plausible Lokal- und Domänenform aufweisen. Es ist kein Ersatz für eine dedizierte Validierungsregel, funktioniert aber gut, wenn Sie einen Import auf offensichtliche Fehler überprüfen.
Bei Shell-Arbeiten kann das Muster einfacher bleiben. Eine Linux-Archivprüfung wie find . -type f \( -name "*.csv" -o -name "*.json" \) -mtime +7 isoliert veraltete CSV- und JSON-Dateien sauber, da der Platzhalter die Auswahl des Dateinamens übernimmt und der Datumsfilter die Lebenszykluskontrolle regelt. Diese Aufteilung hält das Muster lesbar und die Ergebnismenge begrenzt.
In OpenSearch findet eine Produktcode-Suche wie { "wildcard": { "sku": "*aa*" } } SKUs mit zwei aufeinanderfolgenden Vokalen in der Mitte, allerdings nur, wenn das Feld so konfiguriert ist, dass es die Platzhaltersuche unterstützt. Es ist ein nützliches Prüfmuster, wenn Sie kontrollieren, ob vorgelagerte Systeme unerwartete Code-Strukturen eingeführt haben.
Praktische Regel: Verwenden Sie den engsten Platzhalter, der das Ziel erreicht. Wenn Sie das Präfix oder Suffix bereits kennen, verankern Sie es. Wenn Sie keinen internen Abgleich benötigen, vermeiden Sie ihn.
Wenn ich das Verhalten der Suche für ein Dashboard oder eine Überprüfung stichprobenartig teste, suche ich nach der kleinsten Abfrage, die den Fehler noch aufzeigt. Dieselbe Disziplin zeigt sich auch bei Arbeiten wie der Steigerung der Markenbekanntheit in der KI, wo der entscheidende Schritt darin besteht, die Abfrageform zu kontrollieren, bevor das System zu weit ausschwärmt.
Anwendungsfall | SQL LIKE | Shell-Glob | Suchmaschine |
|---|---|---|---|
E-Mail-Prüfung |
| n. v. | Regex oder feldbasierte Suche |
Dateibereinigung | n. v. |
| indizierte Dateimetadaten-Abfrage |
SKU-Formprüfung |
|
|
|
Präfix-Validierung |
|
|
|
Die besten Prüfungen sind hier eng definiert, temporär und leicht zu entfernen, sobald die Daten die Überprüfung bestanden haben. Das ist dieselbe Denkweise wie bei der Datenbereinigung in SQL mit digna, da beide Aufgaben besser funktionieren, wenn Sie die Form bestätigen, bevor Sie die Suche ausweiten.
Performance, Indexierung und die Kosten eines führenden Platzhalters
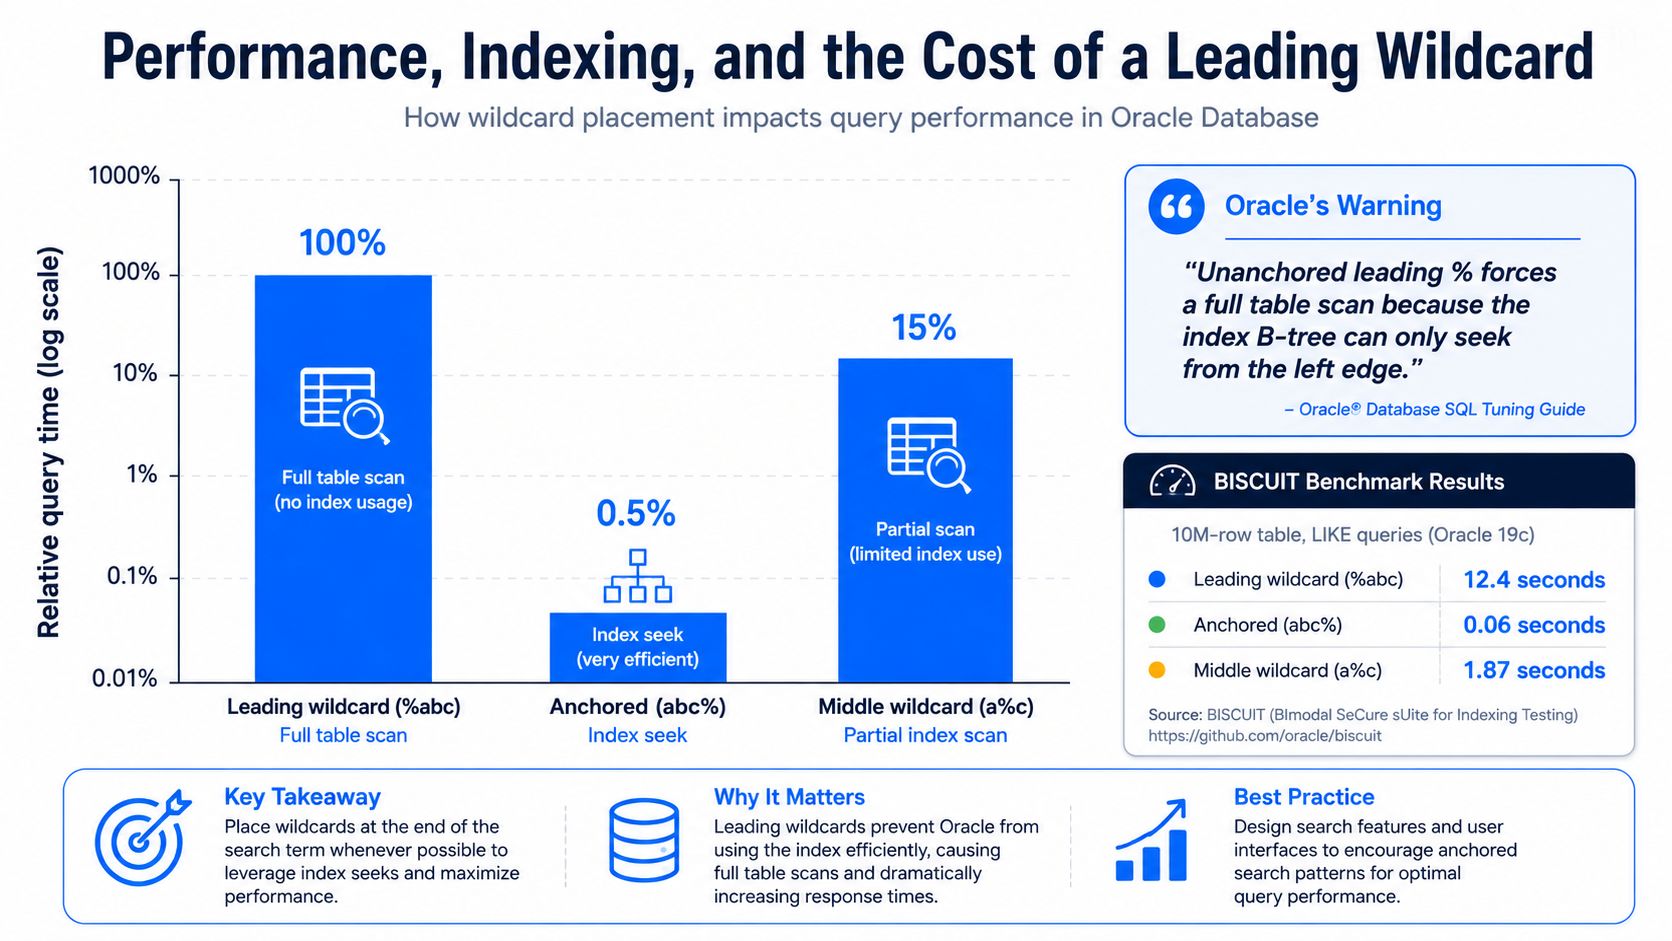
Ein führender Platzhalter ändert den Ausführungspfad, und die Kosten machen sich schnell bemerkbar. Oracle warnt davor, dass Suchen wie a* oder Abfragen, die nur aus Platzhaltern oder Satzzeichen bestehen, erhebliche Zeit in Anspruch nehmen können, und empfiehlt, vor der Ausführung mindestens 2 bis 3 Nicht-Platzhalter-Zeichen zu verwenden Oracles Richtlinien zu Platzhaltern.
Die Engine kann ab dem linken Rand suchen, sodass abc% indexfreundlich bleibt, während %abc dies normalerweise nicht ist. Sobald das Muster dem Index kein stabiles Präfix mehr bietet, wechselt die Abfrage von einer schnellen Suche zu einem Scan. Im BISCUIT-Benchmark liefen Suffix- und Infix-Platzhaltermuster in 2,2 bis 28,9 ms im Vergleich zu 34,97 to 189,3 ms für Trigram/B-Tree im veröffentlichten Benchmark, und die Suite berichtet von einer 14,4-fachen medianen Beschleunigung gegenüber der B-Tree-Indexierung bei 100 % Korrektheit über 11.400 Messungen hinweg BISCUIT-Benchmark. Der Nachteil ist der Speicherbedarf, da der Index etwa 10-mal größer als Trigram war BISCUIT-Benchmark.
Suchmaschinen folgen demselben Muster, auch wenn sich die Interna unterscheiden. Ein führendes * eliminiert den einfachen, links verankerten Pfad, sodass die Engine mehr Terme auswerten muss, was die Koordinatorenknoten und Erweiterungssicherungen belasten kann Elasticsearch-Dokumentation zu Platzhaltern OpenSearch-Dokumentation zu Platzhaltern. Aus diesem Grund wird „einfach einen Platzhalter hinzufügen“ bei großen Indizes zu einer teuren Angewohnheit.
Zwei Abmilderungen, die tatsächlich helfen
Trigram- oder N-Gramm-Indizes: Verwenden Sie diese, wenn Teilübereinstimmungen häufig und in großem Umfang vorkommen. Sie bieten der Engine eine Struktur zum Suchen, anstatt einen vollständigen Scan zu erzwingen.
Reverse-Field-Indizes für Suffix-Suchen: Wenn Benutzer nach Endungen suchen, speichern Sie eine umgekehrte Kopie des Strings und verankern Sie den Platzhalter auf der linken Seite des umgekehrten Felds. Dadurch wird ein Suffix-Problem in ein Präfix-Problem verwandelt.
Ein typisches SQL-Muster für den Reverse-Field-Ansatz ist einfach:
Für Teilübereinstimmungen in PostgreSQL ist die Trigram-Indexierung das Standardwerkzeug:
Die wichtigste Erkenntnis ist unkompliziert. Die Engine benötigt Unterstützung, sobald Sie sich vom linken Rand entfernen. Der Leitfaden zur SQL-Abfrageoptimierung von digna hält diese Diskussion auf der Ebene der Ausführungskosten statt der Mustersyntax.
Wo Platzhalter nicht mehr funktionieren und wie man das erkennt
Die Platzhaltersyntax kann scheitern, ohne eine Fehlermeldung auszugeben, was schlimmer ist als ein offensichtlicher Syntaxfehler, da die Abfrage gültig aussieht. SharePoint und einige Enterprise-Suchwerkzeuge entfernen führende Platzhalter standardmäßig, sodass eine scheinbar breite Suche stattdessen zu einer engen Präfixsuche werden kann CAS-Produkthilfe zu Platzhaltern.
In Anführungszeichen gesetzte Phrasen sind eine weitere Falle. Viele Systeme behandeln Platzhalter innerhalb von doppelten Anführungszeichen als literalen Text, sodass "apple%" nach der exakten Zeichenfolge apple% sucht, anstatt das Muster zu erweitern. Das Platzhalterverhalten von PubMed zeigt ebenfalls ein subtileres Problem. Die Verwendung von Platzhaltern kann die automatische Zuordnung von Begriffen stoppen, was die Treffermenge auf eine Weise verändert, die schwer zu erkennen ist, bis jemand die Ergebnisse manuell vergleicht.
Schnelle Überprüfungen, die die Fehlerquellen aufdecken
Führender Platzhalter entfernt: Führen Sie
app%aus und vergleichen Sie es mit%app%im selben Datenbestand. Wenn sich die Anzahl der Ergebnisse kaum ändert, schreibt die Plattform Ihre Abfrage möglicherweise um.Platzhalter in Anführungszeichen ignoriert: Testen Sie
"apple%"gegenapple%außerhalb von Anführungszeichen und vergleichen Sie das Abfrage-Explain (Query Plan), sofern die Plattform ein solches bereitstellt.Mindestpräfix-Regel erzwungen: Versuchen Sie es mit einem Muster, das nur ein einziges Nicht-Platzhalter-Zeichen enthält. Einige Systeme erfordern mindestens 3 Nicht-Platzhalter-Zeichen oder erlauben nur einen Platzhalter pro Begriff.
Erweiterung begrenzt oder blockiert: Einige Suchmaschinen verfügen über Sicherheitsvorkehrungen, die die Platzhaltererweiterung einschränken, wenn das Muster zu weit ausschwärmen würde.
Unterschiedliches Verhalten bei Groß-/Kleinschreibung: Eine Plattform behandelt Platzhaltertreffer standardmäßig unabhängig von der Groß-/Kleinschreibung, während eine andere dieses Verhalten als Option anbietet. Dieselbe Eingabe kann auf verschiedenen Systemen unterschiedliche Ergebnisse liefern.
Die meisten Platzhalterfehler resultieren aus falschen Erwartungen, nicht aus Logikfehlern.
Der schnellste Weg, sie zu finden, besteht darin, dasselbe Muster in einem winzigen, bekannten Datensatz zu testen, bevor Sie es in einem gemeinsam genutzten Dashboard oder einer gespeicherten Suche produktiv schalten. Ein kleiner Validierungsdatensatz zeigt, ob die Engine die Abfrage umschreibt, den Platzhalter verwirft oder eine Ergebnisliste liefert, die zwar plausibel aussieht, in der aber die erwarteten Datensätze fehlen.
Eine praktische Platzhalter-Checkliste vor dem Ausführen
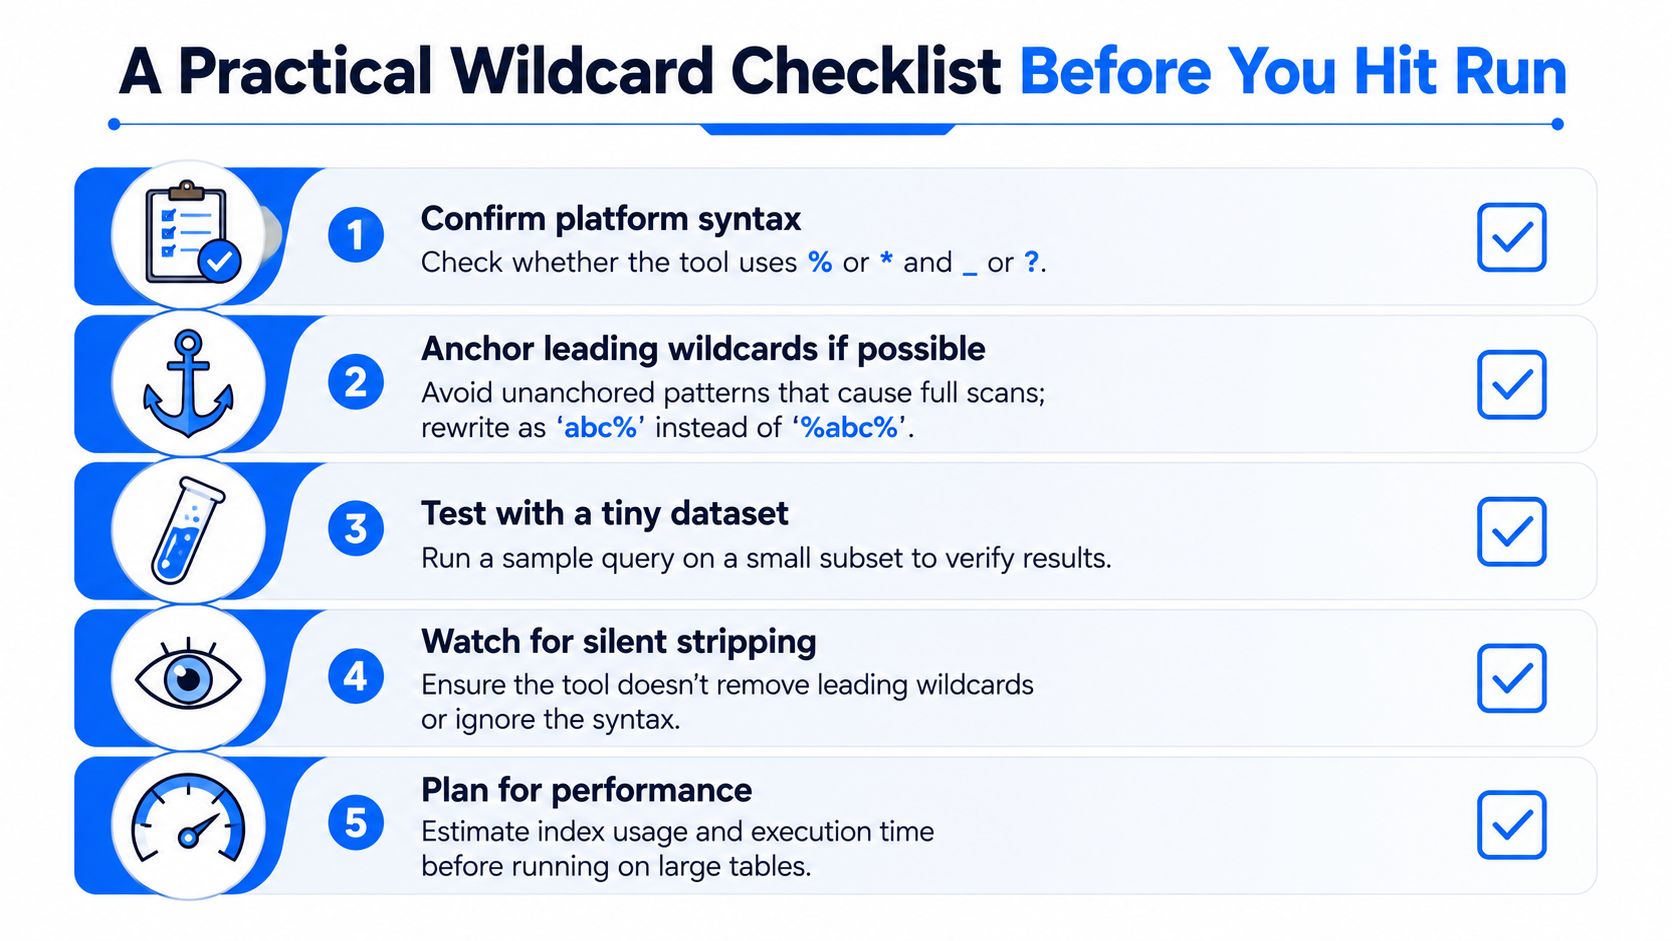
Bevor Sie eine Platzhalterabfrage absenden, überprüfen Sie zuerst die Plattformregeln. Prüfen Sie, ob % oder * verwendet wird, ob _ oder ? einem einzelnen Zeichen entspricht und ob Klammern, Anführungszeichen oder andere reservierte Symbole das Parsen verändern.
Prüfen Sie dann das Muster selbst. Maskieren Sie Sonderzeichen, bevor sie den Parser erreichen, und stellen Sie sicher, dass die Abfrage eng genug ist, damit die Engine sie ohne einen breiten Scan verarbeiten kann. Wenn das Muster in einem gemeinsam genutzten Dashboard ausgeführt werden soll, stellen Sie sicher, dass Datumsfilter, Zeilenbegrenzungen und die Eignung des Index weiterhin gelten.
Governance ist ebenso wichtig. Bestätigen Sie, dass die Abfrage protokolliert, gegen das Zielschema validiert und auf SQL-Injection-Risiken geprüft wird, falls ein Teil des Musters aus Benutzereingaben stammt. Eine Platzhalterabfrage sollte dem nächsten Ingenieur leicht zu erklären sein, ohne dass der Vorfallskanal erneut geöffnet werden muss.
Gehen Sie diese Checkliste jedes Mal durch. Die meisten Platzhalterfehler werden vor der Ausführung abgefangen.
Häufig gestellte Fragen
Welche vier kanonischen Wildcard-Symbole gibt es?
Denken Sie in Bedeutungen statt in Zeichen. Beliebig lange Folgen nutzen % in SQL oder * in vielen Suchmaschinen, Einzelzeichen nutzen _ in SQL oder ? anderswo, und Zeichenklassen nutzen eckige Klammern. Die vierte Kategorie ist der Escape-Mechanismus, mit dem Sie nach den Symbolen selbst suchen.
Was trifft % in SQL tatsächlich?
Null oder mehr Zeichen, und es darf am Anfang, in der Mitte oder am Ende eines Musters stehen. LIKE 'cust%' trifft customer_id, cust und custodian, weil der Vergleich nur verlangt, dass der Text mit cust beginnt, unabhängig davon, was folgt.
Funktionieren Zeichenklassen überall gleich?
Im Großen und Ganzen, mit Produktunterschieden. SQL Server unterstützt Bereiche wie [a-f] in LIKE-Mustern, Teradata unterstützt Mengen wie [xyz] und [0-5] in seinem History-Filter. Deshalb wirkt Wildcard-Syntax vertraut, auch wenn sich die Produktoberfläche ändert.
Warum ist Wildcard-Suche eine operative Entscheidung?
Weil die Unterstützung von Wildcards nicht die eigentliche Frage ist. Fragen Sie stattdessen, ob sich die Abfrage nach Tokenisierung, Quoting, Escaping und Indexauswahl noch wie eine Wildcard verhält. Besonders eine führende Wildcard macht aus einem Indexzugriff einen vollen Scan, ohne Syntaxfehler.
Warum liefert eine Wildcard-Suche nichts oder läuft in ein Timeout?
Meist weil eine dieser Schichten eingegriffen hat. Wer *error* tippt und nichts, ein Timeout oder eine Ergebnismenge ohne Wildcard-Wirkung erhält, sieht drei Symptome derselben Ursache: Das Muster wurde umgeschrieben oder der Index konnte es nicht bedienen.


