Stammdatenmanagement für Kundendaten: Ein praktischer Leitfaden für 2026
|
7
min. Lesezeit

Ihr Kunde aktualisiert eine E-Mail in der mobilen App, aber die Marketing-Plattform verfügt immer noch über die alte Adresse. Das CRM spiegelt die Änderung wider, die Rechnungsstellung behält eine andere Telefonnummer und die nächste Kampagne wirbt für ein Produkt, das der Kunde bereits gekauft hat. Das Ergebnis ist eine fehlgeleitete Nachricht, ein Support-Ticket und eine weitere manuelle Abstimmungsaufgabe für ein Operations-Team, das ohnehin schon zu viele davon hat.
Dieser Fehler ist bekannt, da sich Kundendaten selten an nur einem Ort ändern. Das Kunden-Stammdatenmanagement führt diese Datensätze zusammen, löst Identitäten auf, wendet verantwortungsvolle Regeln an und verteilt vertrauenswürdige Attribute an die Systeme, die sie nutzen. Die wichtige Verschiebung für 2026 besteht darin, dass ein gemasterter Datensatz nicht stillstehen darf. Er muss außerdem frisch, beobachtbar, rückverfolgbar und bereit für die Aktivierung durch CRM-Workflows, Analysen, Personalisierung, Betrugskontrollen und KI sein.
Inhaltsverzeichnis
Warum Kunden-Stammdatenmanagement jetzt wichtig ist
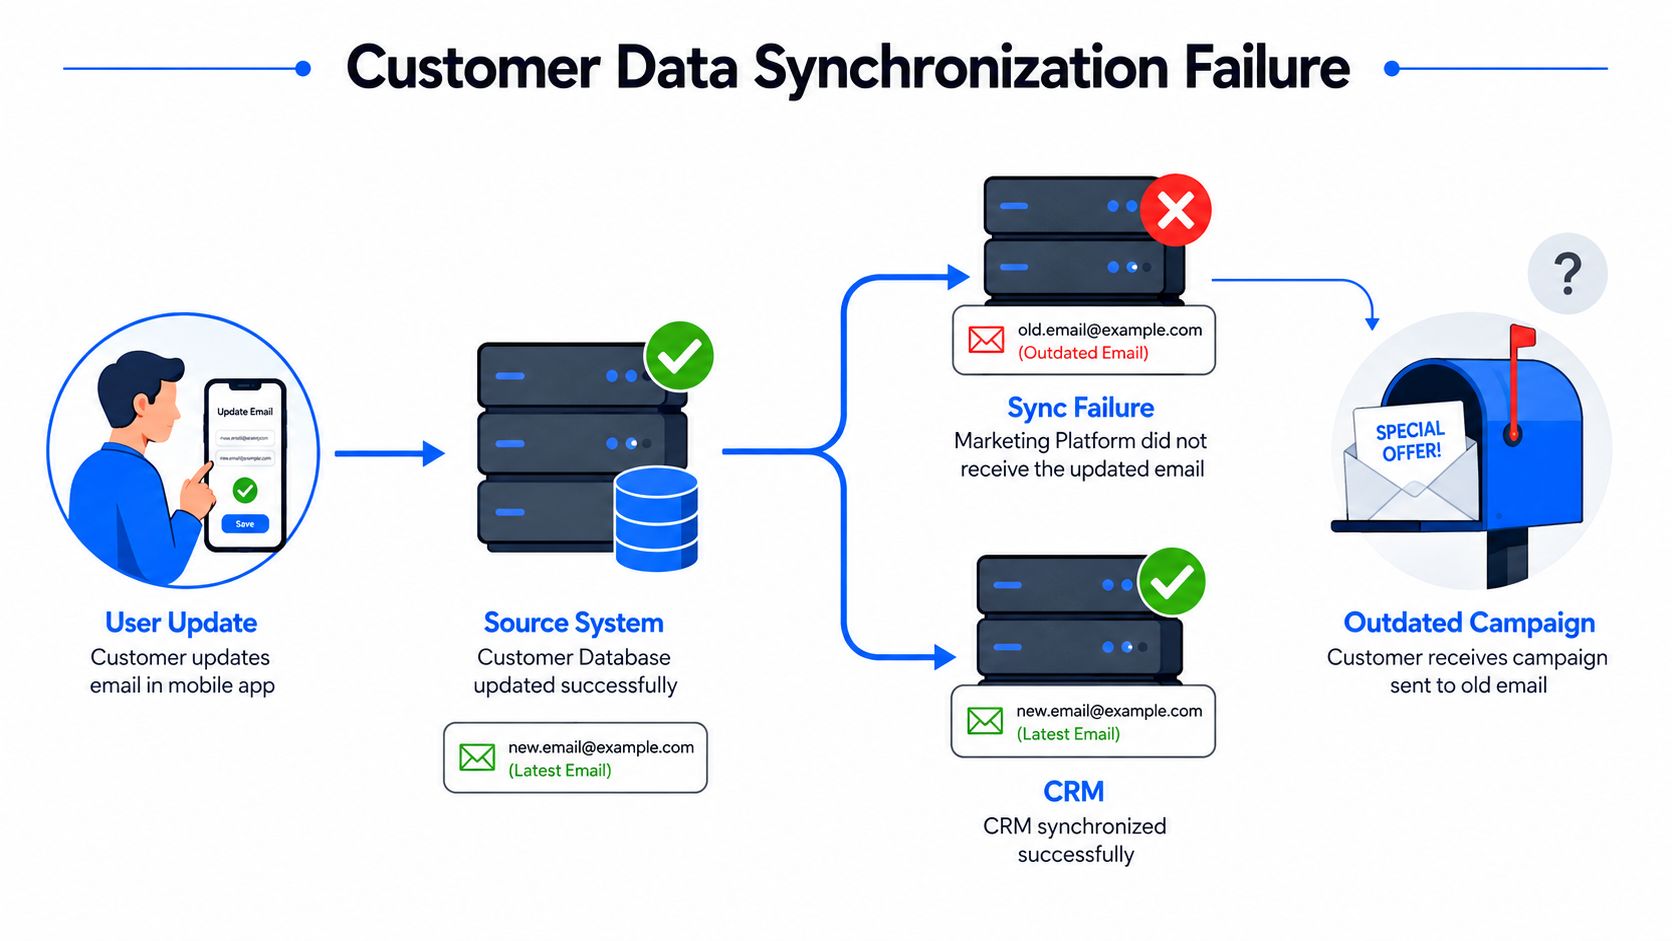
Das obige Szenario ist ein operatives Latenzproblem und nicht bloß eine Datenbereinigungsaufgabe. Ein Kunde ändert ein Attribut, aber die Aktualisierung verpasst das Zeitfenster, das von einem oder mehreren Konsumenten benötigt wird. Das Marketing verwendet veraltete Daten, der Support erbt die Beschwerde und das Unternehmen zahlt für einen Synchronisationsfehler.
Kunden-MDM erstellt eine zuverlässige Identität aus Datensätzen in CRM, ERP, Rechnungsstellung, E-Commerce, Support und analytischen Systemen. Es konsolidiert Datensätze, entfernt Duplikate, gleicht widersprüchliche Attribute ab und bewahrt die Historie (Lineage), sodass Teams feststellen können, woher jeder Wert stammt. IBM beschreibt MDM als einen Prozess, der Quelldaten integriert, Datensätze dedupliziert, Diskrepanzen ausgleicht und das Ergebnis für die nachgelagerte Nutzung anreichert, wie in seiner Übersicht zum Stammdatenmanagement dargelegt.
Die Disziplin ist älter als moderne Unternehmensplattformen. Edwin G. Seibels führte das Konzept der Hängeregistratur im Jahr 1898 ein, und die US-Social Security Administration erstellte 1936 eine Sterberegister-Stammdatei, so diese Geschichte des Stammdatenmanagements. Kunden-MDM etablierte sich in den 1990er-Jahren als formale Unternehmensdisziplin, als ERP-Systeme begannen, Kunden-, Produkt- und Lieferantendomänen zu verwalten. Bis Mitte der 2000er-Jahre boten Anbieter umfassendere Funktionen an.
Der geschäftliche Druck ist nicht mehr theoretisch
Die MDM-Umfrage von McKinsey aus dem Jahr 2023 ergab, dass 83 % der Unternehmen Kunden- und Produktdaten als ihre dominantesten Domänen betrachteten. 82 % der Befragten verbrachten mindestens einen Tag pro Woche mit der Behebung von Qualitätsproblemen bei Stammdaten, und 66 % verließen sich auf manuelle Prüfungen, um die Qualität zu bewerten und zu verwalten (McKinsey). Der operative Widerspruch ist offensichtlich: Kundendaten haben strategisches Gewicht, während ihre Pflege immer noch stark von wiederkehrenden menschlichen Eingriffen abhängt.
Kundendaten spielen auch eine herausragende Rolle auf dem globalen MDM-Markt, was ihren Einfluss auf Analysen, Compliance, Betrieb und Entscheidungsfindung in wichtigen Märkten widerspiegelt.
Praktische Regel: Ein Golden Record hat keinen operativen Wert, wenn ein nachgelagertes System ihn erst erhält, nachdem das geschäftliche Ereignis bereits stattgefunden hat.
Messen Sie Kunden-MDM an mehr als nur der Reduzierung von Duplikaten. Verfolgen Sie, wie schnell sich Einwilligungsänderungen verbreiten, wie lange ein Ausfall der Quelle unbemerkt bleibt, wie viele Konsumenten ein geändertes Attribut nutzen und ob ein KI-Modell den aktuellen Identitätskontext erhält. Für eine umfassendere Untersuchung darüber, wie sich verlässliche Datensätze auf Geschäftsergebnisse auswirken, lesen Sie die Vorteile der Datenqualität.
Kernkomponenten der Kunden-MDM-Architektur
Eine produktive Kunden-MDM-Architektur ist eine Kette kontrollierter Transformationen, kein einzelnes Repository. Jede Schicht benötigt einen Eingangsvertrag, einen Fehlerpfad, einen Eigentümer und eine messbare Serviceerwartung.
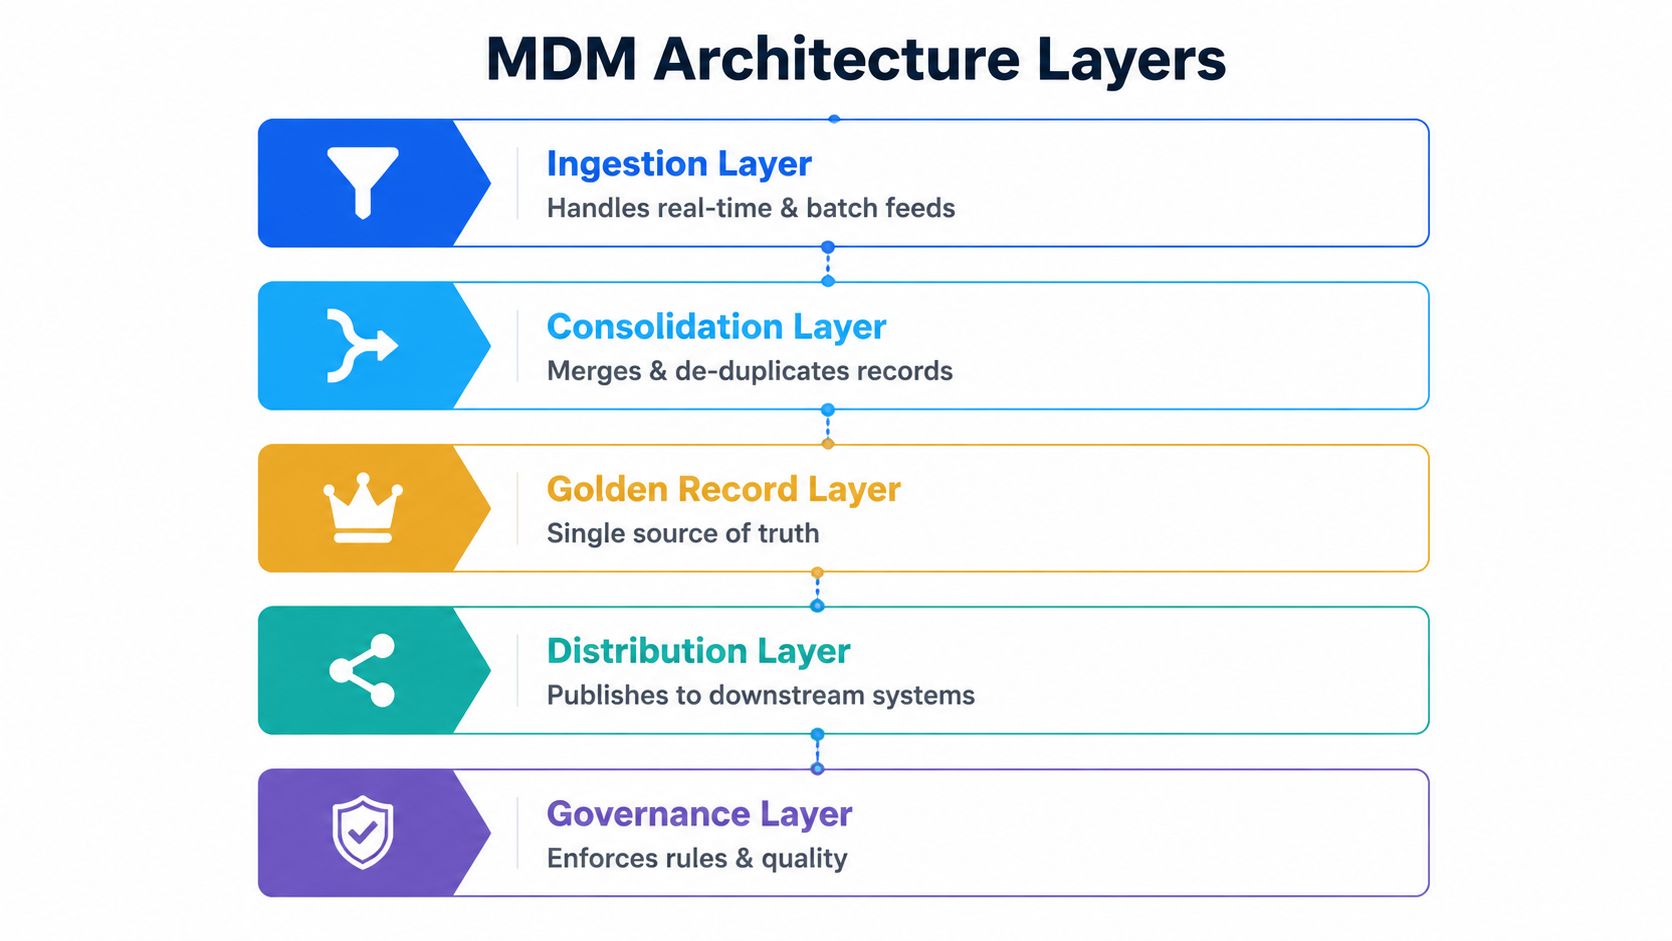
Die fünf Schichten, auf die es in der Produktion ankommt
Ingestion (Datenaufnahme) akzeptiert Echtzeit-Events und Batch-Feeds aus CRM, E-Commerce, Support, Rechnungsstellung und anderen Systemen. Validieren Sie Schemata, bevor Datensätze in den Prozess einfließen. Ein umbenanntes Feld, ein geänderter Datentyp oder eine geänderte Null-Wert-Regel sollte nicht automatisch zu einem fehlerhaften Kundenattribut führen.
Staging (Bereitstellung) bietet einen kontrollierten Bereich für die Normalisierung. Standardisieren Sie Formate, bereinigen Sie fehlerhafte Werte, wenden Sie Referenzprüfungen an und identifizieren Sie offensichtliche Duplikate, bevor die Matching-Engine die Identität bewertet. Bewahren Sie die ursprüngliche Payload neben dem transformierten Wert auf, damit Datenverantwortliche (Data Stewards) rekonstruieren können, was passiert ist.
Matching und Konsolidierung entscheiden, ob Datensätze denselben Kunden darstellen. Deterministische Schlüssel verarbeiten eindeutige Übereinstimmungen, während probabilistische Logik weniger exakte Kombinationen aus Namen, Kontaktdaten, Adressen und Quell-IDs bewertet. Die Engine sollte sowohl die Verknüpfungsentscheidung als auch deren Konfidenz bewahren.
Die Golden-Record-Schicht wendet Survivorship-Regeln (Überlebensregeln) auf jedes Attribut an. Das CRM ist möglicherweise maßgebend für die Vertriebszuständigkeit, die Abrechnung für rechtliche Rechnungsdetails und ein Einwilligungsdienst steuert die Kommunikationspräferenzen. Diese Entscheidungen liegen beim Unternehmen und nicht bei der Quelle, die zufällig als Letzte eingetroffen ist.
Distribution (Verteilung) veröffentlicht gemasterte Datensätze über APIs, Event-Streams oder Batch-Exporte. Konsumenten benötigen den Bereitstellungsstatus, Support für erneutes Abspielen (Replay), Versionsinformationen und ein klares Verhalten, wenn eine Veröffentlichung fehlschlägt. Ein Master, der sich intern aktualisiert, aber das CRM oder die Marketing-Plattform nicht erreicht, ist aus Nutzersicht nicht gemastert.
Die Governance-Schicht zieht sich durch alle fünf Bereiche. Sie definiert Eigentümerschaft, Zugriff, Aufbewahrung, Validierung, Lineage und Ausnahmebehandlung. Die IBM-Governance-Richtlinie hebt hervor, dass Stammdaten eine Bereinigung, Duplikateleminierung und laufende Qualitätsprüfungen über das erste Laden hinaus erfordern, anstatt eines einmaligen Repository-Imports (IBM-Governance-Richtlinie).
Design auf Isolation ausrichten, nicht auf Optimismus
Setzen Sie Schutzschalter (Circuit Breaker) zwischen die Stufen. Wenn der Quell-Feed gegen seinen Vertrag verstößt, stellen Sie die betroffenen Nachrichten unter Quarantäne, anstatt zuzulassen, dass fehlerhafte Datensätze den Master verunreinigen. Wenn das Vertrauen in die Übereinstimmung unerwartet sinkt, leiten Sie unsichere Fälle an das Data Stewardship weiter, anstatt eine unsichere Zusammenführung automatisch auszuweiten.
Eine nützliche Implementierungsreferenz ist dieser Leitfaden zur Datenqualität für Geschäftsergebnisse, insbesondere bei der Übersetzung technischer Kontrollen in operative Ergebnisse. Für eine tiefergehende Behandlung der MDM-Architektur und der Rolle kontrollierter, synchronisierter Datensätze siehe dignas Leitfaden zum Stammdatenmanagement.
Ansätze und Kompromisse bei der Identitätsauflösung
Die Identitätsauflösung bestimmt, ob zwei Datensätze zu einem Kunden gehören. Eine falsche Entscheidung ist in beide Richtungen teuer. Eine verpasste Übereinstimmung fragmentiert die Kundensicht, während eine fälschliche Zusammenführung die Historie einer Person für einen anderen Kunden offenlegen oder die Berechtigung, Compliance und Modellmerkmale verfälschen kann.
Deterministisches Matching vergleicht exakte oder normalisierte Identifikatoren wie E-Mail, Telefonnummer, Kunden-ID oder einen externen Quellschlüssel. Es ist schnell und nachvollziehbar, was es für Pfade mit hoher Konfidenz nützlich macht. Es scheitert, wenn Identifikatoren fehlen, veraltet, geteilt, vertippt oder über Kanäle hinweg bewusst unterschiedlich sind.
Probabilistisches Matching bewertet die Ähnlichkeit über mehrere Attribute hinweg und erstellt einen Konfidenzwert. Es kann Abweichungen erfassen, die exakte Regeln übersehen, erfordert jedoch Feinabstimmung, repräsentative Beispiele, Schwellenwertmanagement und eine Stewardship-Warteschlange für Grenzfälle. Ein hybrider Ansatz funktioniert operativ meist am besten, wobei deterministische Regeln offensichtliche Verknüpfungen auflösen und probabilistische Logik Unklarheiten behandelt.
Vergleich der Methoden zur Identitätsauflösung
Methode | Übereinstimmungsrate | Falsch-Positiv-Rate | Implementierungskomplexität | Bester Anwendungsfall |
|---|---|---|---|---|
Deterministisch | Hoch bei vollständigen, stabilen Identifikatoren | Niedrig, wenn Identifikatoren vertrauenswürdig sind | Niedrig | Gemeinsame Kunden-IDs und validierte Kontaktdaten |
Probabilistisch | Breitere Abdeckung bei unvollständigen Datensätzen | Erfordert aktive Kontrolle und Überprüfung | Hoch | Fragmentierte Identitäten mit inkonsistenten Attributen |
Hybrid | Starke Abdeckung mit expliziten Konfidenzbändern | Gesteuert durch Regeln und Stewardship | Mittel bis hoch | Unternehmensumgebungen über viele Quellsysteme hinweg |
Behandeln Sie die „Übereinstimmungsrate“ nicht als ein Ziel, das isoliert maximiert werden muss. Eine höhere scheinbare Rate kann aggressive Zusammenführungen verbergen. Überprüfen Sie fälschliche Zusammenführungen nach geschäftlichen Auswirkungen, nicht nur nach aggregierten Qualitätswerten. Die Finanzabteilung toleriert möglicherweise eine manuelle Ausnahme in einer risikoarmen Kontohierarchie, während ein regulierter Onboarding-Prozess ein konservatives Matching und explizite Nachweise erfordern kann.
Konfidenz muss den Workflow steuern
Legen Sie separate Ergebnisse für Übereinstimmungen mit hoher Konfidenz, unsichere Kandidaten und abgelehnte Verknüpfungen fest. Speichern Sie die von der Engine verwendeten Nachweise, einschließlich Quellwerten, normalisierten Werten, Regelpfaden und Modell-Scores. Wenn ein Steward eine Entscheidung überschreibt, lassen Sie diese Aktion in die Regeloptimierung und die Audit-Historie einfließen.
Plattformübergreifendes Reporting hängt ebenfalls von konsistenten Identitätsschlüsseln und -definitionen ab. Teams, die diese Reporting-Ebenen entwerfen, finden Kennzahlen für plattformübergreifende Systeme nützlich, um über die Vergleichbarkeit zwischen Systemen nachzudenken. Wenn Kontaktdaten aus Quellen unzuverlässig sind, sollte ein disziplinierter Ansatz zur Validierung personenbezogener Daten vor dem Matching stehen, nicht nach einer fragwürdigen Zusammenführung.
Anforderungen an Governance und Validierung
Governance wird real, wenn sie verändert, was die Pipeline akzeptiert, veröffentlicht und eskaliert. Ein Richtliniendokument kann Prinzipien definieren, aber produktive Kontrollen benötigen ausführbare Regeln, verantwortliche Eigentümer und Nachweise, die später überprüft werden können.
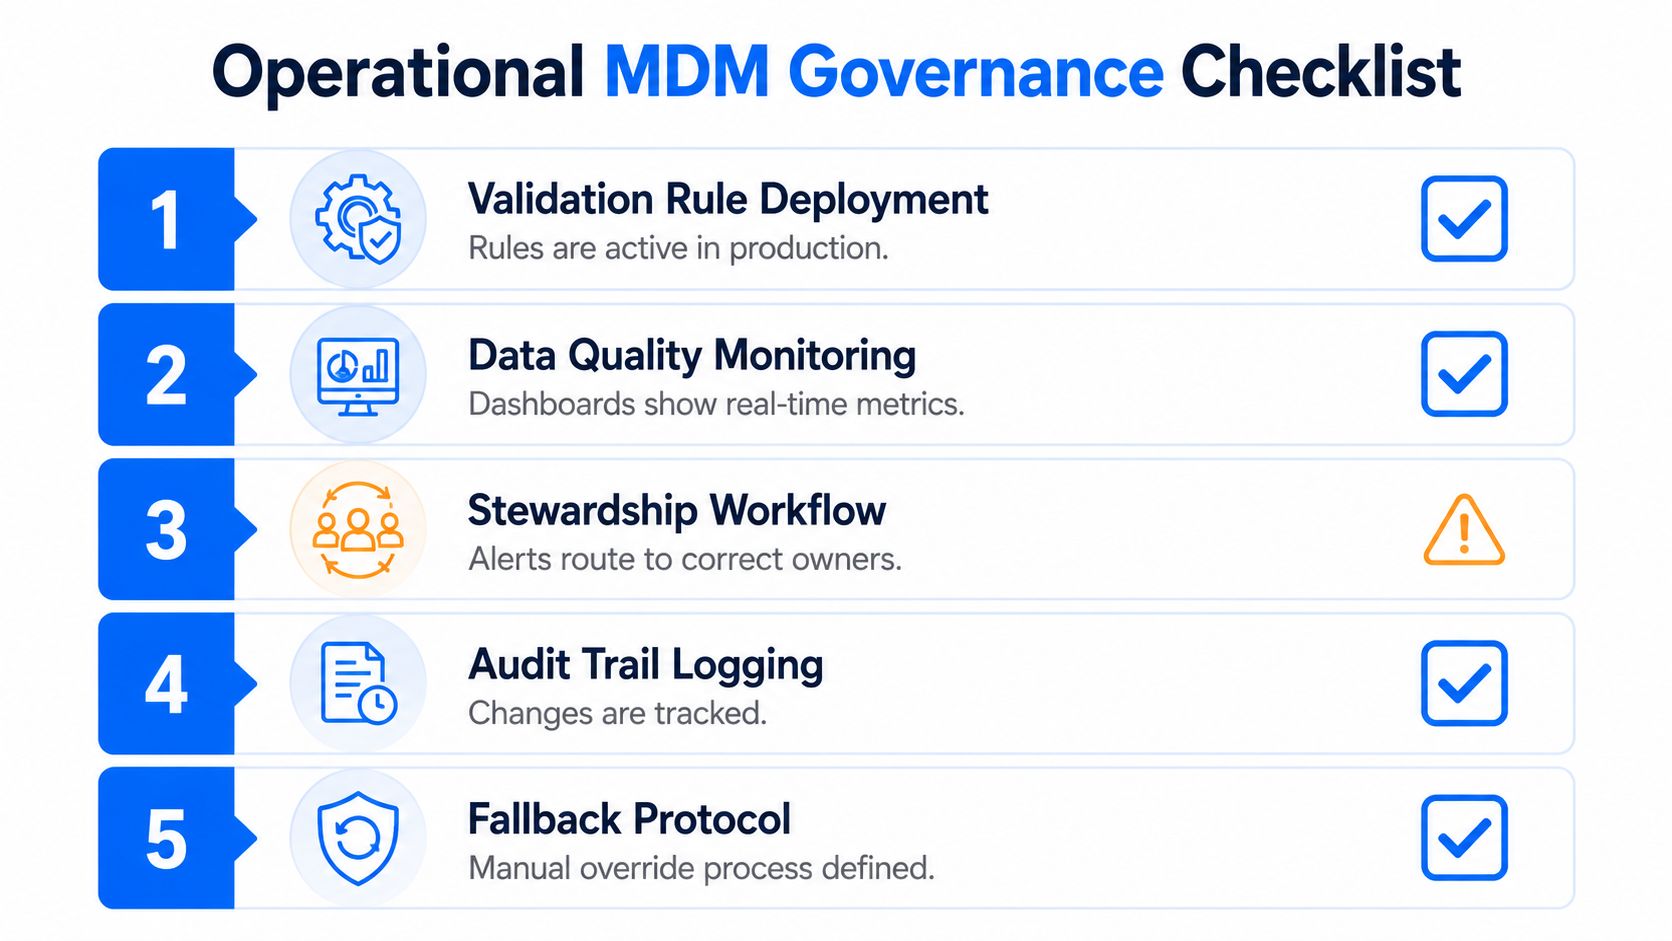
Eigentümerschaft auf Attributebene zuweisen
Ein Eigentümer auf Entitätsebene ist oft zu ungenau definiert. Weisen Sie die Verantwortung für bestimmte Attribute und Entscheidungen zu. Das Marketing besitzt möglicherweise die Kontaktpräferenzen, die Finanzabteilung die Rechnungsattribute, Compliance den Einwilligungsstatus und ein Datenplattform-Team die technischen Identifikatoren und Verteilungsverträge.
Survivorship-Regeln benötigen dieselbe Präzision. Wenn zwei Systeme nicht übereinstimmen, muss der gewinnende Wert bis zur Quell-Lineage, der Transformationshistorie und einer dokumentierten Stewardship-Regel zurückverfolgbar sein. Die Anleitung von CDQ zur Datenbereinigung bringt den Kernpunkt klar auf den Punkt: Wenn Stewards nicht erklären können, warum eine Quelle gewonnen hat, wird der Golden Record zu einer Black Box, was das Vertrauen und die Auditierbarkeit schwächt.
Validierungsgatter vor der Aktivierung nutzen
Eine praktische Checkliste vor dem Start sollte diese Gatter abdecken:
Schema-Validierung: Überprüfen Sie erforderliche Felder, Typen, Formate und zulässige Änderungen bei der Aufnahme.
Identitätsintegrität: Testen Sie das Verhalten bei Übereinstimmung, Zusammenführung, Aufteilung und Ablehnung anhand überprüfter Beispiele.
Referenzielle Integrität: Überprüfen Sie Verknüpfungen zu maßgebenden Referenz- und Quellidentifikatoren.
Attribut-Survivorship: Stellen Sie sicher, dass jedes kritische Feld eine verantwortliche Rangfolge-Regel besitzt.
Weitergabe des Datenschutzes: Übertragen Sie Einwilligungen, Einschränkungen und Löschanweisungen an jeden relevanten Konsumenten.
Verteilungskontrolle: Testen Sie Bereitstellung, Wiederholungsversuche, Replays, Versionierung und Fehlerisolation.
Audit-Nachweise: Erfassen Sie Quell-Lineage, Transformationen, Entscheidungen, Overrides und Veröffentlichungsstatus.
Strikte Gatter schützen das Vertrauen, können aber die Aktivierung verzögern, wenn legitime Grenzfälle blockiert werden. Tolerante Gatter sichern den Datenfluss, lassen aber fragwürdige Daten in Systeme gelangen, die möglicherweise sofort darauf reagieren. Nutzen Sie Dringlichkeitsstufen. Blockieren Sie risikoreiche Datenschutz- oder Identitätsfehler, stellen Sie unsichere Datensätze unter Quarantäne und lassen Sie fehlerhafte Datenanreicherungen mit geringen Auswirkungen unter Anzeige von Warnungen zu.
Art. 5 DSGVO verlangt, dass personenbezogene Daten dem Zweck angemessen, erheblich und auf das notwendige Maß beschränkt sein müssen, und besagt, dass identifizierbare Daten nicht länger als für ihren Zweck erforderlich aufbewahrt werden sollten, vorbehaltlich definierter Ausnahmen und Garantien (DSGVO Datenminimierung und Speicherbegrenzung). Das macht Erfassungs- und Aufbewahrungskontrollen zu einem Teil des MDM-Designs und nicht zu einer nachträglichen rechtlichen Prüfung. Teams können sich auch an den Richtlinien zum Schutz von Kundendaten orientieren, wenn sie operative Kontrollen den Datenschutzpflichten zuordnen.
Integration mit Plattformen für Data Observability
Die meisten MDM-Teams entdecken Probleme erst an der Grenze zum Konsumenten. Eine Kampagne schlägt fehl, ein Dashboard verschiebt sich oder eine KI-Funktion liefert fragwürdige Empfehlungen. Zu diesem Zeitpunkt war der Kundenstamm möglicherweise bereits seit Stunden oder Tagen fehlerhaft.
Observability verändert das Betriebsmodell, indem das Datenverhalten überwacht wird und nicht nur der Abschluss der Pipeline. Ein erfolgreicher Job kann dennoch veraltete, unvollständige, duplizierte oder strukturell veränderte Datensätze liefern. Kunden-MDM benötigt Signale, die beschreiben, ob die Daten pünktlich ankommen, das erwartete Volumen behalten, Schema-Verträge einhalten und stabile Ergebnisse bei der Identitätsauflösung liefern.

Überwachung der Signale, die schleichende Fehler aufdecken
Die Aktualitätsüberwachung (Freshness) sollte das tatsächliche Ankunftsverhalten mit den erwarteten Liefermustern vergleichen. Ein CRM-Aktualisierungs-Feed, der nicht mehr ankommt, löst möglicherweise keinen Infrastruktur-Alarm aus, wenn der Scheduler weiterhin erfolgreich ausgeführt wird. Ein Schema Tracker kann hinzugefügte oder entfernte Spalten und Änderungen des Datentyps erkennen, bevor ein nachgelagerter Parser fehlschlägt.
Volumenanomalien bieten eine weitere Frühwarnung. Ein unerwarteter Anstieg von Duplikaten, ein ungewöhnlicher Rückgang bei der Neukundenanlage oder eine plötzliche Häufung von Null-Werten können auf eine fehlerhafte Integration oder eine Änderung des Quellprozesses hindeuten. Das Vertrauen in die Identitätsauflösung sollte ebenfalls als beobachtbare Metrik behandelt werden. Wenn die Verteilung der Scores abweicht, sieht die Matching-Engine möglicherweise ein neues Format, eine neue Quellpopulation oder ein verändertes Dateneingabeverhalten.
Die Lineage auf Spaltenebene verbindet diese Signale mit den Auswirkungen. Wenn sich das Telefon-Attribut im Quellsystem ändert, sollte das Team wissen, welche CRM-, Support-, Marketing-, Analyse- und KI-Konsumenten davon abhängen, bevor die Änderung genehmigt wird. Die in Rite NRGs Leitfaden zur Überwachung der Zuverlässigkeit diskutierten Überwachungsprinzipien sind hier nützlich, da MDM dieselbe Disziplin wie andere Produktionsdienste erfordert.
Qualität in Serviceziele verwandeln
Definieren Sie Service-Indikatoren für Aktualität der Quelle, Veröffentlichungsverzögerung, Schema-Stabilität, Verteilung der Übereinstimmungskonfidenz, Duplikatniveaus und Validierungsfehler. Legen Sie dann Ziele je nach Anwendungsfall fest. Betrugskontrollen und operative Entscheidungen erfordern möglicherweise eine schnelle Weiterleitung, während ein Analyse-Export mit geringerer Priorität einen langsameren Zeitplan tolerieren kann.
Senden Sie MDM-Qualitätssignale an Tools wie Monte Carlo oder Datadog oder stellen Sie sie über den Incident-Workflow des Unternehmens bereit. Die Warnmeldung sollte das betroffene Attribut, die Quelle, den Konsumenten, den letzten fehlerfreien Zustand und den empfohlenen Eigentümer nennen. Eine umfassendere Erklärung dieser Praktiken finden Sie unter Bedeutung von Data Observability.
Die wichtigste Designentscheidung ist das Feedback. Observability sollte nicht nur ein Datenteam benachrichtigen. Sie sollte in der Lage sein, die Verteilung anzuhalten, das Vertrauen herabzustufen, eine Stewardship-Aufgabe zu erstellen oder ein Replay auszulösen, wenn die Nachweise zeigen, dass eine Aktivierung unsicher wäre.
Über statische Golden Records hinausgehen
Ein statischer Golden Record ist bereits veraltet, wenn das nächste Kundenereignis eintrifft. Das macht das Konzept nicht nutzlos, aber es führt dazu, dass rein Batch-basiertes MDM schlecht zu Echtzeit-Personalisierung, Betrugserkennung und KI-Systemen passt, die auf den aktuellen Kundenkontext angewiesen sind.
Neuere Berichte beschreiben einen Trend hin zu dynamischem, komponierbarem und Data-Warehouse-integriertem MDM. Ein Bericht von Twilio stellte außerdem einen Anstieg von 57 % bei prädiktiven Merkmalen fest, einhergehend mit einer wachsenden CDP- und Warehouse-Integration, was auf einen Wandel vom Batch-Mastering hin zu aktivierungsbereiten Kundendaten hindeutet (Diskussion über die neuen Regeln des MDM in 2025).
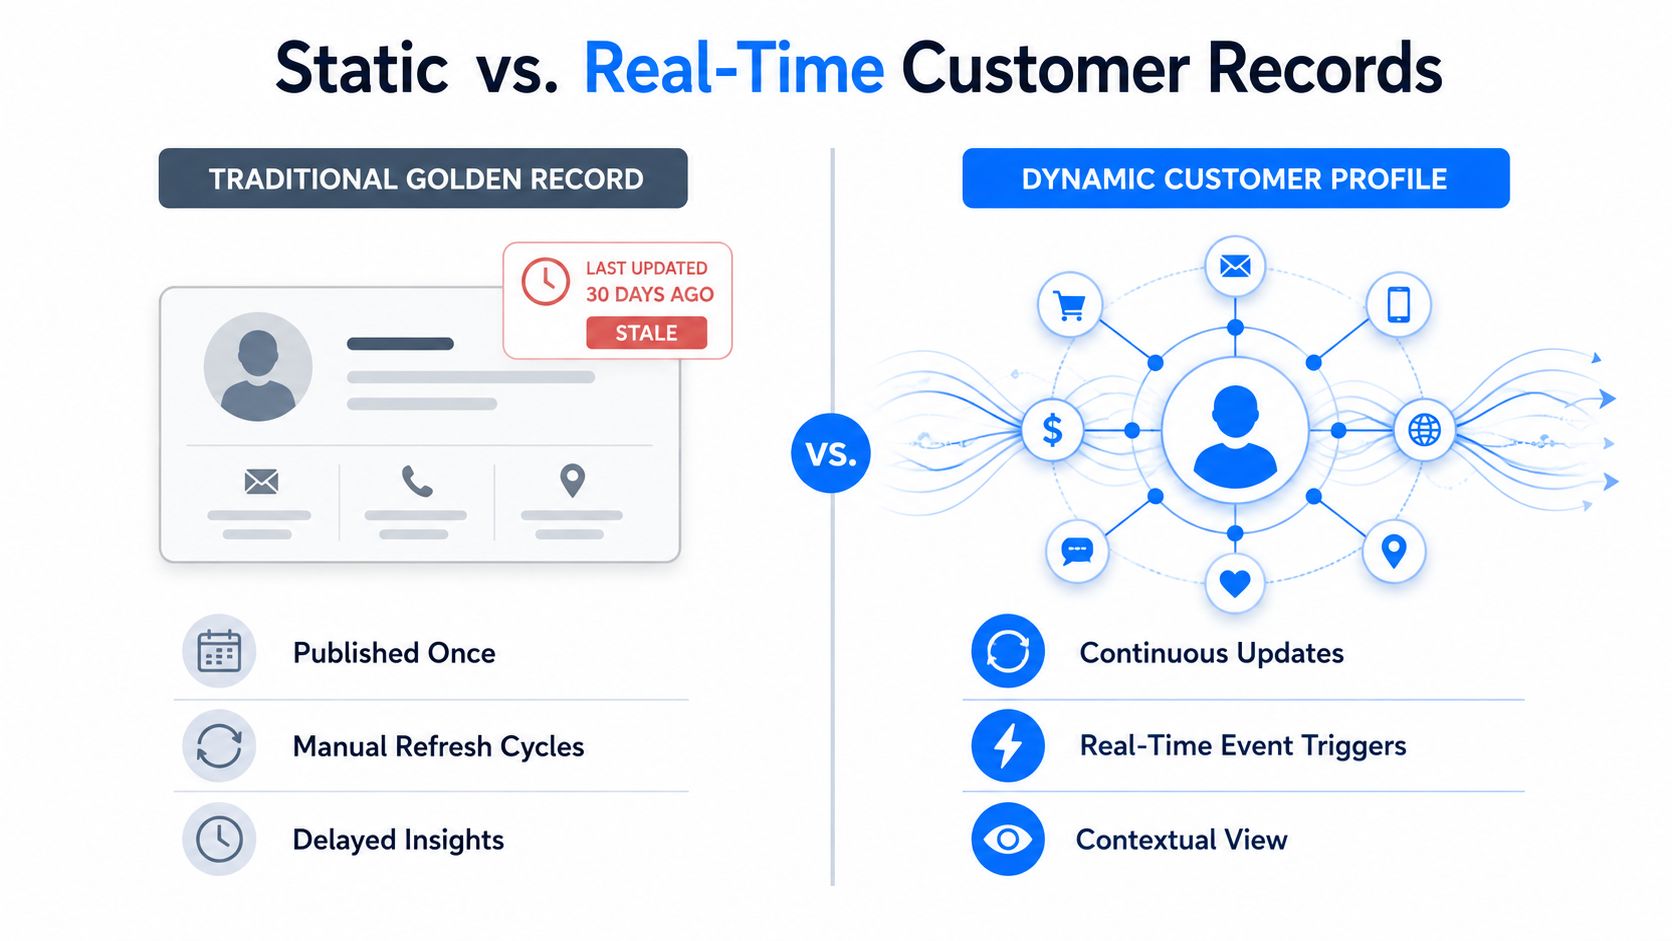
Events nutzen, ohne die Kontrolle aufzugeben
Ein ereignisgesteuertes Design kann Change Data Capture aus CRM-, Support-, E-Commerce- und Transaktionssystemen verarbeiten. Jedes Ereignis löst Validierung, Identitätsauflösung, Survivorship und die Veröffentlichung für die relevanten Konsumenten aus. Das verringert die Zeitspanne zwischen einer Kundenänderung und der darauf basierenden Aktion.
Die Architektur bringt echte Komplexität mit sich. Ereignisse können in falscher Reihenfolge eintreffen, Konsumenten können zu unterschiedlichen Zeiten konvergieren und zwei Quellen können dasselbe Attribut fast gleichzeitig aktualisieren. Sie benötigen idempotente Verarbeitung, Zeitstempel für Ereignisse, Versionsprüfungen, Konfliktrichtlinien, Replay-Funktionen und eine klare Handhabung von Eventual Consistency (erwartungsgemäßer Konsistenz).
Eine sinnvolle Migration erfordert nicht den Austausch der gesamten MDM-Plattform. Behalten Sie das bestehende Master-Modell und die Governance-Regeln bei und führen Sie Streaming für die Attribute und Anwendungsfälle ein, bei denen Latenz am wichtigsten ist. Beginnen Sie mit der Messung der aktuellen Weitergabeverzögerungen und der Fehlersichtbarkeit. Stellen Sie einen hochgradig wertvollen Datenfluss auf eine ereignisgesteuerte Verteilung um, vergleichen Sie das operative Verhalten und erweitern Sie das Muster erst, wenn Lineage, Rollback und Observability funktionieren.
Architekturentscheidung: Echtzeit-MDM bedeutet nicht, dass „alles gestreamt wird“. Es bedeutet auszuwählen, welche Kundenänderungen sofort weitergegeben werden müssen, welche Batch-orientiert bleiben können und wie das System nachweist, dass diese Wahl funktioniert.
Messung von geschäftlichen Auswirkungen und ROI
Ein Business Case, der auf „besserer Datenqualität“ aufbaut, wird einer strengen Finanzprüfung nicht standhalten. Verknüpfen Sie Kunden-MDM mit Ergebnissen, für die ein Stakeholder bereits die Verantwortung trägt, und etablieren Sie eine Baseline, bevor Sie den Prozess ändern.
Umsatzkennzahlen können doppelte Kampagnenkontakte, unterdrückte oder fehlgeleitete Angebote, die Qualität der Kontenverknüpfung in Cross-Selling-Workflows und Churn-Interventionen auf der Grundlage einer einheitlichen Kundensicht umfassen. Zu den Kostenkennzahlen gehören der manuelle Abstimmungsaufwand, fehlgeschlagene Transaktionen aufgrund falscher Identitäten, Support-Aufwand im Zusammenhang mit widersprüchlichen Datensätzen und die Zeit, die für die Untersuchung von Datenvorfällen benötigt wird.
Risikokennzahlen sollten die Weitergabe von Einwilligungen, die Bearbeitung von Anträgen betroffener Personen, die Vollständigkeit von Audits, das Identitätsvertrauen in sensiblen Workflows und die Reichweite eines fehlerhaften Attributs über nachgelagerte Konsumenten hinweg abdecken. Es geht nicht darum, jede Verbesserung dem MDM zuzuschreiben. Isolieren Sie den Beitrag des MDM, indem Sie definierte Datenflüsse vergleichen, Prozessänderungen protokollieren und andere Initiativen dokumentieren, die das Ergebnis beeinflussen könnten.
MDM-ROI-Messrahmen nach Stakeholdern
Stakeholder | Primäre KPI | Baseline-Metrik | Erwartete Verbesserung | Messrhythmus |
|---|---|---|---|---|
CFO | Kosten für Abstimmung und Nacharbeit | Erfasster Aufwand und Vorfallkosten vor dem Rollout | Weniger vermeidbare manuelle Arbeit und Fehlerbehebung | Vierteljährlich |
CMO | Unterdrückungsgenauigkeit und Zielgruppenintegrität | Rate doppelter und veralteter Kontakte in Kampagnen-Inputs | Weniger widersprüchliche Kontakte und sauberere Aktivierung | Pro Kampagne, vierteljährlich zusammengefasst |
Customer Operations | Identitätsbezogener Arbeitsaufwand zur Klärung | Tickets und Bearbeitungsaufwand aufgrund von Kundenverwirrung | Schnellere Untersuchung und weniger wiederholte Korrekturen | Monatlich |
Compliance Officer | Abdeckung von Einwilligung und Lineage | Datensätze und nachgelagerte Nutzungen mit überprüfbaren Nachweisen | Stärkere Rückverfolgbarkeit und kontrollierte Weitergabe | Monatlich und im Audit-Zyklus |
Leiter Daten und KI | Aktualität, Konfidenz und Zuverlässigkeit für Konsumenten | Verzögerung zwischen Quelle und Master sowie Vorfälle bei Modell-Inputs | Zeitnäherer, erklärbarer Kundenkontext | Wöchentlich, mit vierteljährlicher Überprüfung |
Nutzen Sie frühzeitig Frühindikatoren. Überwachen Sie das Verhalten von Duplikaten, Validierungsfehler, Aktualitätsverletzungen, ungelöste Stewardship-Aufgaben und Veröffentlichungsfehler, anstatt auf Umsatz- oder Compliance-Ergebnisse zu warten. Verknüpfen Sie diese Indikatoren dann im Rahmen einer vierteljährlichen Überprüfung mit geschäftlichen Ereignissen, die zeigt, welche Kundenattribute sich verbessert haben, welche Konsumenten profitiert haben und wo das Betriebsmodell immer noch Risiken birgt.
Eine gute ROI-Argumentation ist auf die jeweiligen Stakeholder zugeschnitten. Erklären Sie dem CFO, welche manuelle Arbeit und Fehlerbehebung sich geändert haben, dem CMO, wie sich die Aktivierungsintegrität verbessert hat, und der Compliance, wie Nachweise und Datenschutzkontrollen rückverfolgbar wurden. Vermeiden Sie es, Kausalitäten zu behaupten, wo das Messdesign dies nicht belegen kann.
digna bietet eine Plattform für Datenqualität und Data Observability in Unternehmen, die in Ihrer eigenen Umgebung ausgeführt wird – mit Modulen für Anomalieerkennung, Timeliness, Validierung, Schema-Tracking und In-Database-Überwachung. Wenn Ihr Kunden-MDM-Programm Nachweise benötigt, dass Datensätze frisch, strukturell stabil und sicher zu verteilen sind, besuchen Sie digna, um eine Observability-Ebene für Ihre kritischen Datenflüsse zu evaluieren.
Häufig gestellte Fragen
Was leistet Customer Master Data Management?
Es baut eine verlässliche Identität aus Datensätzen in CRM, ERP, Abrechnung, Commerce, Support und analytischen Systemen. Es löst das Problem, dass sich Kundendaten selten an einer Stelle ändern, sodass dieselbe Person gleichzeitig in mehreren teilweise korrekten Versionen existiert.
Warum genügt ein Golden Record 2026 nicht?
Weil ein gemasterter Datensatz nicht stillstehen darf. Ein Golden Record hat keinen operativen Wert, wenn ein nachgelagertes System ihn erhält, nachdem das Geschäftsereignis bereits vorbei ist. Das macht daraus ein Problem operativer Latenz und keine Aufräumaufgabe.
Wie viel Aufwand bindet Stammdatenqualität?
McKinseys MDM-Umfrage von 2023 fand, dass 82 % der Befragten mindestens einen Tag pro Woche mit dem Beheben von Stammdatenproblemen verbrachten und 66 % sich auf manuelle Prüfung zur Bewertung und Steuerung der Qualität stützten. Dieser manuelle Anteil begrenzt, wie weit Identity Resolution skaliert.
Welche Domänen dominieren MDM-Programme?
Kunden- und Produktdaten. McKinseys Umfrage von 2023 fand, dass 83 % der Organisationen sie als ihre dominierenden Domänen betrachteten, weshalb Kundendaten in Analytics, Compliance, Betrieb und Entscheidungsfindung so schwer wiegen.
Wie alt ist die Disziplin?
Älter als Unternehmenssoftware. Seibels führte 1898 das Konzept der Hängeregistratur ein, und das damals adressierte Problem, schnell den richtigen Datensatz zur richtigen Person zu finden, ist erkennbar dasselbe, das Customer MDM mit anderer Technik löst.


