Self-Service-Analytics: Ein kompletter Leitfaden für 2026
|
6
min. Lesezeit
Die meisten Ratschläge zu Self-Service-Analytics beginnen beim falschen Problem. Sie behandeln den schwierigen Teil als die Benutzeroberfläche und nehmen an, dass Drag-and-Drop-Dashboards irgendwie von selbst vertrauenswürdige Entscheidungen hervorbringen. In regulierten Unternehmen ist das genau umgekehrt. Die Einschränkung besteht darin, ob das Unternehmen über eine kontrollierte semantische Schicht, zuverlässige Metadaten, Zugriffskontrollen und Datenqualitätsprüfungen verfügt, die stark genug sind, um nicht-technische Benutzer schnell agieren zu lassen, ohne die Berichtlogik oder die Compliance zu verletzen.
Die Kategorie wurde im Mainstream populär, weil Business-Anwender Fragen stellen wollten, ohne auf zentrale Teams warten zu müssen, und moderne Plattformen dies heute durch Abfragen in natürlicher Sprache, visuelle Erkundung und automatisierte Aufbereitung erleichtern. Aber der historische Wandel vom IT-gesteuerten Reporting zur Analyse in den Fachbereichen funktioniert nur, wenn die Datenumgebung kuratiert ist, und nicht, wenn Benutzer in Rohdatentabellen abgesetzt werden und man ihnen sagt, sie sollen selbst klarkommen.
Inhaltsverzeichnis
Warum die meisten Self-Service-Analytics-Initiativen scheitern
Governance-Modelle, die Geschwindigkeit und Kontrolle ausbalancieren
Checkliste für die Tool-Auswahl und Bereitstellungsstrategie
Warum die meisten Self-Service-Analytics-Initiativen scheitern
Das häufigste Fehlerszenario ist simpel. Teams kaufen ein BI-Tool, richten es auf gemeinsam genutzte Daten und nennen das dann Self-Service-Analytics. Der erste Monat sieht vielversprechend aus, weil die Leute herumklicken und Dashboards erstellen können. Der zweite Monat legt das eigentliche Problem offen: Die Metriken driftet ab, die Business-Logik spaltet sich je nach Team auf, und niemand vertraut den Zahlen mehr.
Ein Tool schafft keine gemeinsame Bedeutung. Das tut eine kontrollierte semantische Schicht. Ohne sie berechnet das eine Finanz-Dashboard den Umsatz auf eine Weise, ein regionales Vertriebsteam auf eine andere, und die Führungsebene erhält zwei Versionen derselben Antwort. Genau hier scheitert Self-Service – nicht an der Benutzeroberfläche, sondern am Fehlen einer gemeinsamen Definitionsebene.
Die Benutzeroberfläche ist der einfache Teil
Drag-and-Drop-Design senkt die Hürde für Fähigkeiten, senkt aber bei schwacher Governance auch die Hürde für Inkonsistenzen. Benutzer können Dashboards schneller erstellen, als Analysten sie überprüfen können. Das klingt effizient, bis der Katalog voller duplizierter Datensätze und ähnlich aussehender Berichte ist, die unterschiedliche Geschäftsfragen beantworten. Das Ergebnis ist eine unkontrollierte Dashboard-Flut statt Autonomie.
Praktische Regel: Wenn ein Business-Anwender ein Dashboard schneller erstellen kann, als ein Data Steward es benennen, freigeben und klassifizieren kann, verfügt das Unternehmen noch nicht über Self-Service-Analytics. Es hat unkontrolliertes Reporting.
Das andere versteckte Problem ist der Zugriff. Wenn Benutzer Rohdatentabellen aus der Produktion abfragen, wird jedes Feld zu einem potenziellen Richtlinienproblem und jede Abfrage zu einem Supportfall. Deshalb trennen moderne Enterprise-Implementierungen die Präsentation von der Speicherung und schalten die Durchsetzung von Richtlinien dazwischen. Das Ziel ist nicht, die Benutzer einzuschränken. Es geht darum, sie davor zu bewahren, versehentlich auf Daten aufzubauen, die sie nicht sehen sollten, oder eine Metrik zu verwenden, die später niemand mehr reproduzieren kann.
Kernkomponenten einer Self-Service-Analytics-Architektur
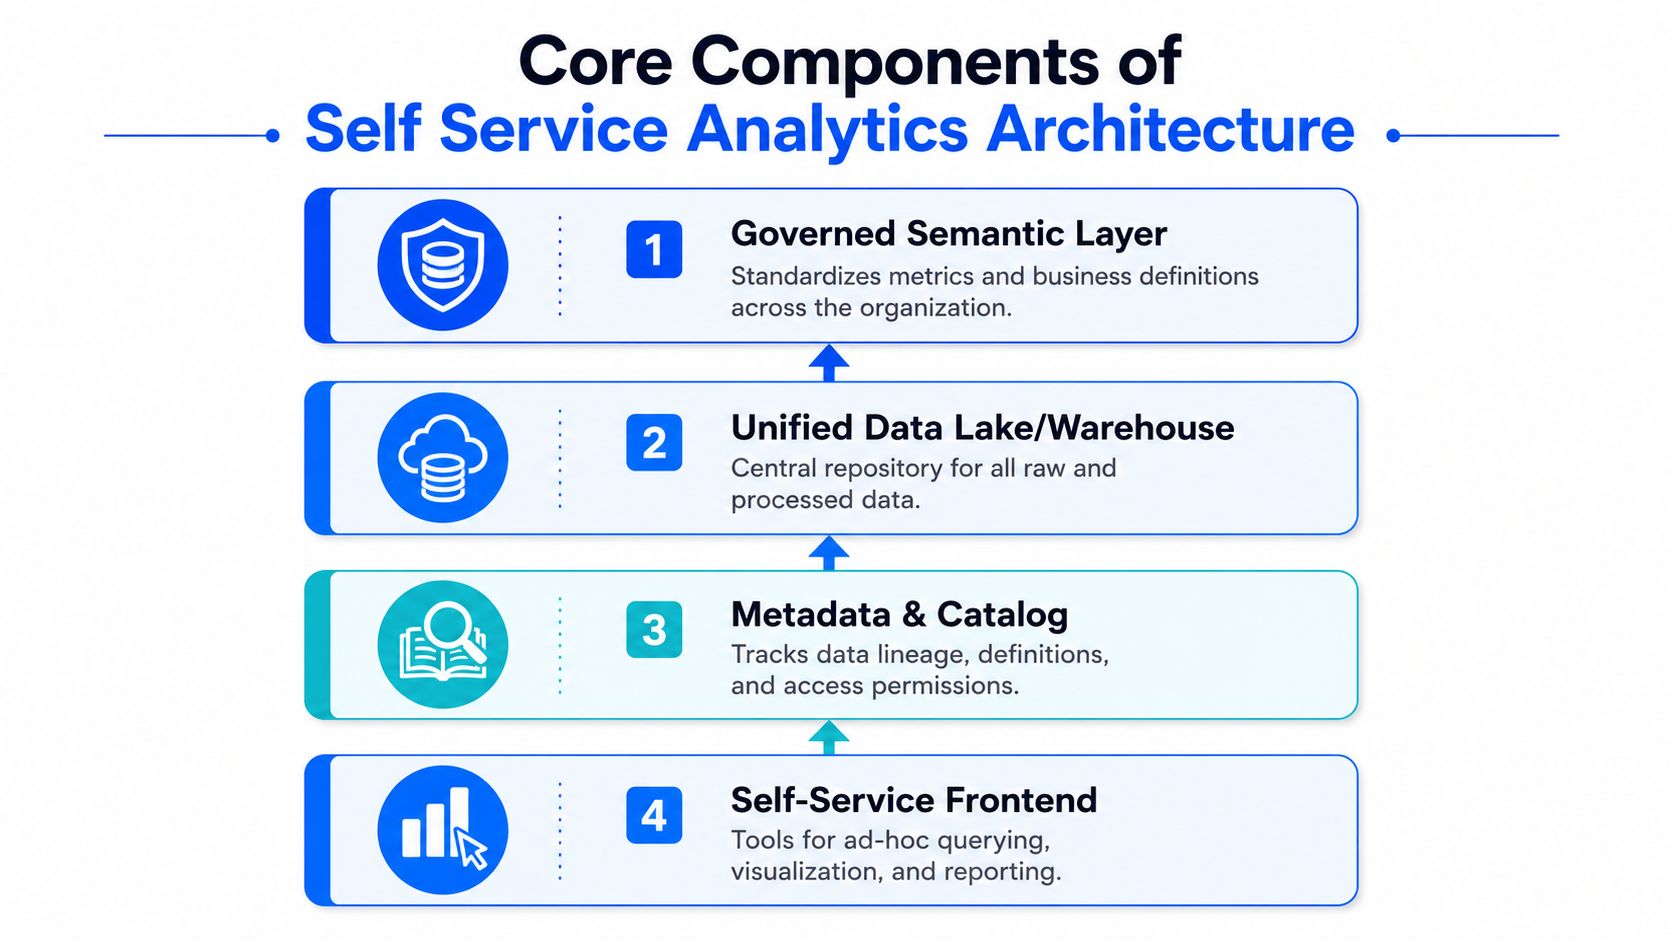
Eine funktionierende Enterprise-Architektur benötigt vier Schichten, die jeweils ein anderes Problem lösen. Der Stack ist nicht aus Modegründen kompliziert, sondern weil jede Schicht ein bestimmtes Fehlerszenario verhindert. Das Ziel ist es, den Benutzern ein unabhängiges Arbeiten zu ermöglichen, während die Plattform Bedeutung, Sicherheit und Leistung intakt hält.
Kontrollierte Bedeutung vor breitem Zugriff
Die kontrollierte semantische Schicht ist der Teil, den viele Unternehmen aufschieben, und meist der Grund, warum die Einführung später chaotisch wird. Sie standardisiert Business-Definitionen, sodass ein KPI abteilungsübergreifend dasselbe bedeutet, selbst wenn sich die Visualisierungen unterscheiden. Das ist wichtiger als jeder optische Feinschliff im Frontend, denn Benutzer können mit einer etwas unhandlichen Benutzeroberfläche leben, aber sie tolerieren keine Diskussionen darüber, was eine Metrik bedeutet.
Eine Katalog- und Metadatenschicht folgt als Nächstes, denn Benutzer können nicht finden, wovon sie nicht wissen, dass es existiert. Gute Metadaten verraten ihnen, wer Eigentümer eines Datensatzes ist, wie aktuell er ist, was er enthält und wie die Datenherkunft (Lineage) verläuft. In der Praxis macht das die Datensuche von einer Schnitzeljagd zu einem Auswahlprozess. Deshalb drängen Plattformen und Datenteams zunehmend auf Business-Glossare und durchsuchbare Kataloge statt auf noch mehr Ad-hoc-Tabellen.
Die Zugriffskontrollschicht ist der Ort, an dem Governance real statt nur ein Wunschbild wird. Rollenbasierte Berechtigungen, datensatzspezifische Zugriffe und Freigabe-Workflows für eingeschränkte Daten verhindern, dass Self-Service in unkontrollierte Offenlegung ausartet. Das ist besonders wichtig im Finanz- und Gesundheitswesen, in der Telekommunikation und im öffentlichen Sektor, wo Auditierbarkeit Teil des Betriebsmodells ist.
Leistungsisolierung ist wichtiger, als man denkt
Die letzte Schicht ist selbst bereitgestellte Rechenleistung (Compute) oder eine gleichwertige Möglichkeit, Ad-hoc-Arbeiten von gemeinsam genutzten Produktions-Workloads zu isolieren. Ohne Quoten oder Sandboxed Compute können einige wenige explorative Joins das Data Warehouse für alle anderen verlangsamen. Das beeinträchtigt nicht nur die Leistung, sondern zerstört auch das Vertrauen in die Plattform.
Ein starker Bezugspunkt für Datensuche-Workflows ist die Datensuche in kontrollierten Enterprise-Umgebungen, denn dieselbe Disziplin, die Benutzern hilft, Datensätze zu finden, bewahrt sie auch vor deren Missbrauch. Teams, die Implementierungspartner evaluieren, können auch vergleichen, wie Datenanalyse-Angebote von Bidwell an kontrollierte Analytics-Projekte herangehen, insbesondere wenn das Unternehmen sowohl geschäftliche Benutzerfreundlichkeit als auch Plattformdisziplin benötigt.
Eine Plattform, die Rohdatentabellen freigibt und das als „Empowerment“ bezeichnet, spart Einrichtungszeit auf Kosten des zukünftigen Vertrauens.
Governance-Modelle, die Geschwindigkeit und Kontrolle ausbalancieren
Governance ist kein Einheitsmodell. Es ist eine Reihe von Kompromissen zwischen Konsistenz, Autonomie und operativem Aufwand. Der falsche Ansatz ist meist der, der in einer Präsentation am einfachsten klingt. Zentralisierte Kontrolle ist sicher, föderierte Governance ist praktisch, und vollständig dezentrale Setups sind nur so lange schnell, bis der erste Streit über eine KPI-Definition oder Zugriffsrichtlinie ausbricht.
Drei Modelle, drei unterschiedliche Risiken
Zentralisierte Kontrolle funktioniert gut, wenn der Compliance-Druck hoch und die Benutzerzahl klein ist. Jede Anfrage läuft über ein zentrales Datenteam, was Konsistenz und strenge Überprüfung gewährleistet, aber auch zu Warteschlangen führt. Dieses Modell schützt Definitionen, verlangsamt jedoch das Geschäft und kann dazu führen, dass sich Self-Service eher wie eine Marketing-Maßnahme als eine echte operative Veränderung anfühlt.
Föderierte Governance ist das Modell, bei dem die meisten regulierten Unternehmen landen, weil es die Verantwortung sinnvoll aufteilt. Zentrale Teams standardisieren Kernmetriken, Zugriffsregeln und Qualitätsgrenzwerte. Die Fachbereichs-Teams erstellen Berichte und Visualisierungen innerhalb dieser Leitplanken. Das hält die Autonomie hoch genug, damit die Teams agieren können, während die Enterprise-Standards gewahrt bleiben, die Führungsebene und Auditoren benötigen.
Dezentrale und demokratische Governance gibt den Teams die größte Freiheit. Sie kann in kleinen, risikoarmen Umgebungen mit eng abgestimmten Benutzern funktionieren, ist aber auf Enterprise-Ebene fragil. Definitionen driften ab, doppelte Logik verbreitet sich, und niemand kann sagen, welches Dashboard nun die Wahrheit abbildet. Wenn das Unternehmen ohnehin schon mit der Konsistenz von Metriken kämpft, verschlimmert dieses Modell das Problem nur.
Modell | Stärke | Schwäche | Beste Eignung |
|---|---|---|---|
Zentralisierte Kontrolle | Maximale Konsistenz | Langsamste Freigaben | Stark regulierte, eng umgrenzte Anwendungsfälle |
Föderierte Governance | Ausgewogene Autonomie und Standards | Erfordert disziplinierte Betreuung (Stewardship) | Große Unternehmen mit mehreren Geschäftsbereichen |
Dezentral und demokratisch | Schnellstes lokales Experimentieren | Höchstes Risiko für Metriken-Drift | Kleine Teams, geringerer Compliance-Druck |
Richtlinien in operative Regeln umsetzen
Gute Governance-Checklisten sind konkret. Ein Katalog sollte die Verantwortlichkeit, die Aktualisierungshäufigkeit, Qualitätshinweise und Business-Definitionen für Schlüsselfelder enthalten. Zugriffsverfahren sollten genau festlegen, wer was sehen darf, wie eingeschränkte Daten angefordert werden und welche Datenschutz- oder Compliance-Prüfungen vor der Genehmigung gelten. Validierungsregeln sollten für die Personen sichtbar sein, die die Daten nutzen, und nicht in irgendeinem Ticketsystem versteckt sein.
Deshalb muss eine Data Governance-Strategie als operatives Modell konzipiert werden, nicht als reines Richtliniendokument. Wenn die Regeln nicht in die tägliche Analyse eingebettet sind, finden Benutzer Umwege. Sobald das passiert, existiert Governance nur noch auf dem Papier.
Die besten föderierten Setups versuchen nicht, lokale Abweichungen komplett zu eliminieren. Sie halten die Kernmetriken stabil und überlassen es den Teams, die Präsentationsschicht an ihre eigenen Fragen anzupassen. Das ist die Balance, die Schnelligkeit bewahrt, ohne dass das Reporting in konkurrierende Versionen der Wahrheit zerfällt.
Anforderungen an Datenqualität und Observability
Self-Service scheitert, wenn die Datenqualität unsichtbar bleibt. Ein Dashboard kann gut aussehen, während die zugrunde liegende Datenladung veraltet ist, sich ein Schema unbemerkt ändert oder eine Regel auf Datensatzebene so bricht, dass sie nur ein einziges nachgelagertes Team betrifft. Die Benutzer sehen nicht die Ursache, sie sehen nur, dass der Bericht nicht mehr mit der Realität übereinstimmt.
Was überwacht werden muss
Die erste Hürde ist das Ingestion-Monitoring. Wenn Daten verspätet, unvollständig oder im falschen Format ankommen, vererbt sich das Problem sofort auf nachfolgende Analysen. Die zweite Hürde ist das Schema- und Lineage-Tracking, da das Hinzufügen von Spalten, Typänderungen und vorgelagerte Transformationen Dashboards ohne Vorwarnung unbrauchbar machen können. Die dritte ist die Anomalieerkennung, die hilft, statistische Abweichungen aufzudecken, die einfache Grenzwerte übersehen. Die vierte ist ein Qualitäts-Dashboard, das Aktualität, Genauigkeit und Abdeckung sowohl für Entwickler als auch für Business-Stakeholder sichtbar macht.
Diese Prüfungen sind besonders wichtig in Unternehmen, die sensible Daten für die Überprüfung nicht einfach in die Umgebung eines Drittanbieters übertragen können. Eine In-Database-Ausführung hält die Analyse innerhalb der vom Kunden kontrollierten Systeme. Dies ist die richtige Wahl, wenn strenge Datenschutz-, Datenresidenz- oder Compliance-Anforderungen bestehen. Zudem verringert es den Aufwand für Spezialisten bei der Routineüberwachung, da die Plattform die Daten dort im Auge behalten kann, wo sie bereits liegen.
Ein praktischer Ablauf für die Überwachung
Zuerst die Aktualität prüfen. Verspätete Datenladungen führen zu veralteten Berichten, noch bevor es jemand bemerkt. Ist die Aktualität nicht sichtbar, nehmen Business-Anwender fälschlicherweise an, das Dashboard sei auf dem neuesten Stand.
Als Nächstes strukturelle Änderungen verfolgen. Schema-Tracking fängt umbenannte oder gelöschte Felder ab, bevor die BI-Schicht bricht.
Auf Ausreißer und Drift achten. Anomalien bei Volumen, Verteilung oder Geschäftsregeln fallen oft auf, bevor Menschen sie in einem Dashboard entdecken.
Die Ergebnisse in einer gemeinsamen Ansicht zeigen. Qualitäts-Dashboards machen deutlich, welche Datensätze stabil genug für den Self-Service sind und welche Aufmerksamkeit benötigen.
Faustregel: Datenqualität für Self-Service ist keine Aufgabe für das Backoffice. Sie ist die Kontrollebene für jeden Bericht, jedes Modell und jede Entscheidung, die auf gemeinsam genutzten Daten basiert.
Die besten Observability-Programme überschwemmen die Teams nicht mit Warnmeldungen. Sie reduzieren das Rauschen, indem sie normales Verhalten erlernen und nur die Ausnahmen hervorheben, auf die es ankommt. Das ist der Unterschied zwischen Alibi-Monitoring und Monitoring als echtem operativen Schutz.
Enterprise-Anwendungsfälle in regulierten Branchen
Ein Sozialversicherungsanbieter ist ein gutes Beispiel dafür, was sich ändert, wenn Governance richtig konzipiert ist. Das Team verabschiedete sich von der Pflege von 9.000 manuell erstellten Datenqualitätsregeln und wechselte zu einer KI-gestützten Anomalieerkennung, wodurch die täglichen Warnmeldungen von über 140 auf handlungsrelevante Signale reduziert wurden. Die eigentliche Lehre liegt nicht nur in der Anzahl der Meldungen. Sie besteht darin, dass die Regelpflege nicht mehr den Qualitäts-Workflow dominierte, sodass die Ingenieure Zeit für die Fehler hatten, die tatsächlich Auswirkungen hatten.
Dieses Muster zeigt sich in allen regulierten Sektoren. Im Gesundheitswesen fängt das Monitoring der Aktualität verspätete Datenladungen ab, bevor die Dashboards für die Patientenversorgung veralten. In der Telekommunikation schützt das Schema-Tracking die Abrechnungsanalysen vor vorgelagerten Änderungen, die sich andernfalls in fehlerhaften Berichten fortsetzen würden. Im Finanzbereich und im öffentlichen Sektor ist der Bedarf noch breiter, da reproduzierbare Berichterstattung und Auditierbarkeit ebenso wichtig sind wie der Benutzerkomfort.
Für Teams, die strukturierte Weiterbildungswege rund um diese betrieblichen Veränderungen suchen, kann ein MBA in Operations and Supply Chain Fachkräften helfen, Prozesskontrolle zu verstehen, obwohl die eigentliche Analysearbeit weiterhin von einem soliden Plattformdesign und Governance-Disziplin abhängt.
Was diese Implementierungen gemeinsam haben
Unternehmen, die Self-Service erfolgreich etablieren, behandeln nicht jeden Datensatz gleich. Sie trennen hochgradig vertrauenswürdige Standardmetriken von experimentellen Arbeiten. Zudem weisen sie Verantwortlichkeiten klar zu, sodass Analysten wissen, wer die semantische Schicht pflegt, wer Zugriffe genehmigt und wer reagiert, wenn ein Datenproblem auftritt.
Der entscheidende Punkt ist nicht, dass jede Branche andere Diagramme hat. Es ist vielmehr die unterschiedliche Fehlertoleranz. Ein Abrechnungs-Dashboard, ein Patienten-Dashboard und ein Bericht über öffentliche Leistungen benötigen alle unabhängige Kontrollen, selbst wenn sie auf derselben Plattform laufen.
Implementierungs-Roadmap und Erfolgsmetriken
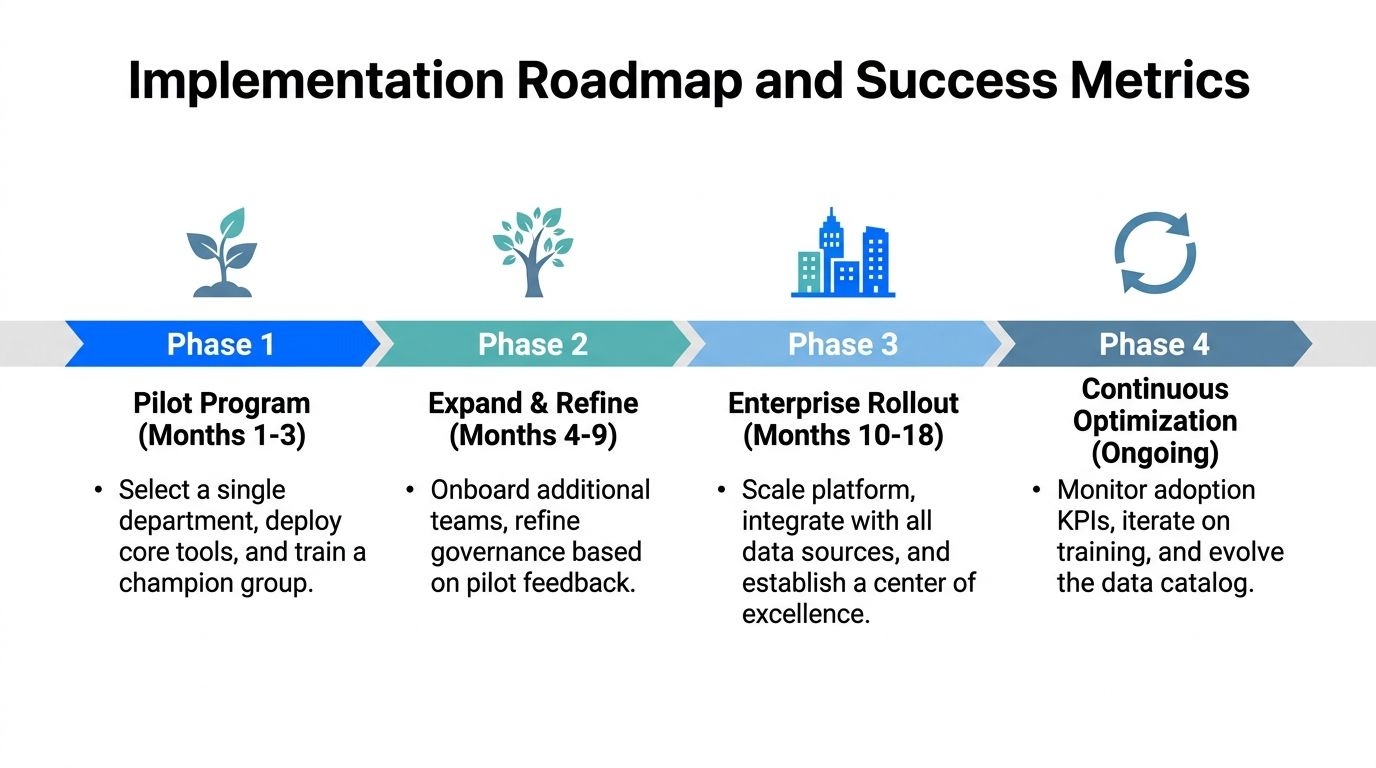
Der sauberste Rollout-Pfad ist der, der klein genug bleibt, um das Modell zu beweisen. Beginnen Sie mit einem Pilot-Team, das unter echtem geschäftlichem Druck steht, aber eine begrenzte Schadenswirkung hat. Erweitern Sie den Kreis erst, wenn Definitionen, Zugriffsrechte und Qualitätsprüfungen dem täglichen Gebrauch standhalten. Wenn die Pilotphase zu schnell ausgeweitet wird, verwässert die Governance, bevor der Prozess stabil ist.
Den Rollout wie ein operatives Programm messen
Die richtigen Metriken sind operativer Natur, nicht kosmetischer. Die Time-to-Insight zeigt Ihnen, ob Benutzer schneller vorankommen. Die Arbeitslast des Datenteams zeigt, ob Analysten weniger mit sich wiederholenden Anfragen belastet werden. Die Dashboard-Akzeptanz signalisiert, ob das Business der Plattform genug vertraut, um sie zu nutzen. Die Häufigkeit von Datenqualitätsvorfällen zeigt, ob die Umgebung sicherer oder einfach nur geschäftiger wird.
Diese Kennzahlen funktionieren am besten, wenn sie gemeinsam betrachtet werden. Wenn sich die Time-to-Insight verbessert, aber die Häufigkeit von Vorfällen steigt, agiert das Unternehmen möglicherweise schneller auf Kosten des Vertrauens. Wenn die Akzeptanz gering ist und die Arbeitslast nie sinkt, ist die Plattform vielleicht nützlich, aber nicht in die tägliche Arbeit integriert. Es kommt darauf an, auf die Balance zu achten, nicht nur auf die reine Geschwindigkeit.
Häufige Fehler beim Rollout
Zu frühe Erweiterung der Pilotphase: Teams fügen oft weitere Abteilungen hinzu, bevor die semantische Schicht und die Governance-Regeln stabil sind.
Mangelnde Schulung der Benutzer: Eine Self-Service-Plattform ohne Einarbeitung verlagert die Verwirrung nur vom Datenteam zum Business-Anwender.
Vernachlässigung der Wartungsarbeit: Glossare, Berechtigungen und Qualitätsprüfungen erfordern fortlaufende Zuständigkeit, keine einmalige Einführung.
Dashboards als das Endprodukt betrachten: Das eigentliche Produkt ist das Betriebsmodell, das dafür sorgt, dass die Dashboards vertrauenswürdig bleiben.
Die besten Programme entwickeln sich zu einem Center of Excellence, das gemeinsame Definitionen pflegt, Fachbereichs-Teams unterstützt und den Katalog sauber hält. Das macht Self-Service-Analytics von einer reinen Tool-Einführung zu einer dauerhaften Kompetenz.
Checkliste für die Tool-Auswahl und Bereitstellungsstrategie
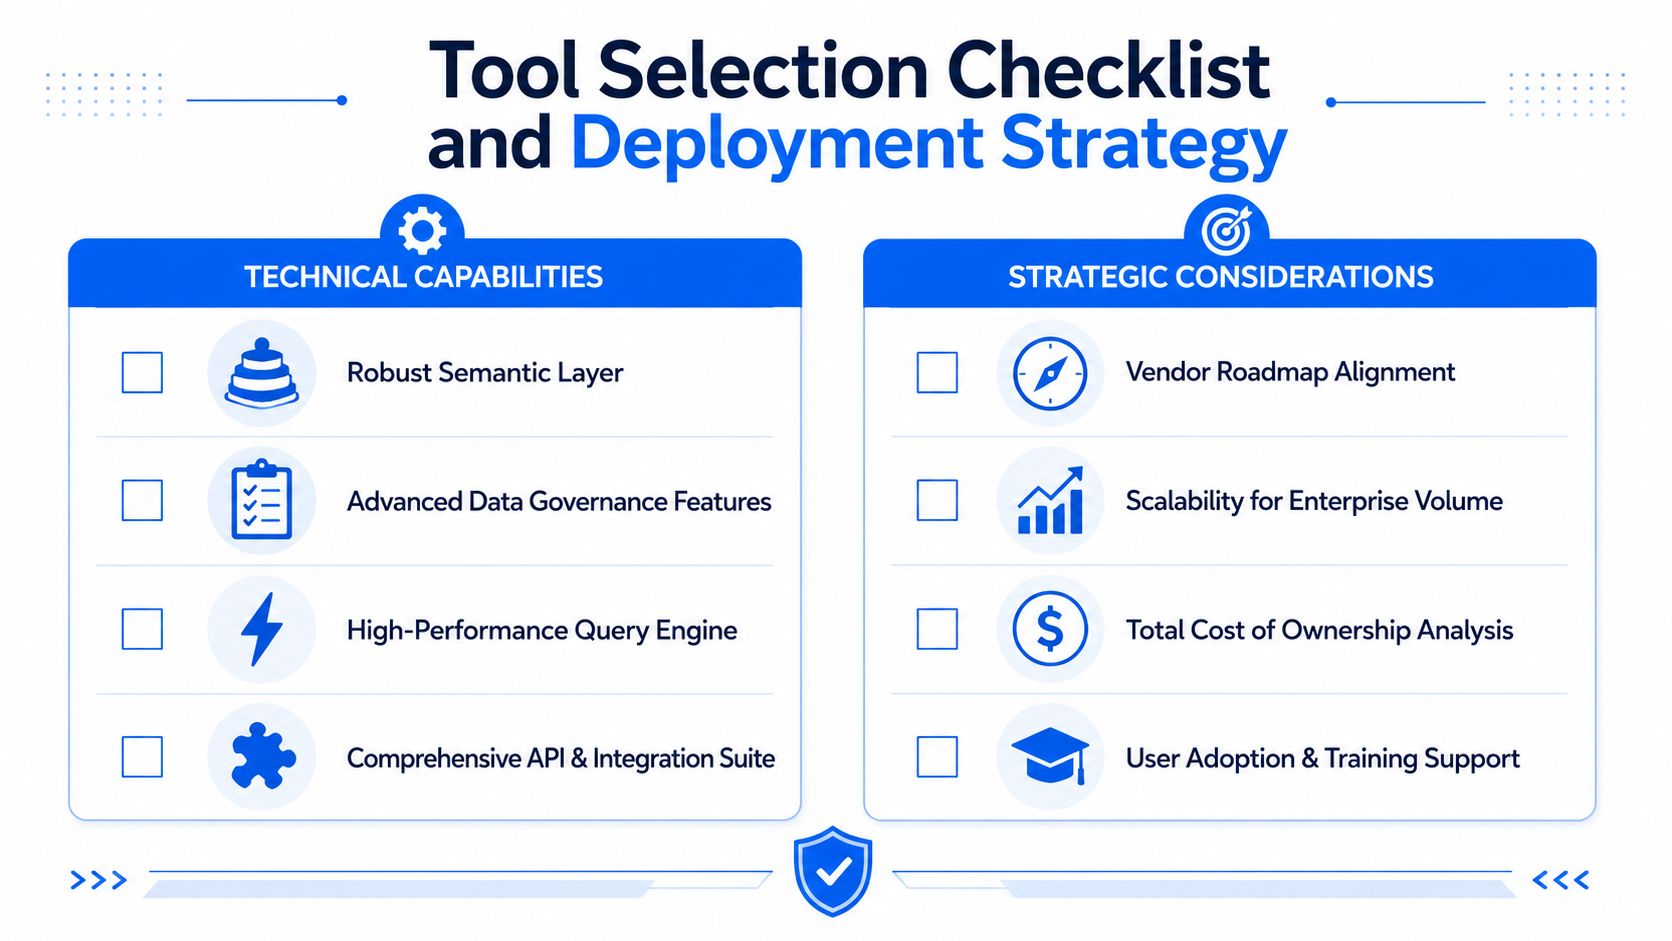
Die Tool-Auswahl sollte bei der Architektur beginnen, nicht bei den Screenshots. Eine ansprechende Benutzeroberfläche ist hilfreich, gleicht aber keine schwache semantische Unterstützung, mangelhafte Governance-Automatisierung oder eine Plattform aus, die nicht zu Ihrem Sicherheitsmodell passt. Enterprise-Einkäufer sollten Tools genauso bewerten wie Infrastruktur – indem sie fragen, was unter realer Nutzung bricht.
Was Sie vor dem Kauf prüfen sollten
Starke Unterstützung für die semantische Schicht. Stellen Sie sicher, dass Business-Definitionen zentralisiert und teamübergreifend wiederverwendet werden können.
Data Governance-Funktionen. Bestätigen Sie, dass rollenbasierter Zugriff, Freigaben und die Durchsetzung von Richtlinien integriert sind.
Integration von Observability. Stellen Sie sicher, dass Qualitäts-, Aktualitäts- und Schema-Tracking mit dem Analytics-Workflow verknüpft werden können.
Flexibilität bei der Bereitstellung. Private Cloud, On-Premises oder vom Kunden kontrollierte Umgebungen sind wichtig, wenn die Datenresidenz eine Einschränkung darstellt.
Tiefe der APIs und Integrationen. Die Plattform sollte in bestehende Warehouses, Kataloge und Pipeline-Tools passen.
Skalierbarkeit für Enterprise-Volumina. Ein Erfolg in der Pilotphase bedeutet noch nicht, dass die Plattform einer breiten Einführung standhalten kann.
Schulung und Unterstützung bei der Einführung. Business-Anwender benötigen Befähigung, nicht nur reinen Zugriff.
Gesamtkosten des Betriebs (TCO). Versteckte Kosten zeigen sich meist im Governance-Overhead und im Supportaufwand, nicht in der Lizenzgebühr.
Eine gute Bereitstellungsstrategie verläuft in Phasen. Betreiben Sie die neue Plattform parallel zum bestehenden Reporting-Stack so lange, bis die Ergebnisse validiert und Lücken geschlossen sind. Führen Sie die Benutzer in Wellen heran. Beginnen Sie mit der Gruppe, die am meisten profitiert und eine gewisse Prozessänderung tolerieren kann. Halten Sie den alten Pfad offen, bis dem neuen Workflow voll vertraut wird.
Die wichtigste Prüfung ist, ob das Tool dem Unternehmen hilft, eine konsistente Bedeutung durchzusetzen, ohne die Benutzer auszubremsen. Wenn es das nicht leisten kann, spielt es keine Rolle, wie gut die Demo aussah.
Wenn Sie Self-Service-Analytics für ein reguliertes Unternehmen aufbauen, kann digna Ihnen helfen, die Qualitäts- und Observability-Schicht zu etablieren, ohne sensible Daten an die Umgebung von Drittanbietern weiterzugeben. Besuchen Sie digna, um zu sehen, wie datenbankinterne Anomalieerkennung, Aktualitätsüberwachung, Schema-Tracking und Validierung vertrauenswürdige Analysen in großem Stil unterstützen.


