Schemas im Data Warehouse: Ein vollständiger Leitfaden für 2026
|
7
min. Lesezeit

Sie kennen das Gefühl. Ein Dashboard sieht morgens noch gut aus, dann beginnt eine Besprechung auf Führungsebene, und ein Diagramm ist plötzlich leer, weil jemand weiter oben in der Pipeline eine Spalte umbenannt hat. Das Data Warehouse ist nicht im abstrakten Sinne „abgestürzt“, sondern ein nachgelagerter Data Contract ist gebrochen, und niemand hat die Auswirkungen früh genug bemerkt.
Das ist der Hauptgrund, warum Schemata in Data-Warehouse-Systemen wichtig sind. Sie sind nicht nur Tabellen-Layouts, sie sind die Struktur, die jedem Konsumenten mitteilt, wie die Geschäftsdaten sicher zu lesen sind, egal ob dieser Konsument ein BI-Tool, ein Semantic Layer oder eine ML-Pipeline ist. Die umfassendere Definition von Oracle für ein Schema als eine Sammlung von Datenbankobjekten, einschließlich Tabellen, Sichten (Views), Indizes und Synonymen, hilft dabei, das allgemeine Datenbankkonzept von dem dimensionalen Warehouse-Muster zu trennen, das Analysten abfragen (Oracle schema definition).
Inhaltsverzeichnis
Was ein Schema in einem Data Warehouse wirklich bedeutet
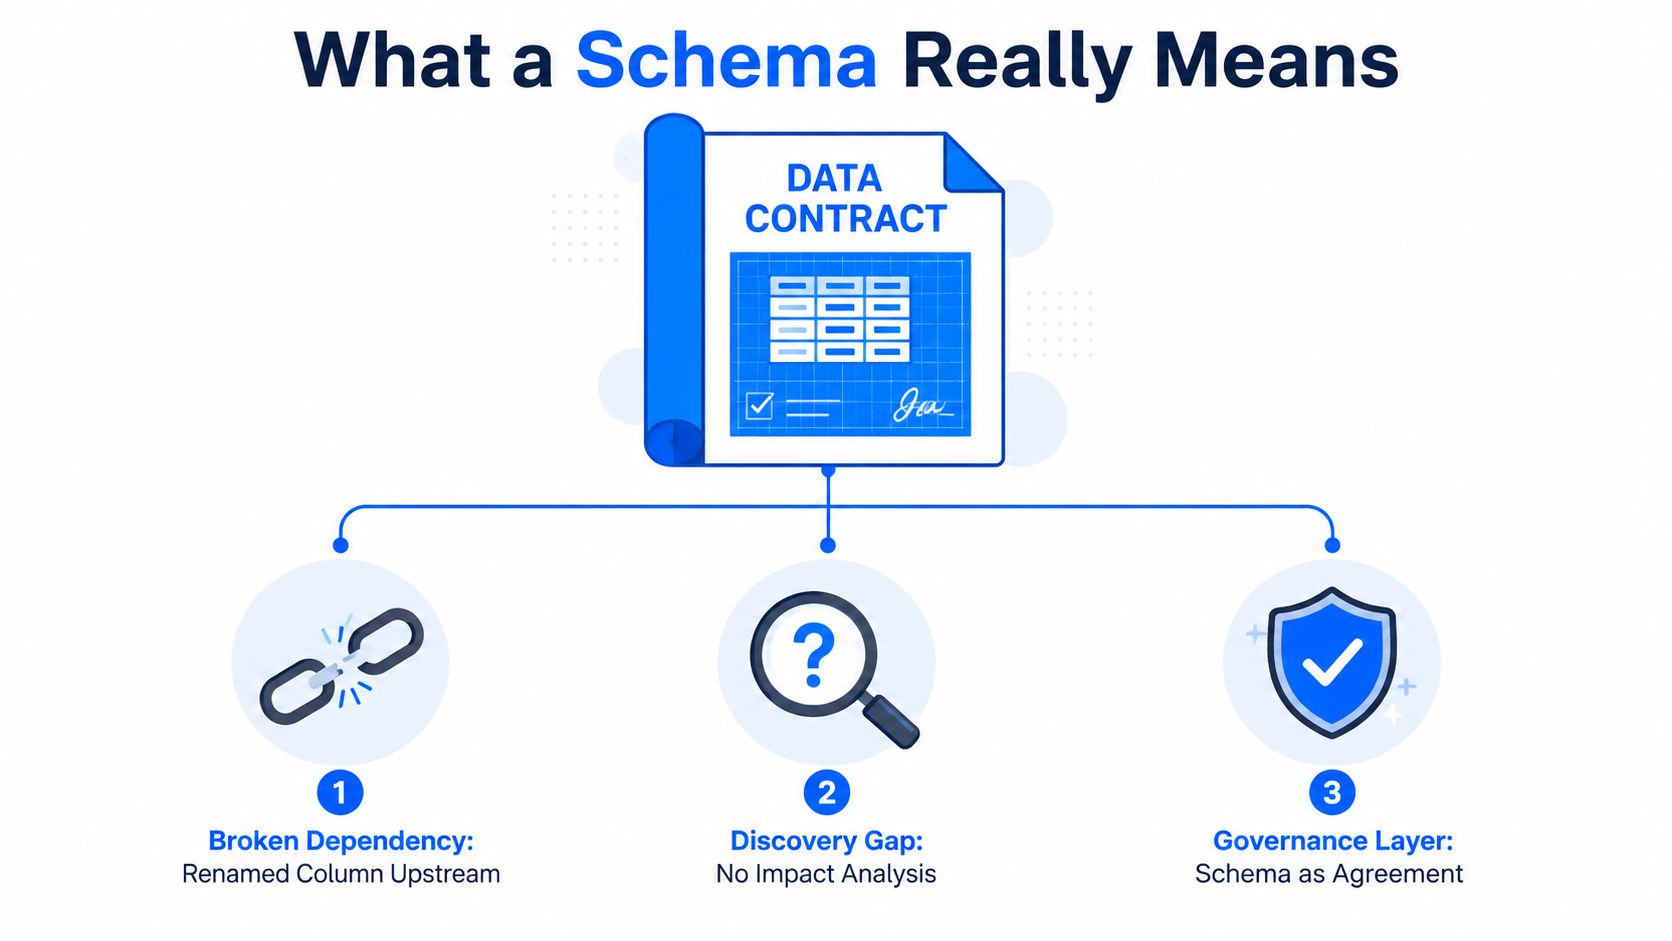
Ein Warehouse-Schema ist die Art und Weise, wie Sie Bedeutung codieren, nicht nur die Art, wie Sie Tabellen anordnen. In der Praxis ist es die logische Anordnung von Tabellen, Schlüsseln, Beziehungen und Einschränkungen, die es einem Warehouse ermöglicht, geschäftliche Fragen konsistent zu beantworten, selbst wenn die Rohquellsysteme ungeordnet sind. Das ist der Grund, warum dimensionale Warehouse-Schemata überhaupt existieren: Sie verwandeln operative Daten in ein semantisches Modell, das das analytische Lesen unterstützt und die geschäftliche Bedeutung mit jeder Zeile verknüpft hält.
Das Tabellen-Layout ist nicht die ganze Geschichte
Ein transaktionales Systemschema und ein Warehouse-Schema lösen unterschiedliche Probleme. Das Quellsystem kümmert sich um schnelle Schreibvorgänge, strenge Integrität und tägliche Aktualisierungen. Das Warehouse kümmert sich um historische Lesevorgänge, wiederholbare Joins und eine stabile Berichterstellung über viele Dimensionen hinweg. Ein Warehouse-Schema verhält sich wie ein Schnittstellenvertrag, da Analysten und BI-Tools darauf angewiesen sind, dass die Bedeutung jeder Tabelle und jedes Schlüssels stabil genug bleibt, um verlässliche Abfragen durchzuführen.
Diese Unterscheidung ist wichtig, wenn eine Spalte umbenannt wird oder sich ein Schlüssel ändert. Wenn das Warehouse das Schema wie einen Vertrag behandelt, können Teams die Auswirkungen abschätzen, bevor sie eine Änderung einführen. Wenn sie es wie ein loses Tabellen-Layout behandeln, bricht die nachgelagerte BI zuerst zusammen und die governance bemerkt es erst später. Das gleiche Prinzip gilt für ML-Features und Reverse-ETL-Feeds, da jeder Konsument, der aus dem Warehouse liest, darauf angewiesen ist, dass die Struktur von einer Version zur nächsten wiedererkennbar bleibt.
Praktische Regel: Ein Warehouse-Schema sollte den Konsumenten sagen, was eine Zeile bedeutet, noch bevor sie jemals SQL schreiben.
Warum die breitere Datenbankdefinition immer noch wichtig ist
Die Definition von Oracle ist nützlich, weil sie Teams daran erinnert, dass ein Schema eine eigene Sammlung von Datenbankobjekten ist und nicht nur ein Diagramm. In einem Warehouse kann dieser breitere Objektsatz neben dimensionalen Tabellen auch Sichten (Views), Einschränkungen (Constraints), Indizes und Synonyme umfassen. Das bedeutet, dass das Schema-Denken Zugriffsmuster und governance miteinschließen muss, nicht nur den Modellierungsstil (Oracle schema definition).
Diese breitere Sichtweise macht auch die Schema-Verfolgung nützlich. Wenn eine Tabelle, eine Sicht oder ein Schlüssel ihre Form ändern, ohne erfasst zu werden, können nachgelagerte Konsumenten die Abhängigkeit verlieren, auf die sie sich verlassen haben – selbst wenn die Abfrage immer noch kompiliert wird. Ein Data Contract-Schema fungiert als governance-Ebene, die diese Abhängigkeiten sichtbar macht, bevor sie brechen, und die Infografik hier zeigt diese Beziehung deutlich: Eine Infografik, die zeigt, dass ein Data Contract-Schema als governance-Ebene fungiert, die fehlerhafte Datenabhängigkeiten verhindert.
Am klarsten lässt es sich so ausdrücken: Ein Schema ist die Vereinbarung des Warehouses über Bedeutung, Struktur und Änderung. Wenn diese Vereinbarung sorgfältig verfolgt wird, erhalten Analysten konsistente Zahlen, BI-Dashboards bleiben lesbar und technische Änderungen können vorangetrieben werden, ohne die Personen zu überraschen, die auf das Warehouse angewiesen sind.
Das Sternschema und die Denkart der dimensionalen Modellierung
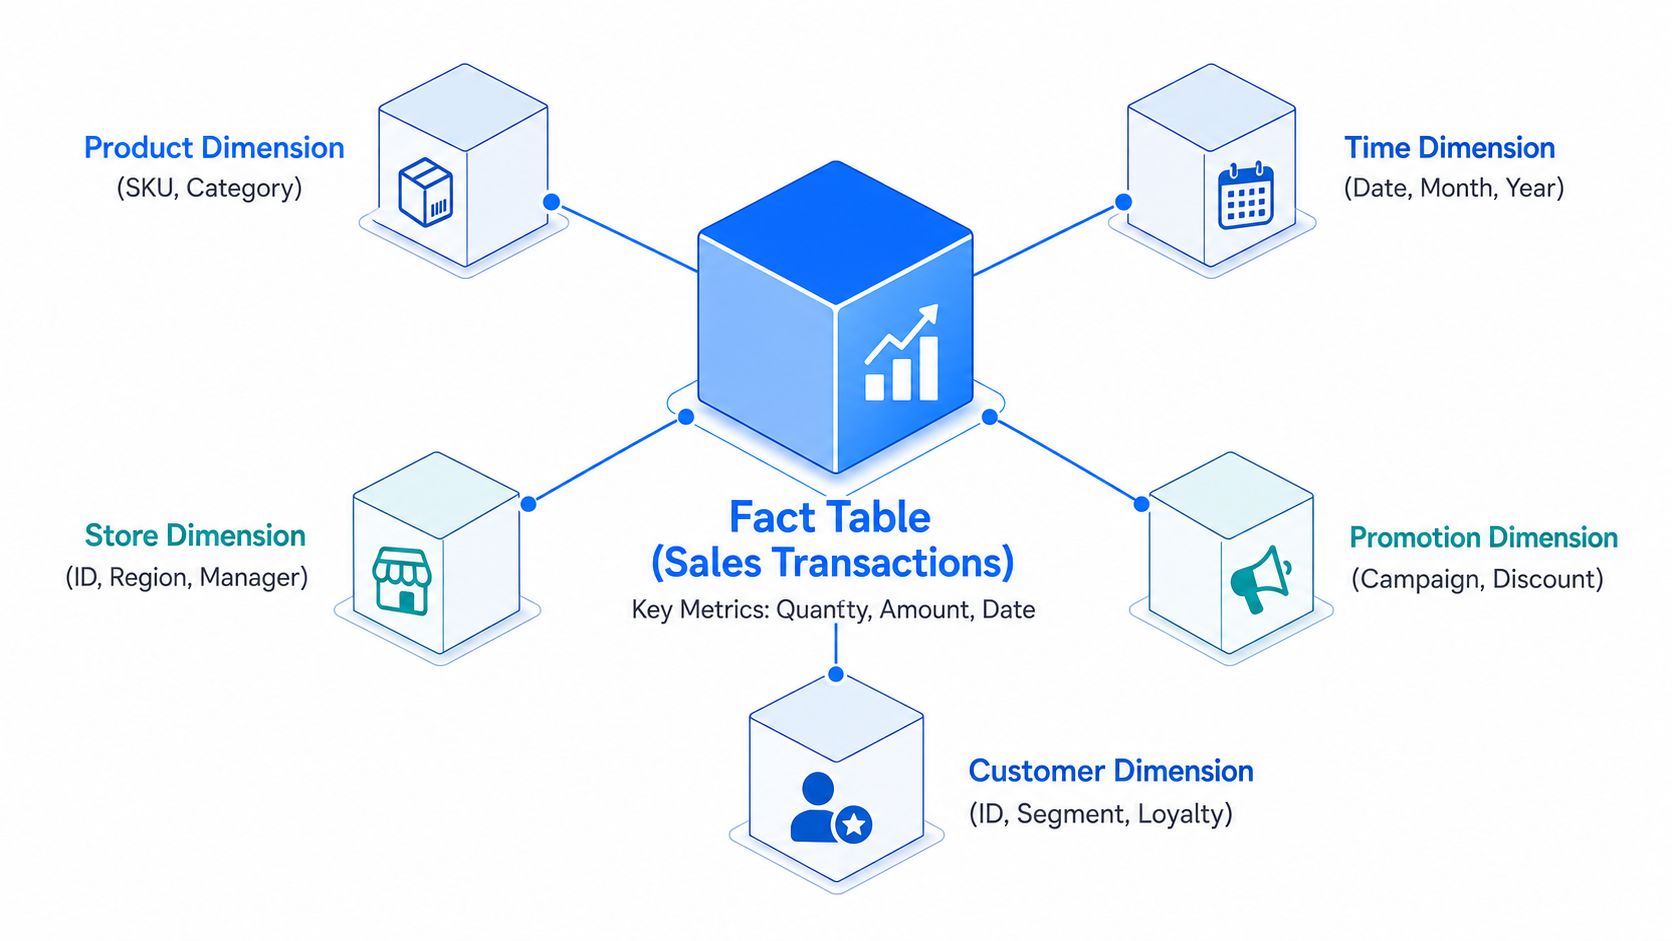
Ein Warehouse-Team spürt den Unterschied meist, sobald ein Modell die BI-Anwender erreicht. Abfragen werden einfacher, die Joins werden vorhersehbar und das Gespräch verlagert sich von „Wo ist dieses Feld gespeichert?“ zu „Welchen Geschäftsvorfall beschreibt diese Zeile?“. Das Sternschema (Star Schema) ist der klarste Ausdruck der dimensionalen Modellierung, weil es diese Antwort sichtbar hält. Eine zentrale Faktentabelle enthält den Geschäftsvorfall, und die umgebenden Dimensionstabellen liefern den Kontext. Der Leitfaden von MotherDuck beschreibt das Muster anschaulich: Jede Faktenzeile stellt einen Geschäftsvorfall dar, während Dimensionen die Fragen nach dem Wer, Was, Wo, Wann und Warum beantworten (MotherDuck star schema guide).
Beginnen Sie mit dem Geschäftsvorfall
Der dimensionale Ansatz von Ralph Kimball prägt auch heute noch das moderne Warehouse-Design, weil er mit der Frage beginnt, die Entwickler zuerst klären müssen: Was bedeutet eine Zeile? Die Abfolge beginnt mit dem Geschäftsprozess, dann dem Detaillierungsgrad (Grain), dann den Dimensionen und schließlich den Fakten auf diesem Detaillierungsgrad. Diese Reihenfolge bewahrt das Team davor, über Spaltennamen zu streiten, bevor das Modell eine stabile Analyseeinheit hat.
Ein Warehouse-Boden mit einer Nabe und mehreren Speichen ist hier ein nützliches mentales Modell. Die Nabe ist die Faktentabelle, die Speichen sind die Dimensionen, und jeder Join folgt einem bekannten Pfad. BI-Teams finden es meist einfacher, damit zu arbeiten als mit einer normalisierten Struktur, da das Beziehungsmuster sichtbar bleibt und die Kennzahlen an dem Ereignis verankert bleiben, das sie beschreiben.
Kennzahlen, Fakten und sich langsam verändernder Kontext
Ein Fakt ist der Geschäftsvorfall, und er trägt in der Regel eine oder mehrere numerische Kennzahlen (Measures). Die Verkaufsmenge ist additiv, der Kontostand ist semi-additiv, weil er von dem betrachteten Zeitraum abhängt, und der Einzelpreis ist nicht-additiv, da eine Summierung meist keinen Sinn ergibt. Die klassische dimensionale Modellierung berücksichtigt auch sich langsam verändernde Dimensionen (Slowly Changing Dimensions). Auf diese Weise bewahrt ein Warehouse den Verlauf, wenn sich beschreibende Attribute wie die Stadt des Kunden oder der Filialleiter im Laufe der Zeit ändern (Conceptual Design of Data Warehouses from ER Schemes).
Ein Sternschema funktioniert wie ein Schnittstellenvertrag für Analysen. Es definiert, welches Ereignis offengelegt wird, welche Deskriptoren verfügbar sind und wie Änderungen gehandhabt werden sollen, damit nachgelagerte Konsumenten nicht raten müssen. Deshalb ist es sowohl für die Schema-Verfolgung als auch für die Modellierung wichtig. Wenn sich ein Dimensionsattribut oder ein Schlüssel ändert, ohne erfasst zu werden, können BI-Berichte und ML-Feature-Pipelines die Abhängigkeit verlieren, auf der sie aufgebaut wurden, selbst wenn das SQL immer noch kompiliert wird.
Ein Sternschema besteht nicht aus „breiten Tabellen aus Bequemlichkeit“. Es ist ein bewusstes Modell für eine stabile analytische Bedeutung.
Das Muster bleibt beliebt, weil es zu Aggregation und Konsum passt. dignas Übersicht zum Sternschema zeigt dieselbe Kernidee in einem einfachen Layout, und das Sternformat sorgt dafür, dass Joins für BI-Abfragen leicht nachvollziehbar bleiben, ohne dass Analysten zuerst jedes operative Detail verstehen müssen.
Vergleich von Stern-, Schneeflocken- und Galaxie-Schemata
Ein Warehouse-Team wählt in der Regel zwischen Stern- (Star), Schneeflocken- (Snowflake) und Galaxie-Schemata (Galaxy) – auch Faktenkonstellation genannt –, wenn es entscheidet, wie viel Struktur es nachgelagerten Benutzern offenlegt. Die entscheidende Frage ist nicht, welcher Name sauberer klingt. Es geht darum, welche Struktur sich wie ein stabiler Schnittstellenvertrag für Ihre Arbeitslast verhält, mit den geringsten Überraschungen für BI- und ML-Konsumenten, wenn sich das Modell im Laufe der Zeit ändert (Exasol warehouse schema overview).
Nutzen Sie die Arbeitslast als Diagnosewerkzeug
Beginnen Sie mit der Art der Arbeit, nicht mit der Namensgebung. Ein Warehouse mit einem klaren Geschäftsbereich und vielen Dashboard-Benutzern passt meist gut zu einem Sternschema, da die zentrale Faktentabelle und ihre direkt verknüpften Dimensionen den Abfragepfad einfach halten. Ein Warehouse, das dieselben beschreibenden Attribute über mehrere verwandte Tabellen hinweg teilt, passt möglicherweise besser zu einem Schneeflockenschema, da die zusätzliche Normalisierung die mehrfache Speicherung von Attributen reduziert. Ein Warehouse, das mehrere Faktentabellen benötigt, um Dimensionen über Geschäftsprozesse hinweg gemeinsam zu nutzen, weist auf das Galaxie-Muster hin, bei dem die Wiederverwendbarkeit über Themenbereiche hinweg wichtiger ist als jede Abfrage so kurz wie möglich zu halten (Exasol warehouse schema overview).
Eine schnelle Diagnose hilft. Zählen Sie die Faktentabellen und fragen Sie dann, wie oft sie kombiniert werden müssen. Ein Bereich mit wiederholtem Slicing und Dicing deutet meist auf ein Sternschema hin. Mehrere Bereiche mit gemeinsam genutzten Dimensionen weisen in Richtung Galaxie. Wenn die Wartung der Dimensionen das Hauptproblem ist, kann das Schneeflockenschema helfen, indem es sich ändernde Attribute in verwandte Tabellen aufteilt – allerdings nur, wenn die zusätzlichen Joins nicht mehr Reibung erzeugen, als sie beseitigen.
Schema-Familie | Struktur | Hauptkompromiss | Beste Eignung |
|---|---|---|---|
Stern (Star) | Eine zentrale Faktentabelle mit direkt verknüpften Dimensionen | Einfachheit vor Normalisierung | BI und Berichterstattung für einen einzelnen Bereich |
Schneeflocke (Snowflake) | Dimensionen sind in verwandte Untertabellen aufgeteilt | Speichereffizienz vor Abfrageeinfachheit | Dimensionen, die mehr strukturelle Wartung erfordern |
Galaxie (Galaxy) | Mehrere Faktentabellen teilen sich Dimensionen | Wiederverwendbarkeit vor anfänglicher Modellierungseinfachheit | Unternehmens-Warehouses, die sich über mehrere Geschäftsprozesse erstrecken |
Was Ihnen das jeweilige Design bringt
Ein Sternschema hält den Vertrag leicht lesbar. Analysten können eine Metrik bis zur Faktentabelle und dann zu den Dimensionen zurückverfolgen, ohne viele Joins durchlaufen zu müssen, weshalb es in BI-orientierten Warehouses nach wie vor üblich ist. Ein Schneeflockenschema hält mehr von der Dimensionshierarchie getrennt, sodass das Modell die Quellstruktur genauer widerspiegeln und einige Wartungsaufgaben sauberer gestalten kann. Der Preis dafür ist die Komplexität der Abfragen, da jede zusätzliche Tabelle einen weiteren Join-Punkt darstellt, den der Konsument verstehen muss.
Galaxie-Schemata lösen ein anderes Problem. Sie helfen, wenn ein Unternehmen möchte, dass dieselben Dimensionsdefinitionen mehr als einen analytischen Prozess unterstützen, wie etwa Vertrieb, Lagerbestand und Abwicklung. In diesem Szenario geht es weniger um Bequemlichkeit als vielmehr darum, Metriken über Teams und Tools hinweg aufeinander abzustimmen. Für einen kompakten Vergleich der Stern- und Schneeflockenformen nutzen Sie dignas Leitfaden zu Stern- und Schneeflockenschemata.
Die Wahl ist meist ein Kompromiss zwischen Abfrageeinfachheit, gemeinsamer Bedeutung und Wartung. Wenn Analysten wiederholbares SQL mit minimaler Join-Logik benötigen, ist das Sternschema meist die sauberste Lösung. Wenn sich gemeinsam genutzte Dimensionen häufig ändern und das Warehouse-Team die Struktur näher an der Quelle halten möchte, kann das Schneeflockenschema Redundanzen reduzieren. Wenn mehrere Faktentabellen über Geschäftsbereiche hinweg konsistent bleiben müssen, bietet das Galaxie-Schema dieses gemeinsame Fundament, ohne dass jedes Team eine eigene Version desselben Dimensionsmodells erstellen muss.
Schema-on-Write und Schema-on-Read in modernen Warehouses
Ein Warehouse-Schema ist nicht nur ein Tabellen-Layout. Es ist der Vertrag, der jedem nachgelagerten Konsumenten mitteilt, welche Form die Daten haben werden. Dieser Vertrag kann durchgesetzt werden, bevor die Daten geladen werden, oder später zur Abfragezeit interpretiert werden. Schema-on-Write wendet die Regeln im Vorfeld an, während Schema-on-Read es ermöglicht, die Struktur erst bei der Abfrage der Daten anzuwenden. Databricks beschreibt Warehouse-Systeme als den Ort für strukturierte, kontrollierte Analysen, während Lake-Systeme das Schema beim Lesen anwenden und Lakehouse-Designs versuchen, beide Ansätze zu verbinden (Databricks data warehouse types).
Wo die Durchsetzung stattfindet
Schema-on-Write-Systeme definieren die Tabellenform, bevor die Erfassung beginnt. Datentypen werden überprüft, nicht passende Datensätze werden frühzeitig abgelehnt und Analysten fragen Informationen ab, die bereits für eine bekannte Verwendung aufbereitet wurden. Das eignet sich für Teams, denen Konsistenz, Auditierbarkeit und wiederholbare Berichterstattung wichtiger sind als die exakte Aufbewahrung jedes Rohdaten-Payloads bei der Ankunft.
Schema-on-Read folgt einem anderen Weg. Rohdaten werden zuerst gespeichert, und die Query-Engine interpretiert die Struktur erst dann, wenn jemand danach fragt. Das macht es nützlich für Explorationen, Sandbox-Arbeiten und einige ML-Workflows, insbesondere wenn das Team noch lernt, was die Daten enthalten.
Der Kompromiss ist einfach: Schema-on-Write bietet Vorhersehbarkeit. Schema-on-Read bietet Flexibilität. Die meisten Unternehmensplattformen nutzen beides, mit einer kuratierten Warehouse-Ebene für kontrollierte Berichte und einer Rohdaten- oder Sandbox-Ebene für Experimente und Feature Engineering.
Warum die meisten Teams letztendlich beide nutzen
Das Lakehouse-Muster existiert, weil keines der Extreme alle Anforderungen abdeckt. Databricks beschreibt moderne Lakehouse-Architekturen als eine Kombination aus governance im Warehouse-Stil und der Flexibilität von Lake-Systemen, was für Teams geeignet ist, die sowohl Rohdatenverläufe als auch vertrauenswürdige Data Marts auf derselben Plattform benötigen.
Kontrollierte BI gehört auf die vertragsgestützte Seite. Exploration gehört auf die flexible Seite.
Diese Aufteilung hält das analytische Warehouse verlässlich und ermöglicht Datenwissenschaftlern dennoch den Zugriff auf Rohdaten. Sie verhindert auch, dass die semantische Ebene jede experimentelle Tabelle aufnimmt, die auf der Plattform landet. Wenn eine Arbeitslast Berichte für die Führungsebene unterstützt, ist Schema-on-Write meist die sicherere Standardeinstellung. Wenn es darum geht, Muster zu finden oder Features aus Rohdaten zu erstellen, ist Schema-on-Read oft die bessere Wahl.
Die Schema-Wahl beeinflusst auch die Observability. Ein Vertrag ist nur dann nützlich, wenn Teams sehen können, wann er sich ändert, die alte Form mit der neuen vergleichen und nachgelagerte Konsumenten warnen können, bevor Dashboards oder Modelle ausfallen. Hier spielen Schema-Verfolgung und zugehörige Überprüfungen eine Rolle, da sie das Schema-Design in etwas verwandeln, das operativ überwacht werden kann, anstatt etwas, das Entwickler erst nach einer fehlgeschlagenen Abfrage entdecken.
Für Teams, die sich mit breiteren Strategien für Änderungen bei IT-Projekten befassen, ist die Lektion dieselbe. Das Schema muss sich kontrolliert ändern, mit Sichtbarkeit für die Personen und Systeme, die davon abhängen.
Schema-Evolution und sicheres Änderungsmanagement
Das stärkste Warehouse-Schema ist nicht das, das am ersten Tag am einfachsten aussah. Es ist dasjenige, das sich vorhersehbar ändern kann, ohne die Personen und Systeme zu beeinträchtigen, die davon abhängen. Das bedeutet, das Schema als einen Schnittstellenvertrag zu betrachten, nicht nur als eine Speicherstruktur. Der Vertrag wird von Dashboards, semantischen Ebenen und automatisierten Pipelines genutzt, und diese Konsumenten können ohne Vorwarnung ausfallen, wenn sich die Form ändert.
Kompatible und inkompatible Änderungen
Einige Änderungen sind leicht zu verkraften. Das Hinzufügen einer Nullable-Spalte, das Hinzufügen einer neuen Tabelle oder das Erweitern einer Sicht kann oft ohne Beeinträchtigung bestehender Konsumenten erfolgen. Andere Änderungen sind gefährlich. Das Umbenennen einer Spalte, das Löschen eines Feldes oder das Verschärfen eines Typs kann eine Abfrage unbrauchbar machen, die gestern noch funktioniert hat und heute immer noch kompiliert wird.
Deshalb beginnt sicheres Änderungsmanagement mit Kompatibilität, nicht mit Bequemlichkeit. Wenn ein nachgelagerter Bericht ein Feld namens customer_id erwartet, verwandelt das Umbenennen in client_id ohne eine Kompatibilitätsebene eine Metadatenänderung in einen Produktionsvorfall. Die Mechanik der Änderung ist weniger wichtig als die Auswirkung auf die Konsumenten.
Muster, die den Schadensradius verringern
Teams halten das Änderungsrisiko in der Regel mit einer kleinen Anzahl von Mustern gering. Spalten-Aliasing kann alte Namen beibehalten, während neue eingeführt werden. Sichtbasierte Kompatibilitätsebenen können eine stabile Schnittstelle bieten, während sich die zugrunde liegende Tabelle weiterentwickelt. Duale Schreibvorgänge und versionierte Tabellen-Suffixe können Konsumenten Zeit für die Migration geben, ohne eine harte Umstellung zu erzwingen. Jedes Muster verschafft Zeit, und Zeit ist das, was das Warehouse vor Instabilität bewahrt.
Für Teams, die an einer umfassenderen Veränderungsdisziplin arbeiten, können Strategien für Änderungen bei IT-Projekten ein nützlicher Rahmen sein, da die Evolution von Warehouses oft aus denselben Gründen scheitert wie Plattformänderungen im Allgemeinen: unklare Verantwortlichkeiten und schwache Kommunikation.
Eine praktische Migrations-Checkliste
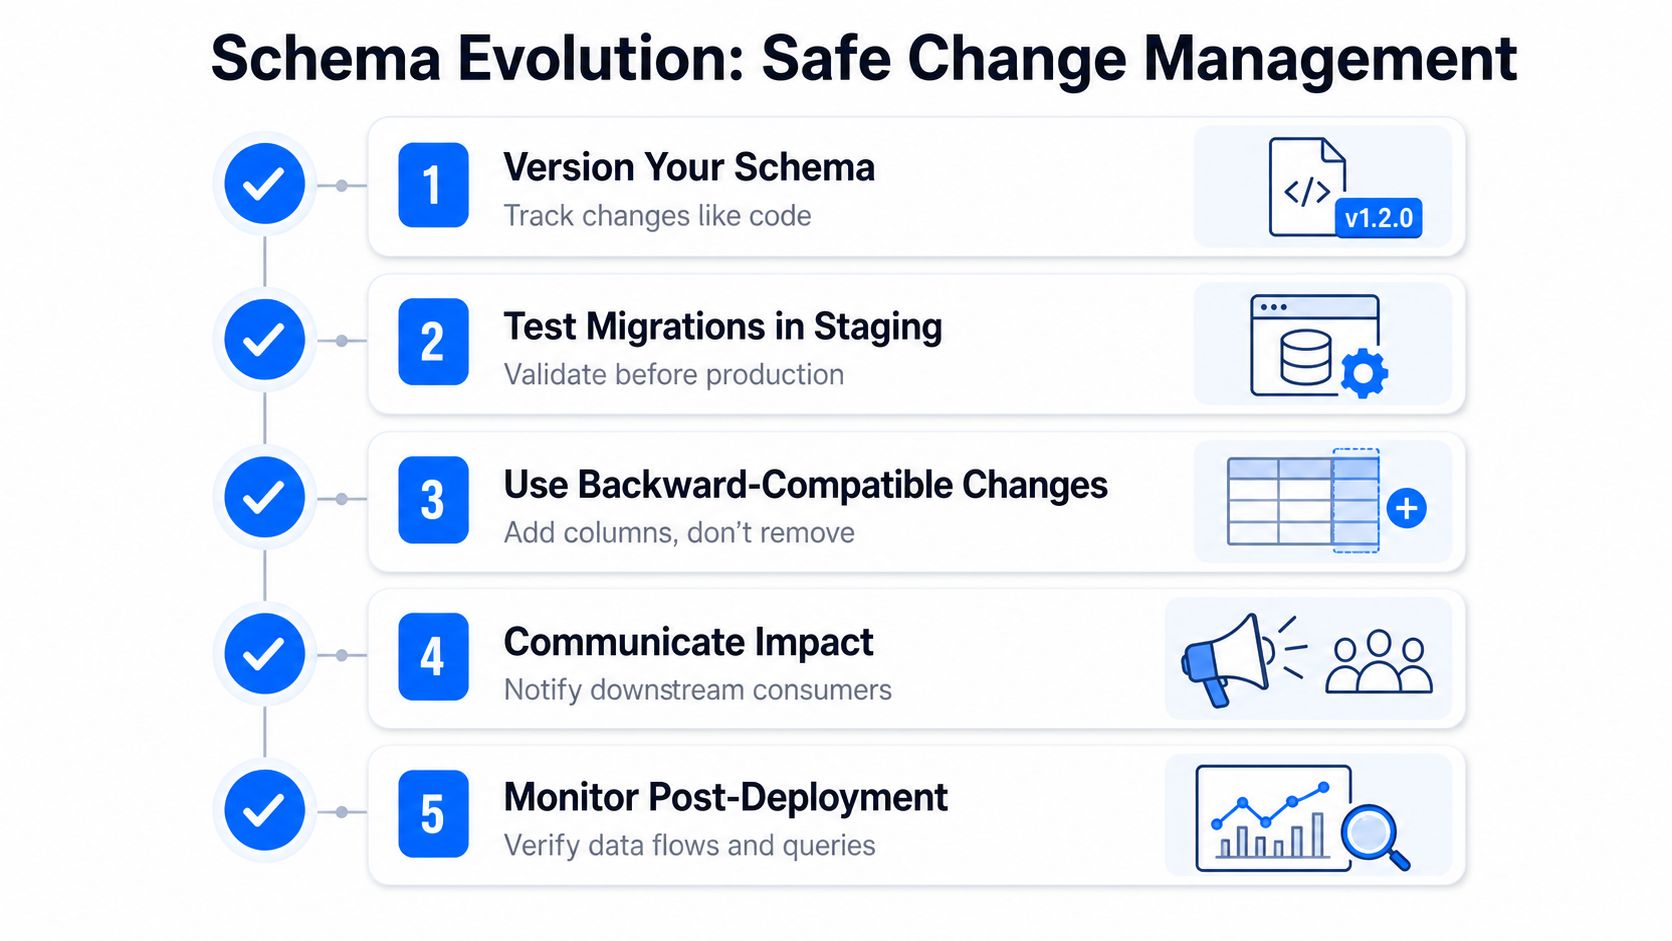
Das Schema versionieren: Verfolgen Sie Änderungen wie Code, damit Sie erklären können, was sich wann geändert hat.
Migrationen zuerst testen: Validieren Sie die neue Form, bevor nachgelagerte Konsumenten sie sehen.
Abwärtskompatible Änderungen bevorzugen: Fügen Sie hinzu, bevor Sie entfernen.
Auswirkungen kommunizieren: Informieren Sie BI-, Analytics-Engineering- und ML-Verantwortliche darüber, was sich ändern wird.
Nach der Bereitstellung überwachen: Bestätigen Sie, dass sich Abfragen, Ladevorgänge und Dashboards weiterhin wie erwartet verhalten.
Das ist der mentale Wandel, den moderne Teams benötigen. Schema-Design ist Lebenszyklus-Arbeit, keine Diagramm-Arbeit. Wenn sich das Modell nicht sicher weiterentwickeln kann, wird Ihnen seine anfängliche Eleganz später nicht helfen.
Observability-Praktiken, die die Schema-Integrität schützen
Ein Finanzbericht, der zwei Tage nach einer Bereitstellung nur Nullen zurückgibt, ist ein klassischer stiller Fehler. Die Ladejobs waren erfolgreich, niemand schlug beim Import Alarm, und das einzige sichtbare Symptom trat viel später auf, als ein Geschäftsanwender der Zahl vertraute. Genau wegen dieser Art von Drift muss die Schema-Integrität überwacht und nicht einfach vorausgesetzt werden.
Achten Sie auf das Fehlermuster, nicht nur auf die Pipeline
Eine Schemaänderung kann aus Sicht des Quellsystems harmlos aussehen. Ein String wird zu einem Int, eine Spalte verschiebt sich oder ein Feld verschwindit aus einer Umgebung und taucht in einer anderen auf. Das Warehouse lädt zwar weiterhin, aber die Bedeutung entspricht nicht mehr dem, was nachgelagerte Konsumenten erwarten.
Hier macht sich die Schema-Verfolgung bezahlt. dignas Schema Tracker überwacht kontinuierlich die Tabellenstruktur und erkennt Änderungen wie hinzugefügte oder entfernte Spalten sowie Datentypänderungen. Das ist nützlich, weil es strukturelle Abweichungen erkennt, bevor BI-Benutzer sie in einem Review-Zyklus bemerken. digna unterstützt auch den umgebungsübergreifenden Schemavergleich, was Teams dabei hilft, Entwicklung, Test und Produktion vor einem Live-Release zu vergleichen.
Ordnen Sie jede Observability-Praxis einem anderen Risiko zu
Die kontinuierliche Schema-Erkennung kümmert sich um strukturelle Abweichungen. Die Aktualitätsüberwachung erfasst fehlende oder verzögerte Ladevorgänge. Die Validierung auf Datensatzebene überprüft Geschäftsregeln, sodass ein technisch gültiger Datensatz, der gegen die erwartete Logik verstößt, dennoch markiert wird. Die KI-gestützte Anomalieerkennung fügt eine weitere Ebene hinzu, indem sie das Datenverhalten und nicht nur die Metadaten überwacht. Dies hilft Teams zu bemerken, wenn sich eine Kennzahl auf unerwartete Weise verändert, selbst wenn sich das Schema nicht geändert hat.
Diese Praktiken greifen ineinander. Die Schema-Verfolgung zeigt Ihnen, dass sich die Struktur geändert hat. Die Aktualität sagt Ihnen, dass die Daten nicht wie erwartet eingetroffen sind. Die Validierung zeigt Ihnen, dass der Datensatz laut Geschäftsregeln fehlerhaft ist. Die Anomalieerkennung signalisiert ungewöhnliches Verhalten, selbst wenn die Zeile technisch existiert.
Das Warehouse garantiert Vertrauen nicht von selbst. Vertrauen entsteht, indem man das Warehouse wie eine Produktionsabhängigkeit überwacht.
Wenn Sie einen konkreten Bezugspunkt für diese Denkweise suchen, zeigen dignas Best Practices für Observability, wie Schema-Verfolgung, Validierung, Aktualität und Anomalieüberwachung in einem einzigen Betriebsmodell zusammenwirken.
Hören Sie nicht beim Alarm auf
Es geht nicht darum, mehr Alarme zu sammeln. Es geht darum, die Zeit zwischen Abweichung und Entdeckung zu verkürzen. Aus diesem Grund muss Observability mit Verantwortlichkeiten, Eskalationspfaden und einem bekannten Rollback-Pfad verknüpft sein. Für Teams in regulierten Umgebungen ist dies besonders wichtig. Wenn Sie über den sicheren Umgang mit operativen Daten in einem anderen Kontext nachdenken, ist der WhisperAI-Leitfaden zur sicheren Transkription ein gutes Beispiel dafür, wie streng kontrollierte Workflows auf verlässliche Datenkontrollen angewiesen sind.
Unternehmens-Checkliste und Empfehlungen
Unternehmensteams sollten die Schema-Arbeit als eine governance-Disziplin betrachten, nicht als eine Frage der Modellierungspräferenz. Beginnen Sie mit einem klaren Geschäftsprozess, deklarieren Sie den Detaillierungsgrad (Grain), wählen Sie die Dimensionen und definieren Sie die Fakten auf diesem Detaillierungsgrad. Entscheiden Sie dann, wie Sie die Kompatibilität wahren, wie Sie Abweichungen überwachen und wer für jede Schemaänderung verantwortlich ist, wenn sich das Warehouse weiterentwickelt.
Eine funktionierende Unternehmens-Checkliste
Designphase: Beginnen Sie mit einem Sternschema, es sei denn, die Arbeitslast erfordert eindeutig eine Normalisierung oder gemeinsam genutzte Dimensionen.
Modellierungsdisziplin: Legen Sie den Detaillierungsgrad frühzeitig fest und dokumentieren Sie die Strategie für sich langsam verändernde Dimensionen für jedes beschreibende Attribut, das sich ändern kann.
Implementierung: Nutzen Sie Data Contracts, idempotente Migrationen und Versionskontrolle für Schemaänderungen.
Operative Kontrolle: Verfolgen Sie Schemata, validieren Sie Datensätze, überwachen Sie die Aktualität und erkennen Sie Anomalien in derselben Betriebsansicht.
governance: Verknüpfen Sie Änderungshistorie, Auswirkungsanalysen und Compliance-Zuordnungen mit kritischen Tabellen.
In regulierten Branchen wird das Schema selbst zum Nachweisdokument. Finanzdienstleistungen, das Gesundheitswesen, die Telekommunikation und der öffentliche Sektor müssen wissen, was sich wann geändert hat und welche nachgelagerten Systeme dies gesehen haben. Das bedeutet, dass das Warehouse nicht nur ein Berichtsmedium ist, sondern Teil des Audit-Trails.
Was zuerst standardisiert werden sollte
Der erste Standard sollte die Kompatibilität sein. Der zweite die Sichtbarkeit. Ein Schema, das sich ohne einen Prüfpfad ändert, wird letztendlich das Vertrauen zerstören, selbst wenn die Abfrageleistung gut aussieht. Ein Schema, das überwachbar, versioniert und dokumentiert ist, kann sich weiterentwickeln, ohne dass jedes Release zu einem Glücksspiel wird.
Beginnen Sie einfach und planen Sie Änderungen so, als ob das Warehouse über Jahre hinweg genutzt wird – denn das wird es.
digna bietet Funktionen für Datenqualität und Data Observability in Unternehmen, die Schemaänderungen verfolgen, Datensätze validieren, die Aktualität überwachen und Anomalien in der Umgebung des Kunden erkennen. Wenn Sie ein Warehouse aufbauen, in dem BI, ML und governance gleichermaßen auf stabilen Verträgen beruhen, besuchen Sie digna, um zu sehen, wie dieser Ansatz in Ihren Stack passt.
Häufig gestellte Fragen
Was kodiert ein Warehouse-Schema wirklich?
Bedeutung, nicht bloß die Art, wie Sie Tabellen platzieren. Es als Tabellenanordnung zu behandeln lässt eine Umbenennung oder Schlüsseländerung als kosmetisch durch das Review gehen, während sie verändert, was eine nachgelagerte Kennzahl tatsächlich zählt.
Warum kann man ein transaktionales Schema nicht wiederverwenden?
Weil beide unterschiedliche Probleme lösen. Ein transaktionales Schema optimiert korrekte Schreibvorgänge auf jeweils einen Datensatz, ein Warehouse-Schema optimiert Fragen, die über viele Datensätze gleichzeitig gestellt werden.
Wann wird der Unterschied spürbar?
Wenn eine Spalte umbenannt wird oder ein Schlüssel sich ändert. In diesem Moment sagt die Layout-Sicht, nichts sei kaputt, weil die Tabellen weiter joinen, während die Bedeutungssicht erkennt, dass sich die Zahl eines Berichts verschoben hat.
Wie unterscheiden sich Star-, Snowflake- und Galaxy-Modelle?
Darin, wie viel Struktur sie normalisieren und teilen. Ein Star hält Dimensionen flach um eine Faktentabelle, ein Snowflake normalisiert diese Dimensionen weiter, und ein Galaxy teilt konforme Dimensionen über mehrere Faktentabellen.
Was braucht Schema-Evolution, um sicher zu bleiben?
Observability am Ort der Änderung. Hinzufügungen, Entfernungen, Umbenennungen und Typänderungen gegen eine Baseline zu verfolgen gibt Produzenten und Konsumenten die Gelegenheit zur Abstimmung, bevor eine strukturelle Änderung ein Dashboard erreicht.




