Datenbankschema-Beschreibung: Ein kompletter Leitfaden für Datenteams
|
6
min. Lesezeit

Sie starren auf ein Dashboard, das gestern noch gut aussah, und dann verwandelt eine einzige umbenannte Spalte einen Routine-Ladevorgang in ein Chaos aus Nullwerten, fehlgeschlagenen Typumwandlungen und unangenehmen Slack-Nachrichten vor dem morgendlichen Standup. Das ist meistens der Moment, in dem den Leuten klar wird, dass das Datenbankschema kein Detail im Hintergrund ist, sondern das Element, das die gesamte Berichtskette zusammenhält. Eine Datenbankschemabeschreibung gibt jedem Team denselben Vertrag an die Hand, und wenn sie als lebendiges Artefakt statt als statisches Diagramm behandelt wird, macht sie den Unterschied zwischen einem kontrollierten Release und einem unbemerkt bleibenden Vorfall in der Produktionsumgebung aus.
Inhaltsverzeichnis
Warum eine Schemabeschreibung vor der ersten Abfrage wichtig ist
Best Practices für das Schreiben und Pflegen von Schemabeschreibungen
Warum eine Schemabeschreibung vor der ersten Abfrage wichtig ist
Eine schlechte Schemaänderung sieht anfangs selten dramatisch aus. Jemand benennt eine Spalte in einer Quelltabelle um, der ETL-Job läuft trotzdem weiter, und ein Dashboard für die Führungsebene öffnet sich mit leeren Feldern dort, wo gestern noch die Zahlen standen. Das ist kein isoliertes Berichtsproblem, sondern ein gebrochener Vertrag zwischen der Datenbank und den Menschen, die sie lesen.
Eine nützliche Datenbankschemabeschreibung ist die gemeinsame Referenz, die diesen Vertrag sichtbar hält. Data Engineers benötigen sie, um zu wissen, was sicher geändert werden kann. Analytics Engineers brauchen sie, damit Transformationen nicht davon ausgehen, dass eine Spalte eine Bedeutung hat, die sie nicht mehr besitzt. BI-Entwickler und Business-Analysten benötigen sie, weil der Tabellenname allein nie die ganze Geschichte erzählt.
Praktische Regel: Wenn ein Konsument von einer Spalte abhängt, gehören die Bedeutung, der Typ und die Constraints dieser Spalte in die Schemabeschreibung und nicht in das Gedächtnis von jemandem.
Der Grund, warum das wichtig ist, ist einfach. Das Schemadesign prägt Integrität, Indizierung und Abfrageverhalten IBMs Schema-Übersicht, und Schemaänderungen können sich auf nachgelagerte Berichte, Anwendungen und Pipelines auswirken, die von den Spalten oder Constraints einer Tabelle abhängen IBMs Schema-Übersicht. Aus diesem Grund steht dieses Thema im Mittelpunkt von governance und Observability, nicht nur der Datenbankmodellierung.
Es gibt drei große Ideen, die man im Hinterkopf behalten sollte. Erstens muss das Schema klar beschrieben werden. Zweitens muss diese Beschreibung in einem Format vorliegen, das Teams tatsächlich nutzen können. Drittens müssen Änderungen kontinuierlich nachverfolgt werden, da moderne Schemata nicht statisch bleiben. Organisationen fügen Spalten hinzu, passen Typen an und setzen neue Regeln durch, wenn sich die geschäftlichen Anforderungen weiterentwickeln. Genau aus diesem Grund muss die Beschreibung nah am Live-System bleiben IBMs Schema-Übersicht. Wenn Sie das richtig machen, wird das Debugging schneller, Audits werden einfacher und das Vertrauen in die Daten hängt nicht mehr von heldenhaften Einzelleistungen ab.
Was eine Datenbankschemabeschreibung tatsächlich ist
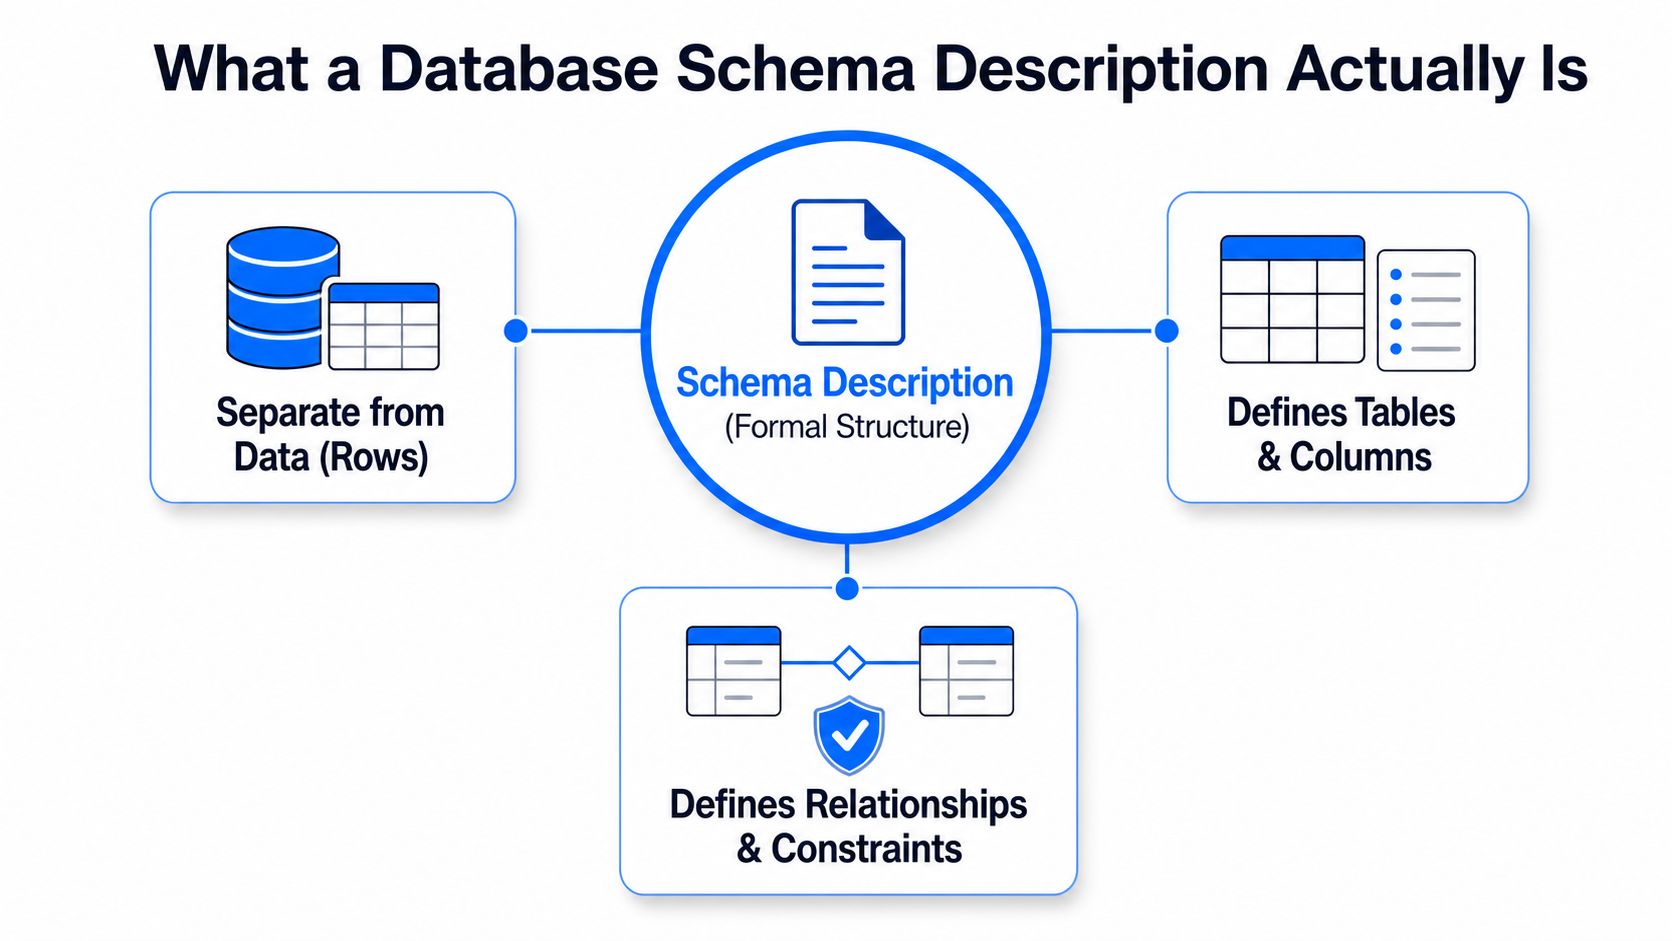
Stellen Sie sich das Schema als den Bauplan und die Zeilen als die Menschen vor, die im Gebäude wohnen. Der Bauplan verrät Ihnen, wie viele Räume es gibt, wo die Türen sind und welchen Regeln die Struktur folgt. Die Bewohner wechseln täglich, aber der Bauplan ist ein separates Objekt.
Diese Unterscheidung ist zentral für die relationale Datenbanktheorie, bei der die Struktur von der Instanz oder dem Zustand getrennt wird UPJS-Vorlesungsnotizen. Ein Datenbankschema ist die formale Beschreibung der Struktur einer Datenbank, einschließlich Tabellen, Feldern, Datentypen, Constraints und Beziehungen Purdue CS Datenbank-Terminologie. Es ist die Beschreibung des Systems, nicht der Daten selbst.
Der digna-Leitfaden für Schema-vs-Datenmodell ist nützlich, wenn Sie versuchen, die Idee der Struktur von den allgemeineren Modellierungsentscheidungen drumherum zu trennen.
What belongs in the description
Eine echte Schemabeschreibung benötigt mehr als nur Tabellennamen. Sie sollte zeigen, was die Datenbank speichert, wie Entitäten miteinander verknüpft sind und welche Werte zulässig sind. Ein Feld mit dem Typ Integer, Date oder Text ist Teil der Bedeutung des Schemas, da diese Wahl die Werte einschränkt, die die Datenbank akzeptiert Purdue CS Datenbank-Terminologie. Dasselbe gilt für Eindeutigkeit, Not-Null-Regeln und referenzielle Beziehungen.
Deshalb sind Schemaänderungen operativer und nicht kosmetischer Natur. Das Ändern eines Spaltentyps oder das Entfernen eines Constraints verändert die erwartete Struktur der Datenbank, und Anwendungen können sofort ausfallen, wenn sie sich auf den alten Vertrag verlassen Purdue CS Datenbank-Terminologie. In der Praxis bedeutet das, dass eine Schemabeschreibung wie ein technisches Artefakt gelesen werden sollte. Sie sagt Ihnen, was das System tun darf, was es ablehnen muss und wo die Joins sicher sind.
Moderne Empfehlungen spiegeln nach wie vor den relationalen Ursprung wider. Normalisierung, Primärschlüssel, Fremdschlüssel und Constraints bleiben die Standardwerkzeuge, um Konsistenz zu wahren und Abfragen vorhersehbar zu machen GeeksforGeeks Schema-Zusammenfassung. Eine Schemabeschreibung, die diese Elemente auslässt, beschreibt die Datenbank nicht wirklich. Sie beschreibt eine Vermutung.
Die grundlegenden Bausteine jeder Schemabeschreibung

Ein gutes Schemadokument beginnt mit den Substantiven des Modells. Tabellen oder Entitäten repräsentieren die Dinge, die für Sie von Bedeutung sind: Kunden, Bestellungen, Produkte, Reklamationen, Konten. Diese Namen sind wichtig, weil sie die geschäftliche Bedeutung definieren, noch bevor jemand eine einzige Abfrage liest.
Tabellen und Spalten
Spalten sind die Eigenschaften jeder Tabelle. Sie verraten Ihnen, welche Fakten über diese Entität gespeichert sind, wie zum Beispiel customer_id, created_at oder status. Bei einer guten Ausformulierung des Schemas transportieren der Tabellenname und die Spaltennamen genügend Bedeutung, dass ein neues Teammitglied die Struktur der Daten ohne Rätselraten ableiten kann.
Datentypen und Constraints
Datentypen bilden die Vertragsebene. Ein Integer-, Datums- oder Textfeld beschreibt nicht nur den Speicherplatz, sondern legt fest, was als gültige Eingabe gilt Purdue CS Datenbank-Terminologie. Constraints leisten dieselbe Arbeit auf einer noch strengeren Ebene. Regeln wie PRIMARY KEY, FOREIGN KEY, UNIQUE, NOT NULL und CHECK halten die Daten konsistent und erzwingbar.
Eine Schemabeschreibung, die Constraints ignoriert, ist nur halb fertig geschrieben.
Das ist auch der Grund, warum Schemaänderungen so schnell Probleme verursachen. Eine Typänderung kann eine Typumwandlung (Cast) beschädigen. Das Aufheben einer Not-Null-Regel kann das Anwendungsverhalten verändern. Das Entfernen eines Fremdschlüssels kann dazu führen, dass fehlerhafte Beziehungen unbemerkt in die Tabelle gelangen. Schemadetails sind keine Zierde, sie wirken sich direkt auf die nachgelagerte Zuverlässigkeit und das Änderungsmanagement aus Wikipedia-Schema-Artikel.
Beziehungen
Beziehungen sind das Bindegewebe. Eins-zu-eins-, Eins-zu-viele- und Viele-zu-viele-Verknüpfungen ermöglichen es Abfragen, Bedeutungen über Tabellen hinweg zusammenzuführen. Die historische Normalisierung hat Schemadesigner zu dieser Struktur gedrängt, da sie Redundanz reduziert und die Konsistenz wahrt GeeksforGeeks Schema-Zusammenfassung. Die Schema-Richtlinien von AWS spiegeln dasselbe Muster wider und identifizieren Entitäten, Schlüssel und Beziehungstabellen als die Mechanik eines sauberen Designs AWS-Datenbankschema-Leitfaden.
Format | Was es beschreibt | Am besten geeignet für | Wo es angesiedelt ist |
|---|---|---|---|
Tabellen | Kernentitäten und ihre Zeilen | Modellierung von Geschäftsobjekten | Datenbank-Designdokumente |
Spalten | Attribute und Felder | Definition der Datensatzstruktur | Schemadokumente und DDL |
Datentypen | Zulässige Werteformate | Validierung und Typumwandlung | DDL, Verträge, Datenspezifikationen |
Constraints | Regeln und referenzielle Integrität | Vermeidung fehlerhafter Daten | Datenbank-Engine und Migrationen |
Eine hilfreiche Methode beim Lesen einer Schemabeschreibung besteht darin, sich für jedes Element eine Frage zu stellen: Was ist es, welche Werte akzeptiert es und was hängt davon ab? Wenn Sie diese drei Fragen beantworten können, denken Sie bereits wie ein Data-Platform-Engineer.
Gängige Formate zur Darstellung einer Schemabeschreibung
Verschiedene Teams benötigen unterschiedliche Darstellungen, und der größte Fehler besteht darin, sie als austauschbar zu behandeln. DDL, ER-Diagramme, JSON-Schema sowie Avro- oder Parquet-Schemata lösen jeweils ein anderes Problem, obwohl sie alle die Struktur beschreiben.
Das Format sollte zur Zielgruppe passen
DDL ist die ausführbare Source of Truth, da die Datenbank-Engine sie erzwingt. Ein ER-Diagramm eignet sich besser für Design-Diskussionen, da man Beziehungen damit schnell erfassen kann. JSON-Schema wird bei Event-Payloads und API-Verträgen eingesetzt, während Avro- oder Parquet-Schemata in Streaming- und Analyse-Pipelines üblich sind, bei denen der Vertrag mit den Daten transportiert werden muss.
Format | Was es beschreibt | Am besten geeignet für | Wo es angesiedelt ist |
|---|---|---|---|
DDL | Tabellen, Spalten, Constraints, Indizes | Warehouses und operative Datenbanken | Migrationsdateien oder Datenbankdefinitionen |
ER-Diagramm | Entitäten und Beziehungen | Design-Reviews und Onboarding | Dokumentation und Architektur-Präsentationen |
JSON-Schema | Felder und Validierungsregeln in JSON | APIs und Event-Payloads | Anwendungscode und Vertragsdateien |
Avro- oder Parquet-Schema | Spaltenstruktur in serialisierten Daten | Streaming- und Lakehouse-Pipelines | Datendateien, Registries oder Pipeline-Konfigurationen |
Ein paar kurze Code-Snippets machen den Unterschied konkret.
CREATE TABLE customers (customer_id INT PRIMARY KEY, email TEXT NOT NULL UNIQUE);
Customer verbindet sich mit Order über Order_Item, wenn es sich um eine Viele-zu-viele-Beziehung handelt.
{"type":"object","properties":{"email":{"type":"string"},"customer_id":{"type":"integer"}}}
message Customer { required int32 customer_id; required string email; }
Die praktische Entscheidung ist unkompliziert. Nutzen Sie DDL, wenn das Warehouse oder die Datenbank den Vertrag erzwingen muss. Nutzen Sie ER-Diagramme, wenn Menschen das Design schnell verstehen müssen. Nutzen Sie JSON-Schema oder Avro-/Parquet-Schemata, wenn der Vertrag mit Events oder Dateien transportiert werden soll. Nicht das Format ist das Ziel, sondern die Zielgruppe.
Ein konkretes Beispiel für eine Datenbankschemabeschreibung
Beginnen wir mit einem einfachen E-Commerce-Szenario: Kunden geben Bestellungen auf, Bestellungen enthalten Produkte, und eine Bestellung kann viele Produkte umfassen. Das liefert Ihnen sofort die benötigten Entitäten: Kunden, Bestellungen und Produkte.
Von den Anforderungen zu den Tabellen
Die Richtlinien von AWS besagen, dass man zuerst den Zweck und die wichtigsten Informationen identifizieren und sich dann mit Entitäten, Schlüsseln und Beziehungen befassen sollte AWS-Datenbankschema-Leitfaden. In diesem Fall benötigt jede Tabelle einen Primärschlüssel, da jede Zeile einen eindeutigen Identifikator braucht. Sie würden also die Tabellen customers, orders und products erstellen, jeweils mit eigenem Schlüssel und entsprechenden Geschäftsattributen.
Die Viele-zu-viele-Beziehung zwischen Bestellungen und Produkten erfordert eine Verknüpfungstabelle, die oft als order_items bezeichnet wird. Diese Tabelle enthält order_id, product_id und die Menge, anstatt die Produktdetails in jeder Bestellzeile zu wiederholen. Das ist Normalisierung in der Praxis – genau das Muster, das AWS als Beziehungstabelle empfiehlt, um Redundanz zu vermeiden AWS-Datenbankschema-Leitfaden.
Wenn ein Wert auf dieselbe Weise zu mehr als einer Zeile gehört, hören Sie auf, ihn zu wiederholen, und machen Sie die Beziehung zu einer eigenen Tabelle.
Ein einfacher DDL-Entwurf macht die Struktur sichtbar:
CREATE TABLE customers (customer_id INT PRIMARY KEY, email TEXT NOT NULL UNIQUE);
CREATE TABLE products (product_id INT PRIMARY KEY, sku TEXT NOT NULL UNIQUE, price DECIMAL(10,2) NOT NULL);
CREATE TABLE orders (order_id INT PRIMARY KEY, customer_id INT NOT NULL, created_at DATE NOT NULL, FOREIGN KEY (customer_id) REFERENCES customers(customer_id));
CREATE TABLE order_items (order_id INT NOT NULL, product_id INT NOT NULL, quantity INT NOT NULL, PRIMARY KEY (order_id, product_id), FOREIGN KEY (order_id) REFERENCES orders(order_id), FOREIGN KEY (product_id) REFERENCES products(product_id));
Eine JSON-Ansicht eines Datensatzes
Derselbe Kunde kann auch in einem JSON-Schema beschrieben werden, wenn der Datensatz über eine API oder einen Event-Stream übertragen wird.
{"type":"object","properties":{"customer_id":{"type":"integer"},"email":{"type":"string"},"created_at":{"type":"string","format":"date"}},"required":["customer_id","email","created_at"]}
Diese Version ersetzt nicht das Datenbankschema. Sie ergänzt es. Die Tabellenstruktur, die Constraints und der Datensatzvertrag drücken dieselbe Kernidee an verschiedenen Stellen aus. Sobald Sie dieses Beispiel sauber aufbauen können, können Sie das Muster auf fast jedes Warehouse, jeden operativen Speicher oder jeden Pipeline-Vertrag übertragen.
Wie Schema-Drift nachgelagerte Konsumenten beeinträchtigt
Eine Schemaänderung fühlt sich harmlos an, bis ein anderes Team von der alten Struktur abhängt. Eine umbenannte Spalte, eine Anpassung des Datentyps oder ein entfernter Constraint können mehrere Dinge gleichzeitig beschädigen. Die Auswirkungen zeigen sich meist in ETL-Prozessen, BI-Tools und Modelleingaben, noch bevor jemand die Quelltabelle öffnet.
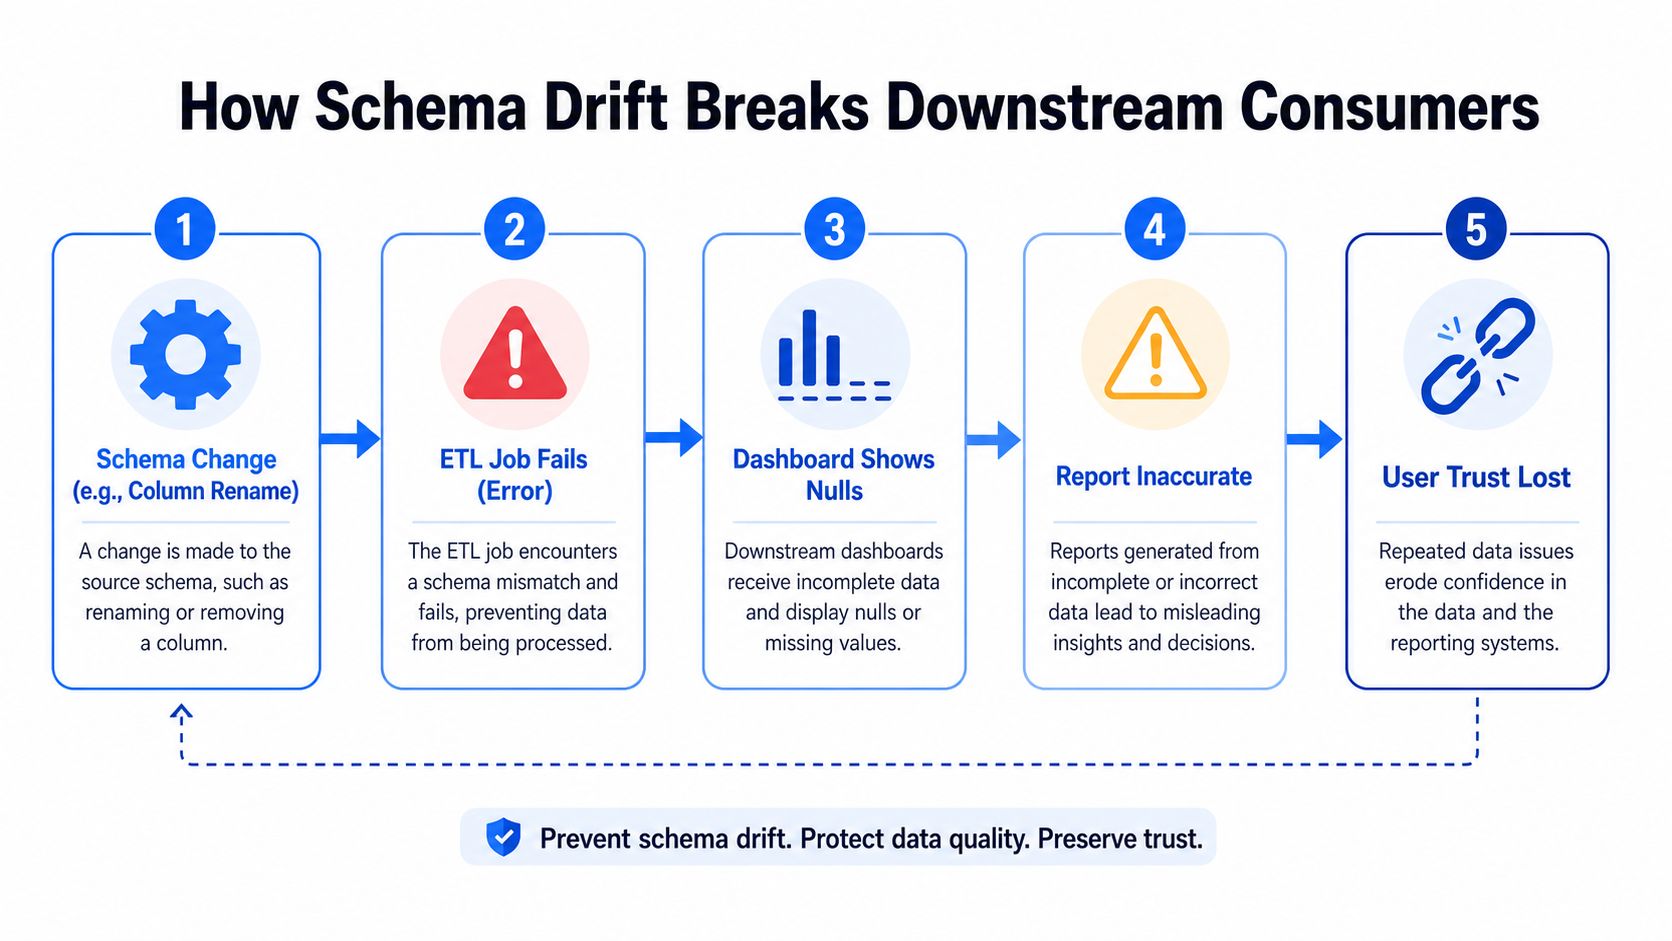
Die Fehlerkette
Eine Quellspalte wird von status in order_status umbenannt. Der ETL-Job, der mit * selektiert hat, liefert nun die falsche Spaltenreihenfolge oder bricht komplett ab. Die semantische BI-Ebene sucht weiterhin nach dem alten Feldnamen, sodass Dashboards leere Felder anzeigen. Ein dbt-Modell, das die Spalte umwandelt, kann einen Fehler ausgeben, und ein nachgelagertes Machine-Learning-Modell liest möglicherweise eine andere Verteilung ein als die, mit der es trainiert wurde, ohne dass ein Alarm ausgelöst wird.
Aus diesem Grund gibt es die Schema-Nachverfolgung. Teams achten auf hinzugefügte oder entfernte Spalten, Datentypänderungen und Constraint-Drift, da dies die strukturellen Abweichungen sind, die am ehesten zu Fehlern bei Konsumenten führen (Wikipedia-Schema-Artikel). Es geht nicht nur darum, Änderungen zu erkennen, sondern sie zu erkennen, bevor es die Geschäftsanwender tun.
Wo das Monitoring ansetzt
Operative Tools sind wichtig. Die Dokumentationslücke zwischen Schemadiagrammen und lebenden Systemen ist real, und Schema-Nachverfolgung schließt einen Teil davon, indem sie strukturelle Änderungen mit der Reaktion auf Vorfälle, Validierungen und Aktualitätsprüfungen verknüpft. Der Schema Tracker von digna ist ein Beispiel für ein Tool in dieser Kategorie. Er eignet sich, wenn ein Team eine kontinuierliche Erkennung von Strukturänderungen wünscht, anstatt sich auf manuelle Audits zu verlassen.
Schema-Drift und fehlerhafte Pipelines ist genau das Fehlerszenario, das viele Teams in der Praxis erleben.
Ein gesundes Observability-Setup behandelt das Schema als Teil der zu überwachenden Oberfläche. Wenn sich die Struktur ändert, sollte der Pipeline-Eigentümer dies sofort wissen, der BI-Eigentümer sollte wissen, welche Felder betroffen sind, und der Analyst sollte wissen, ob dem Bericht von gestern noch vertraut werden kann. Das ist kein zusätzlicher bürokratischer Aufwand. Es ist das Minimum, das erforderlich ist, um zu verhindern, dass Datenkonsumenten Fehler erst im Nachhinein entdecken.
Best Practices für das Schreiben und Pflegen von Schemabeschreibungen
Eine Schemabeschreibung wird dann nützlich, wenn sie wie ein aktives Arbeitsmittel gelesen wird und nicht wie ein einmaliger Entwurf. Das beginnt bei der Namensgebung. Tabellen- und Spaltennamen sollten eine geschäftliche Bedeutung transportieren, da ein guter Name den Kontext reduziert, den jemand benötigt, bevor er die Daten nutzen kann.
Sorgen Sie dafür, dass das Dokument die Daten erklärt
Spaltenkommentare sind wichtiger, als viele Teams denken. Ein Kommentar kann einem neuen Analysten verraten, ob status den Zahlungsstatus, den Versandstatus oder den Kontostatus meint. Ein Data Dictionary oder eine Katalogansicht sollte diese Beschreibungen direkt neben den Daten anzeigen, damit man nicht in Slack oder Tickets nach der Bedeutung eines Feldes suchen muss.
Praktische Regel: Jede Spalte, die missverstanden werden könnte, sollte einen Kommentar oder einen Dictionary-Eintrag haben, der die Bedeutung eindeutig erklärt.
Änderungen wie Code nachverfolgen
Änderungsprotokolle für das Schema sollten den Autor, den Reviewer, die Begründung und den Zeitstempel für jede Änderung festhalten. Sechs Monate später ist dieser Verlauf die einzige verlässliche Möglichkeit zu rekonstruieren, warum sich ein Feldtyp geändert hat oder warum ein Constraint entfernt wurde. Die Versionierung von DDL oder Migrationsskripten bietet diese Nachvollziehbarkeit und macht den Review-Prozess zu einem festen Bestandteil des normalen Release-Pfads.
Einige Ergänzungen werden oft ausgelassen, sind aber eine Dokumentation wert:
Beispielabfragen: Zeigen Sie, wie das Schema verknüpft oder gefiltert werden soll.
Sicherheitshinweise: Halten Sie fest, wer sensible Felder lesen darf und was eingeschränkt bleiben muss.
Verknüpfungen zu vorgelagerten Prozessen: Verbinden Sie das Schema mit dem Geschäftsworkflow, der die Daten erzeugt.
Zuständigkeit: Nennen Sie das Team, das für die Genehmigung zukünftiger Änderungen verantwortlich ist.
Die Dokumentation nah am System halten
Dokumentation veraltet schnell, wenn sie weit entfernt vom Code existiert. Der sicherere Weg ist, die Schemabeschreibung in der Nähe der DDL, der Migrationen und des Datenkatalog-Eintrags aufzubewahren, der die Tabelle beschreibt. Auf diese Weise durchlaufen strukturelle Änderungen denselben Review-Pfad wie Codeänderungen. Das Ergebnis ist einfacher für die Rufbereitschaft, erleichtert Audits und ist beim Onboarding weitaus weniger fehleranfällig.
Aufbau eines Dokumentations- und Tracking-Workflows
Ein guter Workflow macht die Schemabeschreibung zu einem Betriebssystem für Veränderungen. Beginnen Sie mit versionierter DDL oder Migrationen als kanonischer Definition und machen Sie das Schema-Review zu einem festen Bestandteil desselben Prozesses, den Sie bereits für Code-Reviews nutzen. Dadurch erhält jede strukturelle Änderung einen sichtbaren Verlauf, bevor sie in der Produktion landet.
Den Kreis mit Observability schließen
Sobald die Definition in der Versionsverwaltung liegt, besteht die nächste Herausforderung im Drift. Schema-Nachverfolgung, Validierung und Aktualitätsüberwachung fangen die unbeabsichtigten Änderungen ab, die ein Code-Review nach dem Deployment nicht sehen kann. An diesem Punkt wird Data Observability operativ, da das System das, was Sie beabsichtigt haben, mit dem vergleichen muss, was im Warehouse oder in der Pipeline tatsächlich existiert.
Die Plattform von digna kombiniert Module für Schema Tracker, Validierung, Aktualität, Anomalien und andere Monitoring-Anforderungen innerhalb der eigenen Umgebung des Kunden. Der Schema-Teil ist hier wichtig, da er kontinuierlich auf strukturelle Änderungen prüft, während der Rest des Stacks überwacht, ob sich die Daten weiterhin wie erwartet verhalten. Wenn Ihr Team einen zentralen Ort benötigt, um einen Schemavertrag zusammen mit anderen Zuverlässigkeitssignalen zu überwachen, ist dies die Rolle, die eine solche Plattform ausfüllt.
Den Workflow wiederholbar machen
Halten Sie den Kreislauf so einfach, dass die Leute ihn auch tatsächlich nutzen.
Wählen Sie ein kanonisches Format. Nutzen Sie DDL oder eine andere maßgebliche Definition, damit jeder weiß, wo die Wahrheit liegt.
Dokumentieren Sie mit Absicht. Fügen Sie Kommentare, Zuständigkeiten und geschäftlichen Kontext hinzu, anstatt das Schema nur als eine Liste von Spalten zu behandeln.
Verfolgen Sie Änderungen wie Code. Verlangen Sie für jedes strukturelle Update ein Review, einen Verlauf und eine Begründung.
Überwachen Sie das Live-System. Vergleichen Sie das erwartete Schema mit dem beobachteten Schema und schlagen Sie bei Abweichungen Alarm.
Die wichtigste Erkenntnis liegt auf der Hand. Eine Schemabeschreibung ist kein Diagramm, das man einmal fertigstellt und dann abheftet. Sie ist gleichzeitig ein Vertrag, ein Design-Artefakt und ein Monitoring-Ziel. Wenn diese drei Rollen miteinander verknüpft bleiben, fällt es leichter, dem Warehouse zu vertrauen und Fehler darin zu beheben.
Wenn Sie nach einer praktischen Möglichkeit suchen, Schemabeschreibungen, Drift-Erkennung, Validierung und Aktualitätsprüfungen in einem einzigen operativen Kreislauf zu bündeln, besuchen Sie digna und sehen Sie, wie sich die Plattform in Ihre Warehouses und Pipelines einfügt. Sie wurde für Teams entwickelt, die sicherstellen wollen, dass das von ihnen dokumentierte Schema mit dem Schema übereinstimmt, das ihre Konsumenten lesen.
Häufig gestellte Fragen
Was ist eine Datenbankschema-Beschreibung?
Eine Datenbankschema-Beschreibung ist die formale Beschreibung der Struktur einer Datenbank: Tabellen, Felder, Datentypen, Constraints und Beziehungen. Sie beschreibt das System, nicht die Daten selbst, so wie sich ein Bauplan von den Menschen unterscheidet, die im Gebäude wohnen. Teams nutzen sie als gemeinsamen Vertrag darüber, was die Datenbank akzeptiert.
Was sollte eine Datenbankschema-Beschreibung enthalten?
Neben Tabellennamen sollte sie Spalten, Datentypen, Constraints wie PRIMARY KEY, FOREIGN KEY, UNIQUE, NOT NULL und CHECK sowie die Beziehungen zwischen Tabellen abdecken. Der Leitfaden empfiehlt außerdem Spaltenkommentare, Beispielabfragen, Sicherheitshinweise, Verweise auf vorgelagerte Prozesse und einen benannten Verantwortlichen, der künftige Änderungen freigibt.
Welches Format eignet sich zur Dokumentation eines Datenbankschemas?
Wählen Sie das Format passend zur Zielgruppe. DDL ist die ausführbare Source of Truth, weil die Datenbank-Engine sie durchsetzt, ER-Diagramme eignen sich für Designgespräche, und JSON Schema, Avro- oder Parquet-Schemas passen zu Verträgen, die mit Events, API-Payloads oder Dateien durch Streaming- und Analyse-Pipelines wandern.
Wie bringt Schema Drift Dashboards und Pipelines zum Scheitern?
Eine einzige strukturelle Änderung kann eine Kettenreaktion auslösen. Im Beispiel des Artikels führt die Umbenennung von status in order_status dazu, dass ein ETL-Job mit select * fehlschlägt oder Felder vertauscht, die BI-Schicht Lücken zeigt, ein dbt-Cast einen Fehler wirft und ein nachgelagertes ML-Modell unbemerkt eine andere Verteilung erhält.
Wie halten Sie eine Schema-Beschreibung aktuell?
Behandeln Sie sie wie Code. Nutzen Sie versioniertes DDL oder Migrationen als kanonische Definition, dokumentieren Sie Autor, Reviewer, Begründung und Zeitstempel jeder Änderung und legen Sie die Dokumentation nahe an DDL und Katalogeintrag ab. Überwachen Sie dann das Live-System, vergleichen Sie erwartetes mit beobachtetem Schema und alarmieren Sie bei Drift.


