Qualitätsdatenanalyse: Ein praktischer Leitfaden für moderne Teams
|
8
min. Lesezeit

Sie öffnen ein Monday-Dashboard und die Zahl oben rechts stimmt nicht mit dem überein, was die Finanzabteilung erwartet hat. Niemand kann sagen, ob das Problem gestern Abend, letzte Woche oder vor zwei Pipeline-Änderungen begann. Das ist der Moment, in dem die Qualitätsdatenanalyse aufhört, eine abstrakte Best Practice zu sein, und zu einer praktischen Überlebensfähigkeit wird. Denn die Aufgabe besteht nicht nur darin, Daten zu bereinigen, nachdem sie fehlerhaft geworden sind. Es geht darum, schleichende Datenprobleme frühzeitig sichtbar zu machen, sie mit statistischer Disziplin zu messen und zu verhindern, dass sie überhaupt erst die Entscheidungsfindung beeinflussen.
Inhaltsverzeichnis
Wie verschiedene Branchen die Qualitätsdatenanalyse anwenden
Fallstricke und Blickwinkel, die die meisten Leitfäden übersehen
Wenn Ihr Dashboard aufhört, die Wahrheit zu sagen
Ein defektes Dashboard sieht normalerweise nicht defekt aus. Es lädt immer noch, die Diagramme werden weiterhin gerendert und die KPI-Namen klingen immer noch vertraut. Das Problem liegt tiefer: Die zugrunde liegenden Datensätze sind möglicherweise veraltet, dupliziert, unvollständig oder inkonsistent, sodass der Bericht zu einer geschönten Version der falschen Geschichte wird.
Deshalb ist eine Qualitätsdatenanalyse so wichtig. Schlechte Datenqualität ist kein kosmetisches Problem, sondern ein operatives Risiko, das Entscheidungen verfälschen kann, noch bevor jemand bemerkt, dass das Diagramm nicht stimmt. Von Gartner im Jahr 2023 zitierte Schätzungen beziffern die durchschnittlichen jährlichen Kosten durch schlechte Datenqualität auf 12,9 Millionen US-Dollar pro Unternehmen, und eine Untersuchung von IBM aus dem Jahr 2022 zu den Kosten schlechter Datenqualität ergab, dass Ungenauigkeiten bei Großunternehmen zu etwa 25 % Umsatzverlust durch Fehlentscheidungen führen können. Diese Zahlen haben die Diskussion von „Bitte bereinigt die Daten“ hin zu „Dies erfordert kontinuierliche Beobachtung und Kontrolle“ verändert (Gitnux data quality statistics).
Viele Teams behandeln Datenqualität immer noch wie eine Aufräumaktion auf den letzten Metern. Sie führen vor der Veröffentlichung eines Berichts eine Bereinigung durch und hoffen dann, dass das Problem nicht wieder auftritt. Dieses Modell scheitert, weil der Fehler meist weiter oben im Prozess beginnt – bei der Datenaufnahme, bei Transformationen, durch Schema-Drift oder verzögerte Feeds, lange bevor jemand das Diagramm sieht. Eine Regel auf Feldebene in einem Formular, wie die im Formcarry-Leitfaden zur Formularvalidierung gezeigten Prüfungen, fängt nur eine Ebene des Problems ab. Die umfassendere Disziplin beobachtet, wie sich diese Eingaben verhalten, nachdem sie in die Pipeline gelangt sind – genau wie ein Mechaniker auf ein neues Geräusch achtet, wenn der Motor bereits läuft.
Praktische Regel: Wenn sich eine Metrik ohne sichtbaren Fehler ändern kann, erfordert sie eine kontinuierliche Überwachung und kein einmaliges Audit.
Die moderne Disziplin kombiniert klassische deskriptive Statistik mit automatisierter Anomalieerkennung und dem Lernen von Baselines, sodass Teams ungewöhnliches Verhalten in großen Datensätzen kontinuierlich erkennen können, anstatt sich auf periodische manuelle Prüfungen zu verlassen. Sie funktioniert auch dann am besten, wenn die Prüfungen nah an den Daten bleiben, beispielsweise durch In-Database-Profiling, das verhindert, dass riesige Tabellen in ein separates Tool gezogen werden müssen. Das ist das Versprechen hier: unsichtbare Fehler in messbare Abweichungen und schließlich in Maßnahmen umzuwandeln und gleichzeitig einen sensiblen Datenfluss mit einem praktischen Framework wie dem in diesem Leitfaden für Datenqualitätsdimensionen beschriebenen genau im Auge zu behalten.
Qualitätsdatenanalyse ohne Fachjargon definiert
Ein guter Vergleich ist die Lebensmittelsicherheit. Eine Küche verdient Vertrauen nicht dadurch, dass sie die Inspektion einmal bestanden hat. Sie verdient Vertrauen, weil Temperatur, Herkunft, Hygiene und Frische immer wieder kontrolliert werden, sodass das Essen sicher bleibt, selbst wenn das Personal wechselt oder das Arbeitsvolumen steigt.
Die Qualitätsdatenanalyse funktioniert genauso. Sie ist kein einmaliges Audit und keine Checkliste zur Bereinigung. Sie ist der fortlaufende Prozess der Messung, ob Daten noch Vertrauen verdienen, während sie sich durch Systeme bewegen, ihre Form verändern und in Entscheidungen einfließen.
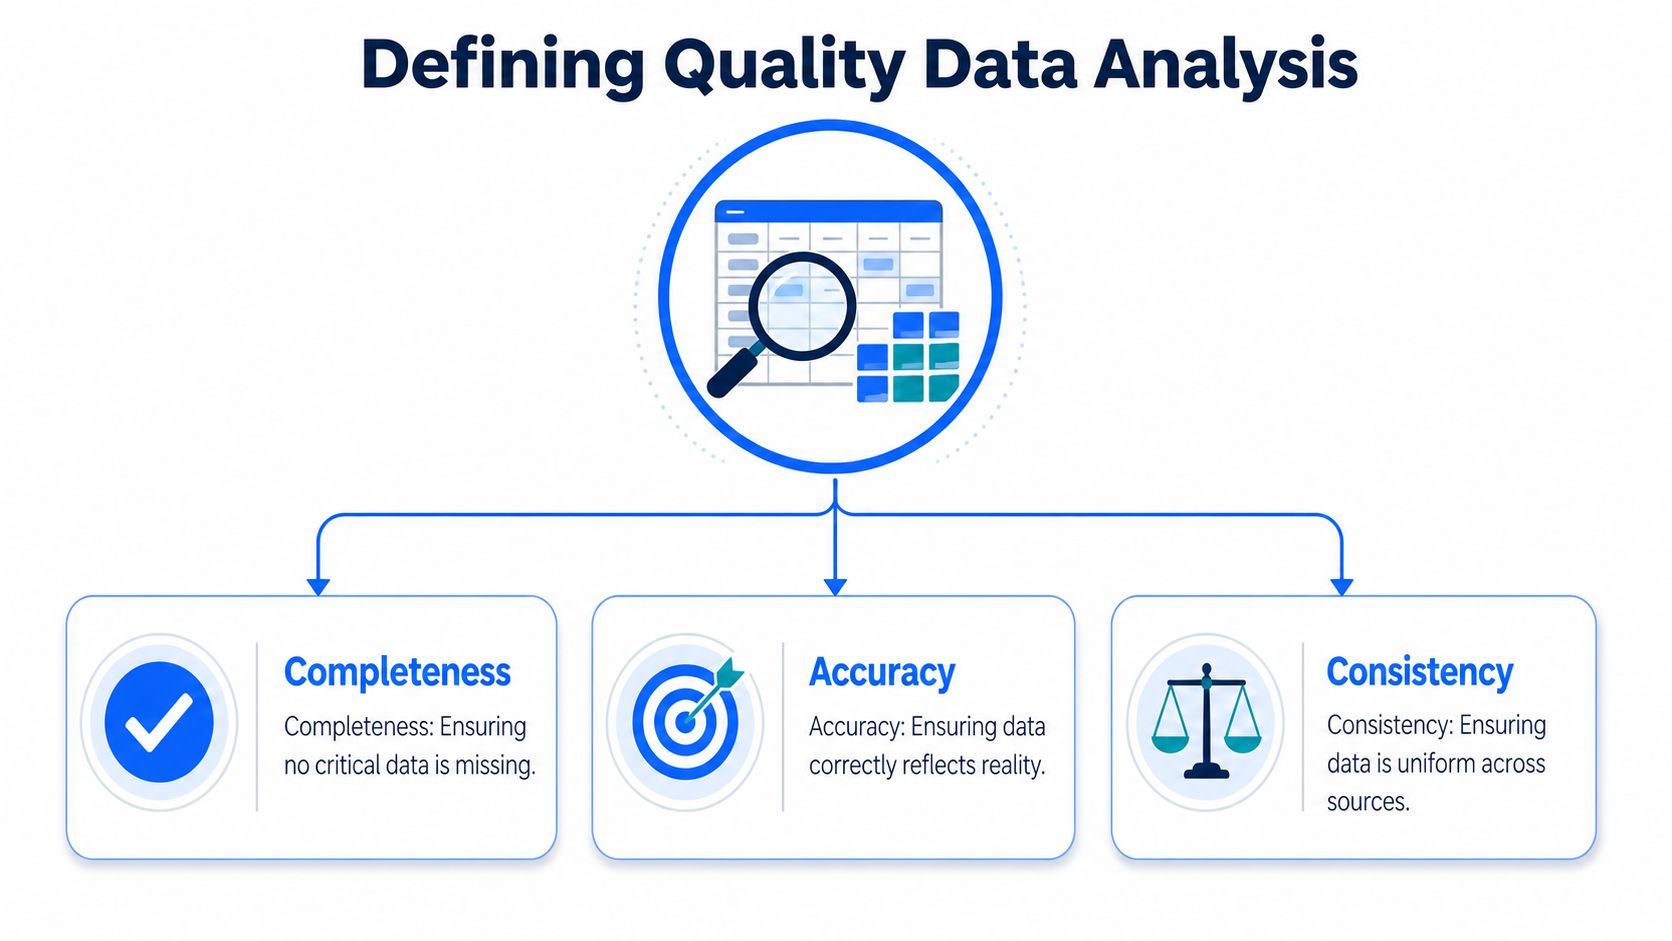
Die formale Seite davon ist breiter gefächert, als viele erwarten. Das statistische Qualitäts-Framework des IWF identifiziert sechs Dimensionen: Relevanz, Genauigkeit, Aktualität, Zugänglichkeit, Interpretierbarkeit und Kohärenz (IMF statistical quality framework). Die operative Definition von IBM erweitert dieses Bild um Genauigkeit, Vollständigkeit, Gültigkeit, Konsistenz, Eindeutigkeit, Aktualität und Eignung für den Zweck (IBM data quality). Die Kernidee ist einfach: Ein Datensatz kann technisch vorhanden und dennoch nicht für die Frage geeignet sein, die Sie stellen.
Was sie nicht ist
Es ist nicht nur Datenbereinigung, denn das Bereinigen entfernt zwar bekannte Fehler, sagt Ihnen aber nicht, wenn sich die Fehlerquote ändert. Es ist kein Dashboard, denn Dashboards fassen den Zustand zusammen, erklären aber nicht, ob die Eingangsdaten vertrauenswürdig sind. Es ist kein einzelner „Quality Score“, da eine einzige Kennzahl viele verschiedene Fehlerarten verbergen kann.
Denken Sie an eine Tabelle, die keine Nullwerte enthält, deren Zeitstempel jedoch drei Tage alt sind. Oder an einen Datensatz, der zwar aktuell ist, bei dem aber eine Geschäftseinheit einen anderen Kategoriecode verwendet als der Rest des Unternehmens. In beiden Fällen sehen die Zahlen zwar ordentlich aus, die Analyse ist aber dennoch unzuverlässig.
Der Datenanalyse-Workflow von Coursera platziert Bereinigung, Ausreißerprüfung und Interpretation innerhalb des umfassenderen Analyseprozesses und nicht als nachträglichen Gedanken (Coursera data analysis guide). Diese Abfolge ist wichtig, da Qualitätsprüfungen dorthin gehören, wo Daten erfasst, transformiert und interpretiert werden, und nicht erst dort, wo sie visualisiert werden.
Die Kerndimensionen, die Daten vertrauenswürdig machen
Die Dimensionen lassen sich leichter merken, wenn man sie mit konkreten Fehlerfällen verknüpft. Jede Dimension beantwortet eine andere Frage, und jede kann fehlschlagen, während die anderen in Ordnung scheinen. Deshalb sagt eine einzige Prozentangabe zur Vollständigkeit nicht viel aus.
Ein praktischer Vergleich
Dimension | Bedeutung | Beispiel für Fehler | Zu überwachende Metrik |
|---|---|---|---|
Genauigkeit | Werte entsprechen der Realität | Ein Kundenstatus wird nach der Kündigung als aktiv markiert | Fehlerquote im Vergleich zu einer vertrauenswürdigen Referenz |
Vollständigkeit | Erwartete Daten sind vorhanden | Erforderliche Adressfelder sind leer | Nullwert-Rate oder Rate fehlender Felder |
Konsistenz | Derselbe Fakt stimmt über Tabellen hinweg überein | Umsatz unterscheidet sich zwischen Finanz- und BI-Modellen | Abweichungsrate zwischen Tabellen |
Eindeutigkeit | Datensätze sind nicht dupliziert | Dieselbe Bestellung erscheint nach der erneuten Verarbeitung doppelt | Duplikatsrate |
Gültigkeit | Werte folgen Regeln und Formaten | Ein Datumsfeld enthält Text | Regelverletzungsrate |
Aktualität | Daten kommen an, wenn sie benötigt werden | Ein täglicher Feed trifft erst nach Redaktionsschluss des Berichts ein | Verzögerung bei der Datenaufnahme oder Stunden seit der Aktualisierung |
Eignung für den Zweck | Daten beantworten die geschäftliche Frage | Dem Datensatz fehlt die Region, die das Team benötigt | Abdeckung im Vergleich zum Entscheidungsumfang |
Genauigkeit ist am einfachsten zu erklären, aber oft am schwersten zu überprüfen. Eine Zahl kann korrekt formatiert und im geschäftlichen Sinne dennoch falsch sein. Deshalb vergleichen Qualitätsteams Daten mit Quellsystemen, Referenztabellen oder Abgleichslogiken, anstatt davon auszugehen, dass syntaktische Gültigkeit gleichbedeutend mit Wahrheit ist.
Vollständigkeit fällt sofort ins Auge, kann aber für sich allein genommen irreführend sein. Eine Tabelle ohne Nullwerte kann dennoch ein ganzes Kundensegment ausschließen, wenn die Ladelogik eine Spalte verworfen oder eine Region herausgefiltert hat. Die Aktualität birgt dieselbe Falle, denn frische Daten können dennoch unbrauchbar sein, wenn sie mit dem falschen Inhalt geliefert wurden.
Konsistenz und Eindeutigkeit zeigen sich meist, wenn Systeme zusammengeführt werden. Wenn ein Finanz-Warehouse und ein Reporting-Mart nicht übereinstimmen, muss jemand entscheiden, welche Quelle maßgebend ist. Wenn sich Duplikate einschleichen, sieht das Diagramm vielleicht immer noch fehlerfrei aus, während die Summen ohne offensichtlichen Fehler nach oben driften.
Gültigkeit ist der Bereich, in dem Geschäftsregeln eine Rolle spielen. Der Formcarry-Leitfaden für Feldvalidierungen ist ein nützliches externes Beispiel dafür, wie Systeme erforderliche Formate und Eingaben erzwingen können, bevor sich fehlerhafte Datensätze weiter verbreiten. In der Analytik gilt dieselbe Logik für Postleitzahlen, Statuswerte, Wertebereiche und Datumseinschränkungen.
Eine nützliche Angewohnheit: Überwachen Sie die Dimension, die für die Entscheidung am wichtigsten ist, und behalten Sie die anderen im Auge, damit Sie nicht eine Art von Vertrauen optimieren, während Sie eine andere zerstören.
Die Eignung für den Zweck ist die letzte Prüfung, und sie wird von vielen Teams ausgelassen. Ein Datensatz kann genau, vollständig und konsistent sein und dennoch unbrauchbar sein, wenn er nicht den geschäftlichen Ausschnitt enthält, von dem die Frage abhängt. Hier fügt sich das interne Framework in dignas Übersicht zu Datenqualitätsdimensionen gut in das Governance-Denken ein.
Methoden und Workflows zur Durchführung der Analyse
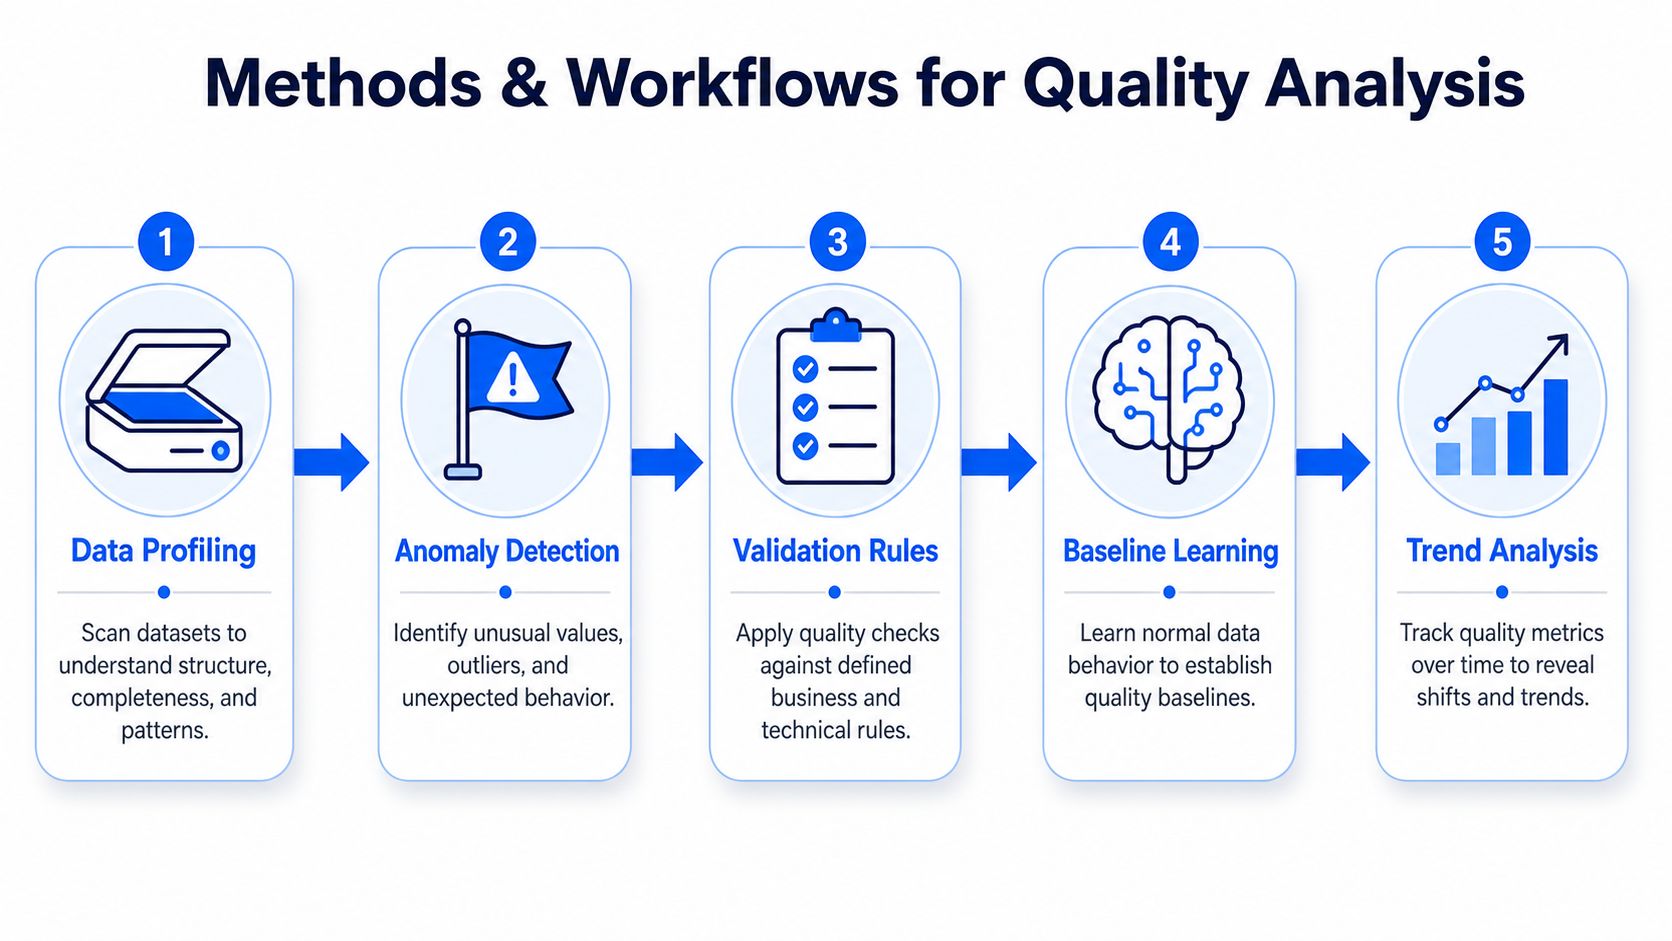
Eine Qualitätsprüfung beginnt in der Regel in dem Moment, in dem die Daten eintreffen, und nicht erst, wenn das Dashboard ausfällt. Eine Methode erkennt fehlende Daten, eine andere fängt Drift ab und eine dritte identifiziert Werte, die zwar eine Regel bestehen, im Kontext aber dennoch falsch aussehen. Die Arbeit ähnelt eher einer medizinischen Triage als einer einmaligen Bereinigung, da jede Prüfung eine andere Frage zum selben Datensatz beantwortet.
Beginnen Sie mit dem Profiling
Profiling beantwortet eine einfache Frage: Wie sieht der Normalzustand hier aus? Teams nutzen Mittelwert, Median, Modus, Standardabweichung, Varianz und Spannweite, um Verteilungen zusammenzufassen, Schiefe zu erkennen und Streuungen zu verstehen. Dies liefert ihnen eine Baseline, bevor sie entscheiden, was Aufmerksamkeit erfordert. Ein guter Ausgangspunkt sind Datenprofilierungs-Techniken, da es darum geht, die Form der Daten kennenzulernen, bevor man Annahmen in Prüfregeln gießt.
Ein neues Teammitglied erwartet oft, dass Profiling ein einmaliger Bericht ist. Es funktioniert jedoch eher wie der Blick auf das Armaturenbrett vor jeder Schicht. Wenn Bestellwerte über Wochen stabil waren und sich eine Spalte plötzlich mit Nullen füllt, verdient diese Änderung eine Überprüfung, selbst wenn keine explizite Regel verletzt wurde.
Fügen Sie Anomalieerkennung und Regeln hinzu
Anomalieerkennung funktioniert am besten, wenn sie aktuelle Datensätze mit der Historie des Datensatzes selbst vergleicht. Z-Scores und Interquartilsabstand-Regeln helfen dabei, Werte zu markieren, die weit außerhalb des normalen Bereichs liegen. Dies ist nützlich für Ausreißer, ungewöhnliche Spitzen und Datensätze, die manuell überprüft werden sollten.
Die deterministische Validierung spielt eine andere Rolle. Sie prüft die Logik auf Zeilenebene, wie z. B. Pflichtfelder, zulässige Werte und Abhängigkeiten zwischen Feldern. Wird die Regel verletzt, schlägt der Datensatz fehl und die Entscheidung erfolgt sofort.
Leitfäden für Qualitätsanalysen empfehlen außerdem, Trendanalysen mit Validierungen zu kombinieren, damit Teams fehlende Felder, Werte außerhalb des zulässigen Bereichs und Lieferverzögerungen frühzeitig in der Pipeline abfangen können (Skymes-Qualitätsanalysen). Diese Kombination ist wichtig, da sich ein Defekt, der sich langsam wiederholt, an starren Regeln vorbeimogeln kann, während er dennoch die Struktur der Daten verändert. Eine Berichtstabelle kann technisch gültig bleiben, während sie sich stetig von den Werten entfernt, die die Nutzer zu lesen glauben.
Lernen Sie die Baseline kennen und beobachten Sie dann den Trend
Das Erlernen von Baselines ersetzt statische Schwellenwerte durch Verhaltensmodelle, die sich an jeden Datensatz anpassen. Anstatt zu fragen, ob ein Zähler über einer willkürlichen Linie liegt, fragt das System, ob das heutige Verhalten vom normalen Muster dieser Tabelle abweicht. Das passt gut zu operativen Daten, da ein Feed naturgemäß schwanken kann, während ein anderer stabil und vorhersehbar bleibt.
Eine Trendanalyse fängt auf, was eine einzelne Warnung übersieht. Ein Feld überschreitet vielleicht nie einen harten Grenzwert, aber wenn der Anteil fehlender Daten eine Woche lang ansteigt, driftet das nachgelagerte Dashboard dennoch ab. Die historische Trendanalyse ist auch ein Kernbestandteil des Datenanalyse-Moduls von digna, das übergeordnete Statistiken wie Trend und Volatilität aus den Kerndatenmetriken berechnet, sodass Teams die Überwachung in ihrer eigenen Umgebung fortführen können, ohne die Daten an andere Orte verschieben zu müssen.
Skalierbare Implementierungsmuster
Die erste Frage bei der Bereitstellung betrifft meist den Ort. Wo sollen die Prüfungen laufen und wie viele Daten müssen dafür verschoben werden? Diese Wahl beeinflusst Latenz, Governance, Kosten und wie schnell ein Team reagieren kann, wenn sich etwas ändert. Sie entscheidet auch darüber, ob die Qualitätsdatenanalyse eine lebendige Kontrolle innerhalb der Pipeline bleibt oder zu einer separaten Aufgabe wird, die zu spät inspiziert wird.
Vier Muster, die Teams nutzen
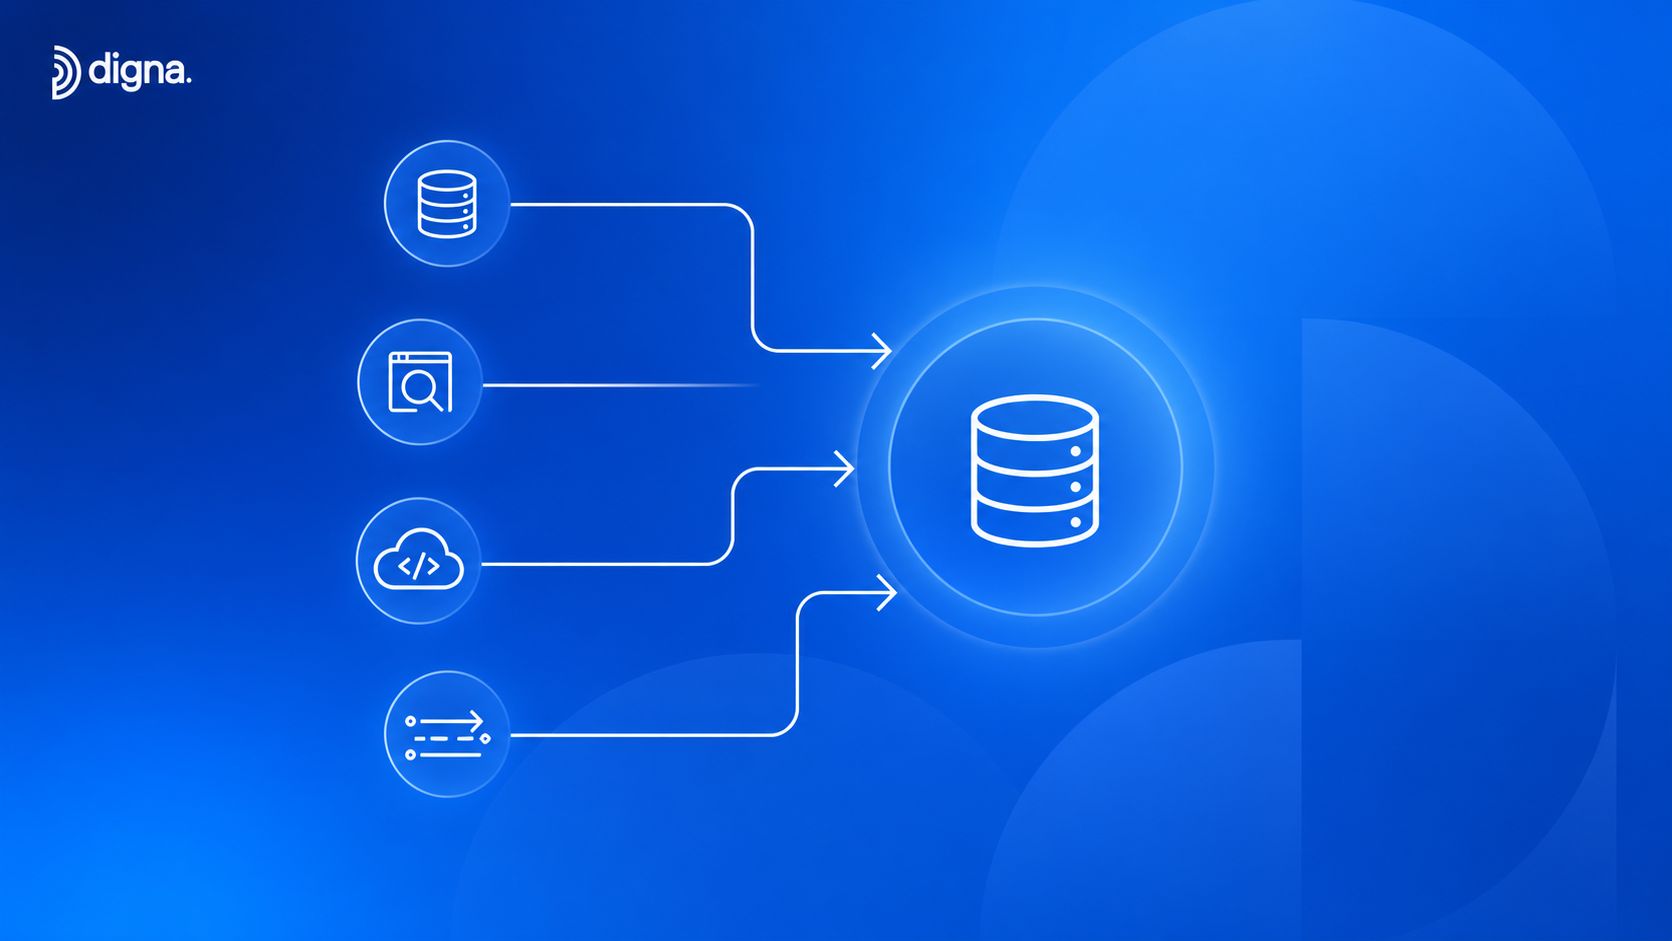
In-Database-Analysen führen Prüfungen dort aus, wo die Daten bereits liegen. Das minimiert Datenbewegungen und entspricht den Sicherheitsanforderungen, da die Daten an Ort und Stelle bleiben, während Metriken berechnet werden. Dies eignet sich auch gut für das statistische Profiling, bei dem Sie Verteilungen, fehlende Werte und Drift anhand der tatsächlichen Tabelle und nicht anhand einer kopierten Stichprobe messen möchten.
Externe Scan-Dienste kopieren oder streamen Stichproben in eine separate Umgebung. Das kann für eine schnelle Inspektion nützlich sein, erhöht jedoch die Datenbewegung, führt zu Duplikaten und schafft einen weiteren Ort, an den sensible Daten gelangen können. Eine kopierte Stichprobe kann einem Team helfen, offensichtliche Probleme zu erkennen, kann aber auch subtile Verschiebungen verbergen, die sich nur an der Quelle zeigen.
Pipeline-native Prüfungen leben im ETL- oder Transformationscode. Sie lassen sich leicht an einen bestimmten Job anhängen, was den Fehlerpfad eindeutig macht, können jedoch instabil werden, wenn jedes Team seine eigenen Regeln ohne gemeinsame Baselines schreibt. In der Praxis funktioniert dieses Muster am besten, wenn die Prüfungen klein, explizit und eng an die Transformation gekoppelt sind, die sie schützen.
Observability-Plattformen kombinieren Validierung, Anomalieerkennung, Schema-Tracking und Alarmierung in einer Schicht. Sie eignen sich am besten für eine kontinuierliche Überwachung, da sie Regeln, Baselines und Vorfallbehandlung miteinander verknüpfen. Für Teams, die diesen Weg einschlagen, zeigt der in Dignas Datenqualitäts-Implementierungsleitfaden beschriebene Ansatz, wie diese Komponenten in der Kundenumgebung verbleiben können, anstatt sich über separate Tools zu verteilen.
Wie man die richtige Wahl trifft
Wenn Ihre Priorität auf geringer Latenz und strenger Governance liegt, gewinnt meist die In-Database-Ausführung. Wenn Ihr Team eine leichtgewichtige Inspektion für einen kleinen Datenausschnitt benötigt, kann ein externer Scan ausreichen. Wenn Sie eine Durchsetzung nahe an der Transformationslogik wünschen, sind Pipeline-native Prüfungen sinnvoll. Wenn Sie einen zentralen Ort benötigen, um Vorfälle, Trends und Status über viele Datensätze hinweg zu sehen, ist eine Observability-Plattform einfacher zu betreiben.
Operativer Rat: Wählen Sie das Muster, das zuerst Ihrer größten Einschränkung gerecht wird, und nicht dasjenige, das in einer Demo am einfachsten aussieht.
Auch die Alarmierung ist wichtig. Wächter für Schemaänderungen sollten hinzugefügte oder entfernte Spalten melden, Baseline-Drift-Warnungen sollten ungewöhnliche Bewegungen aufzeigen und Eskalationspfade sollten definieren, wer was behebt. Audit-bereite Nachweise lassen sich viel einfacher erbringen, wenn das System die Zeit bis zur Erkennung, die Zeit bis zur Behebung und die genaue Regel oder Anomalie aufzeichnet, die den Vorfall ausgelöst hat. Diese Aufzeichnung hilft Teams auch zu überprüfen, ob es sich bei dem Problem um zufälliges Rauschen, einen wiederkehrenden Pipeline-Fehler oder eine breitere Verschiebung handelte, die einen anderen Schwellenwert erfordert.
digna ist ein Beispiel für eine Plattform, die um diese Ideen herum aufgebaut ist – mit In-Database-Ausführung, KI-gestütztem Baseline-Lernen, Schema-Tracking und Aktualitätsüberwachung direkt in der eigenen Umgebung des Kunden. Dieses Setup eignet sich für Teams, die kontinuierliche Prüfungen wünschen, ohne Produktionsdaten in eine separate Scanschicht abziehen zu müssen.
Wie verschiedene Branchen die Qualitätsdatenanalyse anwenden
Die gleichen Mechanismen wirken sich je nach Risikolage unterschiedlich aus. Ein Finanzteam sorgt sich um fehlerhafte regulatorische Feeds und Transaktionsintegrität. Ein Gesundheitsteam sorgt sich um die Struktur von Abrechnungen, klinische Aufzeichnungen und Aktualität. Ein Telekommunikationsteam muss hochvolumige operative Feeds schützen, ohne im Rauschen von Fehlalarmen unterzugehen. Ein Team im öffentlichen Sektor benötigt Rückverfolgbarkeit und Nachweise, die einer Prüfung standhalten.
Was sich je nach Branche ändert
Finanzdienstleistungen überwachen in der Regel zuerst Risikodaten, Transaktionsdaten und regulatorische Daten. Die praktische Priorität liegt darin, verspätete Feeds, abweichende Summen und Schemaänderungen abzufangen, bevor Berichte oder nachgelagerte Kontrollen darauf aufbauen. Die Zeit bis zur Entdeckung und die Zeit bis zur Behebung werden zu zentralen KPIs, da sich eine Verzögerung auf mehrere Prozesse gleichzeitig auswirken kann.
Das Gesundheitswesen setzt stark auf Vollständigkeit, Frische und strukturelle Stabilität in klinischen und operativen Arbeitsabläufen. Eine Schemaverschiebung bei Abrechnungsdaten oder eine fehlende Ladung in einem Patienten-Feed kann sowohl die Behandlungsanalytik als auch das Compliance-Reporting verfälschen, weshalb Teams die Regelverletzungsraten und Lieferzeiten genau im Auge behalten.
Die Telekommunikation hat es mit großen operativen Datenströmen zu tun, bei denen das Problem oft nicht in einer einzelnen schlechten Zeile liegt, sondern in einer subtilen Verschiebung des Volumens oder Formats. Schwellenwertüberschreitungen bei Verbindungsdaten und unerwartete Feldänderungen sind Probleme, die durchrutschen, wenn die Überwachung zu statisch ist.
Der öffentliche Sektor benötigt mehr als alles andere Konsistenz, Rückverfolgbarkeit und prüfbereite Nachweise. Ein Bericht mag technisch korrekt sein, aber wenn die Datenherkunft oder die Validierungshistorie nicht nachgewiesen werden kann, wird die Arbeit den Erwartungen an das öffentliche Vertrauen nicht gerecht.
Das Federal Committee on Statistical Methodology definiert Datenqualität als „den Grad, in dem Daten die gewünschten Informationen unter Verwendung einer angemessenen Methodik in einer Weise erfassen, die das Vertrauen der Öffentlichkeit stärkt“ (FCSM framework). Diese Formulierung passt auf jeden dieser Sektoren, da es nicht nur um Genauigkeit geht, sondern um die verlässliche Nutzung im jeweiligen Kontext.
In all diesen Branchen tauchen immer wieder die gleichen Kontrollmechanismen auf: Aktualitätsprüfungen, Validierung auf Datensatzebene, Schema-Tracking und Anomalieerkennung. Die geschäftliche Fragestellung ändert sich, die Disziplin bleibt dieselbe.
Fallstricke und Blickwinkel, die die meisten Leitfäden übersehen
Ein einzelner, globaler Qualitäts-Score klingt ordentlich, aber er verschleiert zu viel. Eine Gruppe kann saubere, aktuelle Daten haben, während einer anderen Gruppe Datensätze fehlen, sie unterrepräsentiert ist oder von einer stillschweigenden Schemaänderung betroffen ist. Der Durchschnitt sieht gut aus, und dennoch führt die Entscheidung zu Ungerechtigkeiten.
Warum Subgruppenprüfungen wichtig sind
Leitfäden für das öffentliche Gesundheitswesen und die Politik betonen die Notwendigkeit von Prüfungen auf fehlende Daten nach Subgruppen, eine separate Imputation, wenn sich die Fehlzeiten zwischen den Gruppen unterscheiden, und eine explizite Dokumentation darüber, wer mit den verfügbaren Daten nicht genau dargestellt werden kann (ASPE equity analysis guidance). Das ist eine deutliche Erinnerung daran, dass die Vollständigkeit des gesamten Datensatzes Ausschlüsse verbergen kann. Wenn eine Region dünn besiedelt ist oder eine historisch ausgeschlossene Gruppe in den Daten systematisch kleiner ist, kann das Modell immer noch verzerrt sein, selbst wenn die Tabelle „größtenteils vollständig“ ist.
Warum KI-Systeme hier anfällig sind
Der andere übersehene Aspekt ist KI und Echtzeit-Überwachung. Traditionelle Qualitätsarbeit stoppt oft bei periodischem Profiling, aber neuere statistische Leitlinien betonen die fortlaufende Überprüfung von Datensatzvolumen, Fehlzeiten in kritischen Feldern, Wertplausibilität und Trends außerhalb des zulässigen Bereichs, um Pipeline-Probleme frühzeitig abzufangen (NISS technical report). Das ist wichtig, da Schema-Drift, fehlende Ladungen und Verteilungsverschiebungen nachgelagerte Modelle beschädigen können, ohne einen lautstarken Fehler zu erzeugen.
Ein Modell benötigt keinen dramatischen Ausfall, um fehlerhaft zu arbeiten. Wenn sich der Typ eines vorgelagerten Feldes ändert, ein Feed zu spät eintrifft oder sich die Verteilung im Laufe der Zeit unmerklich verschiebt, kann sich die Qualität des Modelleingangs verschlechtern, lange bevor jemand das Ergebnis bemerkt. Aus diesem Grund ist eine kontinuierliche Observability bei operativen Prozessen periodischen Audits überlegen.
Kontinuierliche Prüfungen schützen nicht nur Dashboards, sie schützen auch die Annahmen, auf denen das Dashboard aufbaut.
Ein Plattform-Ansatz hilft hier, wenn er Baseline-Lernen, Validierung auf Datensatzebene, Aktualitätsüberwachung und kontinuierliches Schema-Tracking direkt in der eigenen Umgebung des Kunden kombiniert. Dadurch bleibt die Analyse nah an den Daten, wo diese Probleme am einfachsten zu beheben sind.
Alles zusammenführen beim nächsten Datensatz
Der schnellste Weg, einen Datensatz zu beurteilen, besteht darin, drei Fragen zu stellen. Erstens: Was bedeutet gut für diese geschäftliche Fragestellung? Zweitens: Welche Methoden decken die Fehler auf, die am meisten ins Gewicht fallen? Drittens: Wo sollten diese Prüfungen laufen, damit sie keine Reibungspunkte oder Risiken erzeugen?
Wenn die Antwort auf die erste Frage unklar ist, beginnen Sie mit den Dimensionen, nicht mit dem Tool. Genauigkeit, Vollständigkeit, Konsistenz, Eindeutigkeit, Gültigkeit, Aktualität und Eignung für den Zweck bieten ein gemeinsames Vokabular, um zu entscheiden, was akzeptabel ist. Wenn die Antwort auf die zweite Frage auch Drift und nicht nur Fehler umfasst, nutzen Sie Profiling, Baseline-Lernen und Trendanalysen. Wenn die Antwort auf die dritte Frage sensible Daten oder große Datenmengen betrifft, verdient die In-Database-Ausführung meist eine genauere Betrachtung.
Ein einfaches mentales Modell hilft hier: Betrachten Sie die Qualitätsdatenanalyse als einen Kreislauf. Definieren Sie die Vertrauenskriterien, messen Sie das Verhalten, alarmieren Sie bei Abweichungen und lassen Sie die Prüfungen dort laufen, wo die Daten liegen. Dieser Kreislauf ist dann am stärksten, wenn er kontinuierlich und statistisch erfolgt und sich am geschäftlichen Anwendungsfall orientiert, anstatt an einer generischen Hygiene-Checkliste.
Die zwei Lücken, die viele Teams immer noch offenlassen, sind Fairness (Equity) und KI-Bereitschaft. Wenn Sie Subgruppenprüfungen weglassen, können Sie übersehen, wen die Daten ausschließen. Wenn Sie auf kontinuierliche Observability verzichten, verpassen Sie die schleichenden Veränderungen, die Analysen und Modelleingaben unbrauchbar machen.
Wenn Sie diese Disziplin in die Praxis umsetzen möchten, bietet digna In-Database-Überwachung für Anomalien, Aktualität, Validierung und Schemaänderungen direkt in der eigenen Umgebung des Kunden. Besuchen Sie die Website, um zu sehen, wie eine kontinuierliche Qualitätsdatenanalyse nah am Data Warehouse, der Pipeline und den darauf basierenden Entscheidungen bleiben kann.
Häufig gestellte Fragen
Was fügt Quality Data Analysis der gewöhnlichen Analyse hinzu?
Eine Prüfung, ob die Eingaben die Schlussfolgerung verdienen. Ein defektes Dashboard sieht meist nicht defekt aus, deshalb erzeugt Analyse ohne Qualitätsschicht Befunde, deren Zuversicht aus der Darstellung und nicht aus Belegen stammt.
Wann braucht eine Kennzahl fortlaufendes Monitoring?
Wenn sie sich ohne sichtbaren Fehler ändern kann. Dieser eine Test trennt die Datensätze, die ständige Kontrollen brauchen, von jenen, für die ein periodisches Audit noch ausreicht.
Was kostet mangelhafte Qualität auf Entscheidungsebene?
2023 zitierte Gartner-Schätzungen nennen durchschnittlich 12,9 Millionen USD pro Organisation und Jahr, und IBMs Arbeit Cost of Poor Data Quality von 2022 fand, dass Ungenauigkeit bei großen Unternehmen etwa 25 % des Umsatzverlusts über fehlerhafte Entscheidungen treiben kann.
Was verbindet die moderne Disziplin?
Klassische deskriptive Statistik mit automatisierter Anomalieerkennung und Baseline-Learning. Diese Verbindung erlaubt einem Team, ungewöhnliches Verhalten über große Datenmengen fortlaufend zu beobachten statt auf periodische manuelle Prüfung zu setzen.
Warum ist Qualität als Hauswirtschaft der letzten Meile ein Fehler?
Weil der Schaden vor der letzten Meile entsteht. Bis eine Zahl einen Bericht erreicht, wurde der Defekt bereits von jeder Berechnung zwischen Quelle und Bildschirm geerbt.



