Metadatenmanagement: Ihr Playbook für 2026
|
8
min. Lesezeit

Sie befinden sich in einem Meeting, jemand fragt, warum das gestrige Dashboard nicht mit den heutigen Zahlen übereinstimmt, und drei Personen geben drei verschiedene Definitionen derselben Metrik an. Die Daten befinden sich im Warehouse, die Pipeline lief, und dennoch vertraut niemand den Ergebnissen genug, um eine Entscheidung zu treffen. Genau hier hört Metadatenmanagement auf, eine Hintergrundaufgabe zu sein, und wird zu dem Element, das die gesamte Datenoperation zusammenhält.
Inhaltsverzeichnis
Warum Metadatenmanagement jetzt wichtig ist
Ein fehlerhaftes Dashboard fällt meistens nicht spektakulär aus. Es liefert plötzlich falsche Antworten, nachdem sich ein Spaltenname geändert hat, eine Quelle verschoben wurde oder eine Transformation ohne Vorwarnung aktualisiert wurde. Das BI-Team hält den Bericht am Leben, der Analyst exportiert weiterhin nach Excel und das Business verliert langsam das Vertrauen in die Daten.
Der Wandel von der Dokumentation zur operativen Kontrolle
Dieser unbemerkte Ausfall ist der Grund, warum sich Metadaten von einer reinen Dokumentation hin zu einer operativen Infrastruktur entwickelt haben. Eine Marktstudie schätzte den globalen Metadatenmanagement-Markt im Jahr 2025 auf 2,84 Milliarden USD und prognostiziert für 2035 ein Erreichen von 27,97 Milliarden USD bei einer jährlichen Wachstumsrate (CAGR) von 25,7 %. Dieselbe Studie besagt, dass Nordamerika mehr als 39,15 % Marktanteil hielt, Datenkataloge und Discovery-Tools 58,4 % des globalen Anteils ausmachten und der US-Markt im Jahr 2025 1,01 Milliarden USD erreichte. Diese Zahlen weisen auf eine einfache Realität hin: Metadaten sind heute fester Bestandteil des Kern-Datenstacks, wie der Market.us-Marktbericht zum Metadatenmanagement zeigt.
Der Druck hinter diesem Wandel ist praktischer Natur. Wenn Metadaten schwach sind, können Data Scientists bis zu 80 % ihrer Zeit mit der Datenbereinigung verbringen, wodurch weniger Zeit für Modellierung, Tests und Bereitstellung bleibt. Ein solcher Effizienzverlust lässt sich in Unternehmen, die gleichzeitig Analysen, Compliance und KI unterstützen wollen, kaum ignorieren. Market.us-Marktbericht zum Metadatenmanagement
Warum sich auch Businessteams dafür interessieren
Ältere Metadatenprogramme waren oft in der IT angesiedelt. Die Business-Anwender kamen nur damit in Berührung, wenn ein Glossar einen neuen Begriff brauchte oder ein Bericht freigegeben werden musste. Dieses Modell funktioniert nicht mehr, da Metadaten-Konsumenten heute oft Business-Anwender sind. Eine vielbeachtete Umfrage ergab, dass fast 80 % der Metadaten-Konsumenten zu dieser Gruppe gehörten, während zwei Drittel der Befragten angaben, dass Metadaten im Jahr 2020 eine größere Rolle spielten als 10 Jahre zuvor. Dieselbe Umfrage zeigt auch, wie breit der Bedarf über verschiedene Rollen hinweg geworden ist, die auf gemeinsame Definitionen und vertrauenswürdigen Kontext angewiesen sind. Dataversity-Umfrage zum Metadatenmanagement
Diese Untersuchung zeigt auch, warum sich die Diskussion verändert hat. Die am häufigsten genutzten Quellen waren Data Warehouses, relationale Datenbanken, Datenmodelle und Business-Glossare, und das am meisten gewünschte zukünftige Asset waren Big-Data-Plattformen. In der Praxis wurden Metadaten zu einer businessorientierten Kontrollinstanz für Governance, Analysen und Auditierbarkeit – ähnlich wie ein Kontrollraum, der zeigt, was läuft, was sich geändert hat und wer reagieren sollte. Teams, die einen leicht verständlichen Einstieg suchen, können sich auch über den Llama 3.1-Zugriff informieren, bevor sie entscheiden, wie viel Metadatenkontext in gemeinsam genutzte Systeme gehört.
Ein Datenkatalog verleiht dieser Kontrollebene eine benutzerfreundliche Oberfläche, da er Menschen hilft, Assets zu finden, den Kontext zu prüfen und die Eigentümerschaft nachzuvollziehen, ohne sich durch mehrere Tools wühlen zu müssen. Das ist der operative Wert, auf den es am meisten ankommt. Wenn ein Business-Anwender nicht sagen kann, was ein Feld bedeutet, wer die Verantwortung dafür trägt und ob es sicher zu verwenden ist, erfüllt die Metadatenebene ihre Aufgabe nicht.
Kernkomponenten des Metadatenmanagements
Ein gutes Metadatenmanagement beginnt mit einer einfachen Definition. Metadatenmanagement ist der systematische Prozess des Erstellens, Speicherns, Organisierens und Pflegens von Metadaten über die Datenbestände einer Organisation hinweg. IBM beschreibt es als das Organisieren, Optimieren und Nutzen von Metadaten zur Verbesserung der Zugänglichkeit und Qualität, während Snowflake es als die Praktiken, Richtlinien und Tools definiert, die regeln, wie Metadaten erstellt, gepflegt, angereichert und nutzbar gemacht werden. IBM-Übersicht zum Metadatenmanagement, Snowflake-Übersicht zum Metadatenmanagement
Die sechs Metadatentypen, auf die es in der Praxis ankommt
Eine nützliche Unternehmenstaxonomie unterteilt Metadaten in technische, beschreibende, strukturelle, administrative, operative und Qualitätsmetadaten. Technische Metadaten umfassen Schemata und Datentypen. Beschreibende Metadaten enthalten Business-Begriffe und Definitionen. Strukturelle Metadaten zeigen Beziehungen zwischen Elementen auf. Administrative Metadaten beinhalten Zugriffsrechte und Aufbewahrungsfristen. Operative Metadaten verfolgen Lineage und Transformationen. Qualitätsmetadaten decken Vollständigkeit und Aktualität ab. Atlan-Metadatentypen
Diese Aufteilung ist wichtig, weil jeder Typ eine andere Frage beantwortet. Wenn ein BI-Entwickler wissen möchte, ob eine Metrik auf den richtigen Feldern aufbaut, helfen technische und strukturelle Metadaten. Wenn ein Governance-Verantwortlicher Aufbewahrungs- und Zugriffskontexte benötigt, sind administrative Metadaten die Single Source of Truth. Wenn ein Analyst einen Bericht debuggt, verraten ihm operative und Qualitätsmetadaten, woher die Daten stammen und ob sie sich so verändert haben, dass man ihnen vertrauen kann.
Die US National Institutes of Health zitieren die Definition der National Information Standards Organization, nach der Metadaten „strukturierte Informationen sind, die eine Informationsressource beschreiben, erklären, lokalisieren oder anderweitig deren Auffinden, Nutzung oder Verwaltung erleichtern.“ Diese Definition ist nützlich, weil sie Metadaten direkt mit dem Auffinden, der Nutzung und der Verwaltung verknüpft, nicht nur mit der Suche. NIH-Metadaten-Grundlagen-Arbeitsbuch
Wie die Teile zusammenwirken
Ein Katalog ist die Eingangstür. Lineage ist die Landkarte. Stewardship ist das Eigentumsmodell. Schema-Versionierung ist das Änderungsprotokoll. Nichts davon funktioniert allein wirklich gut. Wenn Definitionen in einem Tool leben, Lineage in einem anderen und Qualitätsbewertungen ganz woanders, verlieren Teams die Fähigkeit, ein Problem durchgängig zurückzuverfolgen. Diese Fragmentierung ist genau das, was die Diagnose von Dashboard-Fehlern und die Erhaltung der systemübergreifenden Konsistenz so schwierig macht. EWSolutions über Metadatensilos
Es hilft, den Prozess gedanklich zu trennen: Was wird definiert, wo lebt es und wie finden es die Menschen? Ein Datenkatalog organisiert Begriffe. Ein Repository speichert die Metadaten. Eigentümerschaft und Versionierung halten sie aktuell. Discovery macht sie für die Personen nutzbar, die sie benötigen.
Eine hilfreiche Referenz für Teams, die diese Eingangstür aufbauen, ist der Llama 3.1-Zugriff, da er zeigt, wie Metadaten und Zugriffsmuster in der realen Implementierung oft zusammen diskutiert werden. Für eine praxisnahe Unternehmenssicht auf die Katalogebene ist auch dignas Übersicht darüber, was ein Datenkatalog ist, lesenswert.

Integration mit Datenqualität und Observability
Metadaten werden operativ nutzbar, wenn sie in Qualitätsprüfungen und Observability-Workflows einfließen. Ein Katalog, der den Menschen nur sagt, wie eine Tabelle heißt, hilft bei der Entdeckung. Ein Katalog, der auch zeigt, wann sich diese Tabelle geändert hat, wer von ihr abhängt und ob der letzte Ladevorgang normal aussah, hilft Entwicklern, Vorfälle zu verhindern, bevor sie sich ausbreiten.
Vom passiven Kontext zu aktiven Signalen
Der praktische Wandel besteht darin, Metadaten direkt neben Validierung und Monitoring zu platzieren, anstatt sie als reines Hintergrundmaterial zu behandeln. Moderne Richtlinien besagen, dass Metadatenmanagement Lineage-, Eigentums-, Sensibilitäts-, Nutzungs- und Qualitätssignale enthalten sollte, da Teams wissen müssen, welche Dashboards genutzt werden und ob sich die Daten wie erwartet verhalten. Eine CDOIQ-Umfrage des MIT aus dem Jahr 2025, die in den verifizierten Daten zitiert wird, ergab, dass nur 12 % der Unternehmen ein stark integriertes Metadatenmanagement über technische, fachliche und operative Ebenen hinweg meldeten. Video zur CDOIQ-Umfrage des MIT
Diese Lücke ist gravierend, da isolierte Metadaten blinde Flecken erzeugen. Wenn die Schemaverfolgung vom Qualitätsmonitoring isoliert ist, bemerkt ein Analyst ein fehlerhaftes Dashboard möglicherweise erst lange nach dem Auftreten des Upstream-Problems. Wenn Lineage von Laufzeitwarnungen getrennt ist, sieht ein Team zwar, dass sich etwas geändert hat, weiß aber nicht, was dadurch beschädigt wurde. Observability verwandelt Metadaten in eine aktive Kontrollfläche, mit der Teams Symptome bis zu den Quellsystemen zurückverfolgen können, anstatt sie in einem statischen Dokumentenarchiv zu belassen.
Die Plattform von digna ist hier relevant, da sie In-Database-Ausführung, KI-gestützte Anomalieerkennung, kontinuierliche Schemaverfolgung und Aktualitätsüberwachung direkt in der Umgebung des Kunden kombiniert. Dieses Setup entspricht dem Betriebsmodell, das sich viele Teams wünschen, bei dem Metadaten, Qualität und Monitoring denselben Incident-Workflow unterstützen, anstatt in separaten Tools zu liegen. Für Teams, die eine praktische Sicht auf die Verbindung zwischen Metadaten und Qualitätsprüfungen suchen, bietet dignas Leitfaden zu Metadaten und Datenqualität einen nützlichen Ausgangspunkt.
Operative Erkenntnis: Wenn die Metadatenebene einen fehlerhaften Bericht nicht anhand von Quelle, Transformation und Auswirkungen auf die Verbraucher erklären kann, bleibt der Prozess immer noch mit zu viel Rätselraten verbunden.
Wie eine gute Integration aussieht
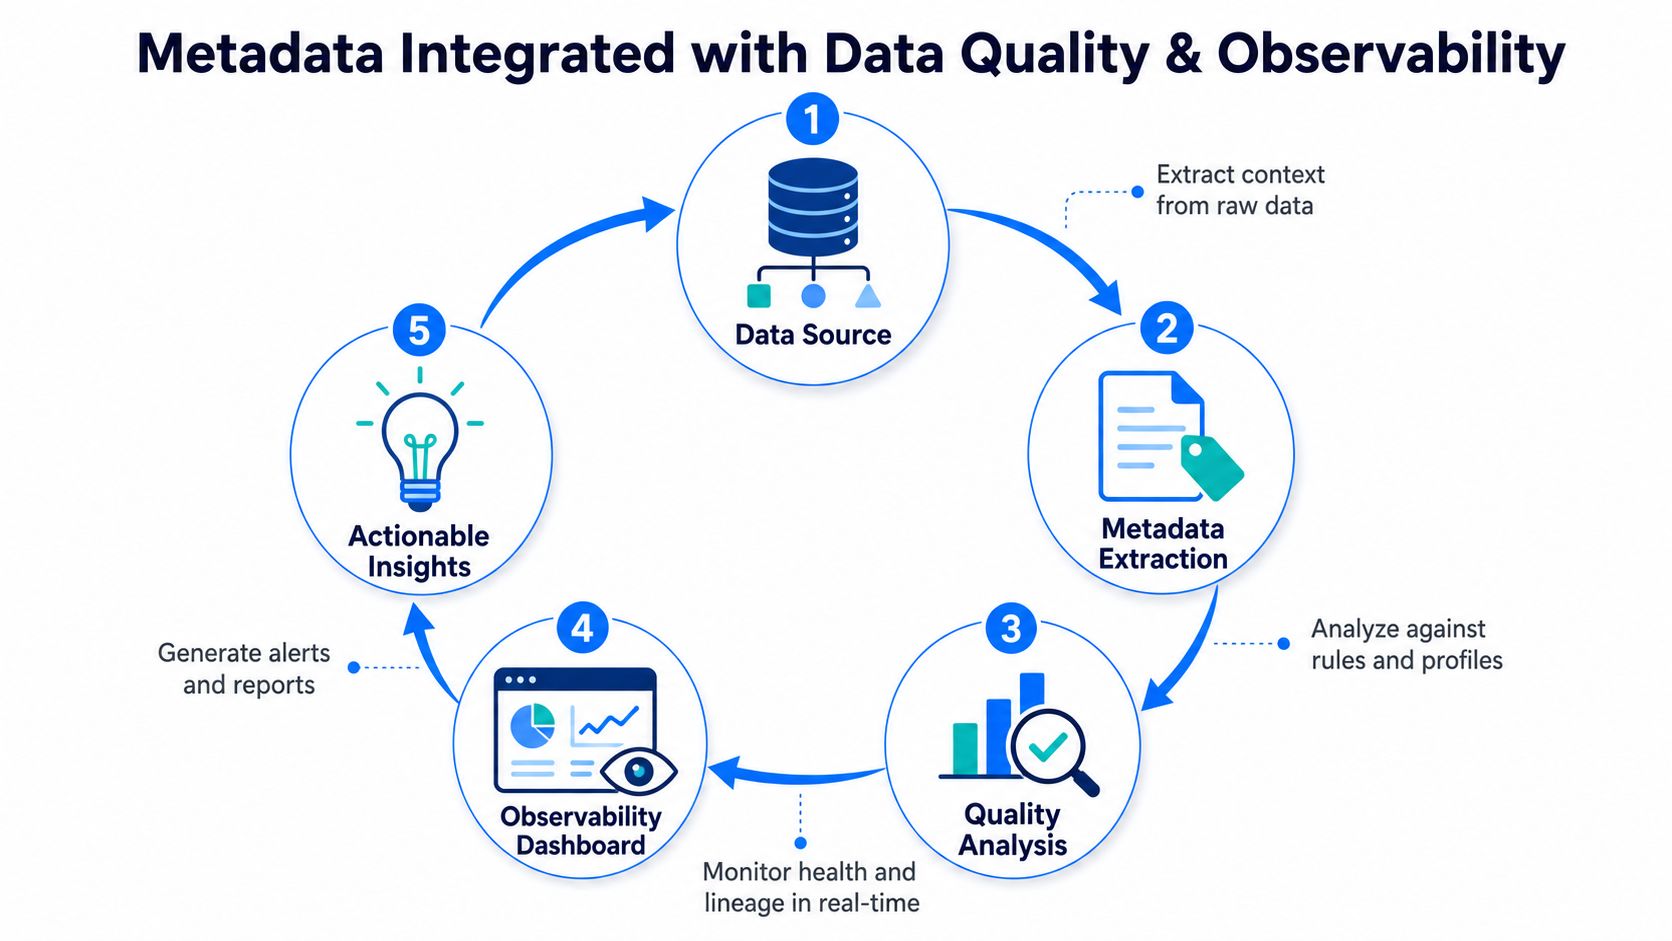
Ein praktischer Workflow beginnt meist beim Quellsystem. Die Metadatenextraktion erfasst Schemata, Eigentümer und Lineage. Qualitätsregeln bewerten die Daten anhand erwarteter Muster. Observability macht Anomalien oder Verzögerungen sichtbar. Die Aufgabe landet direkt beim richtigen Team, weil die Metadaten auf das betroffene Asset und dessen nachgelagerte Konsumenten verweisen.
Diese Kette ist im Arbeitsalltag entscheidend. Eine Schemaänderung sollte dem BI-Entwickler sofort signalisieren, welches Dashboard fehlerhaft sein könnte. Ein Aktualitätsproblem sollte dem Betriebsanalysten zeigen, ob die Verzögerung neu ist oder wiederkehrend auftritt. Ein Validierungsfehler sollte dem Governance-Verantwortlichen genügend Kontext liefern, um zu beurteilen, ob das Problem lokal oder systemisch ist. Für Teams, die stärkere Kontrollen rund um Datenqualität und Observability aufbauen, bietet der Artikel über IT-governance-Frameworks für UK-Projekte eine nützliche, ergänzende Perspektive.
Governance- und Sicherheitsaspekte
Ein Metadatenkatalog mag auf den ersten Blick harmlos erscheinen, da er weder die Rohdaten der Kunden noch die Finanztransaktionen selbst enthält. Diese Sichtweise übersieht jedoch das operative Risiko. Metadaten legen Strukturen, Eigentumsverhältnisse, Zugriffsmuster, Aufbewahrungsregeln und die Business-Logik offen. Sie können somit zeigen, wie sensible Systeme funktionieren und wer welche Daten einsehen kann.
Metadaten genau und aktuell halten
Die erste Governance-Frage betrifft die Aktualität. Auf Unternehmensebene wird die Pflege von Metadaten immer schwieriger, da Suche, Abruf, Aktualisierung und Abgleich mit zunehmendem Volumen und der Vielfalt der Datensätze immer aufwendiger werden. IBM weist darauf hin, dass große, verteilte Umgebungen Automatisierung und governance benötigen, da manuelle Aktualisierungen schnell zu veralteten oder unbrauchbaren Einträgen führen. IBM-Übersicht zum Metadatenmanagement
Dieses Problem zeigt sich besonders bei Compliance-Aufgaben. Veraltete Metadaten schwächen die Beweiskraft, verlangsamen die Ursachenanalyse und machen es schwerer, bei Audits lückenlos nachzuweisen, was sich wann geändert hat. Die Lösung ist operativer Natur, nicht kosmetischer: Erfassen Sie Metadaten direkt bei der Pipeline-Ausführung, weisen Sie Eigentumsrechte zu und versionieren Sie die Änderungen, sodass sich die Metadaten synchron mit den Daten bewegen, anstatt hinterherzuhinken.
Lineage und Provenienz erfordern dieselbe Disziplin. Ein klarer Lineage-Pfad zeigt, woher ein Asset stammt, wie es sich verändert hat und wo es verwendet wird, während die Provenienz hilft, den Ursprung und die Geschichte der Daten selbst zu erklären. Teams, die eine schärfere Unterscheidung benötigen, können diese Erklärung zu Datenprovenienz versus Daten-Lineage als Referenz heranziehen, wenn sie Kontrollen und Audit-Trails entwerfen.
Vollständigkeit und Überlastung ausbalancieren
Es gibt noch eine weitere Falle, die man leicht übersieht. Zu viele Metadaten können ebenso problematisch sein wie zu wenige. Neuere Empfehlungen raten dazu, Pflichtfelder gegenüber optionalen Feldern zu definieren und veraltete Einträge regelmäßig zu bereinigen, damit Kataloge nützlich bleiben und nicht überladen werden. Das ist besonders in Umgebungen wichtig, die Warehouses, Data Lakes, SaaS-Tools und KI-Modelle umfassen, in denen Schema-Drift und ständige Änderungen einen Katalog schnell in Datenmüll verwandeln können. Datagalaxy-Leitfaden zum Metadatenmanagement
Sicherheit erfordert dieselbe Konsequenz. Metadaten sollten durch Zugriffskontrollen, rollenbasierte Verwaltung und Änderungsfreigaben geschützt werden, die der Sensibilität der beschriebenen Daten entsprechen. Wenn Metadaten Ausnahmen von Aufbewahrungsrichtlinien oder Business-Logiken offenlegen, verdienen sie dieselbe Governance wie die Daten selbst.
Für Teams, die formelle Kontrollen aufbauen, bietet der Leitfaden zu IT-governance-Frameworks für UK-Projekte einen nützlichen Orientierungspunkt zur Strukturierung von Verantwortlichkeiten und Aufsicht bei Datenprogrammen.

Implementierungs-Roadmap und Checkliste
Ein Metadatenprogramm ist dann erfolgreich, wenn es beim bereits vorhandenen Chaos ansetzt und nicht bei einem theoretischen Zukunftszustand. Die meisten Unternehmen benötigen an Tag eins kein monumentales Gesamtkonzept. Sie brauchen eine klare Bestandsaufnahme darüber, was existiert, wer dafür verantwortlich ist und welche Datensätze bei Abweichungen die größten Probleme verursachen.
Mit den Daten mit der größten Reibung beginnen
Der erste Durchgang sollte sich auf kritische Domänen konzentrieren – also auf jene Tabellen, Berichte und Pipelines, die die meisten Fragen, Vorfälle oder manuellen Abgleiche verursachen. Dort stiften Metadaten am schnellsten sichtbaren Nutzen. Wenn das Team für diese Assets weder Lineage, Aktualität noch Eigentümerschaft einsehen kann, wird auch der Rest des Katalogs keine Abhilfe schaffen.
Definieren Sie anschließend die Mindestanzahl an Metadatenfeldern, die für jedes geschäftskritische Asset vorhanden sein müssen. Halten Sie diese Liste so kurz wie möglich. Fragen Sie nach dem Business-Namen, dem technischen Speicherort, dem Eigentümer, einer Beschreibung und den wichtigsten operativen Signalen. Alles andere kann später hinzugefügt werden, sofern es einer echten Entscheidung oder Kontrolle dient.
Frühzeitig auf Automatisierung setzen
Die manuelle Pflege von Metadaten scheitert bei wachsender Systemgröße. Quellen zur Beschreibung von Metadatenprozessen weisen darauf hin, dass verteilte Umgebungen Automatisierung erfordern, da manuelle Prozesse zu veralteten, inkonsistenten oder unbrauchbaren Datensätzen führen. Die praktische Lösung besteht darin, Metadaten automatisch aus Orchestrierungs-, Warehouse- und Transformationsebenen zu extrahieren und sie direkt zum Zeitpunkt der Änderung zu aktualisieren. IBM-Übersicht zum Metadatenmanagement
Eine einfache Checkliste hilft Teams, realistisch zu bleiben:
Ist-Zustand analysieren: Erfassung der Hauptquellen, Kataloge, Glossare und Lücken bei der Eigentümerschaft.
Governance-Regeln definieren: Festlegen, wer Metadateneinträge bearbeiten, freigeben oder entfernen darf.
Die Plattform auswählen: Tools wählen, die sich nahtlos an die bereits genutzten Systeme anbinden lassen.
Eine kritische Domäne testen: Mit einem Geschäftsbereich starten, der die Auswirkungen schlechter Metadaten wöchentlich zu spüren bekommt.
Messen und verbessern: Aktualität, Akzeptanz und das Volumen ungelöster Metadatenprobleme regelmäßig überprüfen.
Die besten Implementierungen betrachten Metadaten nicht als separates Bereinigungsprojekt. Sie binden sie direkt in die Pipeline-Ausführung, Validierung und Alarmierung ein, sodass Schemaänderungen und Qualitätssignale Hand in Hand gehen. Dadurch sind die Metadaten genau in dem Moment nützlich, in dem jemand handeln muss – und nicht erst Tage nach der Aufarbeitung eines Vorfalls.

Praxisbeispiele aus Unternehmen
Metadatenmanagement wirkt oft abstrakt, bis es ein Team vor einer Fehlentscheidung bewahrt. In der Praxis zeigen sich in der Finanzbranche, im Gesundheitswesen, in der Telekommunikation und im öffentlichen Sektor dieselben Muster, da jeder dieser Bereiche auf Rückverfolgbarkeit, Aktualität und Vertrauen in das nachgelagerte Berichtswesen angewiesen ist.
Finanzen und reguliertes Berichtswesen
Im Finanzdienstleistungssektor nutzen Teams Metadaten, um regulatorische Berichtsdaten zu verfolgen, kritische Business-Regeln zu validieren und ungewöhnliche Muster zu erkennen, bevor sie die Compliance beeinträchtigen. Die Risiken liegen auf der Hand. Ein Berichtsproblem, das eine fehlerhafte Lineage oder eine veraltete Definition verschleiert, kann schnell zu einem ernsthaften Audit-Problem werden. Metadaten geben Risiko- und Governance-Teams die Möglichkeit zu beantworten, was sich geändert hat, wo es sich geändert hat und wer darüber informiert werden muss.
Gesundheitswesen und operative Zuverlässigkeit
Teams im Gesundheitswesen sind auf Metadaten angewiesen, um klinische und operative Daten vertrauenswürdig zu halten. Schemaänderungen, verzögerte Datenbereitstellungen und unvollständige Datensätze können die Patientenberichterstattung und interne Abläufe beeinträchtigen, lange bevor jemand die Ursache entdeckt. Eine kontinuierliche Nachverfolgung hilft diesen Teams zu erkennen, ob ein Problem isoliert auftritt oder Teil einer größeren Störung im Datenfluss ist.
Telekommunikation und Betriebsabläufe im öffentlichen Sektor
Telekommunikationsanbieter arbeiten mit riesigen Mengen an Kunden- und Netzwerkdaten, weshalb sich unerwartete Änderungen schnell ausbreiten können. Metadaten helfen ihnen, strukturelle Verschiebungen frühzeitig zu erkennen und kritische Datensätze zu validieren, bevor nachgelagerte Systeme das Problem verstärken. Organisationen des öffentlichen Sektors nutzen ähnliche Kontrollen, um die Zuverlässigkeit, Rückverfolgbarkeit und Audit-Bereitschaft ihrer Datenprogramme zu verbessern.
Ein Screenshot der Observability-Oberfläche von digna zeigt, wie eine solche operative Ansicht Vorfälle, Datenstatus und die Änderungsverfolgung an einem zentralen Ort zusammenführen kann. Das ist entscheidend, da Ingenieure und Analysten dieselbe Informationsbasis benötigen, wenn sie entscheiden müssen, ob ein Problem technischer Natur ist, das Business betrifft oder beides.
Wichtigste Erkenntnisse und nächste Schritte
Beim Metadatenmanagement geht es längst nicht mehr nur um das Katalogisieren von Feldern. Es ist die operative Ebene, die Teams hilft, Daten zu entdecken, zu erklären, zu steuern und ihnen beim Weg durch die Systeme zu vertrauen. Die erfolgreichsten Programme verknüpfen Metadaten mit Qualität, Observability und Eigentümerschaft, sodass Probleme frühzeitig erkannt werden und die zuständigen Personen sofort handeln können.
Beginnen Sie mit einer eng eingegrenzten Auswahl kritischer Datensätze, definieren Sie die relevanten Metadatenfelder und automatisieren Sie die Erfassung, wo immer es möglich ist. Etablieren Sie anschließend eine klare Governance, damit Metadaten aktuell, sicher und nutzbar bleiben, anstatt im Chaos zu versinken. Teams, die Metadaten als lebendiges System behandeln, verbringen meist weniger Zeit mit Diskussionen über Definitionen und mehr Zeit mit der Verbesserung der Datenqualität an sich.
digna unterstützt Teams dabei, das Datenverhalten, Schemaänderungen, Aktualität und Validierungen direkt in der eigenen Umgebung zu überwachen. Damit ist es die ideale Ergänzung für ein metadatenbasiertes Qualitäts- und Observability-Konzept. Wenn Sie eine zuverlässigere Metadatenebene für Ihre Analysen oder KI aufbauen möchten, besuchen Sie digna und erfahren Sie, wie die Plattform Datenteams unterstützt, die Kontrolle, Rückverfolgbarkeit und kontinuierliches Monitoring benötigen.
Häufig gestellte Fragen
Warum ist Metadatenmanagement dringend geworden?
Weil Metadaten von der Dokumentation in die operative Infrastruktur gewandert sind. Ein defektes Dashboard scheitert meist ohne Drama, und genau dieses leise Versagen macht aus Metadaten statt einer nette-zu-haben-Aufzeichnung das Mittel zur Diagnose.
Wie sieht das klassische Symptom aus?
Drei Personen geben drei verschiedene Definitionen derselben Kennzahl, während jemand fragt, warum das Dashboard von gestern nicht zu den heutigen Zahlen passt. Die Uneinigkeit ist die sichtbar werdende Metadatenlücke.
Wie schnell wächst der Markt?
Eine Marktstudie schätzte globales Metadatenmanagement 2025 auf 2,84 Milliarden USD und prognostizierte 27,97 Milliarden USD bis 2035, bei 25,7 % CAGR. Wachstum in dieser Höhe spiegelt eine Verschiebung dessen, was Metadaten leisten sollen, und nicht bloß mehr Ausgaben.
Was unterscheidet Dokumentation von operativer Kontrolle?
Dokumentation hält fest, was Daten bedeuten sollen; operative Kontrolle nutzt diese Aufzeichnung, um etwas zu entscheiden. Metadaten, die keine Pipeline, kein Alert und keine Zugriffsentscheidung konsultiert, sind eine Beschreibung und keine Kontrolle.
Wo beginnt ein Metadatenprogramm?
Bei den Definitionen, über die ohnehin gestritten wird. Diese Streitigkeiten benennen die Kennzahlen, deren Bedeutung umkämpft ist, und genau dort verändert eine gemeinsame Definition ein Ergebnis statt einen Katalog zu füllen.


