Modelldrift-Erkennung: Ein praktischer Leitfaden für 2026
|
8
min. Lesezeit

Normalerweise bemerkt man Model Drift (Modellabweichung) nicht, wenn sie beginnt. Die Dashboards bleiben grün, das Modell liefert weiterhin Ergebnisse, und das erste Signal kommt von einem Geschäftsanwender, der feststellt, dass sich Freigaben, Genehmigungen oder Empfehlungen im Vergleich zum Vormonat „falsch“ anfühlen. Bis jemand ein Ticket öffnet, läuft das Modell oft schon seit Tagen oder sogar länger auf der Grundlage veralteter Annahmen, und das Team debuggt bereits an der falschen Stelle.
Deshalb muss die Model Drift Detection (Modellabweichungserkennung) als ein Problem der Data Observability beginnen. Das Modell ist nur ein Teil des Systems. Inputs verschieben sich, Schemata brechen, Labels kommen zu spät an, das Vertrauen ändert sich unmerklich und die Verteilung der Ergebnisse beginnt zu schwanken, noch bevor ein offensichtlicher Genauigkeitsabfall sichtbar wird.
Inhaltsverzeichnis
Die vier Drift-Typen, die Sie tatsächlich unterscheiden müssen
Baselines, Schwellenwerte und Alarm-Routing, die tatsächlich funktionieren
Wenn ein Modell stillschweigend aufhört zu funktionieren
Ein Betrugserkennungsmodell kann wochenlang gesund aussehen, während das Unternehmen Verluste einfährt. Die Dashboards zeigen normalen Datenverkehr, das Modell liefert immer noch Ergebnisse, und niemand sieht etwas Beunruhigendes, bis ein Zahlungsverantwortlicher fragt, warum ein vertrautes Kundensegment häufiger als erwartet abgelehnt wird. Das ist der schmerzhafte Teil von Drift. Er äußert sich nicht immer als Absturz, sondern oft als Verhaltensänderung, die Menschen früher bemerken als das Monitoring.
Ein gutes Drift-Programm erkennt diese Verschiebung, bevor die Beschwerde in Slack landet. Die praktische Aufgabe besteht nicht nur darin, die Genauigkeit zu überwachen, sondern das System zu beobachten, das das Modell speist, die Vorhersagen, die es ausgibt, und das Timing der Labels, die schließlich bestätigen, ob es richtig lag. Das ist der Unterschied zwischen einem Modell-Monitor und einer echten Data Observability-Ebene für ML.
Praktische Regel: Wenn ein Stakeholder die Abweichung vor der Plattform bemerkt, überwacht die Plattform das Falsche.
Das nützliche mentale Modell ist einfach. Input Drift zeigt sich, wenn sich Feature-Verteilungen ändern. Output Drift zeigt sich, wenn sich die Score-Verteilungen oder das Vertrauen (Confidence) verschieben. Schema Drift zeigt sich, wenn Spalten ihre Form ändern, verschwinden oder zu spät ankommen. Label Lag verbirgt die Wahrheit bis lange nach dem Liveschalten der Vorhersage. Sie müssen alle vier im Blick haben, denn jede einzelne davon kann die Nützlichkeit des Modells beeinträchtigen, ohne dass es zu einem dramatischen Einbruch der üblichen KPIs kommt.
Aus diesem Grund behandeln Unternehmensteams die Erkennung von Modellabweichungen schließlich als Teil der umfassenderen Pipeline und nicht als reines Modell-Add-on. Sobald man es so betrachtet, wird die Lösung klarer. Man trainiert nicht einfach nur schneller neu, sondern erkennt vorgelagerte Änderungen schneller, lokalisiert sie schneller und leitet sie schneller an den richtigen Verantwortlichen weiter.
Die vier Drift-Typen, die Sie tatsächlich unterscheiden müssen
Data Drift, Concept Drift, Label Drift und Feature Drift hängen zusammen, erfordern aber nicht die gleiche Reaktion. In der Produktion verschwendet eine Verwechslung dieser Typen Zeit. Ein Team verbringt vielleicht einen halben Tag damit, ein Modell neu zu trainieren, das eigentlich eine Schema-Korrektur benötigt, oder es optimiert weiterhin Features, obwohl sich die zugrunde liegende Beziehung geändert hat.
Beginnen Sie mit Data Drift
Data Drift ist am einfachsten zu erkennen und verleitet am leichtesten zu Überreaktionen. Es bedeutet, dass sich die Input-Verteilung geändert hat, während die geschäftliche Aufgabe dieselbe geblieben sein kann. Ein Kreditrisikomodell könnte nach der Einführung eines neuen Produkts eine Verschiebung der Einkommensklassen der Antragsteller feststellen, oder ein Churn-Modell könnte nach einer Änderung des Kanalmixes mehr mobile Nutzer erfassen. Das Modell liegt nicht unbedingt falsch, aber seine Welt hat sich so weit verändert, dass seine Annahmen möglicherweise nicht mehr zutreffen.
Trennen Sie Concept Drift von Input Drift
Concept Drift ist der schwierigere Fall. Die Beziehung zwischen den Inputs und dem Zielwert ändert sich, selbst wenn die Inputs immer noch vertraut aussehen. Ein Betrugsmodell sieht möglicherweise weiterhin dieselben Transaktionsmuster, aber Kriminelle ändern ihre Taktik, sodass die alten Signale Betrug nicht mehr so gut vorhersagen wie früher. Das ist kein Feature-Problem. Es ist ein Problem mit der erlernten Zuordnung selbst.
Behandeln Sie Label Drift und Feature Drift unterschiedlich
Label Drift bedeutet, dass sich die Klassenverteilung (Class Balance) ändert. In einem Kredit-Workflow kann sich das Verhältnis von genehmigten zu abgelehnten Fällen verschieben, was allein schon Metriken und Schwellenwerte verzerren kann. Feature Drift ist enger gefasst; hierbei geht es um die Änderung eines bestimmten Inputs, wie z. B. ein neuer kategorialer Wert, ein größerer numerischer Bereich oder ein fehlendes Feld, das vorher nicht fehlte. Feature Drift resultiert oft aus vorgelagerten Datenproblemen und nicht aus dem Modellverhalten, weshalb die Reaktion in der Regel eine Pipeline-Reparatur und kein erneutes Training ist.
Ein nützlicher Kontrollpunkt besteht darin, zwei Fragen zu stellen. Haben sich die Inputs geändert oder hat sich die Beziehung geändert? Und liegt das Problem im Modell oder im Datenpfad, der es speist?
Die Unterscheidung ist wichtig, da ein Schemabruch, eine Nullwert-Spitze oder eine verzögerte Tabelle in einem Dashboard wie Drift aussehen können, selbst wenn die Modelllogik in Ordnung ist. Für einen konkreten Implementierungspfad ist der digna Data Drift Detection Guide nützlich, da er die operativen Signale um die Datenebene herum zentriert, anstatt davon auszugehen, dass Labels die Lösung sind.
Die Wahl der richtigen Metrik für jedes Signal
Die beste Metrik hängt davon aus, was Sie überwachen und wie schnell Sie handeln müssen. In regulierten Umgebungen wünschen sich Teams meist eine transparente Statistik, die an eine Baseline gebunden ist. In dynamischeren Umgebungen benötigen sie oft eine Metrik, die kontinuierlich über mehrere Segmente hinweg laufen kann, ohne zu rauschen.
Das älteste und immer noch praktischste Fundament ist das formale Testen von Hypothesen. Der Kolmogorov-Smirnov-Test (KS) eignet sich gut für kontinuierliche Variablen, da er die Form von Live- und Referenzverteilungen vergleicht, ohne Normalverteilung vorauszusetzen. Der Chi-Quadrat-Test ist die natürliche Wahl für kategoriale Inputs, bei denen es darauf ankommt, ob sich der Kategoriemix so stark verändert hat, dass es eine Rolle spielt. Der Population Stability Index (PSI) wird häufig als schwellenwertbasierte Stabilitätsprüfung verwendet, wobei ein PSI über 0,25 üblicherweise als starkes Warnsignal gewertet wird Statsig on drift methods and PSI.
Für komplexere Verteilungen ist die Jensen-Shannon-Divergenz eine sinnvolle Option, insbesondere für kategoriale Outputs, Embeddings oder das Monitoring des Vorhersageraums. Sie ist nützlich, wenn Sie wissen wollen, wie sich zwei Wahrscheinlichkeitsverteilungen voneinander unterscheiden, und nicht nur, ob ein einzelnes Feature eine Grenze überschritten hat. Der Schlüssel liegt darin, nicht eine einzige Metrik auszuwählen und so zu tun, als würde sie jedes Signal abdecken.
Eine einzelne Metrik deckt selten alle Fehlermodi ab. Der richtige Stack nutzt eine Statistik für das Feature, eine andere für den Output und eine dritte für das Segment, das für das Unternehmen am wichtigsten ist.
Schnellreferenz für Drift-Metriken | Bestens geeignet für | Häufiger Alarmschwellenwert |
|---|---|---|
Population Stability Index | Regulierte kontinuierliche Features, Stabilitätsprüfungen der Baseline | 0,25 für ein starkes Warnsignal |
Kolmogorov-Smirnov-Test | Kontinuierliche Verteilungen, nicht-parametrischer Vergleich | Verwenden Sie einen p-Wert-Schwellenwert, der auf Ihre Richtlinien abgestimmt ist |
Chi-Quadrat-Test | Kategoriale Inputs, Änderungen im Kategoriemix | Verwenden Sie einen p-Wert-Schwellenwert, der auf Ihre Richtlinien abgestimmt ist |
Jensen-Shannon-Divergenz | Embeddings, Vorhersageverteilungen, höherdimensionale Signale | Verwenden Sie einen Richtlinienschwellenwert basierend auf dem Referenzverhalten |
Der praktische Standard ist die parallele Ausführung mehrerer Statistiken sowohl in kurzen als auch in langen Zeitfenstern. Kurze Fenster erfassen Vorfälle schnell. Lange Fenster erfassen langsamen Verfall, der bei einer eintägigen Prüfung nicht auffällt. Wenn Sie sich entscheiden müssen, wo Sie anfangen sollen, ist der Leitfaden how to describe distribution of data ein guter Referenzpunkt, um darüber nachzudenken, welche Form von Verteilung Sie vergleichen.
Aufbau der Erkennungs-Pipeline von Ende zu Ende
Eine produktive Drift-Pipeline hat fünf Aufgaben, und jede Aufgabe beantwortet eine andere Frage. Erfassen Sie zuerst die richtigen Signale. Erstellen Sie dann Profile. Vergleichen Sie anschließend das Live-Verhalten mit einer Referenz. Alarmieren Sie dann das richtige Team. Und erzwingen Sie schließlich eine Reaktion – sei es eine Untersuchung, eine Neukalibrierung, ein erneutes Training oder eine Pipeline-Korrektur.
Erfassen Sie die Signale, die Drift sichtbar machen
Das minimale Erfassungsset ist unkompliziert, aber Teams übersehen dennoch oft Teile davon. Sie benötigen Modell-Inputs, Outputs, Vorhersagekonfidenz, Zeitstempel und Ground-Truth-Labels, sobald diese eintreffen. Wenn Sie einen LLM-Workflow überwachen, erfassen Sie zusätzlich Prompts, Antworten, Token-Zahlen, Latenz und Guardrail-Aktivierungen. Diese zusätzlichen Signale sind wichtig, da sich schleichende Fehler in generativen Systemen oft im Verhalten und nicht in einer einzelnen Genauigkeitszahl äußern.
Berechnen Sie Profile nahe an den Daten
Die Profilebene sollte das Produktionsverhalten mit einem Referenzprofil vergleichen, nicht nur mit einer einmaligen Momentaufnahme. In der Praxis bedeutet dies, Baseline-Statistiken zu speichern und Live-Metriken im Laufe der Zeit auf denselben Tabellenfamilien zu berechnen. Sie möchten diese Berechnung nah an den Daten durchführen, idealerweise im Data Warehouse oder Data Lake, da das Verschieben großer Datenmengen in einen separaten Analysespeicher Latenzen, Kopiervolumen und mehr Fehlerquellen für den Monitoringpfad verursacht.
Führen Sie die Drifterkennung auf Datenscheiben (Slices) durch, nicht nur global
Globale Durchschnittswerte maskieren lokale Fehler. Ein Modell kann insgesamt stabil aussehen, während eine bestimmte Region, Produktlinie oder ein Vertriebskanal einbricht. Deshalb erfordert das Produktions-Monitoring eine Segmentierung. Kurze Zeitfenster helfen bei Vorfällen, lange Zeitfenster helfen bei langsamem Verfall, und beide sollten nach den für das Geschäft wichtigen Segmenten aufgeteilt werden.
Alert auf Aktion, nicht noise
Die Alarmierung sollte an einen Reaktionspfad gebunden sein. Eine schwache Feature-Verschiebung gehört vielleicht in ein Dashboard. Ein plötzlicher Verteilungsbruch verdient möglicherweise eine Benachrichtigung (Page). Ein Validierungsfehler muss eventuell an den Data Engineer gehen, nicht an das ML-Team. Die Reaktion funktioniert nur, wenn das Signal bei der Person landet, die das zugrunde liegende Problem beheben kann.
Für Teams, die dies in einer Plattform-Umgebung aufbauen, fügt sich ein Tool wie digna natürlich ein, wenn das Ziel darin besteht, Baselines direkt im Warehouse zu berechnen und sie mit Anomalie-, Aktualitäts-, Schema- und Validierungsprüfungen zu kombinieren. Dadurch bleiben die Daten dort, wo sie bereits liegen, und Betreiber haben einen zentralen Ort, um Trends, Aktualität und strukturelle Änderungen zu untersuchen.
Warum Performance-Metriken Drift zu spät erfassen
Teams lieben Genauigkeitsdiagramme, weil sie vertraut sind. Das Problem ist, dass Genauigkeit (Accuracy), Präzision (Precision), Recall, F1, MAE, RMSE und AUC-ROC meist nachgelagerte Signale und keine Frühwarnungen sind. Wenn die Labels verspätet oder nur lückenhaft eintreffen, teilt Ihnen die Metrik erst dann mit, dass das Modell falsch liegt, wenn die geschäftlichen Auswirkungen bereits spürbar sind.
Diese Verzögerung ist das zentrale operative Problem. Ein Modell kann weiterhin Vorhersagen liefern, während die Ground Truth noch fehlt. Bis ein signifikanter Leistungsabfall sichtbar wird, kann das Modell bereits so lange falsch gelegen haben, dass Freigaben, Betrugserkennungen, Empfehlungen oder das Service-Routing beeinträchtigt wurden.
Operative Wahrheit: Performance-Metriken sind Bestätigungswerkzeuge, nicht immer Erkennungswerkzeuge.
Aus diesem Grund sind Proxy-Signale so wichtig. Verschiebungen der Input-Verteilung können Ihnen zeigen, dass sich die eingehende Population verändert hat. Verschiebungen der Vorhersageverteilung können zeigen, dass sich das Vertrauen des Modells verschoben hat, noch bevor Labels eintreffen. Shadow Deployments können das direkte Vergleichsverhalten offenlegen. Die Konfidenzkalibrierung kann zeigen, dass das Modell immer noch sicher klingt, während es weniger zuverlässig wird. Diese Proxys beweisen nicht, dass das Modell versagt hat, aber sie sind oft der erste Beweis dafür, dass sich etwas geändert hat.
Die nützlichste Art, dies intern zu erklären, besteht darin, Drift-Hinweise als Anhaltspunkte, nicht als Beweise für ein Versagen zu behandeln. Diese Formulierung bewahrt das Team davor, bei jedem kleinen Ausschlag überzureagieren, und gibt ihm gleichzeitig die Erlaubnis zur Untersuchung, bevor aus dem Rückstau ein geschäftlicher Vorfall wird. In risikoreichen Workflows, insbesondere dort, wo Labels verzögert oder unvollständig sind, ist dies der einzige Ansatz, der zuverlässig funktioniert.
Baselines, Schwellenwerte und Alarm-Routing, die tatsächlich funktionieren
Ein Drift-Programm gewinnt an Vertrauen, wenn seine Baselines der Realität entsprechen. Eine statische Baseline aus der Trainingsphase ist gut für den Start, altert in Live-Systemen jedoch oft schlecht. Eine rollierende Produktions-Baseline ist besser für Workflows, die sich natürlich weiterentwickeln. Shadow-Mode-Baselines können helfen, wenn ein Modell neben einem bestehenden Modell evaluiert wird, da sie den aktuellen Datenverkehr widerspiegeln, ohne den Hauptentscheidungspfad zu beeinträchtigen.
Der Fehler, den viele Teams machen, ist die Annahme, dass ein einzelner statischer Schwellenwert alles abdecken kann. Das kann er nicht. Plötzliche Änderungen verdienen eine schnellere Eskalation als ein langsames Abdriften. Ein Feature, das sich allmählich verändert, rechtfertigt vielleicht eine Warnung und eine Untersuchungswarteschlange, während ein plötzlicher KS-Sprung bei einem sensiblen Feld eine sofortige Triage erfordern kann. Der Schwellenwert sollte sowohl die Metrik als auch den operativen Kontext widerspiegeln.
Ein gestaffeltes Routing-Modell funktioniert besser als ein gemeinsames Postfach. Leiten Sie Schema-Probleme an den Data Engineer weiter. Leiten Sie Konfidenz- oder Output-Verschiebungen an die ML-Plattform oder das Modellierungsteam weiter. Leiten Sie Aktualitätsprobleme und fehlende Datenladungen an den Pipeline-Verantwortlichen weiter. Diese Aufteilung ist wichtig, damit der Ersthelfer nicht raten muss, wo der Fehler aufgetreten ist.
Wenn der Alarm keinen Verantwortlichen nennt, ist es kein Alarm. Es ist nur besser formatierter Lärm.
Der schnellste Weg, Alarmmüdigkeit (Alert Fatigue) zu reduzieren, besteht darin, den Alarm so aussagekräftig zu gestalten, dass er die erste Untersuchung verkürzt. Nennen Sie das betroffene Segment, das Vergleichsfenster, die verschobene Metrik und die Referenz-Baseline. Lassen Sie dann den zuständigen Bearbeiter entscheiden, ob die Lösung in einem erneuten Training, einer Neukalibrierung, einer Feature-Reparatur oder einer Übergabe an das Data Engineering besteht.
Ursachenanalyse und wo Observability hineinpasst
Ein guter Drift-Alarm sollte zu einer Lösung führen, nicht zu einer Diskussion. Betrachten wir ein Zahlungs-Feature, das plötzlich einen KS-Ausschlag auslöst. Das Modellteam vermutet vielleicht zuerst Concept Drift, aber die tatsächliche Ursache kann eine Schemaänderung im Upstream sein, wie z. B. die Änderung eines Feldtyps oder eine Nullable-Spalte, die plötzlich unerwartete Werte enthält. In diesem Fall ist die richtige Lösung eine Pipeline-Reparatur, kein erneutes Training.
Ein anderer Fall wirkt weniger eindeutig. Ein PSI-Trend steigt nach einer Produkteinführung langsam an, und das Team stellt ein schlechteres Modellverhalten bei einem Teil des Datenverkehrs fest. Das deutet oft auf eine Verschiebung des Kundenmixes hin, nicht auf ein fehlerhaftes Modell. Das Modell ist möglicherweise immer noch valide, aber seine Referenzpopulation ist nicht mehr repräsentativ. Hier ist der historische Kontext wichtig, denn ein Trend ohne Historie ist nur eine Momentaufnahme.
Das dritte Muster ist Calibration Drift (Kalibrierungsdrift). Das Modell liefert weiterhin Ergebnisse, aber verzögerte Labels zeigen schließlich, dass das Vertrauen (Confidence) nicht mehr so gut mit der Realität übereinstimmt wie zuvor. Das ist eine Erinnerung daran, dass das Monitoring verspätete Labels elegant verarbeiten muss. Proxy-Signale liefern Ihnen die Frühwarnung, während die schlussendlichen Labels bestätigen, ob die Sorge berechtigt war.
Eine Data Observability-Plattform sollte diese Untersuchung beschleunigen, indem sie Schema-Tracking für hinzugefügte oder entfernte Spalten, Aktualitätsüberwachung (Timeliness Monitoring) für fehlende oder verspätete Daten, Anomalieerkennung für unerwartete Verschiebungen und Ansichten historischer Trends für den Kontext bereitstellt. Hier setzt digna in der Praxis an, da es Baselines berechnet und Anomalie-, Aktualitäts-, Schema- und Validierungsprüfungen direkt in der Datenbank des Kunden ausführt. Der Vorteil ist nicht nur der Datenschutz, sondern auch ein wesentlich effizienterer Triage-Pfad, da Ingenieure das Signal untersuchen können, ohne sensible Daten in ein anderes System verschieben zu müssen.
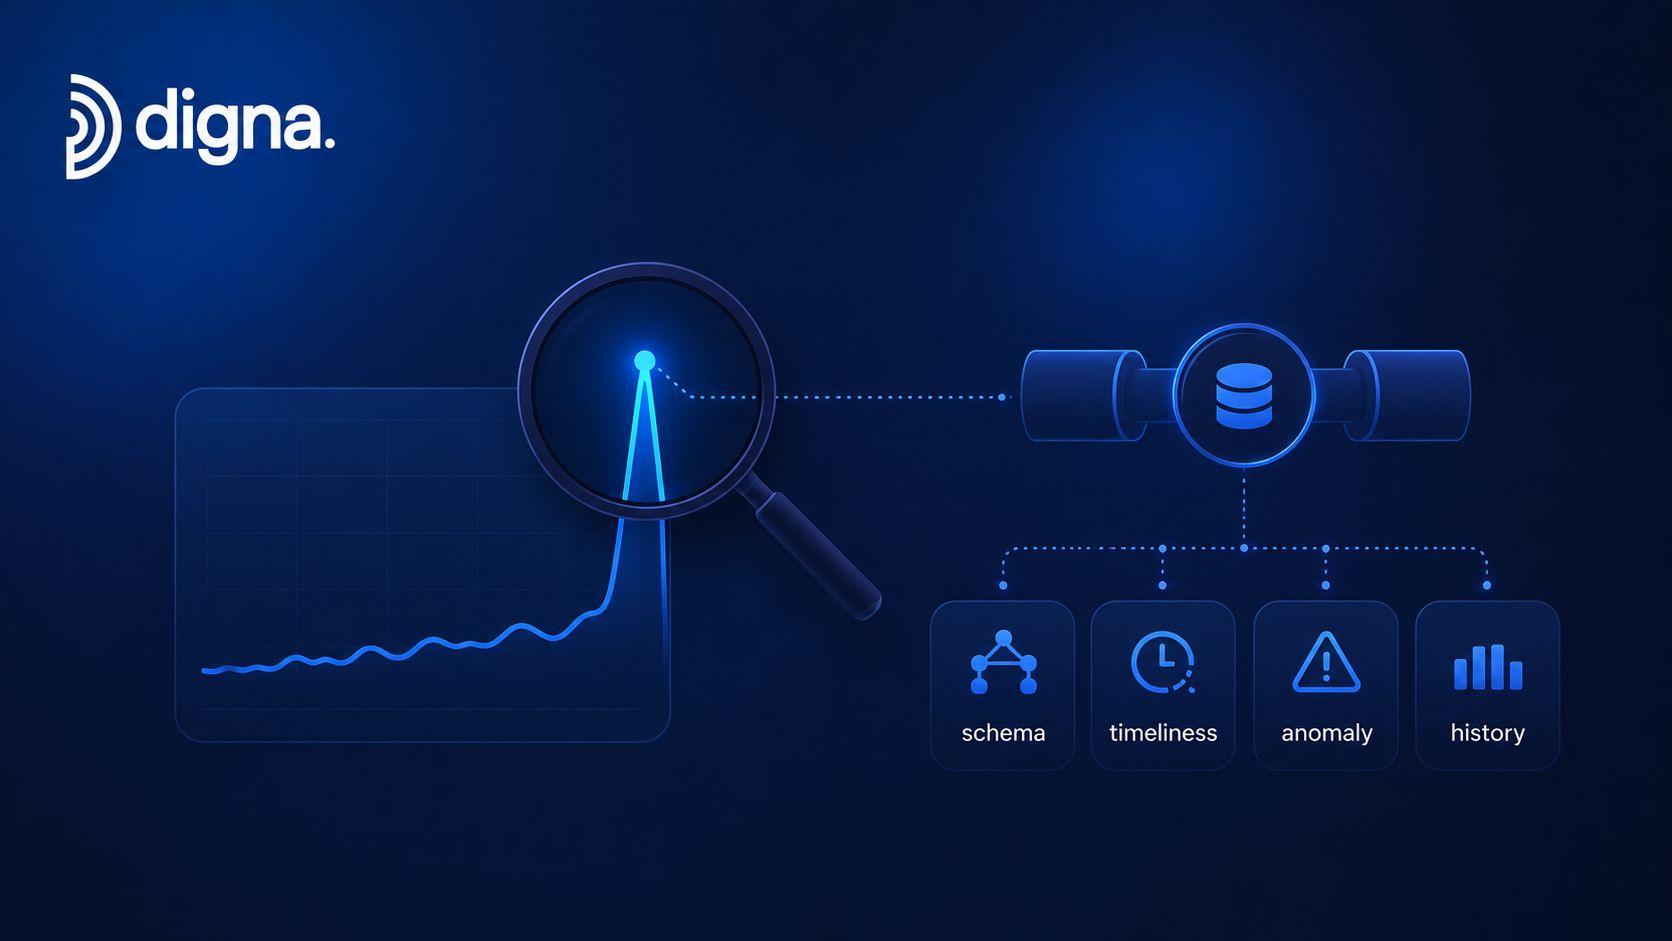
Wenn Ihr Team immer noch auf Labels wartet, bevor es Drift untersucht, ist die Monitoring-Schleife bereits zu langsam. Besuchen Sie digna, um zu sehen, wie datenbanknahe Baselines, Anomalieprüfungen, Aktualitätsüberwachung, Schema-Tracking und Validierung Ihren ML-Systemen ein klareres Drift-Signal und einen schnelleren Weg vom Alarm zur Ursache bieten können.


