KI-Datenqualität meistern für die Unternehmensüberwachung 2026
|
7
min. Lesezeit

Der Montagmorgen beginnt mit einem allzu bekannten Gefühl des Schmerzes. Ein Dashboard, das eigentlich ruhig sein sollte, blinkt rot, die Zahlen wirken unstimmig und niemand kann sich einigen, ob das Problem real oder nur ein weiterer veralteter Feed ist. Bis jemand die Ursache auf eine verspätete Datei, einen doppelten Batch oder eine unbemerkt geänderte Schema-Struktur zurückverfolgt, hat der Schaden bereits seinen Weg in die Besprechungsnotizen, das Modellergebnis oder die Vorstandspräsentation gefunden.
Das ist der aktuelle Stand der KI-Datenqualität im Jahr 2026. Es ist längst keine ordentliche Übung mehr, bei der man Nullwerte korrigiert und Zeilen dedupliziert, denn moderne Pipelines bewegen sich zu schnell, als dass statische Prüfungen jede bedeutende Änderung erfassen könnten. Vor allem in Europa hat sich die Diskussion von der Frage „Sind die Daten sauber?“ hin zu „Können wir den Daten vertrauen, es beweisen und sie über den gesamten Lebenszyklus hinweg verwalten?“ verlagert. Deswegen stehen Observability, Auditierbarkeit und Lineage heute neben der Genauigkeit an vorderster Stelle, insbesondere bei hochriskanten KI-Anwendungen und regulierten Umgebungen. Ein guter Ausgangspunkt ist die praktische Observability-Ansicht unter dignas Data Observability-Übersicht.
Jenseits sauberer Daten: Das neue Gebot
Ein Finanzteam kann eine Stunde lang mit einem fehlerhaften Diagramm leben. Eine Preisgestaltungs-Engine kann das nicht. Wenn der Feed unbemerkt verzögert ankommt oder wenn sich die eingehende Verteilung gerade so stark verschiebt, dass sie noch innerhalb einer starren Regel bleibt, spürt das Unternehmen dennoch die Auswirkungen. Manuelle Prüfungen erfassen das Offensichtliche, aber sie übersehen die schleichenden Ausfälle, die sich Datensatzgruppe für Datensatzgruppe einschleichen.
Deshalb ist die KI-Datenqualität dem alten Ansatz des „Später-Aufräumens“ entwachsen. Die auf Europa fokussierte Forschung behandelt Datenqualitätskontrollen mittlerweile als Teil der umfassenderen Data Governance, insbesondere dort, wo hochriskante KI im Spiel ist und Datensätze relevant, repräsentativ, fehlerfrei und vollständig sein müssen (Analyse des Artikels 10 im European Journal of Information Law). Der Governance-Aspekt ist deshalb so wichtig, weil ein schlechter Datensatz nicht nur ein Ärgernis bei der Modellierung darstellt, sondern der Beweis dafür ist, dass man der Pipeline noch nicht vertrauen kann.
Der Wandel vom Aufräumen zur Kontrolle
Das alte Modell war einfach: Ein Dateningenieur schrieb eine Regel, ein Dashboard löste einen Alarm aus und jemand ging der Sache nach, nachdem sich der Schaden bereits ausgebreitet hatte. Das funktioniert, wenn das Problem eindeutig und wiederkehrend ist. Es versagt jedoch, wenn der Fehler im Verhalten liegt – wie etwa bei einem Feed, der zwar pünktlich eintrifft, aber eine veränderte Verteilung aufweist, oder einem Kundensegment, das verschwindet, ohne eine Nullwertprüfung auszulösen.
Genau darum geht es bei moderner Observability. Sie fragt nicht nur, ob die Spalte existiert. Sie fragt, ob sich die Daten immer noch so verhalten wie die Daten, die Sie erwartet haben. Für Teams in Spanien oder in der gesamten EU ist das mehr als nur Bequemlichkeit – es deckt sich mit der rechteorientierten Sichtweise, dass verlässliche KI mit verlässlichen Kontrollen beginnt. Eine nützliche praktische Perspektive bietet die Herangehensweise von Plattformen, die speziell für dieses Problem entwickelt wurden, wie etwa Datenqualitätsdimensionen und wie man sie misst, denn die Dimensionen sind ebenso wichtig wie die Werkzeuge selbst.
Praktische Regel: Wenn ein Datenproblem nur dadurch gefunden werden kann, dass eine Person am Ende der Woche eine Tabellenkalkulation öffnet, ist es für eine operative KI bereits zu spät.
Die bessere Frage ist, ob das System Drift, Verzögerung, Duplizierung und Validitätsprobleme erkennen kann, bevor die Geschäftsanwender die Symptome bemerken. Das ist heute der entscheidende Standard, und das ist ebenso eine Governance-Hürde wie eine technische.
Was KI-Datenqualität tatsächlich bedeutet
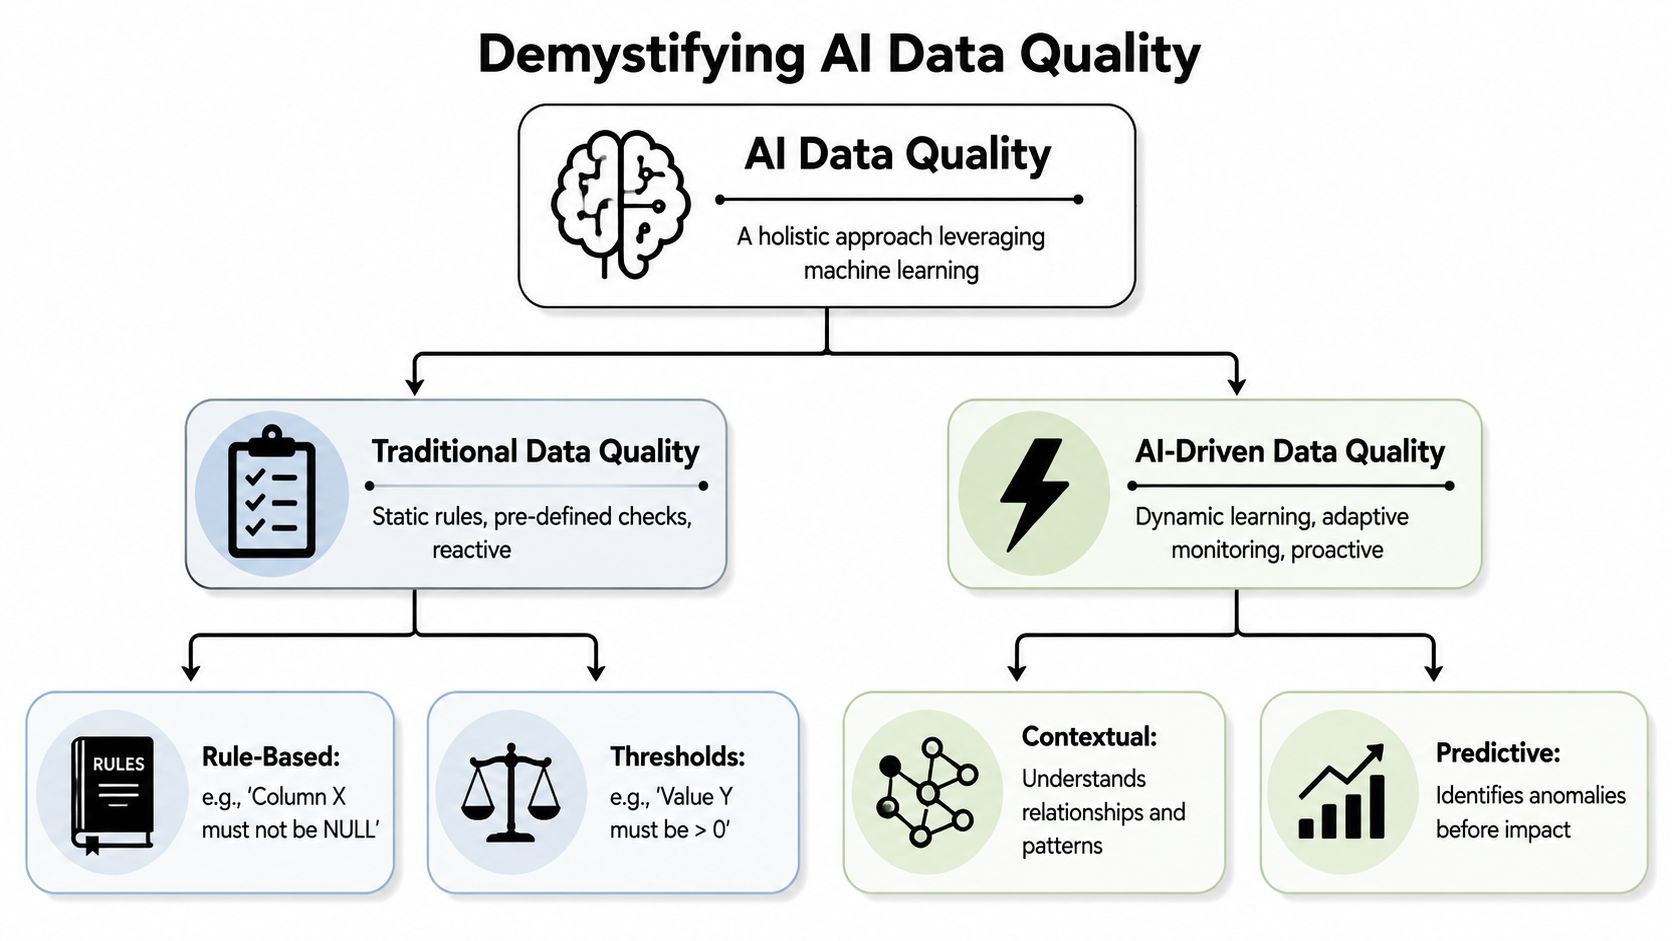
Traditionelle Datenprüfungen sind wie eine Alarmanlage am Auto, die nur eine Aufgabe hat: Sie schrillt auf, wenn ein Fenster geöffnet wird. Nützlich, aber stumpf. Ein intelligentes Haussicherheitssystem überwacht Bewegungsmuster, Türöffnungszeiten, ungewöhnliche Zugriffe und den Kontext dessen, was für dieses Haus normal ist. KI-Datenqualität arbeitet eher wie das zweite Modell, weil sie den Herzschlag einer Pipeline lernt, anstatt darauf zu warten, dass eine einzelne Regel verletzt wird.
Die Definition der FRA ist hier ein guter Anker. Sie besagt, dass die Datenqualität für KI Vollständigkeit, Genauigkeit, Konsistenz, Aktualität, Duplikation, Validität, Verfügbarkeit und Provenienz umfasst (FRA-Bericht). Das ist wichtig, weil es den Blickwinkel erweitert. Ein Datensatz kann im engsten Sinne genau sein und dennoch nutzlos, wenn er zu spät eintrifft, keine Provenienz aufweist oder sich so stark verändert hat, dass nachgelagerte Entscheidungen unzuverlässig werden.
Statische Regeln versus erlerntes Verhalten
Regelbasiertes Monitoring stellt Fragen wie „Ist Spalte X null?“ oder „Liegt Wert Y über Null?“. Diese Prüfungen sind nach wie vor nützlich, und niemand, der die Sache ernst nimmt, sollte sie abschaffen. Aber sie erfassen nur die Bedingungen, an deren Codierung Sie zuvor bereits gedacht haben.
KI-gestütztes Monitoring lernt normale Muster über Zeit, Volumen, Verteilung, Saisonalität und die Beziehungen zwischen den Feldern hinweg. Es kann eine Änderung signalisieren, selbst wenn die Rohwerte noch innerhalb eines festen Grenzwerts liegen. Das ist der entscheidende Unterschied, und deshalb nutzen moderne Teams KI, um starre Regeln zu ergänzen, anstatt sie zu ersetzen.
Die Dimensionen, auf die es wirklich ankommt
Der FRA-Rahmen hilft Teams auch dabei, einen häufigen Fehler zu vermeiden: „Datenqualität“ als eine einzige vage Kennzahl zu behandeln. Das ist sie nicht. Die Dimensionen unterteilen sich in verschiedene operative Fragen.
Vollständigkeit fragt, ob die Daten vorhanden sind.
Aktualität fragt, ob sie zum erwarteten Zeitpunkt eingetroffen sind.
Konsistenz fragt, ob die Datensätze immer noch zueinander passen.
Provenienz fragt, woher sie kamen und wie sie sich verändert haben.
Validität fragt, ob die Datensätze im Vergleich zum erwarteten Geschäftsverlauf noch Sinn ergeben.
Diese breitere Definition deckt sich hervorragend mit der operativen Observability. Ein System, das Trends, Schema-Änderungen, verspätete Eingänge und die Validität auf Datensatzebene überwacht, leistet echte Datenqualitätsarbeit und nicht nur reine Datenpflege.
Wie KI die Datenüberwachung aktiv verbessert
Die europäische amtliche Statistikpraxis zeigt bereits, wie dies in der Praxis funktioniert. KI wird eingesetzt, um Datenerfassung, Klassifizierung, Bearbeitung, Anomalieerkennung und Imputationsvorschläge zu unterstützen, während die menschliche Aufsicht zur Sicherung der Qualität im Prozess verbleibt (Webinar der amtlichen Statistik der EU). Das ist auch für Unternehmensteams ein nützliches Modell, weil es die Maschine auf die Mustererkennung fokussiert und dem Experten die Urteilsfindung überlässt.
Der größte Gewinn liegt nicht darin, dass KI magisch ist. Vielmehr skaliert sie die Art von Wachsamkeit, die Menschen manuell nur schwer aufrechterhalten können. Eine Plattform kann lernen, dass ein Feed an Wochentagen normalerweise bis zu einer bestimmten Uhrzeit eintrifft oder dass eine Metrik nach einem bestimmten geschäftlichen Ereignis natürlicherweise ansteigt, und dann die Ausnahme hervorheben, ohne dass jemand für jeden Einzelfall eine benutzerdefinierte Regel schreiben muss. Für eine eher produktbezogene Sichtweise dazu lässt sich der in Wie KI Datenanomalien in Pipelines erkennt beschriebene Workflow nahtlos auf die Art und Weise übertragen, wie Teams Vorfälle priorisieren.
Baselines, die sich mit den Daten bewegen
Statische Grenzwerte sind anfällig, weil sich der Normalzustand im Laufe der Zeit verändert. Ein saisonales Geschäft hat kein einziges starres Muster, und ein modernes Warehouse ebenfalls nicht. Das KI-gestützte Erlernen von Baselines passt sich an wiederkehrendes Verhalten an, sodass der Alarm bei einer unerwarteten Änderung und nicht bei einem erwarteten Zyklus ausgelöst wird.
Das macht bei der Reaktion auf Vorfälle einen spürbaren Unterschied. Anstatt darüber zu diskutieren, ob ein Ausschlag „schlecht“ ist, können Teams sehen, ob er vom gelernten Muster abweicht. Das Signal verbessert sich und das Rauschen nimmt ab.
Aktualität ist ein Qualitätsproblem, kein ärgerliches Terminierungsthema
Das europäische Datenmanagement behandelt Aktualität als formales Qualitätsmerkmal und nicht als weiches operatives Problem. Das EUROCAT DQI-Framework beinhaltet die Aktualität der Datenübertragung neben Vollständigkeit und Genauigkeit (EUROCAT DQI-Liste). Das ist eine eindringliche Erinnerung daran, dass eine verspätete Lieferung genauso schädlich sein kann wie ein falscher Wert.
Ein Feed, der zwei Stunden zu spät eintrifft, kann gefährlicher sein als ein Feed mit einem sichtbaren Fehler, da das Dashboard weiterhin fehlerfrei aussieht, während das Unternehmen auf der Grundlage veralteter Zahlen agiert.
Traditionelle Regeln vs. KI-gestütztes Monitoring
Aspekt | Traditioneller regelbasierter Ansatz | KI-gestützter Ansatz |
|---|---|---|
Erkennungsstil | Feste Grenzwerte und manuell erstellte Prüfungen | Lernt Verhalten und achtet auf Abweichungen |
Reaktionszeitpunkt | Häufig reaktiv | Proaktiv und kontinuierlich |
Abdeckung | Beschränkt auf bekannte Fehlermuster | Besser beim Auffinden unbekannter Anomalien |
Instandhaltung | Regeln müssen ständig gepflegt werden | Modelle passen sich an, wenn sich Pipelines weiterentwickeln |
Aktualität | Normalerweise getrennt von anderen Prüfungen | Wird als Teil des normalen Verhaltens überwacht |
Für Teams, die komplexe Pipelines verwalten, verwandelt dieser Wandel das Monitoring von einer Brandmeldeanlage in ein Frühwarnsystem.
Die echten Vorteile und verborgenen Risiken
Das beste Argument für KI-Datenqualität ist einfach: Es reduziert die Zeit, die Teams mit dem Schreiben und Verwalten fehleranfälliger Tests verbringen, und es erfasst Probleme, an deren Codierung im Vorfeld niemand gedacht hat. Das ist wichtig, wenn sich Pipelines häufig ändern und die Fehlerszenarien sich ständig weiterentwickeln. Es stärkt auch das Vertrauen, da Analysten und Geschäftsanwender Qualitätsprüfungen nicht mehr als reine Backoffice-Routine betrachten, sondern als Teil des Produkts.
In regulierten Branchen gibt es zudem einen noch tiefer gehenden Vorteil. Praxisnahe Forschung, die an den EU-Regulierungen ausgerichtet ist, hat gezeigt, dass fehlende Daten das größte Qualitätsproblem darstellten, während Datenschutzaspekte (37 %) ein wichtiges Anliegen waren (EU-konforme Praxisstudie). Das erinnert daran, dass Qualitätsarbeit im Finanz-, Gesundheits- und Telekommunikationsbereich innerhalb kontrollierter Umgebungen stattfinden muss und nicht erst, nachdem die sensiblen Daten zur Überprüfung an einen anderen Ort übermittelt wurden.
Was sich schnell verbessert
Teams bemerken meist drei praktische Vorteile zuerst. Der erste ist eine Reduzierung der manuellen Fehleranalyse, da das System offensichtliches Rauschen filtert, bevor ein Mensch eingreifen muss. Der zweite ist eine frühere Warnung bei unbekannten Problemen, was wichtiger ist als eine perfekte Klassifizierung jedes einzelnen Vorfalls. Der dritte ist ein höheres Vertrauen in nachgelagerte Berichte, wodurch die Wahrscheinlichkeit sinkt, dass Mitarbeiter eigene Schattenprüfungen aufbauen.
Dieses Vertrauen ist jedoch fragil. Wenn die Monitoring-Ebene selbst undurchsichtig wird oder wenn jeder Grenzfall einen lauten Alarm auslöst, gerät die Einführung ins Stocken. Alarm-Müdigkeit kann ein gutes System schneller zunichtemachen als eine schlechte Modellierung.
Der Datenschutz-Kompromiss, den die meisten Artikel verschweigen
Ein Anbieter, der sensible Daten aus einer kontrollierten Umgebung kopiert, schafft ein neues Problem, während er versucht, das alte zu lösen. Für regulierte Teams ist das sicherere Muster in der Regel ein In-Database- oder ein On-Premises-Monitoring, bei dem die Analyse direkt bei den Daten läuft, anstatt die Daten zur Analyse zu bewegen. Diese Architektur ist optimal für Sektoren, die Datenschutz standardmäßig (Privacy by Design) benötigen, und sie ist einer der Gründe, warum die Wahl der Plattform wichtiger ist als Feature-Checklisten.
Derselbe Spannungsbereich zwischen Datenschutz und governance zeigt sich auch bei medizinischen Tests. Eine nützliche Parallele findet sich in Klinische Testgenauigkeit meistern, da dies verdeutlicht, warum Sensitivität, Spezifität und Kontext alle von Bedeutung sind, wenn die Kosten für ein falsches Signal hoch sind.
Warum die Architektur Teil der Qualitätsgeschichte ist
digna wird innerhalb der Kundenumgebung ausgeführt, entweder On-Premises oder in einer Private Cloud, und in den Dokumenten wird dargelegt, dass es niemals als SaaS bereitgestellt wird, sodass kein Zugriff des Anbieters auf die Kundendaten erfolgt (digna-Dokumentation auf Spanisch). Diese Designentscheidung ist keine reine Marketingfloskel. Sie adressiert ganz direkt die praktische Hürde, vor der viele europäische Teams stehen: Wie lässt sich die Qualität verbessern, ohne die Kontrolle abzugeben?
Das ist auch für den Nachweis der Governance von Bedeutung. Wenn das System, das die Qualität prüft, selbst innerhalb der geschützten Umgebung arbeitet, ist die Auditierung transparenter und die Sicherheitsprüfung verläuft in der Regel reibungsloser.
Einführung von KI-Datenqualität im Unternehmen
Die Einführung im Unternehmen scheitert meist an einem von zwei Gründen. Entweder schafft das Team ein glänzendes neues Tool an, bevor das operative Problem definiert wurde, oder es pfropft es auf einen Workflow auf, für den sich niemand verantwortlich fühlt. Der bessere Weg ist schmaler und weniger glanzvoll: Wählen Sie eine kritische Pipeline, einen Geschäftszweig und eine Reihe von Qualitätsfragen aus, die bereits jetzt Probleme verursachen.
Von diesem Punkt an werden die Bewertungskriterien klarer. Eine echte Plattform sollte sich in den bestehenden Stack integrieren lassen, Muster ohne endloses manuelles Schreiben von Regeln erlernen, genügend Erklärungen liefern, damit Ingenieure und Analysten den Ergebnissen vertrauen können, und innerhalb des Sicherheitsmodells arbeiten, das Ihr Unternehmen bereits nutzt. Wenn sie diese Dinge nicht leisten kann, wird sie zu ungenutzter Software mit einem Dashboard.
Worauf Sie achten sollten, bevor Sie etwas einführen
Integrationstiefe: Es sollte ohne eine parallele Infrastruktur direkt mit Ihrem Warehouse, Lake und Ihren Pipelines funktionieren.
Modelltransparenz: Teams müssen verstehen, warum etwas gemeldet wurde, nicht nur, dass es gemeldet wurde.
Governance-Kompatibilität: Es sollte Nachweise liefern, die die Validierung, das Testen und die Überprüfung unterstützen.
Kontrolle über das Deployment: Achten Sie bei sensiblen Workloads auf eine Ausführung in der Private Cloud oder On-Premises.
Nutzerübergreifende Usability: Ingenieure, Analysten und Governance-Verantwortliche benötigen unterschiedliche Sichten auf dasselbe Problem.
Der letzte Punkt wird oft unterschätzt. Wenn nur ein einziger Spezialist das Tool bedienen kann, ist der Prozess nicht skalierbar.
Regulatorischer Druck verändert die Kaufentscheidung
Unter dem EU AI Act müssen Datensätze für KI-Systeme mit hohem Risiko über ihren gesamten Lebenszyklus hinweg so verwaltet werden, dass sie relevant, repräsentativ, fehlerfrei und vollständig bleiben (Analyse des EU AI Act). Das bedeutet, dass Anomalieerkennung, Bias-Prüfungen und der Umgang mit fehlenden Daten keine optionalen Extras sind. Sie sind Teil der Kontrollebene.
Eine Plattform mit In-Database-Ausführung kann hier helfen, da sie die Analyse nah an den Daten hält und den Nachweispfad sichert. Das ist besonders nützlich, wenn Compliance-Teams aufzeigen müssen, wie ein Datensatz überwacht wurde, anstatt nur zu behaupten, dass er „bereinigt“ wurde.
Ein praktischer Ansatz besteht darin, mit einem Feed zu beginnen, der bereits für den Umsatz, die Compliance oder das Kundenerlebnis von Bedeutung ist. Beweisen Sie, dass das System verspätete Eingänge, Schema-Änderungen oder Volatilitätsschwankungen erkennen kann, bevor sie für das Unternehmen sichtbar werden, und bauen Sie darauf auf. Das ist jedes Mal besser als ein überstürzter, flächendeckender Rollout.
Ihre nächsten Schritte hin zu einem intelligenten Daten-Monitoring
Der wichtigste Wandel zeichnet sich bereits ab. KI-Datenqualität ist keine dekorative Schicht auf alten Regeln, sondern das Betriebsmodell für Daten, die sich zu schnell verändern, um sie manuell zu überwachen. Organisationen, die dies richtig angehen, streiten sich nicht mehr darüber, ob jede einzelne Zeile perfekt ist, sondern konzentrieren sich darauf, ob die Pipeline vertrauenswürdig, erklärbar und auditbereit ist.
Wenn Sie das Thema nächste Woche vorantreiben möchten, halten Sie es einfach:
Wählen Sie eine besonders wertvolle Pipeline aus und listen Sie die Qualitätsmängel auf, die Entscheidungen beeinträchtigen.
Testen Sie, wie Ihre aktuellen Tools mit unbekannten Anomalien umgehen, nicht nur mit bekannten Regelverstößen.
Bringen Sie Observability in die Governance-Diskussion ein, damit Compliance, Engineering und Analytics auf dieselben Nachweise blicken.
Für einen praktischen Einstieg prüfen Sie dignas Tools zur Überwachung der Datenqualität und gleichen Sie diese mit Ihren aktuellen Vorfallsmustern, Ihren Deployment-Einschränkungen und Ihren Audit-Anforderungen ab. Nehmen Sie diese engere Auswahl dann mit einer klaren Frage in Ihre nächste Überprüfung der Datenplattform: Kann dieses Setup das Vertrauen in die Daten sichern, ohne das Unternehmen auszubremsen?
Ein CTA für digna.
Wie gelernte Baselines, Timeliness- und Schema-Monitoring in der Kundenumgebung statt in einer Anbieter-Cloud zusammenwirken, zeigt digna für Data Platform Observability.
Häufig gestellte Fragen
Was ist KI-gestützte Datenqualität?
KI-gestützte Datenqualität ist ein Monitoring, das die normalen Muster einer Pipeline über Zeit, Volumen, Verteilung, Saisonalität und Feldbeziehungen lernt und Abweichungen meldet, selbst wenn Werte feste Schwellenwerte bestehen. Der Artikel vergleicht sie mit einem intelligenten Sicherheitssystem fürs Haus, klassische Prüfungen dagegen mit einer Autoalarmanlage mit nur einer Aufgabe.
Welche Dimensionen definieren Datenqualität für KI?
Laut der im Artikel zitierten FRA-Definition umfasst Datenqualität für KI Vollständigkeit, Genauigkeit, Konsistenz, Aktualität, Duplikate, Gültigkeit, Verfügbarkeit und Herkunft. Das erweitert den Blick: Ein Datensatz kann im engen Sinne korrekt und dennoch unbrauchbar sein, wenn er zu spät eintrifft, keine Herkunftsangaben hat oder sich verschoben hat.
Ersetzt KI regelbasierte Datenqualitätsprüfungen?
Nein, KI ergänzt feste Regeln, statt sie zu ersetzen. Prüfungen wie „Ist Spalte X null?“ oder „Ist Wert Y größer als null?“ bleiben nützlich, erfassen aber nur Bedingungen, die Sie bereits kodiert haben. Gelerntes Monitoring deckt zusätzlich unbekannte Anomalien ab, etwa einen pünktlichen Feed mit veränderter Verteilung.
Was verlangt der EU AI Act an Datenqualität für Trainingsdaten?
Nach dem EU AI Act müssen Datensätze für Hochrisiko-KI-Systeme über ihren gesamten Lebenszyklus so gesteuert werden, dass sie relevant, repräsentativ, fehlerfrei und vollständig bleiben. Der Artikel folgert daraus, dass Anomalieerkennung, Bias-Prüfungen und der Umgang mit fehlenden Daten Teil der Kontrollebene werden und keine optionalen Extras sind.
Wie sollte ein Unternehmen mit KI-gestützter Datenqualität beginnen?
Beginnen Sie eng: Wählen Sie eine kritische Pipeline, einen fachlichen Konsumenten und eine Reihe von Qualitätsfragen, die bereits Probleme verursachen. Weisen Sie nach, dass das System verspätete Lieferungen, Schemaänderungen oder Volatilitätsverschiebungen erkennt, bevor das Business sie bemerkt, und prüfen Sie dann Integrationstiefe, Modelltransparenz, Governance-Eignung, Deployment-Kontrolle und Nutzbarkeit für verschiedene Rollen.



