Dimensionen der Datenqualität: Die 9 Kernmetriken erklärt
|
10
min. Lesezeit

Datenqualität wird in der DAMA-DMBOK® 2.0 Revised Edition durch neun Standarddimensionen definiert, nicht durch eine einzige universelle Bewertung. Ein Datensatz erfüllt seinen Zweck erst dann, wenn die relevanten Dimensionen wie Genauigkeit, Vollständigkeit, Konsistenz, Aktualität, Integrität, Timeliness, Eindeutigkeit, Gültigkeit und Angemessenheit den Anforderungen der Nutzer entsprechen.
Der kontraintuitive Teil ist, dass genaue Daten dennoch unbrauchbar sein können. Ein Kundendatensatz kann der Realität entsprechen, aber erst nach einer Kampagnenentscheidung eintreffen, oder eine vollständige Tabelle kann im Widerspruch zu den Quellsystemen stehen, auf die sich die Geschäftsteams verlassen. Datenqualität ist das Maß dafür, wie gut Daten ihren beabsichtigten Zweck erfüllen, bewertet über mehrere verschiedene Dimensionen hinweg und nicht über eine einzelne Bewertung.
Inhaltsverzeichnis
Definition von Datenqualität in modernen Data Stacks
Datenqualität beschreibt, ob Daten für einen bestimmten geschäftlichen, analytischen, operativen oder regulatorischen Zweck geeignet sind. Ein Finanzteam benötigt möglicherweise hochpräzise und konsistente Transaktionsdaten für die Berichterstattung, während ein Betriebsteam eher darauf achtet, ob Ereignisse pünktlich eintreffen und ob jeder erforderliche Datensatz vorhanden ist. Keines der Teams kann Qualität unabhängig von der Entscheidung definieren, die durch die Daten unterstützt wird.
Qualität als eine einzige Zahl zu behandeln, maskiert diese Unterschiede. Eine Warehouse-Tabelle kann eine Genauigkeitsprüfung bestehen, obwohl sie fehlende Datensätze, veraltete Werte, doppelte Kunden oder ungültige Formate enthält. Eine einzelne aggregierte Bewertung kann auch dazu führen, dass ein schwerwiegender Fehler hinter einer starken Leistung in nicht verwandten Bereichen verschwindet.
Warum eine einzige Bewertung fehlschlägt
Datenqualität ist ein multidimensionales Konstrukt. Analysen identifizieren Genauigkeit, Vollständigkeit, Konsistenz, Timeliness und Relevanz als die am häufigsten genannten Dimensionen, während breitere Frameworks auch Gültigkeit, Eindeutigkeit, Glaubwürdigkeit, Interpretierbarkeit und Sicherheit umfassen. Die praktische Konsequenz ist einfach: Ordnen Sie jede Kontrolle dem Fehlermodus zu, den sie verhindern soll, anstatt zu fragen, ob ein Datensatz „gut“ oder „schlecht“ ist (Review von Datenqualitätsdimensionen).
Für einen Dateningenieur bedeutet das zu prüfen, ob die erforderlichen Ladeprozesse abgeschlossen wurden, ob Werte den Typen und Bereichen entsprechen und ob Datensätze systemübergreifend übereinstimmen. Für einen Analysten kann es bedeuten, zu bestätigen, dass eine Metrik eine stabile Definition und ein zuverlässiges Aktualisierungsmuster aufweist. Für einen Geschäftsinhaber ist die zentrale Frage, ob die Daten eine Entscheidung unterstützen, ohne ein unakzeptables Risiko darzustellen.
Praktische Regel: Beginnen Sie mit der Entscheidung und definieren Sie dann die Dimensionen, die diese Entscheidung scheitern lassen können.
Moderne Stacks erschweren die Verwaltung dieses Kontexts, da sich Daten durch Datenbanken, APIs, ETL- und ELT-Pipelines, Warehouses, Dashboards und KI-Feature-Stores bewegen. Jede Übergabe kann einen anderen Fehler verursachen. Ein Quellsystem kann ein Feld als Pflichtfeld erzwingen, während eine nachgelagerte Transformation es in eine Nullable-Spalte umwandelt, oder ein verspätetes Ereignis ist zwar technisch gültig, aber für ein zeitkritisches Dashboard irrelevant.
Teams, die über Cloud-Warehouses und Unternehmensintegrationen hinweg arbeiten, können auch davon profitieren zu verstehen, wie Implementierungspartner an die Plattformarchitektur herangehen. Zum Beispiel bietet die Snowflake-Partnerschaft von Faberwork LLC einen nützlichen Kontext für Organisationen, die Datenplattformen entwerfen, bei denen Qualitätskontrollen über Ingestions-, Transformations- und Konsumschichten hinweg funktionieren müssen.
Das Framework der 9 Dimensionen der Datenqualität
Was sind die 9 Dimensionen der Datenqualität? Die DAMA-DMBOK® 2.0 Revised Edition identifiziert neun Standarddimensionen mit breiter Zustimmung: Genauigkeit, Vollständigkeit, Konsistenz, Aktualität, Integrität, Timeliness, Eindeutigkeit, Gültigkeit und Angemessenheit. Die Revision fügt dem früheren Set aus acht Dimensionen die Aktualität (Currency) hinzu und verwendet Angemessenheit (Reasonableness) anstelle von Reasonability (DAMA-DMBOK® 2.0 Revisionsdetails).
Nutzen Sie die Tabelle als Arbeitsreferenz und nicht als Ersatz für den geschäftlichen Kontext. Jede Dimension beschreibt eine andere Art und Weise, wie Daten fehlerhaft sein können.
Dimension | Definition | Unternehmensbeispiel |
|---|---|---|
Genauigkeit (Accuracy) | Daten stellen das reale Objekt, Ereignis oder den Wert, den sie beschreiben, korrekt dar. | Die Postanschrift eines Kunden stimmt mit der Adresse in einer vertrauenswürdigen operativen Quelle überein. |
Vollständigkeit (Completeness) | Erforderliche Datensätze, Felder und Werte sind für den beabsichtigten Gebrauch vorhanden. | Jede genehmigte Finanztransaktion enthält eine Kontokennung, einen Betrag und ein Buchungsdatum. |
Konsistenz (Consistency) | Daten widersprechen sich nicht über Systeme, Tabellen, Datensätze oder definierte Geschäftsregeln hinweg. | Das Warehouse und die Abrechnungsdatenbank klassifizieren dasselbe Konto mit demselben Kundenstatus. |
Aktualität (Currency) | Daten spiegeln den aktuellen Zustand des realen Objekts oder Prozesses wider. | Ein Bestandsdatensatz spiegelt den neuesten bekannten Lagerbestand und nicht einen älteren Zustand wider. |
Integrität (Integrity) | Beziehungen zwischen Datenelementen bleiben gültig und logisch kohärent. | Jede Bestellposition verweist über gültige Beziehungen auf einen vorhandenen Bestell- und Produktdatensatz. |
Timeliness | Daten werden innerhalb des für den beabsichtigten Zweck angemessenen Zeitraums verfügbar. | Ein Risiko-Dashboard erhält den erforderlichen Transaktions-Feed, bevor die geschäftliche Überprüfung beginnt. |
Eindeutigkeit (Uniqueness) | Jedes reale Objekt erscheint nur einmal, wenn eine Duplizierung den Anwendungsfall verzerren würde. | Ein Kundenstamm enthält einen gesteuerten Datensatz für jede Kundeneinheit. |
Gültigkeit (Validity) | Werte entsprechen ihrem definierten Typ, Format, Bereich, ihrer Domäne oder Regel. | Ein Transaktionsstatus gehört zum zulässigen Status-Set und ein Betrag verwendet den erwarteten numerischen Typ. |
Angemessenheit (Reasonableness) | Werte und Beziehungen sind im Kontext plausibel und verletzen kein erwartetes Geschäftsverhalten. | Eine Verkaufsmenge ist technisch gültig, wird jedoch markiert, weil sie für den Produkt- und Bestellkontext unplausibel ist. |
Die Unterschiede sind bei der Diagnose von Bedeutung. Eine fehlende Kundenkennung ist ein Vollständigkeitsproblem, während eine Kennung mit einem ungültigen Format ein Gültigkeitsproblem ist. Ein duplizierter Kunde ist ein Eindeutigkeitsproblem, während ein mit dem falschen Konto verknüpfter Kunde auf einen Integritäts- oder Genauigkeitsfehler hinweisen kann.
Verknüpfen Sie bei der Implementierung jede Dimension mit einer Metrik und einer Aktion. Eine Vollständigkeitsprüfung kann fehlende erforderliche Werte zählen, eine Eindeutigkeitsprüfung kann unerwartete Duplikate identifizieren und eine Gültigkeitsprüfung kann Datentypen, Formate, Klassen und Bereiche testen. Teams, die nach weiteren praktischen Maßnahmen suchen, können diese Beispiele für Datenqualitätsmetriken als Ausgangspunkt für den Entwurf eigener Kontrollen nutzen.
Wie Dimensionen interagieren und Kompromisse erfordern
Datenqualitätsdimensionen wirken nicht unabhängig voneinander. Die Verbesserung einer Dimension kann die Einhaltung einer anderen erschweren, insbesondere wenn Pipelines feste Lieferfenster oder eine ungleichmäßige Quellqualität aufweisen.
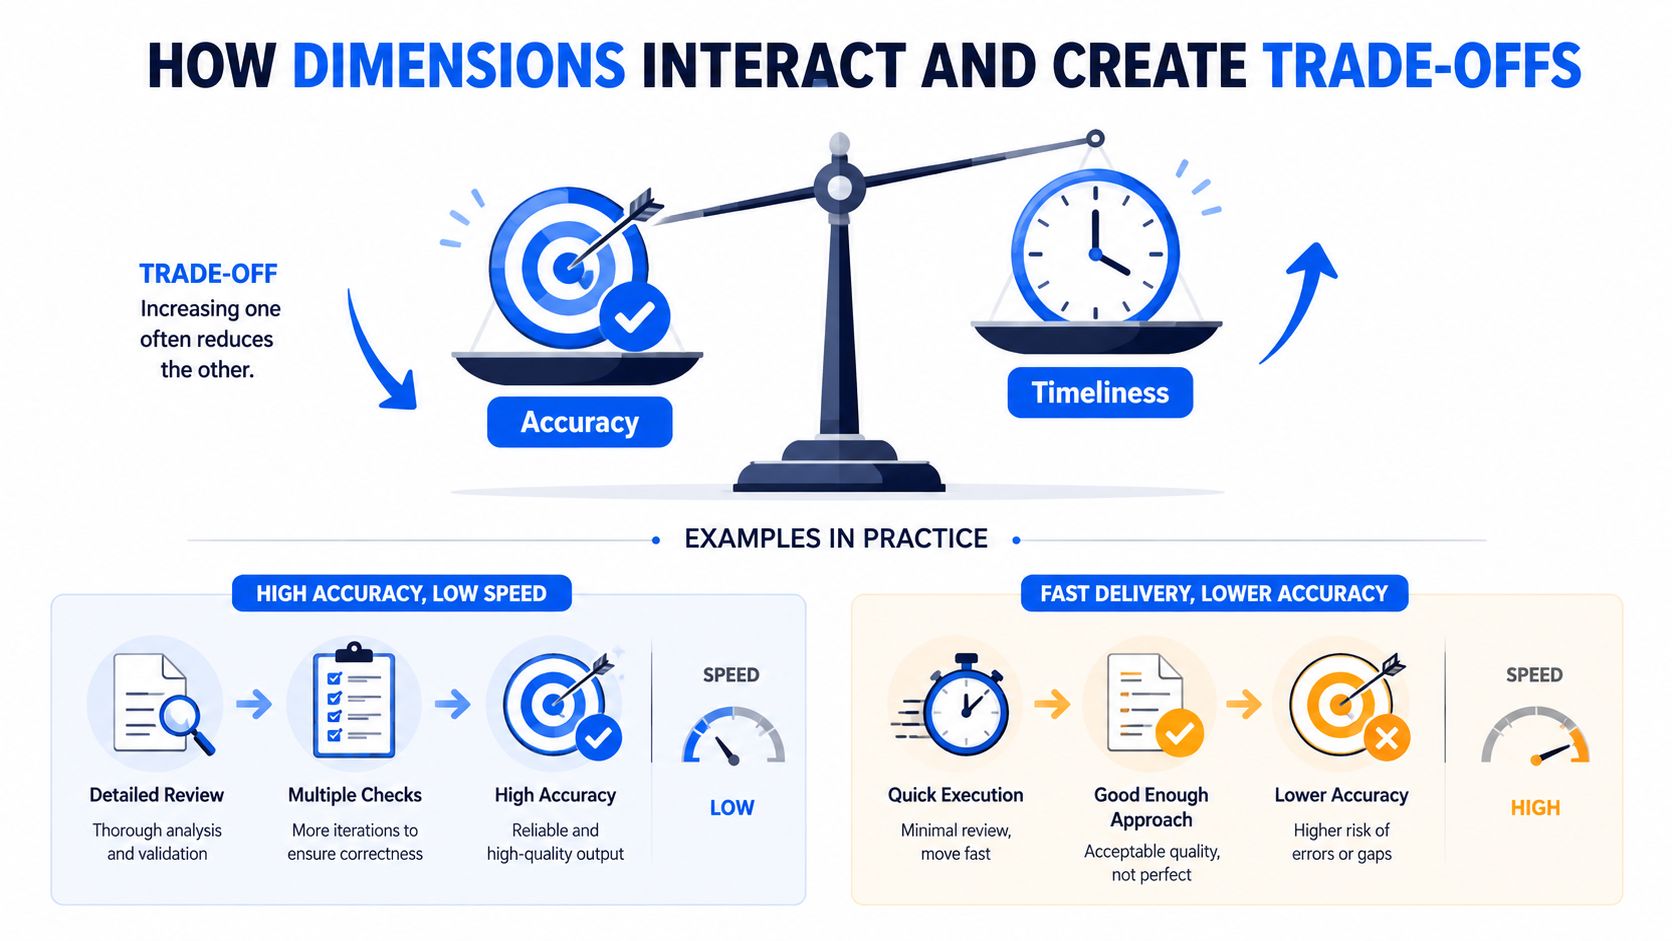
Betrachten Sie einen Warehouse-Ladeprozess, der den ganzen Tag über Kundentransaktionen empfängt. Ein Engineering-Team kann die Veröffentlichung verzögern, bis die Abstimmung Diskrepanzen behebt, was die Genauigkeit und Konsistenz verbessert. Die Verzögerung kann dazu führen, dass ein Dashboard sein Entscheidungsfenster verpasst, was die Timeliness und Aktualität (Currency) verringert. Die sofortige Veröffentlichung sichert die Frische, kann jedoch unvollständige oder widersprüchliche Datensätze offenlegen.
Häufige Konflikte in der Produktion
Genauigkeit versus Timeliness ist der deutlichste Kompromiss. Ein regulatorischer Bericht kann es rechtfertigen, Daten zurückzuhalten, bis die Abstimmung abgeschlossen ist, während ein Betrugsüberwachungs-Workflow möglicherweise ein unvollkommenes, aber sofortiges Signal benötigt. Treffen Sie die Entscheidung basierend auf den Konsequenzen des Wartens und des Handelns auf der Grundlage vorläufiger Daten.
Gültigkeit versus Vollständigkeit kann bei der Ingestion in Konflikt geraten. Eine strenge Regel kann fehlerhafte Werte abweisen und nachgelagerte Konsumenten vor ungültigen Daten schützen. Die Ablehnung kann dazu führen, dass die Zieltabelle unvollständig bleibt, es sei denn, die Pipeline stellt die Datensätze unter Quarantäne, meldet den Fehler und bietet einen Korrekturpfad an.
Konsistenz versus Quellautonomie schafft ein weiteres Spannungsfeld. Die Standardisierung des Kundenstatus über ein CRM, eine Abrechnungsplattform und ein Warehouse verbessert die Konsistenz, aber jedes System nutzt dieses Feld möglicherweise für einen legitimen lokalen Zweck. Eine gesteuerte kanonische Definition, gepaart mit dokumentierten systemspezifischen Attributen, kann besser funktionieren, als überall Einheitlichkeit zu erzwingen.
Eine Pipeline im Finanzdienstleistungsbereich wird in der Regel Genauigkeit, Konsistenz, Vollständigkeit und Integrität für geschäftskritische Berichte priorisieren. Ein E-Commerce-Personalisierungs-Feed priorisiert möglicherweise Timeliness und Aktualität, während er eine kontrollierte, verspätete Anreicherung zulässt. Keines dieser Prioritäten-Sets gilt für jeden Anwendungsfall.
Auch die Architektur verändert den Kompromiss. Batch-Pipelines können eine vollständige Lieferung zur Abstimmung zurückhalten, während Streaming-Systeme häufig vorläufige Ereignisse veröffentlichen und diese später korrigieren. Diese Korrekturen erfordern, dass Konsumenten Aktualisierungen, Rücknahmen und den Datensatzstatus verstehen.
Ein sinnvolles Qualitätsziel sind nicht „perfekte Daten“. Es sind Daten, die für eine definierte Entscheidung zuverlässig genug sind, mit bekannten Ausnahmen und verantwortlichen Eigentümern.
Überwachen Sie Dimensionen separat. Ein Datensatz kann genau, aber verspätet sein, oder vollständig, aber inkonsistent über Quellsysteme hinweg. Eine einzige aggregierte Bewertung kann den Fehler verbergen, auf den es am meisten ankommt. Separate Metriken zeigen den Kompromiss auf, anstatt ihn wegzumitteln.
Von statischen Regeln zu KI-gestützter Observability
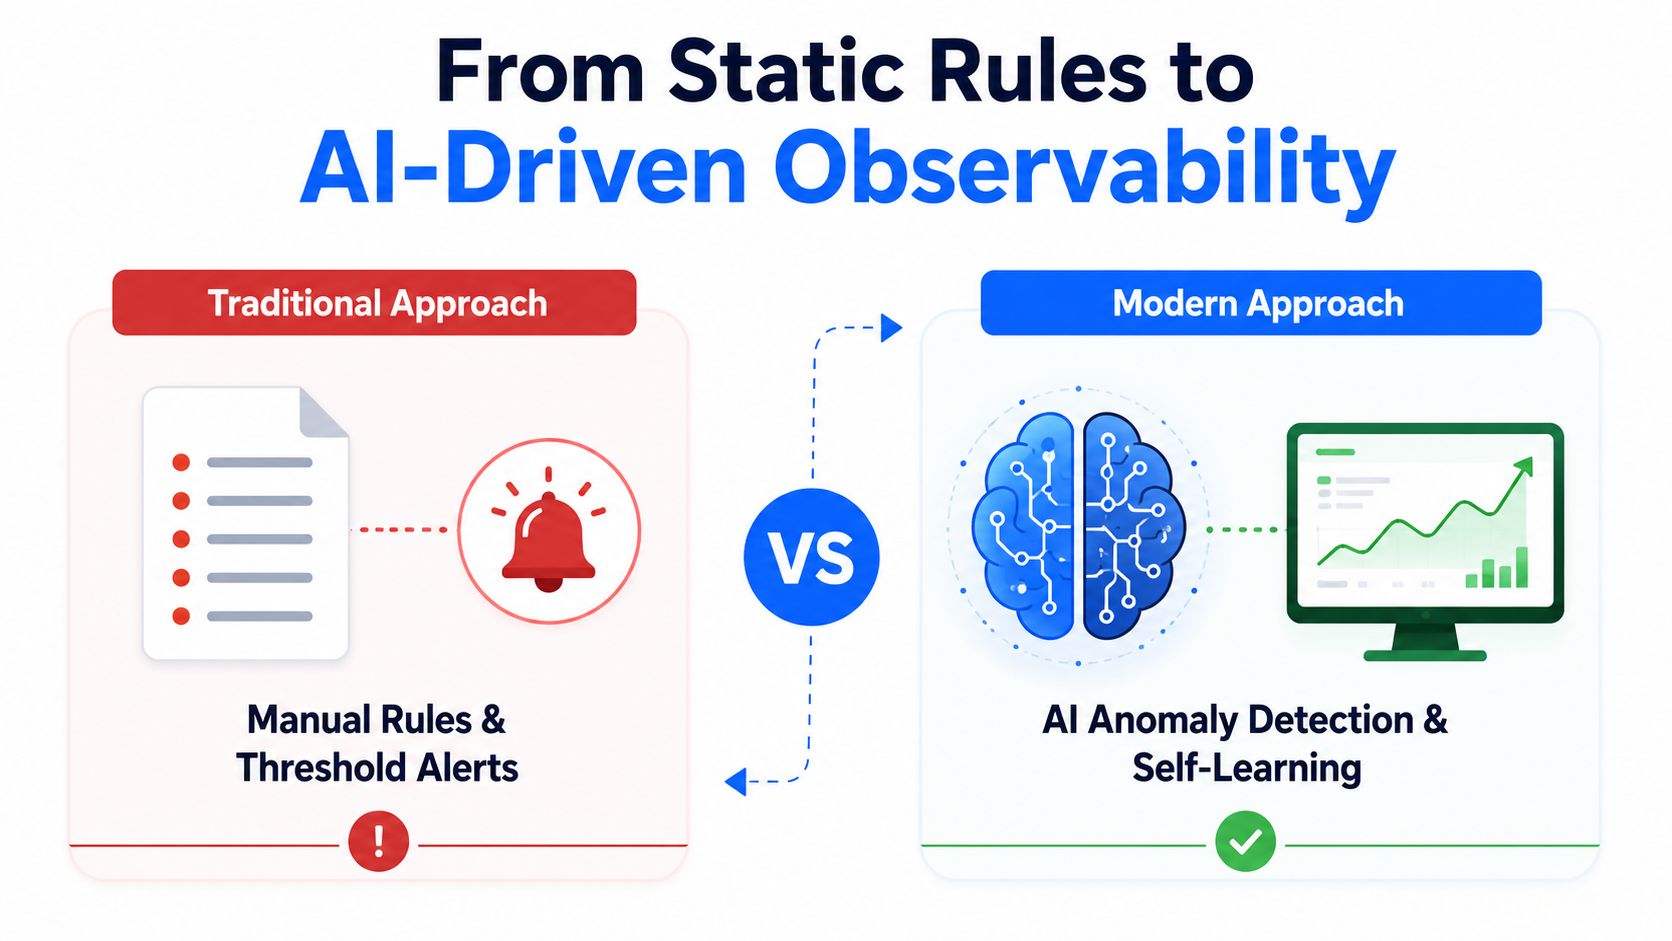
Die traditionelle Datenqualitätsüberwachung hängt von manuell geschriebenen SQL-Tests, festen Schwellenwerten und Warnmeldungen ab, die für bekannte Fehlermodi konfiguriert sind. Diese Kontrollen bleiben wertvoll. Eine Regel, die eine Nicht-Null-Kontokennung erfordert oder einen ungültigen Status ablehnt, ist explizit, prüfbar und leicht zu erklären.
Die Schwachstelle zeigt sich bei der Skalierung. Ingenieure müssen Regeln anpassen, wenn sich Schemata, Quellen, Geschäftsprozesse und akzeptable Bereiche ändern. Feste Schwellenwerte können zudem zu einer Alarmmüdigkeit führen, wenn normale saisonale oder operative Schwankungen wiederholt Warnungen auslösen. Regelbasierte Prüfungen erkennen das, was Teams vorhergesehen haben, aber sie übersehen möglicherweise ungewöhnliche Verschiebungen bei Verteilungen, Volumina oder Beziehungen, die niemand codiert hat.
Was Observability ergänzt
Moderne Observability kombiniert deterministische Kontrollen mit historischen Baselines, Anomalieerkennung, Lineage-Kontext und Incident-Workflows. Anstatt nur zu fragen, ob ein fest codierter Schwellenwert überschritten wurde, kann die Plattform bewerten, ob das aktuelle Verhalten vom etablierten Muster des Datensatzes abweicht.
Dieser Ansatz ist besonders nützlich für Metriken wie Zeilenanzahlen, Wertverteilungen, Null-Verhalten und Bereitstellungszeiten. Er ersetzt keine Geschäftsregeln. Er ergänzt sie, indem er unerwartetes Verhalten abdeckt, das eine statische Validierung möglicherweise nicht vorhersieht. Teams, die sich mit KI-Observability befassen, können auch Doczens Erklärung zu AI Observability heranziehen, um Kontext zur Überwachung von KI-bezogenen Systemen und Datenverhalten zu erhalten.
Der Markt dehnt sich auch über strukturierte Warehouse-Tabellen hinaus aus. Eine Branchenstudie aus dem Jahr 2025 berichtete, dass 62 % der Organisationen semistrukturierte Daten untersuchten, 28 % diese aktiv nutzten und 60 % unstrukturierte Dokumente evaluierten (Trends der Data Observability 2025). Dieselbe Quelle berichtete von einer Observability-Reife von 88 % in Nordamerika im Vergleich zu 47 % in Europa, was zeigt, dass die Einführung in den verschiedenen Regionen ungleichmäßig verläuft.
Protokolle, Dokumente, Ereignisströme und multimodale KI-Korpora erfordern unterschiedliche Interpretationen von Vollständigkeit und Konsistenz. Bei einer Dokumentensammlung kann Vollständigkeit erwartete Dateien, extrahierbare Felder oder nutzbaren Text umfassen. Bei einem Ereignisstrom kann die Timeliness eher von den Eingangsmustern als von einer täglichen Tabellenaktualisierung abhängen.
Teams können den Überblick über Data Observability von digna nutzen, um zu verstehen, wie sich eine kontinuierliche Überwachung in Validierung, Anomalieerkennung, Timeliness-Tracking und Schema-Überwachung einfügt. Ein starkes Design behält explizite Regeln für bekannte Anforderungen bei und nutzt gelerntes Verhalten, um Abweichungen zu identifizieren, die eine Untersuchung wert sind.
Auswahl der richtigen Dimensionen für Ihren Anwendungsfall
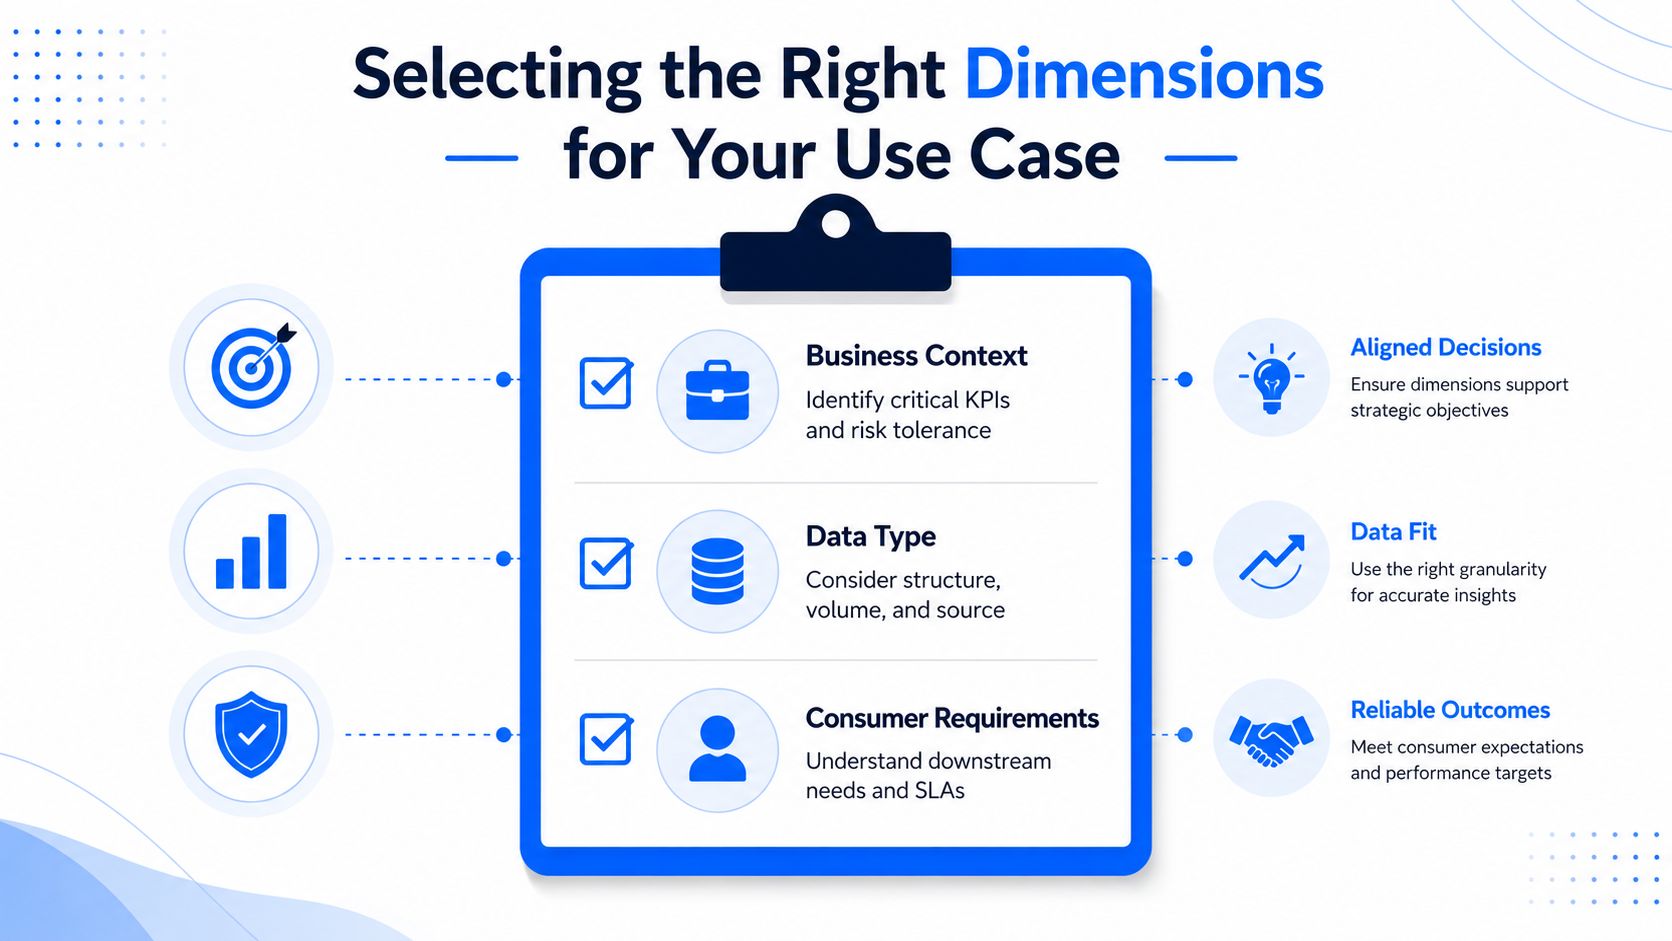
Wie sollte ein Team zwischen den Dimensionen der Datenqualität wählen? Beginnen Sie mit der geschäftlichen Entscheidung, identifizieren Sie die Datenelemente, die diese beeinflussen, verstehen Sie, wie sich die Daten durch die Architektur bewegen, und priorisieren Sie dann die Fehlermodi mit den größten operativen, regulatorischen oder finanziellen Konsequenzen.
Eine Umfrage aus dem Jahr 2025 argumentiert, dass der Bereich breiter und kontextspezifischer ist als eine statische Checkliste. Sie fügt Dimensionen wie Barrierefreiheit, Compliance, Reputation, Portabilität und Aktualität hinzu und weist gleichzeitig darauf hin, dass praktische Anleitungen zu Kompromissen und Prioritätensetzungen weiterhin begrenzt sind (Umfrage zu Datenqualitätsdimensionen).
Eine praktische Priorisierungsmethode
Regulatorische Berichterstattung beginnt in der Regel mit Genauigkeit, Vollständigkeit, Konsistenz und Integrität. Das Team sollte das führende System (Source of Record) identifizieren, Schlüsselsummen abgleichen, zulässige Werte validieren und Nachweise über Ausnahmen aufbewahren. Timeliness ist zwar immer noch wichtig, aber das akzeptable Lieferfenster wird möglicherweise eher durch den Berichterstattungsprozess als durch Echtzeit-Operationen definiert.
Echtzeit-Analysen legen mehr Gewicht auf Timeliness und Aktualität (Currency). Ein Dashboard, das aktuelle Betriebsbedingungen anzeigt, kann irreführend werden, wenn der Feed verzögert ist, selbst wenn jeder gelieferte Datensatz genau ist. Vollständigkeit und Konsistenz bleiben wichtig, insbesondere wenn Benutzer Live-Metriken mit historischen Warehouse-Daten vergleichen.
Feature-Stores für KI und maschinelles Lernen benötigen starke Kontrollen für Gültigkeit, Eindeutigkeit, Timeliness und Integrität. Ungültige Feature-Werte können Transformationen stören oder Vorhersagen verzerren, Duplikate können Entitäten übergewichten und veraltete Features können das aktuelle Verhalten falsch darstellen. Die entsprechenden Prüfungen sollten den Feature-Definitionen und Bereitstellungserwartungen des Modells folgen.
Kritische Datenelemente (Critical Data Elements, CDEs) verdienen eine breitere Abdeckung als Attribute mit geringem Risiko. Ein CDE kann einen regulatorischen Bericht, einen Kundenidentitätsprozess, eine Finanzberechnung oder ein Modell-Feature unterstützen. Überwachen Sie dafür mehrere relevante Dimensionen, weisen Sie einen verantwortlichen Eigentümer zu und definieren Sie, was passiert, wenn eine Prüfung fehlschlägt.
Ein nützlicher erster Durchgang sieht so aus:
Den Konsumenten zuordnen: Identifizieren Sie, wer die Daten nutzt und welche Entscheidung davon abhängt.
Den Pfad nachverfolgen: Dokumentieren Sie die Quelldatenbank, ETL- oder ELT-Transformationen, Warehouse-Tabellen und nachgelagerte Produkte.
Den Fehler benennen: Wählen Sie Dimensionen basierend auf realistischen Fehlermodi und nicht nach einer generischen Checkliste aus.
Die Reaktion festlegen: Entscheiden Sie, ob Sie blockieren, unter Quarantäne stellen, warnen oder eine Ausnahme protokollieren möchten.
Schrittweise erweitern: Beginnen Sie mit den Datenelementen mit dem höchsten Risiko und erweitern Sie die Überwachung, wenn sich Eigentümerschaft und Erkenntnisse verbessern.
Für Teams, die messbare Kontrollen entwerfen, bieten die Datenqualitätsmetriken von digna einen relevanten Referenzpunkt, um Dimensionen mit operativen Messungen zu verknüpfen.
Implementierung einer kontinuierlichen Datenqualitätsüberwachung
Kontinuierliche Überwachung bedeutet, dass Qualitätsprüfungen durchgeführt werden, während sich Daten bewegen und verändern, anstatt auf ein periodisches Audit zu warten. Der Unterschied ist wichtig, da ein verspäteter Feed ein Dashboard oder einen Feature-Store vor der nächsten geplanten Überprüfung beeinträchtigen kann. Timeliness ist eine eigenständige technische Dimension, da Daten an geschäftlichem Wert verlieren, wenn sie nicht zum erwarteten Zeitpunkt verfügbar sind. Sie wird üblicherweise anhand von Lieferplänen, Latenzschwellenwerten oder Aktualitäts-SLAs bewertet und betrifft die Frage, ob Daten umgehend verarbeitet, aktuell und für die Aufgabe geeignet sind (Forschung zur Data Timeliness).
Ein praktischer Rollout kann mit einer hochwertigen Warehouse- oder Datenbankdomäne beginnen. Profilieren Sie deren normales Verhalten, beobachten Sie Bereitstellungsmuster und identifizieren Sie, welche Spalten und Tabellen geschäftskritische Workflows unterstützen. Fügen Sie von dort aus Kontrollen hinzu, die den Risiken entsprechen, anstatt zu versuchen, jedes Objekt auf einmal zu überwachen.
Ein modulares Betriebsmodell
Eine Plattform wie digna kann als ein Beispiel für einen modularen Ansatz dienen. Teams können mit Data Anomalies für das grundlegende Lernen beginnen und dann die Timeliness-Überwachung für fehlende oder verzögerte Ladeprozesse, Data Validation für Geschäftsregeln auf Datensatzebene und den Schema Tracker für hinzugefügte, entfernte oder geänderte Felder hinzufügen.
Die Implementierung sollte die Daten dort belassen, wo sie bereits liegen. Die In-Database-Ausführung ermöglicht es der Plattform, Metriken zu berechnen und Analysen innerhalb der Kundendatenbanken durchzuführen, was unnötige Datenbewegungen reduziert und Umgebungen mit strengen Sicherheitsanforderungen unterstützt. Die Bereitstellung kann in einer Private Cloud oder On-Premises erfolgen, je nach Infrastruktur- und governance-Modell der Organisation.
Kontinuierliche Überwachung benötigt auch operativen Kontext. Ein gemeinsames Dashboard sollte Warnungen mit der betroffenen Tabelle, der Pipeline, dem Eigentümer und dem nachgelagerten Konsumenten verknüpfen. Integrationen mit Schedulern, Katalogen und Kollaborations-Workflows helfen Teams, von der Erkennung zur Diagnose überzugehen, ohne einen separaten manuellen Prozess zu erstellen.
Die wichtigste Designentscheidung ist die Reaktionsrichtlinie. Eine fehlgeschlagene Gültigkeitsregel könnte ein Release blockieren, während eine ungewöhnliche Metrik eine Untersuchungswarnung auslösen kann. Eine fehlende Lieferung alarmiert möglicherweise einen Bereitschaftsingenieur bei einem kritischen Feed, generiert jedoch eine Benachrichtigung mit niedrigerer Priorität bei einem unwichtigen Datensatz. Überwachung funktioniert, wenn sie Menschen hilft zu handeln, und nicht, wenn sie einen ungefilterten Strom von Warnungen erzeugt.
Nutzen Sie dignas Funktionen zur Datenqualitätsüberwachung als Referenz dafür, wie Anomalieerkennung, Validierung, Timeliness und Schemakontrollen in einem laufenden Betriebsmodell kombiniert werden können.
Aufbau Ihrer Datenqualitätsstrategie
Datenqualitätsmanagement ist die fortlaufende Praxis des Definierens, Messens, Überwachens und Verbesserns der Datenqualität in einer Organisation. Es kombiniert technische Kontrollen mit Eigentümerschaft, Geschäftsdefinitionen, Incident-Response und governance.
Ein praktischer Fahrplan ist:
Den aktuellen Zustand auditieren: Profilieren Sie prioritäre Datenbanken, Warehouse-Tabellen, Pipelines und nachgelagerte Berichte.
CDEs identifizieren: Markieren Sie die Datenelemente, deren Ausfall Compliance, Umsatz, Betrieb, Kunden oder KI-Ergebnisse beeinträchtigen könnte.
Dimensionen priorisieren: Wählen Sie die Dimensionen aus, die zum Anwendungsfall und Risiko des jeweiligen CDE passen.
Überwachung implementieren: Kombinieren Sie explizite Validierung mit Anomalie-, Timeliness- und Schema-Überwachung.
Überprüfen und verbessern: Nutzen Sie Vorfälle und das Feedback von Stakeholdern, um Regeln, Schwellenwerte, Eigentümerschaft und Abdeckung zu verfeinern.
Die zentrale Erkenntnis ist einfach: Qualität ist multidimensional, priorisiert und kontinuierlich. Manuelle Regeln haben immer noch ihren Platz, aber sie benötigen Kontext, Eigentümerschaft und eine Überwachung, die sowohl bekannte Verstöße als auch unerwartetes Verhalten erkennen kann.
digna bietet eine Plattform für Datenqualität und Data Observability in Unternehmen, um das Datenverhalten zu überwachen, Datensätze zu validieren, die Timeliness zu verfolgen, Schemaänderungen zu erkennen sowie Geschäfts- und Plattformmetriken innerhalb der eigenen Umgebung des Kunden zu analysieren. Besuchen Sie digna, um einen modularen Ansatz für die kontinuierliche Überwachung von Warehouses, Lakes, Datenbanken und Pipelines zu entdecken.


