Leitfaden zur Verbesserung der Datenqualität für Enterprise-Teams
|
6
min. Lesezeit

Ein vierteljährliches Umsatz-Dashboard kann vollkommen gesund aussehen, während es wochenlang die EMEA-Buchungen überbewertet. Ein Anbieter-Upgrade ändert eine Quellsystem-Währungsspalte, Nullwerte fließen in das Warehouse und eine nachgelagerte Transformation interpretiert die fehlenden Werte fälschlicherweise. Die Finanzabteilung entdeckt das Problem während der Vorbereitung der Vorstandssitzung, nachdem Analysten bereits Berichte in Umlauf gebracht haben und Führungskräfte auf dieser Grundlage Entscheidungen getroffen haben.
Dieser Vorfall ist nicht in erster Linie ein Dashboard-Problem. Es handelt sich um ein Versagen bei der data quality improvement, das Schemakontrolle, Timeliness, Eigentumsverhältnisse und die Reaktion auf Vorfälle betrifft. Die Lösung ist nicht ein weiterer isolierter Kauf von Monitoring-Tools. Es ist ein Betriebsmodell, das definiert, was vertrauenswürdige Daten bedeuten, den Teams, die sie erstellen, die Verantwortung zuweist, Defekte nahe an ihrem Ursprung erkennt und misst, wie schnell das Unternehmen das Vertrauen wiederherstellt.
Inhaltsverzeichnis
Warum die meisten Datenqualitätsprogramme ins Stocken geraten, bevor sie überhaupt beginnen
Das Tool ist selten das Betriebsmodell
Die Abdeckung muss über die Vollständigkeit hinausgehen
Beurteilung Ihres aktuellen Datenqualitätszustands
Erstellen Sie die Baseline aus vier Nachweisquellen
Erstellen Sie eine messbare Reifegrad-Momentaufnahme
Definition von SLAs und KPIs, die tatsächlich Bestand haben
Datensätze nach Konsequenzen priorisieren
Frühzeitige Signale von Ergebnismessungen trennen
Validation, Anomaly Detection, Timeliness und Schema-Kontrollen
Passen Sie die Kontrolle an den Defekt an
In-Database-Ausführung, Workflow-Integration und Runbooks
Signale in bestehende Arbeitsabläufe leiten
Das Runbook ausführbar machen
Organisation von Teams, Eigentumsrechten und Betriebszyklen
Rollen trennen
Meetings in Artefakte verwandeln
Messung des ROI und Ihre ersten 90 Tage
Operative Verluste in einen Business Case umwandeln
Nutzen Sie eine fokussierte 90-Tage-Sequenz
Warum die meisten Datenqualitätsprogramme ins Stocken geraten, bevor sie überhaupt beginnen
Die erste Reaktion auf einen Vorfall wie das EMEA-Beispiel ist oft vorhersehbar. Jemand schlägt eine Datenqualitätsplattform vor, ein anderes Team erstellt ein Dashboard mit Nullwert-Raten und ein Center of Excellence veröffentlicht Standards, die die Erzeuger nie zu Gesicht bekommen. Die Organisation schafft sichtbare Aktivität, ohne die Bedingungen zu ändern, die den Defekt überhaupt erst zugelassen haben.
Das Tool ist selten das Betriebsmodell
Ein Qualitätstool kann Metriken berechnen, Regeln ausführen und Warnungen weiterleiten. Es kann nicht entscheiden, ob das Finanzteam oder das Team für kommerzielle Systeme Eigentümer des Währungsfeldes ist. Es kann auch nicht bestimmen, ob ein fehlender Wert einen Ladevorgang blockieren, betroffene Datensätze unter Quarantäne stellen oder eine Warnung auslösen soll, während die Verarbeitung fortgesetzt wird.
Diese Entscheidung erfordert eine dokumentierte Vereinbarung zwischen Erzeugern und Konsumenten. Ohne diese diskutieren die Teams nach dem Vorfall über Warnmeldungen, anstatt sich im Vorfeld auf ein akzeptables Verhalten zu einigen. Eine nützliche Übersicht über strukturelle Ursachen bietet diese Analyse, warum Datenqualitätsprojekte scheitern, insbesondere im Hinblick auf die Unterscheidung zwischen technischen Symptomen und organisatorischen Ursachen.
Die Abdeckung muss über die Vollständigkeit hinausgehen
Nullwert-Raten sind nützlich, aber eine Tabelle kann vollständig und dennoch falsch sein. Ein Feed kann zu spät eintreffen, ein geändertes Schema enthalten, einen ungültigen Währungscode verwenden oder doppelte Business Keys einführen. Teams, die nur die Vollständigkeit messen, wiegen sich in einer falschen Sicherheit, da sie nur eine Dimension überprüfen, während sie das Entscheidungsfenster und die Bedeutung der Daten ignorieren.
Ein funktionierendes Programm weist den Risiken, auf die es ankommt, Kontrollen zu:
Standards: Definitionen, akzeptierte Werte, Eigentumsrechte und Änderungsverfahren.
Rechenschaftspflicht: Namentlich genannte Erzeuger und Datenverantwortliche (Stewards) mit der Befugnis, Defekte zu beheben.
Feedback: Warnmeldungen, Tickets, Retrospektiven und Pipeline-Änderungen, die ein erneutes Auftreten verhindern.
Qualität benötigt auch eine wirtschaftliche Perspektive. Die Zusammenfassung des IBM Institute for Business Value berichtete, dass 43 % der Chief Operations Officers Datenqualitätsprobleme als ihre wichtigste Datenpriorität identifizierten. Mehr als ein Viertel der Unternehmen meldete jährliche Verluste von über 5 Millionen USD, während 7 % Verluste von 25 Millionen USD oder mehr verzeichneten. Diese Zahlen erklären, warum Qualität in operative Reviews gehört und nicht nur in die Backlogs der Entwicklung.
Die praktische Maßeinheit für Fortschritt ist der Zyklus vom Vorfall bis zur Behebung. Ein Programm funktioniert, wenn es Fehler früher erkennt, sie dem richtigen Eigentümer zuweist, die nachgelagerten Auswirkungen begrenzt und jede Erkenntnis nach einem Vorfall in eine stärkere Pipeline-Kontrolle umwandelt.
Beurteilung Ihres aktuellen Datenqualitätszustands
Beginnen Sie mit Fakten, nicht mit dem Frust der Stakeholder. Oft heißt es, man vertraue einem Datensatz nicht, aber diese Wahrnehmung spiegelt möglicherweise nur eine Handvoll sichtbarer Vorfälle, unklare Definitionen oder messbare Defekte wider. Ihre Baseline sollte alle drei Aspekte erfassen.
Erstellen Sie die Baseline aus vier Nachweisquellen
Erstens: Betreiben Sie Vorfalls-Archäologie. Exportieren Sie die datenbezogenen Tickets der letzten sechs Monate aus Jira oder ServiceNow. Clustern Sie jedes Ticket nach Domäne, betroffenem Datensatz, Defekttyp, Fehlerursache (Root Cause), Zeit bis zur Erkennung, Zeit bis zur Behebung und der Frage, ob dasselbe Problem schon einmal aufgetreten ist. Verwerfen Sie keine „kleinen“ Tickets. Wiederholte manuelle Korrekturen weisen oft auf eine Prozessschwäche hin, die später zu einem größeren Ausfall führt.
Zweitens: Profilieren Sie kritische Tabellen automatisch. Untersuchen Sie Nullwert-Raten, eindeutige Kardinalität, Minimal- und Maximalwerte, doppelte Schlüssel, referenzielle Integrität und Verteilungsänderungen. Vergleichen Sie gegebenenfalls Quell- und Zielzahlen, aber betrachten Sie übereinstimmende Zeilenanzahlen nicht als Beweis für die Richtigkeit. Eine Transformation kann das Datenvolumen beibehalten, während sie die Werte verfälscht.
Drittens: Befragen Sie Erzeuger und Konsumenten getrennt voneinander. Fragen Sie die Erzeuger, welche Felder sie als ihr Eigentum betrachten, und die Konsumenten, ob die Daten für ihre Entscheidungen geeignet sind. Erfassen Sie qualitative Vertrauenswerte zusammen mit Nutzungsmustern, kritischen Berichten, Modellen und operativen Arbeitsabläufen. Ein viel genutzter Datensatz mit geringem Vertrauen verdient Priorität, selbst wenn seine Vorfallshistorie unauffällig ist.
Viertens: Klassifizieren Sie Defekte anhand der sechs Dimensionen. Verwenden Sie Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Gültigkeit und Eindeutigkeit als gemeinsames Vokabular. Das Datenqualitäts-Reifegradmodell kann Teams dabei helfen, verstreute Beobachtungen in eine wiederholbare Baseline statt in einen einmaligen Workshop zu verwandeln.
Erstellen Sie eine messbare Reifegrad-Momentaufnahme
Bewerten Sie jede Dimension auf einer Skala von 1 bis 5 anhand klarer Nachweise. Eine niedrige Punktzahl kann bedeuten, dass das Unternehmen über keine gemeinsame Definition oder wiederholbare Messung verfügt. Eine mittlere Punktzahl könnte auf automatisierte Prüfungen, aber inkonsistente Eigentumsrechte hinweisen. Eine hohe Punktzahl sollte dokumentierte Schwellenwerte, überwachte Kontrollen, verantwortliche Eigentümer, eine Vorfallshistorie und regelmäßige Verbesserungen voraussetzen.
Dimension | Primäre Metrik | Stichproben-Ansatz | Typische Erkennungsquelle |
|---|---|---|---|
Genauigkeit | Übereinstimmung mit einer maßgeblichen Quelle oder einem verifizierten Ergebnis | Vergleich kritischer Felder mit Quellaufzeichnungen oder genehmigten Referenzdaten | Abgleich, Überprüfung durch den Konsumenten |
Vollständigkeit | Raten von Nullwerten, fehlenden Datensätzen und Pflichtfeldern | Prüfung der gesamten Tabelle für kritische Felder, stichprobenartige Prüfungen für Attribute mit geringerem Risiko | Profilierung, Validierungstests |
Konsistenz | Übereinstimmung über Systeme, Tabellen und Definitionen hinweg | Vergleich von gemeinsamen Schlüsseln, Einheiten, Bezeichnungen und berechneten Werten | Systemübergreifender Abgleich |
Timeliness | Ankunft und Verfügbarkeit im Verhältnis zum Entscheidungsfenster | Überwachung jeder erwarteten Partition oder jedes Bereitstellungsereignisses | Zeitplanüberwachung, Pipeline-Protokolle |
Gültigkeit | Konformität mit Typen, Bereichen, Formaten und Geschäftsregeln | Vollständige Prüfungen für eingeschränkte Felder, gezielte Stichproben für komplexe Datensätze | Schema-Prüfungen, Regel-Engine |
Eindeutigkeit | Duplikatsrate für definierte Business Keys | Scans vollständiger Schlüssel oder inkrementelle Duplikaterkennung | Datenbank-Constraints, Profilierung |
Halten Sie die Baseline versioniert. Eine Punktzahl ohne die zugrundeliegenden Tests, Stichproben und Definitionen kann keinen Vergleich von Quartal zu Quartal unterstützen.
Definition von SLAs und KPIs, die tatsächlich Bestand haben
Ein Datenqualitäts-SLA benötigt vier Dinge: einen Eigentümer, einen Schwellenwert, ein Messfenster und einen Eskalationspfad. Fehlt einer dieser Punkte, wird das SLA zu einem bloßen Wunschdenken. „Die Daten aktuell halten“ ist nicht durchsetzbar. „Der Risiko-Feed muss innerhalb seines vereinbarten Entscheidungsfensters eintreffen, wobei der Eigentümer der Risikodaten benachrichtigt wird, wenn der Schwellenwert überschritten wird“ ist operativ umsetzbar.
Datensätze nach Konsequenzen priorisieren
Wenden Sie nicht auf jede Tabelle die gleiche Kontrollintensität an. Klassifizieren Sie Datensätze als kritisch, operativ oder explorativ – je nach Geschäftsauswirkung, regulatorischen Risiken, nachgelagerten Abhängigkeiten und Erwartungen an die Wiederherstellung.
Kritische Datensätze unterstützen die Finanzberichterstattung, Risikoentscheidungen, regulatorische Meldungen oder essenzielle Kundenaktivitäten. Operative Datensätze treiben wiederkehrende Arbeitsabläufe und das Management-Reporting an. Explorative Datensätze unterstützen Analysen, bei denen verzögerte oder unvollständige Daten zwar unangenehm, aber nicht sofort schädlich sind.
Schwellenwerte sollten die tatsächliche Nutzung widerspiegeln und nicht eine universelle Scorecard. Eine Umsatz-Faktentabelle erfordert möglicherweise eine Vollständigkeit von 95 %, während ein untertägiger Risiko-Feed eine Aktualität von 98 % erfordern kann. Diese Zahlen sind jedoch nur dann von Bedeutung, wenn sie jeweils an einen Eigentümer, ein definiertes Messfenster und eine explizite Reaktion gekoppelt sind. Ziel ist es, die geschäftlichen Kompromisse sichtbar zu machen.
Frühzeitige Signale von Ergebnismessungen trennen
Zeilenanzahlen und Nullwert-Raten beschreiben den Zustand der Daten nach der Verarbeitung. Sie sind nützliche nachgelagerte Indikatoren (Lagging Indicators), aber sie verraten Ihnen nicht, ob sich das Betriebsmodell verbessert. Fügen Sie voreilende Indikatoren (Leading Indicators) hinzu, wie z. B. die SLA-Verletzungsrate, die Zeit bis zur Bestätigung, die von Konsumenten gemeldete Fehlerrate, die Rate wiederkehrender Vorfälle und den Prozentsatz kritischer Datensätze mit aktuellen Runbooks.
Stufe | Freshness SLA | Completeness KPI | Validity KPI | Verantwortlichkeit des Eigentümers |
|---|---|---|---|---|
Kritisch | Definiert durch das Entscheidungsfenster und pro Bereitstellung überwacht | Erforderliche Felder bei jedem Ladevorgang gemessen | Geschäftsregeln blockieren oder isolieren wesentliche Fehler | Namentlich genannter Steward, Erzeuger-Eigentümer und On-Call-Eskalation |
Operativ | Vereinbartes Bereitstellungsfenster mit Warn- und Verletzungsstatus | Trend überwacht gegen einen genehmigten Schwellenwert | Ungültige Datensätze werden vor dem Verbrauch zur Korrektur weitergeleitet | Erzeuger behebt das Problem, Steward bestätigt die Eignung |
Explorativ | Verfügbarkeit nach bestem Bemühen mit sichtbarem Status | Periodisch profiliert, anstatt die Arbeit zu blockieren | Warnungen für bekannte Einschränkungen dokumentiert | Konsument akzeptiert das Risiko oder eskaliert es |
Veröffentlichen Sie das SLA dort, wo die Erzeuger arbeiten. Hinterlegen Sie es im Warehouse-Repository, in der Pipeline-Konfiguration, im Pull-Request-Template und im Incident-Runbook. Ein Governance-Portal kann die kanonische Definition enthalten, aber es sollte nicht der einzige Ort sein, an dem Entwickler den Vertrag finden.
Validation, Anomaly Detection, Timeliness und Schema-Kontrollen
Keine einzelne Kontrolle erfasst jeden Defekt. Eine regelbasierte Validierung bietet Präzision, wo die Regeln bekannt sind. Eine KI-gestützte Erkennung bietet eine breitere Abdeckung, wo normales Verhalten schwer zu codieren ist. Timeliness- und Schema-Kontrollen adressieren Fehlermuster, die bei Prüfungen auf Wertebene oft übersehen werden.
Passen Sie die Kontrolle an den Defekt an
Deterministische Validierung ist die richtige Wahl für Pflichtfelder, Eindeutigkeit, referenzielle Integrität, akzeptierte Wertemengen, Datentypen und bekannte Geschäftsregeln auf Zeilenebene. Sie ist interpretierbar und lässt sich leicht mit einem Audit-Trail verknüpfen. Ihre Schwäche ist der Wartungsaufwand. Jede neue Regel erfordert Erstellung, Tests und Eigentumsrechte, und eine Regel kann keinen Fehler erkennen, den niemand vorhergesehen hat.
Anomaly Detection lernt im Laufe der Zeit normale Verteilungen, Volumina, Kardinalitäten und Verhaltensweisen. Sie kann schleichende Veränderungen, unerwartete Verschiebungen und Änderungen der Payload von Anbietern aufdecken, ohne dass für jede Möglichkeit eine eigene Regel erforderlich ist. Der Kompromiss liegt in der Interpretierbarkeit. Eine statistische Warnung benötigt Kontext, und die Teams müssen sie so anpassen, dass ungewöhnliche, aber legitime Ereignisse nicht zu einer Alarmmüdigkeit führen.
Timeliness-Überwachung prüft, ob Daten innerhalb ihres Entscheidungsfensters eintreffen und nutzbar werden. Eine Tabelle, die zwar existiert, aber den Zustand von gestern widerspiegelt, ist für einen untertägigen Prozess nicht brauchbar. Richtlinien zur Daten-Timeliness und Validierungsüberwachung empfehlen automatisierte Alterungsschwellenwerte, damit veraltete Datensätze markiert werden, bevor nachgelagerte Arbeitsabläufe sich auf sie verlassen.
Schema-Tracking versioniert Spaltentypen, Nullwerte-Zulässigkeit (Nullability), verschachtelte Strukturen und das Vorhandensein von Feldern. Es sollte zwischen additiven Änderungen, unterbrechenden Änderungen (Breaking Changes) und semantischer Drift unterscheiden. Das Hinzufügen einer Spalte, die Nullwerte zulässt, kann für einen Konsumenten sicher und für einen anderen störend sein, weshalb Lineage- und Auswirkungsanalysen wichtig sind.
Kontrolle | Was sie erfasst | Was sie übersieht | Kostenprofil | Best-Fit-Ebene |
|---|---|---|---|---|
Deterministische Validierung | Bekannte Regelverletzungen und Vertragsbrüche | Neue Muster außerhalb definierter Regeln | Vorhersehbarer Aufwand für Erstellung und Wartung | Ingestion, Normalisierung, Bereitstellung |
KI-gestützte Anomaly Detection | Verteilungsverschiebungen, ungewöhnliche Volumina, schleichende Verhaltensänderungen | Kontext, der eine geschäftliche Erklärung erfordert | Geringerer Aufwand bei der manuellen Regelerstellung, höherer Anpassungsbedarf | Breit angelegte Überwachung über Pipelines hinweg |
Timeliness-Prüfungen | Ausgebliebene Ladevorgänge, verzögerte Partitionen, veraltete, aber vorhandene Daten | Werte, die pünktlich ankommen, aber falsch sind | Gering, sobald Zeitpläne und Fenster definiert sind | Schnittstellen für Ingestion und Bereitstellung |
Schema-Tracking | Hinzugefügte, entfernte oder typveränderte Felder und Strukturen | Bedeutungsänderungen ohne strukturelle Änderung | Moderater Aufwand für Metadaten und Eigentumsrechte | Quellverträge und Pipeline-Grenzen |
Teams, die Automatisierungsmuster evaluieren, können auch die Truespeak-Automatisierungserkenntnisse für einen breiteren Workflow-Kontext heranziehen. Das Qualitätsprogramm sollte dennoch entscheiden, welche Fehler die Verarbeitung blockieren, welche Datensätze isoliert werden und welche lediglich die Konsumenten benachrichtigen. Mehr Automatisierung ist nicht automatisch besser, wenn sie Unsicherheiten in eine undurchsichtige Warteschlange verschiebt.
Ein mehrschichtiger Ansatz ist stärker als die bloße Entscheidung zwischen Regeln und KI. Verwenden Sie Datenvalidierungsregeln und kontinuierliche Qualitätskontrollen für bekannte Pflichten und fügen Sie dann eine Anomaly Detection für die Sonderfälle (Long Tail) hinzu.
In-Database-Ausführung, Workflow-Integration und Runbooks
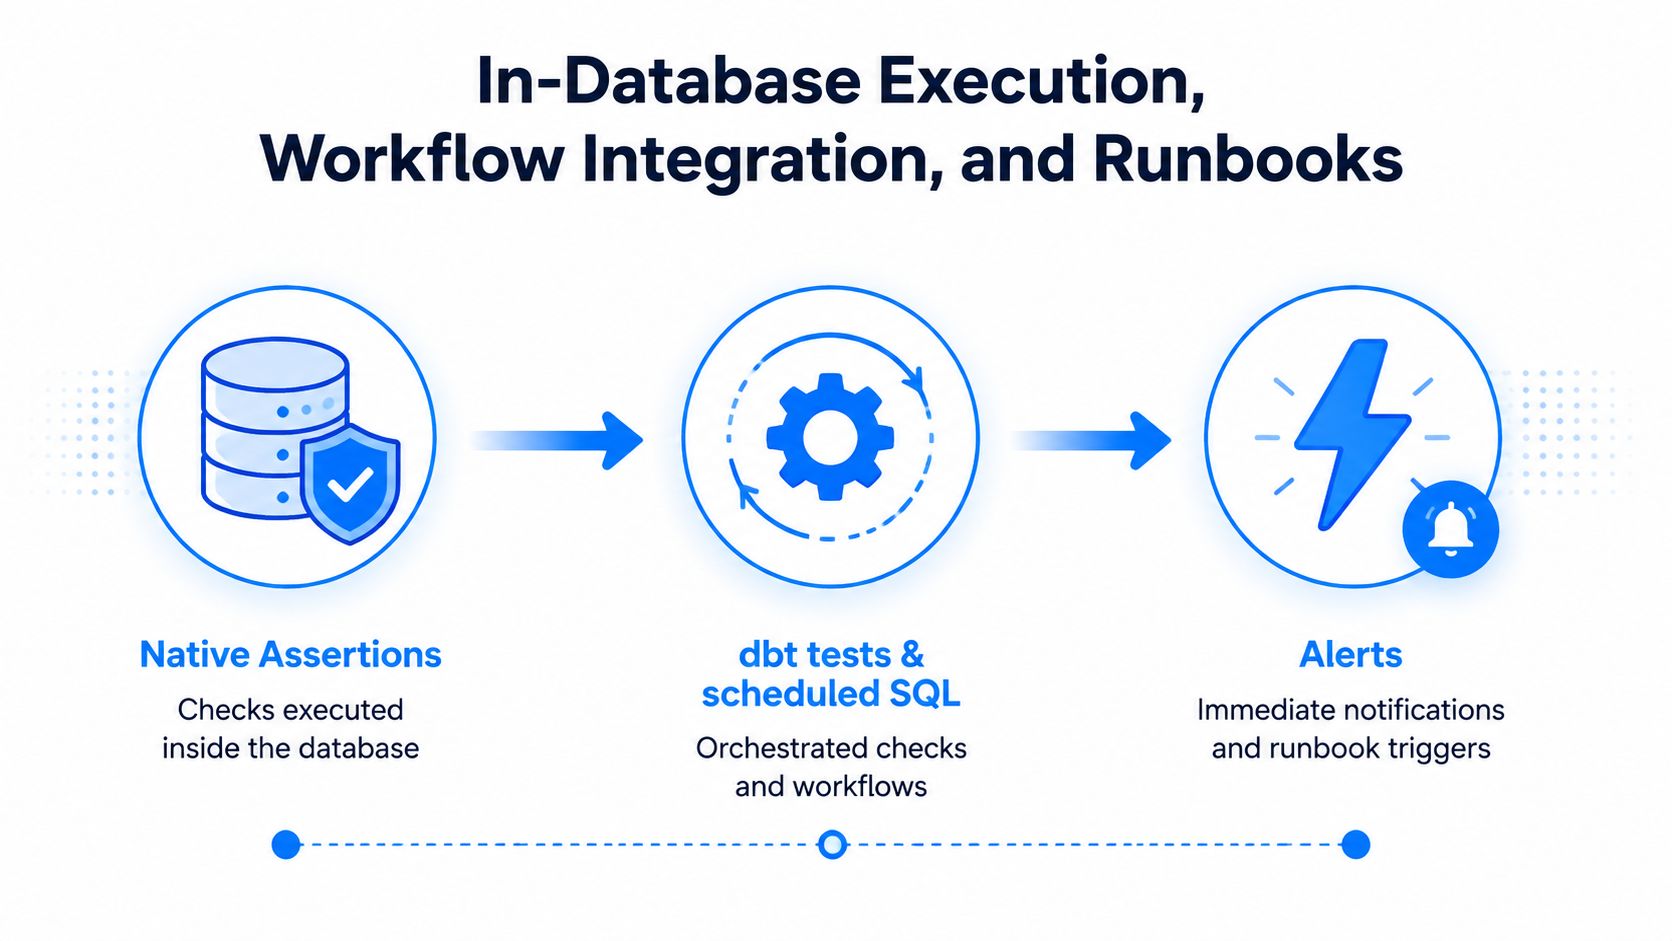
Führen Sie Prüfungen an der Grenze durch, an der die Daten erzeugt oder transformiert werden. Native Assertions, dbt-Tests und geplante SQL-Abfragen halten die Validierung nah an der Tabelle und machen es einfacher, Fehler mit einem bestimmten Ladevorgang, einer Partition oder einer Transformation in Verbindung zu bringen. Eine separate Überwachungsschicht kann einen Mehrwert bieten, sollte aber keine lange Verzögerung zwischen der Entstehung und der Erkennung eines Defekts verursachen.
Signale in bestehende Arbeitsabläufe leiten
Nutzen Sie ein auf dem Schweregrad basierendes Routing, anstatt jedes Ergebnis an jeden Kanal zu senden.
Schweregrad 1 (Severity One): Benachrichtigen Sie den diensthabenden Entwickler über PagerDuty, wenn ein kritischer Datensatz nicht verfügbar, wesentlich ungültig oder außerhalb seines Entscheidungsfensters ist.
Schweregrad 2 (Severity Two): Eröffnen Sie einen Slack-Thread mit dem Erzeuger und dem Steward, wenn Konsumenten betroffen sind, aber ein kontrollierter Workaround existiert.
Nachverfolgung (Follow-up): Erstellen Sie ein Jira-Ticket für wiederkehrende Defekte, Regelwartung, Dokumentation oder Pipeline-Behebung.
Die Richtlinien zur Daten-Workflow-Automatisierung sind nützlich bei der Gestaltung dieser Übergaben, aber das Prinzip ist einfach: Warnungen müssen die Person erreichen, die den erzeugenden Prozess ändern kann.
Das Runbook ausführbar machen
Ein Runbook sollte es einem Entwickler ermöglichen, mit der Diagnose zu beginnen, ohne den ursprünglichen Autor ausfindig machen zu müssen. Es sollte Folgendes enthalten:
Fehlersignatur: Die Metrik, die Regel oder der Zeitplan, der verletzt wurde.
Auswirkungsradius (Blast Radius): Betroffene Tabellen, Dashboards, Modelle, Berichte und Geschäftsprozesse.
Wahrscheinlicher Eigentümer: Erzeuger, Steward, Plattform-Team oder externer Anbieter.
Die ersten drei Abfragen (Queries): Prüfungen für Quellwerte, Transformations-Output und nachgelagerte Auswirkungen.
Eindämmungsschritt (Containment): Rollback, Quarantäne, Ladepause oder Benachrichtigung des Konsumenten.
Kommunikationsvorlage: Was passiert ist, was betroffen ist, was Benutzer tun sollten und wann das nächste Update erfolgt.
Deduplizieren Sie Warnungen innerhalb eines definierten Fensters, unterdrücken Sie nachgelagerte Warnungen, wenn ein Fehler in der übergeordneten Pipeline diese erklärt, und fassen Sie Erkenntnisse mit niedrigem Schweregrad in einer Übersicht zusammen. Führen Sie vor der Liveschaltung des Prozesses eine Vorfallsübung durch. Bestätigen Sie, dass die Warnung ausgelöst wird, der Eigentümer erreichbar ist, die Abfragen funktionieren, der Rollback sicher ist und das Ticket genügend Beweise für eine spätere Retrospektive erfasst.
Organisation von Teams, Eigentumsrechten und Betriebszyklen
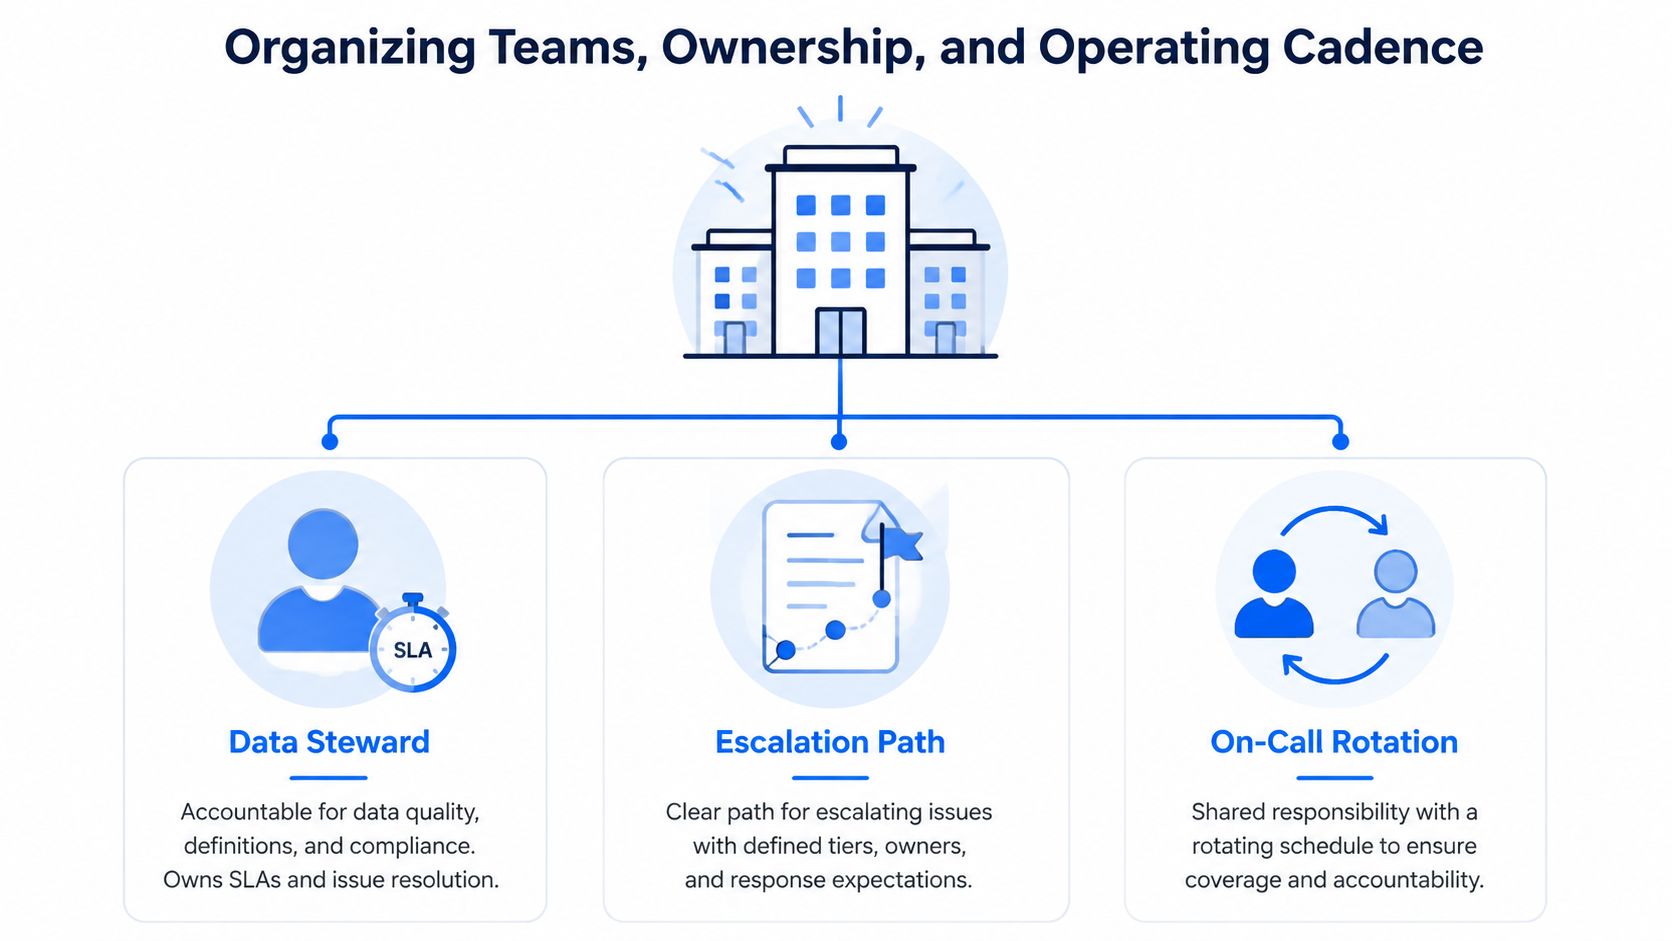
Eigentumsverhältnisse werden klar, wenn jeder Datensatz einen benannten Steward, einen Erzeuger, einen Konsumenten und einen Eskalationspfad hat. Ein Center of Excellence kann Muster und Coaching bereitstellen, sollte aber nicht für einen Defekt verantwortlich sein, den es selbst nicht beheben kann.
Rollen trennen
Der Daten-Erzeuger ist Eigentümer der Ingestion, der Quellverträge, der Schemaänderungen und des Pipeline-Verhaltens. Der Daten-Steward ist Eigentümer der Definitionen, der Qualitätsanforderungen, der geschäftlichen Interpretation und der Koordinierung der Fehlerbehebung. Der Daten-Konsument validiert, ob der Datensatz für einen Bericht, ein Modell oder eine operative Entscheidung geeignet ist, und meldet verwertbare Defekte.
Domänenübergreifende Vorfälle erfordern einen designierten Vorfallsleiter (Incident Lead). Wenn ein Anbieter Eigentümer der Quelle ist, ein Team für kommerzielle Systeme Eigentümer der Anwendung ist und ein Plattform-Team Eigentümer des Warehouse ist, koordiniert der Leiter die Eindämmung, während jede Gruppe ihren Teil der Untersuchung übernimmt.
Meetings in Artefakte verwandeln
Ein nützlicher Rhythmus führt zu Entscheidungen, nicht zu bloßen Diskussionen:
Wöchentliche Triage: Überprüft neue Anomalien, weist Eigentümer zu und schließt oder eskaliert Vorfälle.
Monatlicher KPI-Review: Vergleicht die SLA-Performance, wiederkehrende Defekte, Meldungen von Konsumenten und überfällige Fehlerbehebungen.
Vierteljährliche Vertragsaktualisierung: Überprüft Definitionen, Schwellenwerte, Lineage, regulatorische Änderungen und neue Konsumenten.
Verwenden Sie eine leichtgewichtige RACI-Matrix für jeden kritischen Datensatz. Der Erzeuger ist für die Implementierung verantwortlich (Responsible), der Steward trägt die Gesamtverantwortung für Eignung und Definitionen (Accountable), Konsumenten werden zu den Auswirkungen konsultiert (Consulted) und das Plattform- oder Governance-Team wird über systemische Änderungen informiert (Informed). Passen Sie die Zuständigkeiten an, wenn Ihr Unternehmen ein anderes Modell verwendet, aber lassen Sie die Rechenschaftspflicht nicht bei einem unbenannten Komitee liegen.
Das Betriebsmodell erfordert außerdem eine Rufbereitschaft (On-Call-Rotation) für die folgenreichsten Pipelines. Ohne diese treffen Warnungen außerhalb der Arbeitszeiten ein, und das Unternehmen misst zwar die Erkennung, nimmt aber eine langsame Behebung in Kauf. Eigentumsrechte sollten im Katalog, im Repository, in der Alarmierungsmeldung und im Runbook dokumentiert sein, nicht nur in einem Meeting-Dokument.
Messung des ROI und Ihre ersten 90 Tage
Die Unternehmensführung benötigt keine weitere Qualitätsbewertung ohne finanzielle Interpretation. Beginnen Sie mit der Data Downtime, also dem Zeitraum, in dem ein Datensatz nicht verfügbar, veraltet oder für den vorgesehenen Zweck nicht vertrauenswürdig ist. Eine praktische Formel lautet DDT = N × (TDD + TTR), bei der die Vorfälle mit der durchschnittlichen Zeit bis zur Erkennung plus der durchschnittlichen Zeit bis zur Behebung multipliziert werden, wie in dieser Anleitung zur Messung der Data Downtime beschrieben.
Operative Verluste in einen Business Case umwandeln
Erfassen Sie die Stunden, die Analysten, Entwickler, Finanzmitarbeiter und operative Teams im vorangegangenen Quartal mit der Suche nach fehlerhaften Daten verbracht haben. Multiplizieren Sie diese Stunden mit den entsprechenden kalkulatorischen Stundensätzen und addieren Sie dokumentierte Konsequenzen wie revidierte Prognosen, verzögerte Entscheidungen, fehlgeschlagene Kundenaktionen oder Compliance-Behebungen hinzu.
Verfolgen Sie dieselben Kategorien nach der Implementierung. Der Vergleich sollte weniger Vorfälle, kürzere Erkennungszeiten, kürzere Behebungszeiten, weniger Nacharbeit und ein geringeres Risiko durch Entscheidungen auf der Grundlage unzuverlässiger Daten zeigen. Behaupten Sie nicht, dass jeder vermiedene Vorfall garantierten Umsatz bedeutet. Trennen Sie harte Einsparungen von vermiedenen Risiken und machen Sie die Annahmen transparent.
Für viele Unternehmen ist der Fall von großer Bedeutung. IBM berichtet, dass mehr als ein Viertel der Unternehmen die jährlichen Verluste durch schlechte Datenqualität auf über 5 Millionen USD schätzen, während 7 % die Verluste auf über 25 Millionen USD schätzen. Nutzen Sie diese Zahlen als Kontext, nicht als Ersatz für Ihre eigene Baseline.
Nutzen Sie eine fokussierte 90-Tage-Sequenz
Phase | Tage | Wichtigste Ergebnisse | Erfolgskriterien |
|---|---|---|---|
Baseline | 1 bis 15 | Profilieren Sie die fünf wichtigsten kritischen Tabellen, definieren Sie SLAs, weisen Sie Eigentümer zu, erfassen Sie die aktuelle Ausfallzeit | Jeder prioritäre Datensatz hat eine Vereinbarung, einen Eigentümer und eine erste Messung |
Instrumentieren | 16 bis 45 | Implementieren Sie Schema- und Freshness-Prüfungen in der Datenbank, leiten Sie Warnungen an On-Call-Kanäle weiter, veröffentlichen Sie Runbooks | Verletzungen erreichen das verantwortliche Team mit direkt umsetzbarem Diagnosekontext |
Feintunen | 46 to 75 | Fügen Sie eine Anomaly Detection hinzu, überprüfen Sie falsch-positive Ergebnisse, passen Sie Schwellenwerte an und dokumentieren Sie Ausnahmen | Das Warnungsvolumen ist handhabbar und signifikante Änderungen werden untersucht |
Review | 76 to 90 | Führen Sie den vierteljährlichen Review durch, berichten Sie über Änderungen bei Ausfallzeiten und Reaktionen und wählen Sie den nächsten Abdeckungsbereich aus | Die Unternehmensführung sieht die operativen Auswirkungen und genehmigt den nächsten Ausbauschritt |
Das Business-Case-Framework für Datenqualität kann dabei helfen, die finanzielle Argumentation rund um Kosten, Risiken und messbare Ergebnisse zu strukturieren.
Vermeiden Sie vier typische Fallen. Scheinmetriken (Vanity Metrics) belohnen die Anzahl der Prüfungen anstelle einer nützlichen Erkennung. Alarmmüdigkeit maskiert schwerwiegende Fehler im allgemeinen Rauschen. Tooling ohne klare Verantwortlichkeiten schafft lediglich Dashboards anstelle von Fehlerbehebungen. Das Überspringen der ersten Vorfalls-Retrospektive garantiert, dass dieselbe Art von Defekt wiederkehrt.
Beginnen Sie mit fünf kritischen Tabellen, einem benannten Eigentümer für jede Tabelle und einer schriftlichen Definition dessen, was „verfügbar und vertrauenswürdig“ bedeutet. Messen Sie dann den ersten Vorfall von der Erkennung bis zur Behebung, denn dieser Zyklus sagt Ihnen mehr über den Reifegrad des Programms als eine geschönte Qualitätsbewertung.
digna bietet In-Database-Validierung, Anomaly Detection, Timeliness-Überwachung und Schema-Tracking innerhalb Ihrer eigenen Umgebung, sodass Teams Qualitätskontrollen direkt mit den Pipelines und Datensätzen verknüpfen können, die sie bereits betreiben. Besuchen Sie digna, um einen modularen Ansatz zur Verbesserung der Datenqualität in Warehouses, Data Lakes und Enterprise-Pipelines zu evaluieren.
Häufig gestellte Fragen
Warum bleiben Datenqualitätsprogramme schon vor dem Start stecken?
Weil die erste Reaktion auf einen Vorfall meist der Kauf oder die Konfiguration eines Werkzeugs ist. Ein Qualitätswerkzeug kann Kennzahlen berechnen, Regeln ausführen und Alerts leiten, aber es kann nicht entscheiden, was korrekt bedeutet. Dafür braucht es einen dokumentierten Vertrag zwischen Produzenten und Konsumenten.
Genügt das Messen von Nullwertquoten?
Nein. Nullwertquoten sind nützlich, doch eine Tabelle kann vollständig und trotzdem falsch sein. Die Abdeckung muss über Vollständigkeit hinaus bis zu den Definitionen, zulässigen Werten und Beziehungen reichen, die entscheiden, ob ein vollständiger Datensatz auch ein richtiger ist.
Was ordnet ein funktionierendes Programm zu?
Kontrollen zu den Risiken, die zählen, in drei Bereichen: Standards zu Definitionen, zulässigen Werten, Verantwortung und Änderungsverfahren; Rechenschaft durch benannte Produzenten und Stewards mit Befugnis zur Behebung; und Rückkopplung über Alerts, Tickets, Retrospektiven und Pipeline-Änderungen, die Wiederholung verhindern.
Warum braucht Qualität eine ökonomische Linse?
Weil ohne sie jeder Datensatz gleich aufmerksamkeitswürdig wirkt. Kontrollen an die Kosten eines Ausfalls zu koppeln, erlaubt einem Team zu begründen, wo Aufwand hingeht und was vorerst überwacht, aber nicht behoben bleibt.
Wie sieht der klassische Fehler aus?
Ein Umsatz-Dashboard, das vollkommen gesund wirkt und über Wochen die Buchungen einer Region zu hoch ausweist. Der Vorfall ist im Kern kein Dashboard-Problem, weshalb ein neues Dashboard oder eine weitere Prüfung den nächsten selten verhindert.


