Datenqualitätstests: Ein praktischer Leitfaden
|
7
min. Lesezeit

In einer Branchenumfrage von 2026 gaben 68 % der Befragten an, die Erkennung eines Datenvorfalls habe vier Stunden oder mehr gedauert, verglichen mit 62 % im Jahr 2022. Die durchschnittliche Zeit bis zur Behebung stieg zudem um 166 % auf 15 Stunden je Vorfall (Monte Carlos Datenqualitätsumfrage). Diese Zahlen ändern, wie Datenqualitätstests bewertet werden sollten. Die Frage ist nicht nur, ob eine Regel einen ungültigen Wert erkennt. Sie lautet, wie schnell Ihr Team einen Fehler entdeckt, seinen Umfang versteht und verhindert, dass unzuverlässige Daten Dashboards, Modelle und operative Systeme erreichen.
Statische SQL-Tests haben weiterhin ihren Platz. Sie sind präzise, überprüfbar und nützlich für stabile Geschäftsregeln. Doch periodische Prüfungen lassen Lücken zwischen den Ausführungen, und handgepflegte Regeln halten selten Schritt mit wechselnden Schemata, Lieferplänen und Datenverhalten. Wirksame Datenqualitätstests verbinden deterministische Validierung mit kontinuierlicher Observability, sodass Teams sowohl Korrektheit als auch die Zeit bis zur Erkennung und Wiederherstellung überwachen.
Inhaltsverzeichnis
Die steigenden Kosten verzögerter Datenvorfälle
Ein Datenvorfall wird teuer, wenn die Erkennung erst eintrifft, nachdem die Daten bereits verwendet wurden. Ein defektes Dashboard, ein angezweifelter KPI oder ein kontaminiertes Modell kann eine Untersuchung über Pipelines und Konsumenten hinweg auslösen. Engineers rekonstruieren dann die Änderung, bestimmen betroffene Datensätze und entscheiden, welche Ergebnisse neu gebaut werden müssen.
68 % der Befragten meldeten Erkennungszeiten von vier Stunden oder mehr, gegenüber 62 % im Jahr 2022, während die durchschnittliche Behebungszeit um 166 % auf 15 Stunden je Vorfall stieg (Monte Carlos Umfrageergebnisse). Diese Zahlen beschreiben Expositionszeit, nicht nur Testleistung. In diesem Zeitraum können unzuverlässige Informationen durch Berichte, Extrakte, Anwendungen und Machine-Learning-Workflows wandern.
MTTD und MTTR gehören in das Qualitätsgespräch
Klassische Datenqualitätstests prüfen, ob Datensätze Bedingungen erfüllen, etwa nicht leere Felder, gültige Typen oder zulässige Bereiche. Diese Assertions messen Korrektheit zum Zeitpunkt ihres Laufs. Sie zeigen nicht, wie lange die Organisation nichts davon wusste, dass die Bedingung verletzt war.
Mean Time to Detect, kurz MTTD, misst die Verzögerung, bis ein Team von einem Vorfall weiß. Mean Time to Recover, kurz MTTR, misst, wie lange die Wiederherstellung vertrauenswürdiger Daten oder einer verlässlichen Pipeline dauert. Eine Suite kann korrekte Pass- oder Fail-Ergebnisse liefern und das Geschäft dennoch vermeidbarem Risiko aussetzen, wenn Alerts zu spät kommen.
Praxisregel: Behandeln Sie jede Qualitätsprüfung als operatives Signal. Halten Sie fest, wann die Bedingung sich änderte, wann das System es erkannte, wer den Alert erhielt und wann die betroffenen Daten wieder nutzbar waren.
Geplante Tests lassen blinde Intervalle. Eine Quelle kann zwischen zwei Prüfungen aufhören zu laden, eine Spalte ergänzen, einen Typ ändern oder eine ungewohnte Verteilung erzeugen. Kontinuierliche Observability verkürzt dieses Intervall, indem sie Aktualität, Schema, Werte und Plattformsignale bewertet, während Daten fließen, statt auf den nächsten Testlauf zu warten.
Die Vorfallspriorität sollte die Geschäftsauswirkung abbilden. Ein verzögerter Vorstands-KPI, ein Ausfall eines regulatorischen Feeds und ein ungenutztes Staging-Tabellenproblem sollten nicht dieselbe Dringlichkeit erhalten. Lineage, Ownership und nachgelagerte Nutzung helfen, Aufmerksamkeit auf Fehler zu lenken, die Entscheidungen oder kritische Konsumenten betreffen. Teams können außerdem ein Werkzeug zur Bezifferung der operativen Kosten von Datenausfällen nutzen, wenn sie entscheiden, welche Kontrollen und Alert-Wege Investition verdienen.
Das operative Ziel ist klar: Korrektheit bleibt notwendig, während die Erkennungslatenz bestimmt, wie weit ein Fehler reist. Datenqualitätstests liefern mehr Wert, wenn sie Engineers rechtzeitige Nachweise, nutzbaren Kontext und einen direkten Weg von der Anomalie zur Ursache geben.
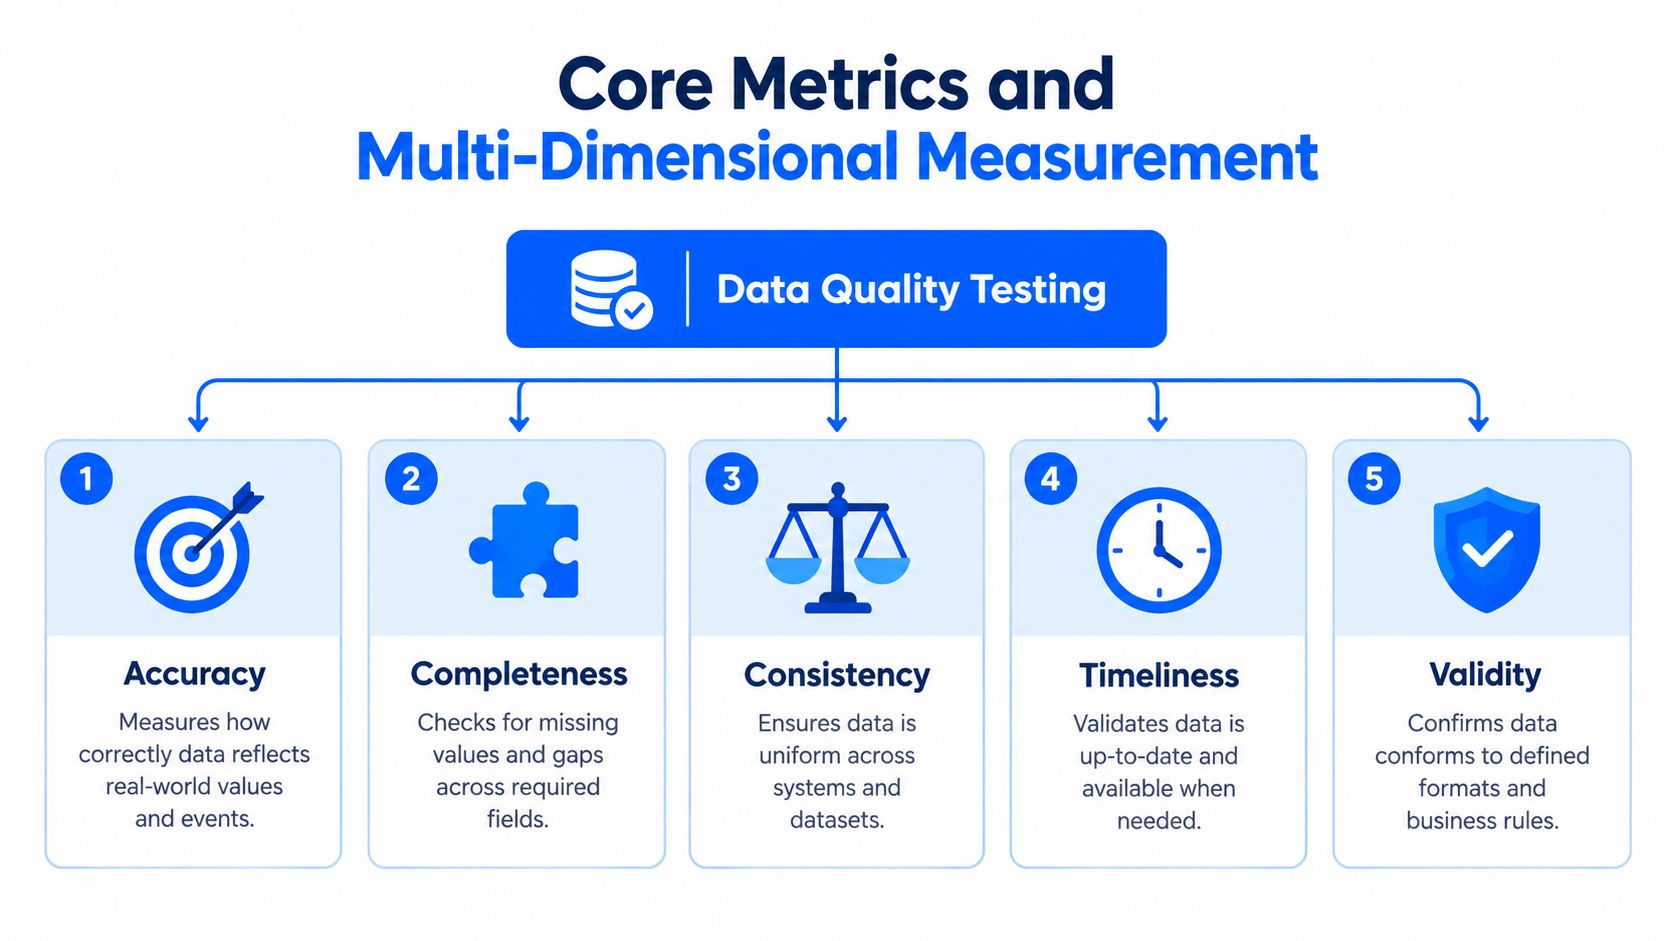
Kernkennzahlen und mehrdimensionale Messung
Ein verlässliches Qualitätsprogramm braucht mehr als eine einzelne Dashboard-Prozentzahl. Profiling schafft statistische Baselines, während Datenqualitätsdimensionen zeigen, ob ein Datensatz für den beabsichtigten Einsatz geeignet bleibt. Die operative Frage lautet, wie schnell eine bedeutsame Abweichung sichtbar wird, nicht nur, ob eine geplante Assertion irgendwann scheitert.
Beginnen Sie mit der Form der Daten
Profilieren Sie einen Datensatz, bevor Sie entscheiden, welche Kontrollen gelten. Nützliche Ergebnisse sind:
Volumen und Struktur: Zeilen- und Spaltenzahlen legen fehlende Ladevorgänge, unerwartetes Wachstum und strukturelle Änderungen offen.
Fehlwerte: Null-Anteile zeigen, ob Pflichtfelder an Vollständigkeit verlieren.
Kardinalität: Distinct- und Duplikatzählungen zeigen Wiederholungen, gebrochene Eindeutigkeit und Identitätsprobleme.
Verteilung: Minimum, Maximum, Mittelwert, Median, Standardabweichung, Schiefe und Häufigkeitsmuster zeigen, ob Werte noch dem erwarteten Verhalten entsprechen.
Der OpenMetadata-Datenqualitätsstandard enthält diese Profiling-Größen neben operativen Indikatoren wie Bestehens- oder Fehlerrate von Tests und der mittleren Zeit bis zur Erkennung und Behebung. Die Kombination verbindet zwei Sichten. Profiling beschreibt, was sich in den Daten geändert hat, operative Größen zeigen, ob das Team diese Änderung schnell genug erkannt und behandelt hat.
Prüfen Sie mehr als den Inhalt
Schema- und Vollständigkeitsprüfungen können bestehen, während ein Datensatz für ein Modell oder einen Geschäftsprozess ungeeignet bleibt. Werte können gültige Typen und wenige Nullwerte haben und dennoch aus einer nicht vertrauenswürdigen Quelle stammen, überholte Zustände abbilden oder eine unausgewogene Grundgesamtheit spiegeln.
Eine Zusammenfassung eines ETSI-Frameworks nennt 18 Metriken über grundlegende Qualität, Nutzbarkeit, Fairness und Datenschutz. Die Berichterstattung zum ETSI-Framework ist eine Zusammenfassung von TelecomTV und nicht die Veröffentlichung des Frameworks selbst. Ihre Abdeckung umfasst Vollständigkeit, Genauigkeit, Konsistenz, Lineage, Nachverfolgbarkeit, Aktualität, Labelqualität und Bias. Zusammen definieren diese Dimensionen Qualität über Inhalt, Kontext und Governance.
Ein geschichteter Messentwurf sollte fragen:
Sind die Daten vorhanden und strukturell gültig?
Bilden sie die beabsichtigten Ereignisse oder Entitäten korrekt ab?
Bleiben sie über Systeme und Transformationen hinweg konsistent?
Sind sie innerhalb des fachlichen Zeitfensters eingetroffen?
Kann das Team Herkunft, Transformationen, Labels und zulässige Nutzungen nachvollziehen?
Stützen sie faire und datenschutzbewusste Analytik oder Modellentwicklung?
Schwellenwerte hängen vom Zweck ab. Ein Finanzdatensatz braucht womöglich strenge Abstimmung und Nachverfolgbarkeit. Ein explorativer Datensatz verträgt vielleicht unvollständige Felder, braucht aber dennoch Aktualität und Lineage. Wenden Sie nur die Prüfungen an, die den beabsichtigten Einsatz entwerten können, und überwachen Sie diese Signale dann fortlaufend, damit Qualitätsfehler auffallen, bevor nachgelagerte Entscheidungen darauf bauen.
Regelbasiertes Testen gegenüber kontinuierlicher Observability
Handgeschriebene Regeln bieten Kontrolle. Eine SQL-Assertion kann eine exakte Erwartung ausdrücken, etwa dass ein Schlüssel eindeutig sein muss oder ein Statuswert einer freigegebenen Liste angehören muss. Dieser Determinismus ist wertvoll für vertragliche Geschäftslogik, regulatorische Kontrollen und Transformationen mit bekanntem Sollverhalten.
Das Problem entsteht, wenn Teams statische Regeln als einzige Verteidigungslinie nutzen. Jede neue Quelle, Tabelle, Spalte und Ausnahme erzeugt mehr Pflegeaufwand. Schwellenwerte veralten, die Testabdeckung bleibt auf die sichtbarsten Datensätze konzentriert, und Engineers aktualisieren Prüfungen, statt bedeutsame Änderungen zu untersuchen.
Der Unterschied lässt sich nebeneinander leichter bewerten:
Dimension | Regelbasiertes Testen | Kontinuierliche Observability |
|---|---|---|
Primärer Mechanismus | Explizite SQL-Assertions und feste Bedingungen | Telemetrie, Profiling, Baselines und Anomalieerkennung |
Beste Eignung | Stabile Geschäftsregeln und vertragliche Vorgaben | Sich ändernde Pipelines und unbekannte Fehlerbilder |
Stärke | Transparent und deterministisch | Breite Abdeckung mit weniger manueller Schwellenpflege |
Schwäche | Pflegeaufwand wächst mit Systemänderungen | Alerts brauchen Kontext und eventuell Untersuchung |
Typisches Signal | Bestanden oder nicht gegen eine definierte Regel | Abweichung vom erwarteten Verhalten über die Zeit |
Vorfallsreaktion | Beginnt oft nach einer fehlgeschlagenen Prüfung | Kann Aktualitäts-, Schema- und Verteilungsänderungen früher zeigen |
Setzen Sie jeden Ansatz dort ein, wo er Hebel hat
Deterministische Regeln sollten Invarianten schützen. Beispiele sind referenzielle Integrität, zulässige Codelisten, Abstimmungslogik und Pflichtfeldvorgaben. Diese Prüfungen erklären genau, was scheiterte und warum, was sie für Release-Gates und Auditnachweise geeignet macht.
Observability deckt Verhalten ab, das schwer erschöpfend zu kodieren ist. Baseline-Lernen kann ungewöhnliche Volumina, fehlende Ladevorgänge, Schema-Drift oder Werteverteilungen erkennen, ohne dass ein Engineer jede gültige Variation vorhersagen muss. Die in Analysen zu Warehouse- und Datenqualitätsüberwachung zitierte operative Forschung verbindet die Überwachung von Volumen-, Schema- und Wertanomalien mit niedrigerer MTTD und MTTR, weil Telemetrie Fehler näher an ihrem Entstehen sichtbar macht.
Statische Regeln sagen Ihnen, ob eine bekannte Bedingung verletzt wurde. Observability hilft zu zeigen, dass sich das System anders verhält, bevor Sie wissen, welche Bedingung zu schreiben wäre.
Das macht automatisierte Anomalieerkennung nicht zum Ersatz für ingenieurmäßiges Urteil. Eine saisonale Veränderung kann anormal wirken, und eine legitime Schemaerweiterung kann einen Alert auslösen. Teams brauchen weiterhin Ownership, Lineage, Vorfallskontext und Unterdrückungs-Workflows. Das praktische Muster verbindet explizite Prüfungen für bekannte Pflichten mit adaptiver Überwachung für unbekannte Änderungen.
Engineers, die zwischen Software- und Datenzuverlässigkeit arbeiten, profitieren womöglich auch vom Blick auf Qualitätssicherungsarbeit, besonders dort, wo Testentwurf, Fehlertriage und Release-Disziplin sich mit dem Betrieb von Datenpipelines überschneiden. Eine fokussierte Behandlung des hybriden Modells bietet Datenvalidierungsregeln und kontinuierliche Datenqualität.
Technische Prüfungen am Geschäftskontext ausrichten
Eine Pipeline kann eine hohe Bestehensquote melden und dennoch eine Geschäftsentscheidung untergraben. Der Fehler beginnt meist mit einer Diskrepanz zwischen dem, was Engineers messen, und dem, was Stakeholder unter „guten Daten“ verstehen.
Die Finanzabteilung definiert einen gültigen Umsatzdatensatz womöglich über Buchungsstatus, Rechnungsperiode, Währungsbehandlung und Abstimmung. Das Marketing achtet vielleicht auf Einwilligung, Identitätsauflösung, Attribution und Kampagnenaktualität. Der Betrieb priorisiert womöglich Lieferpünktlichkeit, Bestandsverfügbarkeit oder vollständige Ereignisabdeckung. Derselbe zugrunde liegende Datensatz kann die Definition eines Teams erfüllen und die eines anderen verfehlen.
Prüfungen Entscheidungen zuordnen, nicht nur Tabellen
Beginnen Sie bei der Geschäftsfrage und arbeiten Sie rückwärts zu den Datenbedingungen, die die Antwort vertrauenswürdig machen. Dokumentieren Sie für jeden wichtigen KPI oder jedes analytische Produkt:
Den Konsumenten: Benennen Sie das Team oder den Prozess, der sich auf das Ergebnis stützt.
Die Definition: Halten Sie fest, wie Begriffe wie „aktiver Kunde“, „Nettoumsatz“ oder „pünktliche Lieferung“ berechnet werden.
Die Fehlerfolge: Beschreiben Sie, was falsch wird, wenn die Daten spät, unvollständig, doppelt oder falsch klassifiziert sind.
Die Nachweise: Benennen Sie, welche Tests, Lineage-Einträge, Abstimmungen und Vorfallsprotokolle belegen, dass das Ergebnis geeignet bleibt.
So entsteht ein Qualitätsvertrag mit Zweck. Er verhindert außerdem, dass Teams eine Kennzahl feiern, die genau die Fälle ausschließt, die Stakeholder interessieren.
Wechselnde Definitionen sichtbar machen
Fachliche Definitionen ändern sich, und Pipeline-Schemata ändern sich mit ihnen. Eine neue Quellspalte kann einen Join verändern, ein umbenanntes Feld ein nachgelagertes Modell brechen, und eine überarbeitete KPI-Definition kann historische Backfills erfordern. Metadatengestützte Lineage hilft zu erkennen, welche Konsumenten von einem Feld oder einer Transformation abhängen, während warehouse-native Validierung die Prüfungen nah an den Daten hält, die sie schützen.
Qualitäts-Dashboards sollten den Umfang zeigen, nicht nur den Status. Ein bestandener Wert braucht eine sichtbare Kennzahldefinition, Grundgesamtheit, Zeitfenster und Ausschlussregel. Sonst vergleichen Teams Unvergleichbares oder verwechseln schmale Abdeckung mit Gesamtzuverlässigkeit.
Ein Qualitätswert ist nur dann nützlich, wenn sein Publikum versteht, was er einschließt, was er ausschließt und welche Entscheidung er schützt.
Die stärksten Programme lassen Stakeholder an der Priorisierung teilnehmen, ohne von ihnen SQL zu verlangen. Data Engineers setzen Kontrollen um, Analysten prüfen Definitionen, und Fachverantwortliche genehmigen die maßgeblichen Bedingungen. Diese Aufgabenteilung macht aus Datenqualitätstests statt einer Engineering-Checkliste eine verantwortete Betriebspraxis.
Die Governance-Lücke im Testdatenmanagement
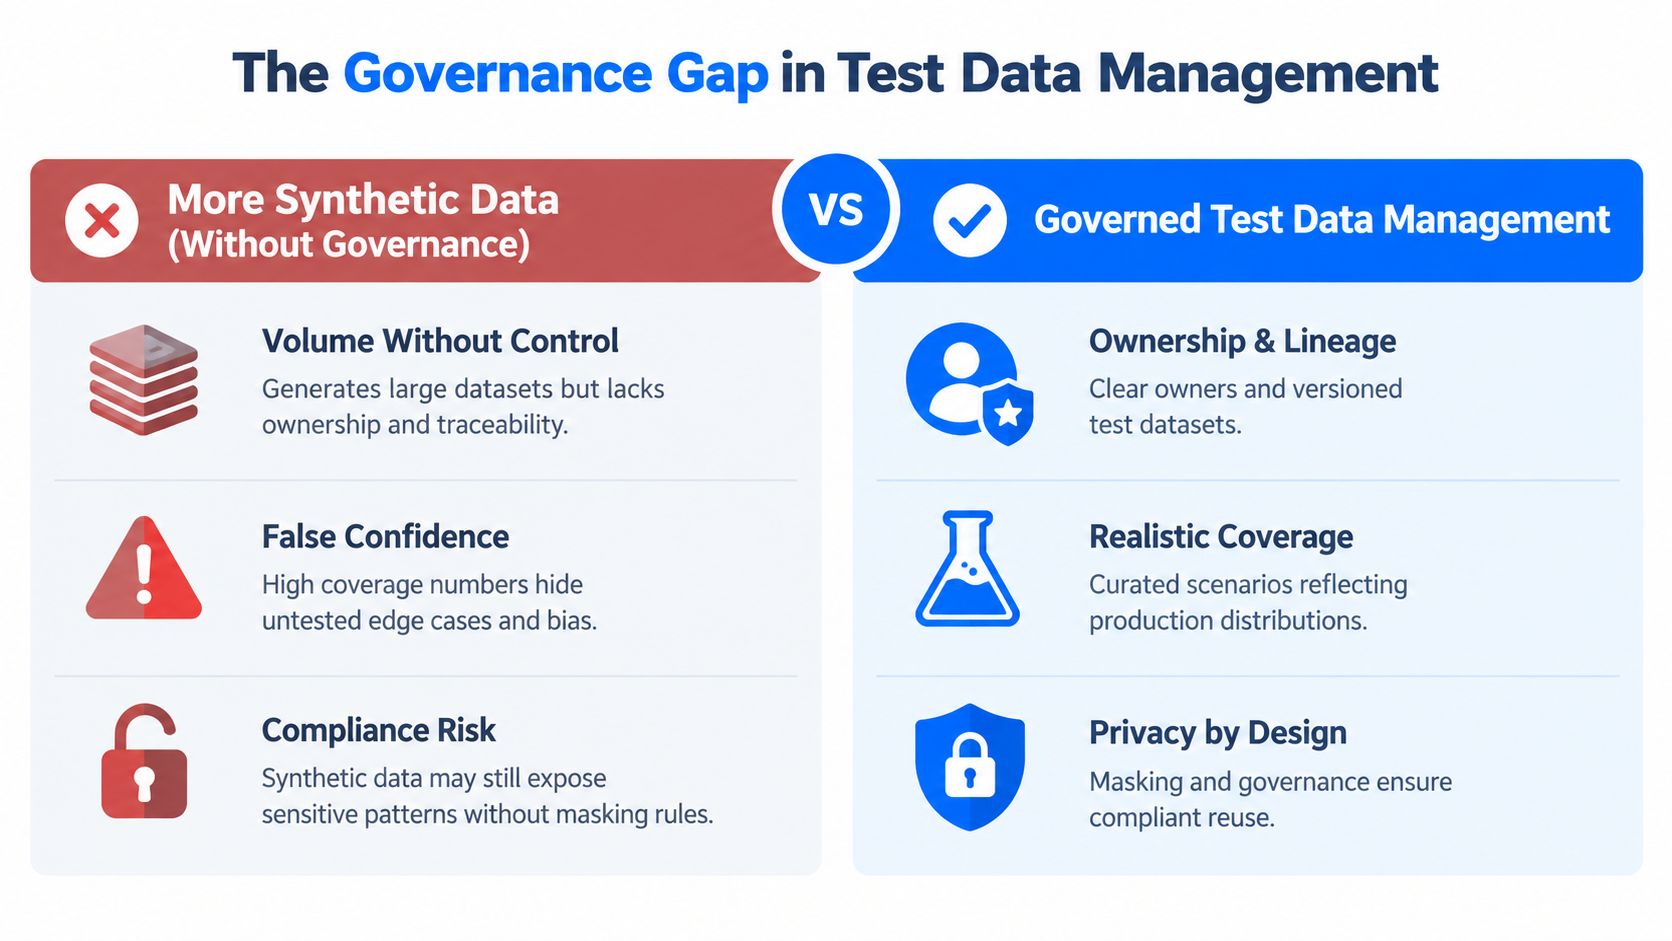
Synthetische Testdaten können die Szenarioabdeckung erweitern, doch Volumen allein schafft kein vertrauenswürdiges Testen. Teams müssen wissen, wem jeder Datensatz gehört, welche Produktionsmerkmale er abbildet, wie er erzeugt wurde und ob er sicher wiederverwendet werden kann.
Die Zusammenfassung des World Quality Report 2025 bis 2026 berichtet, dass 95 % der Organisationen KI zur Testdatenerzeugung einsetzen, während nur 10 % ein KI-gestütztes Testdatenmanagement vollständig integriert haben und knapp 50 % keine zentrale Verantwortung besitzen (Zusammenfassung des World Quality Report). Dieselbe Quelle berichtet, dass 35 % bei mehr als einem Viertel ihrer Testdaten auf synthetische Daten setzen. Zusammen beschreiben diese Befunde ein Governance-Problem, nicht bloß ein Erzeugungsproblem.
Mehr Daten können weniger Abdeckung verbergen
Ungesteuerte synthetische Daten wirken oft produktiv, weil sie schnell viele Datensätze erzeugen. Doch erzeugtes Volumen kann seltene Kombinationen, realistische Verteilungen, ungültige Übergänge oder die Grenzfälle auslassen, die Produktionsausfälle verursachen. Eine Testsuite kann daher breit erscheinen und dort schwach bleiben, wo das tatsächliche Risiko konzentriert ist.
Gesteuertes Testdatenmanagement braucht ein klares Betriebsmodell:
Ownership: Weisen Sie Verantwortung für Erstellung, Freigabe, Pflege und Stilllegung von Datensätzen zu.
Nachverfolgbarkeit: Halten Sie Quellmerkmale, Erzeugungslogik, Transformationen, Versionen und vorgesehene Testszenarien fest.
Durchsetzung von Richtlinien: Wenden Sie Maskierung, Zugriff, Aufbewahrung und Wiederverwendung konsistent an.
Abdeckungsprüfung: Vergleichen Sie synthetische Szenarien mit dem Produktionsverhalten und bekannten Fehlerbildern.
Integration: Verbinden Sie Testdaten-Workflows mit Delivery-Pipelines, Qualitätsergebnissen und Vorfallsbehebung.
Datenschutz verlangt ebenfalls mehr, als Daten „synthetisch“ zu nennen. Erzeugte Datensätze können sensible Muster reproduzieren oder realen Verteilungen so nahekommen, dass Exposition entsteht, wenn Teams Maskierung und Zugriffskontrollen auslassen. Governance muss den gesamten Lebenszyklus abdecken, von der Erstellung über Speicherung, Weitergabe und Ausführung bis zur Löschung.
Die kontraintuitive Schlussfolgerung ist praktisch: mehr synthetische Daten bedeuten nicht automatisch besseres Testen. Ohne zentrale Verantwortung und Nachverfolgbarkeit können sie Fragmentierung, falsches Vertrauen und blinde Flecken hinzufügen. Teams sollten auf repräsentative Szenarien und verantwortete Wiederverwendung optimieren, nicht auf Datensatzmenge.
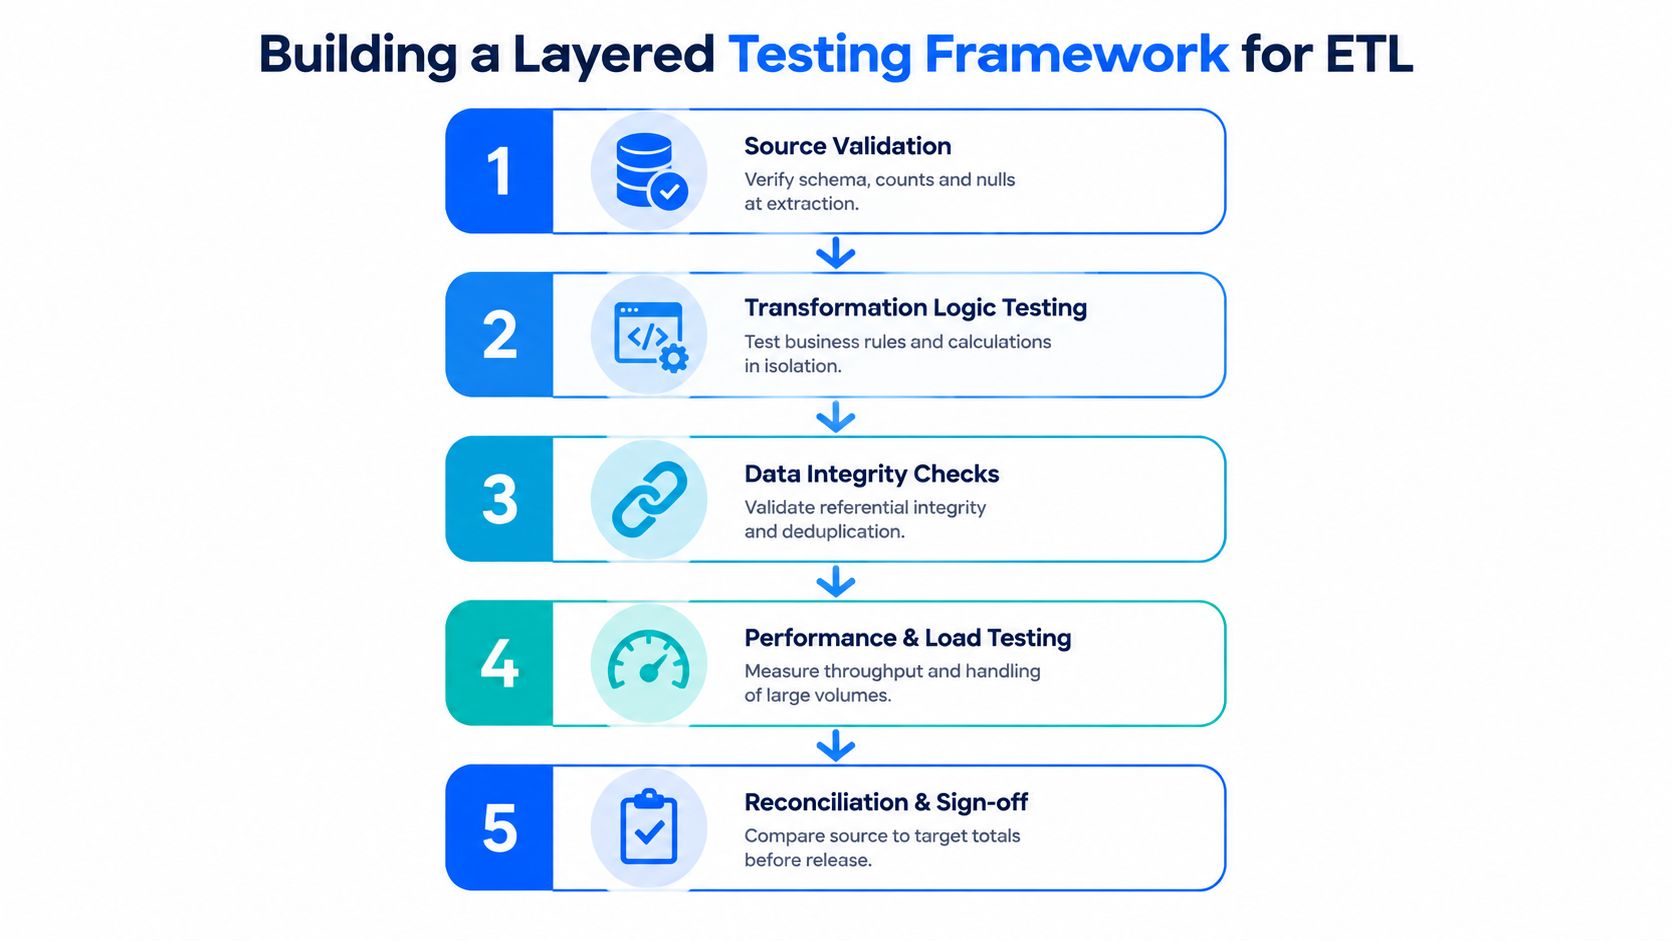
Ein geschichtetes Testframework für ETL aufbauen
Ein ETL-Job sollte als ungeprüft gelten, bis er Aktualitäts-, Schema- und Datensatzprüfungen besteht. Diese Kontrollen der Reihe nach laufen zu lassen gibt Engineers einen schnellen Weg, Lieferfehler von strukturellen Änderungen und inhaltlichen Defekten zu unterscheiden.
Mit Lieferung und Struktur beginnen
Aktualität kommt zuerst. Bestätigen Sie, dass der erwartete Ladevorgang innerhalb des fachlichen Zeitfensters des Datensatzes eingetroffen ist. Eine technisch gültige Tabelle mit den Daten von gestern kann für eine operative Entscheidung dennoch unbrauchbar sein. Timeliness-Alerts sollten auslösen, wenn die Lieferverzögerung dieses definierte Fenster überschreitet, statt sich auf einen generischen Zeitplan ohne Geschäftskontext zu stützen.
Schemaprüfungen folgen. Überwachen Sie hinzugefügte Spalten, entfernte Spalten und Änderungen von Datentypen. Manche Änderungen sind kompatibel und beabsichtigt, andere brechen Transformationen oder verändern nachgelagerte Bedeutung ohne Vorwarnung. Der Alert sollte betroffenes Objekt, Änderungsart, Verantwortung und nachgelagerte Abhängigkeiten enthalten.
Danach die Validierung auf Datensatzebene. Prüfen Sie Null-Vorkommen, exakte Werte, Schwellen, Bereiche, Referenzlisten, Duplikate, Beziehungen und Geschäftsregeln. Halten Sie diese Prüfungen nah an der Transformations- oder Zielschicht, wo die passende Semantik verfügbar ist.
Nutzen Sie für die Umsetzung ein Release-Gate, das jede Schicht eigenständig protokolliert:
Quellvalidierung: Bestätigen Sie erwartete Struktur, Volumen und Pflichtfelder vor der Transformation.
Transformationslogik: Testen Sie Berechnungen, Mappings, Filter und Geschäftsregeln isoliert.
Integritätsvalidierung: Prüfen Sie referenzielle Beziehungen, Eindeutigkeit, Deduplizierung und Abstimmung.
Performance-Beobachtung: Überwachen Sie Ausführungsverhalten, Durchsatz und Umgang mit der Last.
Release-Freigabe: Vergleichen Sie Quell- und Zielnachweise und halten Sie Entscheidung sowie genehmigte Ausnahmen fest.
Korrektheit dort berechnen, wo die Daten liegen
SQL-basierte Validierungsregeln können nativ auf der Compute-Engine der Quelle laufen und ersparen unnötige Extraktion für Datensatzprüfungen. Actians Dokumentation beschreibt eine konkrete Korrektheitsberechnung anhand des Anteils der Datensätze mit is_valid = 1 (Datenqualitätsvalidierung auf Datensatzebene). Nützlich ist nicht die Bezeichnung selbst, sondern die Fähigkeit, ein transparentes Ergebnis auf Datensatzebene nahe an der Quelle zu berechnen und die Nachweise fehlgeschlagener Datensätze für die Behebung zu bewahren.
Einen Überblick über ETL-Konzepte im Testkontext bietet was ETL im Software-Testing bedeutet. Das wichtigste Umsetzungsdetail ist der Umgang mit Fehlern. Eine fehlgeschlagene Aktualitätsprüfung sollte die nachgelagerte Veröffentlichung stoppen oder in Quarantäne stellen, während eine kleine Zahl ungültiger Datensätze je nach Risiko und Geschäftsrichtlinie zur Behebung geleitet werden kann.
Qualität mit Observability in der Datenbank skalieren
Kontinuierliche Datenqualitätstests werden schwierig, wenn jede Kennzahl Datenbewegung, separate Infrastruktur und eine andere Oberfläche verlangt. Observability in der Datenbank ändert die Architektur, indem sie Qualitätssignale innerhalb der bestehenden Umgebung des Kunden berechnet und auswertet.
Dieser Entwurf reduziert unnötige Bewegung und hält Zugriffskontrollen im Einklang mit den Systemen, die Produktionsdaten ohnehin schützen. Er erlaubt Engineers zudem, Warehouse-Tabellen, Lake-Assets und Pipeline-Ergebnisse zu überwachen, ohne eine Parallelkopie allein für die Qualitätsanalyse zu erzeugen. Für Teams mit strengen Sicherheits- oder Governance-Anforderungen ist der Unterschied wichtig: Die Plattform analysiert Daten dort, wo sie liegen, statt zu verlangen, dass Produktionsdatensätze die Umgebung verlassen.
Statistik, Regeln und operativen Kontext verbinden
Eine praktikable Observability-Schicht sollte mehrere Formen von Nachweisen vereinen:
Statistische Baselines: Lernen Sie normales Volumen, Verteilungen und Schwankung je Datensatz.
Deterministische Validierung: Setzen Sie Geschäftsregeln und Vorgaben auf Datensatzebene durch.
Timeliness-Monitoring: Erkennen Sie späte, fehlende oder unerwartet frühe Lieferungen.
Schema-Tracking: Erkennen Sie hinzugefügte oder entfernte Spalten und Typänderungen.
Lineage und Ownership: Verbinden Sie Vorfälle mit betroffenen Konsumenten und zuständigen Teams.
Gemeinsamer Status: Geben Sie Engineers, Analysten und Fachverantwortlichen eine gemeinsame Sicht auf Qualität.
Der Ansatz der Datenqualitätsausführung in der Datenbank ist nützlich, wenn Teams diese Kontrollen brauchen, ohne sensible Produktionsdaten zu exportieren. Der Kompromiss ist, dass Observability weiterhin durchdachte Konfiguration braucht. Baselines können lärmende Alerts erzeugen, wenn Teams Saisonalität ignorieren, Verantwortung unklar ist oder Konsumenten nicht sehen, warum ein Vorfall zählt.
Das tragfähige Betriebsmodell behandelt Datenqualität als Service Level für Information. Teams definieren, was korrekt sein muss, was pünktlich eintreffen muss und welche Änderungen eine Prüfung erfordern. Die Überwachung misst dann nicht nur, ob die Bedingung verletzt wurde, sondern auch, wie schnell Menschen das erkannt und behoben haben.
Datenqualitätstests sind keine einmalige Migrationsaufgabe. Sie sind eine fortlaufende Praxis, die Analytik, Reporting und KI-Systeme vor stillen Änderungen und verzögerter Reaktion schützt.
digna bietet Anomalieerkennung in der Datenbank, Validierung auf Datensatzebene, Timeliness-Monitoring und Schema-Tracking innerhalb Ihrer eigenen Datenumgebung. Besuchen Sie digna, um zu prüfen, wie die modulare Observability-Plattform Ihrem Team hilft, Qualitätsfehler früher zu erkennen und technische Vorfälle mit den betroffenen Datensätzen und Entscheidungen zu verbinden.
Tests sagen Ihnen, dass eine Regel fehlgeschlagen ist; Data Platform Observability sagt Ihnen, welche vorgelagerte Änderung sie ausgelöst hat — und genau das drückt die MTTR, nicht allein die MTTD.
Häufig gestellte Fragen
Wie lange dauert heute die Erkennung von Datenvorfällen?
Länger als früher. In einer Branchenumfrage von 2026 gaben 68 % der Befragten an, die Erkennung habe vier Stunden oder mehr gedauert, gegenüber 62 % im Jahr 2022, während die durchschnittliche Behebungszeit um 166 % auf 15 Stunden je Vorfall stieg.
Warum gehören MTTD und MTTR in ein Qualitätsprogramm?
Weil Korrektheit allein den Schaden nicht begrenzt. Mean Time to Detect misst die Verzögerung, bis ein Team von einem Vorfall weiß, und die Erkennungslatenz bestimmt, wie weit ein Fehler reist, bevor ihn jemand stoppen kann.
Welche Messgrößen sollte eine Testsuite zuerst profilieren?
Die Form der Daten: Volumen und Struktur, um fehlende Ladevorgänge und strukturelle Änderungen sichtbar zu machen, Fehlwerte über Null-Anteile, Kardinalität über Distinct- und Duplikatzählungen sowie Verteilung über Minimum, Maximum, Mittelwert, Median, Standardabweichung und Schiefe.
Genügt es, Inhalte zu prüfen?
Nein. Schema- und Vollständigkeitsprüfungen können bestehen, während ein Datensatz für ein Modell oder einen Geschäftsprozess ungeeignet bleibt. Eine Zusammenfassung eines ETSI-Frameworks nennt 18 Metriken über grundlegende Qualität, Nutzbarkeit, Fairness und Datenschutz.
Wo schlagen Regeln Observability und umgekehrt?
Deterministische Regeln sollten Invarianten und vertragliche Vorgaben schützen, wo Transparenz zählt. Observability deckt sich ändernde Pipelines und unbekannte Fehlerbilder ab und zeigt Änderungen bei Aktualität, Schema und Verteilung, bevor jemand weiß, welche Bedingung zu schreiben wäre.



