Datenqualitäts-Governance: Prinzipien und Praxis
|
7
min. Lesezeit

Montagmorgen wirkt das Dashboard ruhig. Der Umsatz steht auf Grün, das Quartal fühlt sich planmäßig an, und niemand stellt unangenehme Fragen. Dann stellt die Finanzabteilung fest, dass die Quell-Pipeline Nullwerte abgeschnitten hat, die Prognose auf den falschen Zahlen beruhte und das saubere Dashboard eine sehr teure Illusion war.
Genau an diesem Punkt klingt Datenqualitäts-Governance nicht mehr abstrakt. Sie ist die Disziplin, die den Drift bemerkt, einen Alert ausgelöst, eine Verantwortung zugewiesen und ein kleines Problem weiter oben davon abgehalten hätte, zur unternehmensweiten Korrektur zu werden. Praktisch verbindet sie rohe Pipelines mit vertrauenswürdigen Entscheidungen, damit ein Dashboard nicht nur korrekt aussieht, sondern korrekt bleibt.
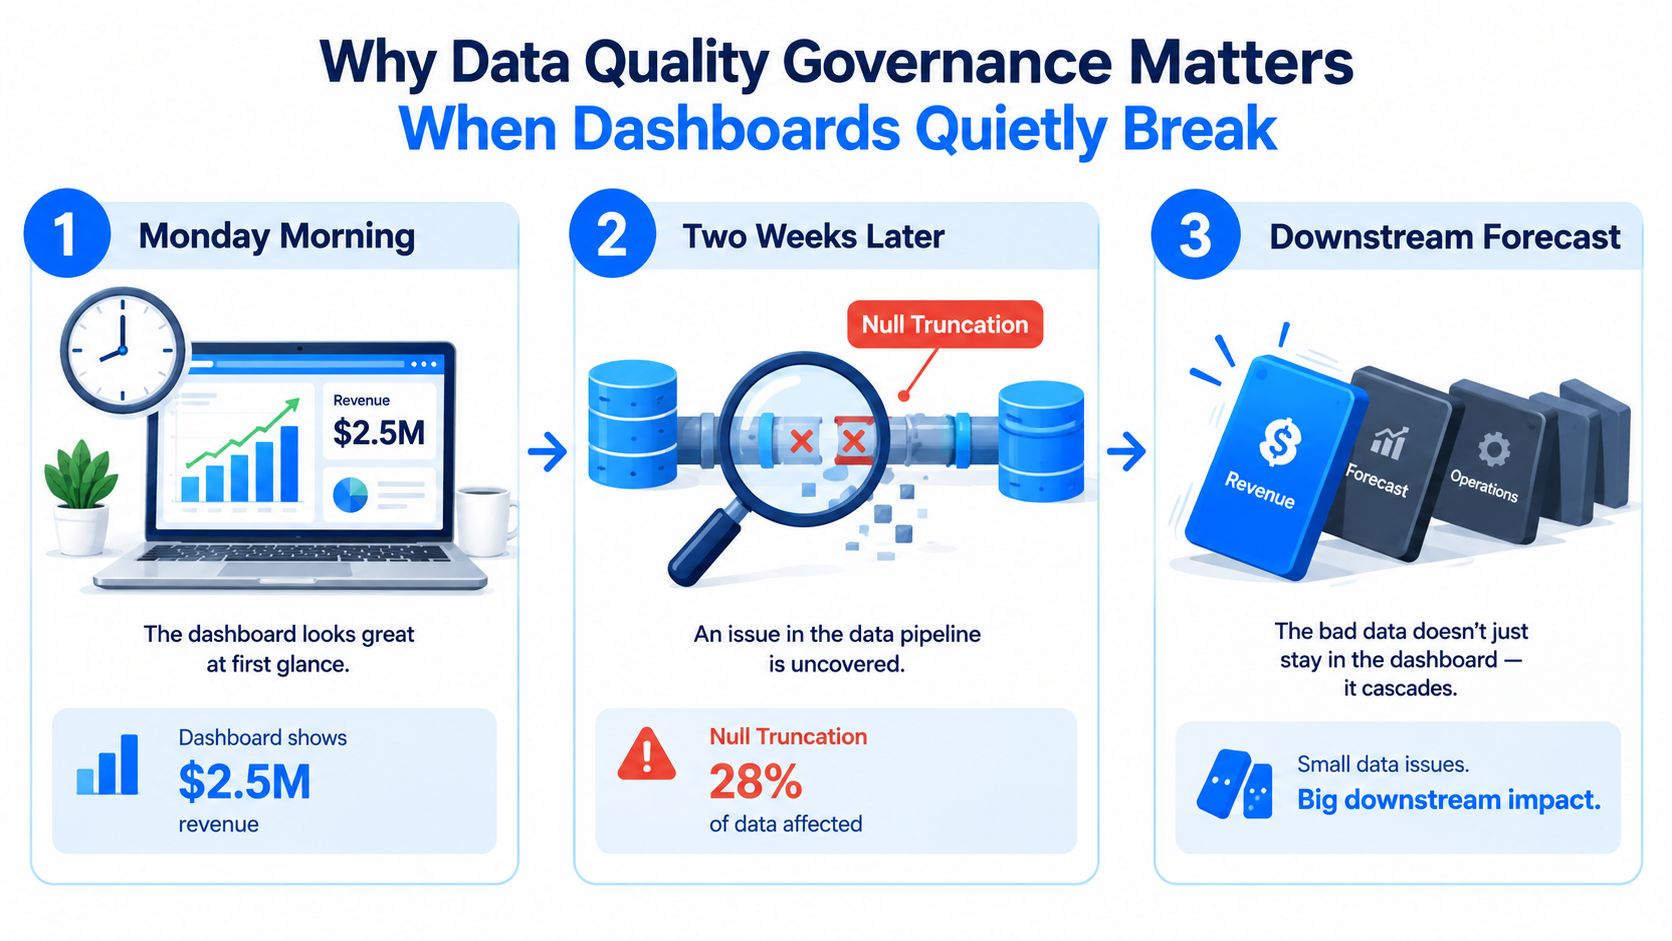
Der Rest des Leitfadens folgt der Denkweise, die eine reale Organisation braucht: erst Prinzipien, dann Rollen, Richtlinien, Kontrollen, Lebenszyklus und Observability. Wenn Sie bereits mit kaputten Berichten, veralteten Feeds oder KI-Trainingsdaten kämpfen, die nicht ganz aufgehen, lautet die praktische Frage nicht, ob Governance zählt. Sie lautet, wie man sie früh genug sichtbar macht, um etwas Nützliches zu tun.
Inhaltsverzeichnis
Warum Datenqualitäts-Governance zählt, wenn Dashboards leise brechen
Was schlechte Datenqualität kostet und warum es Governance gibt
Rollen und Verantwortlichkeiten in einem Datenqualitäts-Governance-Programm
Warum Datenqualitäts-Governance zählt, wenn Dashboards leise brechen
Ein kaputtes Dashboard meldet sich selten selbst. Meist kommt es zuerst als fehlgeleitete Zuversicht und erst später als Verwirrung. Am Montag sehen die Zahlen gut aus. Zwei Wochen später bemerkt jemand, dass das Quellsystem Nullwerte verworfen hat und jede nachgelagerte Prognose auf Fiktion beruhte.
Deshalb kann Governance nicht nur in Dokumentation leben. Datenqualitäts-Governance ist die Kontrollschicht, die auf Drift achtet, ein Problem an eine Verantwortung bindet und es weiterleitet, bevor der Schaden sich ausbreitet. In einer gesteuerten Umgebung wird die Pipeline wie ein überwachter Geschäftsprozess behandelt, und moderne Observability-Werkzeuge geben dieser Disziplin einen Ort im Datenfluss statt nur auf Papier.
Was zuerst bricht
Der erste Ausfall betrifft meist das Vertrauen. Analysten prüfen Berichte erneut, Teams streiten, welche Version stimmt, und Entscheidungen verlangsamen sich, weil niemand den Zahlen vor sich glaubt. Dieser verlorene Aufwand ist ein Grund, warum schlechte Datenqualität im großen Maßstab so teuer geworden ist: IBMs Zusammenfassung eines Berichts von 2025 nennt, dass mehr als ein Viertel der Organisationen jährlich über 5 Millionen USD verliert und 7 % Verluste von 25 Millionen USD oder mehr melden.
Der zweite Ausfall ist operativ. Eine auf abgeschnittenen Daten gebaute Vertriebsprognose kann zu Überverpflichtung führen, ein Nachschubplan kann den Bestand überschießen, und ein Modell kann dasselbe schlechte Signal erben wie das Dashboard. Das Problem wächst, weil niemand es an der Quelle abfängt.
Ein Governance-Programm ist nur so nützlich wie seine Fähigkeit, das Problem zu erkennen, solange noch Zeit zum Handeln bleibt.
Observability ändert die Geschichte. Ein Sprung in der Null-Rate, eine unerwartete Schemaänderung, ein spät eintreffender Feed oder ein fehlender Datensatz muss nicht warten, bis die Finanzabteilung es bemerkt. KI-gestützte Anomalieerkennung, Timeliness-Monitoring, Schema-Tracking und Validierung auf Datensatzebene können das Problem innerhalb der Pipeline sichtbar machen, mit bereits angehängten Nachweisen und bereits klarer Verantwortung.
Für Teams, die gesteuerte Daten mit Live-Reporting verbinden wollen, zeigt dieser Überblick zu Datenqualitäts-Dashboards, wie Dashboards von statischem Reporting zu aktiver Kontrolle werden. Dieser Unterschied zählt. Ein Dashboard, das nur die Vergangenheit spiegelt, kann Drift verbergen. Eines, das an Monitoring und Validierung hängt, kann ihn früh genug melden, um zu korrigieren.
Die Kernprinzipien der Datenqualitäts-Governance
Im Kern ist Datenqualitäts-Governance die Menge der Prinzipien, Rollen und Kontrollen, die Daten für ihren beabsichtigten Einsatz geeignet halten. Die Prinzipien klingen geradlinig, doch jedes muss in einem echten Prozess, an einem echten Datensatz, von einer echten verantwortlichen Person geprüft werden. Ist eine Schicht vage, wird schnell das Ganze schwammig.
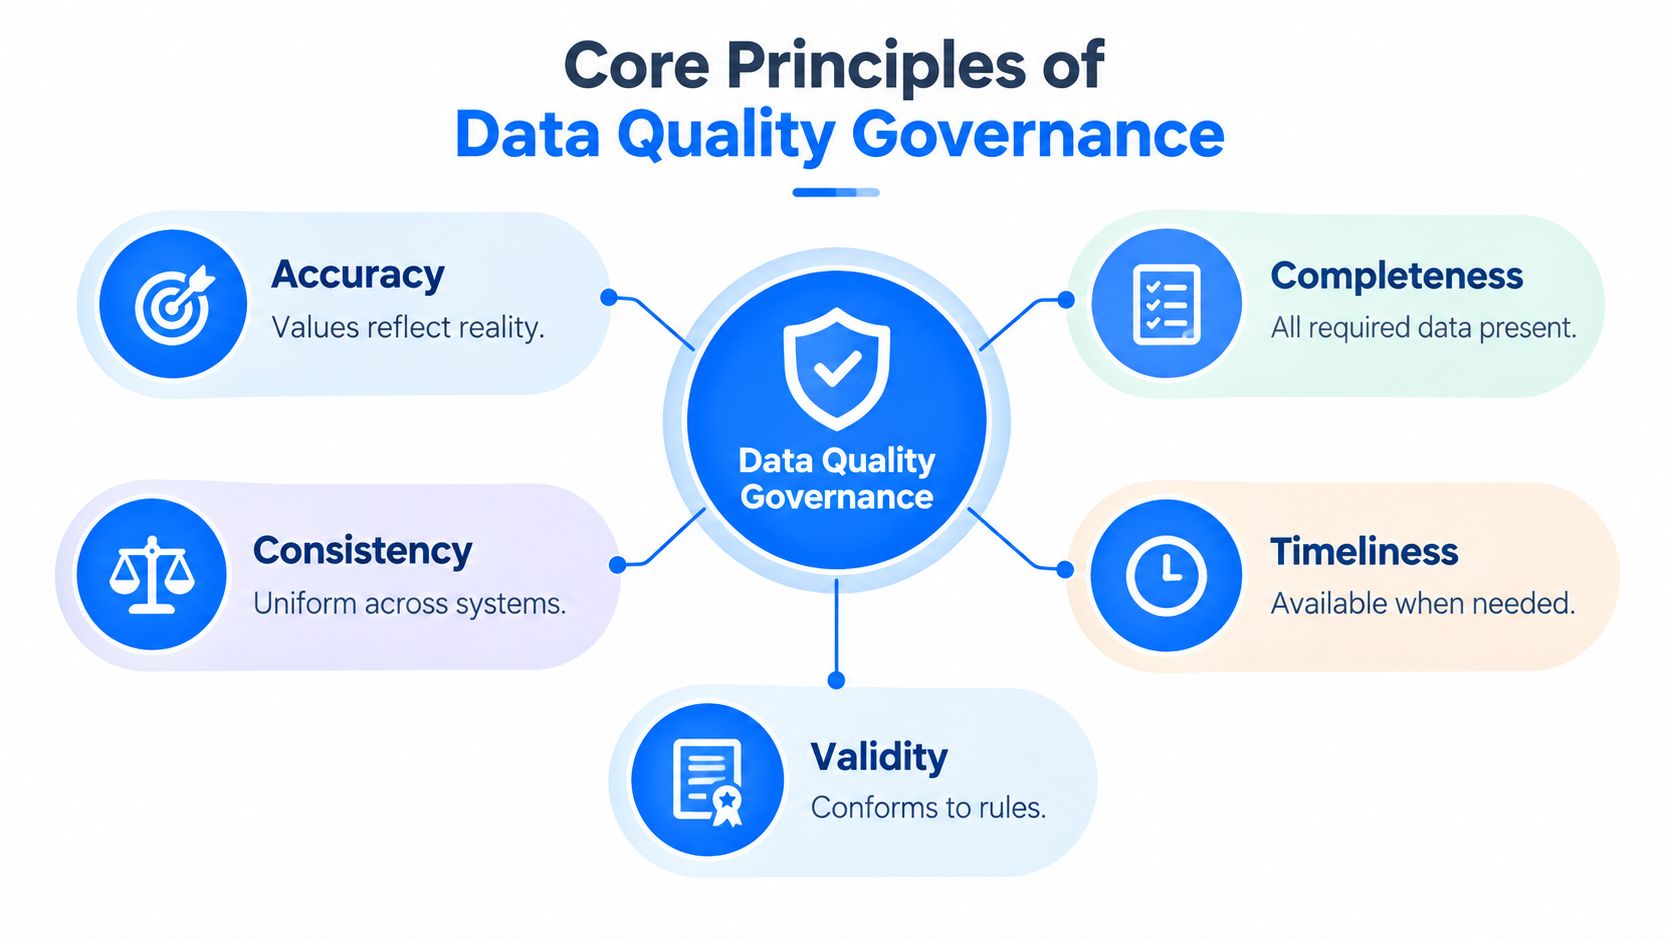
Die fünf Dimensionen, die in der Praxis zählen
Genauigkeit heißt, dass Werte die Realität abbilden. Eine Kundenadresse, die noch auf eine alte Wohnung zeigt, mag eine Formatprüfung bestehen, ist aber falsch, wenn ein Kurier dort nicht zustellen kann.
Vollständigkeit heißt, dass die benötigten Daten vorhanden sind. Ein Anmeldedatensatz ohne E-Mail oder ohne Einwilligungskennzeichen kann strukturell in Ordnung wirken und für den Geschäftsprozess dennoch unbrauchbar sein.
Konsistenz heißt, dass dasselbe überall dasselbe bedeutet. Wird Währung in der Finanzabteilung anders gespeichert als im Betrieb, wird Abstimmung zur manuellen Detektivarbeit.
Timeliness heißt, dass die Daten früh genug eintreffen, um die Entscheidung zu stützen. Ein veralteter Bestands-Feed mag technisch korrekt und trotzdem nutzlos sein, wenn das Lager längst weiter ist.
Gültigkeit heißt, dass die Daten den gesetzten Regeln entsprechen. Eine E-Mail-Adresse, die keinem gültigen Muster entspricht, sollte früh scheitern und nicht erst auffallen, wenn eine Kampagne zurückkommt.
Unter diesen fünf liegen zwei stützende Eigenschaften. Verlässlichkeit sagt den Menschen, dass sie sich auf erwartetes Verhalten der Daten stützen können, und Verfügbarkeit heißt, dass die Daten erreichbar sind, wenn man sie braucht. Zusammen machen sie aus einem schön klingenden Prinzip ein funktionierendes Betriebsmodell.
Wenn Sie eine verwandte Sichtweise aus einer anderen Domäne suchen: Der Artikel über die Genauigkeit von Gemeindefinanzen zeigt, wie sehr sorgfältige Datenführung zählt, wenn öffentliches Vertrauen und rechenschaftspflichtige Berichte auf dem Spiel stehen. Die Lehre lässt sich sauber übertragen, auch wenn der Kontext wechselt.
Für Teams, die das in ein breiteres Betriebsmodell einbauen, ist die DMBOK-Übersicht von digna ein praktischer Bezugspunkt. Sie hilft, Qualitätskontrollen in der weiteren Governance-Struktur zu verorten, statt sie als isolierte Prüfungen zu behandeln.
Was schlechte Datenqualität kostet und warum es Governance gibt
Schlechte Datenqualität erzeugt nicht eine einzelne Ausgabe. Sie beginnt mit verlorener Analystenzeit, weil Menschen Abfragen erneut laufen lassen, Berichte abstimmen und derselben Abweichung nachjagen, da niemand der ersten Antwort traut.
Dann erreicht sie das Geschäft. Ein Team, das wegen eines falschen Feeds zu viel Bestand einlagert, zahlt diesen Fehler im Betrieb, nicht nur im Backlog des Datenteams. Governance gibt es, um Fehler zu stoppen, bevor sie sich ausbreiten.
Die Kostenleiter und die Kontrolle auf jeder Sprosse
Unten auf der Leiter fangen Validierungsregeln offensichtliche Probleme früh ab. Ein fehlendes Pflichtfeld, eine fehlerhafte E-Mail oder ein unmöglicher Wert sollte scheitern, bevor der Datensatz zur Aufräumarbeit eines anderen wird.
Eine Stufe höher fangen Anomalieerkennung und Freshness-SLAs Änderungen ab, die technisch gültig, operativ aber falsch sind. Ein Feed, der täglich zu spät kommt, oder eine Kennzahl, die aus ihrem Normalbereich springt, braucht Aufmerksamkeit, auch wenn das Schema noch stimmt. Das ist die Brücke zwischen Richtlinie und Observability: Die Regel wird einmal geschrieben, dann prüft die Pipeline sie fortlaufend.
Weiter oben zählen Audit-Trails und Genehmigungs-Workflows, wenn das Problem Offenlegungen, reguliertes Reporting oder einen Prozess betrifft, der Nachweise über Freigaben braucht. Muss eine Änderung später erklärt werden, muss der Nachweis dieser Entscheidung jetzt entstehen.
Ganz oben verbinden durchgängige Lineage und Verantwortung für die Behebung den fehlerhaften Datensatz mit den Dashboards, Berichten oder Modellen, die er berührt hat. Ohne diese Spur beheben Teams das Symptom und verfehlen die Quelle, wie ein Leck abzudichten, ohne das Rohr zu finden.
Vorbeugung ist billiger als Korrektur, weil jeder nachgelagerte Konsument die Aufräumkosten vervielfacht.
Diese ökonomische Logik ist nicht abstrakt. Eine Literaturübersicht führte 23 Beispiele für Kosten schlechter Daten an, darunter Wartung, Mehrarbeit, Neueingabe, Umsatzverlust, Kundenverlust und Nacharbeit, weshalb Governance mehr ist als aufgeräumte Metadaten. Dieselbe Übersicht nannte ein Modell von Dun & Bradstreet, wonach die Behebung eines Datenproblems etwa 1 USD pro Datensatz vor dem Eintritt ins System kostet, 10 USD pro Datensatz nach der Erfassung und 100 USD pro Datensatz nach einem Ereignis, sodass der Zeitpunkt die Ökonomie verändert. Siehe die Übersicht zu Kostenkategorien und Ökonomie je Datensatz.
Für ein Governance-Team ist das der praktische Fall in einfacher Sprache. Fangen Sie das Problem früh ab, bleibt es lokal. Fangen Sie es spät ab, zahlt jedes Team auf dem Weg mit.
Rollen und Verantwortlichkeiten in einem Datenqualitäts-Governance-Programm
Ein Governance-Programm scheitert am schnellsten, wenn niemand weiß, wem der fehlerhafte Datensatz gehört. Die Lösung ist ein einfaches Verantwortungsmodell, meist wie ein RACI aufgebaut, in dem eine Gruppe rechenschaftspflichtig ist, andere ausführen und niemand annehmen darf, das Problem gehöre jemand anderem.
Wer was verantwortet
Der Data-Governance-Council oder der Executive Sponsor ist für Ergebnis und Risikohaltung rechenschaftspflichtig. Bricht die Qualität in einer Domäne wiederholt, ist das nicht nur ein technisches Ärgernis, sondern eine Führungsfrage.
Data Owner sind meist leitende Fachverantwortliche. Sie entscheiden, wie akzeptable Qualität in ihrer Domäne aussieht, und genehmigen dann Prioritäten bei der Behebung, wenn verschiedene Korrekturen um Aufmerksamkeit konkurrieren.
Data Stewards übersetzen diese Regeln in tägliche Praxis. Sie schreiben fachliche Definitionen, prüfen Anomalien, koordinieren Korrekturen und sorgen dafür, dass die Regeln für die Nutzenden dasselbe bedeuten.
Data Engineers setzen die Prüfungen in Pipelines um und verantworten die Infrastruktur, die sie durchsetzt. Läuft die Kontrolle nicht dort, wo die Daten fließen, schützt sie nichts.
Platform- und Analytics-Engineers halten Werkzeuge, Workflow-Integration und Lieferwege stabil genug, damit die Kontrollen reibungslos arbeiten. Compliance-Partner kommen hinzu, wenn die Nachweise einer Prüfung oder Regulierung standhalten müssen.
Rolle | Hauptaufgabe | Rechenschaftspflichtig für |
|---|---|---|
Executive Sponsor oder Governance Council | Richtung vorgeben und große Risikoabwägungen entscheiden | Programmergebnisse und Risikohaltung |
Data Owner | Akzeptable Qualität in der Fachdomäne definieren | Domänenentscheidungen und Priorität der Behebung |
Data Steward | Definitionen pflegen und Korrekturen koordinieren | Tägliches Qualitätsmanagement |
Data Engineer | Validierung in Pipelines bauen und betreiben | Technische Durchsetzung der Kontrollen |
Platform- oder Analytics-Engineer | Monitoring- und Lieferwege am Laufen halten | Operative Zuverlässigkeit des Kontroll-Stacks |
Compliance-Partner | Nachweise und Richtlinienkonformität prüfen | Auditbereitschaft und regulatorische Belastbarkeit |
Eine ausführlichere Aufschlüsselung dieser Übergaben bietet dieser Leitfaden zu Rollen und Verantwortlichkeiten in der Datenqualität. Achten Sie vor allem auf das klassische Versagensmuster, bei dem alle denken, jemand anderes beobachte dasselbe Problem.
Richtlinien, Standards und maschinell prüfbare Konformität
Richtlinien sind die geschriebene Absicht. Standards sind die messbare Fassung dieser Absicht. Konformität ist der Teil, in dem das System belegt, dass die Daten den Standard erfüllt haben, nicht nur das Richtlinienmemo.
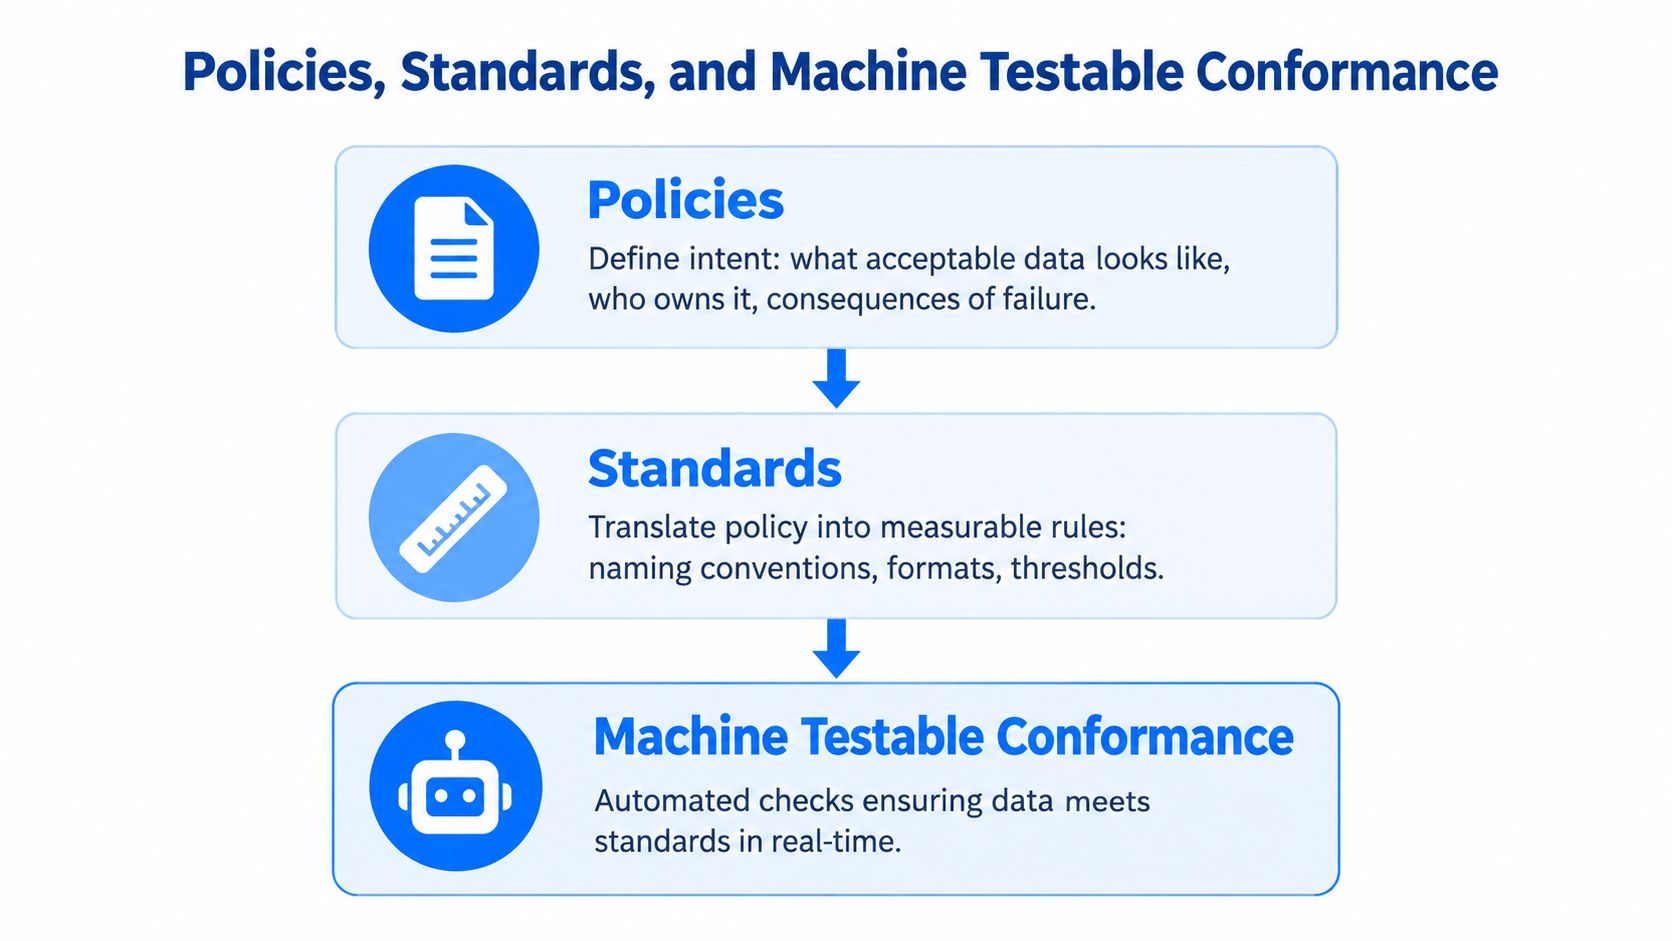
Absicht in etwas überführen, das eine Pipeline durchsetzen kann
Eine Richtlinie könnte sagen, Kernkundendaten müssten für den operativen Einsatz vertrauenswürdig genug sein. Ein Standard macht das konkret, etwa indem er verlangt, dass die Kundentabelle innerhalb eines festgelegten Aktualitätsfensters landet oder kritische Felder unter einem definierten Null-Schwellenwert bleiben.
Das ist der Unterschied zwischen einer Regel und einer Hoffnung. Eine Richtlinie ohne Test ist bloß Anspruch. Ein Test ohne Richtlinie ist bloß eine technische Prüfung ohne Governance-Bedeutung.
ISO 8000-51:2023 macht diese Idee sehr konkret. Die Norm legt Anforderungen für den Austausch von Data-Governance-Richtlinienaussagen und für automatisierte Konformitätsprüfungen von Datensätzen gegen die in diesen Aussagen benannten Spezifikationen fest und verknüpft damit die geschriebene Ebene direkt mit maschinell geprüfter Durchsetzung ISO 8000-51:2023.
Wie maschinell prüfbare Konformität aussieht
In der Praxis erscheint sie als Assertions, Schemaprüfungen, Contract-Tests und Validatoren auf Pipeline-Ebene. Ein Team erzwingt vielleicht eine Namenskonvention beim Ingest, ein anderes prüft Pflichtfelder vor dem Training eines Modells, und ein drittes blockiert die Veröffentlichung, wenn sich das Schema unerwartet ändert.
Das Rahmenwerk der britischen Regierung ist hier nützlich, weil es Organisationen zu formaler Governance, vereinbarten Prinzipien und Standards drängt, die Daten wiederverwendbar und interoperabel machen Government Data Quality Framework. Es ist dieselbe Logik, die Teams in der Privatwirtschaft brauchen, wenn sie Nachweise wollen und nicht nur Absichten.
Für ein detaillierteres Betriebsmodell ist die Seite zu Datenqualitätsstandards von digna ein praktischer Anker für das Gespräch. Sie verhindert, dass Richtlinie, Standard und Durchsetzung in ein vages Dokument zusammenfallen.
Validierung und Behebung als kontinuierlicher Lebenszyklus
Qualitätsarbeit ist keine einmalige Aufräumaktion. Sie ist eine Schleife. Die Schleife beginnt, wenn etwas Ungewöhnliches auftaucht, und endet erst, nachdem die Korrektur gegen dieselbe Kontrolle geprüft wurde, die das Problem zuerst gefunden hat.
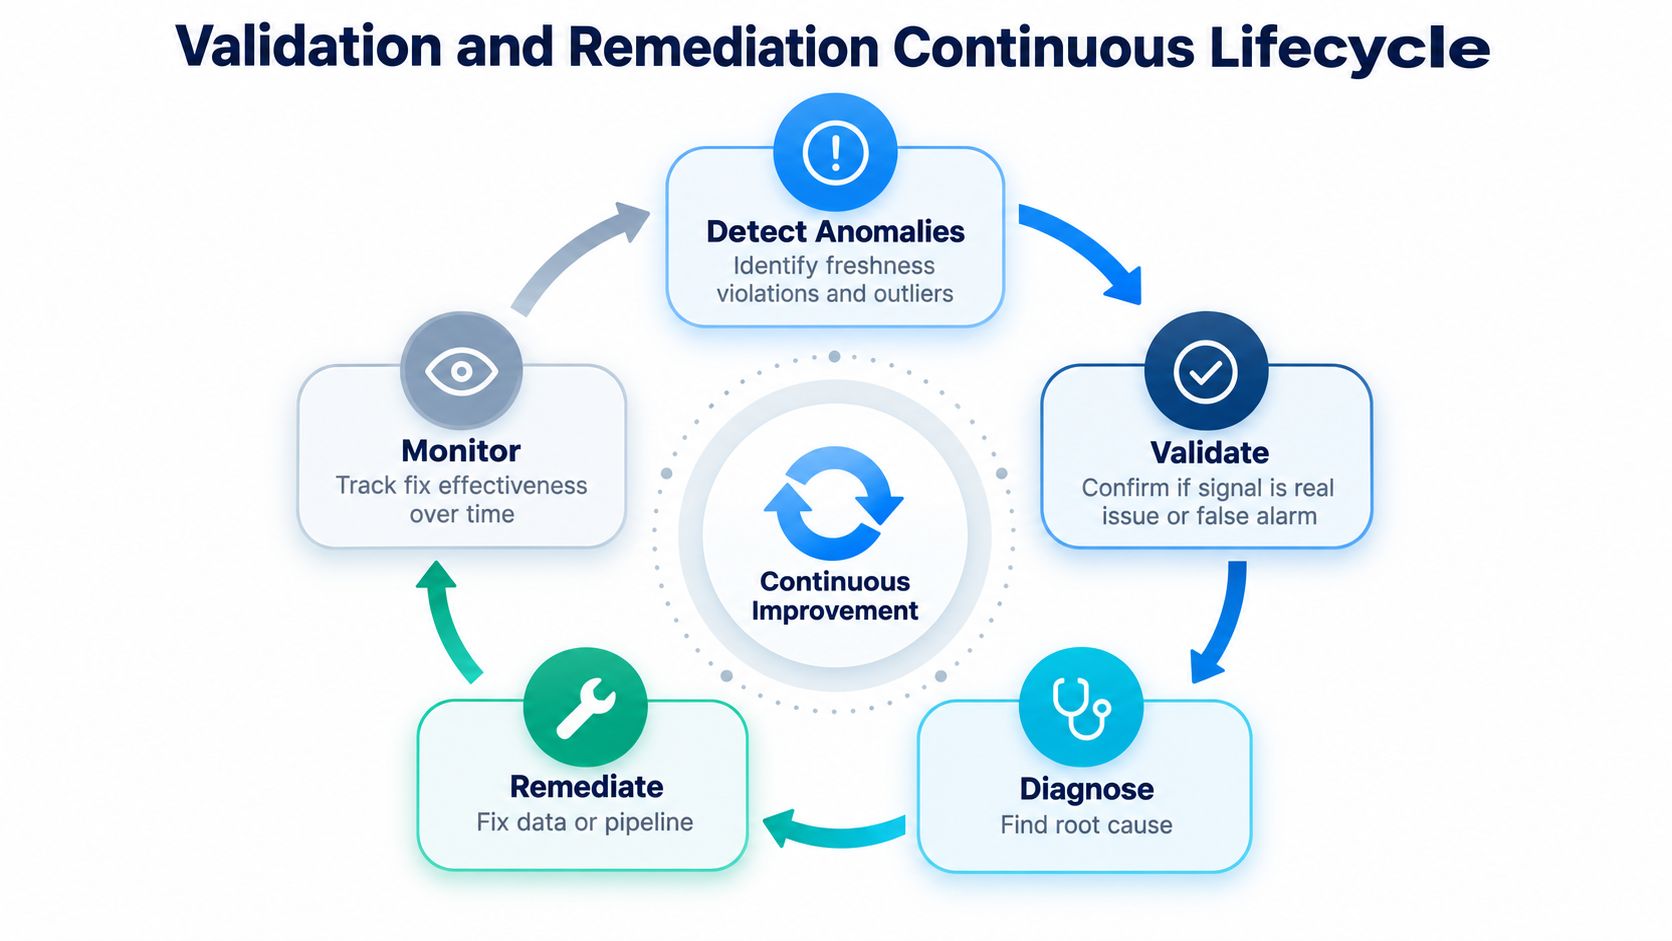
Die fünfstufige Schleife
Erstens erkennen. KI-gestützte Anomalieerkennung kann statistische Ausreißer sichtbar machen, Timeliness-Monitoring kann späte Ladevorgänge melden, und Schema-Tracking kann hinzugefügte, entfernte oder typgeänderte Attribute abfangen, bevor nachgelagerte Nutzende den Bruch spüren.
Zweitens validieren. Nicht jeder Alert ist ein Defekt. Manche sind erwarteter Drift, saisonale Veränderung oder ein Geschäftsereignis, das Kontext braucht, bevor jemand die Pipeline anfasst.
Drittens priorisieren. Die richtige Frage lautet nicht nur „Ist es kaputt?“, sondern „Welche Auswirkung hat es, und was hängt noch daran?“. Lineage zählt hier, denn eine fehlerhafte Tabelle kann eine lange Kette von Berichten und Modellen betreffen.
Viertens beheben. Korrigieren Sie die Quelle, wenn möglich. Wenn nicht, dokumentieren Sie die kompensierende Logik und stellen Sie sicher, dass der Workaround verantwortet, sichtbar und vorübergehend ist.
Fünftens verifizieren. Die Korrektur sollte Konformität wiederherstellen, ohne Konsumenten zu brechen. Hier zählt Validierung auf Datensatzebene, denn Zeilenzahlen, referenzielle Integrität und Werteverteilungen können belegen, dass die Korrektur gewirkt hat.
Gute Behebung schließt die Schleife. Schlechte Behebung verschiebt das Problem nur in eine andere Tabelle.
Operative Plattformen wie der Integrationsbereich von Donely lohnen einen Vergleich, wenn Sie prüfen, wie Monitoring an bestehende Werkzeuge und Workflows andockt. Es geht nicht um die Marke, sondern um das Entwurfsmuster: Kontrollen sollten nahe am Datenfluss liegen, nicht mehrere Systeme entfernt.
Wie Observability Governance in messbare Praxis verwandelt
Observability macht Governance real, weil sie Prinzipien in Nachweise verwandelt. Statt auf eine monatliche Durchsicht zu warten, können Teams Aktualität, Volumen, Verteilung, Schema, Lineage und Datensatzgültigkeit beobachten, während die Daten fließen.
Was ein nützliches Governance-Dashboard zeigt
Ein ernstzunehmendes Dashboard sollte aktuelle Konformität, Trends über die Zeit, fehlgeschlagene Prüfungen, offene Ausnahmen sowie das Tempo von Erkennung und Behebung zeigen. Es sollte den Alert auch im Kontext lesbar machen, mit betroffenem Datensatz, Geschäftsprozess, Pipeline-Lauf, erwartetem Bereich, Schweregrad und dem Steward, der handeln soll.
Dieser Kontext zählt, denn ein Alert ohne Lineage ist nur Rauschen. Mit Lineage sagt derselbe Alert, welcher Bericht, welches Modell oder welcher operative Prozess das Problem spüren wird, wenn niemand handelt.
Warum Trendanalyse zählt
Ein einzelner Vorfall mag einmalig sein. Ein wiederkehrender Schema-Drift oder wiederholtes Verfehlen der Aktualität deutet meist auf eine Kontrollschwäche hin, nicht auf Zufall. Trendanalyse hilft Governance-Teams, isolierte Fehler von strukturellen Schwächen zu trennen, die eine Richtlinien- oder Prozessänderung brauchen.
Unveränderliche Prüfergebnisse zählen ebenfalls. Sie geben Auditoren Nachweise, Stewards eine Historie und der Leitung etwas Nützlicheres als die vage Versicherung, „die Zahlen sähen jetzt besser aus“.
Für Teams, die das produktiv setzen, passt dignas Sicht auf Data Observability gut zum Betriebsmuster, weil sie Anomalieerkennung, Validierung, Timeliness-Monitoring und Schema-Tracking in dem Workflow vereint, in dem das Problem auftritt. Das ist der Unterschied zwischen Richtlinie auf Papier und Kontrolle in Bewegung.
Beginnen Sie mit den kritischen Datenelementen und staffeln Sie Alerts dann nach Geschäftsrisiko. Wenn alles gleichzeitig schreit, hört niemand das Wesentliche.
Die größere Verschiebung ist kulturell. Observability ersetzt Governance nicht, sie liefert Governance Fakten schnell genug, damit Menschen danach handeln können.
Datenqualität für KI steuern und Ihre nächsten Schritte
KI erhöht den Einsatz, weil ein Modell kleine Defekte in viele Entscheidungen verstärken kann. Veraltete Features, undokumentierte Schemaänderungen, inkonsistente Labels und unvollständige Stichproben bleiben nicht lokal, sobald sie in Training oder Inferenz gelangen.
Ein praktikables Programm beginnt bei den Datensätzen, die wichtige Modelle speisen. Weisen Sie Owner und Steward zu, definieren Sie Schwellen für die Zweckeignung und testen Sie die Daten, bevor sie Training oder produktives Scoring erreichen. Dieselbe Logik gilt für Herkunft, Feature-Verteilungen, Labelqualität, Vollständigkeit, Timeliness und das Verhalten in Untergruppen über den Modell-Lebenszyklus hinweg.
Eine praktikable Einstiegs-Checkliste
Inventarisieren Sie die wichtigsten Datenprodukte: Bestimmen Sie, welche Tabellen, Feeds und Feature-Sets Umsatz, Risiko, Service oder reguliertes Reporting betreffen.
Setzen Sie zuerst wenige messbare Kontrollen: Konzentrieren Sie sich auf die Prüfungen, die die bereits erlebten Fehler gefangen hätten, nicht auf jedes theoretische Problem.
Benennen Sie den Eskalationsweg: Entscheiden Sie, wer alarmiert wird, wer entscheidet und wer eine Ausnahme genehmigen darf, wenn Daten unvollkommen, aber noch nutzbar sind.
Dokumentieren Sie Ausnahmen: Akzeptiert ein Team einen zeitweiligen Workaround, halten Sie das fest, damit dieselbe Abkürzung nicht zur neuen Normalität wird.
Prüfen Sie wiederkehrende Defekte: Nutzen Sie die Historie von Fehlern, Behebungszeiten und Richtlinienkonformität, um zu entscheiden, wohin die nächste Investition gehört.
Menschliche Prüfung zählt weiterhin, wenn Automatisierung nicht sagen kann, ob Daten semantisch korrekt, fair oder für den Anwendungsfall geeignet sind. Das gilt besonders in der KI, wo ein sauberes Schema dennoch einen schlechten Labelsatz oder eine verzerrte Stichprobe verbergen kann.
Eine breitere Branchensicht auf die KI-Druckpunkte bietet diese Umfragezusammenfassung von 2026 zu Data Governance und KI, die zeigt, wie oft Organisationen mit der Qualität von Trainingsdaten und der Abhängigkeit von Governance ringen. Die Lehre ist einfach: KI verringert den Bedarf an Governance nicht, sie legt offen, wo die Governance ohnehin dünn war.
Wenn Sie diese Idee in ein funktionierendes Programm überführen wollen: digna bietet Funktionen für Datenqualität und Observability im Unternehmensmaßstab, die Anomalien, Validierung, Timeliness und Schemaänderungen innerhalb der Kundenumgebung überwachen. Besuchen Sie digna, um zu sehen, wie diese Kontrollen in Ihre Pipelines, Ihr Governance-Modell und die KI-Workflows passen, für die Sie verantwortlich sind.
Richtlinien werden erst messbar, wenn sie auf Zahlen abbilden, die jemand wöchentlich verfolgt — beginnen Sie mit einem tragfähigen Satz an Datenqualitätskennzahlen.
Häufig gestellte Fragen
Warum darf Datenqualitäts-Governance nicht nur in Dokumentation leben?
Weil ein defektes Dashboard sich selten meldet. Governance, die als geschriebene Richtlinie existiert, hat keine Möglichkeit, das leise Versagen zu bemerken, und genau dieses Versagen sollte sie verhindern.
Was bricht zuerst, wenn Governance nur auf Papier steht?
Vertrauen. Der erste Fehler ist, dass Menschen den Zahlen nicht mehr glauben, der zweite ist operativ, weil Aufwand in das erneute Prüfen von Arbeit wandert, die längst verlässlich hätte sein sollen.
Was kostet dieser vergeudete Aufwand?
IBMs Zusammenfassung eines Berichts von 2025 nennt, dass mehr als ein Viertel der Organisationen jährlich über 5 Millionen USD durch mangelhafte Datenqualität verliert und 7 % Verluste von 25 Millionen USD oder mehr berichten.
Was macht ein Governance-Programm wirklich nützlich?
Seine Fähigkeit, das Problem zu erkennen, solange noch Zeit zum Handeln bleibt. Ein Programm, das einen genauen Bericht über das letzte Quartal liefert, ist ein Audit, und Audits kommen nach der Entscheidung an, die sie verändert hätten.
In welcher Reihenfolge baut man es auf?
Erst Prinzipien, dann Rollen, Richtlinien, Kontrollen, Lebenszyklus und Observability. Mit Kontrollen vor Rollen zu beginnen erzeugt Prüfungen ohne Verantwortung, und mit Richtlinien vor Prinzipien zu beginnen erzeugt Regeln, die niemand schlichten kann.



