7 Datenkatalog-Beispiele für bessere Governance
|
7
min. Lesezeit

Ein Katalog ist nur dann nützlich, wenn die Menschen ihm vertrauen. Der gängige Rat lautet, ein Datenkatalog-Beispiel als durchsuchbares Inventar zu betrachten, doch damit wird der eigentlich entscheidende Test verfehlt. Der stärkste Katalog hängt davon ab, welche Metadaten er erfasst, wie Ownership und Lineage durchgesetzt werden, wie Assets organisiert sind und ob jeder Eintrag genügend Zuverlässigkeitssignale enthält, damit Teams sicher darauf handeln können. Deshalb sehen die besten Beispiele je nach Betriebsmodell unterschiedlich aus – von Governance-lastigen Plattformen bis zu Active-Metadata-Systemen, von Open-Source-Flexibilität bis zu Privacy-first-Observability in Ihrer eigenen Umgebung.
Diese Perspektive ist wichtig, weil sich moderne Kataloge von schmalen Schema-Listen zu Governance-Systemen entwickelt haben. Die Ursprünge von Katalogen reichen zurück zu Data Dictionaries und manuellen Metadatenspeichern, während neuere Plattformen Lineage, Review-Workflows und Vertrauen über große Datenlandschaften hinweg unterstützen, wie die Entwicklung der Kataloggeschichte und Adoptionsmuster in der Data Governance von Unternehmen zusammengefasst werden in DataGalaxys Geschichte des Datenkatalogs und StatPits Adoptionsübersicht 2026. Für Teams, die nach einem Datenkatalog-Beispiel suchen, lautet die Schlüsselfrage nicht, ob ein Tool Tabellen auflisten kann. Entscheidend ist, ob der Katalog Menschen hilft, Daten mit weniger Reibung zu finden, zu validieren, zu klassifizieren und zu nutzen.
Genau hier gehört Observability im Stil von digna in den Vergleich, denn digna kombiniert katalogartige Discovery mit Anomalieerkennung, Timeliness, Validierung und Schema-Tracking innerhalb der Kundenumgebung. Die folgenden sieben Muster zeigen, wie unterschiedliche Katalogdesigns funktionieren, wo sie passen und mit welchen Kompromissen Teams rechnen sollten.
Inhaltsverzeichnis
1. digna
digna entspricht dem Muster des Privacy-first-Datenkatalog-Beispiels, weil es Metadaten als Teil der betrieblichen Zuverlässigkeit behandelt und nicht nur als Mittel zur Discovery. Die Plattform läuft in Ihrer eigenen Cloud, Ihrer VPC oder Ihrem Rechenzentrum, sodass Produktionsdaten in Ihrer Umgebung bleiben und Prüfungen direkt in der Datenbank laufen. Das reduziert Datenbewegungen und steht im Einklang mit Sicherheitskontrollen. Damit ist digna eine praxistaugliche Option für Teams, die Katalogtransparenz plus vertrauenswürdige Observability-Nachweise in regulierten Umgebungen benötigen.

Zuverlässigkeitskontext zählt mehr als ein statisches Inventar
Die Stärke von digna liegt darin, Anomalieerkennung, Timeliness-Tracking, Validierung auf Datensatzebene und Monitoring von Schemaänderungen in einer Oberfläche zu vereinen. AWS trennt Metadatenmanagement, Katalog und Governance, wobei der Katalog die Discovery unterstützt und die Governance die Nutzungsrichtlinien festlegt AWS-Leitfaden zum Metadatenmanagement. digna ist näher am operativen Geschehen angesiedelt, wo Teams sehen müssen, ob Daten pünktlich angekommen sind, ob sich ein Schema verändert hat oder ob eine Geschäftsregel fehlgeschlagen ist, bevor ein Dashboard oder Modell ausfällt.
Die Plattform passt zu Teams im Finanzwesen, im Gesundheitswesen, in der Telekommunikation und im öffentlichen Sektor, die Nachvollziehbarkeit und Compliance-taugliche Nachweise benötigen. Sie umfasst von Anfang an auch einen Scheduler, einen Katalog, Integrationen und Funktionen für die Zusammenarbeit, sodass Katalogeintrag und Monitoring-Workflow verbunden bleiben, statt in getrennte Tools auseinanderzudriften. Für Teams, die Katalogmodelle vergleichen, ist diese Kombination wichtig, weil sie Governance an tägliche Zuverlässigkeitsprüfungen bindet, statt Qualitätssignale in einem anderen System zu belassen. Der Data-Observability-Ansatz von digna zeigt dieses Muster deutlich.
Praxisregel: Wenn Ihr Team mehr Zeit damit verbringt zu erklären, warum Daten falsch sind, als sie zu finden, sind mit Observability verknüpfte Metadaten einem reinen Inventar in der Regel überlegen.
digna hilft außerdem gemischten technischen Gruppen, mit demselben System zu arbeiten, darunter Engineers, Analysten, Governance-Verantwortliche und Fachanwender. Der Kompromiss liegt in der Verantwortung für das Deployment, da die Organisation die Umgebung selbst betreiben muss. Für Teams, die dieses Modell tragen können, ergibt sich ein Katalogmuster, das auf Vertrauen und operativen Nachweisen aufbaut.
Website: digna.ai
2. Alation Data Catalog
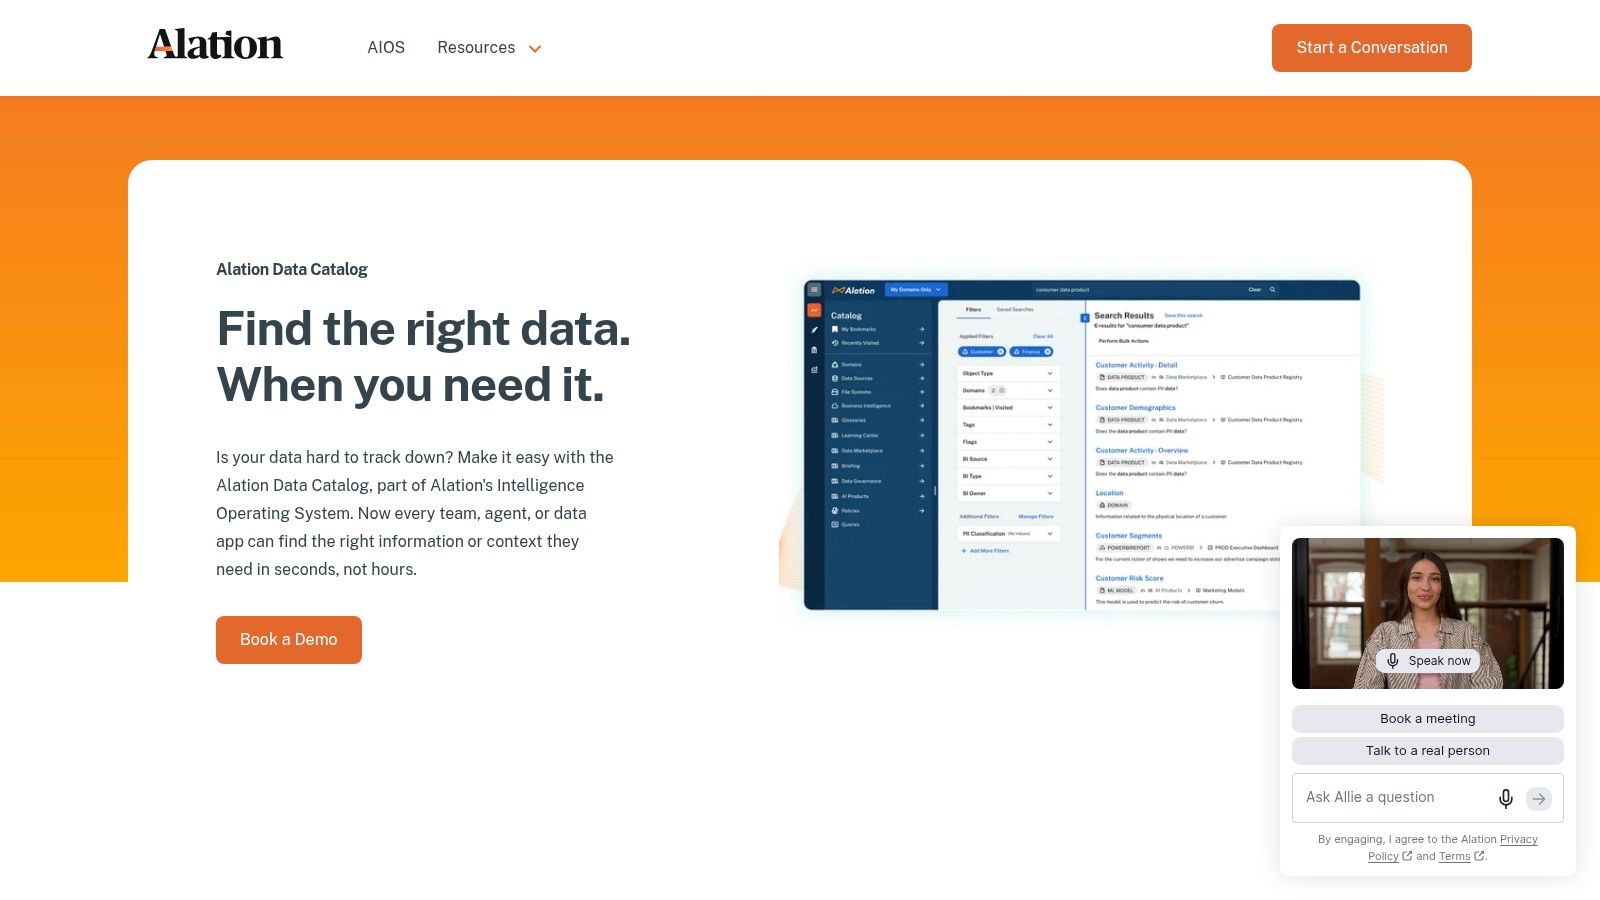
Ein suchgesteuerter Katalog funktioniert nur, wenn Nutzer den Suchergebnissen vertrauen. Alation ist das deutlichste Beispiel für dieses Muster. Es richtet sich an große Unternehmen, die Discovery, Lineage und eine breite Abdeckung an Konnektoren benötigen. Der eigentliche Test ist jedoch, ob Fachanwender mit einer Frage beginnen und trotzdem bei geprüften Inhalten landen können.
Starke Suche hängt von Stewardship-Disziplin ab
Der Mehrwert entsteht durch mehr als nur Indexierung. Glossarbegriffe, Richtlinienkontext, Lineage und Nutzungssignale müssen so gut gepflegt werden, dass Suchergebnisse nicht zu einem Haufen attraktiver, aber nicht vertrauenswürdiger Assets werden. Alations Produktseite hebt Suche in natürlicher Sprache, End-to-End-Lineage, über 120 vorgefertigte Konnektoren und ein offenes Konnektor-Framework hervor. Diese Mischung ist sinnvoll, wenn Stewardship über viele Systeme verteilt ist und die Verantwortung für das Glossar klar geregelt ist.
Diese Bedingung ist entscheidend. Hat eine Organisation viele Quellen, aber keine Zertifizierungsregeln, kann eine nach Beliebtheit gewichtete Suche Inhalte zwar schneller sichtbar machen, ohne jedoch das Vertrauen zu verbessern. In diesem Fall überholt die Discovery die Governance, und Nutzer müssen weiterhin manuell validieren.
Das Muster funktioniert am besten, wenn die Akzeptanz der Engpass ist und Metadaten-Disziplin bereits besteht. Fachanwender erhalten ein vertrautes Sucherlebnis, während Datenteams eine geregelte Struktur über eine fragmentierte Datenlandschaft hinweg beibehalten. Der Kompromiss liegt im operativen Aufwand. Breite Abdeckung bedeutet in der Regel mehr Enablement-Arbeit, besonders wenn Ownership und fachliche Definitionen noch uneinheitlich sind.
Als Datenkatalog-Beispiel zeigt Alation, wie sich geregelte Discovery natürlich anfühlen kann, ohne oberflächlich zu werden. Der Katalog ist am stärksten, wenn Suche, Stewardship und Zertifizierung bereits miteinander verbunden sind. Schwächer ist er, wenn die Organisation erst noch festlegen muss, wem Assets gehören, welche davon vertrauenswürdig sind und wie Begriffe verwendet werden sollen. Weiterführende Lektüre: Wie digna einen Datenkatalog in der Praxis definiert
Website: Alation Data Catalog
3. Collibra Data Catalog
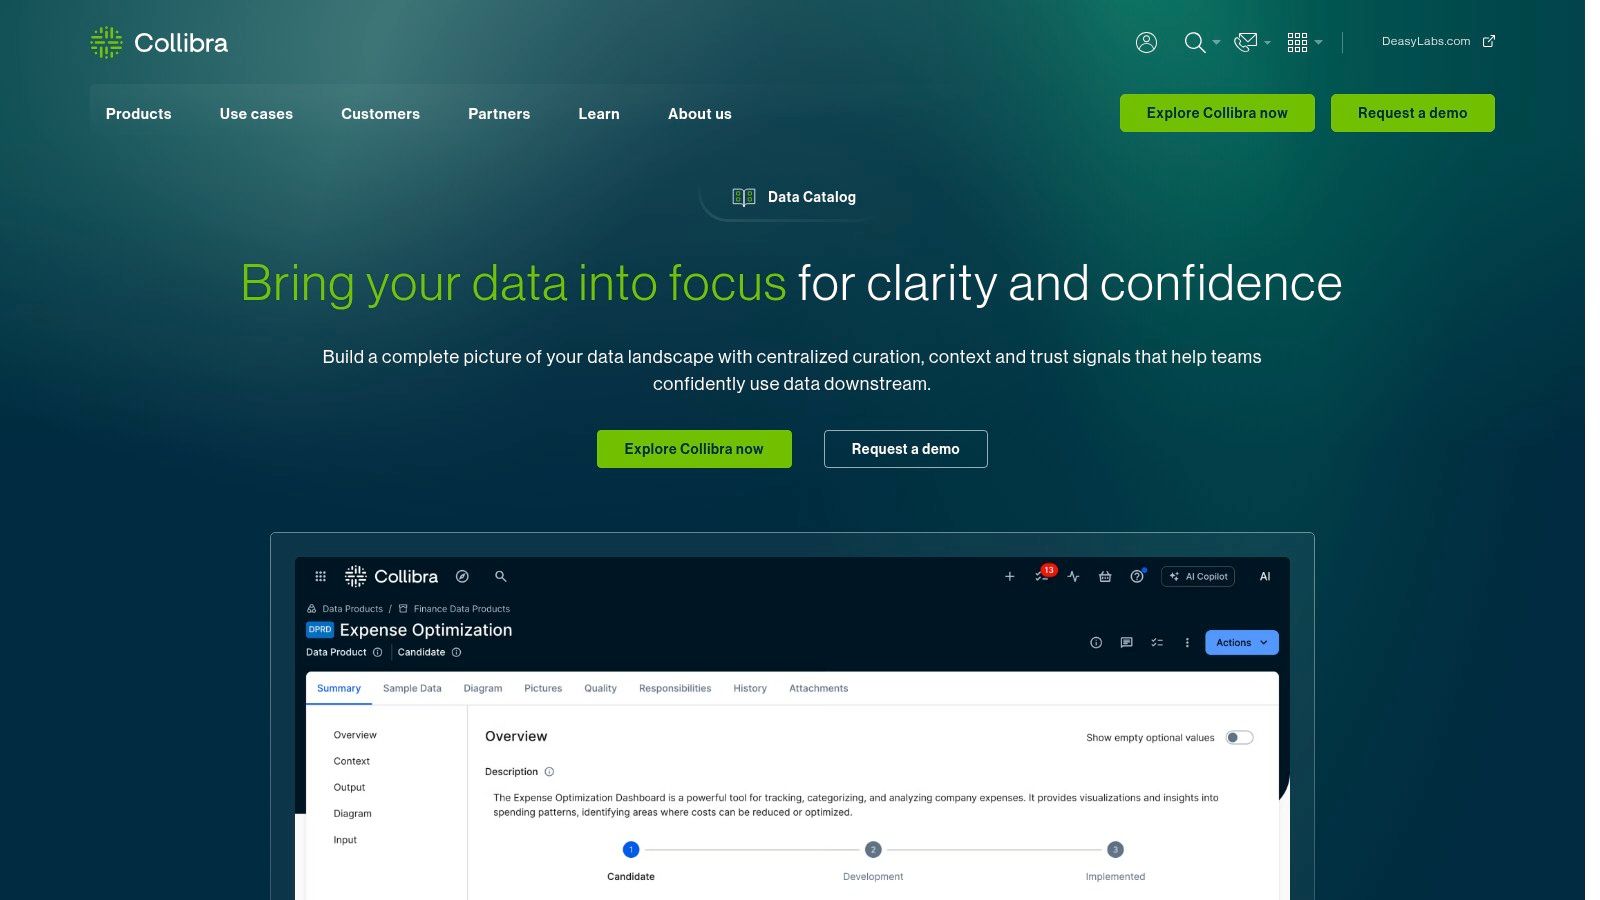
Collibra entspricht dem Muster der Enterprise Governance. Es ist für Organisationen gebaut, bei denen Discovery, Lineage, die Klassifizierung sensibler Daten und richtliniengesteuerte Workflows innerhalb eines umfassenderen Data-Intelligence-Modells zusammenwirken müssen. Das ist wichtig, wenn Recht, Risikomanagement, Compliance und das Data Office denselben Asset-Eintrag prüfen müssen.
Governance-Tiefe zahlt sich in komplexen Betriebsmodellen aus
Der praktische Vorteil ist Kontrolle. Collibras Produktseite verweist auf ein zentrales Inventar, mehr als 100 native Integrationen, automatisierte Kuratierung, Kennzeichnung sensibler Daten, interaktive Lineage und einen Zugriffs-Workflow im Stil eines Marktplatzes. Diese Kombination funktioniert, wenn der Katalog zeigen muss, was ein Asset ist, wer es genehmigt hat, welche Richtlinie gilt und wie der Zugriff geregelt ist.
Das Muster ist praxistauglich, wenn Recht, Risikomanagement und Compliance Assets gemeinsam freigeben müssen und die Kennzeichnung sensibler Daten verpflichtend ist. Es passt auch zu Organisationen mit mehreren Stewardship-Ebenen und formalen Prüfpfaden. Weniger praxistauglich ist es, wenn die Organisation weniger als 3 Stewardship-Ebenen hat und eine schlanke Discovery benötigt. In diesem Umfeld kann der Betriebsaufwand den Nutzen der zusätzlichen Kontrolle übersteigen.
Collibra eignet sich auch für Teams, die Datenprodukte in eine geregelte Wiederverwendung überführen. Zugriff im Marktplatz-Stil und Glossarkontext helfen dabei, vertrauenswürdige Daten bereitzustellen, allerdings nur, wenn Ownership und Prüfverantwortlichkeiten bereits klar sind. Der Kompromiss liegt auf der Hand. Je reichhaltiger das Kontrollmodell, desto mehr Disziplin brauchen Teams bei Rollen, Administration und dem Umgang mit Ausnahmen.
Ein Governance-first-Katalog sollte Richtlinien bereits bei der Discovery sichtbar machen, damit Nutzer die Regel sehen, bevor sie das Asset anfordern.
Wie digna eine Data-Governance-Strategie definiert bietet hier einen nützlichen Bezugspunkt. Collibra setzt diese Strategie über die Katalogebene operativ um. Für Organisationen, die Nachvollziehbarkeit, den Umgang mit sensiblen Daten und geteilte Verantwortung benötigen, liegt darin der Wert dieses Musters.
Website: Collibra Data Catalog
4. Atlan Active Metadata Catalog
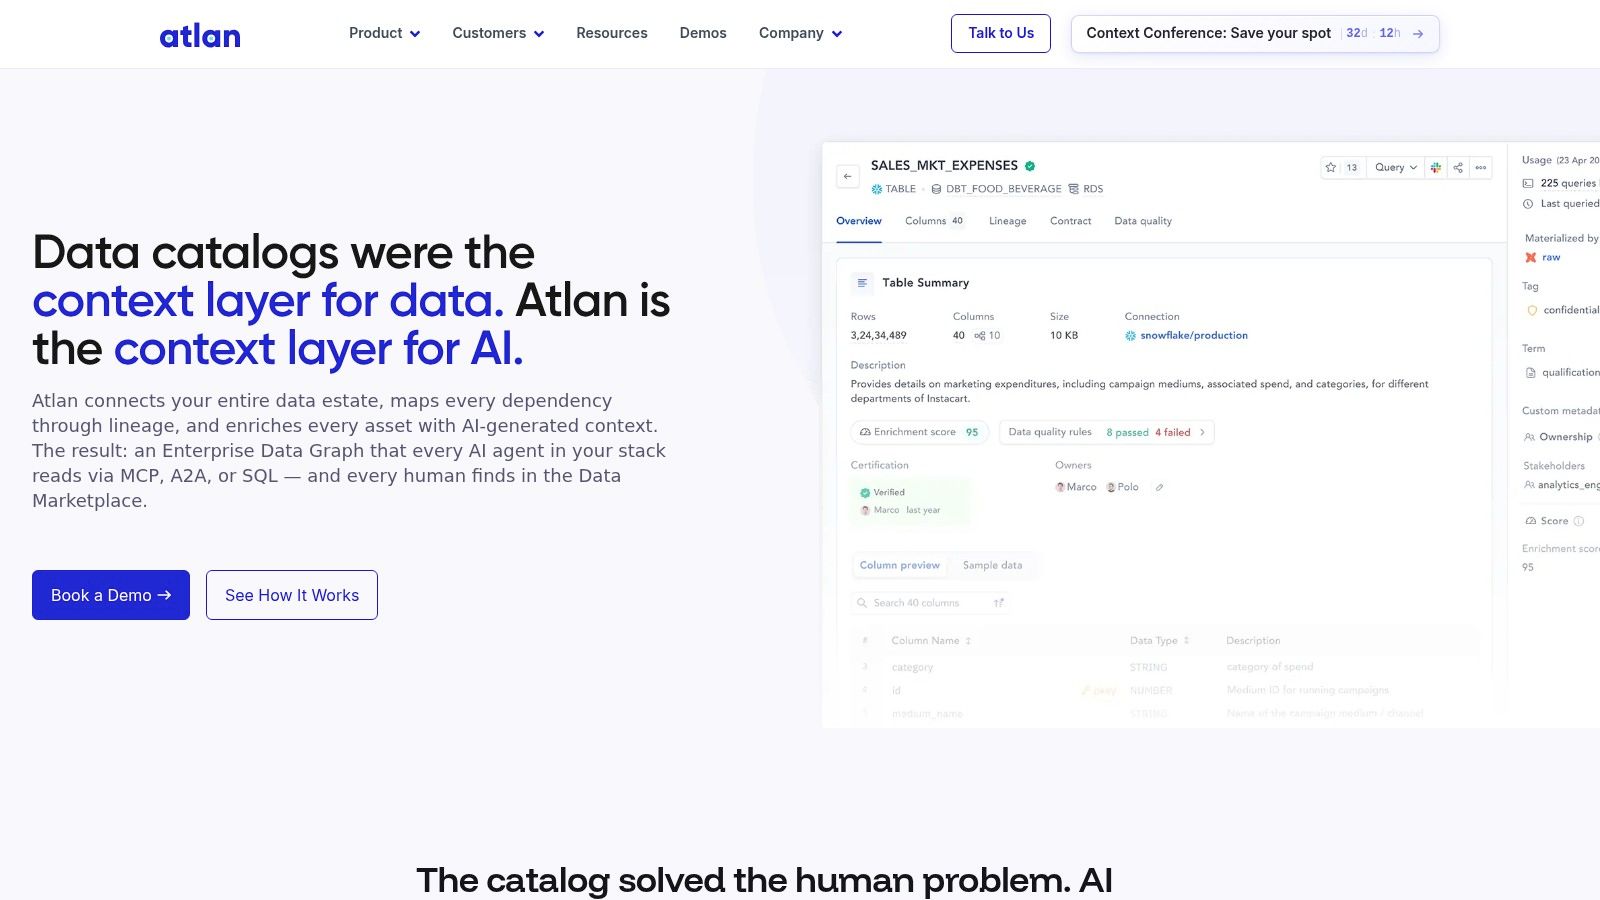
Atlan entspricht dem Muster der Active Metadata. Der Katalog ist für Teams konzipiert, deren Metadaten sich mit den Daten verändern sollen, sodass Aktualität, Lineage, Zertifizierung und Domänenkontext im Workflow sichtbar bleiben. Das macht ihn nützlich für Analytics-Gruppen und Data-Mesh-Programme, in denen sich Ownership schnell verschiebt und manuelle Pflege nicht mehr Schritt hält.
Active Metadata funktioniert, wenn das Betriebsmodell bereits klar definiert ist
Atlans Seite zum Data Discovery Catalog verweist auf Suche in natürlicher Sprache, automatisierte Lineage, Active-Metadata-Automatisierungen und KI-gestützte Dokumentation. Diese Funktionen sind vor allem dann wichtig, wenn der Katalog den aktuellen operativen Kontext widerspiegeln muss und nicht nur eine einmalige Dokumentation. Wenn sich Ownership, Aktualität und Zertifizierung häufig ändern, veraltet ein statischer Katalog schnell.
Das Muster funktioniert, wenn Domänengrenzen definiert sind, Ownership-Verträge im Code existieren und Metadaten-Pipelines ereignisgesteuert sind. In diesem Umfeld kann der Katalog den Kontext aktualisieren, sobald Änderungen eintreten, und Stewardship verteilt halten. Fehlen diese Voraussetzungen, kann Automatisierung Verwirrung ebenso leicht skalieren wie Dokumentation.
Wann es funktioniert: Domänenteams verantworten bereits Datenprodukte, Metadaten-Ereignisse sind zuverlässig, und der Katalog kann Updates ohne manuelles Eingreifen veröffentlichen. Wann es scheitert: Grenzen sind vage, Ownership wird in Tabellenkalkulationen gepflegt, und veraltete Signale überschreiben den lokalen Kontext.
Eine Analystennotiz von digna zur Data Discovery passt hier. Discovery wird erst dann nutzbar, wenn der Katalog widerspiegelt, wie Teams bereits arbeiten. Atlan ist dort am stärksten, wo die Geschwindigkeit der Zusammenarbeit zählt und die Organisation eine moderne Oberfläche wünscht, die zur Beteiligung anregt. Der Kompromiss ist jedoch klar: Es setzt ein diszipliniertes Domänendesign voraus, bevor Automatisierung helfen kann.
Website: Atlan Data Discovery Catalog
5. Microsoft Purview Unified Catalog
Microsoft Purview entspricht dem Muster des Cloud-nativen Stewardships, allerdings nur unter den richtigen Betriebsbedingungen. Am praxistauglichsten ist es, wenn eine stark Microsoft-geprägte Datenlandschaft bereits Azure, Fabric und OneLake umfasst und das Team Governance schrittweise ausbauen muss, statt eine vollständige Plattformmigration durchzuführen. In diesem Setup folgt der Katalog der Plattform, die die Organisation bereits betreibt.
Nutzungsbasierte Governance passt zu schrittweisen Rollouts
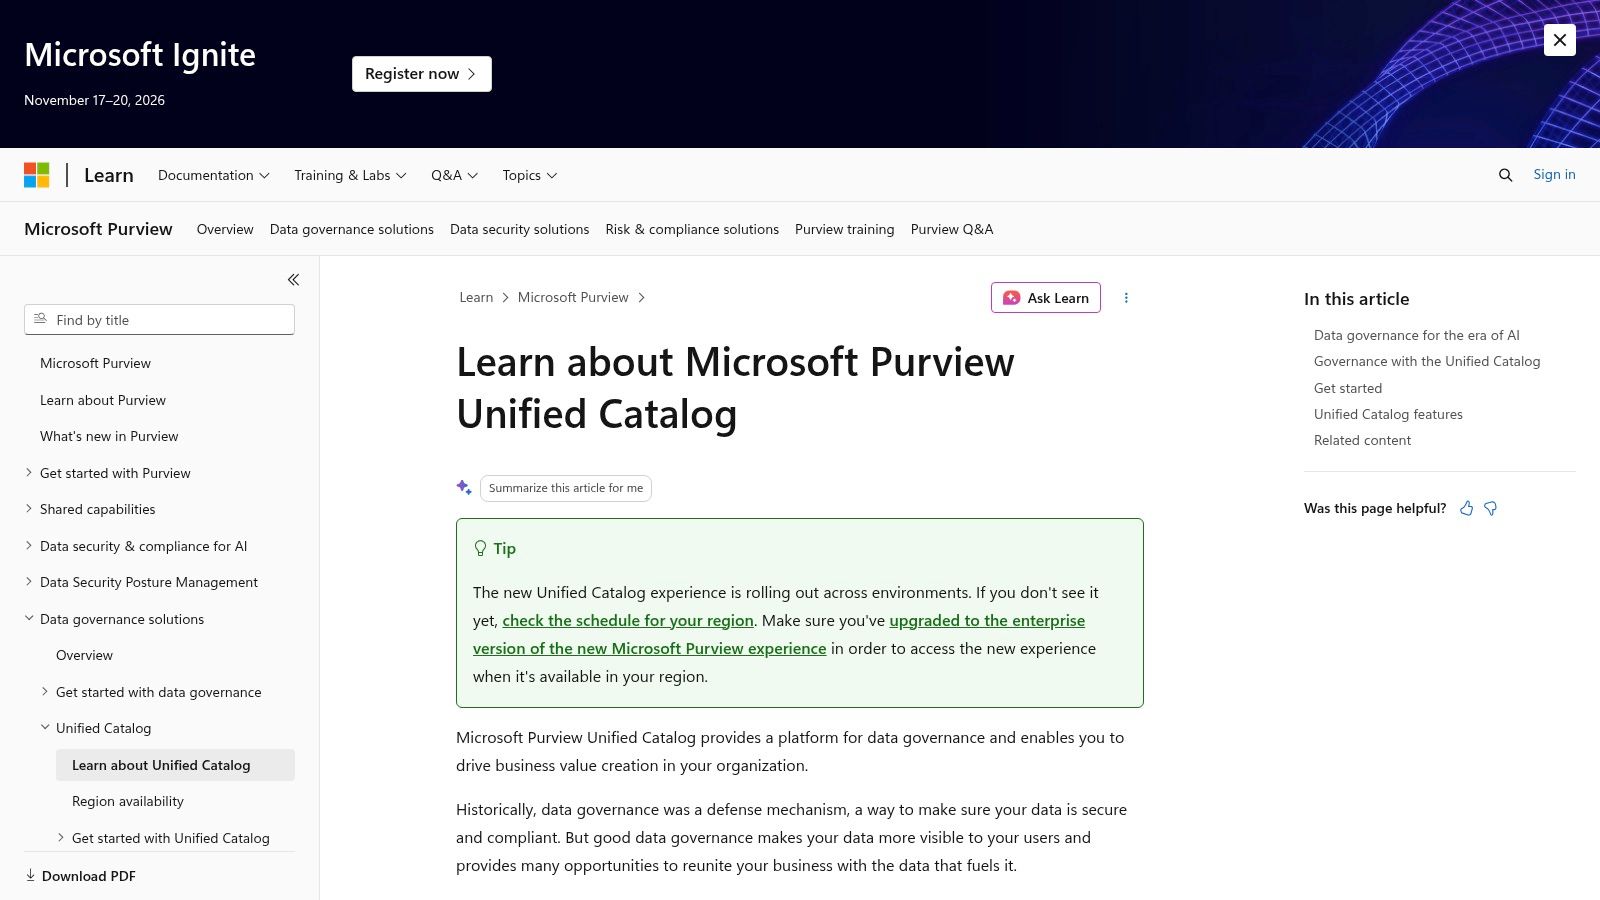
Purviews Dokumentation zum Unified Catalog zeigt ein Modell, das auf Multicloud-Scanning, zentralen Data Maps, Lineage, Klassifizierungen und DGPU-basierter Governance-Verarbeitung aufbaut. Der praktische Nutzen liegt nicht in allgemeiner Katalogtheorie, sondern in der Möglichkeit, mit einem begrenzten Umfang zu starten, Konnektoren zu validieren und Governance dort auszuweiten, wo die Nutzung die Kosten rechtfertigt.
Wählen Sie dieses Muster, wenn Sie nutzungsbasiert abgerechnete Governance und Fabric-Integration ohne Plattformmigration benötigen. Planen Sie 2 bis 3 Sprints für die Validierung von Konnektoren zu Nicht-Microsoft-Quellen ein, denn die Abdeckung variiert je nach Konnektor und beeinflusst die Akzeptanz. Das Modell ist praxistauglich, wenn etwa 70 % oder mehr der Assets in Azure, Fabric oder OneLake liegen, und weniger praxistauglich, wenn die Datenlandschaft Multi-Cloud ist und Microsoft nur eine geringe Rolle spielt.
Damit ist der Kompromiss klar. Microsoft-zentrierte Teams profitieren von einer besseren Passung, geringerer Integrationsreibung und einer Governance-Ebene, die nah am bereits genutzten Security-Stack liegt. Teams mit gemischten Quellen können Purview ebenfalls nutzen, doch Unterschiede zwischen den Konnektoren können dazu führen, dass wichtige Assets außerhalb der zuverlässigsten Abdeckung des Katalogs bleiben.
Als Datenkatalog-Beispiel in einer stark Microsoft-geprägten Datenlandschaft ist dies eher ein wiederverwendbares Muster als ein generischer Katalog. Es funktioniert am besten, wenn die Governance-Reife schrittweise wachsen kann und die Organisation möchte, dass der Katalog ihrem Microsoft-Betriebsmodell folgt.
Website: Microsoft-Purview-Dokumentation
Weiterführende Lektüre: digna zum Metadatenmanagement
6. DataHub Open Source und DataHub Cloud
DataHub steht für das Muster der technisch geprägten Flexibilität. Es passt zu Teams, die Lineage, Suche, Governance-Workflows und Observability-Signale wünschen, ohne sich an einen geschlossenen Katalog-Stack zu binden. Die Open-Source-Edition gibt technischen Teams die Kontrolle. DataHub Cloud behält dasselbe Modell bei, nimmt aber einen Großteil des Infrastrukturaufwands ab.
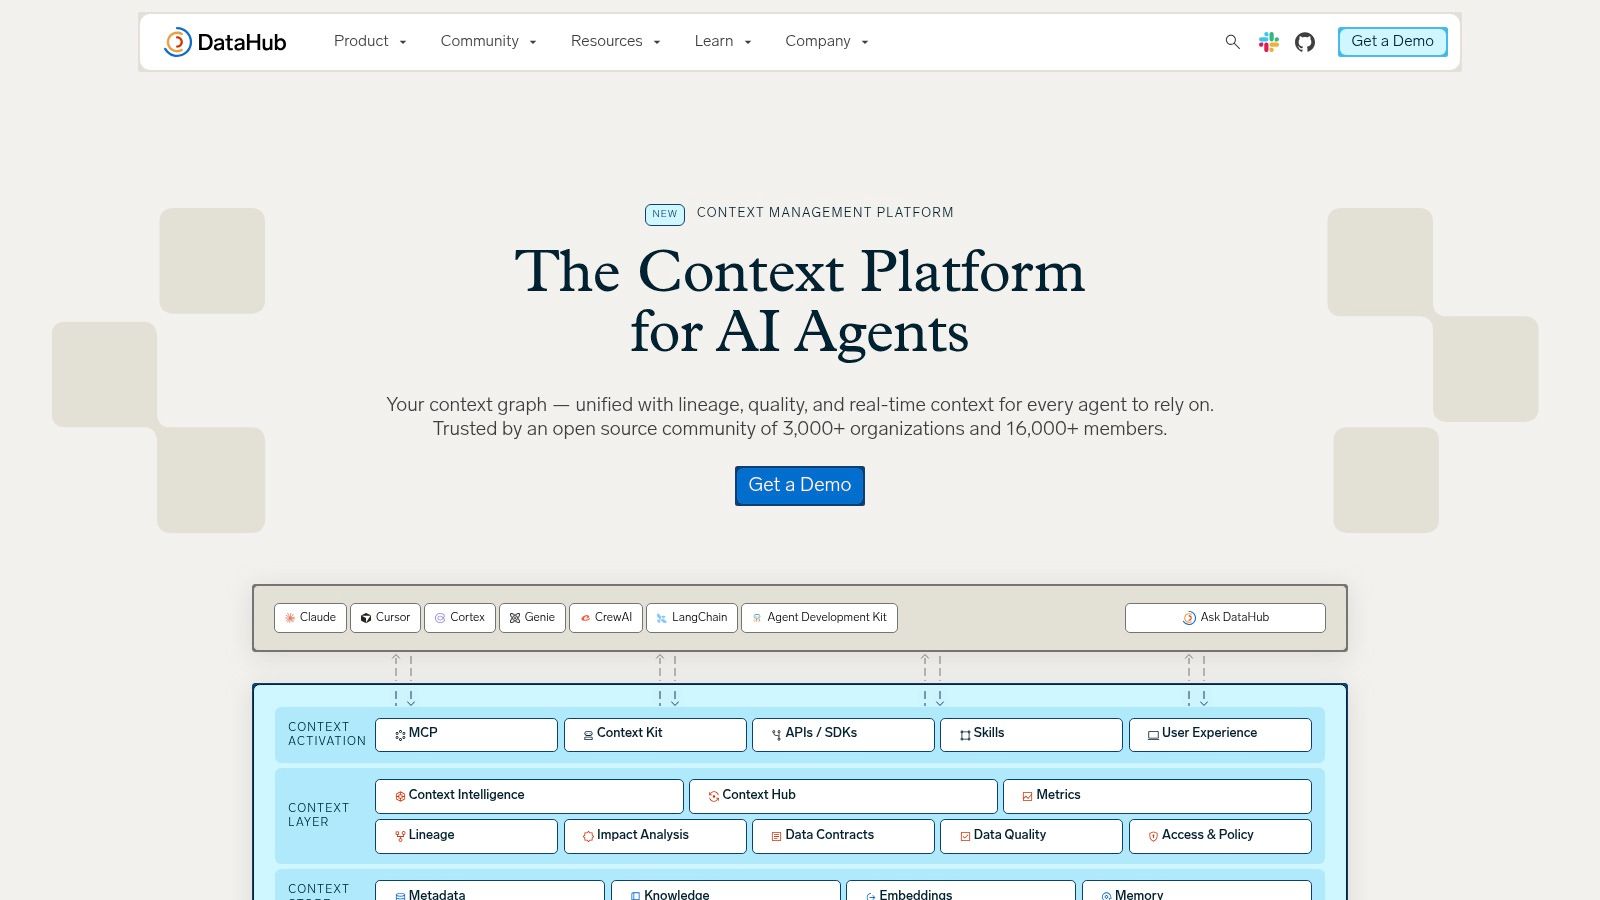
Technische Kontrolle versus Betriebsaufwand: Was das Open-Source-Modell wirklich kostet
Die Stärke von DataHub liegt nicht in allgemeiner Katalogbreite. Sie liegt in der Fähigkeit, Metadaten als Teil der Plattform zu gestalten, statt sie nur über ein Frontend-Tool zu konsumieren. Das macht das Muster praxistauglich für Teams, die bereits interne Plattformen, eigene Konnektoren und Metadaten-Pipelines betreiben, die sie bei Änderungen am Stack pflegen können.
DataHub Cloud senkt die operative Last, doch der Kompromiss verschwindet nicht. Open-Source-Kontrolle erfordert weiterhin Upgrade-Management, Konnektorpflege und jemanden, der die Ingestion stabil hält, wenn sich vorgelagerte Systeme ändern. Es passt, wenn ein Plattformteam diese Arbeit übernehmen kann, und lässt sich schwerer rechtfertigen, wenn der Organisation dedizierte SRE- oder Katalogbetriebskapazitäten fehlen.
Eignungssignal | Praxistauglich, wenn | Weniger praxistauglich, wenn |
|---|---|---|
Betriebsmodell | das Engineering die Metadaten-Workflows verantwortet | der Katalog mit wenig praktischer Betreuung laufen soll |
Deployment-Wahl | eigene Erweiterungen und Self-Hosting wichtig sind | das Team möglichst wenig Verantwortung für Infrastruktur tragen will |
Zuverlässigkeitsfokus | Ingestion-Pipelines überwacht und gepflegt werden | Upgrades und Konnektoren dem Zufall überlassen werden |
Für Käufer, die Datenkatalog-Beispiele über verschiedene Deployment-Varianten hinweg vergleichen, ist DataHub das deutlichste Beispiel für selbst gehostete Kontrolle neben einer verwalteten Option. Es funktioniert am besten, wenn Metadaten-Infrastruktur wie Software behandelt wird – mit Ownership, Release-Disziplin und klarer operativer Verantwortung.
Website: DataHub
7. Informatica Cloud Data Governance and Catalog
Für hybride Datenlandschaften, in denen die Breite der Scanner darüber entscheidet, ob der Katalog vollständig ist, priorisiert Informatica Abdeckung vor einem schlankeren Discovery-Erlebnis. Es eignet sich für Organisationen, die bereits auf Informatica-Tools setzen und deren Katalogisierung mit Integrations-, Qualitäts- und Governance-Arbeit verbunden sein muss.
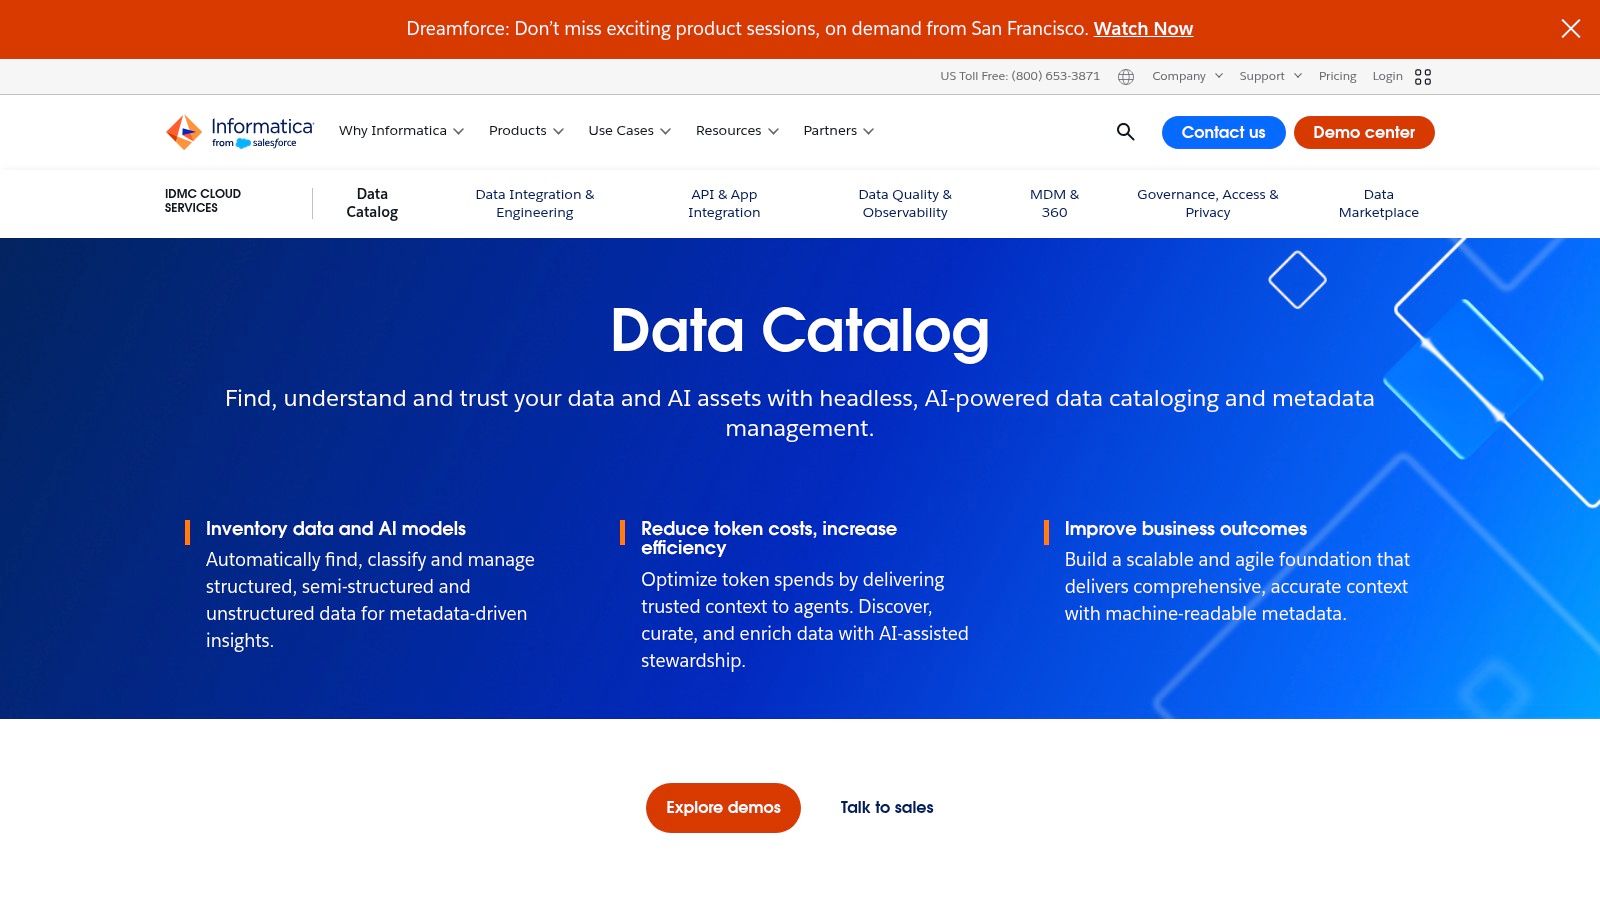
Breite zählt, wenn die Datenlandschaft unübersichtlich ist
Die Produktseite des Katalogs hebt automatisiertes Scanning, Profiling, Lineage, Glossar, Richtlinienmanagement sowie angrenzende Services für Datenqualität und Integration hervor. Dieses Profil ist wichtig, wenn sowohl Cloud- als auch On-Premises-Systeme abgedeckt werden müssen und Governance-Artefakte mit technischen Metadaten abgestimmt bleiben müssen. Der Wert liegt in einer vollständigen Metadatenabdeckung statt in schlanker Discovery.
Dieses Muster passt zu Unternehmen, die eine breite Scanner-Unterstützung und eine engere Kopplung an einen bestehenden Data-Management-Stack benötigen. Der Kompromiss ist das operative Gewicht. Umfang, Administration und Enablement können erheblich werden, besonders wenn technische Teams und Governance-Nutzer vom selben Katalog abhängen. Die Akzeptanz ist in der Regel höher, wenn die Katalogarbeit in ein umfassenderes Betriebsmodell eingebettet ist und nicht als eigenständiges Suchtool dient.
Wählen Sie Informatica, wenn die Datenlandschaft eine breite Scanner-Abdeckung und IDMC-gebundene Qualitäts- oder Integrationsservices erfordert. Wählen Sie Collibra, wenn Governance im Marktplatz-Stil und Workflows für Fachanwender wichtiger sind als Scan-Tiefe. Für Leser, die ein Datenkatalog-Beispiel mit maximaler Plattformbreite vergleichen, ist Informatica die naheliegendste Wahl für Organisationen, deren Katalogisierung als Teil eines größeren Data-Management-Programms funktionieren soll.
Website: Informatica Cloud Data Governance and Catalog
Die 7 wichtigsten Datenkataloge im Vergleich
Produkt | Implementierungskomplexität (🔄) | Ressourcen & Betrieb (⚡) | Erwartete Ergebnisse (⭐📊) | Ideale Anwendungsfälle | Wichtigste Vorteile (💡) |
|---|---|---|---|---|---|
digna | Mittel (🔄🔄), Installation in der eigenen Umgebung und Modul-Setup | Mittel bis hoch ⚡, Kunde betreibt die Infrastruktur; Berechnung in der Datenbank reduziert Datenbewegungen | Hoch ⭐⭐⭐⭐, Observability auf Enterprise-Niveau, schnelle Time-to-Value (Erkenntnisse in <2 Std.) | Regulierte Unternehmen, die Privacy-first-Prüfungen direkt vor Ort benötigen | Ausführung in der eigenen Umgebung, Prüfungen in der Datenbank, modulare Lizenzierung, KI-Anomalieerkennung + deterministische Validierung |
Alation Data Catalog | Mittel bis hoch (🔄🔄🔄), Aufwand für Governance und Akzeptanz | Mittel ⚡, Konnektoren + Enablement für breite Datenlandschaften | Hoch ⭐⭐⭐⭐, starke Discovery, Suche und Governance-Akzeptanz | Große Unternehmen, die geregelte Data Discovery und Suche anstreben | Suche in natürlicher Sprache, Lineage, über 120 Konnektoren, Governance-Workflows |
Collibra Data Catalog | Hoch (🔄🔄🔄), Rollen- und Modell-Setup auf Organisationsebene erforderlich | Hoch ⚡, erheblicher Aufwand für Enablement und Betriebsmodell | Hoch ⭐⭐⭐⭐, umfassende Governance, Kontrollen für sensible Daten | Komplexe Organisationen mit Compliance- und Datenprodukt-Anforderungen | Zentrale Governance, Kennzeichnung sensibler Daten, AI Copilot, Marktplatz/Workflows |
Atlan, Active Metadata Catalog | Mittel (🔄🔄), schnellere UX, erfordert aber Domänendesign | Mittel ⚡, moderne UX senkt die Hürden; etwas Setup für Domänen | Gut ⭐⭐⭐, schnellere Akzeptanz und kollaboratives Metadatenmanagement | Data-Mesh-/Domänenteams, auf Zusammenarbeit ausgerichtete Analytics-Teams | Active-Metadata-Automatisierungen, KI-gestützte Dokumentation, Domänen-/Produkt-Workflows |
Microsoft Purview, Unified Catalog | Niedrig bis mittel (🔄🔄), Cloud-nativ, schrittweiser Rollout | Mittel ⚡, nutzungsbasierte Abrechnung (DGPU); unterschiedliche Konnektorabdeckung | Gut ⭐⭐⭐, einheitlicher Katalog für Microsoft-Ökosysteme | Auf Microsoft/Azure/Fabric ausgerichtete Organisationen | Multicloud-Scanning, Fabric-/OneLake-Integration, transparente nutzungsbasierte Preise |
DataHub (Open Source) / DataHub Cloud | Mittel (🔄🔄), OSS erfordert Engineering; Cloud erleichtert den Betrieb | Variabel ⚡, Self-Hosting hoch; DataHub Cloud senkt die operative Last | Gut ⭐⭐⭐, entwicklerfreundliche Metadaten, starke Lineage/Suche | Teams, die OSS-Flexibilität oder einen verwalteten SaaS-Weg wünschen | Open-Source-Community, flexibles Deployment, transparente Einstiegspreise (Cloud) |
Informatica, Cloud Data Governance & Catalog (IDMC) | Hoch (🔄🔄🔄), Deployment und Governance im Enterprise-Maßstab | Hoch ⚡, breite Scanner-Abdeckung und laufende Administration | Hoch ⭐⭐⭐⭐, tiefes Scanning, Profiling und Enterprise-Integrationen | Sehr große, hybride Datenlandschaften mit umfassendem Bedarf an Quellenabdeckung | Scanner-Breite auf Enterprise-Niveau, detaillierte Lineage, Integration in das IDMC-Ökosystem |
Wählen Sie das Muster, das Ihr Betriebsmodell tragen kann
Der richtige Katalog hängt weniger von der Anzahl der Funktionen ab als davon, ob Ihr Betriebsmodell das Verhalten tragen kann, das das Tool voraussetzt. Wenn Sie Enterprise Governance und Compliance-Nachweise benötigen, sind Collibra oder Informatica sinnvoll. Hängt die Akzeptanz von einer schnellen, intuitiven Suche ab, passt Alation besser. Arbeiten Ihre Teams in Domänen und Produkten, bietet Atlan Active Metadata ein praktisches Zuhause. Ist Ihre Datenlandschaft Microsoft-zentriert, fügt sich Purview natürlich ein. Wenn das Engineering Kontrolle und Flexibilität wünscht, ist DataHub der offene Weg. Wenn Zuverlässigkeit, Datenschutz und Ausführung in der eigenen Umgebung am wichtigsten sind, ist digna das operativ fundierteste Muster.
Für einen sinnvollen Vergleich empfiehlt es sich, sechs Fragen zu stellen. Können Menschen das Asset schnell finden? Können sie eine Lineage sehen, der sie vertrauen? Kann das Glossar oder die Taxonomie Begriffe konsistent halten? Können Observability- oder Aktualitätssignale sie warnen, bevor sie veraltete Daten verwenden? Passt das Deployment-Modell zu Ihrer Sicherheitsstrategie? Und kann Ihr Team den Betriebsaufwand tragen, der mit dem gewählten Design einhergeht?
Discovery: Alation und Atlan führen bei der suchgesteuerten Discovery, während Collibra, Purview, DataHub, Informatica und digna Discovery mit unterschiedlichen Ebenen von Governance oder Zuverlässigkeit verbinden.
Lineage: Collibra, Purview, DataHub, Informatica und Alation legen den Schwerpunkt auf Transparenz der Lineage, während digna Zuverlässigkeitsprüfungen an Schema- und Timeliness-Signale knüpft.
Unterstützung für Taxonomie oder Glossar: Collibra, Alation, DataHub und Informatica bieten den stärksten Glossar- und Richtlinienkontext, während Atlan und Purview stärker auf operativen Kontext setzen.
Observability-Kontext: digna passt hier am deutlichsten, während DataHub und Collibra unterstützende Signale in die Katalogebene einbringen.
Deployment-Modell: Purview und Cloud-Anbieter bevorzugen verwaltete oder Cloud-native Wege, DataHub bietet Self-Hosting oder Cloud, und digna läuft innerhalb der Kundeninfrastruktur.
Betriebsaufwand: Open-Source-Flexibilität und Governance-Tiefe auf Enterprise-Niveau erfordern beide Verantwortung. Der Unterschied liegt darin, wo der Aufwand anfällt: im Engineering, in der Administration oder in beidem.
Die praktische Reihenfolge ist einfach. Definieren Sie zuerst den Metadateneintrag, legen Sie als Zweites Regeln für Ownership und Taxonomie fest, pilotieren Sie als Drittes einen besonders wertvollen Datensatz, ergänzen Sie danach Vertrauenssignale wie Lineage, Aktualität oder Validierung und messen Sie anschließend, ob Nutzer das Asset finden und sicher verwenden können. Ein Katalog gewinnt Akzeptanz, wenn er Menschen hilft, schneller Entscheidungen zu treffen – mit weniger Diskussionen darüber, was die Daten bedeuten.
digna bietet Teams eine andere Art von Katalogerlebnis, bei dem Discovery und Observability in derselben Umgebung verbunden bleiben. Wenn Sie eine Plattform benötigen, die Metadaten mit Anomalien, Timeliness, Validierung und Schemaänderungen verknüpft, ohne Produktionsdaten aus Ihrer Kontrolle zu geben, besuchen Sie digna und prüfen Sie, ob dieses Betriebsmodell besser zu Ihrem Datenkatalog-Beispiel passt, als es ein statisches Inventar je könnte.
Wenn der Katalogeintrag Aktualitäts-, Schemaänderungs- und Validierungssignale statt eines statischen Inventars enthalten soll, sehen Sie sich an, wie digna Data Platform Observability in Ihrer eigenen Umgebung umsetzt.
Häufig gestellte Fragen
Was ist ein gutes Beispiel für einen Datenkatalog?
Es gibt nicht das eine beste Beispiel; der Artikel vergleicht sieben Muster. Alation steht für suchgesteuerte Discovery, Collibra für Enterprise Governance, Atlan für Active Metadata, Microsoft Purview für Cloud-natives Stewardship, DataHub für Open-Source-Flexibilität, Informatica für Scanner-Breite und digna für ein Privacy-first-Muster, das Katalogeinträge mit Observability-Prüfungen in Ihrer eigenen Umgebung verknüpft.
Ist Microsoft Purview ein guter Datenkatalog für eine gemischte Cloud-Landschaft?
Purview funktioniert am besten, wenn etwa 70 % oder mehr der Assets in Azure, Fabric oder OneLake liegen. Für Nicht-Microsoft-Quellen empfiehlt der Artikel, 2 bis 3 Sprints für die Validierung der Konnektoren einzuplanen, da die Abdeckung je nach Konnektor variiert und wichtige Assets außerhalb der zuverlässigsten Abdeckung des Katalogs liegen können.
Was ist der Unterschied zwischen den Datenkatalogen von Collibra und Informatica?
Wählen Sie Informatica, wenn die Datenlandschaft eine breite Scanner-Abdeckung und Anbindung an IDMC-Services für Qualität oder Integration benötigt. Collibra passt besser, wenn Governance im Marktplatz-Stil, die Kennzeichnung sensibler Daten und Workflows für Fachanwender wichtiger sind als Scan-Tiefe, ist jedoch für Organisationen mit weniger als 3 Stewardship-Ebenen weniger praxistauglich.
Wann funktioniert ein Active-Metadata-Katalog wie Atlan?
Active Metadata funktioniert, wenn Domänengrenzen definiert sind, Ownership-Verträge im Code existieren und Metadaten-Pipelines ereignisgesteuert sind. Es scheitert, wenn Grenzen vage sind und Ownership in Tabellenkalkulationen gepflegt wird, weil Automatisierung dann Verwirrung ebenso leicht skaliert wie Dokumentation. Atlans Suche in natürlicher Sprache und automatisierte Lineage helfen erst, wenn diese Grundlagen geschaffen sind.
Wie sollte ich einen Datenkatalog einführen?
Folgen Sie einer Abfolge von fünf Schritten: Definieren Sie zuerst den Metadateneintrag, legen Sie als Zweites Regeln für Ownership und Taxonomie fest und pilotieren Sie als Drittes einen besonders wertvollen Datensatz. Ergänzen Sie dann Vertrauenssignale wie Lineage, Aktualität oder Validierung und messen Sie schließlich, ob Nutzer das Asset finden und sicher verwenden können, bevor Sie den Katalog weiter ausbauen.



