Data Observability-Architektur einfach erklärt
|
8
min. Lesezeit

Ein Dashboard kann grün sein, während die dahinter stehende Entscheidung bereits falsch ist. Die Pipeline wurde abgeschlossen, das Data Warehouse ist verfügbar und jeder geplante Job meldet Erfolg. Dennoch hat ein Quellsystem verspätete Daten geliefert, ein Upstream-Team hat einen Spaltentyp geändert oder ein Teilladevorgang hat Datensätze entfernt. Das Finanzteam sieht den Umsatz von gestern, ein Betriebsteam übersieht ein sich entwickelndes Problem und ein KI-Feature nutzt Eingabedaten, die nicht mehr den beim Training getroffenen Annahmen entsprechen.
Teams beginnen oft damit, mehr Warnmeldungen hinzuzufügen. Dieser Ansatz hilft so lange, bis ein Alarm ohne klare Zuständigkeit, Kontext oder eine klare Sicht auf die nachgelagerten Auswirkungen ausgelöst wird. Das tiefere Problem ist architektonischer Natur: Wo läuft die Observability-Berechnung, wo liegen die Metadaten und wie verbindet das System ein technisches Signal mit den betroffenen Personen und Geschäftsprozessen?
Die Data Observability-Architektur liefert Antworten auf diese Fragen. Sie erweitert das traditionelle Infrastruktur-Monitoring um kontinuierliche Transparenz über Datenpipelines, Warehouses, Lakes, Dashboards und Machine-Learning-Eingaben hinweg. Diese kommerzielle Kategorie ist rasant gewachsen. Eine Branchenschätzung für 2026 beziffert den Markt für Data Observability auf 3,51 Milliarden USD und prognostiziert 6,03 Milliarden USD bis 2031, mit einer durchschnittlichen jährlichen Wachstumsrate (CAGR) von 11,42 % im Zeitraum von 2026 bis 2031 (Marktschätzung von Mordor Intelligence). Ein anderer Bericht aus dem Jahr 2026 bewertet den Markt mit 3,4 Milliarden USD im Jahr 2026, gegenüber 2,94 Milliarden USD im Jahr 2025 (Marktbericht von Spherical Insights).
Die praktische Lehre daraus ist einfach. Eine zuverlässige Architektur sollte Ihnen nicht nur mitteilen, dass sich eine Tabelle geändert hat. Sie sollte zeigen, was sich geändert hat, ob die Änderung erwartet wird, welche nachgelagerten Assets davon abhängen und ob das Signal Auswirkungen auf das Berichtswesen, den Betrieb, die governance oder die KI hat. Teams, die einen strukturierten Ansatz für Zuverlässigkeit suchen, können diesen Leitfaden auch nutzen, um die Datenzuverlässigkeit zu messen.
Inhaltsverzeichnis
Einführung: Warum eine Data Observability-Architektur jetzt wichtig ist
Wo Observability ausgeführt werden sollte und wie man sie bereitstellt
Von technischen Signalen zu geschäftlichen Auswirkungen mit realen Beispielen
Ihr Fahrplan zur Implementierung einer Data Observability-Architektur
Einführung: Warum eine Data Observability-Architektur jetzt wichtig ist
Ein typischer Vorfall beginnt unauffällig. Ein Ingestion-Job empfängt weniger Datensätze als üblich, wird aber erfolgreich beendet. Eine Transformation läuft weiter, da das Schema technisch valide ist. Das Dashboard aktualisiert sich planmäßig, sodass seine Statusanzeige grün bleibt. Niemand bemerkt etwas, bis eine Führungskraft fragt, warum sich eine Geschäftskennzahl unerwartet verändert hat.
Herkömmliches Monitoring eignet sich gut zur Beantwortung operativer Fragen, beispielsweise ob ein Server verfügbar ist, ein Job abgeschlossen wurde oder ein Prozess einen Fehler zurückgegeben hat. Datensysteme benötigen mehr Kontext. Daten verändern Form, Volumen, Verteilung, Timing und Bedeutung, während sie Ingestion, Transformation, Speicherung und Konsum durchlaufen. Eine Pipeline kann betrieblich einwandfrei funktionieren, während sie Daten produziert, die unvollständig, veraltet oder strukturell inkompatibel mit der nachgelagerten Nutzung sind.
Der blinde Fleck ist meist architektonischer Natur
Die moderne Data Observability-Architektur entstand, weil grundlegende Infrastrukturmetriken und das Application Performance Monitoring diese Fehler nicht erklären konnten. Da Pipelines immer verteilter wurden, fügten Teams Prüfungen für Datenqualität, Lineage, Anomalien und Echtzeitverhalten hinzu. Diese Disziplin fungiert heute als Architekturebene für Zuverlässigkeit und governance, nicht bloß als Dashboard zur Reaktion auf Vorfälle.
Diese Unterscheidung ist für verschiedene Gruppen von Bedeutung:
Data Engineers müssen die Ursache eines Fehlers finden, ohne in isolierten Tools suchen zu müssen.
Analytics Engineers und BI-Entwickler benötigen Gewissheit, dass Transformationen und Dashboards aktuelle, strukturell valide Eingaben widerspiegeln.
Governance-Verantwortliche benötigen den Nachweis, dass Kontrollen kontinuierlich über Warehouses, Lakes und Pipelines hinweg angewendet werden.
KI-Teams benötigen Rückverfolgbarkeit von den Quelldatensätzen über Features und Trainingsdaten bis hin zu den Modelleingaben.
Die Architektur entscheidet darüber, ob diese Gruppen einen gemeinsamen Kontext teilen oder diesen im Falle eines Vorfalls manuell zusammensetzen müssen. Eine zentrale Metadatenebene kann Zuständigkeit, Lineage, historisches Verhalten und Nutzung miteinander verknüpfen. Eine verteilte Ausführung kann Prüfungen nahe an den Systemen halten, welche die Daten hosten. Das Alerting kann dann ein aussagekräftiges Ereignis weiterleiten, anstatt eine isolierte Metrik an einen generischen Betriebskanal zu senden.
Was eine gute Architektur ermöglicht
Ein gut konzipiertes System erkennt sowohl bekannte als auch unerwartete Fehlermodi. Deterministische Prüfungen können explizite Regeln durchsetzen, während statistische Methoden ungewöhnliches Verhalten identifizieren können, ohne dass jemand jedes mögliche Problem vorhersagen muss. Das Ergebnis sind nicht per Definition perfekte Daten. Es ist ein Feedback-System, das Teams frühzeitigere Hinweise, eine bessere Diagnose und eine klarere Grundlage für die Priorisierung von Behebungsmaßnahmen bietet.
Die Architektur beeinflusst auch Governance, Portabilität und Kostenkontrolle. Das Verschieben von Daten in einen externen Dienst kann zwar einige Analysen vereinfachen, aber zusätzliche Bedenken hinsichtlich Zugriff, Datenbewegung und Infrastruktur aufwerfen. Das Ausführen von Prüfungen innerhalb einer bestehenden Warehouse- oder Lake-Umgebung kann die Datenlokalität bewahren, erfordert jedoch eine sorgfältige Planung in Bezug auf Berechtigungen, Workloads und unterstützte Engines. Diese Abwägungen verdienen ebenso viel Aufmerksamkeit wie die Liste der überwachten Metriken.
Was Data Observability-Architektur wirklich bedeutet
Ein nützlicher Vergleich ist das Armaturenbrett eines Autos. Traditionelles Monitoring sagt Ihnen vielleicht, ob der Motor läuft und ob das Fahrzeug Strom hat. Observability bietet Ihnen eine reichhaltigere Sicht: Geschwindigkeit, Kraftstoffstand, Temperatur, Warnanzeigen und genügend Kontext, um zu verstehen, warum sich das Auto nicht wie erwartet verhält.

Wenden wir diesen Vergleich auf eine Datenplattform an. Die Datenebene (Data Plane) ist der Ort, an dem Daten generiert, verschoben, transformiert und gespeichert werden. Die Steuerungsebene (Control Plane) definiert Zeitpläne, Richtlinien, Schwellenwerte, Workflows und Reaktionen. Die Metadatenebene erklärt, was jedes Asset ist, wem es gehört, wie es mit anderen Assets verbunden ist und wie es sich im Laufe der Zeit verhalten hat.
Die Definition in drei Schritten aufbauen
Identifizieren Sie zuerst das zu beobachtende System. Es umfasst Quellanwendungen, Ingestion-Jobs, Transformationswerkzeuge, Warehouses, Lakes, Dashboards und Modelleingaben. Observability muss den Daten auf diesem gesamten Pfad folgen und darf nicht beim ersten erfolgreichen Job aufhören.
Identifizieren Sie zweitens die Signale. Metriken beschreiben messbares Verhalten wie Ankunftszeit, Volumen oder Verteilung. Logs protokollieren Ereignisse und Fehler. Prädiktive Signale heben Abweichungen von erwarteten Mustern hervor. Lineage und Metadaten liefern den Kontext, der eine Warnung in einen Untersuchungspfad verwandelt.
Identifizieren Sie drittens die Entscheidungsschleife. Die Plattform erfasst oder berechnet Signale, bewertet sie anhand von Regeln oder gelernten Baselines, reichert Ereignisse mit Kontext an und leitet Maßnahmen an die Verantwortlichen oder Incident-Workflows weiter. Diese Schleife unterscheidet Observability von einem statischen Qualitätsbericht.
Warum Qualitätswerkzeuge allein nicht ausreichen
Ein Datenqualitätswerkzeug kann validieren, ob Werte den bekannten Regeln entsprechen. Das ist wertvoll, erklärt aber nicht automatisch, ob eine verzögerte Tabelle Auswirkungen auf einen regulatorischen Bericht hat, welches Team die Upstream-Quelle besitzt oder ob dasselbe Verhalten für einen bestimmten Bereitstellungsplan normal ist. Observability kombiniert Validierung mit Timeliness, Anomalieerkennung, Lineage und operativem Kontext.
Die Architektur sollte zudem unabhängig von den beobachteten Pipelines bleiben. Praktische Leitfäden trennen die Observability-Plattform vom beobachteten Datensystem, sodass die Plattform neue und bestehende Altsysteme überwachen kann, ohne dass architektonische Neugestaltungen erforderlich werden (wissenschaftliche Architektur-Leitfäden). Diese Unabhängigkeit ermöglicht es Teams, die Abdeckung schrittweise auszubauen, anstatt zuerst jedes Warehouse, jeden Lake oder jeden Orchestrierungs-Workflow neu zu entwerfen.
Einfach ausgedrückt ist eine Data Observability-Architektur die Anordnung von Ausführung, Erfassung, Metadaten, Analyse und Aktion, die es einem Team ermöglicht, den aktuellen und erwarteten Zustand von Daten über deren gesamten Lebenszyklus hinweg zu verstehen.
Kernebenen und Komponenten einer modernen Architektur
Eine moderne Architektur funktioniert am besten als eine Reihe spezialisierter Ebenen. Jede Ebene übernimmt eine andere Aufgabe, aber alle Ebenen teilen genügend Metadaten und Ereigniskontext, um die Diagnose zu unterstützen.

Quellsysteme und die Datenebene
Innerhalb dieser Ebene entstehen Geschäftsdaten und werden Transformationen ausgeführt. Sie kann operative Datenbanken, SaaS-Anwendungen, Streaming-Systeme, Cloud-Speicher, Warehouses und Lakes umfassen. Die Datenebene sollte für die Aufgabe des Verschiebens und Verarbeitens von Daten verantwortlich bleiben.
Eine wichtige Designentscheidung ist, ob die Observability-Berechnungen hier ausgeführt werden. Die In-Database-Ausführung berechnet Metriken und führt Prüfungen innerhalb kompatibler Datenquellen durch, während ein externes Design Informationen für die Analyse an anderer Stelle extrahiert. Die Ausführung nahe an den Daten zu halten, kann unnötige Datenbewegungen reduzieren und bestehende Sicherheitsgrenzen wahren. Dennoch müssen Teams Berechtigungen und Workload-Isolierung sorgfältig verwalten.
Erfassung und Ingestion
Die Erfassungsebene sammelt Telemetriedaten und Metadaten aus der Datenebene. Sie kann Tabellenstatistiken, Pipeline-Ereignisse, Schemaänderungen, Abfrageverhalten, Bereitstellungszeiten, Validierungsergebnisse und Lineage-Updates erfassen. Der Zweck besteht nicht darin, jeden Datensatz in das Observability-System zu kopieren. Es geht darum, die Signale und Referenzen zu sammeln, die zum Verständnis des Verhaltens erforderlich sind.
Eine leistungsstarke Erfassungsebene unterstützt sowohl zeitgesteuerte als auch ereignisgesteuerte Muster. Zeitgesteuerte Prüfungen sind nützlich für bekannte Bereitstellungsfenster. Ereignisse sind nützlich, wenn sich ein Schema ändert, eine Pipeline abgeschlossen wird oder eine Quelle einen relevanten Zustandsübergang meldet.
Zentralisierte Orchestrierung und Metadaten
Die Steuerungsebene plant Prüfungen, wendet Richtlinien an, speichert Konfigurationen und koordiniert Warnmeldungen. Die Metadatenebene reichert jedes Signal mit Zuständigkeiten, Definitionen, Lineage, Nutzung, Umgebung und historischem Kontext an. Zusammen beantworten sie die Fragen, die rohe Metriken nicht beantworten können.
Diese Ebene sollte auch ältere und heterogene Umgebungen unterstützen. Eine Plattform, die nur ein einziges Warehouse versteht, hinterlässt blinde Flecken bei On-Premises-Systemen, Multi-Cloud-Umgebungen oder älteren Orchestrierungswerkzeugen. Das architektonische Ziel ist ein gemeinsames Kontextmodell, nicht erzwungene Einheitlichkeit in jedem zugrunde liegenden System.
Observability und Aktion
Die oberste Ebene stellt den Gesundheitszustand, Trends, Anomalien, Vorfälle und Auswirkungen dar. Sie soll einem Responder helfen, von einem Signal zu einer Entscheidung zu gelangen:
Erkennung: Welches Verhalten hat sich geändert?
Diagnose: Welches Upstream-Ereignis oder welche Transformation könnte dies erklären?
Auswirkung: Welche Datensätze, Dashboards, Modelle oder Prozesse hängen davon ab?
Aktion: Wer ist für die Behebung zuständig und wie soll das Ereignis nachverfolgt werden?
Diese Struktur deckt sich mit allgemeineren Leitfäden für Datensystem-Architekturen, bei denen die Grenzen zwischen Verarbeitung, Orchestrierung, Metadaten und Konsum explizit bleiben müssen.
Architekturregel: Halten Sie die Ausführung nahe an den Daten, wenn Governance und Kosten Lokalisierung erfordern. Halten Sie den Kontext jedoch zentral genug, damit Responder die Auswirkungen über die gesamte Plattform hinweg verstehen können.
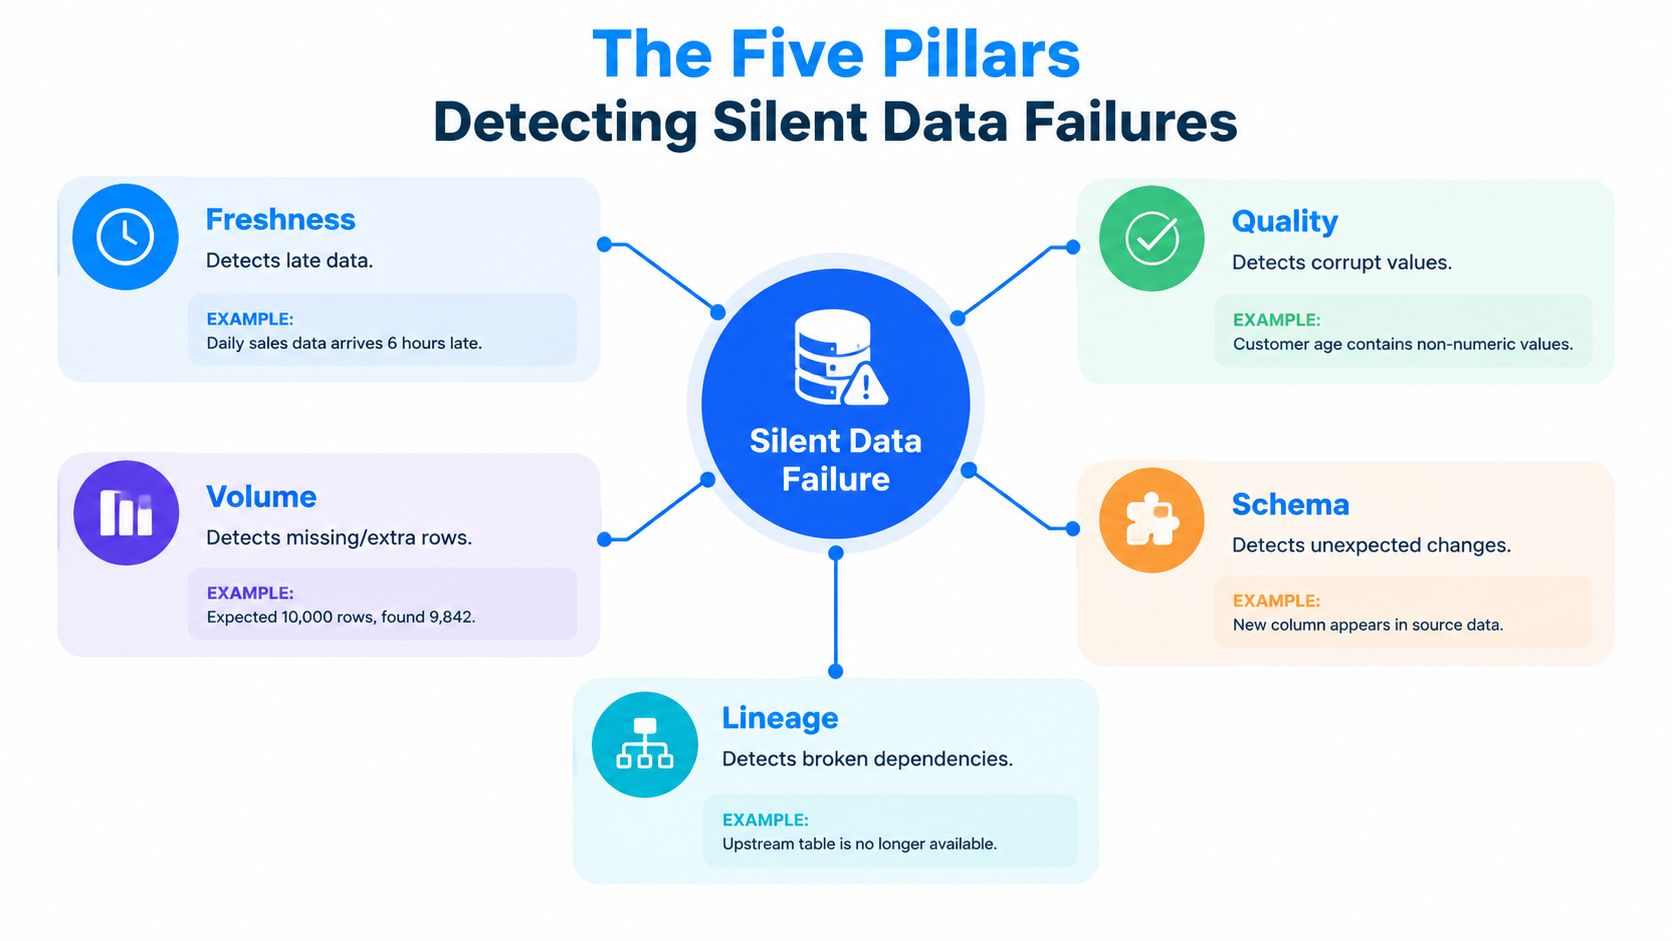
Die fünf Säulen, die stille Datenfehler erkennen
Das Fünf-Säulen-Modell bietet Teams einen praktischen Ausgangspunkt: Freshness, Qualität, Volumen, Schema und Lineage. Jede Säule deckt einen anderen Fehlermodus ab. Ausgereifte Implementierungen kombinieren deterministische Validierung mit statistischer Anomalieerkennung, da explizite Regeln bekannte Verletzungen abfangen, während Verhaltensanalysen unerwartete Verschiebungen aufdecken können.
Freshness
Freshness hinterfragt, ob Daten für ihre beabsichtigte Verwendung aktuell genug sind. Dies beschränkt sich nicht nur auf die Prüfung, ob ein Job gelaufen ist. Ein erfolgreicher Job kann dennoch Daten verspätet liefern, eine Partition auslassen oder einen unvollständigen Extrakt veröffentlichen.
Freshness bedeutet Timeliness. Überwachen Sie den Eingang und die Verarbeitung im Vergleich zum historischen Verhalten oder einer expliziten Service-Erwartung und behandeln Sie Verzögerungen als potenzielle Quell- oder Ingestionsfehler.
Eine nützliche Prüfung vergleicht die tatsächliche Ankunftszeit mit dem erwarteten Zeitplan. Das System sollte auch zwischen verspäteter und vorzeitiger Bereitstellung unterscheiden, wenn diese Unterscheidung von Bedeutung ist. Eine vorzeitige Datei kann darauf hindeuten, dass sich ein Quellprozess geändert hat, selbst wenn die Daten verfügbar zu sein scheinen.
Qualität
Qualitätsprüfungen validieren Datensätze und Werte anhand geschäftlicher oder technischer Erwartungen. Beispiele hierfür sind Pflichtfelder, gültige Wertebereiche, referenzielle Beziehungen, zulässige Kategorien und Konsistenz zwischen verwandten Datensätzen. Diese Regeln sind besonders wichtig für das regulierte Berichtswesen und kritische operative Workflows.
Qualität ist kein einzelner Wert. Teams sollten definieren, welche Dimensionen für den jeweiligen Anwendungsfall wichtig sind, und fehlgeschlagene Prüfungen dann mit dem betroffenen Asset und dem Eigentümer verknüpfen. Eine Regel für eine Finanztransaktionstabelle kann sich von der für einen explorativen Datensatz unterscheiden. Weitere Details zur Organisation dieser Dimensionen finden Sie im Leitfaden von digna zu den Dimensionen der Datenqualität.
Volumen
Volumenprüfungen suchen nach fehlenden, duplizierten oder unerwartet angewachsenen Daten. Eine Änderung der Zeilenanzahl kann auf eine unvollständige Ladung, einen Ausfall der Quelle, ein Join-Problem oder ein legitimes Geschäftsereignis hindeuten. Die Prüfung wird nützlicher, wenn sie historische Muster und nachgelagerte Abhängigkeiten berücksichtigt, anstatt einen einzigen universellen Schwellenwert anzuwenden.
Schema
Das Schema-Monitoring verfolgt strukturelle Änderungen wie hinzugefügte oder entfernte Spalten, umbenannte Felder und geänderte Datentypen. Es dient oft als Frühwarnsystem, da strukturelle Änderungen Transformationen, Dashboards, Verträge oder Modell-Features beschädigen können, bevor jemand einen sichtbaren Berichtsfehler bemerkt.
Teams sollten zwischen erwarteten und unerwarteten Änderungen unterscheiden. Eine kontrollierte Migration kann absichtlich eine Spalte hinzufügen, während eine vorgeschaltete API einen Typ ohne Vorankündigung ändern kann. Dasselbe Ereignis erfordert je nach Zuständigkeit, Umgebung und nachgelagerter Nutzung eine unterschiedliche Weiterleitung.
Lineage
Lineage zeigt, wie sich Daten von der Quelle über die Transformation bis zum Konsum bewegen. Sie verwandelt eine isolierte Warnmeldung in eine Auswirkungsanalyse. Wenn sich eine Quelltabelle ändert, kann Lineage aufzeigen, welche abgeleiteten Tabellen, Berichte, Metriken oder KI-Eingaben vom betroffenen Feld abhängen.
End-to-End-Observability verbindet Quellereignisse mit nachgelagerten Auswirkungen über Ingestion, Transformation, Speicherung und Konsum hinweg (Forschung zur Pipeline-Observability). Ohne Lineage erkennen Teams ein Problem zwar vielleicht schnell, verbringen aber immer noch zu viel Zeit damit, zu entscheiden, wo sie mit der Behebung beginnen sollen.
Wo Observability ausgeführt werden sollte und wie man sie bereitstellt
Eine Pipeline kann eine fehlgeschlagene Qualitätsprüfung erkennen und dennoch Probleme bei Governance, Kosten oder Portabilität verursachen. Die folgenschwerste Architekturentscheidung betrifft eher die Frage, wo Berechnung, Metadaten und Alerting angesiedelt sein sollen, als welche Prüfungen aktiviert werden sollen. In-Database-Designs berechnen kompatible Prüfungen innerhalb des Warehouses oder der Datenplattform. Externe Designs extrahieren Daten oder Metriken zur Verarbeitung in einen separaten Dienst.
In-Database-Ausführungen können Jobs innerhalb von Systemen wie Databricks, SAP HANA oder Snowflake ausführen und die Verarbeitung im SQL-Warehouse halten, anstatt Daten für die Analyse auszulagern (Leitfaden für Pushdown-Observability). Dieser Ansatz ähnelt der Inspektion von Waren direkt in der Fabrik: Die Daten verbleiben in der Nähe ihrer Quelle, während die Plattform den Workload aufnimmt. Eine externe Ausführung schafft ein zentralisiertes Betriebsmodell, erfordert jedoch möglicherweise umfassendere Berechtigungen, Konnektoren und Datenbewegungen. Teams, die ihre Data Platform Engineering-Praxis aufbauen, sollten diese Platzierungsentscheidung als Teil des Plattformdesigns betrachten.
Kriterium | In-Database-Ausführung | Externe Ausführung |
|---|---|---|
Governance | Prüfungen erfolgen innerhalb bestehender Datenzugriffsgrenzen und -richtlinien. | Ein separater Dienst benötigt eventuell Berechtigungen zum Extrahieren oder Inspizieren von Daten. |
Datenbewegung | Metriken und Validierungen können dort berechnet werden, wo sich die Daten befinden. | Daten oder Profiling-Ergebnisse werden an eine externe Verarbeitungsebene übertragen. |
Kostenkontrolle | Nutzt die Rechenleistung des Warehouses oder der Plattform, weshalb die Workload-Governance wichtig ist. | Verursacht separate Infrastruktur- oder Dienstleistungskosten, während einige Arbeiten innerhalb der Plattform reduziert werden. |
Portabilität | Funktioniert gut, wenn unterstützte Engines und SQL-Muster einheitlich sind. | Kann Logik über heterogene Systeme hinweg zentralisieren, schafft jedoch möglicherweise eine Dienstabhängigkeit. |
Sicherheit | Unterstützt Datenlokalität und minimiert das Risiko der Offenlegung von Produktionsdaten. | Erfordert sorgfältige Kontrollen für Extraktion, Speicherung, Verschlüsselung und Aufbewahrung. |
Performance | Profitiert von lokalem Datenzugriff und Engine-Optimierung. | Kann Overhead durch Übertragung, Planung oder Serialisierung verursachen. |
Betrieb | Teams verwalten die Auswirkungen auf die Arbeitslast innerhalb der jeweiligen Plattform. | Teams verwalten Konnektoren, Extraktionszuverlässigkeit und externe Kapazitäten. |
Bereitstellung an die Umgebung anpassen
Optionen für Private Cloud, VPC und On-Premises sind von Bedeutung, wenn Datenresidenz, Netzwerk- oder Zugriffsregeln die Bereitstellung einschränken. Eine regulierte Organisation kann das Observability-System innerhalb des eigenen Cloud-Kontos, der eigenen VPC oder des eigenen Rechenzentrums installieren und so Produktionsdaten innerhalb einer genehmigten Grenze halten.
Die Portabilität verdient die gleiche Aufmerksamkeit. Offene und interoperable Ansätze, einschließlich der Einführung von OpenTelemetry, Observability-as-Code und Tool-Konsolidierung, werden in aktuellen Berichten zu Observability-Trends als Prioritäten genannt (IBM Observability-Trends). Für Datenteams bedeutet Portabilität, dass Metadaten, Richtlinien, Lineage und Betriebshistorie auch bei Plattformwechseln erhalten bleiben. Der reine Export von Dashboards bewahrt diesen Betriebskontext nicht.
Stellen Sie vor der Entscheidung drei Fragen:
Kann die Plattform jede kritische Umgebung überwachen, ohne eine Datenverschiebung zu erzwingen?
Wer bezahlt für die Rechenleistung, die für Profiling und Anomalieerkennung verwendet wird?
Können Governance-Teams die Prüfungen, Berechtigungen, Ergebnisse und das Aufbewahrungsmodell auditieren?
Ein technisch korrekter Alarm ist unzureichend, wenn die Architektur das Zugriffsrisiko erhöht oder unvorhersehbare Kosten verursacht. Wählen Sie das Design, das Erkennungsqualität mit Datenlokalität, Portabilität und betrieblicher Kontrolle in Einklang bringt.
Von technischen Signalen zu geschäftlichen Auswirkungen mit realen Beispielen
Eine Aktualisierungswarnung wird nützlicher, wenn sie mit einem Geschäftsprozess verknüpft ist. Eine Schemawarnung wird dringlich, wenn sie ein Feld identifiziert, das von einem regulatorischen Bericht oder einer KI-Funktion verwendet wird. Ein Signal zur Auslastung der Plattform wird umsetzbar, wenn es erklärt, welches Team, welches Abfragemuster oder welches Datenprodukt Ressourcen verbraucht.
Diese Verbindung entsteht durch die Kombination von Lineage, Nutzungsmetadaten, Zuständigkeiten, Geschäftsdefinitionen und Observability-Signalen in einem kontextuellen Abhängigkeitsgraphen. Der Graph ersetzt keine technischen Prüfungen. Er weist jeder Prüfung einen Platz im Betriebsmodell zu.

Finanzdienstleistungen
Ein Transaktionsdatensatz kann eine grundlegende Prüfung auf Pipeline-Abschluss bestehen, während er gleichzeitig eine Geschäftsregel verletzt oder nach einem Berichtsfenster eintrifft. Das Datenqualitätsmanagement kombiniert Validierung, Anomalieerkennung, Timeliness-Tracking und Schema-Monitoring, um das Problem zu identifizieren. Lineage zeigt dann, ob die betroffenen Datensätze in Risikoberechnungen, das regulatorische Berichtswesen oder den nachgelagerten Abgleich einfließen.
Die Priorität der Reaktion sollte diese Auswirkung widerspiegeln. Eine Abweichung in einer ungenutzten analytischen Tabelle ist nicht gleichzusetzen mit einer strukturellen Änderung in einem Datensatz, der von einem kritischen Finanzprozess verwendet wird.
Gesundheitswesen
Teams im Gesundheitswesen benötigen oft zuverlässige klinische, operative und regulatorische Daten über Systeme mit unterschiedlichen Zuständigkeiten und Bereitstellungsmustern hinweg. Ein verspäteter Extrakt kann eine operative Sicht verzögern, während ein geänderter Feldtyp eine nachgelagerte Integration beschädigen kann. Freshness, Validierung, Schema-Tracking und Lineage liefern unterschiedliche Belege für dieselbe Untersuchung.
Die Architektur sollte sensible Daten innerhalb genehmigter Umgebungen halten, während sie gleichzeitig genügend Metadaten bereitstellt, damit autorisierte Teams Status und Zuständigkeiten verstehen können.
Telekommunikation und öffentlicher Sektor
Eine Telekommunikationsplattform kann Kunden- und Betriebsdaten auf ungewöhnliches Verhalten bezüglich Volumen, Verfügbarkeit oder Verteilung überwachen. Eine Organisation des öffentlichen Sektors priorisiert möglicherweise Rückverfolgbarkeit, Konsistenz und auditfähige Nachweise über langlaufende Datenprozesse hinweg. In beiden Szenarien besteht die wichtigste Designentscheidung darin, technische Ereignisse mit Dienstverpflichtungen und verantwortlichen Eigentümern zu verknüpfen.
Das Business-Monitoring kann KPIs auch direkt auf den zugrunde liegenden Daten auswerten. Data Platform Observability fügt eine ergänzende Sicht auf Workloads, Verbrauch, Verfügbarkeit und Plattformverhalten hinzu. Observability wird zunehmend Teil des Kostenmanagements und einer Strategie für offene Standards, nicht nur eine reine Dashboard-Ebene.
KI-Bereitschaft
KI-Teams benötigen mehr als nur eine saubere Tabelle zum Zeitpunkt des Trainings. Sie benötigen Lineage von den Quelldaten über Transformationen, Features und Trainingseingaben bis hin zu den Modelleingaben. Wenn sich ein Quellschema ändert oder eine Freshness-Verzögerung eine Feature-Pipeline beeinträchtigt, sollte der Abhängigkeitsgraph offenlegen, welche Modelleingaben veraltet oder strukturell inkompatibel sein könnten.
Die entscheidende Frage lautet nicht mehr nur: „War die Prüfung erfolgreich?“ Sie lautet: „Welches Geschäftsergebnis, welcher Betriebsprozess oder welche KI-Eingabe hängt von diesem Signal ab und wer kann darauf reagieren?“
Ihr Fahrplan zur Implementierung einer Data Observability-Architektur
Beginnen Sie mit einem eng gesteckten Rahmen und einem klaren Verantwortlichen. Eine breit angelegte Einführung ohne Prioritäten erzeugt Rauschen, bevor das Team überhaupt versteht, wie es reagieren soll.
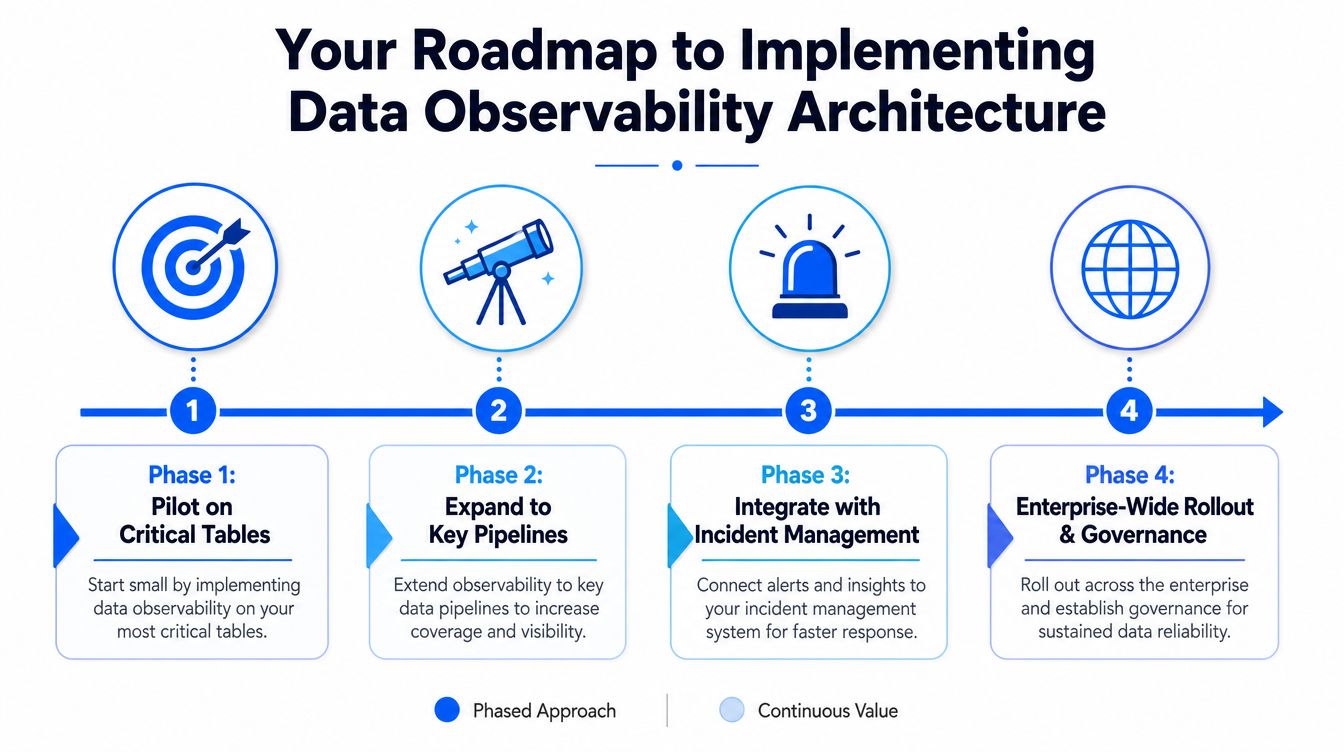
Phase eins: Pilotierung kritischer Tabellen
Wählen Sie Datensätze aus, die wichtige Berichts-, Betriebs-, Governance- oder KI-Workflows unterstützen. Etablieren Sie das erwartete Bereitstellungsverhalten, grundlegende Volumenmuster, Schemaerwartungen und einen kleinen Satz von Geschäftsvalidierungen. Weisen Sie jedem Alarm einen Verantwortlichen zu, bevor Sie Benachrichtigungen aktivieren.
Phase zwei: Erweiterung auf wichtige Pipelines
Fügen Sie Upstream- und Downstream-Abdeckung hinzu, damit das Team Fehler an ihrer Quelle zurückverfolgen kann, anstatt nur isolierte Symptome auf Tabellenebene zu sehen. Beziehen Sie Lineage-, Nutzungs- und Inhaber-Metadaten ein und vergleichen Sie dann die In-Database- und die externe Ausführung für die relevanten Umgebungen.
Phase drei: Anbindung des Incident Managements
Leiten Sie Warnmeldungen an die für die Behebung zuständigen Teams weiter. Erfassen Sie die betroffenen Assets, die vermutete Ursache, die geschäftlichen Auswirkungen, den Status und die Lösung. Analysieren Sie wiederkehrende Vorfälle, um architektonische Lösungen zu identifizieren, anstatt manuelle Wiederherstellungen zu wiederholen.
Phase vier: Etablierung von Enterprise Governance
Standardisieren Sie Richtlinien für Freshness, Schemaänderungen, Validierung, Zugriff, Aufbewahrung und Eskalation. Erweitern Sie die Abdeckung auf Warehouses, Lakes, Pipelines und On-Premises-Umgebungen, während Sie Portabilität und Rechenleistungverbrauch überprüfen. Eine modulare Implementierung kann mit einer einzelnen Funktion beginnen und über ein Modell aus Grundgebühr plus Kosten pro aktiver Tabelle pro Modul wachsen, anstatt von Anfang an jeden Anwendungsfall abdecken zu müssen.
Ein benutzerzentriertes Dashboard sollte Engineers, Analysten und Governance-Stakeholder mit unterschiedlichen Sichten auf denselben zugrunde liegenden Kontext bedienen. Teams, die nach praktischen Anleitungen suchen, können dieses Framework zur Implementierung von Datenqualität nutzen, um Zuständigkeiten, Kontrollen und Rollout-Prioritäten zu definieren.
Die robusteste Architektur behandelt Erkennungsqualität, Governance, Portabilität und Kostenkontrolle als ein einziges Designproblem. Beginnen Sie mit einem kritischen Datenprodukt, messen Sie, wie gut das Team Fehler erkennen und erklären kann, und erweitern Sie das System erst dann, wenn das Betriebsmodell bereit ist.
digna bietet eine Enterprise-Plattform für Datenqualität und Observability mit In-Database-Ausführung, Anomalieerkennung, Timeliness-Monitoring, Validierung, Schema-Tracking sowie Business- und Plattform-Monitoring. Besuchen Sie digna, um zu erfahren, wie eine Architektur, die Daten an Ort und Stelle belässt, zuverlässige Analysen, Governance und KI in Ihrer gesamten Datenumgebung unterstützen kann.
Häufig gestellte Fragen
Was ist Data-Observability-Architektur?
Die Anordnung von Ausführung, Erfassung, Metadaten, Analyse und Handlung, die einem Team erlaubt, den aktuellen und erwarteten Zustand der Daten über den gesamten Lebenszyklus zu verstehen. Die nützliche Analogie ist ein Armaturenbrett: nicht mehr Anzeigen, sondern die Anordnung, die zu richtigem Handeln führt.
Warum genügt klassisches Monitoring nicht?
Weil es operative Fragen beantwortet, etwa ob ein Server verfügbar ist, ein Job endete oder ein Prozess einen Fehler lieferte. Keine davon erklärt eine Tabelle, die pünktlich eintraf, erfolgreich durchlief und dennoch falsche Werte trägt, genau dieser Fehler erreicht die Entscheidung.
Wo sollten Observability-Berechnungen laufen?
Das ist die zentrale Entwurfsentscheidung in der Datenebene. Prüfungen dort auszuführen, wo die Geschäftsdaten entstehen, hält den Kontext nah am Fehler, vermeidet unnötige Bewegung und zählt besonders dort, wo Datenschutz und Betriebslast begrenzen, was die Umgebung verlassen darf.
Wer profitiert von guter Observability-Architektur?
Vier Gruppen mit unterschiedlichen Bedürfnissen: Data Engineers, die eine Ursache ohne Suche über getrennte Werkzeuge finden, Analytics Engineers, die strukturell valide Eingaben brauchen, Governance-Verantwortliche, die Nachweise fortlaufender Kontrollen benötigen, und KI-Teams, die Nachvollziehbarkeit von Quelldaten über Features bis zu Modelleingaben brauchen.
Wie groß ist der Markt für Data Observability?
Eine Branchenschätzung von 2026 beziffert ihn auf 3,51 Milliarden USD und prognostiziert 6,03 Milliarden USD bis 2031, bei einer CAGR von 11,42 % über 2026 bis 2031. Das Wachstum spiegelt die zunehmende Überschneidung von Governance, Verlässlichkeit und operativer Rechenschaft wider.



