Datenimport Bedeutung: Pipeline, Tools und Best Practices
|
6
min. Lesezeit

Unter Daten-Ingestion versteht man das Sammeln von Rohdaten aus mehreren Quellen und deren Übertragung in ein zentrales Repository mit minimaler Transformation, wodurch die Quellentreue gewahrt bleibt, sodass nachgelagerte Teams darauf zuverlässige Analysen und KI aufbauen können. Das klingt einfach, ist in der Praxis jedoch das erste Zuverlässigkeitstor in der Pipeline, und Teams spüren die Kosten später, wenn Dashboards hinterherhinken, Modellfunktionen veralten oder Schemaänderungen unbemerkt zu Fehlern führen.
Inhaltsverzeichnis
Einführung in die Frage, warum die Ingestion-Qualität alles Nachgelagerte bestimmt
Best Practices für Dateningenieure beim Aufbau von Ingestion-Pipelines
Fazit: Von der Ingestion als Transfer zur Ingestion als Vertrauensbasis
Einführung in die Frage, warum die Ingestion-Qualität alles Nachgelagerte bestimmt
Ingestion ist mehr als nur ein Kopierjob, es ist eine Disziplin der Zuverlässigkeit, die bestimmt, worauf sich nachgelagerte Teams verlassen können. Wenn Rohdatensätze verspätet, unvollständig oder fehlerhaft ankommen, bleibt das Problem nicht am Rand der Pipeline. Es zeigt sich später als veraltetes BI, verrauschte Warnmeldungen, schwache Modelleingaben und in Diskussionen von Teams darüber, wessen Zahlen stimmen.
Die praktische Bedeutung des Ingestierens von Daten ist unkompliziert. Es ist der Prozess des Sammelns von Rohdaten aus Quellen und deren Verschieben in ein Zielsystem mit so wenig Transformation wie möglich, damit spätere Stufen diese bereinigen, validieren, modellieren und verwalten (governance) können, während der Originaldatensatz der Quelle noch intakt ist. Diese grundlegende Idee findet sich in den Leitfäden von Anbietern wie Databricks, IBM und Microsoft wieder.
Die Verwirrung beginnt, weil die Leute „Ingestion“ hören und an „Transfer“ denken. In einer echten Pipeline ist der Transfer nur ein Teil der Aufgabe. Ein guter Ingestion-Pfad muss Latenzbudgets respektieren, die Vollständigkeit wahren, Duplikate unter Kontrolle halten und Schemaänderungen sichtbar machen, bevor nachgelagerte Verbraucher auf die harte Tour davon erfahren. Das ist der Unterschied zwischen Daten, die lediglich ankommen, und Daten, die Entscheidungen stützen können. Dies zeigt sich auch bei operativen Aufgaben wie der Funktionsweise von KI-Transkription, wo Timing, Struktur und Genauigkeit darüber entscheiden, ob das Ergebnis überhaupt verwendet werden kann.
Praktische Regel: Wenn die Daten bei der Landung nicht vertrauenswürdig sind, wird auch kein noch so großes nachgelagertes Modellieren sie später vertrauenswürdig machen.
Aus diesem Grund bewegen sich die folgenden Abschnitte von der Definition über die Betriebsmodi zu den Pipeline-Komponenten, realen Anwendungsfällen, Fehlermustern und den Gewohnheiten, die die Ingestion im großen Maßstab nutzbar halten. Wenn Sie eine konkrete Vorstellung davon bekommen möchten, wie diese Pipeline-Teile zusammenpassen, beginnen Sie mit einer Übersicht über Daten-Ingestion-Pipelines.
Was Daten-Ingestion bedeutet
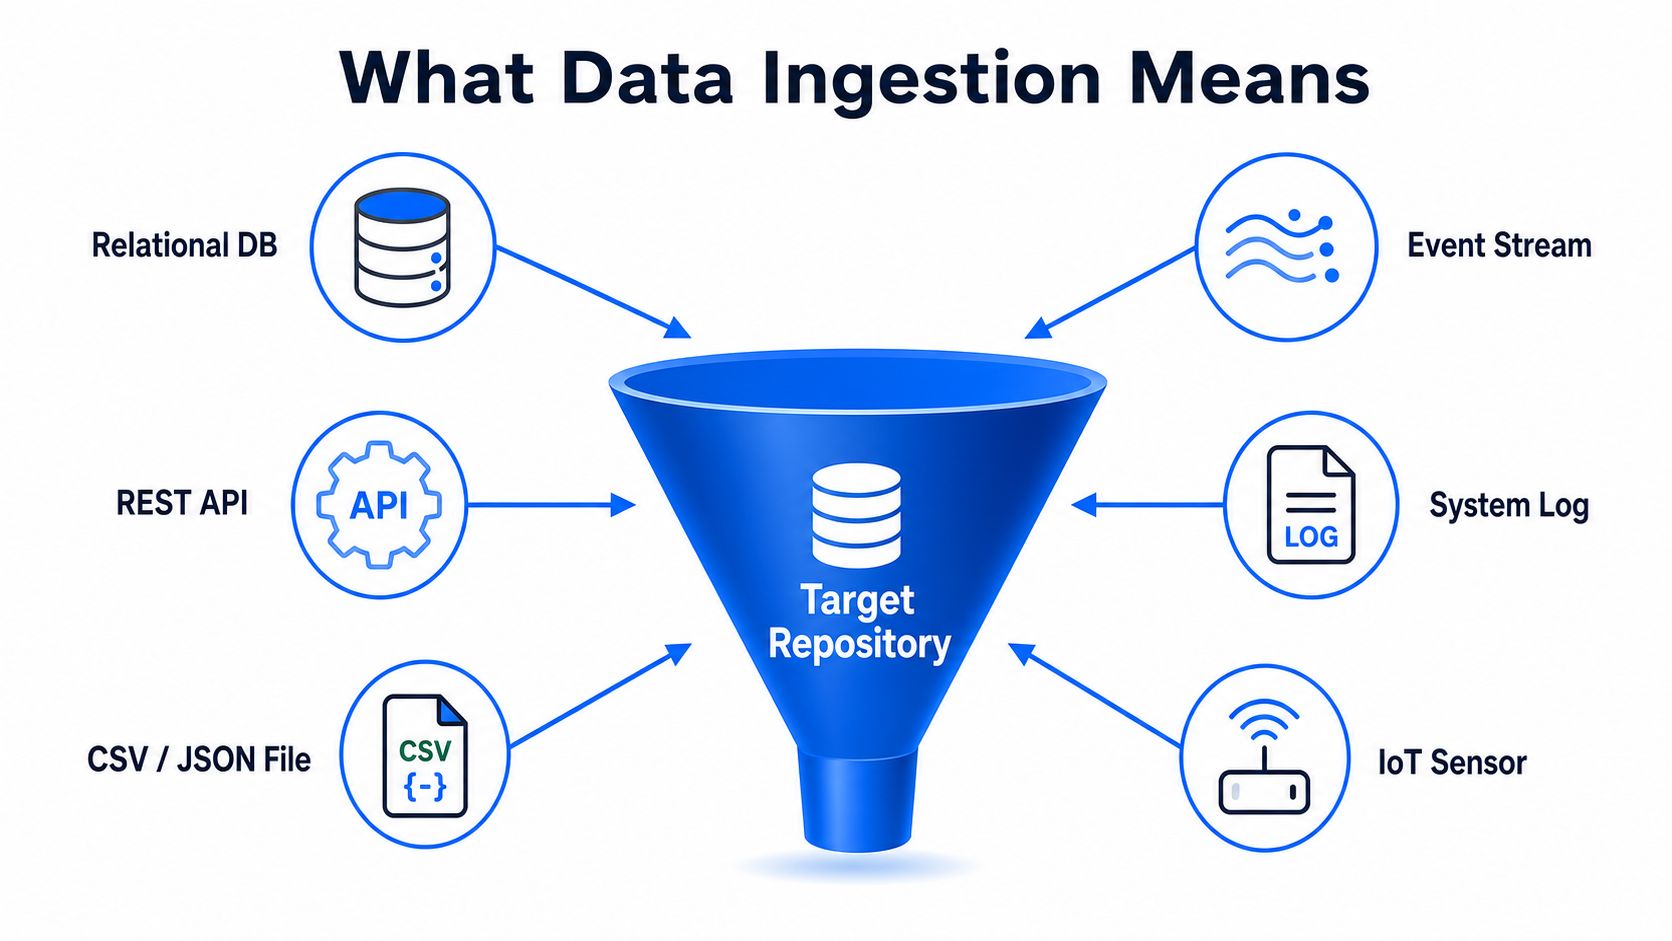
Die Ingestion ist die Annahmestelle für ein Datensystem. Sie nimmt den Datensatz entgegen, prüft, was reingekommen ist, erfasst die Grundlagen und leitet ihn für die spätere Verwendung an den richtigen Ort weiter. Diese Arbeit ist praktisch, repetitiv und wird leicht unterschätzt. Deshalb stellen Teams ihre Kosten oft erst fest, wenn nachgelagert etwas kaputtgeht.
Das ist der Kern der Bedeutung der Daten-Ingestion in einem modernen Stack. Die Aufgabe besteht darin, Rohdaten aus Quellsystemen, Datenbanken, SaaS-Apps, APIs, Dateisystemen, Protokollen, IoT-Geräten und Streaming-Feeds zu sammeln und sie in einem Data Lake, Warehouse oder Lakehouse abgelegen, wo Analysen und Automatisierungen stattfinden können. Das wahre Maß ist nicht, ob Daten verschoben wurden, sondern ob das Zielsystem sie ohne Rätselraten verwenden kann. Wenn Schemaänderungen, doppelte Datensätze oder zeitliche Lücken durchschlüpfen, sieht die Pipeline zwar immer noch geschäftig aus, während Analysen und KI-Modelle stetig an Zuverlässigkeit verlieren.
Eine gute Ingestion-Schicht schützt auch die Quellentreue. Die Daten landen in einem minimal transformierten Zustand, sodass Bereinigung, Validierung und governance stattfinden können, während der Originaldatensatz noch für Vergleiche zur Verfügung steht. Das ist wichtig, wenn ein Analyst eine Metrik bis zur genauen Quellzeile zurückverfolgen muss oder wenn ein Modellteam den Roheingang mit kuratierten Features vergleichen muss, bevor es der Ausgabe vertraut.
Der operative Wert geht über die Speicherung hinaus. Mit dem Übergang von isolierten Datenbanken zu cloudbasierten Analyseplattformen wurde die Ingestion zur Brücke, die verstreute Informationen in einem Tempo, das das Unternehmen nutzen kann, in gemeinsame Systeme kopiert. Informatica beschreibt diesen Wandel als mehr als nur Laden – es ist die Schicht, die den sicheren Transfer, die Pipeline-Bereitschaft und vertrauenswürdige Analysen unterstützt.
Wenn Sie eine konkrete Anleitung dazu suchen, wie diese Teile zusammenpassen, zeigt der Leitfaden für Daten-Ingestion-Pipelines den Pfad von der Erfassung bis zur nachgelagerten Nutzung auf. Das gleiche operative Denken zeigt sich bei der Funktionsweise von KI-Transkription, wo Roheingaben sorgfältig vorbereitet werden müssen, bevor sie ein nützliches Ergebnis liefern können.
Core Modes and Methods of Data Ingestion
Die erste Entscheidung betrifft die Frage, wie oft die Daten verschoben werden sollen. Die zweite betrifft die Frage, wer die Bewegung initiiert. Diese beiden Entscheidungen – Batch versus Streaming und Push versus Pull – prägen den Rest der Pipeline stärker, als viele Teams erwarten.
Batch Versus Streaming
Die Batch-Ingestion verschiebt Daten in geplanten Blöcken. Sie eignet sich für Berichte, historische Analysen und viele ML-Workflows, bei denen das System eine Verzögerung tolerieren kann. Die Streaming-Ingestion verschiebt Daten kontinuierlich. Dies ist die bessere Wahl, wenn das Unternehmen aktuelle Datensätze für die Betrugserkennung, operative Dashboards oder ereignisgesteuerte Systeme benötigt.
Modus oder Methode | Typische Latenz | Am besten geeignet für | Wichtigster Kompromiss |
|---|---|---|---|
Batch-Ingestion | Geplant, nicht kontinuierlich | Berichterstattung, historische Analysen, regelmäßige ML-Aktualisierungen | Geringere betriebliche Komplexität, aber langsamere Aktualität |
Streaming-Ingestion | Kontinuierliches Eintreffen | Betrugserkennung, Live-Dashboards, ereignisgesteuerte Workflows | Höhere Komplexität, engere Überwachung erforderlich |
Push-Ingestion | Quelle sendet Daten automatisch | Pipelines mit geringerer Latenz und fähigen Produzenten | Mehr Verantwortung bei den Quellsystemen |
Pull-Ingestion | Pipeline ruft nach einem Zeitplan ab | Kontrollierte Integrationen und Altsysteme | Zentral einfacher zu verwalten, aber mehr Verzögerung |
Diese Tabelle ist im Grunde ein Entscheidungsfilter. Wenn Ihr nachgelagerter Verbraucher nicht alle paar Sekunden frische Daten benötigt, ist Batch oft die vernünftigere Wahl. Wenn eine Verzögerung die Maßnahmen eines Teams beeinflusst, wird Streaming sinnvoll.
Push Versus Pull
Push-Ingestion reduziert die Latenz, da die Quelle Daten ausgibt, sobald sie bereit sind. Der Nachteil ist, dass die Produzenten verlässlich sein müssen, was bedeutet, dass sich ein schlechtes Verhalten der Quelle direkt in die Pipeline übertragen kann. Pull-Ingestion verlagert die Orchestrierungslast auf die Verbraucherseite. Sie gewinnen mehr Kontrolle über das Timing, erben aber auch die Verzögerung zwischen den Abrufen.
Für Teams, die in KI-intensiven Umgebungen arbeiten, ist diese Unterscheidung wichtiger als früher. Ein Workflow zur Markenüberwachung muss beispielsweise Signale von vielen Quellen schnell erfassen, während andere Datensätze auf einen geplanten Pull warten können. Der Leitfaden von GetIntel zur KI-Markenüberwachung ist eine nützliche Referenz, wenn Sie die Aktualitätsanforderungen für verschiedene Feeds und benutzerbezogene Warnmeldungen vergleichen.
Entscheidungsregel: Wählen Sie den langsamsten Modus, der das Geschäftsergebnis noch unterstützt, und überwachen Sie die Aktualität so aggressiv, dass Sie beweisen können, dass es funktioniert.
Pipeline-Komponenten, die die Ingestion zuverlässig machen
Ein zuverlässiger Ingestion-Pfad funktioniert wie eine Übergabekette. Wenn ein Glied schwach ist, bleibt der Bruch bei geringen Volumina möglicherweise verborgen und zeigt sich erst später als Latenz, fehlende Datensätze oder schlechte nachgelagerte Joins, sobald sich vorgelagerte Systeme ändern.
Sammlung und Transport
Der Datenkollektor oder Connector ist der Ort, an dem die quellenspezifische Realität lebt. Er kümmert sich um Protokolle, Authentifizierung und Schema-Erkennung, weshalb Teams Konnektoren verwenden, anstatt jede Integration selbst zu programmieren. Die Transportschicht verschiebt Datensätze sicher an ihr Ziel. In realen Systemen muss sie oft Pufferung und Backpressure verwalten, damit Verkehrsspitzen die Pipeline nicht überlasten.
Staging und Orchestrierung
Der Staging-Bereich ist der Ort, an dem Rohdatensätze vor der Transformation abgelegt werden. Dieser Puffer ist wichtig, da er die ursprüngliche Nutzlast bewahrt, falls nachgelagerte Jobs fehlschlagen oder erneut abgespielt werden müssen. Er bietet Teams zudem einen Ort, um Duplikate, fehlerhafte Felder oder verspätet eintreffende Datensätze zu prüfen, bevor sie Berichte und Modelle erreichen. Der Scheduler oder Orchestrator übernimmt Wiederholungen, Abhängigkeiten und das Timing, sodass sich das System vorhersehbar verhält, anstatt darauf angewiesen zu sein, dass sich jemand an einen Cron-Job erinnert.
Für Architekturmuster ist die Datenpipeline-Architektur-Seite ein nützlicher Referenzpunkt, da sie die Ingestion in den breiteren operativen Ablauf einordnet, anstatt sie als isolierten, eigenständigen Kopierschritt zu betrachten.
Monitoring und Observability
Das letzte Puzzleteil ist der Bereich, in dem viele Unternehmen zu wenig investieren. Das Monitoring muss Aktualität, Vollständigkeit, Schemaänderungen, Duplikate und Anomalien abdecken, und nicht nur, ob ein Job sauber beendet wurde. Das ist der Unterschied zwischen einer Pipeline, die einfach nur lief, und einer Pipeline, die beweist, dass ihre Ausgabe brauchbar ist.
digna ist eine Option in dieser Schicht. Seine Plattform läuft innerhalb der Kundenumgebung und konzentriert sich auf Ankunftszeitpläne, Schemaänderungen, Validierung und Anomalieerkennung, was der Art und Weise entspricht, wie die Zuverlässigkeit der Ingestion in der Produktion gemessen wird. Da die Prüfungen direkt in der Datenbank ablaufen, bleiben die Daten an Ort und Stelle, was Teams hilft, die Observability nahe an den Systemen zu halten, die sie bereits verwalten (governance).
Eine praktische Methode, diese Komponenten zu bewerten, besteht darin, sich zu fragen, wo ein fehlerhafter Datensatz gestoppt wird. Wenn der Kollektor eine Feldänderung übersieht, sollte das Staging dies aufdecken. Wenn Transport-Wiederholungen Duplikate erzeugen, sollte die Observability diese Spitze markieren, bevor Analyse- oder KI-Jobs falschen Zeilen vertrauen.
Wenn eine Stufe fehlt, tritt der Fehler oft an einer anderen Stelle auf – meist als Beschwerde aus dem Business und nicht als technischer Alarm.
Praxisbeispiele für Daten-Ingestion in der Realität
Ein nützlicher Weg, die Ingestion zu beurteilen, besteht darin, sich zu fragen, was kaputtgeht, wenn sie fehlerhaft ist. Die Antwort unterscheidet sich je nachdem, ob die Daten für die Betrugserkennung, Berichte der Geschäftsleitung oder das Modelltraining verwendet werden.
Betrugserkennung
In einem Zahlungsfluss muss die Streaming-Ingestion aus Transaktionsprotokollen und Zahlungs-APIs schnell genug ankommen, damit automatisierte Entscheidungen noch eine Rolle spielen. Wenn die Pipeline hinterherhinkt, blickt das Betrugsmodell in die Vergangenheit statt auf den Live-Event-Stream. Das operative Signal, auf das geachtet werden muss, ist die Aktualität, da veraltete Daten eine verpasste Sperrung oder eine verzögerte Reaktion bedeuten können.
Berichterstattung für die Geschäftsführung
Für ERP- und CRM-Daten ist die Batch-Ingestion üblich, da es bei Berichten für die Führungsebene meist mehr auf Konsistenz und Timing als auf sofortige Aktualisierungen ankommt. Die entscheidende Frage ist, ob die Daten vor dem Berichts-Stichtag landen. Wenn nicht, sieht das Dashboard vielleicht immer noch poliert aus, während die zugrunde liegenden Zahlen bereits veraltet sind.
ML-Feature-Pipelines
Feature-Pipelines stehen und fallen mit der Aktualität. Wenn sich die Ingestion verlangsamt, driftet der Trainingsdatensatz vom Systemzustand ab, und das Modell lernt aus alten Bedingungen. Das ist besonders riskant, wenn das Unternehmen von Mustern abhängt, die sich schnell ändern, da veraltete Features dazu führen können, dass ein Modell beim Testen gut, in der Produktion jedoch unzuverlässig aussieht.
Diese Beispiele knüpfen an einen Punkt an, der in modernen Leitfäden immer wieder auftaucht, einschließlich der Diskussion von Unstructured über die Qualität der Ingestion. Teams bewegen sich weg vom Denken „Daten verschieben“ hin zu „beweisen, dass die Daten nutzbar sind“ – insbesondere wenn nachgelagerte Entscheidungen von Aktualität, fehlerfreien Ladevorgängen und stabilen Schemata abhängen.
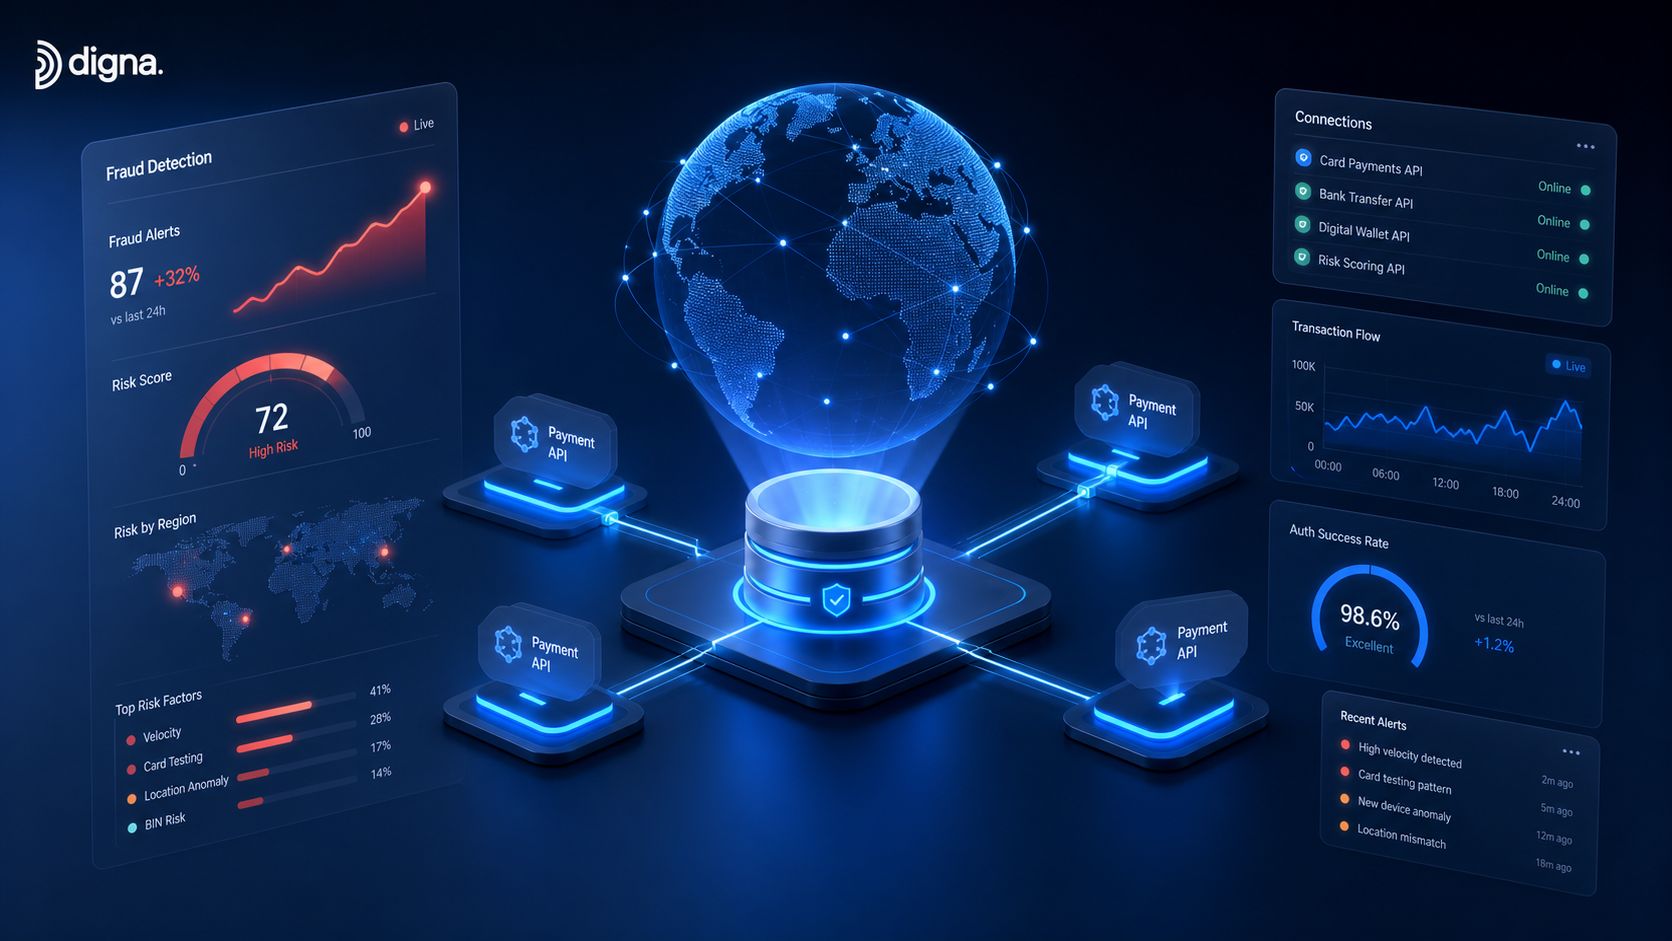
In allen drei Fällen ist die ingenieurtechnische Frage dieselbe: Wie stellen Sie sicher, dass die Daten rechtzeitig, vollständig und in einer Form angekommen sind, die das nächste System verwenden kann?
Häufige Ingestion-Fallstricke und wie sie sich fortpflanzen
Das teure an Ingestion-Problemen ist, dass sie selten lokal bleiben. Ein kleines Problem an der Quelle kann mehrere Stufen später zu einem geschäftlichen Problem werden, und zu diesem Zeitpunkt scheint die Ursache nichts mehr damit zu tun zu haben.
Latenz-Drift
Latenz-Drift tritt auf, wenn Daten später als erwartet eintreffen und dies niemand sofort bemerkt. Das unmittelbare Symptom ist oft ein Dashboard, das „in Ordnung“ aussieht, aber alte Bedingungen widerspiegelt. Für ein Team, das tägliche Entscheidungen trifft, kann diese Verzögerung ausreichen, um die nächsten Schritte zu verändern.
Doppelte Datensätze
Doppelte Datensätze sind tückischer, da sie Zahlen besser aussehen lassen können, als sie sind. Eine At-least-once-Zustellung ist zwar gut für die Zuverlässigkeit, kann aber die Zahlen künstlich in die Höhe treiben, wenn die Pipeline nicht intelligent dedupliziert. Der Schaden zeigt sich meist in Funnels, Umsatzsummen und ereignisbasierten Metriken, von denen die Leute annehmen, sie seien sauber.
Schema-Drift
Schema-Drift ist der leiseste dieser drei Fehler. Ein vorgelagertes Team fügt eine Spalte hinzu, ändert einen Typ oder benennt ein Feld um, und nachgelagerte Verbraucher fallen entweder aus oder laufen mit falschen Annahmen weiter. Das Schlimmste daran ist, dass der Fehler nur teilweise auftreten kann, sodass einige Abfragen erfolgreich sind, während andere fehlschlagen oder unsinnige Ergebnisse liefern.
Operative Wahrheit: Verspätete Daten, doppelte Daten und Formänderungen liegen oft weniger an Transportfehlern als vielmehr an mangelnder Sichtbarkeit.
Aus diesem Grund setzen Teams in den Bereichen Finanzen, Gesundheitswesen, Telekommunikation und im öffentlichen Sektor zunehmend auf evidenzbasierte Ingestion-Prüfungen. Sie benötigen den Nachweis, dass der Ingestion-Pfad für regulierte oder geschäftskritische Entscheidungen zuverlässig genug ist, und nicht nur den Beweis, dass Bytes verschoben wurden. Wenn die Observability schwach ist, kann die Pipeline immer noch erfolgreich abgeschlossen werden, während das Unternehmen veraltete, aufgeblähte oder unvollständige Ergebnisse erhält.
Best Practices für Dateningenieure beim Aufbau von Ingestion-Pipelines
Die erfolgreichsten Ingestion-Teams verlassen sich nicht auf Hoffnung oder eine einmalige Einrichtung. Sie etablieren Gewohnheiten, die Fehler frühzeitig sichtbar und die Behebung unspektakulär machen.
Mit der Erhaltung der Rohdaten beginnen
Bewahren Sie die rohen Quelldaten vor der Transformation im Staging auf. Das gibt Ihnen einen sauberen Rettungsanker, wenn ein nachgelagerter Job fehlschlägt oder sich eine Geschäftsregel ändert. Zudem erleichtert es Audits und die Wiederaufbereitung erheblich, da die ursprüngliche Nutzlast noch vorhanden ist.
Wiederholungsversuche sicher machen
Nutzen Sie idempotente Ladevorgänge, damit das erneute Ausführen eines Jobs keine künstlichen Duplikate erzeugt. Wenn eine Pipeline zweimal laufen muss, sollte der zweite Durchlauf die Realität nicht umschreiben. Diese eine Designentscheidung verhindert später eine Menge Verwirrung bei den Kennzahlen.
Überwachen, bevor Benutzer sich beschweren
Legen Sie Aktualitäts-SLAs mit realistischen Zeitfenstern fest und alarmieren Sie, wenn das System diese verfehlt. Verfolgen Sie Schemaänderungen kontinuierlich und warten Sie nicht darauf, dass eine nachgelagerte Abfrage ein fehlerhaftes Feld entdeckt. In der Praxis verbinden die besten Teams deterministische Prüfungen mit KI-gestütztem Erlernen von Baselines, um sowohl bekannte Fehler als auch neue Muster zu erkennen.
Die operative Checkliste kurz halten
Rohdaten bewahren: Speichern Sie Originale im Staging, um sie später erneut abspielen oder prüfen zu können.
Idempotente Ladevorgänge nutzen: Gestalten Sie Wiederholungen so, dass sie keine Duplikate erzeugen.
Frühzeitig überwachen: Richten Sie Warnmeldungen ein, bevor die Pipeline geschäftskritisch wird.
Schemaentwicklung verfolgen: Markieren Sie hinzugefügte, entfernte oder geänderte Felder schnell.
Zuständigkeiten dokumentieren: Weisen Sie Runbooks, Eskalationspfade und Regressionsprüfungen zu.
Eine Plattform wie die Daten-Ingestion-Software von digna passt gut in ein solches Betriebsmodell, da sie sich auf das Ankunftsverhalten, Schema-Drift und die Validierung auf Datensatzebene innerhalb der Kundenumgebung konzentriert. Dieses In-Database-Design ist wichtig, wenn Sicherheits- und Compliance-Anforderungen Datenbewegungen schwerer rechtfertigen lassen.
Der Kernpunkt ist einfach. Warten Sie nicht, bis die Pipeline „groß genug“ ist, um sich um Observability zu kümmern. Bis dahin sind die Kosten der Unwissenheit bereits Teil der Architektur.
Fazit: Von der Ingestion als Transfer zur Ingestion als Vertrauensbasis
Die Daten-Ingestion beginnt als Transferschritt, wird jedoch in dem Moment zur Vertrauensschicht, in dem andere Teams von ihr abhängen. Sobald BI-Dashboards, Feature-Stores und automatisierte Entscheidungen auf diesen Datensätzen basieren, ist der Ingestion-Pfad keine bloße Rohrleitung mehr, sondern ein geschäftlicher Kontrollpunkt.
Die grundlegenden Entscheidungen bleiben in allen Umgebungen gleich. Batch und Streaming bestimmen das Aktualitätsmodell. Push und Pull bestimmen das Zuständigkeitsmodell. Die fünst Pipeline-Komponenten – Sammlung, Transport, Staging, Orchestrierung und Observability – entscheiden darüber, ob das System reale Veränderungen übersteht. Die häufigsten Fallstricke – Latenz-Drift, Duplikate und Schema-Drift – zeigen sich als Vertrauensverlust, wenn man sie nicht frühzeitig abfängt.
Dieser Wandel von der bloßen Datenverschiebung hin zum Nachweis der Nutzbarkeit ist in modernen Datenprogrammen bereits spürbar, insbesondere dort, wo Entscheidungen Compliance- oder Betriebsrisiken bergen. Teams wollen nicht einfach nur Datensätze in einem Warehouse haben. Sie wollen den Beweis, dass der Ingestion-Pfad rechtzeitig, vollständig und stabil genug ist, um den nächsten Schritt zu unterstützen.
Wenn Sie diesen Teil Ihres Stacks optimieren, konzentrieren Sie sich auf die Signale, die für Ihre Benutzer am wichtigsten sind, und bauen Sie Prüfungen um sie herum auf. Die Teams, die das gut machen, verbringen weniger Zeit damit, über Dashboards zu streiten, und mehr Zeit damit, sie zu nutzen.
Wenn Sie bereit sind, die Zuverlässigkeit Ihrer Ingestion sichtbar zu machen, anstatt sie nur zu vermuten, entdecken Sie digna. Es wurde entwickelt, um Aktualität, Schemaänderungen, Validierung und Anomalien innerhalb Ihrer eigenen Umgebung zu überwachen, was es zu einer praktischen Lösung für Teams macht, die vertrauenswürdige Pipelines ohne zusätzliche Datenbewegungen benötigen.


