Co oznacza ingest danych: procesy, narzędzia i najlepsze praktyki
|
6
min. czyt.

Pozyskiwanie danych (data ingestion) oznacza zbieranie surowych danych z wielu źródeł i przenoszenie ich do scentralizowanego repozytorium przy minimalnej transformacji, z zachowaniem wierności źródła, dzięki czemu zespoły korzystające z danych na dalszych etapach mogą budować na nich niezawodne analizy i sztuczną inteligencję. Brzmi to prosto, ale w praktyce jest to pierwsza bramka niezawodności w potoku danych, a zespoły odczuwają koszty później, gdy pulpity nawigacyjne mają opóźnienia, cechy modeli stają się nieaktualne, a zmiany schematu psują się po cichu.
Spis treści
Wprowadzenie do tego, dlaczego jakość pozyskiwania danych decyduje o wszystkim na dalszych etapach
Komponenty potoku, które sprawiają, że pozyskiwanie danych jest niezawodne
Typowe pułapki pozyskiwania danych i sposób ich rozprzestrzeniania się
Najlepsze praktyki dla inżynierów danych budujących potoki pozyskiwania danych
Podsumowanie: Od pozyskiwania jako transferu do pozyskiwania jako zaufania
Wprowadzenie do tego, dlaczego jakość pozyskiwania danych decyduje o wszystkim na dalszych etapach
Pozyskiwanie danych to coś więcej niż kopiowanie, to dyscyplina niezawodności, która decyduje o tym, na ile zespoły na dalszych etapach mogą ufać danym. Jeśli surowe rekordy docierają opóźnione, niekompletne lub uszkodzone, problem nie pozostaje na skraju potoku. Objawia się później jako nieaktualne analizy BI, fałszywe alerty, słabe dane wejściowe do modeli i spory między zespołami o to, czyje liczby są poprawne.
Praktyczne znaczenie pozyskiwania danych jest proste. Jest to proces zbierania surowych danych ze źródeł i przenoszenia ich do systemu docelowego przy jak najmniejszej transformacji, tak aby na późniejszych etapach można było je czyścić, walidować, modelować i nadzorować (governance), podczas gdy rekord źródłowy pozostaje nienaruszony. Ta podstawowa idea pojawia się w wytycznych dostawców takich jak Databricks, IBM i Microsoft.
Zamieszanie zaczyna się, gdy ludzie słyszą „pozyskiwanie” i myślą „transfer”. W rzeczywistym potoku transfer to tylko część pracy. Dobra ścieżka pozyskiwania musi uwzględniać budżety opóźnień, dbać o kompletność, kontrolować duplikaty i uwidaczniać zmiany schematu, zanim odbiorcy końcowi dowiedzą się o nich w bolesny sposób. Na tym polega różnica między danymi, które po prostu dotarły, a danymi, które mogą wspierać decyzje. Przejawia się to również w pracach operacyjnych, takich jak jak działa transkrypcja AI, gdzie czas, struktura i dokładność wpływają na to, czy wynik w ogóle nadaje się do użytku.
Praktyczna zasada: jeśli dane nie są wiarygodne w momencie ich zapisu, żadne modelowanie na dalszych etapach nie sprawi, że staną się wiarygodne później.
Dlatego poniższe sekcje przechodzą od definicji do trybów pracy, następnie do komponentów potoku, rzeczywistych przypadków użycia, wzorców awarii i nawyków, które pozwalają na efektywne korzystanie z pozyskiwania danych na dużą skalę. Jeśli chcesz uzyskać konkretny obraz tego, jak te elementy potoku łączą się ze sobą, zacznij od przeglądu potoku pozyskiwania danych.
Co oznacza pozyskiwanie danych
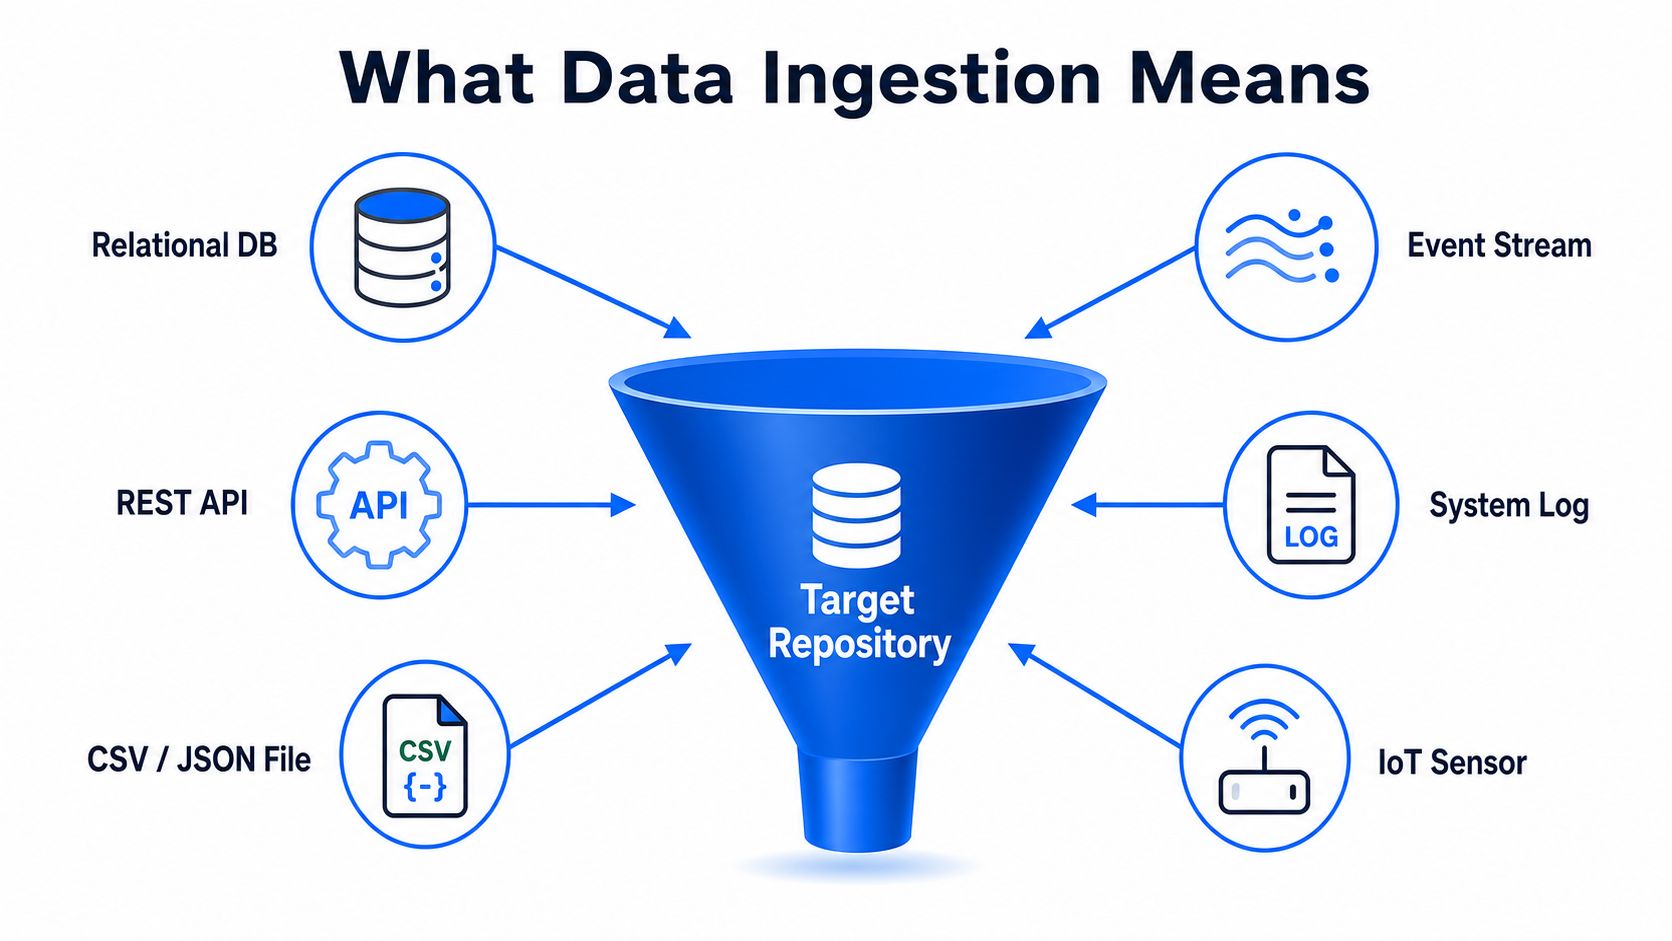
Pozyskiwanie to punkt przyjęć dla systemu danych. Odbiera rekord, sprawdza, co napłynęło, rejestruje podstawowe informacje i kieruje je we właściwe miejsce do późniejszego wykorzystania. Ta praca jest praktyczna, powtarzalna i łatwa do zbagatelizowania, dlatego zespoły często odkrywają jej koszt dopiero wtedy, gdy coś psuje się na dalszych etapach.
To jest sedno znaczenia pozyskiwania danych w nowoczesnym stosie technologicznym. Zadaniem jest zebranie surowych danych z systemów źródłowych, baz danych, aplikacji SaaS, interfejsów API, systemów plików, logów, urządzeń IoT i strumieni danych, a następnie umieszczenie ich w jeziorze danych (data lake), hurtowni danych (warehouse) lub lakehouse, gdzie mogą odbywać się analizy i automatyzacja. Prawdziwym miernikiem nie jest to, czy dane zostały przeniesione, ale to, czy system docelowy może z nich korzystać bez domysłów. Jeśli zmiany schematu, zduplikowane rekordy lub luki czasowe przejdą niezauważone, potok może nadal wyglądać na aktywny, podczas gdy analizy i modele AI stale tracą na niezawodności.
Dobrawa warstwa pozyskiwania chroni również wierność źródła. Dane lądują w minimalnie przekształconym stanie, dzięki czemu czyszczenie, walidacja i governance mogą odbywać się przy jednoczesnej dostępności oryginalnego rekordu do porównania. Ma to znaczenie, gdy analityk musi prześledzić metrykę wstecz do dokładnego wiersza źródłowego lub gdy zespół zajmujący się modelami musi porównać surowe dane wejściowe z wyselekcjonowanymi cechami przed zaufaniem wynikom.
Wartość operacyjna wykracza poza samo przechowywanie. Wraz z przejściem organizacji z silosowych baz danych na chmurowe platformy analityczne, pozyskiwanie stało się mostem, który kopiuje rozproszone informacje do współdzielonych systemów w tempie, z którego firma może korzystać. Firma Informatica opisuje tę zmianę jako coś więcej niż tylko ładowanie – to warstwa, która wspiera bezpieczny transfer, gotowość potoku i wiarygodną analitykę.
Jeśli chcesz zapoznać się z konkretnym omówieniem tego, jak te elementy łączą się ze sobą, przewodnik po potokach pozyskiwania danych mapuje ścieżkę od zbierania do wykorzystania na dalszych etapach. To samo myślenie operacyjne pojawia się w artykule o tym, jak działa transkrypcja AI, gdzie surowe dane wejściowe muszą być starannie przygotowane, zanim będą mogły wesprzeć użyteczny wynik.
Główne tryby i metody pozyskiwania danych
Pierwsza decyzja dotyczy tego, jak często dane powinny być przenoszone. Druga dotyczy tego, kto inicjuje ten ruch. Te dwa wybory – wsadowo czy strumieniowo oraz push czy pull – kształtują resztę potoku mocniej, niż spodziewa się wiele zespołów.
Wsadowo a strumieniowo
Pozyskiwanie wsadowe (batch ingestion) przenosi dane w zaplanowanych paczkach. Pasuje do raportowania, analizy historycznej i wielu procesów uczenia maszynowego (ML), w których system może tolerować opóźnienie. Pozyskiwanie strumieniowe (streaming ingestion) przenosi dane w sposób ciągły, co lepiej sprawdza się, gdy firma potrzebuje świeżych rekordów do wykrywania oszustw, operacyjnych pulpitów nawigacyjnych lub systemów sterowanych zdarzeniami.
Tryb lub metoda | Typowe opóźnienie | Najlepsze do | Kluczowy kompromis |
|---|---|---|---|
Pozyskiwanie wsadowe | Zaplanowane, nieciągłe | Raportowanie, analiza historyczna, regularne odświeżanie ML | Mniejsza złożoność operacyjna, ale wolniejsze odświeżanie danych |
Pozyskiwanie strumieniowe | Ciągłe docieranie | Wykrywanie oszustw, pulpity nawigacyjne na żywo, przepływy pracy sterowane zdarzeniami | Większa złożoność, potrzeba ścisłego monitorowania |
Pozyskiwanie typu Push | Źródło wysyła dane automatycznie | Potoki o niższym opóźnieniu z wydajnymi producentami | Większa odpowiedzialność po stronie systemów źródłowych |
Pozyskiwanie typu Pull | Potok pobiera dane zgodnie z harmonogramem | Kontrolowane integracje i systemy legacy | Łatwiejsze centralne zarządzanie, ale większe opóźnienie |
Ta tabela to w rzeczywistości filtr decyzyjny. Jeśli odbiorca końcowy nie potrzebuje świeżych danych co kilka sekund, wybór trybu wsadowego jest zazwyczaj najrozsądniejszy. Jeśli opóźnienie zmienia działania podejmowane przez zespół, wówczas sens zaczyna mieć strumieniowanie.
Push a Pull
Pozyskiwanie typu Push zmniejsza opóźnienia, ponieważ źródło wysyła dane, gdy tylko są gotowe. Wadą jest to, że producenci muszą być niezawodni, co oznacza, że złe zachowanie źródła może bezpośrednio wpłynąć na potok. Pozyskiwanie typu Pull przenosi ciężar orkiestracji na stronę odbiorcy. Zyskujesz większą kontrolę nad czasem, ale przejmujesz także opóźnienie między pobraniami.
Dla zespołów pracujących w środowiskach intensywnie korzystających z AI to rozróżnienie ma większe znaczenie niż dawniej. Na przykład proces monitorowania marki może wymagać szybkiego przechwytywania sygnałów z wielu źródeł, podczas gdy inne zestawy danych mogą poczekać na zaplanowane pobranie (pull). Przewodnik GetIntel dotyczący monitorowania marki przez AI jest przydatnym odniesieniem, jeśli porównujesz wymagania dotyczące świeżości w wielu kanałach i alertach dla użytkowników.
Zasada decyzyjna: wybierz najwolniejszy tryb, który nadal wspiera cele biznesowe, a następnie monitoruj świeżość wystarczająco agresywnie, aby udowodnić, że to działa.
Komponenty potoku, które sprawiają, że pozyskiwanie danych jest niezawodne
Niezawodna ścieżka pozyskiwania działa jak łańcuch przekazywania danych. Jeśli jedno ogniwo jest słabe, uszkodzenie może pozostać ukryte przy małych wolumenach, a ujawnić się dopiero później jako opóźnienie, brakujące rekordy lub błędne złączenia na dalszych etapach po zmianie systemów źródłowych.
Zbieranie i transport
Kolektor danych lub konektor to miejsce, gdzie spotykamy się ze specyfiką danego źródła. Obsługuje on protokoły, uwierzytelnianie i wykrywanie schematów, dlatego zespoły używają gotowych konektorów zamiast pisać każdą integrację ręcznie. Warstwa transportowa bezpiecznie przenosi rekordy do miejsca docelowego, a w rzeczywistych systemach często musi zarządzać buforowaniem i przeciążeniami (backpressure), aby skoki ruchu nie przeciążyły potoku.
Strefa przejściowa i orkiestracja
Strefa przejściowa (staging area) to miejsce, w którym surowe rekordy czekają przed transformacją. Ten bufor ma znaczenie, ponieważ zachowuje oryginalny zestaw danych, jeśli zadania na dalszych etapach zakończą się niepowodzeniem lub muszą zostać powtórzone, oraz daje zespołom miejsce na sprawdzenie duplikatów, zniekształconych pól lub opóźnionych rekordów, zanim trafią one do raportów i modeli. Harmonogram (scheduler) lub orkiestrator obsługuje ponowne próby, zależności i czas, dzięki czemu system zachowuje się przewidywalnie, zamiast polegać na tym, że ktoś pamięta o zadaniu w cronie.
W przypadku wzorców architektury, strona poświęcona architekturze potoków danych jest przydatnym punktem odniesienia, ponieważ umieszcza pozyskiwanie danych w szerszym przepływie operacyjnym, zamiast izolować je jako samodzielny krok kopiowania.
Monitorowanie i observability
Ostatni element to obszar, w którym wiele organizacji inwestuje zbyt mało. Monitorowanie musi obejmować terminowość, kompletność, zmiany schematów, duplikaty i anomalie, a nie tylko to, czy zadanie zakończyło się pomyślnie. Na tym polega różnica między potokiem, który się uruchomił, a potokiem, który udowadnia, że jego wynik nadaje się do użytku.
digna to jedna z opcji w tej warstwie. Jej platforma działa w środowisku klienta i koncentruje się na harmonogramach docierania danych, zmianach schematów, walidacji i wykrywaniu anomalii, co odpowiada sposobowi mierzenia niezawodności pozyskiwania danych w środowisku produkcyjnym. Ponieważ kontrole są uruchamiane wewnątrz bazy danych, dane pozostają na swoim miejscu, co pomaga zespołom utrzymać observability blisko systemów, którymi już zarządzają.
Praktycznym sposobem analizy tych komponentów jest zadanie pytania, gdzie zatrzymywany jest uszkodzony rekord. Jeśli kolektor pominie zmianę pola, strefa przejściowa (staging) powinna to ujawnić. Jeśli ponowne próby transportu wygenerują duplikaty, observability powinna zasygnalizować ten skok, zanim procesy analityczne lub AI zaczną ufać niewłaściwym wierszom.
Jeśli brakuje jednego etapu, awaria często pojawia się w innym miejscu, zazwyczaj jako skarga biznesowa, a nie alert techniczny.
Rzeczywiste przykłady pozyskiwania danych w praktyce
Użytecznym sposobem oceny pozyskiwania danych jest zadanie pytania, co psuje się, gdy przebiega ono nieprawidłowo. Odpowiedź zmienia się w zależności od tego, czy dane zasilają logikę wykrywania oszustw, raportowanie dla kierownictwa, czy trenowanie modeli.
Wykrywanie oszustw
W przepływie płatności pozyskiwanie strumieniowe z logów transakcyjnych i interfejsów API płatności musi odbywać się wystarczająco szybko, aby automatyczne decyzje miały sens. Jeśli potok ma opóźnienia, model wykrywania oszustw analizuje historię zamiast strumienia zdarzeń na żywo. Sygnałem operacyjnym, który należy obserwować, jest świeżość danych, ponieważ nieaktualne dane mogą oznaczać pominięcie blokady lub opóźnioną reakcję.
Raportowanie dla kadry zarządzającej
Pozyskiwanie wsadowe jest powszechne w przypadku danych z systemów ERP i CRM, ponieważ raporty dla kierownictwa zazwyczaj bardziej dbają o spójność i odpowiedni czas niż o natychmiastowe aktualizacje. Kluczowym pytaniem jest to, czy dane lądują przed momentem zamrożenia raportów. Jeśli nie, pulpit nawigacyjny może nadal wyglądać nienagannie, podczas gdy kryjące się pod nim liczby są już nieaktualne.
Potoki cech uczenia maszynowego (ML feature pipelines)
Potoki cech (feature pipelines) zależą całkowicie od świeżości danych. Jeśli pozyskiwanie zwalnia, zestaw treningowy zaczyna odbiegać od stanu systemu, a model uczy się na starych warunkach. Jest to szczególnie ryzykowne, gdy biznes zależy od szybko zmieniających się wzorców, ponieważ nieaktualne cechy mogą sprawić, że model będzie wyglądał dobrze w testach, ale okaże się niezawodny w produkcji.
Te przykłady nawiązują do kwestii, która stale pojawia się w nowoczesnych publikacjach, w tym w dyskusji firmy Unstructured na temat jakości pozyskiwania danych. Zespoły przechodzą od myślenia „przenieś dane” do „udowodnij, że dane nadają się do użytku”, zwłaszcza gdy decyzje na dalszych etapach zależą od terminowości, kompletności załadunków i stabilnych schematów.
We wszystkich trzech przypadkach pytanie inżynieryjne jest takie samo. Skąd wiesz, że dane dotarły na czas, w całości i w postaci, którą kolejny system może przetworzyć?
Typowe pułapki pozyskiwania danych i sposób ich rozprzestrzeniania się
Kosztowna strona problemów z pozyskiwaniem danych polega na tym, że rzadko mają one charakter lokalny. Mały problem u źródła może stać się problemem biznesowym kilka warstw dalej, a wtedy jego główna przyczyna wydaje się zupełnie niepowiązana.
Dryf opóźnienia
Dryf opóźnienia (latency drift) ma miejsce wtedy, gdy dane zaczynają docierać później niż oczekiwano i nikt od razu tego nie zauważa. Natychmiastowym symptomem jest często pulpit nawigacyjny, który wygląda „w porządku”, ale odzwierciedla nieaktualne warunki. Dla zespołu podejmującego codzienne decyzje takie opóźnienie może wystarczyć, by zmienić kierunek dalszych działań.
Zduplikowane rekordy
Zduplikowane rekordy są trudniejsze do wykrycia, ponieważ mogą sprawić, że liczby będą wyglądać korzystniej niż w rzeczywistości. Dostarczanie typu „co najmniej raz” (at-least-once delivery) jest przydatne dla niezawodności, ale może sztucznie zawyżać statystyki, jeśli potok nie przeprowadza inteligentnej dedupikacji. Szkody zazwyczaj ujawniają się w lejkach konwersji, sumach przychodów i metrykach opartych na zdarzeniach, o których ludzie myślą, że są poprawne.
Dryf schematu
Dryf schematu (schema drift) to najcichsza z tych trzech awarii. Zespół pracujący na wcześniejszym etapie dodaje kolumnę, zmienia typ lub zmienia nazwę pola, a odbiorcy na dalszych etapach albo napotykają błędy, albo kontynuują działanie przy błędnych założeniach. Najgorsze jest to, że awaria może być częściowa, przez co niektóre zapytania kończą się sukcesem, podczas gdy inne zawodzą lub zwracają bzdury.
Prawda operacyjna: opóźnione dane, zduplikowane dane i zmiany struktury są często mniej związane z błędami transportu, a bardziej z brakiem widoczności.
Z tego powodu zespoły w finansach, opiece zdrowotnej, telekomunikacji i sektorze publicznym skłaniają się ku opartym na dowodach kontrolom pozyskiwania danych. Potrzebują dowodu, że ścieżka pozyskiwania jest wystarczająco niezawodna dla decyzji regulowanych lub o krytycznym znaczeniu, a nie tylko dowodu, że bajty zostały przesłane. Gdy observability jest słaba, potok może nadal odnosić „sukces”, podczas gdy biznes otrzymuje nieaktualne, zawyżone lub niekompletne wyniki.
Najlepsze praktyki dla inżynierów danych budujących potoki pozyskiwania danych
Najlepsze zespoły zajmujące się pozyskiwaniem danych nie polegają na nadziei ani jednorazowej konfiguracji. Budują nawyki, dzięki którym awarie są widoczne wcześnie, a przywracanie działania staje się rutyną.
Zacznij od zachowania surowych danych
Przechowuj surowe dane źródłowe w strefie przejściowej (staging) przed transformacją. Daje to czyste wyjście awaryjne, gdy zadanie na dalszym etapie nie powiedzie się lub zmieni się reguła biznesowa. Ułatwia to również audyt i ponowne przetwarzanie, ponieważ oryginalne dane są nadal dostępne.
Spraw, aby ponowne próby były bezpieczne
Stosuj **podejście idempotentne (idempotent loads)**, aby ponowne uruchomienie zadania nie powodowało mnożenia duplikatów. Jeśli potok musi zostać uruchomiony dwukrotnie, drugie uruchomienie nie powinno nadpisywać rzeczywistości. Ten jeden wybór projektowy zapobiega wielu późniejszym nieporozumieniom związanym z metrykami.
Monitoruj, zanim użytkownicy zaczną narzekać
Ustal realistyczne okna czasowe dla umów SLA dotyczących terminowości, a następnie wysyłaj alerty, gdy system ich nie dotrzymuje. Śledź zmiany schematów w sposób ciągły i nie czekaj, aż zapytanie na dalszym etapie wykryje uszkodzone pole. W praktyce najlepsze zespoły łączą kontrole deterministyczne z uczeniem linii bazowej opartym na AI, dzięki czemu mogą wykryć zarówno znane awarie, jak i nowe wzorce.
Skróć listę kontrolną operacji
Zachowuj surowe dane: przechowuj oryginały w strefie przejściowej, aby móc je później odtworzyć lub poddać audytowi.
Stosuj ładowanie idempotentne: projektuj ponowne próby tak, aby nie tworzyły duplikatów.
Monitoruj wcześnie: konfiguruj alerty, zanim potok stanie się krytyczny dla biznesu.
Śledź ewolucję schematu: szybko flaguj dodane, usunięte lub zmienione pola.
Dokumentuj własność: przypisuj procedury operacyjne (runbooks), ścieżki eskalacji i kontrole regresji.
Platforma taka jak oprogramowanie do pozyskiwania danych firmy digna wpisuje się w ten model operacyjny, ponieważ koncentruje się na zachowaniu podczas napływu danych, dryfie schematu i walidacji na poziomie rekordów w środowisku klienta. Taka konstrukcja wewnątrz bazy danych ma znaczenie, gdy wymogi bezpieczeństwa i governance utrudniają uzasadnienie przesyłania danych.
Główny wniosek jest prosty. Nie czekaj, aż potok będzie „wystarczająco duży”, aby zacząć dbać o observability. Do tego czasu koszt niewiedzy będzie już wpisany w architekturę.
Podsumowanie: Od pozyskiwania jako transferu do pozyskiwania jako zaufania
Pozyskiwanie danych zaczyna się jako etap transferu, ale staje się warstwą zaufania w momencie, gdy zależą od niego inne zespoły. Gdy pulpity nawigacyjne BI, magazyny cech (feature stores) i automatyczne decyzje opierają się na tych rekordach, ścieżka pozyskiwania przestaje być tylko infrastrukturą techniczną, a staje się biznesowym punktem kontrolnym.
Kluczowe wybory pozostają takie same we wszystkich środowiskach. Tryb wsadowy i strumieniowy określają model świeżości danych. Push i pull określają model własności. Pięć komponentów potoku – zbieranie, transport, strefa przejściowa (staging), orkiestracja i observability – decyduje o tym, czy system przetrwa zmiany w świecie rzeczywistym. Typowe pułapki – dryf opóźnienia, duplikaty i dryf schematu – ujawniają się jako utrata zaufania, jeśli nie zostaną wykryte odpowiednio wcześnie.
To przejście od przesyłania danych do udowadniania ich użyteczności jest już widoczne w nowoczesnych programach danych, zwłaszcza tam, gdzie decyzje niosą ze sobą ryzyko operacyjne lub ryzyko niezgodności z przepisami (compliance). Zespoły nie chcą po prostu rekordów w hurtowni danych. Chcą dowodów na to, że ścieżka pozyskiwania jest terminowa, kompletna i wystarczająco stabilna, aby wspierać kolejne działania.
Jeśli porządkujesz tę część swojego stosu technologicznego, skup się na sygnałach, które mają największe znaczenie dla Twoich użytkowników, a następnie zbuduj wokół nich kontrole. Zespoły, które robią to dobrze, spędzają mniej czasu na kłótniach o pulpity nawigacyjne, a więcej na korzystaniu z nich.
Jeśli chcesz sprawić, by niezawodność pozyskiwania danych była widoczna, a nie tylko domniemana, poznaj rozwiązanie digna. Zostało zaprojektowane do monitorowania terminowości, zmian schematów, walidacji i anomalii w Twoim własnym środowisku, co czyni je praktycznym wyborem dla zespołów, które potrzebują wiarygodnych potoków danych bez dodatkowego przesyłania danych.


