Wymiary jakości danych wyjaśnione dla nowoczesnych zespołów ds. danych
|
8
min. czyt.

Możesz mieć pulpit pełen zielonych ikon, potok danych kończący się zgodnie z harmonogramem i cotygodniowy raport trafiający na czas do każdej skrzynki odbiorczej, a i tak patrzeć, jak firma podejmuje błędną decyzję. To jest ta część, którą ludzie pomijają, gdy traktują wymiary jakości danych jak listę kontrolną Compliance zamiast jak model operacyjny. W środowisku produkcyjnym awaria zazwyczaj nie jest oczywistym uszkodzeniem danych. To powolne przesunięcie w jednym wymiarze, być może w terminowości, być może w spójności, a może w dokładności, które wymyka się ogólnemu monitoringowi i zatruwa decyzje.
Spis treści
Kiedy dobre dane prowadzą do błędnych decyzji
Od ram akademickich do rzeczywistości operacyjnej
Dlaczego lista stała się krótsza
Kluczowe wymiary i jak je mierzyć
Co mierzyć w pierwszej kolejności
W którym miejscu testy zawodzą w rzeczywistych potokach danych
Dlaczego kontekst decyduje o tym, które wymiary są najważniejsze
Wybieraj wymiary na podstawie przypadku użycia, a nie przyzwyczajenia
Operacjonalizacja wymiarów dzięki ciągłemu monitorowaniu
Jak ciągłe sprawdzanie działa w praktyce
Dlaczego architektura ma znaczenie
Ramy priorytetyzacji i lista kontrolna wdrożenia
Etapowe wdrożenie, które działa
Argumenty za ciągłym monitorowaniem zamiast okresowych kontroli
Kiedy dobre dane prowadzą do błędnych decyzji
Zespół ds. usług finansowych może przez miesiące ufać swoim pulpitom nawigacyjnym dotyczącym ryzyka, a i tak ponieść stratę. Liczby wyglądają stabilnie, zadania ETL kończą się sukcesem i nikt nie widzi uszkodzonej tabeli. Następnie przegląd modelu ujawnia problem: dane wejściowe dryfowały w sposób, którego zespół nigdy nie wyizolował, więc wyniki modelu pogarszały się na długo przed tym, jak ktokolwiek to zauważył.
To jest praktyczne niebezpieczeństwo stosowania pojedynczego wskaźnika jakości danych. Zbiór danych może być kompletny, ale nieświeży, prawidłowy, ale niespójny lub wewnętrznie czysty, ale niezgodny ze zdarzeniem biznesowym, które ma reprezentować. Gdy monitorowanie mówi tylko, że „jakość jest w porządku”, ukrywa pytanie: który wymiar zawiódł i w jaki sposób.
Wiele zespołów odkrywa to dopiero po podjęciu błędnej decyzji. Rzadko zdarza się, aby dane były bezużyteczne w każdym sensie. Częściej jeden wymiar przesunął się na tyle nieznacznie, że pozostał niewidoczny dla ogólnych kontroli, a jednocześnie zmienił zachowanie downstreamowych modeli, raportów lub alertów.
Praktyczna zasada: jeśli Twój monitoring nie potrafi określić, czy problemem jest świeżość, sprzeczność, duplikacja czy brak danych, oznacza to, że nie monitoruje tego, co faktycznie uległo awarii.
Dlatego praktycy muszą traktować wymiary osobno. Biznes nie doświadcza „jakości danych” jako abstrakcyjnego wyniku – doświadcza opóźnionych zasileń, powielonych podmiotów, brakujących pól, sprzecznych systemów i wartości, które nie odpowiadają już rzeczywistości. Użyteczny model operacyjny zaczyna się od zidentyfikowania dokładnego wymiaru, który uległ zmianie, a następnie prześledzenia, jak ta zmiana wpłynęła na decyzję.
Aby zapoznać się z powiązaną perspektywą na temat tego, jak słaba jakość danych wpływa na wyniki biznesowe, zobacz dyskusję digna na temat wpływu słabej jakości danych na decyzje biznesowe.
Od ram akademickich do rzeczywistości operacyjnej
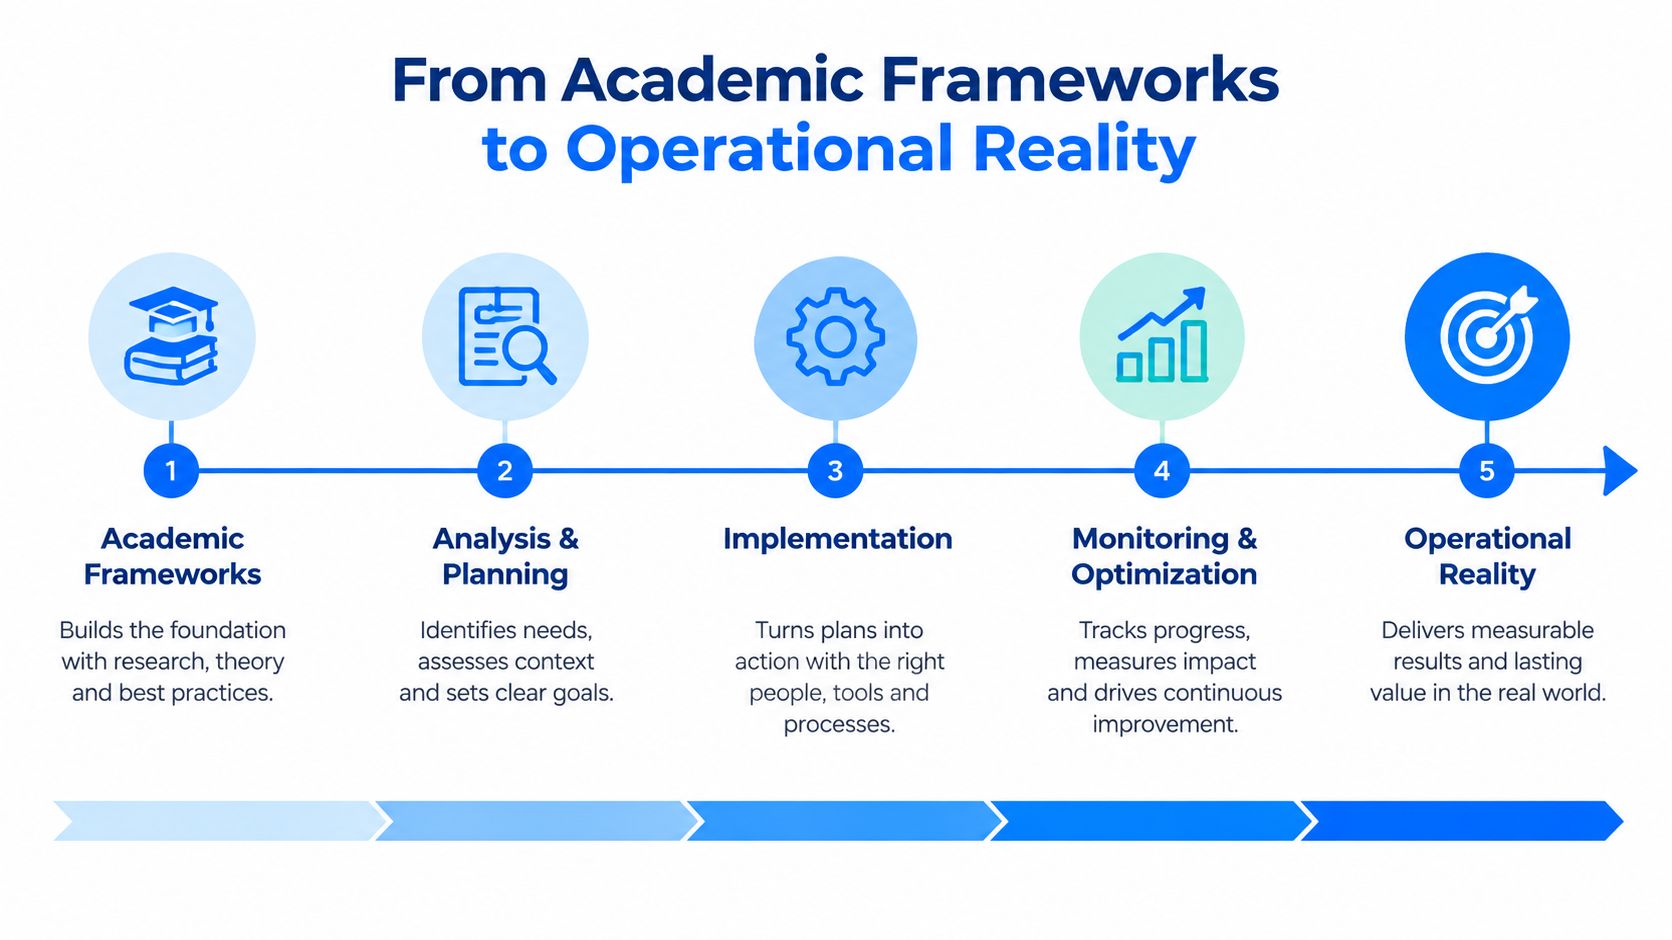
Praktyczny program jakości danych zazwyczaj zaczyna się od chaotycznej rzeczywistości, a nie uporządkowanej taksonomii. Historia współczesnych ram sięga lat 90. XX wieku, kiedy badacze zgrupowali 15 wymiarów jakości danych w kategorie: wewnętrzne, kontekstowe, reprezentacyjne i dostępności. Rozszerzyło to dyskusję poza samą dokładność i pomogło ukształtować późniejsze standardy, takie jak ISO 8000, jak opisano w literaturze. Ta historia ma znaczenie, ponieważ wyjaśnia, dlaczego zespoły wciąż dziedziczą pofragmentowany zestaw definicji, kontroli i modeli własności.
Dlaczego lista stała się krótsza
Większość organizacji nie jest w stanie wdrożyć operacyjnie wszystkich 15 cech jednocześnie. Potrzebują wymiarów, które mogą mierzyć, na które mogą ustawiać alerty i do których mogą przypisać właściciela. Zaproponowane przez IBM sześć podstawowych wymiarów – dokładność, kompletność, spójność, terminowość, poprawność i unikalność – odzwierciedla to przejście w kierunku kontroli, którymi zespoły mogą zarządzać. W przypadku szerszego rodowodu governance, DAMA-DMBOK jest często punktem odniesienia, z którego korzystają praktycy, gdy muszą powiązać koncepcje z praktyką operacyjną.
Ta sama potrzeba ujawnia się w innych ramach. Statistics Canada stosuje łatwiejszy do zarządzania zestaw obejmujący trafność, dokładność, terminowość, dostępność, interpretowalność i spójność, co pokazuje, jak organizacje upraszczają model, gdy celem jest codzienne governance, a nie akademickie pokrycie.
Norma ISO/IEC 25012 kieruje model w stronę wdrożenia, traktując jakość jako model wielowymiarowy z 15 charakterystykami wysokiego poziomu, podzielonymi na grupy wrodzone i zależne od systemu zgodnie z podsumowaniem standardu. Ten podział ma znaczenie w środowisku produkcyjnym, ponieważ same dane mogą być poprawne, podczas gdy potok, schemat lub interfejs sprawiają, że wyglądają na uszkodzone. Norma ISO 8000-8 zawęża następnie te działania do jakości syntaktycznej, semantycznej i pragmatycznej jak opisano w literaturze, co stanowi rodzaj podziału, który inżynierowie mogą przekształcić w testy, wyjątki i ścieżki eskalacji.
Praktyczna lekcja jest prosta. Taksonomie akademickie definiują przestrzeń. Ramy operacyjne mówią zespołom, co kontrolować, gdzie to kontrolować i jak odróżnić jeden rodzaj awarii od drugiego.
Standardy pomagają najbardziej wtedy, gdy zmuszają do jawnego pójścia na kompromisy. Jeśli nie potrafisz określić, czy problem ma charakter semantyczny, syntaktyczny czy pragmatyczny, zazwyczaj nie potrafisz też zaprojektować właściwej kontroli.
Kluczowe wymiary i jak je mierzyć
Model sześciu wymiarów to praktyczny punkt wyjścia, ponieważ daje zespołom wspólny język, a nie dlatego, że obejmuje każdy przypadek skrajny. W środowisku produkcyjnym każdy wymiar wymaga metryki, metody wykrywania i wzorca błędu, który ujawnia się, zanim zauważą go użytkownicy. Celem jest wychwycenie tego rodzaju uszkodzeń, które zmieniają zachowanie systemów downstream. Aby uzyskać szczegółowe omówienie jednego z wymiarów, przydatnym przewodnikiem jest poradnik digna na temat tego, jak mierzyć dokładność danych.
Wymiar | Kluczowe metryki | Metody wykrywania | Typowe rodzaje awarii |
|---|---|---|---|
Dokładność | Odchylenie od źródła prawdy, dryf od wartości referencyjnych | Weryfikacja krzyżowa z autorytatywnymi systemami, audyty próbkowania, porównania dryfu | Wartości nie odpowiadają już rzeczywistości, dane wejściowe modeli tracą aktualność |
Kompletność | Wskaźnik wartości null, brakujące wymagane rekordy, częściowe rekordy | Testy obecności na poziomie pól, uzgadnianie liczby wierszy, walidacja pól wymaganych | Brakujące identyfikatory, puste atrybuty, częściowo zapisane rekordy |
Spójność | Wskaźnik sprzeczności między systemami, liczba niezgodności | Porównania międzysystemowe, uzgadnianie podmiotów, oparte na regułach kontrole sprzeczności | Ten sam podmiot ma różne wartości w różnych miejscach |
Timeliness | Opóźnienie między okresem referencyjnym a dostępnością, wskaźnik opóźnionych dostarczeń | Monitorowanie czasu przybycia, kontrole SLA, szacunki oczekiwanego dostarczenia | Zasoby docierają z opóźnieniem, pulpity nawigacyjne odzwierciedlają niewłaściwy okres |
Compliance | Wskaźnik błędów reguł, wartości spoza zakresu, naruszenia formatu | Wymuszanie reguł biznesowych, ograniczenia schematu, sprawdzanie wyrażeń regularnych i domen | Nieprawidłowe kody, niemożliwe wartości, zniekształcone pola |
Unikalność | Wskaźnik duplikatów, liczba powtarzających się kluczy | Logika deduplikacji, skanowanie kolizji kluczy, dopasowywanie rozmyte dla bliskich duplikatów | Zduplikowani klienci, powtarzające się transakcje, zawyżone sumy |
Co mierzyć w pierwszej kolejności
Dokładność zaczyna się od zaufanego punktu odniesienia. Porównuj wartości z tym punktem odniesienia i obserwuj dryf w czasie. Rekord może przejść pomyślnie walidację schematu i nadal być błędny, dlatego kontrola musi porównywać dane z czymś spoza zbioru danych. Dla zespołów próbujących zdefiniować tę kontrolę, artykuł jak mierzyć dokładność danych jasno przedstawia mechanizmy działania.
Kompletność jest zazwyczaj najłatwiejszym wymiarem do wdrożenia na wczesnym etapie produkcji. Śledź wskaźniki wartości null, brakujące wymagane wiersze i częściowe rekordy według pól i źródeł. Ten rodzaj awarii jest prosty: potok przesyła wiersze, ale jeden ważny atrybut nigdy nie zostaje uzupełniony, co później niszczy analitykę i raportowanie.
Spójność wymaga myślenia międzysystemowego. Dwa systemy mogą same w sobie wyglądać dobrze, a mimo to różnić się w kwestii tego samego podmiotu. Taka sprzeczność utrudnia uzgadnianie danych, zwłaszcza gdy zespoły downstream zakładają, że istnieje tylko jedno źródło prawdy.
W którym miejscu testy zawodzą w rzeczywistych potokach danych
W przypadku Timeliness chodzi o opóźnienie, a nie o ogólnikową etykietę świeżości. Wytyczna rządu stanu Wiktoria definiuje to jako opóźnienie między okresem referencyjnym a publikacją informacji, co czyni z tego konkretną miarę operacyjną, a nie tylko hasło reklamowe dotyczące świeżości danych. Ramy rządu Wielkiej Brytanii również traktują terminowość jako dane, które odzwierciedlają okres, który reprezentują, i pozostają aktualne w ramach oficjalnego modelu.
W wymiarze Compliance kryją się reguły biznesowe. Sprawdzaj dozwolone zakresy, listy dokładnych wartości, formaty i progi, ponieważ nieprawidłowe rekordy często wyglądają nieszkodliwie, dopóki proces downstream ich nie odrzuci lub, co gorsza, nie zaakceptuje.
Unikalność dotyczy kontroli duplikacji. Oznacza brak duplikacji w rekordach dotyczących tego samego podmiotu, jak określa to brytyjski model rządowy w tym samym oficjalnym modelu. W ujęciu operacyjnym zduplikowane rekordy sztucznie zwiększają wolumeny, podwójnie zliczają klientów lub zmieniają złączenie downstream w bezużyteczne dane.
Znaczenie mają również integralność i pochodzenie (provenance). Integralność chroni relacje między rekordami i tabelami. Pochodzenie pokazuje, skąd wzięła się wartość i jak się zmieniała. Rzadko są one priorytetem podczas pierwszego przeglądu jakości, ale często decydują o tym, czy naprawa zostanie wdrożona szybko, czy też zamieni się w dochodzenie śledcze.
Dlaczego kontekst decyduje o tym, które wymiary są najważniejsze
Nie każde obciążenie wymaga takiej samej równowagi wymiarów. Zespół finansowy, zespół kliniczny i zespół e-commerce mogą korzystać z tej samej hurtowni danych, a mimo to zwracać uwagę na zupełnie inne rodzaje awarii. Błędem jest zakładanie, że każdy wymiar zasługuje na taką samą wagę w każdym miejscu.
W usługach finansowych dokładność i spójność zazwyczaj wysuwają się na pierwszy plan, ponieważ sprawozdawczość regulacyjna, obliczenia ryzyka i uzgodnienia zależą od zgodności wartości w różnych systemach. Rekord, który jest kompletny, ale sprzeczny, nadal stanowi problem. W opiece zdrowotnej Timeliness może mieć w danej chwili większe znaczenie, ponieważ opóźniony strumień danych może być mniej użyteczny niż ten nieznacznie niedoskonały, zwłaszcza gdy decyzje operacyjne zależą od najnowszych dostępnych statusów.
E-commerce często priorytetowo traktuje kompletność i Compliance. Katalog produktów z brakującymi atrybutami lub nieprawidłowymi kategoriami może popsuć wyszukiwanie, filtry i logikę realizacji zamówień, nawet jeśli większość rekordów wygląda poprawnie. Systemy IoT i sterowane zdarzeniami zazwyczaj opierają się głównie na terminowości i dokładności, ponieważ nieświeża telemetria może sprawić, że system decyzyjny czasu rzeczywistego zareaguje zbyt późno lub na niewłaściwy stan.
Wybieraj wymiary na podstawie przypadku użycia, a nie przyzwyczajenia
Niedawne badanie wskazuje, że wymiary jakości danych zależą od kontekstu i powinny być przekładane na praktyki, a nie traktowane jako statyczna lista kontrolna etykiet. Pokrywa się to z tym, z czym zespoły stykają się w środowisku produkcyjnym. Ten sam zbiór danych może być „wystarczająco dobry” do miesięcznego raportowania finansowego i niewystarczający dla operacyjnego pulpitu nawigacyjnego aktualizowanego tego samego dnia.
Pytanie operacyjne zawsze brzmi: co popsuje się najpierw, jeśli ten wymiar ulegnie pogorszeniu? Jeśli brakujące pole wpływa tylko na mało istotne wzbogacenie danych, może to poczekać. Jeśli nieświeże dane wpływają na decyzję kliniczną lub handlową, trafia to na początek kolejki.
Wgląd operacyjny: nadaj priorytet temu wymiarowi, który wpływa na decyzję, a nie temu, który jest najłatwiejszy do zmierzenia.
Takie podejście pomaga zespołom uniknąć typowej pułapki polegającej na nadmiernej optymalizacji obszaru o niskim ryzyku przy jednoczesnym pomijaniu obszaru o wysokim ryzyku. Wyjaśnia to również, dlaczego statyczne karty wyników zawodzą w środowiskach regulowanych. Karta wyników może wyglądać na czystą, podczas gdy rzeczywistemu przypadkowi użycia nadal brakuje świeżości, kontroli sprzeczności lub reguł walidacji, których potrzebuje.
Praktycznym krokiem jest przypisanie każdego zbioru danych do jego rzeczywistych odbiorców, a następnie zapisanie, od których wymiarów ci odbiorcy zależą. Gdy to stanie się jasne, zaprojektowanie monitoringu będzie znacznie łatwiejsze.
Operacjonalizacja wymiarów dzięki ciągłemu monitorowaniu
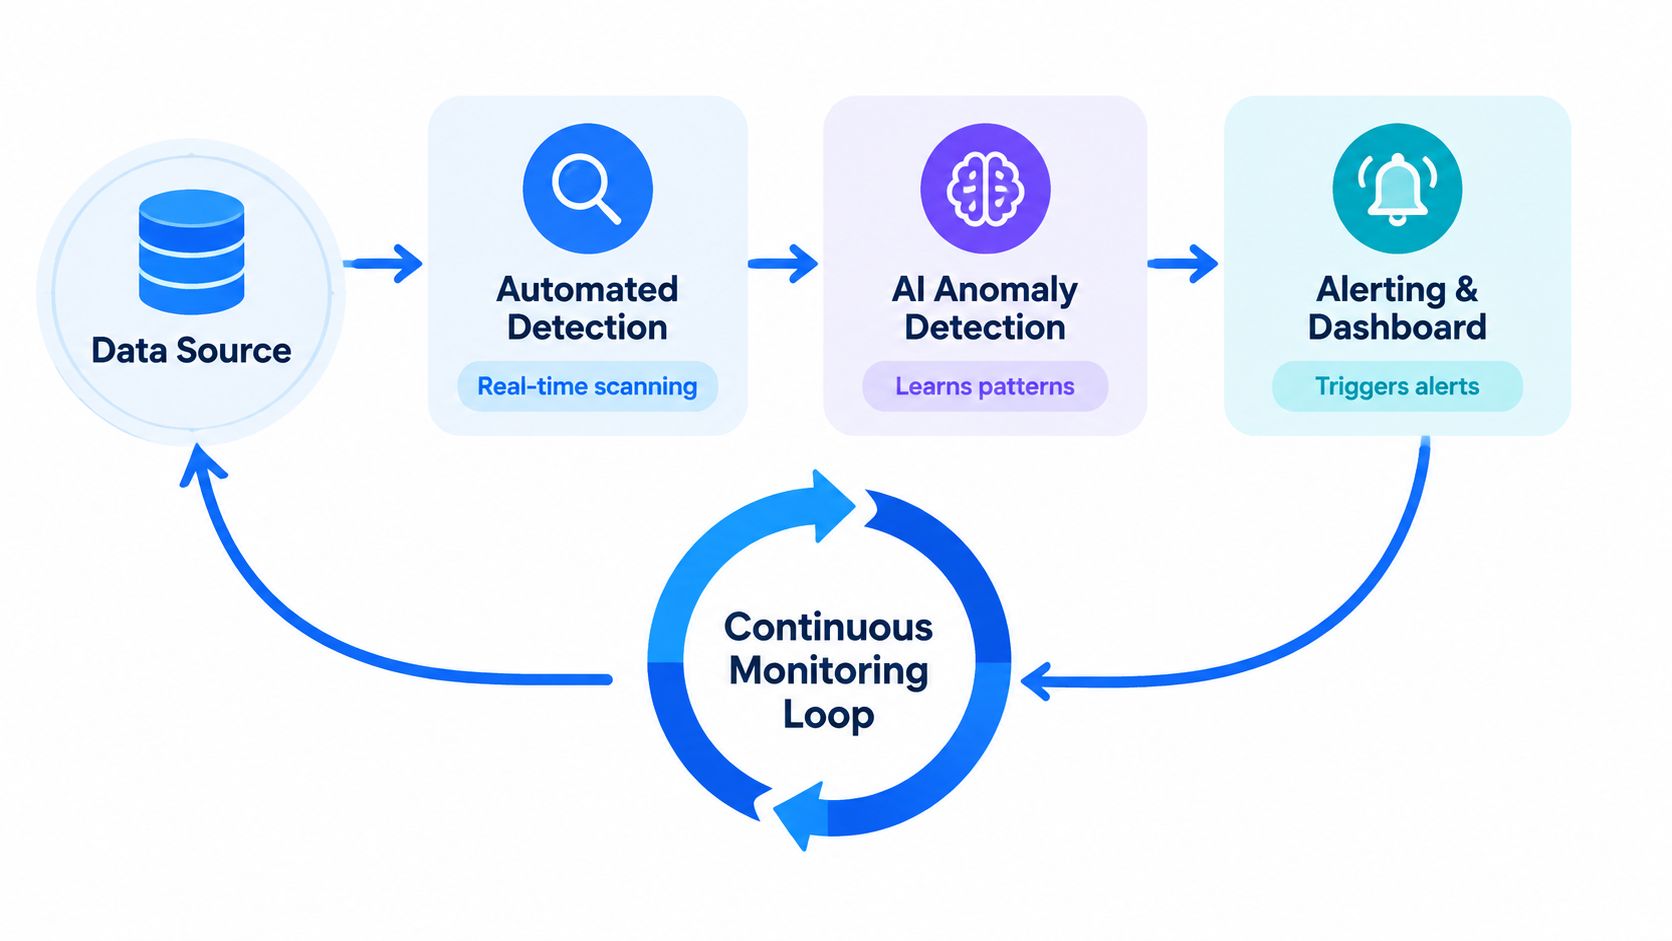
Ciągłe monitorowanie to miejsce, w którym teoria staje się użyteczna. Zamiast czekać na cotygodniowy przegląd, nowoczesne platformy obserwują same dane, uczą się normalnych wzorców i sygnalizują odchylenia natychmiast po ich pojawieniu się. Ma to znaczenie, ponieważ większość błędów jakościowych nie pojawia się jako oczywiste awarie – przejawiają się one jako subtelny dryf.
Modułowa konfiguracja digna odzwierciedla tę rzeczywistość. Data Anomalies obejmuje oparte na sztucznej inteligencji uczenie się linii bazowej dla przesunięć dokładności i spójności, Timeliness śledzi oczekiwane wzorce przybycia i opóźnienia w dostarczaniu, Data Validation wymusza oparte na regułach kontrole poprawności i kompletności, a Schema Tracker obserwuje zmiany strukturalne, które mogą zaszkodzić odbiorcom downstream. Kontrole są uruchamiane w bazie danych, dzięki czemu dane pozostają na miejscu, podczas gdy platforma oblicza metryki i wykrywa problemy w środowisku klienta.
Jak ciągłe sprawdzanie działa w praktyce
Uczenie się linii bazowej jest przydatne, ponieważ nie każda anomalia jest prostym naruszeniem progu. Tabela może zawsze wykazywać skok w pierwszy dzień roboczy miesiąca, więc stała reguła generowałaby niepotrzebny szum. Poznanie linii bazowej pozwala systemowi zobaczyć, jak wygląda norma dla danego zbioru danych, a następnie zasygnalizować odchylenie, gdy wzorzec ulegnie zmianie.
Monitorowanie terminowości powinno robić coś więcej niż tylko oznaczać spóźnione zasilenia po fakcie. Musi uczyć się oczekiwanego rytmu, porównywać go z rzeczywistymi przybyciami oraz identyfikować brakujące zasilenia lub przedwczesne dostawy, zanim procesy downstream zużyją nieświeże dane. Na tym polega różnica między wykryciem problemu podczas analizy postmortem a wychwyceniem go w momencie, gdy wciąż jest czas na zmianę trasy potoku danych.
Śledzenie schematów eliminuje kolejną typową lukę. Zmiany strukturalne, dodane lub usunięte kolumny oraz modyfikacje typów mogą popsuć procesy u odbiorców, nawet jeśli liczba wierszy wygląda prawidłowo. Odbiorcy nie obchodzi, że tabela źródłowa nadal istnieje, jeśli zmienił się jej kształt.
Dlaczego architektura ma znaczenie
Ręczne kontrole nie skalują się dobrze, gdy zespoły zarządzają wieloma zbiorami danych i wieloma regułami. Ciągła automatyzacja zmniejsza obciążenie związane z ręcznym skanowaniem wszystkiego i pomaga odróżnić rzeczywiste anomalie od rutynowych zmian. Zmniejsza to zmęczenie alertami, które zazwyczaj jest główną przyczyną niepowodzenia programów monitorowania.
Platforma musi również wspierać naprawianie błędów, a nie tylko ich wykrywanie. Inżynierowie potrzebują incydentów, trendów i wystarczającego kontekstu, aby zdecydować, czy naprawić problem u źródła, zmodyfikować regułę, czy zaakceptować nową linię bazową. Bez tej pętli zwrotnej monitorowanie staje się strumieniem alarmów bez możliwości podjęcia działań.
Ramy priorytetyzacji i lista kontrolna wdrożenia
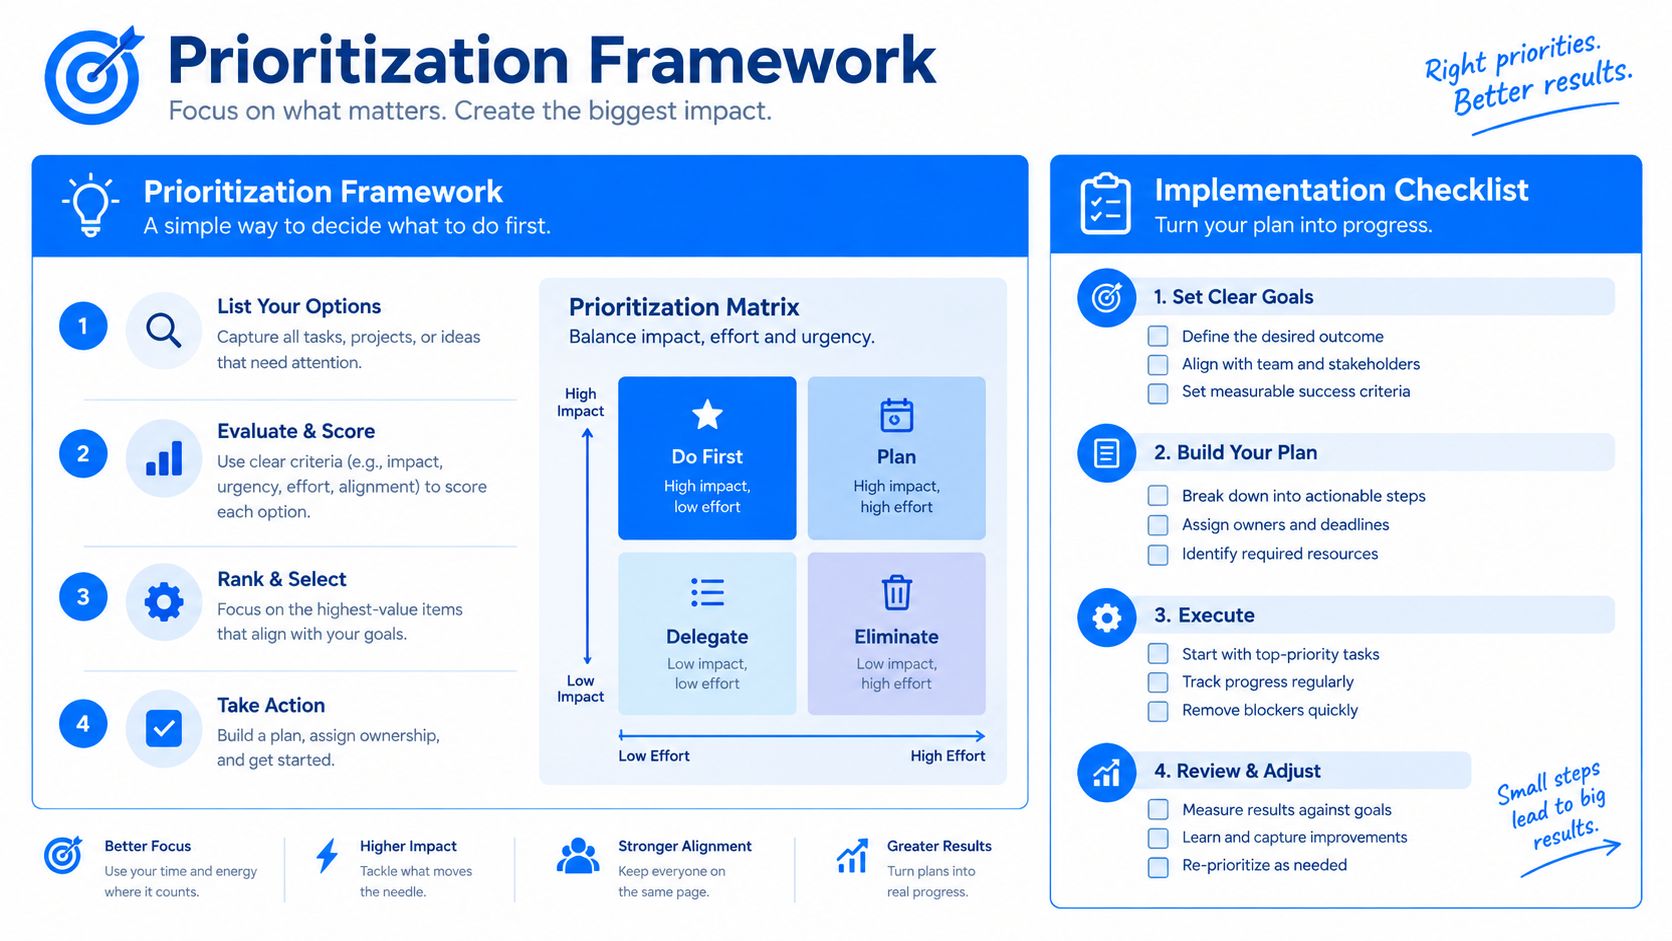
Zacznij od zbiorów danych, które mogą zaszkodzić Ci najbardziej. Zazwyczaj oznacza to zasilenia finansowe, operacyjne tabele faktów, dane podstawowe klientów, regulowane zestawy raportów lub wszystko, co zasila pulpity nawigacyjne kadry zarządzającej. Zbiór danych o niskiej wartości może poczekać. Krytyczny – nie.
Etapowe wdrożenie, które działa
Faza 1: uzupełnienie oczywistych luk. Terminowość i kompletność to zazwyczaj najszybsze sukcesy, ponieważ są łatwiejsze do zdefiniowania, sprawdzenia i wyjaśnienia interesariuszom. Jeśli zasilenie dociera z opóźnieniem lub brakuje wymaganego pola, wiele zespołów potrafi szybko rozpoznać tego konsekwencje.
Faza 2: dodanie kontroli sprzeczności i reguł. Gdy podstawy są pod kontrolą, przejdź do spójności i poprawności. To właśnie tutaj zaczynają pojawiać się sprzeczności międzysystemowe, nieprawidłowe kody i złe kombinacje reguł biznesowych.
Faza 3: zaostrzenie dokładności i unikalności. Te obszary wymagają lepszych linii bazowych, lepszych danych referencyjnych i bardziej dojrzałych procesów naprawczych. Trudniej je opanować za pomocą pojedynczej reguły, ale mają ogromne znaczenie, gdy wolumen i wpływ na biznes są wysokie.
Użyteczna lista kontrolna dla każdej fazy jest prosta:
Jasno zdefiniuj metrykę. Jeśli zespół nie potrafi wyjaśnić, co się zmieniło, metryka nie jest gotowa.
Ustal linię bazową. Bez zdefiniowania normalnego zachowania każdy alert wygląda podejrzanie.
Ustaw progi alertów. Progi powinny odzwierciedlać ryzyko biznesowe, a nie tylko techniczną poprawność.
Udokumentuj ścieżkę naprawczą. Ktoś musi wiedzieć, kto naprawia błąd, gdzie i jak szybko.
Modułowa platforma pomaga, ponieważ nie musisz instalować wszystkich funkcji pierwszego dnia. Możesz zacząć od jednej tabeli, jednego modułu i jednej klasy problemów, a następnie rozszerzać zakres w miarę wzrostu zaufania organizacji i doprecyzowywania celów. Takie podejście jest o wiele bardziej zrównoważone niż próba monitorowania każdego wymiaru wszędzie od samego początku.
Argumenty za ciągłym monitorowaniem zamiast okresowych kontroli
Okresowe kontrole miały sens, gdy potoki danych były wolniejsze, a liczba krytycznych zbiorów danych była możliwa do opanowania. Przestają się sprawdzać, gdy dane przepływają w sposób ciągły, odbiorcy zależą od świeżych zasileń, a koszt późnego wykrycia błędu jest wysoki. Zanim zaplanowany raport ujawni problem, szkody są często już zakorzenione w podjętych decyzjach.
Ciągłe monitorowanie zmienia ten rytm. Wykrywa dryf w trakcie przesyłania danych, a nie po tym, jak zdążyły one już wpłynąć na analizę lub wywołać działanie. Jest to szczególnie ważne, ponieważ problemy z jakością często zaczynają się od drobiazgów, a następnie rozprzestrzeniają się przez złączenia, agregaty, modele i pulpity nawigacyjne.
W tym miejscu znaczenie ma również skala. Zespoły zarządzające wieloma regułami, wieloma źródłami i wieloma odbiorcami downstream nie są w stanie nadążyć z ręczną kontrolą. Automatyzacja przejmuje powtarzalne czynności, a oparte na sztucznej inteligencji uczenie się linii bazowej pomaga ograniczyć szum, rozumiejąc, jak wygląda norma dla każdego zbioru danych, zamiast traktować każde wahanie jako awarię.
Kolejną zaletą jest czas reakcji. Gdy opóźnienie, sprzeczność lub zmiana schematu zostaną wykryte wcześnie, zespół może naprawić źródło, wstrzymać zadanie downstream lub zmienić trasę procesu, zanim użytkownicy podejmą działania na podstawie błędnych wyników. Jest to znacznie trudniejsze do wykonania, gdy pierwszy alert pojawia się dopiero podczas cotygodniowego przeglądu.
W ciągłym monitorowaniu nie chodzi o zastąpienie ludzkiej oceny. Chodzi o dostarczenie inżynierom odpowiedniego sygnału we właściwym czasie, aby mogli podjąć działania, zanim firma odczuje skutki błędu.
Jeśli budujesz lub usprawniasz program jakości danych, zacznij od zbiorów danych, które niosą ze sobą największe ryzyko biznesowe, i monitoruj wymiary, które wpływają na podejmowane decyzje. digna zapewnia zespołom modułowe monitorowanie anomalii, terminowości, walidacji i zmian schematu w ich własnym środowisku, dzięki czemu kontrole pozostają blisko danych, a ścieżka naprawcza jest praktyczna. Odwiedź digna, aby zobaczyć, jak to podejście pasuje do Twojego stosu technologicznego i od czego zacząć w pierwszej kolejności.
Najczęściej zadawane pytania
Jakie są główne wymiary jakości danych?
Poprawność, kompletność, spójność, Timeliness, poprawność formalna i unikalność. Każdy ma własne wskaźniki i metody wykrywania: poprawność sprawdza się względem zaufanego źródła odniesienia, kompletność przez udział wartości pustych i uzgadnianie liczby wierszy, a spójność przez liczbę sprzeczności między systemami.
Skąd wzięły się modele wymiarów?
Badania z lat dziewięćdziesiątych pogrupowały 15 wymiarów w kategorie wewnętrzną, kontekstową, reprezentacyjną i dostępnościową. ISO/IEC 25012 zachowuje 15 cech wysokiego poziomu podzielonych na grupy nieodłączne i zależne od systemu, a ISO 8000-8 zawęża pracę do jakości syntaktycznej, semantycznej i pragmatycznej.
Dlaczego pojedyncza ocena jakości to problem?
Bo ukrywa, jaka awaria faktycznie wystąpiła. Jeśli monitoring nie potrafi powiedzieć, czy chodzi o świeżość, sprzeczność, duplikację czy braki, nie obserwuje tego, co zawiodło, a zespoły odkrywają to zwykle dopiero po błędnej decyzji.
Które wymiary zespół powinien traktować priorytetowo?
To zależy od odbiorcy, a nie od przyzwyczajenia. Usługi finansowe zwykle stawiają na pierwszym miejscu poprawność i spójność, bo sprawozdawczość regulacyjna i uzgodnienia wymagają zgodnych wartości między systemami, a e-commerce często priorytetyzuje kompletność i poprawność formalną. Zapytaj, co pęknie pierwsze, gdy ten wymiar się pogorszy.
Jak wdrażać monitoring wymiarów?
W trzech fazach: zacznij od oczywistych luk, dodaj kontrole sprzeczności i reguł, a następnie dopracuj poprawność i unikalność. W każdej fazie jasno zdefiniuj wskaźnik, ustal linię bazową, wyznacz progi alertów i udokumentuj ścieżkę naprawy, zanim przejdziesz dalej.



