Wykrywanie anomalii w danych czujników: Praktyczny przewodnik
|
8
min. czyt.

Pulpit drgań zmienia kolor na czerwony podczas popołudniowej zmiany. Operator sprawdza maszynę i nie znajduje niczego oczywistego. Alarm pochodził z kanału temperatury reagującego na cieplejsze pomieszczenie, podczas gdy oddzielny kanał drgań dryfował w kierunku awarii, nie przekraczając swojego stałego limitu. Zanim ktoś powiąże te sygnały, detektor albo zbyt często wszczynał fałszywy alarm, albo zbyt długo milczał.
Taka jest rzeczywistość wdrożeniowa detekcji anomalii w danych z czujników. Przemysłowe strumienie danych są szumne, multimodalne, zależne od czasu i stale się zmieniają. Detektor, który działa dobrze na czystym teście referencyjnym, może zawieść w warunkach produkcyjnych, gdy czujniki dryfują, znaczniki czasu się rozjeżdżają, kanały zmieniają się wspólnie lub zakład zmienia reżim pracy. Praktyczne pytanie nie brzmi wyłącznie, który model ma najwyższy wynik. Chodzi o to, czy system potrafi zidentyfikować istotne odchylenia wystarczająco szybko, aby operator lub inżynier mógł podjąć działania.
Spis treści
Dlaczego detekcja anomalii w czujnikach jest trudniejsza, niż się wydaje
Ograniczenia produkcyjne, które mają znaczenie
Inżynieria cech dla strumieni danych z czujników
Wyrównaj czas przed obliczeniem cech
Dopasuj cechy do wzorca awarii
Praktyczne menu cech
Wybór właściwego modelu detekcji
Statystyczne punkty odniesienia
Klasyczne uczenie maszynowe
Głębokie uczenie
Obsługa sezonowości, dryfu i skorelowanych kanałów
Ostrożnie przebuduj punkt odniesienia
Uwzględnij powiązane kanały
Uczciwa ocena skuteczności detekcji
Używaj oceny uwzględniającej zdarzenia
Architektury wdrożeniowe do monitorowania w czasie rzeczywistym
Dopasuj wzorzec do decyzji
Nie pomijaj oceniania wewnątrz bazy danych
Pewne wejście na produkcję
Uruchom listę kontrolną przed wdrożeniem
Jasno określ ścieżkę eskalacji
Dlaczego detekcja anomalii w czujnikach jest trudniejsza, niż się wydaje
Czujnik drgań turbiny może pozostać niemal płaski przez wiele godzin po poluzowaniu uchwytu montażowego. Stan mechaniczny uległ zmianie, jednak sygnał może dryfować powoli i pozostawać poniżej statycznego progu. Reguła generująca alert powyżej określonej wartości widzi normalną pracę. Inżynier analizujący trend, kontekst obrotowy i powiązane kanały może dostrzec rozwijającą się usterkę.
Ta rozbieżność definiuje problem produkcyjny. Systemy przemysłowe łączą drgania, temperaturę, ciśnienie, prąd, sygnały sterujące, obrazy i inne modalności, z których każda charakteryzuje się innym zachowaniem próbkowania i innymi trybami awarii. Brakujące próbki powodują luki, szumne odczyty generują skoki, a skorelowane kanały mogą sprawić, że uzasadniona zmiana operacyjna będzie wyglądać na anomalię. Detektor musi nauczyć się normalnego zachowania dla konkretnego zasobu, stanu roboczego i okresu, zamiast zapamiętywać jeden globalny zakres.
Praktyczna zasada: Traktuj „normę” jako wyuczony kontekst operacyjny, a nie stałą wartość liczbową.
Badania naukowe w tej dziedzinie odzwierciedlają ten sam postęp. Wczesne metody detekcji anomalii opierały się głównie na statystyce i przetwarzaniu sygnałów. Późniejsze prace rozszerzyły ten zakres o uczenie maszynowe i głębokie uczenie. Przegląd inteligentnej detekcji anomalii w systemach czujnikowych z 2020 roku opisuje długą historię metod statystycznych i przetwarzania sygnałów oraz odróżnia tradycyjne techniki od podejść opartych na danych. Oddzielny przegląd detekcji anomalii w maszynach przemysłowych ocenił 84 badania z lat 2016-2023, ilustrując szybki wzrost nowoczesnych badań przemysłowych.
Ograniczenia produkcyjne, które mają znaczenie
Rurociąg detekcji musi poradzić sobie z kilkoma ograniczeniami, zanim wygeneruje użyteczny wynik:
Zmiany reżimu pracy: Obciążenie, prędkość, temperatura otoczenia, receptury produkcyjne i wzorce zmianowe modyfikują oczekiwany sygnał.
Dryf czujnika: Zmiany kalibracji i starzenie się mogą przesunąć linię bazową, podczas gdy maszyna pozostaje sprawna.
Skorelowane kanały: Temperatura, drgania i prąd mogą reagować na ten sam stan mechaniczny lub elektryczny.
Nierównomierne próbkowanie: Jeden kanał może dostarczać dane szybko, podczas gdy inny raportuje sporadycznie, więc proste łączenie wiersz po wierszu może zniekształcić relacje.
Opóźnione etykiety: Zespoły utrzymania ruchu rzadko rejestrują dokładny moment rozpoczęcia anomalii, co pozostawia okna szkoleniowe i ewaluacyjne niepewnymi.
Opóźnienie i lokalność: Decyzja dotycząca bezpieczeństwa może wymagać podjęcia blisko maszyny, podczas gdy głębsza analiza może być uruchamiana na centralnej platformie.
Warunki te wyjaśniają, dlaczego dokładność testów referencyjnych na czystych zbiorach danych często przekłada się na słabe wyniki w produkcji. Testy referencyjne zazwyczaj oferują uporządkowane znaczniki czasu, stabilne rozkłady i jednoznaczne etykiety. Fabryki dostarczają wypadanie sygnałów z czujników, interwencje konserwacyjne, zmieniające się obciążenia robocze i anomalie, które rozwijają się w czasie. Model może osiągać dobre wyniki, generując jednocześnie alerty zbyt późno, zbyt często lub bez wystarczającego kontekstu, by operator mógł podjąć działanie.
Dla zespołów odpowiedzialnych za otaczające potoki danych, Data Observability dla niezawodności operacyjnej dostarcza narzędzi kontroli pozwalających odróżnić anomalię maszyny od opóźnionego, brakującego, uszkodzonego lub strukturalnie zmienionego strumienia danych. Detektor nie może rzetelnie wnioskować o sygnale, który nigdy nie dotarł lub dotarł w niewłaściwym formacie. Monitorowanie operacyjne musi zatem obejmować zarówno sprzęt, jak i ścieżkę danych, która go reprezentuje.
Inżynieria cech dla strumieni danych z czujników
Surowe wartości z czujników są słabymi danymi wejściowymi dla modelu bez kontekstu operacyjnego. Temperatura wynosząca 70 stopni może być normalna przy jednym obciążeniu i podejrzana przy innym. Odczyt drgań, który sam w sobie wygląda nieszkodliwie, może mieć znaczenie po długotrwałym wzroście. Użyteczne cechy wychwytują lokalny kontekst, zmiany w czasie oraz relacje między kanałami.
Wyrównaj czas przed obliczeniem cech
Wybierz kadencję analizy pasującą do budżetu opóźnienia detektora, a następnie celowo przepróbkuj każdy kanał. Nie uzupełniaj w przód wysokoczęstotliwościowego strumienia drgań podczas długiej awarii ani nie interpoluj danych w okresie, gdy sprzęt był offline. Zachowaj wskaźnik imputacji i braków danych, aby detektor mógł odróżnić zmierzoną wartość od rekonstrukcji.
Wyrównanie zależy również od jakości zegara. Niezsynchronizowanie zegarów między urządzeniami lub bramami może powodować fałszywe relacje opóźnienia, gdy jeden kanał tłumaczy drugi. Przed połączeniem strumieni sprawdź kolejność znaczników czasu, duplikaty, luki w próbkowaniu i spójność jednostek. Dobrze zaprojektowana cecha zbudowana na nieprawidłowo wyrównanych sygnałach nadal będzie błędna.
W przypadku urządzeń multimodalnych zachowaj, jeśli to możliwe, oryginalne znaczniki czasu kanałów lub flagi jakości. Wspólna kadencja ułatwia obliczanie cech, ale może maskować krótkie luki i sprawiać, że wolny kanał wydaje się bardziej precyzyjny niż w rzeczywistości. Właściwy wybór zależy od trybu awarii i okna czasowego na podjęcie działania, a nie od samego wyglądu schludnej tabeli.
Dopasuj cechy do wzorca awarii
Kroczący wskaźnik z-score mierzy, jak daleko obecny odczyt odbiega od niedawnej średniej w stosunku do ostatnich wahań. Krótkie okno, na przykład pięciominutowe, może ujawnić nagły skok amplitudy. Dłuższe okno, na przykład 30-minutowe, może ujawnić wolniejszy dryf, który krótkie okno mogłoby potraktować jako normę. Ta znana metoda oblicza średnią i odchylenie standardowe w ruchomym oknie, a następnie flaguje wartości wykraczające poza wybrany próg. Jedna z referencyjnych implementacji używa progu o wartości 3, co odpowiada w przybliżeniu 3 na 1000 punktów przy rozkładzie normalnym, jak opisano w przykładzie detekcji anomalii z-score firmy Ericsson.
Różnicowanie pozwala odpowiedzieć na inne pytanie. Różnice pierwszego rzędu ujawniają skoki między sąsiednimi obserwacjami. Różnice drugiego rzędu ujawniają zmiany w tempie zmian, pomagając zidentyfikować przyspieszający dryf lub rodzącą się niestabilność. Obie operacje mogą wzmacniać szum, dlatego należy najpierw wygładzić lub zagregować wysoce zmienne sygnały. Takie wstępne przetwarzanie dodaje opóźnienie, które musi mieścić się w budżecie monitorowania.
Cechy opóźnione o jeden do dziesięciu kroków dają klasycznym modelom skondensowany widok niedawnej historii. Sprawdzają się w procesach, w których kolejny odczyt zależy od niedawnych wartości, ale zwiększają wymiarowość i stają się nadmiarowe przy gęstym próbkowaniu. Kroczące percentyle opisują lokalny rozrzut bez zakładania symetrycznego rozkładu, co czyni je użytecznymi przy wartościach odstających i asymetrycznym zachowaniu operacyjnym.
Praktyczne menu cech
Technika | Co wychwytuje | Najlepsze zastosowanie |
|---|---|---|
Kroczący z-score | Lokalne odchylenie od niedawnej średniej i zmienności | Dryf amplitudy i krótkotrwałe odchyłki |
Różnica pierwszego rzędu | Zmiana między sąsiednimi odczytami | Nagłe skoki i przerwy w ciągłości |
Różnica drugiego rzędu | Zmiana tempa zmian | Przyspieszające wzrosty i rodząca się niestabilność |
Cechy opóźnione (lag) | Niedawny kontekst autoregresyjny | Krótkie zależności czasowe w klasycznych modelach |
Kroczące percentyle | Lokalne granice rozkładu | Szumne sygnały i zmienność niegaussowska |
Reszty międzykanałowe | Odchylenie po uwzględnieniu powiązanego sygnału | Powiązane zachowania temperatury, prądu, prędkości i drgań |
Reszty międzykanałowe często wnoszą większą wartość niż kolejna transformacja tego samego sygnału. Oszacuj oczekiwane zachowanie jednego kanału na podstawie powiązanego z nim innego kanału, a następnie monitoruj resztę (residual). Weryfikuj tę relację w miarę zmian obciążeń i kalibracji, ponieważ korelacja może dryfować, nawet gdy oba czujniki pozostają sprawne.
Aby uzyskać dokładniejsze informacje na temat budowania cech, zapoznaj się ze wskazówkami dotyczącymi detekcji anomalii w szeregach czasowych z czujników oraz wiedzą o posiadanych zasobach. Wybór cech ma większe znaczenie niż ich ilość. Każda transformacja powinna odpowiadać na konkretne pytanie monitoringu, być łatwa do prześledzenia w alercie i nie zużywać więcej czasu ani mocy obliczeniowej, niż pozwala na to decyzja operacyjna.
Wybór właściwego modelu detekcji
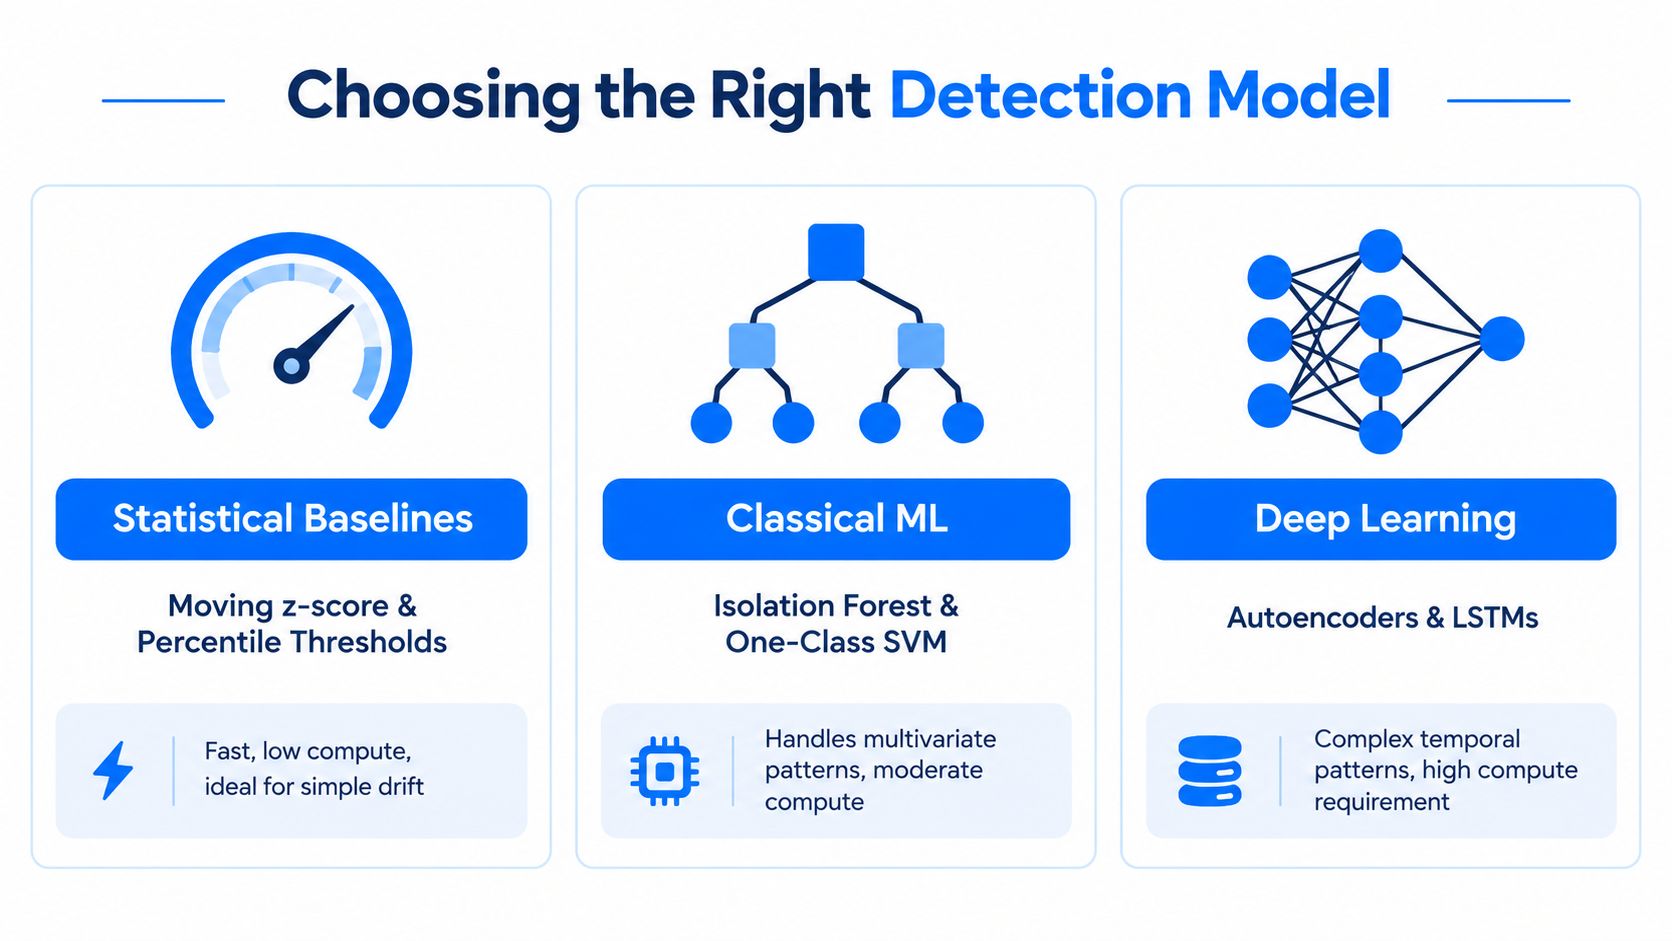
Żaden pojedynczy detektor nie wygrywa we wszystkich scenariuszach pracy czujników. Metody statystyczne są tanie i wyjaśnialne, klasyczne uczenie maszynowe radzi sobie ze zwartymi przestrzeniami wielowymiarowymi, a głębokie uczenie potrafi modelować skomplikowane zależności czasowe. Właściwy projekt produkcyjny zazwyczaj przydziela każdemu z tych podejść określone zadanie, zamiast zmuszać jeden model do przetwarzania każdego alertu.
Statystyczne punkty odniesienia
Ruchome z-score, kroczące percentyle i progi resztowe stanowią doskonałe detektory pierwszego kontaktu. Są szybkie, łatwe w interpretacji i odpowiednie do wykrywania prostego dryfu lub nagłych zmian. Ich słabością jest brak kontekstu. Stały próg zawodzi, gdy zmienia się reżim pracy, a krótkie ruchome okno może potraktować utrzymującą się usterkę jako nową normę.
Adaptacyjne linie bazowe mogą wyeliminować część ręcznej konfiguracji. Jedna z udokumentowanych implementacji uczy się linii bazowej z odczytów z ostatnich siedmiu dni, aktualizuje ją raz na godzinę i wymaga co najmniej 100 odczytów przed ustaleniem linii bazowej, jak opisano w dokumentacji linii bazowej anomalii czujników. Te mechanizmy to przydatne wzorce, ale wciąż wymagają zabezpieczeń przed uczeniem się na danych z okresu, w którym występowały zakłócenia.
Klasyczne uczenie maszynowe
Isolation Forest i jednoklasowy SVM są przydatne, gdy anomalie zajmują nietypowe obszary w wielowymiarowej przestrzeni cech. Mogą łączyć kroczące statystyki, opóźnienia, reszty i kontekst operacyjny bez konieczności posiadania dużego, etykietowanego archiwum awarii. Często są łatwiejsze we wdrożeniu niż modele sekwencyjne, ale ich skuteczność może spaść, gdy rozkłady cech się przesuną lub gdy rzadkie usterki będą słabo reprezentowane.
Wymagana jest tu duża ostrożność. W jednym z przemysłowych testów referencyjnych anomalii algorytm Isolation Forest (z przeskalowaniem lub bez) osiągnął średni wynik F1 na poziomie zaledwie 0,171, podczas gdy LOF uzyskał średni wynik F1 równy 0,100, zgodnie z zaraportowanymi wynikami przemysłowej detekcji anomalii. Wyniki te nie oznaczają, że algorytmy te są bezużyteczne. Pokazują raczej, dlaczego nienadzorowana linia bazowa musi zdobyć zaufanie na docelowym sprzęcie, zamiast być przyjmowana na wiarę z podręcznikowych przykładów.
Głębokie uczenie
Autoenkodery LSTM oraz detektory oparte na transformerach potrafią reprezentować długie zależności czasowe i relacje między kanałami. Lepiej sprawdzają się, gdy sygnatura usterki zależy od sekwencji, a nie od pojedynczego punktu, ale wymagają większych zasobów obliczeniowych, starannego projektowania okien czasowych oraz wiarygodnych danych z okresów poprawnej pracy.
Wyniki wdrożeń pokazują zarówno potencjał, jak i pułapki. Autoenkoder LSTM połączony z Isolation Forest osiągnął 95,7% dokładności oraz wynik F1 równy 0,93 w jednej z ocen anomalii czujników, jak opisano w badaniu identyfikacji anomalii w czujnikach. Inne badanie nad autoenkoderem w przemysłowych systemach sterowania wykazało precyzję (precision) na poziomie 0,993 i dokładność (accuracy) 96%, ale pełność (recall) wyniosła tylko 0,673, a F1 wyniosło 0,771, co udokumentowano w badaniu autoenkodera dla przemysłowych systemów sterowania. Wysoka precyzja może współistnieć ze zbyt dużą liczbą pominiętych usterek.
Zazwyczaj bardziej efektywna jest architektura wielopoziomowa. Pozwól regułom statystycznym obsługiwać oczywiste odchylenia, używaj klasycznych modeli dla reszt wielowymiarowych, a niejednoznaczne lub złożone czasowo przypadki wysyłaj do bardziej zaawansowanego modelu. W kwestii szczegółów implementacji procesów anomalii opartych na języku Python, warto zestawić praktyki detekcji anomalii danych w Pythonie z dokumentacją konkretnego modelu.
Obsługa sezonowości, dryfu i skorelowanych kanałów
Linia produkcyjna może pracować na różne zmiany, nagrzewać się w ciągu dnia i wykazywać zużycie łożysk przy jednoczesnych zmianach profilu obciążenia. Stały próg potraktuje każdą taką zmianę jako usterkę. Detektor musi odróżnić oczekiwane zmiany od dowodów na to, że proces lub relacja między czujnikami uległa zmianie.
Ostrożnie przebuduj punkt odniesienia
Kroczący z-score może zneutralizować dzienny cykl pracy, zachowując jednocześnie odchylenia od niedawnego wzorca. Tworzy to jednak martwy punkt: usterka rozwijająca się stopniowo w czasie trwania okna może stać się częścią linii bazowej. Dobieraj okno na podstawie cyklu procesu i czasu reakcji na alerty, a nie na podstawie domyślnych wartości.
Dekompozycja STL oddziela trend, sezonowość i zmienność resztową, a następnie ocenia resztę zamiast surowej wartości. Używaj jej, gdy kanał wykazuje powtarzalny wzorzec. Progi percentylowe opierają się na mniejszej liczbie założeń, ponownie obliczając lokalne granice z ostatnich obserwacji, choć wciąż wymagają ochrony przed zanieczyszczeniem okresów treningowych.
Jeden z projektów adaptacyjnego progu ponownie oblicza linię bazową codziennie na podstawie ostatnich siedmiu dni, wykorzystuje dane z dokładnością minutową do oszacowania 99. percentyla i dodaje składnik zmienności oparty na rozstępie międzyćwiartkowym między 25. a 75. percentylem, zgodnie z metodą auto-adaptacyjnego progu Dynatrace. Ta implementacja ilustruje szerszą zasadę: niedawne zachowanie może definiować oczekiwane zachowanie tylko wtedy, gdy okresy nienormalne zostaną wykluczone lub otrzymają mniejszą wagę.
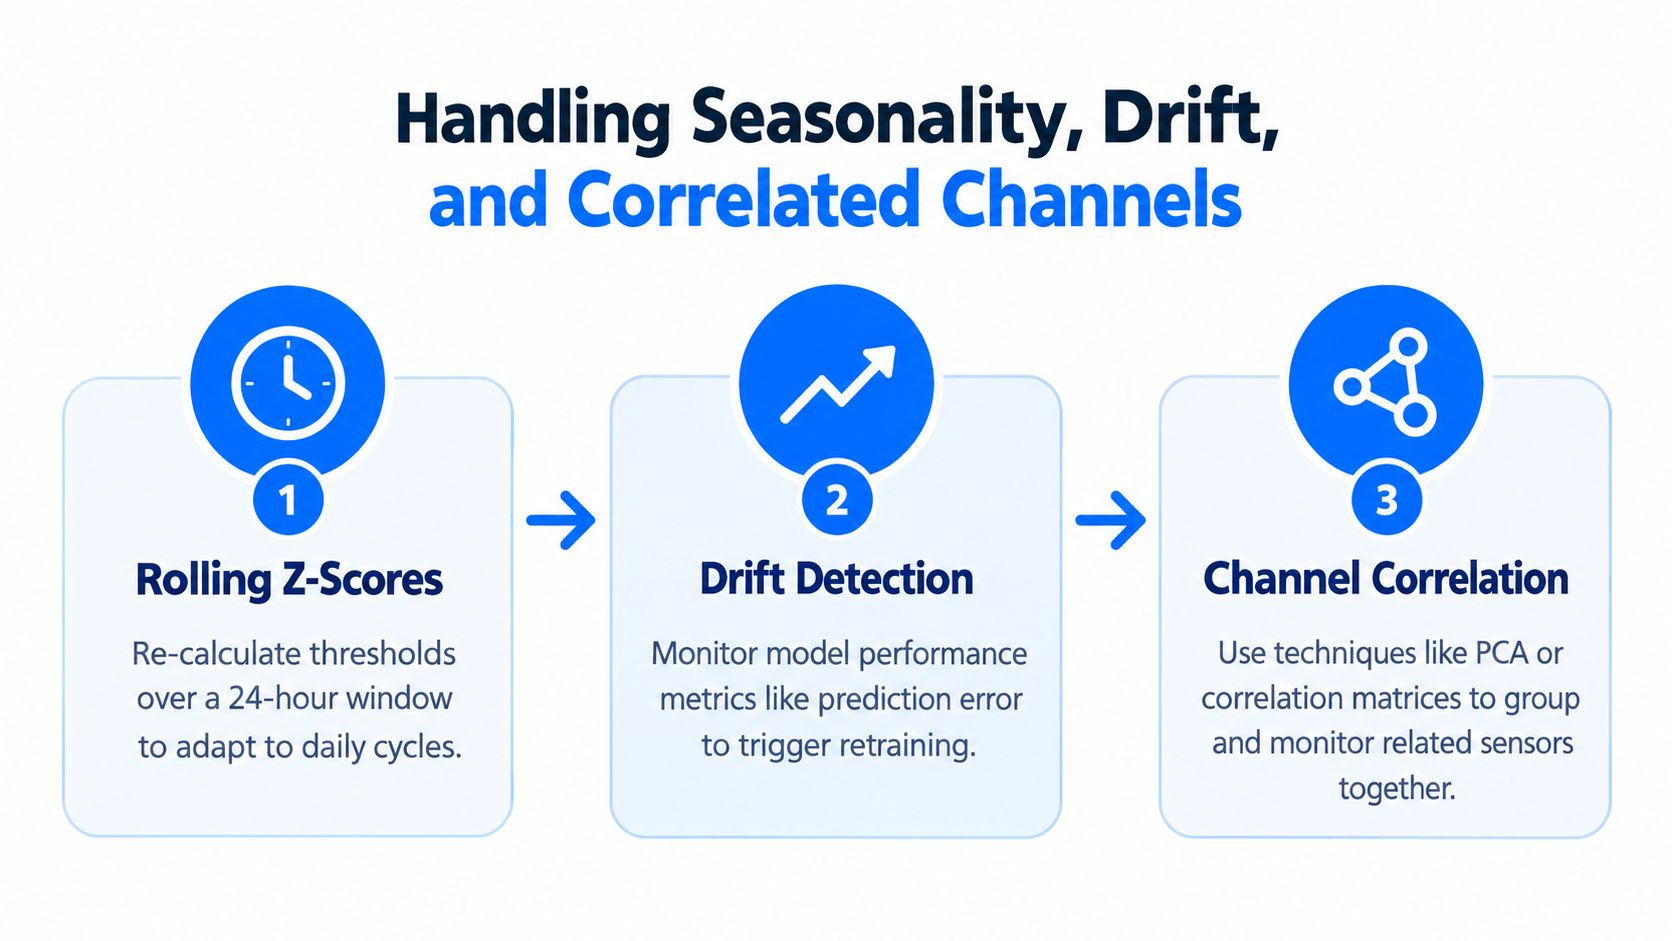
Monitoruj dryf modelu dla linii bazowych czujników za pomocą model drift detection for sensor baselines. Osobno analizuj rozkłady cech, reszty oraz wyniki alertów. Linia bazowa może wyglądać na poprawną nawet po tym, jak relacja między czujnikiem a warunkami operacyjnymi uległa zmianie.
Uwzględnij powiązane kanały
Temperatura, drgania i prąd często zmieniają się razem, ponieważ prędkość lub obciążenie wpływa na wszystkie trzy parametry. Niezależne ocenianie każdego z nich generuje wtedy alerty dla uzasadnionych zmian operacyjnych. Skorelowane kanały powinny być oceniane w odniesieniu do kontekstu operacyjnego oraz względem siebie nawzajem.
Analiza reszt to praktyczny pierwszy krok. Jeśli obroty silnika (RPM) wyjaśniają większość amplitudy drgań, przeprowadź regresję drgań względem RPM i oceniaj resztę. Metoda PCA może skompresować skorelowane kanały do ukrytych wzorców operacyjnych, podczas gdy macierze korelacji pomagają zidentyfikować grupy, które powinny podlegać tej samej regule monitorowania. Badania nad silnie zaszumionymi strumieniami przemysłowymi analizują również metody hybrydowe, takie jak PCA połączone z autoenkoderami, co omówiono w badaniach nad detekcją anomalii w mocno zaszumionych czujnikach.
Zasada decyzyjna: Używaj adaptacyjnego okna, gdy proces pozostaje stabilny, ale jego linia bazowa się przesuwa. Przeprowadź ponowne szkolenie, gdy relacja między danymi wejściowymi a oczekiwanym zachowaniem ulegnie istotnej zmianie lub gdy zweryfikowane incydenty wykażą systematyczne pominięcia.
Pamiętaj o opóźnieniu przy podejmowaniu decyzji. Wielokanałowy model, który nie mieści się w budżecie czasu reakcji, jest mniej użyteczny niż prostsza reguła resztowa działająca w sposób ciągły. Połącz relacje między kanałami z kontrolą dryfu, a następnie kieruj niepewne przypadki do weryfikacji, zamiast pozwalać, by linia bazowa je wchłonęła.
Uczciwa ocena skuteczności detekcji
Dokładność (accuracy) jest często najmniej użyteczną metryką w systemie detekcji anomalii. Jeśli anomalie występują rzadko, detektor może uzyskać świetny wynik, przewidując stan normalny dla niemal każdej obserwacji i nie wykrywając niczego istotnego. Nawet bez sztucznego zawyżania częstości występowania anomalii lekcja operacyjna jest jasna: oceniaj zdarzenia, które interesują operatorów, a nie tylko pojedyncze wiersze danych.
Precyzja (precision) informuje o tym, ile alertów miało sens. Pełność (recall) mówi o tym, ile spośród oznaczonych anomalii wykrył detektor. Żadna z tych metryk nie określa, czy system zareagował odpowiednio wcześnie. Mierz opóźnienie detekcji od momentu rozpoczęcia anomalii, a nie tylko od końca okna oceniania, ponieważ spóźniony alert może być technicznie poprawny, ale operacyjnie bezużyteczny.
Używaj oceny uwzględniającej zdarzenia
Praktyczny zestaw ewaluacyjny powinien zawierać:
Precyzję i pełność (precision/recall): Obliczaj obie te wartości na oznaczonych oknach czasowych, weryfikując etykiety z historią konserwacji i kontekstem operacyjnym.
Opóźnienie detekcji: Mierz czas, jaki upłynął od najwcześniejszego możliwego do obrony początku anomalii do pierwszego alertu umożliwiającego podjęcie działań.
Liczbę alertów: Śledź alerty w przeliczeniu na zmianę oraz na zasób, a nie tylko zagregowane metryki modelu.
Obciążenie fałszywymi alarmami: Rejestruj fałszywe alarmy na godzinę pracy operatora, aby wynik odzwierciedlał rzeczywiste obciążenie pracą ludzi.
Przegląd pominiętych zdarzeń: Analizuj anomalie, których detektor nigdy nie wykrył, zwłaszcza stopniowy dryf i awarie wielokanałowe.
Badanie porównawcze funkcjonalnej detekcji anomalii wykazało, że skuteczność zależy w dużej mierze od typu anomalii, a ewaluacja oparta na symulacjach jest niezbędna, ponieważ żaden pojedynczy detektor nie jest niezawodny dla wszystkich wzorców. Wniosek ten przemawia za stworzeniem zestawu testowego zawierającego nagłe skoki, stopniowe narastanie, przesunięcia poziomu, brakujące dane, skorelowane zmiany oraz przedziały z szumem, jak opisano w teście porównawczym funkcjonalnej detekcji anomalii.
Metryka | Co mierzy | Pułapka przy danych z czujników |
|---|---|---|
Dokładność (Accuracy) | Ogólny udział poprawnych klasyfikacji | Może maskować pominięte rzadkie usterki |
Precyzja (Precision) | Udział alertów, które rzeczywiście odpowiadają anomaliom | Wysoka precyzja może wynikać ze zbyt rzadkiego generowania alertów |
Pełność (Recall) | Udział wykrytych anomalii spośród wszystkich oznaczonych | Może faworyzować generowanie zbyt wielu szumnych alertów bez kontekstu czasowego |
F1-score | Równowaga między precyzją a pełnością | Traktuje każdą próbkę jednakowo, nawet gdy jedno zdarzenie obejmuje wiele próbek |
Opóźnienie detekcji | Czas od wystąpienia anomalii do pierwszego alertu | Etykiety mogą oznaczać czas naprawy, a nie fizyczny początek awarii |
Liczba alertów | Obciążenie operacyjne generowane przez model | Zagregowane sumy mogą maskować jeden generujący szum zasób lub zmianę |
Literatura dostarcza przydatnego ostrzeżenia. Kontekst czasowy poprawił detekcję na przemysłowym zbiorze danych OPC UA o 2,27% dla F1, 2,33% dla precyzji oraz 3,02% dla pełności po dodaniu pamięci sekwencyjnej drugiego rzędu, zgodnie z badaniem pamięci sekwencyjnej w przemysłowym IoT. Tego rodzaju usprawnienie ma znaczenie tylko wtedy, gdy sprawdzi się w testach równoległych w konkretnym zakładzie.
Uruchom testowany model równolegle z istniejącymi regułami w trybie cichym (shadow mode). Podczas początkowej oceny nie pokazuj operatorom jego alertów, porównaj czas wykrywania zdarzeń i obciążenie pracą z historycznymi incydentami i zbadaj każdą rozbieżność przed wdrożeniem produkcyjnym.
Do analizy niepewności w scenariuszach z rzadkimi zdarzeniami przydatna może być symulacja Monte Carlo do testów operacyjnych. Pomoże ona zespołom zbadać, jak zachowują się reguły alertów w różnych warunkach sygnałowych, bez traktowania syntetycznych wyników jako ostatecznego dowodu działania w produkcji.
Architektury wdrożeniowe do monitorowania w czasie rzeczywistym
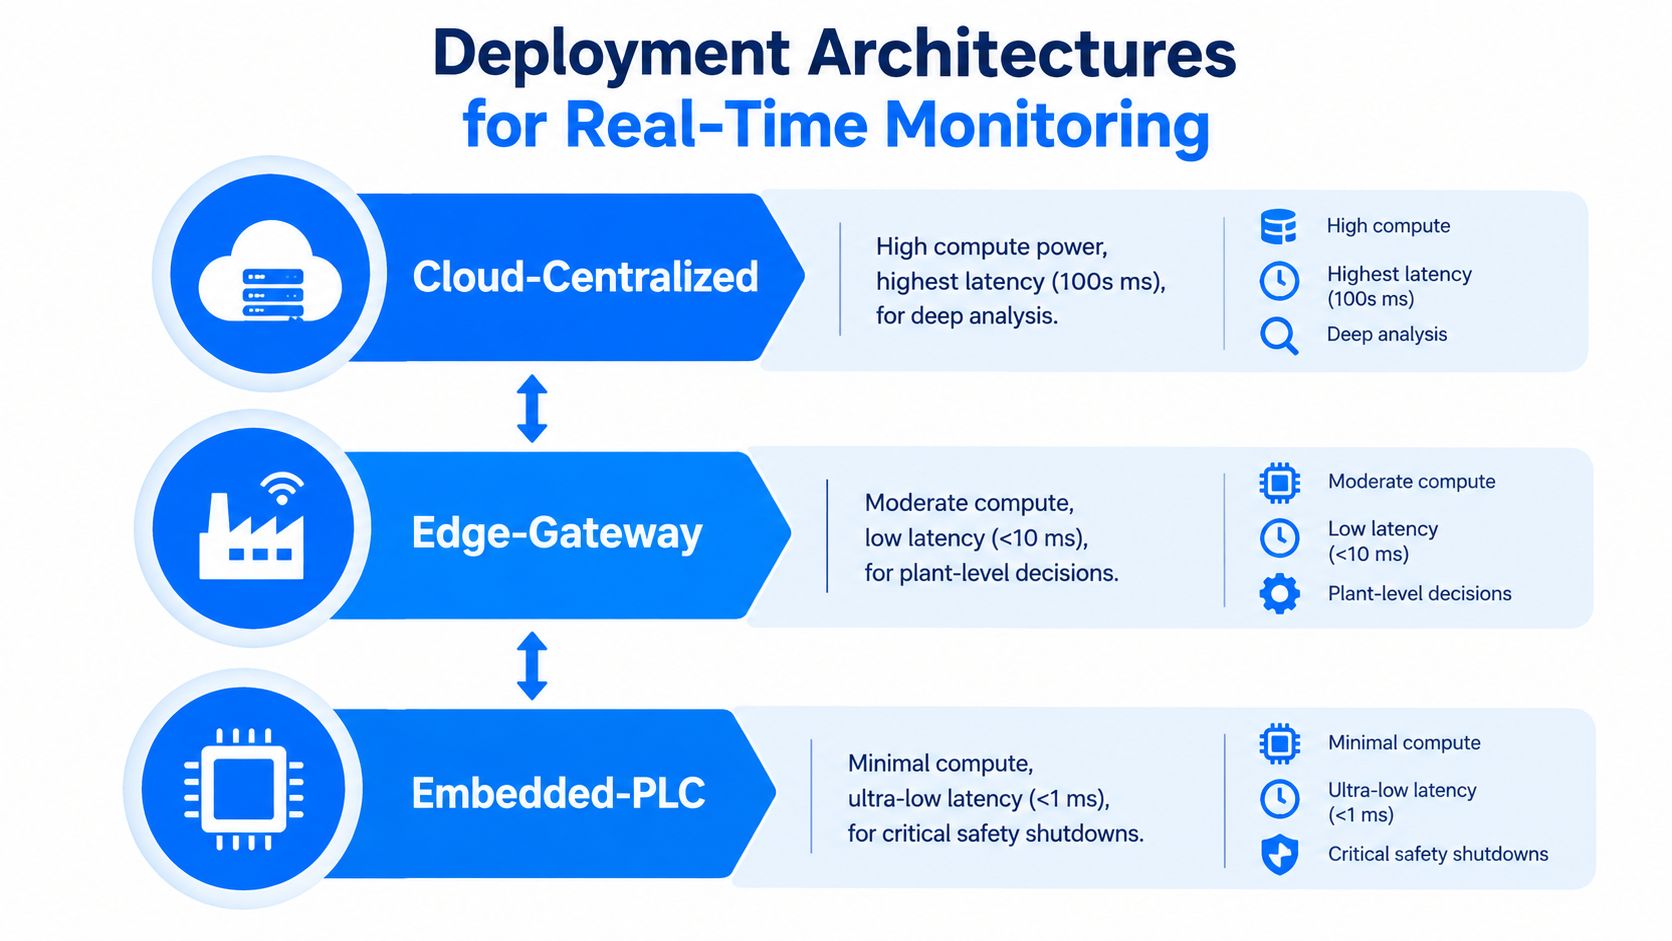
Architektura wynika z ograniczeń. Jeśli decyzja musi zostać podjęta blisko maszyny, wysyłanie każdej surowej próbki do odległej chmury zwiększa opóźnienia i uzależnia system od dostępności sieci. Jeśli celem jest analiza trendów dla całej floty urządzeń, wdrażanie dużego modelu w każdym kontrolerze tworzy niepotrzebne obciążenie operacyjne.
Dopasuj wzorzec do decyzji
Wnioskowanie wbudowane w PLC lub bezpośrednio w czujniku sprawdza się w przypadku krytycznych działań lokalnych. Kompaktowy detektor może działać w miejscu, w którym sygnał wchodzi do systemu sterowania, co pozwala uniknąć przesyłania danych przez sieć. Wadą są poważne ograniczenia zasobów, trudne aktualizacje modeli i rygorystyczne wymagania testowe. Stosuj to rozwiązanie do prostych decyzji związanych z bezpieczeństwem, a nie automatycznie do każdego zadania analitycznego.
Wnioskowanie na bramie brzegowej (Edge) zapewnia więcej przestrzeni dla inżynierii cech i modeli wielokanałowych, zachowując jednocześnie dane wewnątrz zakładu. Brama może odbierać komunikaty z lokalnych systemów, obliczać okna czasowe i wysyłać wyżej jedynie wyniki ocen lub wybrane cechy. Ten wzorzec sprawdza się, gdy prywatność i odporność systemu są ważniejsze niż scentralizowana prostota.
Wnioskowanie w chmurze lub jednostce centralnej oferuje największą moc obliczeniową i łatwiejsze ponowne szkolenie modeli dla całej floty urządzeń. Nadaje się do głębokich analiz, porównań między oddziałami i długofalowego rozwoju modeli, ale zależy od niezawodnego połączenia sieciowego i zwiększa transfer wrażliwych, surowych danych.
Nie pomijaj oceniania wewnątrz bazy danych
W przypadku podsumowań dla floty urządzeń i monitorowania historycznego, wykonywanie ocen bezpośrednio w bazie danych szeregów czasowych, takiej jak TimescaleDB lub Influx, może ograniczyć niepotrzebne przesyłanie każdego punktu do chmury. Pozwala to również zachować obliczenia cech blisko przechowywanych danych i ułatwia analizę inżynierom danych pracującym w SQL. Ograniczeniem jest to, że wykonywanie zapytań w bazie danych może nie spełniać rygorystycznych wymagań sterowania w czasie rzeczywistym.
Współpraca chmury i urządzeń brzegowych staje się coraz bardziej praktyczna w przemysłowych sieciach czujników, ponieważ oddziela lokalną detekcję od scentralizowanej analizy. Badania nad współpracą chmury i urządzeń brzegowych w detekcji anomalii opisują ten podział jako odpowiedź na ograniczenia związane z opóźnieniami i skalowalnością, podczas gdy nowsze prace ukierunkowane na urządzenia brzegowe skupiają się na wydajnej i szybkiej detekcji przy ograniczonych zasobach.
Dbaj o wersjonowanie artefaktów modeli we wszystkich lokalizacjach. Przy każdym alercie rejestruj konfigurację czujników, definicje cech, stan kalibracji oraz wersję modelu. Zapisuj wystarczającą ilość surowego kontekstu wokół incydentu na potrzeby późniejszego debugowania, ale zdefiniuj rozsądne zasady retencji, ponieważ surowe okna wysokiej częstotliwości mogą szybko urosnąć do olbrzymich rozmiarów.
Wybieraj rozwiązanie, odpowiadając na trzy pytania: jak szybko musi dotrzeć decyzja, czy surowe sygnały mogą opuścić zakład oraz jaką mocą obliczeniową dysponuje urządzenie lokalne. Odpowiedź często prowadzi do wdrożenia hybrydowego: lokalnego oceniania połączonego ze scentralizowanym douczaniem i analizą.
Pewne wejście na produkcję
Model nie zastąpi zaufanego procesu obsługi alertów. Operatorzy oceniają system na podstawie tego, czy alerty docierają w przydatnym momencie, zawierają odpowiedni kontekst i odróżniają zdarzenie wymagające reakcji od zwykłych wahań procesu. O wejściu detektora na produkcję powinien decydować realizm operacyjny, a nie nowatorska architektura.
Uruchom listę kontrolną przed wdrożeniem
Zacznij od uruchomienia cichego (shadow run) obok dotychczasowych reguł na okres od dwóch do czterech tygodni, stosując przedział czasowy określony w planie wdrożenia, zamiast traktować go jako uniwersalną gwarancję. Nie reaguj jeszcze na nowe alerty. Porównaj je z historią konserwacji, notatkami operatorów, znanymi interwencjami oraz dotychczasowym strumieniem alertów.

Następnie dostosuj czułość na podstawie zaobserwowanych zachowań:
Uruchomienie ciche (shadow run): Zidentyfikuj, które alerty dotarłyby do operatorów i czy odpowiadają one rozpoznawalnym zdarzeniom.
Strojenie progów: Zrównoważ liczbę pominiętych zdarzeń z obciążeniem alertami, korzystając z rzeczywistych okresów operacyjnych, a nie tylko z odtwarzanych plików testowych.
Plan awaryjny: Zdefiniuj procedurę wycofania (rollback), ręcznego nadpisania oraz bezpiecznego zachowania systemu w przypadku awarii modelu, potoku cech, bramy sieciowej lub źródłowego strumienia danych.
Ciągłe monitorowanie: Śledź dryf danych wejściowych, dostępność cech, rozkłady wyników, rezultaty alertów oraz metryki modelu po wdrożeniu.
Monitorowanie modelu wymaga pętli zwrotnej o incydentach. Ponowne szkolenie powinno następować po zweryfikowanych, oznaczonych incydentach oraz istotnych zmianach w zachowaniu operacyjnym, a nie wynikać z arbitralnie wybranej daty w kalendarzu. Jeśli czujnik zostanie wymieniony, proces ulegnie zmianie lub działania konserwacyjne zresetują zachowanie maszyny – odnotuj ten kontekst, aby model nie zinterpretował interwencji jako niewyjaśnionej anomalii.
Jasno określ ścieżkę eskalacji
Krytyczne anomalie powinny trafiać do inżynierów dyżurnych w ramach określonego celu czasowego (latency objective). Zdarzenia o niższym priorytecie mogą trafiać do kolejki tygodniowego przeglądu, gdzie inżynierowie analizują wzorce, potwierdzają etykiety i decydują, czy linia bazowa bądź zestaw cech wymagają korekty. Każdy alert powinien zawierać informację o zasobie, znacznik czasu, kanały mające wpływ na wynik, wartości cech, wersję modelu oraz link do odpowiedniego okna z surowymi danymi.
Prawdziwą miarą sukcesu jest zaufanie operatora. Detektor zyskuje status produkcyjny wtedy, gdy ludzie podejmują działania na podstawie jego alertów bez kwestionowania każdego z nich.
System, który minimalizuje liczbę fałszywych alarmów w testach porównawczych, ale paraliżuje pracę zespołu na zmianie, jest porażką. Prostszy detektor, który wykrywa właściwe zdarzenia, wyjaśnia swój wynik i wyłącza się w bezpieczny sposób, może przynieść większą wartość niż skomplikowany model, którego nikt nie potrafi utrzymać. Celem detekcji anomalii w danych z czujników nie jest generowanie imponujących metryk w izolacji. Jest nim dostarczenie osobom odpowiedzialnym za sprzęt wystarczających i terminowych dowodów do podjęcia lepszej decyzji.
digna pomaga zespołom monitorować nieprawidłowości w zachowaniu danych, terminowość (Timeliness), reguły walidacji oraz zmiany strukturalne w ich własnym środowisku, co stanowi dopełnienie potoków detekcji anomalii w czujnikach, które zależą od wiarygodnych danych wejściowych. Odwiedź witrynę digna, aby zobaczyć, jak jej podejście do Observability wewnątrz bazy danych może pomóc Ci wykryć luki w danych i nieoczekiwane zmiany, zanim zakłócą one monitoring przemysłowy.
Najczęściej zadawane pytania
Dlaczego wykrywanie anomalii w danych z czujników jest trudniejsze, niż się wydaje?
Bo „normalne” to wyuczony kontekst pracy, a nie stała liczba. Czujnik drgań turbiny potrafi pozostać niemal płaski przez wiele godzin po poluzowaniu wspornika, więc stały próg raportuje zdrowie, choć stan mechaniczny już się zmienił.
Jakie ograniczenia produkcyjne psują model czujnikowy?
Powtarza się sześć: zmiany reżimu pracy wynikające z obciążenia, prędkości i zmian roboczych; dryf czujnika z kalibracji i starzenia; skorelowane kanały reagujące na ten sam stan; nierówne próbkowanie, przez które naiwne złączenia wiersz po wierszu mylą; opóźnione etykiety z zapisów utrzymania ruchu; oraz limity opóźnień, gdy decyzja bezpieczeństwa musi zapaść przy maszynie.
Jak przygotować cechy z czujników?
Wyrównaj czas, zanim cokolwiek policzysz. Dobierz rytm analizy do budżetu opóźnień detektora, świadomie przepróbkuj każdy kanał i zachowaj oryginalne znaczniki czasu lub flagi jakości przy urządzeniach wielomodalnych. Surowe odczyty są słabymi wejściami bez kontekstu pracy.
Które cechy wychwytują które awarie?
Dopasuj cechę do wzorca. Kroczący z-score mierzy odległość od niedawnej średniej względem niedawnej zmienności, dłuższe okno, na przykład 30 minut, ujawnia wolniejszy dryf, który krótkie okno wchłania jako normę, różnicowanie odpowiada na inne pytanie, a cechy opóźnione dają klasycznym modelom zwięzłą historię ostatnich kroków.
Dlaczego dokładność z benchmarków nie przenosi się na produkcję?
Bo czyste zbiory pomijają właśnie te warunki, które powodują awarie: zmiany reżimu, dryf, skorelowane kanały, nierówne próbkowanie i niepewne etykiety. Liczą się też kontrole otaczającego potoku, bo oddzielają prawdziwą anomalię maszyny od spóźnionego, brakującego, zniekształconego lub strukturalnie zmienionego strumienia.



