Wykrywanie anomalii w bazach danych: praktyczny przewodnik
|
9
min. czyt.

Pierwszy sygnał rzadko jest spektakularną awarią. Pulpit nawigacyjny przychodów pozostaje zielony, liczba wierszy wygląda normalnie i nikt nie wzywa zespołu ds. hurtowni danych, ale cicha zmiana na wcześniejszym etapie zdążyła już skierować część danych na ścieżkę rezerwową lub zmienić strukturę zasilania. Zanim dział finansów zauważy, że prognoza jest błędna, wadliwe wiersze trafiły już do modeli, raportów i slajdów dla zarządu.
Właśnie dlatego wykrywanie anomalii w bazie danych działa lepiej, gdy sama hurtownia jest traktowana jako monitorowany obszar. Przydatne pytanie brzmi nie tylko, czy wykres wygląda dziwnie, ale czy Timeliness, kształt i dystrybucja danych nadal pasują do bazy wyjściowej, na której polegają Twoi odbiorcy. W praktyce oznacza to ekstrakcję cech natywną dla SQL, porównanie z linią bazową blisko źródła oraz alertowanie, które rozumie kontekst, zamiast alarmować przy każdym spodziewanym skoku.
Spis treści
Wybór między statystycznymi liniami bazowymi a uczeniem opartym na AI
Budowanie linii bazowych podobieństwa segmentów dla powtarzalnych obciążeń roboczych
Wykrywanie dryfu schematu i opóźnień w dostarczaniu jako jednego sygnału
Projektowanie alertów świadomych kontekstu, którym ludzie naprawdę ufają
Włączanie wykrywania anomalii w bazie danych do swojego stosu Observability
Kiedy cichy dryf danych niszczy Twoje raporty
Zespół finansowy może ufać temu samemu codziennemu pulpitowi nawigacyjnemu przychodów przez tygodnie i nadal się mylić. Jedna zmiana nazwy schematu na wcześniejszym etapie, jedno odgałęzienie w transformacji lub jedna zmiana typu w tabeli źródłowej może skierować wiersze na domyślną ścieżkę, więc pulpit nawigacyjny nadal się renderuje, a liczby nadal wyglądają porządnie. Problem polega na tym, że mianownik jest teraz częściowy, a organizacja tworzy prognozy na podstawie przefiltrowanego wycinka rzeczywistości.
Kontrole pulpitów nawigacyjnych i asercje typu dbt okazują się niewystarczające. Liczby wierszy mogą pozostać w normalnym zakresie, podczas gdy aktywne identyfikatory klientów dryfują w dół, potok może dotrzeć późno bez całkowitego zatrzymania pracy, lub wcześniej wypełniona kolumna może zacząć zwracać wartość NULL w niewłaściwym miejscu. Żaden z tych wzorców nie musi zawsze uruchamiać prostej reguły, ale wszystkie mogą zniekształcić decyzje.
Podejście natywne dla hurtowni danych wyłapuje problem u źródła. Zamiast czekać, aż odbiorcy na dalszych etapach zauważą, że coś jest nie tak, wykrywanie anomalii w bazie danych porównuje obecny stan danych ze sposobem, w jaki normalnie zachowuje się ta tabela, metryka lub potok. Obejmuje to strukturę, świeżość i dystrybucję wartości, a nie tylko to, czy zadanie zakończyło się sukcesem.
Praktyczna zasada: jeśli dane zmieniły się w sposób, którego pulpit nawigacyjny nie potrafi samodzielnie wyjaśnić, Twoja warstwa detekcji powinna znajdować się tam, gdzie dane są generowane, a nie trzy narzędzia dalej.
Lekcja historyczna jest jasna. Wczesne testy porównawcze wykazały już, że jakość wykrywania anomalii w dużym stopniu zależy od danych, a późniejszy test porównawczy na znacznie większą skalę potwierdził tę samą tezę przy znacznie szerszym zakresie, testując 30 algorytmów na 57 zestawach danych referencyjnych i 98 436 eksperymentach w celu zbadania poziomu nadzoru, typu anomalii i warunków szumu (ADBench benchmark). Powód, dla którego ma to znaczenie w hurtowniach danych, jest prosty – obciążenia robocze się różnią, schematy dryfują, a linie bazowe, które sprawdzają się w jednym zestawie danych, mogą zawieść w środowiskach zbliżonych do produkcyjnych.
Wyodrębnianie cech detekcji za pomocą SQL w bazie danych
Najszybszym sposobem na uczynienie wykrywania anomalii użytecznym jest pozostawienie inżynierii cech wewnątrz hurtowni danych. Jeśli najpierw wyeksportujesz surowe tabele do osobnego magazynu cech, dodasz opóźnienie, duplikację i kolejne miejsce, w którym świeżość danych może ulec pogorszeniu, zanim detektor w ogóle się uruchomi. SQL potrafi już obliczyć potrzebne sygnały, więc warto z tego skorzystać.
Zacznij od okien ruchomych i różnic
W przypadku większości kontroli w hurtowni danych zaczynam od agregacji kroczących w oknach 7-dniowych i 28-dniowych. Funkcje okna, takie jak AVG, STDDEV i COUNT, dają lokalną linię bazową bez opuszczania bazy danych, a LAG i proste różnice pokazują zmianę okres do okresu bezpośrednio w zapytaniu. Takie połączenie pozwala wykryć stopniowy spadek, nagłe skoki oraz zmiany, które ujawniają się dopiero przy porównaniu dnia dzisiejszego z tym samym punktem w poprzednim cyklu.
Percentyle również mają znaczenie. Średnia może pozostać stabilna, podczas gdy mediana się przesuwa, szczególnie w przypadku niesymetrycznych danych biznesowych, dlatego PERCENTILE_CONT pomaga wychwycić dryf, który umyka kontrolom opartym na średniej. Klasyczne metody, takie jak odchylenie standardowe, mediana odchylenia bezwzględnego, rozstęp międzykwartylowy, wskaźnik z-score i zmodyfikowany z-score, nadal są przydatne, ponieważ są przejrzyste i tanie w obliczeniach na aktywnej tabeli (classical statistical methods).
Jeśli metryka jest na tyle ważna, by wysyłać z niej powiadomienia, to jest na tyle ważna, by obliczać ją tuż obok danych, a nie po eksporcie wsadowym.
Praktyczny wzorzec na tabeli faktów o złożonym ziarnie wygląda następująco:
Partycjonowanie według dnia i metryki, tak aby każdy sygnał miał własną historię.
Obliczanie kroczących linii bazowych dla średniej, rozrzutu i liczby.
Dodawanie opóźnionych różnic dla zmian dzień do dnia i tydzień do tygodnia.
Zapisywanie wyniku w tabeli cech, z której kolejne zadania mogą czytać bez ponownego obliczania wszystkiego.
Wzorzec SQL | Użyta funkcja | Ujawniony sygnał |
|---|---|---|
Krocząca linia bazowa | AVG, STDDEV, COUNT | Lokalny trend, zmienność i brakujący wolumen |
Różnica okresu | LAG, odejmowanie | Zmiany skokowe i nagły regres |
Dryf mediany | PERCENTILE_CONT | Przesunięcie rozkładu ukryte przez średnie |
W tym miejscu wykonanie w bazie danych przynosi korzyści operacyjne. Unikasz kopiowania terabajtów do innego systemu i utrzymujesz logikę detekcji blisko sygnału świeżości. Aby zapoznać się z porównaniem architektonicznym tego wzorca, zobacz wewnętrzną notatkę na temat in-database data quality execution and safer external pipelines.
Wybór między statystycznymi liniami bazowymi a uczeniem opartym na AI
Statystyczne linie bazowe nadal są właściwym punktem wyjścia dla wielu tabel produkcyjnych. Średnia ruchoma wraz z odchyleniem standardowym, mediana odchylenia bezwzględnego, rozstęp międzykwartylowy i wskaźniki z-score są łatwe do wyjaśnienia, łatwe do audytowania i łatwe do uruchomienia w SQL. Działają szczególnie dobrze, gdy metryka jest stabilna, sezonowość jest słaba, a biznes oczekuje jasnego progu zamiast czarnej skrzynki.
Słabość ujawnia się, gdy tylko seria staje się nieregularna. Cykle tygodniowe, efekty świąteczne i interakcje wielowymiarowe sprawiają, że stałe progi stają się mało elastyczne, a ręczne dostrajanie zamienia się w uciążliwy obowiązek konserwacji. Dlatego właśnie istnieją wyuczone linie bazowe. Mogą one przyswoić więcej kontekstu, lepiej radzić sobie z sezonowością i modelować relacje między kolumnami lub tabelami, których pojedyncza reguła jednowymiarowa nie dostrzeże.
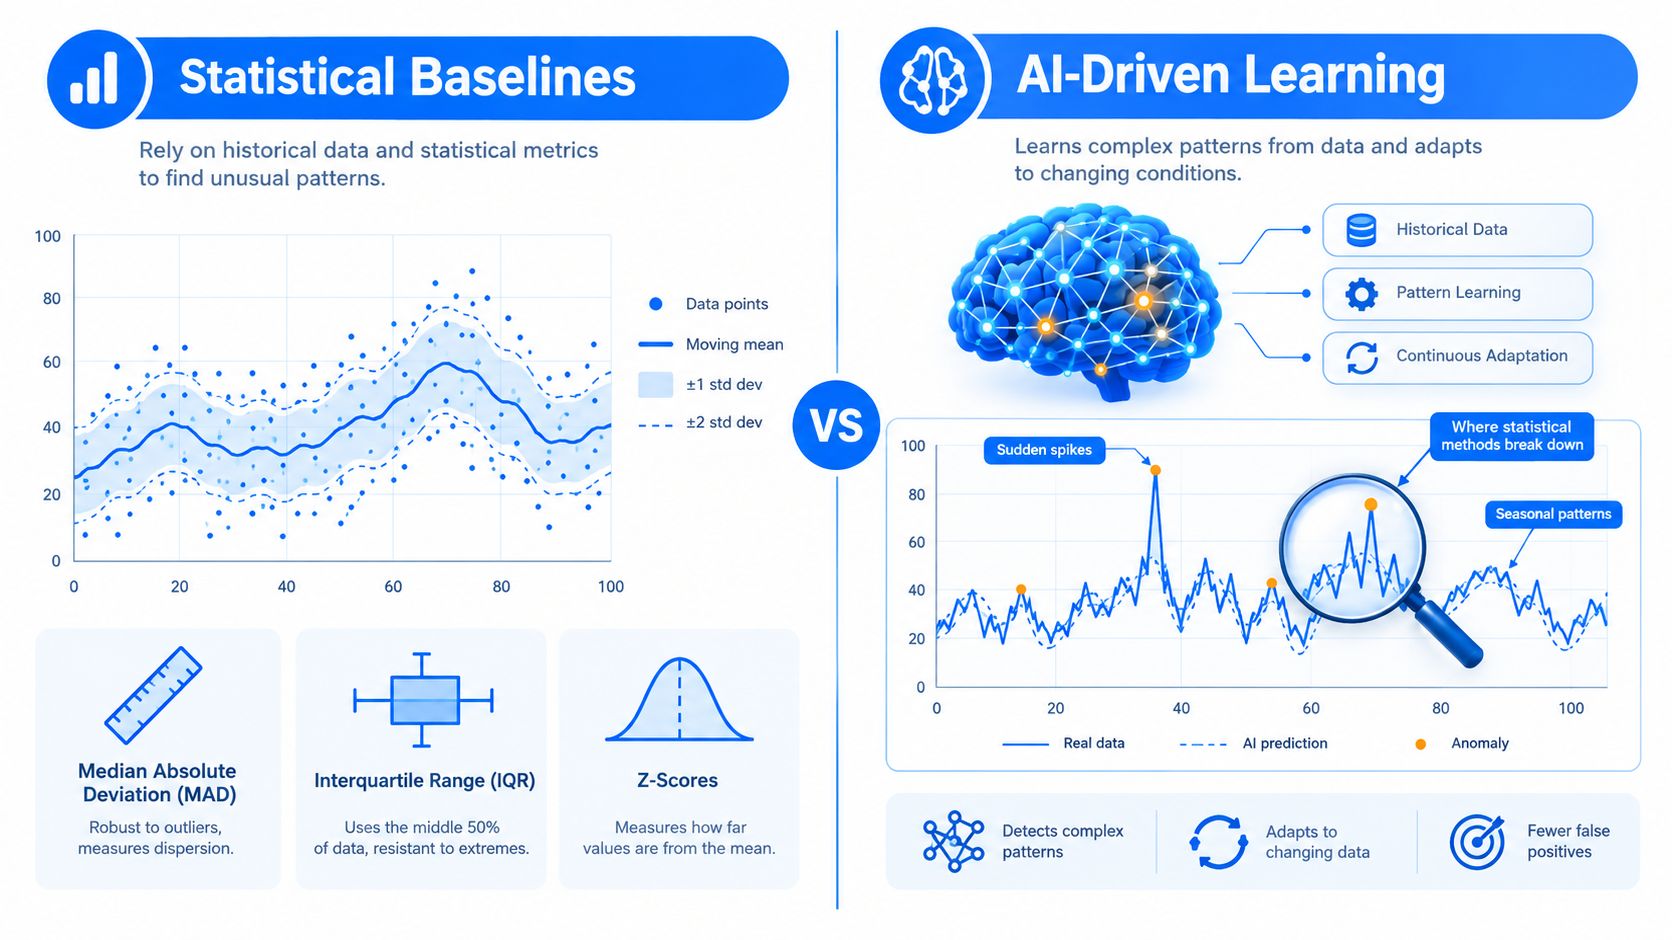
Kompromis ma charakter operacyjny, nie tylko matematyczny. Wyuczone modele wprowadzają potok szkoleniowy, wersjonowanie i dryf w samym modelu. Utrudniają również wyjaśnialność, gdy ktoś pyta, dlaczego uruchomił się alert na poziomie wiersza lub metryki, co jest realnym problemem w środowiskach regulowanych, gdzie zespoły potrzebują twardych dowodów, a nie tylko wyniku liczbowego.
Przydatne ramy porównawcze są następujące. Metody statystyczne często wychwytują około 60-70% anomalii jednowymiarowych przy niemal zerowej liczbie fałszywych alarmów na stabilnych metrykach, podczas gdy wyuczone linie bazowe mogą zbliżyć się do 85% czułości (recall), ale wymagają dłuższego dostrajania. Są to wewnętrzne punkty odniesienia, a nie uniwersalne obietnice, ale pokrywają się z tym, co widzi większość praktyków przy przejściu z ręcznie dostrajanych progów na detekcję opartą na modelach.
Jeśli chcesz zacząć praktycznie, użyj statystycznych linii bazowych dla progów poszczególnych metryk i warstwowych modeli wyuczonych dla serii o wysokiej wartości i dużej wariancji. Takie podejście wpisuje się w szerszy podział branżowy na wyjaśnialne reguły i modele adaptacyjne, i jest to również powód, dla którego materiały takie jak AI anomaly detection in social ops są przydatną lekturą, nawet jeśli Twoim przypadkiem użycia jest hurtownia danych, a nie kolejka zdarzeń klientów. W celu głębszego ujęcia statystycznego dobrym uzupełnieniem będą wewnętrzne materiały na temat statistical pattern recognition.
Budowanie linii bazowych podobieństwa segmentów dla powtarzalnych obciążeń roboczych
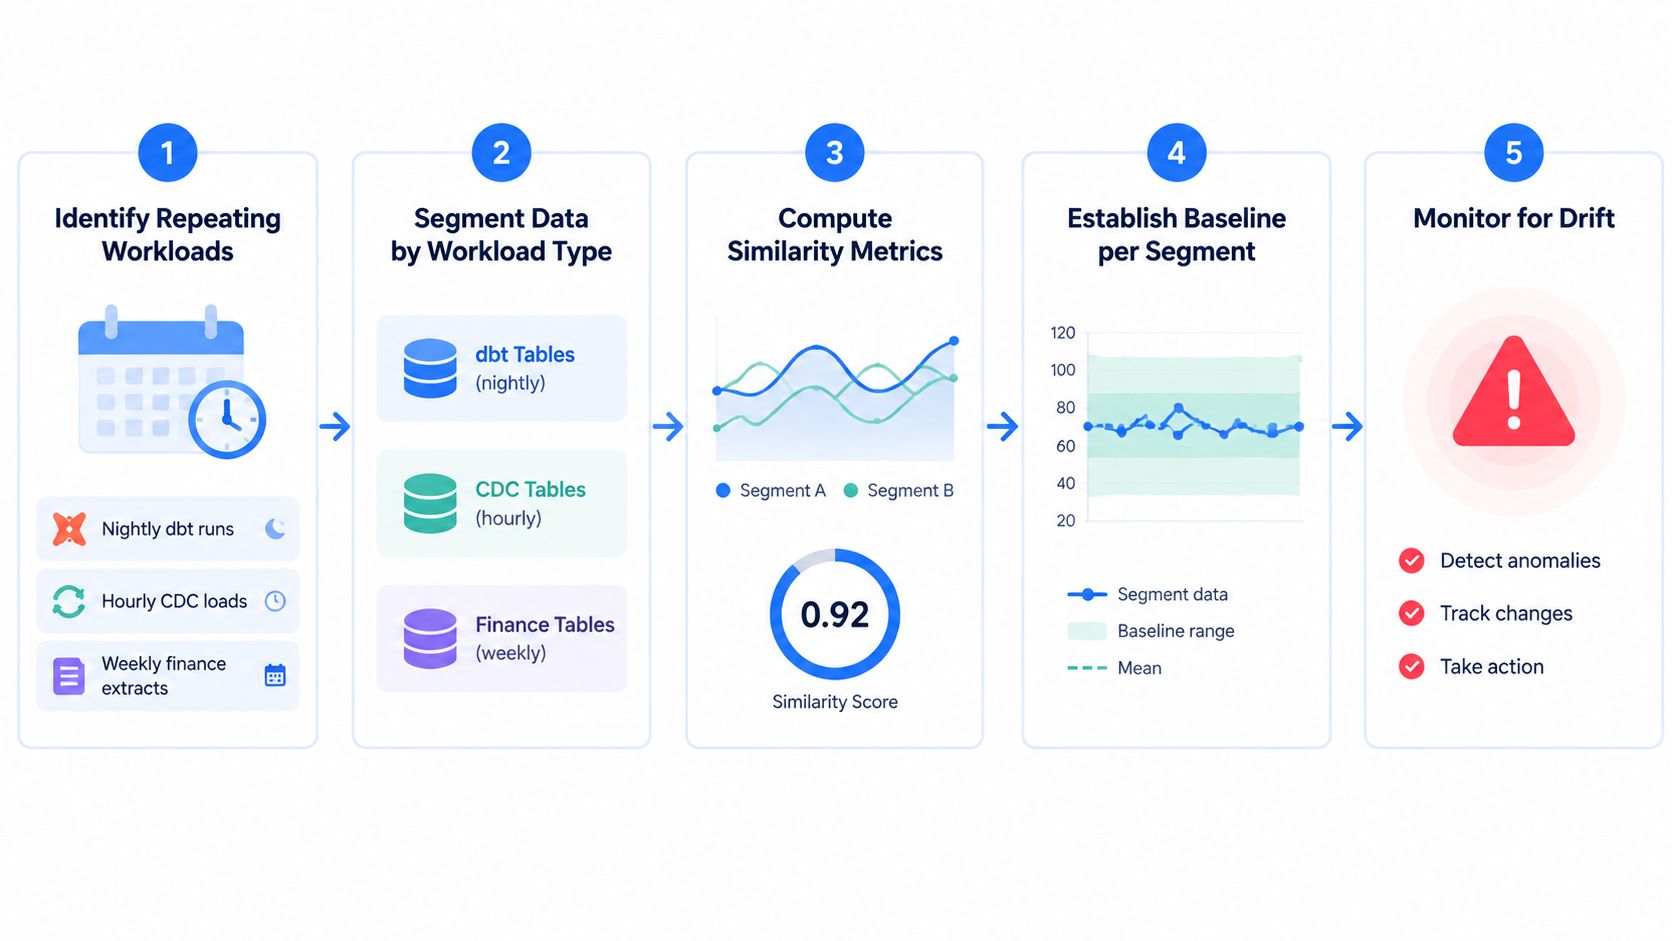
Powtarzalne obciążenia robocze wymagają innej linii bazowej niż metryki działające w trybie ciągłym. Nocne uruchomienia dbt, godzinne ładowania CDC i cotygodniowe ekstrakcje finansowe mają swoją kadencję, więc właściwym porównaniem zazwyczaj nie jest „dzisiaj w porównaniu do ogólnej średniej”, ale „dzisiaj w porównaniu do najbardziej podobnego segmentu historycznego”. W ten sposób oddzielasz rzeczywisty dryf od poniedziałkowego uzupełniania danych lub skoku w Czarny Piątek.
Tworzenie unikalnego identyfikatora każdego uruchomienia w SQL
Zacznij od stworzenia unikalnego identyfikatora (fingerprint) każdego zakończonego uruchomienia w hurtowni danych. Zazwyczaj uwzględniam liczbę wierszy, skrót (hash) kluczowych rozkładów kolumn, wskaźniki wartości pustych (null ratios) oraz kilka podsumowań liczbowych z PERCENTILE_CONT lub odpowiednika w hurtowni. Wartości te dają kompaktową reprezentację obciążenia bez konieczności przepuszczania całej tabeli przez detektor.
Przechowuj te identyfikatory w tabeli baseline_segments z kluczami job_id, day_of_week oraz hour_of_week. Następnie porównaj bieżące okno z K najbardziej podobnymi wcześniejszymi segmentami przy użyciu miary podobieństwa na wektorze identyfikatora. Jeśli podobieństwo spadnie poniżej progu przeglądu, np. 0.85, uruchomienie zasługuje na weryfikację przez człowieka, zanim zanieczyści dane dla odbiorców końcowych.
Logika jest prosta, ale korzyść subtelna. Nie pytasz, czy obciążenie jest „normalne” w ujęciu abstrakcyjnym. Pytasz, czy zachowuje się jak jego własna historyczna grupa rówieśnicza, co znacznie lepiej pasuje do hurtowni danych, gdzie sezonowość jest częścią normalnego działania.
Linia bazowa, która ignoruje kadencję, zawsze będzie generować nadmierną liczbę fałszywych alertów przy prawidłowych zachowaniach okresowych.
Trudnością są linie bazowe, które tracą aktualność. Gdy obciążenie naturalnie ewoluuje, biblioteka identyfikatorów musi zostać unieważniona i zbudowana na nowo, w przeciwnym razie będziesz w nieskończoność porównywać nowe zachowanie z nieaktualną historią. Jest to problem związany z governance w tym samym stopniu, co problem modelowania, i powinien być obsługiwany w tym samym potoku observability, co samo zadanie.
W celu uzyskania praktycznych informacji na temat segmentacji powtarzalnych zachowań danych warto zapoznać się z wewnętrznym przewodnikiem dotyczącym data profiling techniques.
Wykrywanie dryfu schematu i opóźnień w dostarczaniu jako jednego sygnału
Większość stosów monitorowania oddziela zmiany strukturalne od świeżości. Ten podział jest wygodny, ale maskuje błędy. Zmiana schematu może dotrzeć na czas i nadal uszkodzić rzutowanie typów na dalszych etapach, podczas gdy spóźniony plik może wyglądać niegroźnie, dopóki nie przełoży się kaskadowo na nieaktualny raport i naruszenie umowy SLA.
Traktowanie struktury i świeżości łącznie
W przypadku dryfu schematu porównaj dzisiejszy przychodzący schemat z bazowym schematem i sklasyfikuj różnice. Konkretne zbiory to brakujące kolumny (Β\I), nowe kolumny (I\B) oraz niezgodności typów we wspólnych polach (schema drift detection pattern). Jeśli pojawią się brakujące kolumny lub niezgodności typów, mamy do czynienia ze zmianą powodującą błędy. Jeśli pojawią się tylko nowe kolumny, zmiana ma charakter przyrostowy.
Timeliness powinna znajdować się obok tej kontroli, a nie pod nią. Monitor świeżości może sklasyfikować każdą dostawę jako wczesną, spóźnioną, brakującą lub częściową, a harmonogram może być określony precyzyjnie, np. w każdy dzień roboczy przed 7:30 rano (data timeliness monitoring). Gdy rzeczywisty czas przybycia zbytnio odbiega od oczekiwań, stan dostawy staje się częścią alertu, a nie osobnym pulpitem, którego nikt nie otwiera.
Typ sygnału | Co wykrywa | Główne źródło SQL | Typowe opóźnienie alertu |
|---|---|---|---|
Dryf schematu | Dodane, usunięte kolumny lub zmiana ich typów | Różnice INFORMATION_SCHEMA | Natychmiast przy pobieraniu |
Opóźnienie dostawy | Spóźnione, brakujące, wczesne lub częściowe ładowania | Znaczniki czasu przybycia i tabele świeżości | W momencie naruszenia harmonogramu |
Połączona awaria | Zmiana strukturalna plus regres świeżości | Połączone kontrole schematu i świeżości | W czasie zbliżonym do rzeczywistego |
Przykład z prawdziwego świata jasno pokazuje tę wartość. Jeśli dostawca rozszerzy kolumnę tekstową do VARCHAR(500), a rzutowanie na typ numeryczny zacznie kończyć się błędem w części wierszy na dalszym etapie, kontrola schematu powinna zadziałać przed wygenerowaniem raportu. Kontrola oparta wyłącznie na wolumenie prawdopodobnie poczekałaby do następnego dnia, co uniemożliwiłoby szybką reakcję operacyjną.
To jest przypadek, w którym platforma taka jak digna może być użyta jako jedna z opcji, ponieważ łączy w jednym modelu operacyjnym monitoring terminowości, śledzenie schematów i kontrole w bazie danych. Wewnętrzne wyjaśnienie na temat schema drift and structural changes that break data pipelines dobrze pasuje do tego wzorca.
Projektowanie alertów świadomych kontekstu, którym ludzie naprawdę ufają
Więcej alertów nie oznacza lepszej detekcji. Zazwyczaj oznacza to zmęczenie alertami, a gdy zespół jest zasypywany hałaśliwymi powiadomieniami, przydatne wezwanie jest ignorowane na równi ze śmieciowymi komunikatami. Zespół, który widzi 40 powiadomień na Slacku dziennie, zacznie wyciszać kanały i w ten sposób rzeczywiste awarie ukrywają się na widoku.
Rozwiązaniem jest alertowanie świadome kontekstu. Wyciszaj znane okna wdrażania za pomocą tabeli deploy_event, obniżaj priorytet, gdy odchylenie pokrywa się z zaplanowaną zmianą wsadową, i wymagaj drugiego potwierdzającego sygnału przed wezwaniem dyżurnego. Tym potwierdzeniem może być inna metryka, zmiana schematu lub regres świeżości, w zależności od obciążenia.
Sama treść powiadomienia powinna wyjaśniać przyczynę alertu. Dołącz użyty segment bazowy, wartość z-score lub wskaźnik podobieństwa oraz główne czynniki wpływające na wynik, aby inżynier mógł szybko przeprowadzić klasyfikację problemu. Jeśli osoba na dyżurze musi odtwarzać kontekst z trzech różnych pulpitów nawigacyjnych, alert nie nadaje się do produkcji.
Praktyczna zasada: jeśli inżynier nie potrafi zrozumieć alertu w mniej niż minutę, to alert zawiera zbyt mało szczegółów.
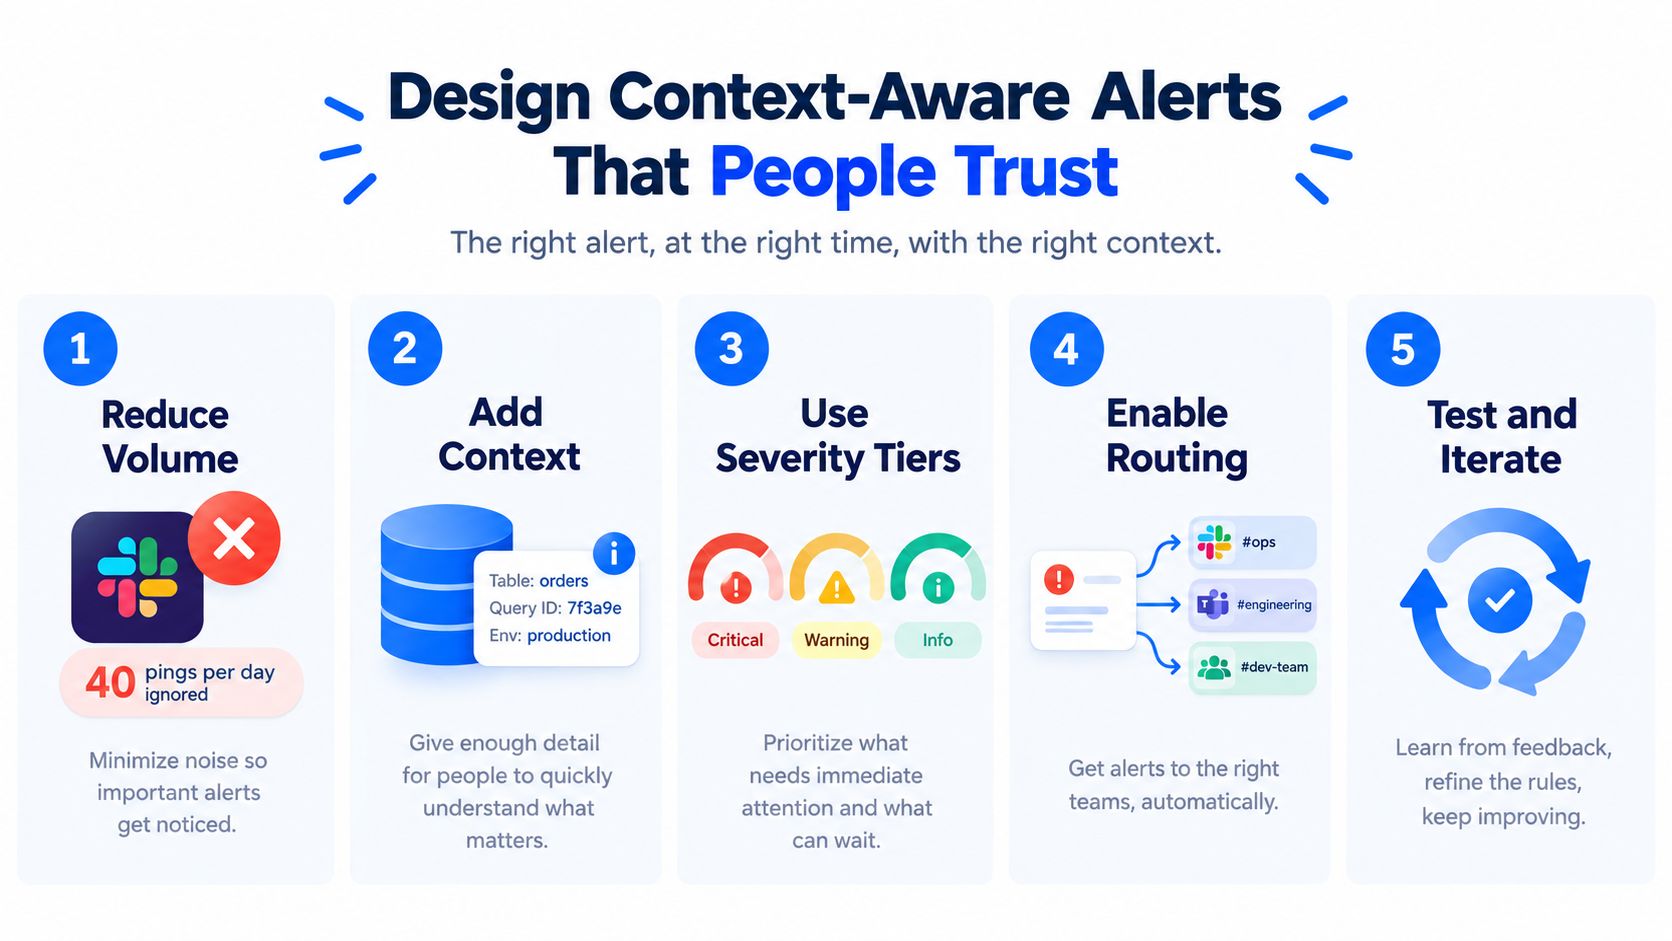
Celem operacyjnym powinno być mniej niż 5 krytycznych wezwań o wysokim znaczeniu tygodniowo na każdą kluczową tabelę, przy czym zaufanie mierzy się wskaźnikiem ignorowanych alertów, a nie ich łączną liczbą. Takie ujęcie zmienia dyskusję z „Ile alertów wysłaliśmy?” na „W przypadku których alertów warto było kogoś obudzić?”. Aby dowiedzieć się więcej o tym, jak zespoły operacyjne kierują i interpretują te sygnały, dobrym punktem odniesienia jest artykuł Sift AI piece on anomaly detection in social ops, mimo że dotyczy on innej domeny.
Włączanie wykrywania anomalii w bazie danych do swojego stosu Observability
Sygnały o anomaliach nie powinny znajdować się na zapomnianym pulpicie nawigacyjnym. Traktuj je jako telemetrię, oznaczaj tagami table, schema oraz run_id i przesyłaj do tej samej ścieżki observability, co metryki aplikacji i infrastruktury. Dzięki temu uszkodzone ładowanie, wdrożenie nowej wersji i skok liczby błędów infrastruktury znajdą się na tej samej osi czasu incydentu, a nie w trzech różnych narzędziach.
Połączenie hurtowni danych z kanałem incydentów
Harmonogramy natywne dla hurtowni danych są zazwyczaj najwygodniejszym miejscem do uruchamiania zapytań o cechy. Zadania Snowflake, zaplanowane zapytania BigQuery, testy dbt oraz sensory Airflow wpisują się w ten wzorzec, o ile ich częstotliwość odpowiada oczekiwaniom dotyczącym świeżości danych. Zdarzenie anomalii może następnie przepływać przez OpenTelemetry lub natywny eksporter do PagerDuty, Slacka lub dowolnej innej centralnej bramki alertów, z której już korzysta zespół dyżurny.
Kompromis jest oczywisty. Moduły odpytujące REST oparte na pobieraniu (pull) są proste, ale generują opóźnienia. Emitery oparte na zdarzeniach po zakończeniu zapisu szybciej wychwytują problemy, ale tworzą powiązanie między producentem a ścieżką monitorowania, co wymaga większej dyscypliny inżynieryjnej w zakresie ponownych prób, usuwania duplikatów i odpowiedzialności za proces.
Praktyczna kolejność wdrażania pomaga utrzymać ten proces pod kontrolą:
Po pierwsze, obliczaj cechy w SQL i zapisuj je trwale.
Po drugie, oznaczaj każde zdarzenie tagiem zasobu danych i metadanymi uruchomienia.
Po trzecie, skieruj alerty do jednego wspólnego strumienia incydentów.
Po czwarte, powiąż anomalie z wdrożeniami, flagami funkcji i procesami ETL na wcześniejszych etapach.
Na koniec, doprecyzuj reguły routingu, aby do ludzi trafiały tylko powiadomienia o najwyższym znaczeniu.

Wewnętrzny przegląd data observability jest tutaj istotny, ponieważ przedstawia wykrywanie anomalii jako jeden z elementów większego systemu operacyjnego, a nie jako samodzielny generator alertów. To właściwy model myślowy dla produkcyjnych hurtowni danych – taki, który powstrzymuje ludzi przed budowaniem kolejnego hałaśliwego pulpitu, którego nikt nie pilnuje.
Jeśli wdrażasz wykrywanie anomalii w bazie danych na produkcji, zacznij od kontroli znajdujących się najbliżej danych, a następnie nałóż na to kontekst, wyjaśnialność i routing. digna wspiera wykrywanie anomalii bezpośrednio w bazie danych, monitorowanie terminowości, śledzenie schematów oraz procesy observability wewnątrz środowiska klienta, dzięki czemu idealnie pasuje do zespołów, które chcą mieć logikę detekcji tam, gdzie już znajdują się dane. Odwiedź digna, aby zobaczyć, jak to podejście przekłada się na Twoją hurtownię danych, potoki i stos alertów.
Najczęściej zadawane pytania
Czym jest wykrywanie anomalii w bazie danych?
To traktowanie samej hurtowni jako monitorowanej powierzchni zamiast sprawdzania pulpitów trzy narzędzia dalej. Jeśli dane zmieniły się w sposób, którego pulpit sam nie wyjaśni, warstwa wykrywania powinna działać tam, gdzie dane powstają.
Jakie cechy SQL wyliczać najpierw?
Agregaty kroczące w oknach 7- i 28-dniowych, liczone per dzień i per wskaźnik, aby każdy sygnał zachował własną historię. Dodaj opóźnione delty dla zmian dzień do dnia i tydzień do tygodnia, użyj percentyli dla przesunięć rozkładu, które ukrywają średnie, i zapisz wynik do tabeli cech.
Która funkcja SQL wychwytuje którą awarię?
Trzy pary pokrywają większość przypadków. AVG, STDDEV i COUNT dają kroczącą linię bazową ujawniającą lokalny trend, zmienność i brakujący wolumen. LAG z odejmowaniem daje delty okresowe ujawniające skokowe zmiany. PERCENTILE_CONT daje dryf mediany i wychwytuje przesunięcia rozkładu ukryte przez średnie.
Kiedy statystyczne linie bazowe powinny ustąpić modelom uczonym?
Statystyczne linie bazowe pozostają właściwym punktem wyjścia dla wielu tabel produkcyjnych, a ich słabość ujawnia się, gdy szereg robi się niespokojny, z sezonowością, cyklami wydań czy efektami segmentów. Benchmarki potwierdzają, że jakość wykrywania silnie zależy od danych.
Czy są dowody, że wybór algorytmu ma znaczenie?
Tak, choć znaczy mniej niż same dane. Benchmark ADBench przetestował 30 algorytmów na 57 zbiorach referencyjnych w 98 436 eksperymentach, badając poziom nadzoru, typ anomalii i warunki szumu, i potwierdził, że jakość silnie zależy od danych, a nie rozstrzyga jej jeden zwycięzca.



