Testowanie jakości danych: praktyczny przewodnik
|
7
min. czyt.

W branżowym badaniu z 2026 r. 68 % respondentów stwierdziło, że wykrycie incydentu danych zajęło cztery godziny lub więcej, wobec 62 % w 2022 r.. Średni czas naprawy incydentu wzrósł też o 166 %, do 15 godzin na incydent (badanie jakości danych Monte Carlo). Te liczby zmieniają sposób oceny testowania jakości danych. Pytanie nie brzmi wyłącznie, czy reguła rozpozna nieprawidłową wartość. Brzmi: jak szybko Twój zespół odkryje awarię, zrozumie jej zasięg i powstrzyma niewiarygodne dane przed dotarciem do pulpitów, modeli i systemów operacyjnych.
Statyczne testy SQL wciąż mają swoje miejsce. Są precyzyjne, łatwe do przeglądu i przydatne dla stabilnych reguł biznesowych. Ale okresowe kontrole zostawiają luki między uruchomieniami, a ręcznie utrzymywane reguły rzadko nadążają za zmieniającymi się schematami, harmonogramami dostaw i zachowaniem danych. Skuteczne testowanie jakości danych łączy walidację deterministyczną z ciągłą observability, dzięki czemu zespoły monitorują zarówno poprawność, jak i czas potrzebny na wykrycie awarii i powrót do normy.
Spis treści
Rosnący koszt spóźnionych incydentów danych
Incydent danych staje się kosztowny, gdy wykrycie przychodzi po tym, jak dane już posłużyły. Zepsuty pulpit, zakwestionowany KPI albo skażony model potrafią uruchomić dochodzenie w pipeline'ach i u odbiorców. Inżynierowie odtwarzają wtedy zmianę, wskazują dotknięte zbiory i decydują, które wyniki wymagają przebudowy.
68 % respondentów raportowało czasy wykrycia wynoszące cztery godziny lub więcej, wobec 62 % w 2022 r., a średni czas naprawy wzrósł o 166 % do 15 godzin na incydent (wyniki badania Monte Carlo). Te liczby opisują czas ekspozycji, a nie samą wydajność testów. W tym przedziale niewiarygodne informacje mogą przechodzić przez raporty, ekstrakty, aplikacje i przepływy uczenia maszynowego.
MTTD i MTTR należą do rozmowy o jakości
Tradycyjne testowanie jakości danych sprawdza, czy rekordy spełniają warunki takie jak pola niepuste, prawidłowe typy czy dopuszczalne zakresy. Te asercje mierzą poprawność w chwili uruchomienia. Nie pokazują, jak długo organizacja nie wiedziała, że warunek został naruszony.
Średni czas do wykrycia, czyli MTTD, mierzy opóźnienie, zanim zespół dowie się o incydencie. Średni czas do przywrócenia, czyli MTTR, mierzy, ile trwa odtworzenie wiarygodnych danych lub sprawnego pipeline'u. Zestaw testów może dawać trafne wyniki zaliczeń i niepowodzeń, a mimo to wystawiać biznes na możliwe do uniknięcia ryzyko, jeśli alerty przychodzą późno.
Zasada praktyczna: Traktuj każdą kontrolę jakości jak sygnał operacyjny. Zapisz, kiedy warunek się zmienił, kiedy system to wykrył, kto dostał alert i kiedy dotknięte dane znów nadawały się do użytku.
Zaplanowane testy zostawiają ślepe przedziały. Między kontrolami źródło może przestać ładować, dodać kolumnę, zmienić typ albo wytworzyć nieznany rozkład. Ciągła observability zwęża ten przedział, oceniając świeżość, schemat, wartości i sygnały platformy w trakcie przepływu danych, zamiast czekać na kolejne uruchomienie testów.
Priorytet incydentu powinien odzwierciedlać wpływ biznesowy. Opóźniony KPI zarządu, awaria kanału regulacyjnego i problem z nieużywaną tabelą staging nie powinny dostawać tej samej pilności. Lineage, własność i użycie poniżej pomagają kierować uwagę na awarie mogące dotknąć decyzje lub krytycznych odbiorców. Zespoły mogą też użyć narzędzia do oszacowania operacyjnego kosztu przestoju danych przy wyborze, które kontrole i ścieżki alertów zasługują na inwestycję.
Cel operacyjny jest jasny: poprawność pozostaje konieczna, ale opóźnienie wykrycia decyduje, jak daleko zawędruje awaria. Testowanie jakości danych daje więcej wartości, gdy dostarcza inżynierom dowodów na czas, użytecznego kontekstu i prostej drogi od anomalii do przyczyny źródłowej.
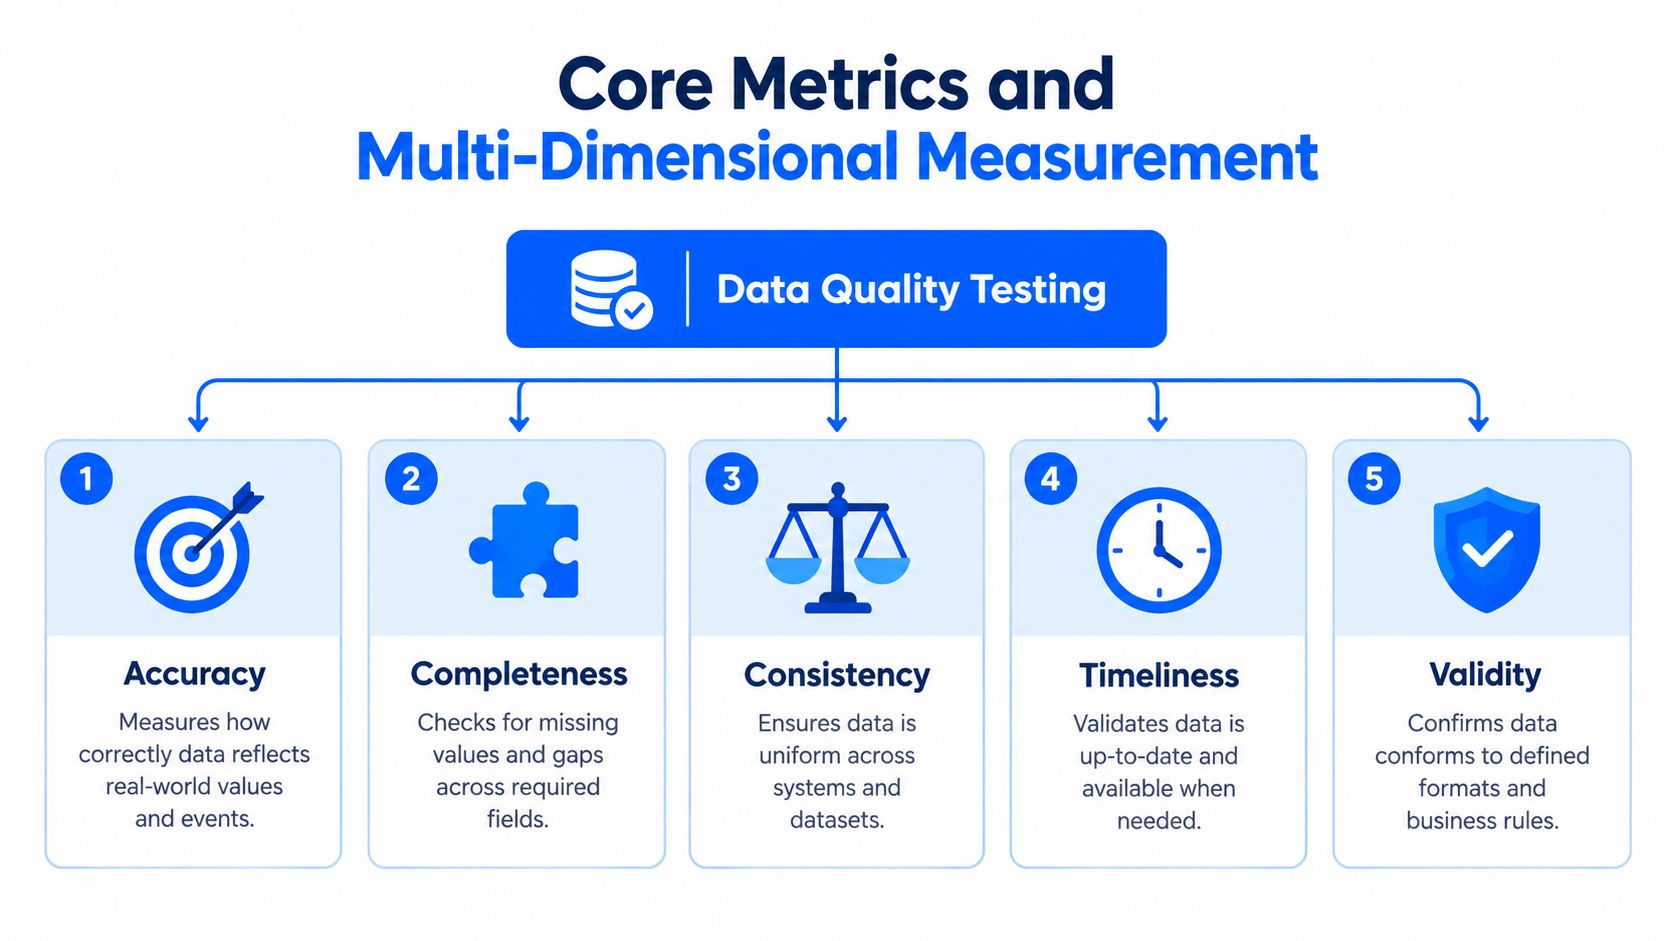
Kluczowe metryki i pomiar wielowymiarowy
Wiarygodny program jakości potrzebuje czegoś więcej niż jednego procentu na pulpicie. Profilowanie ustala statystyczne linie bazowe, a wymiary jakości danych pokazują, czy zbiór pozostaje przydatny do zamierzonego użycia. Pytanie operacyjne brzmi, jak szybko istotne odchylenie staje się widoczne, a nie tylko czy zaplanowana asercja w końcu zawiedzie.
Zacznij od kształtu danych
Sprofiluj zbiór, zanim zdecydujesz, które kontrole egzekwować. Użyteczne wyniki obejmują:
Wolumen i struktura: Liczby wierszy i kolumn ujawniają brakujące ładowania, nieoczekiwany wzrost i zmiany strukturalne.
Braki: Odsetki wartości null pokazują, czy pola wymagane tracą kompletność.
Kardynalność: Liczby wartości unikalnych i duplikatów wskazują powtórzenia, złamaną unikalność i problemy tożsamości.
Rozkład: Minimum, maksimum, średnia, mediana, odchylenie standardowe, skośność i wzorce częstości pokazują, czy wartości wciąż odpowiadają oczekiwanemu zachowaniu.
Standard jakości danych OpenMetadata obejmuje te miary profilowania obok wskaźników operacyjnych, takich jak odsetek zaliczonych i niezaliczonych testów oraz średni czas wykrycia i naprawy problemów. To połączenie łączy dwa spojrzenia. Profilowanie opisuje, co zmieniło się w danych, a miary operacyjne pokazują, czy zespół wykrył i obsłużył tę zmianę dość szybko.
Testuj więcej niż treść
Kontrole schematu i kompletności mogą przejść, podczas gdy zbiór pozostaje nieprzydatny dla modelu lub procesu biznesowego. Wartości mogą mieć prawidłowe typy i mało wartości null, a mimo to pochodzić z niewiarygodnego źródła, odzwierciedlać nieaktualne warunki albo odbijać niezrównoważoną populację.
Podsumowanie ram ETSI wymienia 18 metryk obejmujących jakość podstawową, użyteczność, sprawiedliwość i prywatność. Omówienie ram ETSI to podsumowanie TelecomTV, a nie sama publikacja ram. Jego zakres obejmuje kompletność, dokładność, spójność, lineage, identyfikowalność, terminowość, jakość etykiet i obciążenie. Razem te wymiary definiują jakość przez treść, kontekst i governance.
Warstwowy projekt pomiaru powinien pytać:
Czy dane są obecne i strukturalnie prawidłowe?
Czy wiernie odzwierciedlają zamierzone zdarzenia lub obiekty?
Czy pozostają spójne między systemami i transformacjami?
Czy dotarły w oknie biznesowym?
Czy zespół potrafi prześledzić ich pochodzenie, transformacje, etykiety i dozwolone użycia?
Czy wspierają sprawiedliwą i dbającą o prywatność analitykę albo rozwój modeli?
Progi zależą od celu. Zbiór finansowy może wymagać ścisłego uzgadniania i identyfikowalności. Zbiór eksploracyjny może tolerować niepełne pola, a wciąż potrzebować świeżości i lineage. Stosuj tylko te kontrole, które mogą unieważnić zamierzone użycie, a potem monitoruj te sygnały nieprzerwanie, by awarie jakości ujawniały się, zanim oprą się na nich decyzje poniżej.
Testowanie oparte na regułach a ciągła observability
Ręcznie pisane reguły dają kontrolę. Asercja SQL potrafi wyrazić dokładne oczekiwanie, na przykład że klucz musi być unikalny albo że wartość statusu musi należeć do zatwierdzonej listy. Ten determinizm jest cenny dla kontraktowej logiki biznesowej, kontroli regulacyjnych i transformacji o znanym zachowaniu docelowym.
Problem pojawia się, gdy zespoły traktują statyczne reguły jako jedyną linię obrony. Każde nowe źródło, tabela, kolumna i wyjątek tworzą więcej pracy utrzymaniowej. Progi się starzeją, pokrycie testami zostaje skupione na najbardziej widocznych zbiorach, a inżynierowie tracą czas na aktualizowanie kontroli zamiast badania istotnych zmian.
Różnicę łatwiej ocenić zestawioną obok siebie:
Wymiar | Testowanie oparte na regułach | Ciągła observability |
|---|---|---|
Główny mechanizm | Jawne asercje SQL i stałe warunki | Telemetria, profilowanie, linie bazowe i wykrywanie anomalii |
Najlepsze dopasowanie | Stabilne reguły biznesowe i zobowiązania kontraktowe | Zmieniające się pipeline'y i nieznane tryby awarii |
Mocna strona | Przejrzysty i deterministyczny | Szerokie pokrycie przy mniejszym ręcznym zarządzaniu progami |
Słaba strona | Utrzymanie rośnie wraz ze zmianami systemów | Alerty wymagają kontekstu i czasem dochodzenia |
Typowy sygnał | Zaliczenie lub niepowodzenie wobec zdefiniowanej reguły | Odchylenie od oczekiwanego zachowania w czasie |
Reakcja na incydent | Często zaczyna się po nieudanej kontroli | Potrafi wcześniej ujawnić zmiany świeżości, schematu i rozkładu |
Używaj każdego podejścia tam, gdzie daje dźwignię
Deterministyczne reguły powinny strzec niezmienników. Przykłady to integralność referencyjna, dozwolone listy kodów, logika uzgodnień i wymogi pól obowiązkowych. Takie kontrole wyjaśniają dokładnie, co zawiodło i dlaczego, co czyni je odpowiednimi dla bramek wydania i dowodów audytowych.
Observability radzi sobie z zachowaniem trudnym do wyczerpującego zakodowania. Uczenie linii bazowej potrafi rozpoznać nietypowe wolumeny, brakujące ładowania, dryf schematu albo rozkłady wartości bez wymagania, by inżynier przewidział każdą prawidłową odmianę. Badania operacyjne przytaczane w analizach monitorowania hurtowni i jakości danych wiążą obserwację anomalii wolumenu, schematu i wartości z niższymi MTTD i MTTR, bo telemetria ujawnia awarie bliżej momentu ich powstania.
Statyczne reguły mówią, czy znany warunek zawiódł. Observability pomaga ujawnić, że system zachowuje się inaczej, zanim wiadomo, jaki warunek napisać.
To nie czyni automatycznego wykrywania anomalii zamiennikiem inżynierskiego osądu. Zmiana sezonowa może wyglądać nienormalnie, a uprawnione dodanie do schematu może wywołać alert. Zespoły wciąż potrzebują własności, lineage, kontekstu incydentu i przepływów wyciszania. Praktyczny wzorzec łączy jawne kontrole dla znanych zobowiązań z adaptacyjnym monitorowaniem dla zmian nieznanych.
Inżynierowie pracujący na styku niezawodności oprogramowania i danych mogą też skorzystać z przeglądu pracy w zapewnianiu jakości, zwłaszcza tam, gdzie projektowanie testów, triage defektów i dyscyplina wydań nakładają się na eksploatację pipeline'ów danych. Skupione ujęcie modelu hybrydowego znajdziesz w tekście reguły walidacji danych i ciągła jakość danych.
Dopasowanie kontroli technicznych do kontekstu biznesowego
Pipeline może raportować wysoki odsetek zaliczonych testów i mimo to podkopać decyzję biznesową. Awaria zaczyna się zwykle od rozbieżności między tym, co mierzą inżynierowie, a tym, co interesariusze rozumieją przez „dobre dane”.
Finanse mogą definiować prawidłowy rekord przychodu przez status księgowania, okres rachunkowy, obsługę waluty i uzgodnienie. Marketing może dbać o zgodę, rozpoznanie tożsamości, atrybucję i świeżość kampanii. Operacje mogą stawiać na terminowość dostaw, dostępność zapasu albo pełne pokrycie zdarzeń. Ten sam zbiór bazowy może spełnić definicję jednego zespołu, a nie spełnić definicji drugiego.
Przypisuj kontrole do decyzji, nie tylko do tabel
Zacznij od pytania biznesowego i cofaj się do warunków danych, które czynią odpowiedź wiarygodną. Dla każdego ważnego KPI lub produktu analitycznego udokumentuj:
Odbiorcę: Wskaż zespół lub proces, który polega na wyniku.
Definicję: Zapisz, jak liczone są pojęcia takie jak „aktywny klient”, „przychód netto” albo „dostawa na czas”.
Konsekwencję awarii: Opisz, co staje się błędne, gdy dane są spóźnione, niekompletne, zduplikowane albo źle sklasyfikowane.
Dowody: Określ, które testy, wpisy lineage, uzgodnienia i logi incydentów świadczą, że wynik pozostaje przydatny.
Tworzy to kontrakt jakościowy z celem. Zapobiega też świętowaniu metryki, która pomija właśnie te przypadki, na których zależy interesariuszom.
Uczyń zmieniające się definicje widocznymi
Definicje biznesowe się zmieniają, a wraz z nimi schematy pipeline'ów. Nowa kolumna źródłowa może zmienić złączenie, przemianowane pole może zepsuć model poniżej, a zmieniona definicja KPI może wymusić historyczne uzupełnienia. Lineage oparte na metadanych pomaga ustalić, którzy odbiorcy zależą od pola lub transformacji, a walidacja natywna dla hurtowni trzyma kontrole blisko danych, które chronią.
Pulpity jakości powinny pokazywać zakres, a nie tylko status. Zaliczony wynik potrzebuje widocznej definicji metryki, populacji, okna czasowego i reguły wykluczeń. Inaczej zespoły porównają rzeczy nieporównywalne albo pomylą wąskie pokrycie z ogólną niezawodnością.
Ocena jakości jest użyteczna tylko wtedy, gdy jej odbiorcy rozumieją, co obejmuje, czego nie obejmuje i jaką decyzję chroni.
Najmocniejsze programy pozwalają interesariuszom uczestniczyć w priorytetyzacji bez wymagania od nich pisania SQL. Inżynierowie danych wdrażają kontrole, analitycy weryfikują definicje, a właściciele biznesowi zatwierdzają istotne warunki. Ten podział obowiązków zamienia testowanie jakości danych z inżynierskiej listy kontrolnej w rozliczalną praktykę operacyjną.
Luka governance w zarządzaniu danymi testowymi
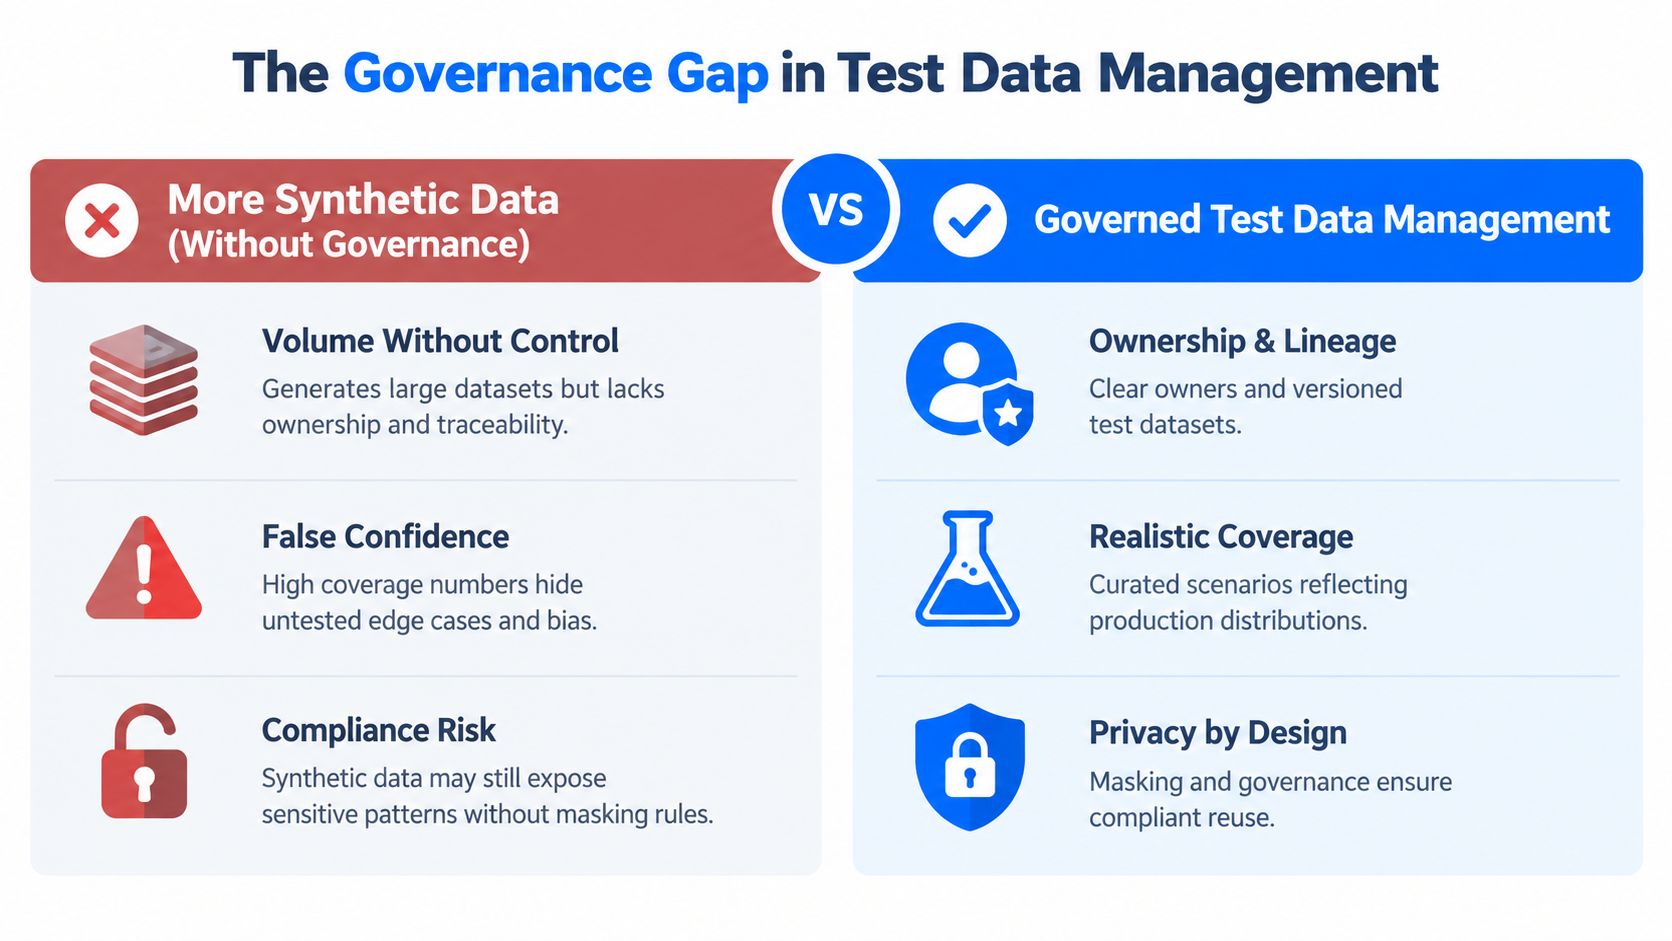
Syntetyczne dane testowe mogą poszerzyć pokrycie scenariuszy, ale sam wolumen nie tworzy wiarygodnego testowania. Zespoły muszą wiedzieć, kto odpowiada za każdy zbiór, jakie cechy produkcyjne on odzwierciedla, jak powstał i czy można go bezpiecznie użyć ponownie.
Podsumowanie World Quality Report 2025–2026 podaje, że 95 % organizacji używa AI do generowania danych testowych, podczas gdy tylko 10 % w pełni zintegrowało zarządzanie danymi testowymi sterowane AI, a blisko 50 % nie ma scentralizowanej własności (podsumowanie World Quality Report). To samo źródło podaje, że 35 % polega na danych syntetycznych w ponad jednej czwartej swoich danych testowych. Razem te ustalenia opisują problem governance, a nie samego generowania.
Więcej danych może ukryć mniejsze pokrycie
Nienadzorowane dane syntetyczne często sprawiają wrażenie produktywnych, bo szybko wytwarzają wiele rekordów. Jednak wygenerowany wolumen może pomijać rzadkie kombinacje, realistyczne rozkłady, nieprawidłowe przejścia albo przypadki brzegowe wywołujące awarie produkcyjne. Zestaw testów może więc wydawać się szeroki, pozostając słabym tam, gdzie skupia się rzeczywiste ryzyko.
Nadzorowane zarządzanie danymi testowymi potrzebuje jasnego modelu operacyjnego:
Własność: Przypisz odpowiedzialność za tworzenie, zatwierdzanie, utrzymanie i wycofanie zbiorów.
Identyfikowalność: Zapisz cechy źródła, logikę generowania, transformacje, wersje i przewidziane scenariusze testowe.
Egzekwowanie polityk: Stosuj maskowanie, dostęp, retencję i ponowne użycie w sposób spójny.
Przegląd pokrycia: Porównuj scenariusze syntetyczne z zachowaniem produkcyjnym i znanymi trybami awarii.
Integracja: Połącz przepływy danych testowych z pipeline'ami dostarczania, wynikami jakości i naprawą incydentów.
Prywatność też wymaga czegoś więcej niż oznaczenia danych jako „syntetyczne”. Wygenerowane rekordy mogą odtwarzać wrażliwe wzorce albo przypominać rzeczywiste rozkłady na tyle blisko, by tworzyć ekspozycję, jeśli zespoły pominą maskowanie i kontrolę dostępu. Governance musi objąć cały cykl życia, od utworzenia po przechowywanie, udostępnianie, wykonanie i usunięcie.
Przewrotny wniosek jest praktyczny: więcej danych syntetycznych nie oznacza automatycznie lepszego testowania. Bez scentralizowanej własności i identyfikowalności mogą dołożyć rozproszenie, fałszywą pewność i martwe pola. Zespoły powinny optymalizować reprezentatywne scenariusze i rozliczalne ponowne użycie, a nie liczbę rekordów.
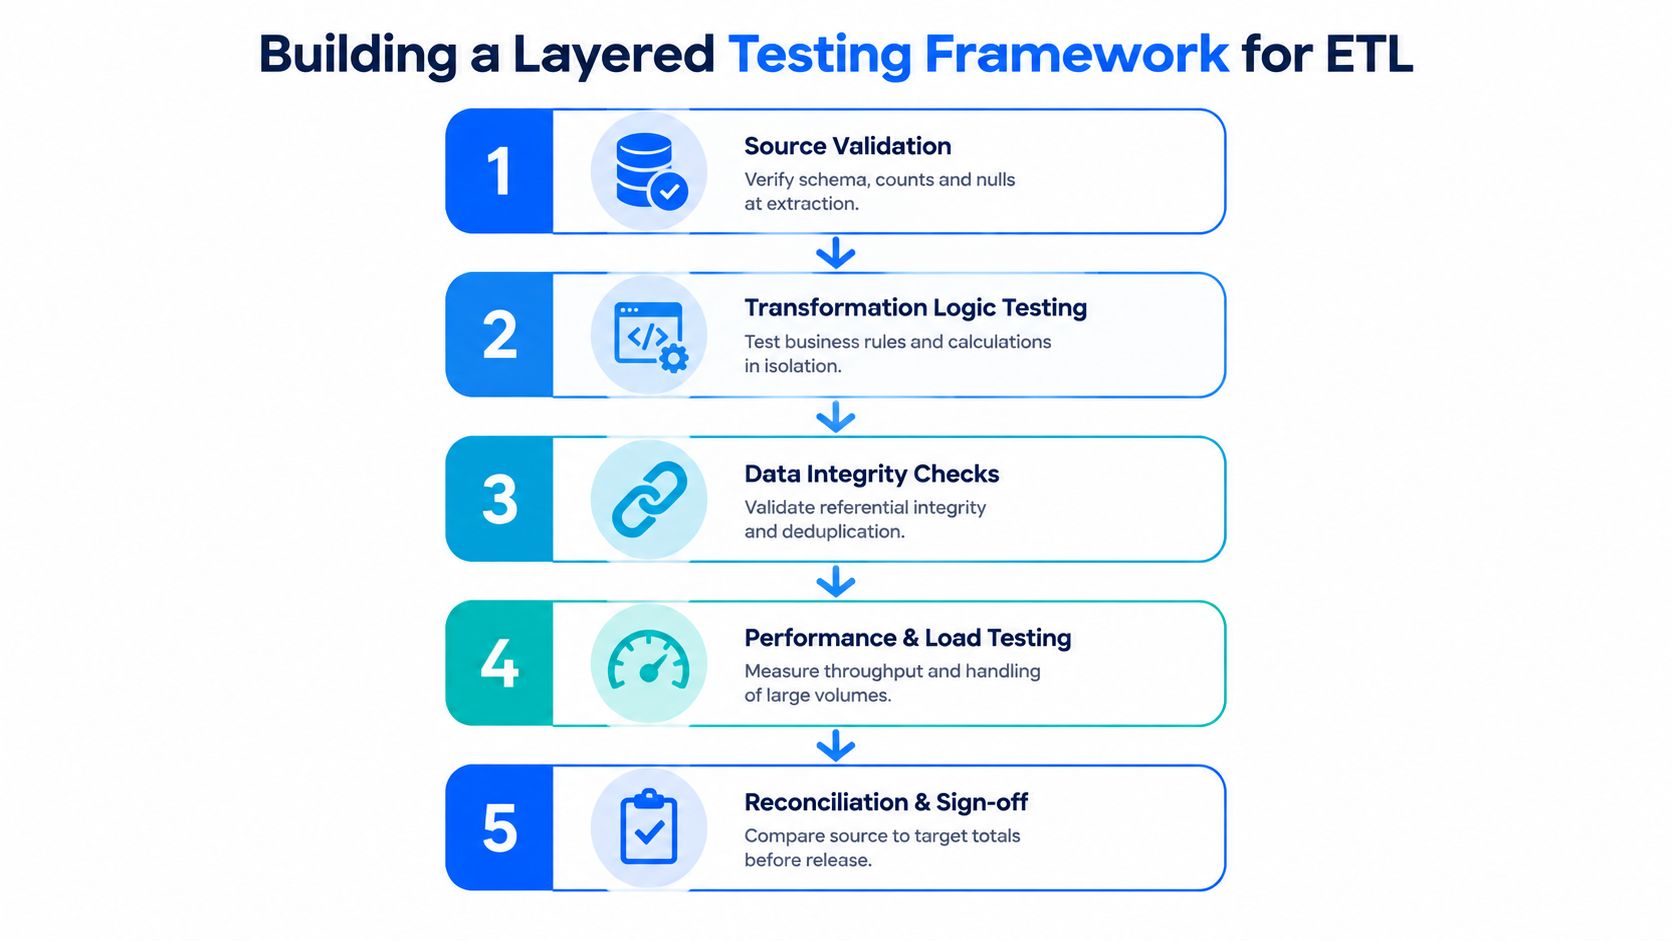
Budowa warstwowego frameworku testów dla ETL
Zadanie ETL powinno pozostawać niezweryfikowane, dopóki nie przejdzie kontroli świeżości, schematu i poziomu rekordu. Uruchamianie tych kontroli po kolei daje inżynierom szybki sposób odróżnienia awarii dostawy od zmian strukturalnych i defektów treści.
Zacznij od dostawy i struktury
Świeżość idzie pierwsza. Potwierdź, że oczekiwane ładowanie dotarło w oknie biznesowym zbioru. Technicznie poprawna tabela z wczorajszymi danymi może wciąż nie nadawać się do decyzji operacyjnej. Alerty Timeliness powinny wyzwalać się, gdy opóźnienie dostawy przekroczy to zdefiniowane okno, zamiast opierać się na ogólnym harmonogramie ignorującym kontekst biznesowy.
Dalej kontrole schematu. Monitoruj dodane kolumny, usunięte kolumny i zmiany typów danych. Część zmian jest zgodna i zamierzona, inne łamią transformacje albo zmieniają znaczenie poniżej bez ostrzeżenia. Alert powinien zawierać dotknięty obiekt, rodzaj zmiany, właściciela i zależności poniżej.
Potem walidacja na poziomie rekordu. Sprawdzaj obecność wartości null, wartości dokładne, progi, zakresy, listy referencyjne, duplikaty, relacje i reguły biznesowe. Trzymaj te kontrole blisko warstwy transformacji albo docelowej, gdzie dostępna jest właściwa semantyka.
Do wdrożenia użyj bramki wydania, która zapisuje każdą warstwę niezależnie:
Walidacja źródła: Potwierdź oczekiwaną strukturę, wolumen i pola wymagane przed transformacją.
Logika transformacji: Testuj obliczenia, mapowania, filtry i reguły biznesowe w izolacji.
Walidacja integralności: Sprawdź relacje referencyjne, unikalność, deduplikację i uzgodnienie.
Obserwacja wydajności: Monitoruj zachowanie wykonania, przepustowość i obsługę obciążenia.
Akceptacja wydania: Porównaj dowody źródła i celu, a potem zapisz decyzję i zatwierdzone wyjątki.
Licz poprawność tam, gdzie żyją dane
Reguły walidacji oparte na SQL mogą wykonywać się natywnie na silniku obliczeniowym źródła, unikając zbędnej ekstrakcji przy kontrolach rekordów. Dokumentacja Actian opisuje konkretne obliczenie poprawności oparte na odsetku rekordów, dla których is_valid = 1 (walidacja jakości danych na poziomie rekordu). Użyteczny nie jest sam etykietowany wskaźnik. Użyteczna jest możliwość policzenia przejrzystego wyniku na poziomie rekordu blisko źródła i zachowania dowodów odrzuconych rekordów do naprawy.
Przegląd pojęć ETL zastosowanych do przepływów testowych znajdziesz w tekście co ETL oznacza w testowaniu oprogramowania. Najważniejszym szczegółem wdrożeniowym jest obsługa niepowodzeń. Nieudana kontrola świeżości powinna zatrzymać albo odizolować publikację poniżej, a niewielka liczba nieprawidłowych rekordów może trafić do naprawy zależnie od ryzyka zbioru i polityki biznesowej.
Skalowanie jakości dzięki observability w bazie danych
Ciągłe testowanie jakości danych staje się trudne, gdy każda metryka wymaga przenoszenia danych, osobnej infrastruktury i innego interfejsu. Observability w bazie danych zmienia architekturę, licząc i analizując sygnały jakości wewnątrz istniejącego środowiska klienta.
Taki projekt ogranicza zbędny ruch danych i utrzymuje kontrolę dostępu w zgodzie z systemami, które już chronią dane produkcyjne. Pozwala też inżynierom monitorować tabele hurtowni, zasoby jeziora i wyniki pipeline'ów bez tworzenia równoległej kopii wyłącznie do analizy jakości. Dla zespołów o surowych wymaganiach bezpieczeństwa albo governance różnica jest istotna: platforma analizuje dane tam, gdzie się znajdują, zamiast wymagać, by rekordy produkcyjne opuściły środowisko.
Połącz statystykę, reguły i kontekst operacyjny
Praktyczna warstwa observability powinna łączyć kilka form dowodów:
Statystyczne linie bazowe: Ucz się normalnego wolumenu, rozkładów i zmienności dla każdego zbioru.
Walidacja deterministyczna: Egzekwuj reguły biznesowe i ograniczenia na poziomie rekordu.
Monitorowanie Timeliness: Wykrywaj dostawy spóźnione, brakujące albo nieoczekiwanie wczesne.
Śledzenie schematu: Rozpoznawaj dodane lub usunięte kolumny i zmiany typów.
Lineage i własność: Łącz incydenty z dotkniętymi odbiorcami i odpowiedzialnymi zespołami.
Wspólny status: Daj inżynierom, analitykom i interesariuszom biznesowym wspólny obraz jakości.
Podejście wykonania kontroli jakości w bazie danych przydaje się, gdy zespoły potrzebują tych mechanizmów bez eksportowania wrażliwych danych produkcyjnych. Kompromisem jest to, że observability nadal wymaga przemyślanej konfiguracji. Linie bazowe potrafią generować hałaśliwe alerty, jeśli zespoły ignorują sezonowość, własność jest niejasna albo odbiorcy nie widzą, dlaczego incydent ma znaczenie.
Trwały model operacyjny traktuje jakość danych jak poziom usługi dla informacji. Zespoły definiują, co musi być poprawne, co musi dotrzeć na czas i które zmiany wymagają przeglądu. Monitorowanie mierzy potem nie tylko to, czy warunek zawiódł, ale też jak szybko ludzie to wykryli i naprawili.
Testowanie jakości danych nie jest jednorazowym zadaniem migracyjnym. To ciągła praktyka chroniąca analitykę, raportowanie i systemy AI przed cichymi zmianami i spóźnioną reakcją.
digna dostarcza wykrywanie anomalii w bazie danych, walidację na poziomie rekordu, monitorowanie Timeliness i śledzenie schematu wewnątrz Twojego własnego środowiska danych. Odwiedź dignę, by ocenić, jak jej modułowa platforma observability może pomóc zespołowi wcześniej wykrywać awarie jakości i łączyć incydenty techniczne ze zbiorami oraz decyzjami, których dotyczą.
Testy mówią, że reguła zawiodła; obserwowalność platformy danych mówi, która zmiana powyżej to spowodowała — i to właśnie obniża MTTR, a nie samo MTTD.
Najczęściej zadawane pytania
Jak długo trwa dziś wykrycie incydentu danych?
Dłużej niż kiedyś. W branżowym badaniu z 2026 r. 68 % respondentów wskazało wykrycie po czterech godzinach lub później, wobec 62 % w 2022 r., a średni czas naprawy wzrósł o 166 % do 15 godzin na incydent.
Dlaczego MTTD i MTTR należą do programu jakości?
Bo sama poprawność nie ogranicza szkód. Średni czas do wykrycia mierzy opóźnienie, zanim zespół dowie się o incydencie, a opóźnienie wykrycia decyduje, jak daleko awaria zawędruje, nim ktokolwiek ją zatrzyma.
Co zestaw testów powinien sprofilować najpierw?
Kształt danych: wolumen i strukturę, by ujawnić brakujące ładowania i zmiany strukturalne, braki przez odsetki wartości null, kardynalność przez liczby wartości unikalnych i duplikatów oraz rozkład przez minimum, maksimum, średnią, medianę, odchylenie standardowe i skośność.
Czy testowanie treści wystarczy?
Nie. Kontrole schematu i kompletności mogą przejść, podczas gdy zbiór pozostaje nieprzydatny dla modelu lub procesu biznesowego. Podsumowanie ram ETSI wymienia 18 metryk obejmujących jakość podstawową, użyteczność, sprawiedliwość i prywatność.
Gdzie wygrywają reguły, a gdzie observability?
Deterministyczne reguły powinny strzec niezmienników i zobowiązań kontraktowych, tam gdzie liczy się przejrzystość. Observability obejmuje zmieniające się pipeline'y i nieznane tryby awarii, ujawniając zmiany świeżości, schematu i rozkładu, zanim ktoś wie, jaki warunek napisać.



