Jak korzystać z symulacji i metody Monte Carlo
|
7
min. czyt.

Prognoza kosztów potoku danych może wydawać się precyzyjna aż do momentu, gdy system nadrzędny zwolni, liczba prób ponownego uruchomienia gwałtownie wzrośnie lub źródło zacznie przesyłać niekompletne rekordy. Kierownictwo może prosić o jedną konkretną liczbę na kolejny kwartał, podczas gdy zespół ds. danych wie tylko tyle, że opóźnienia, ponowne próby i odsetek wartości null mieszczą się w szerokich, niepewnych przedziałach. Średnie ułatwiają prezentację prognozy, ale mogą ukrywać wyniki, które generują największe ryzyko operacyjne.
Symulacja daje możliwość odtworzenia tych niepewnych warunków zanim wpłyną one na produkcję. Zamiast pytać tylko: „Ile będzie kosztować potok w typowych warunkach?”, można zapytać: „Jak zmienia się koszt przy wielu prawdopodobnych kombinacjach opóźnień, ponownych prób i brakujących danych?”. Wynikiem jest rozkład, który ujawnia ryzyko, testuje progi alertów i zmienia założenia w coś, co zespół może poddać inspekcji.
Metoda Monte Carlo jest najczęściej używanym silnikiem do tego przekładu. Wielokrotnie próbkuje ona niepewne dane wejściowe, uruchamia model i agreguje wyniki. Metoda ta powstała w Los Alamos w połowie lat 40. XX wieku i szybko przeszła od fizyki wojennej do szerokiej techniki obliczeniowej, co udokumentowano w relacji z Los Alamos na temat narodzin tej metody. Niniejszy przewodnik łączy jej fundamenty z dyscypliną Data Observability, przedstawiając praktyczne wzorce w językach Python i R dla zakresów metryk, testów przeciążeniowych potoków, wrażliwości na brakujące dane oraz walidacji wykrywania anomalii.
Spis treści
Dlaczego zespoły ds. danych potrzebują symulacji
Od szacunków punktowych do rozkładów ryzyka
Nastawienie zorientowane na produkcję
Zrozumienie symulacji i metody Monte Carlo
Analogia do tarczy strzeleckiej
Odwzorowanie pętli w obszarze observability
Kluczowe podstawy statystyczne
Planowanie prób na podstawie docelowego przedziału
Ostrożna redukcja wariancji
Implementacja metody Monte Carlo
Kompaktowy wzorzec implementacji
Python z NumPy
R z funkcjami bazowymi
Wybory inżynieryjne, które mają znaczenie
Praktyczne zastosowania dla zespołów ds. danych
Zakresy metryk zamiast pozornej precyzji
Obciążenie i wrażliwość
Testowanie detektorów anomalii
Typowe pułapki i najlepsze praktyki
Powtarzalność i jakość danych wejściowych
Zależność i zbieżność
Unikanie nadmiernej pewności siebie przy walidacji
Budowanie wiarygodnych badań symulacyjnych
Dlaczego zespoły ds. danych potrzebują symulacji
Zespół platformy danych przygotowuje prognozę kosztów potoku na kolejny kwartał. Model finansowy wymaga oczekiwanego obciążenia pracą, ale dane wejściowe nie są stałe. Nadrzędne API może dostarczyć dane wcześniej lub później, zachowanie ponownych prób zmienia się pod obciążeniem, a tabele źródłowe mogą zawierać więcej wartości null, niż oczekuje zespół. Pojedyncza średnia dla każdej zmiennej daje czysty arkusz kalkulacyjny, ale niewiele mówi o kombinacjach, które wypychają platformę poza jej budżet lub cele usługowe.
Symulacja zmienia postawienie pytania. Zespół może wygenerować wiele syntetycznych odtworzeń, próbując dla każdej próby prawdopodobne opóźnienia przybycia danych, współczynniki ponownych prób i odsetek wartości null. Każde odtworzenie daje określony wynik, taki jak czas przetwarzania, zużycie zasobów obliczeniowych, uszkodzone rekordy lub szacowany koszt. Zbiór wyników pokazuje, czy decyzja jest stabilna, czy też niewielka zmiana założeń tworzy znaczący „ogon” złych wyników.

Od szacunków punktowych do rozkładów ryzyka
Obliczenia deterministyczne wykorzystują stałe dane wejściowe i zwracają jeden wynik. To podejście jest użyteczne, gdy dane wejściowe są znane i stabilne, ale decyzje dotyczące observability rzadko pasują do tego opisu. Próg świeżości danych może zależeć od zmiennych zachowań związanych z ich nadejściem. Alert dotyczący wolumenu może zależeć od sezonowości, opóźnionego ładowania i filtrowania na wcześniejszych etapach. Kontrola jakości może reagować inaczej w zależności od tego, czy brakujące wartości są losowe, czy też skoncentrowane w segmencie o wysokiej wartości.
Symulacja pozwala inżynierom zmieniać te dane wejściowe jednocześnie. Można wtedy zbadać medianę, wynik skrajny, prawdopodobieństwo awarii lub zakres, w którym mieści się większość prób. Celem nie jest sprawienie, aby niepewność zniknęła. Chodzi o to, aby uczynić niepewność widoczną, zanim pulpit nawigacyjny, alert lub plan wydajności zakoduje nieuzasadnione założenie.
Zasada praktyczna: Jeśli decyzja zależy od danych wejściowych, które można opisać jedynie jako zakresy lub rozkłady, pojedyncze oszacowanie prawdopodobnie ukrywa informacje, których potrzebują interesariusze.
Nastawienie zorientowane na produkcję
Użyteczne badanie symulacyjne zaczyna się od decyzji, a nie od generatora liczb losowych. Zdefiniuj wynik, który ma znaczenie, zidentyfikuj niepewne dane wejściowe, udokumentuj powiązania między nimi i zachowaj wyniki prób do wglądu. Ten sam schemat może wspierać prognozę kosztów, test przeciążeniowy potoku lub sprawdzenie, czy próg anomalii pozostaje użyteczny przy zmianie ruchu.
Poniższe sekcje przekładają to nastawienie na działający wzorzec. Zobaczysz, czym ogólna idea symulacji różni się od metody Monte Carlo, jak zbieżność wpływa na zaufanie do wyników, jak zaimplementować pętlę w językach Python i R oraz jak połączyć wyniki z procesami observability.
Zrozumienie symulacji i metody Monte Carlo
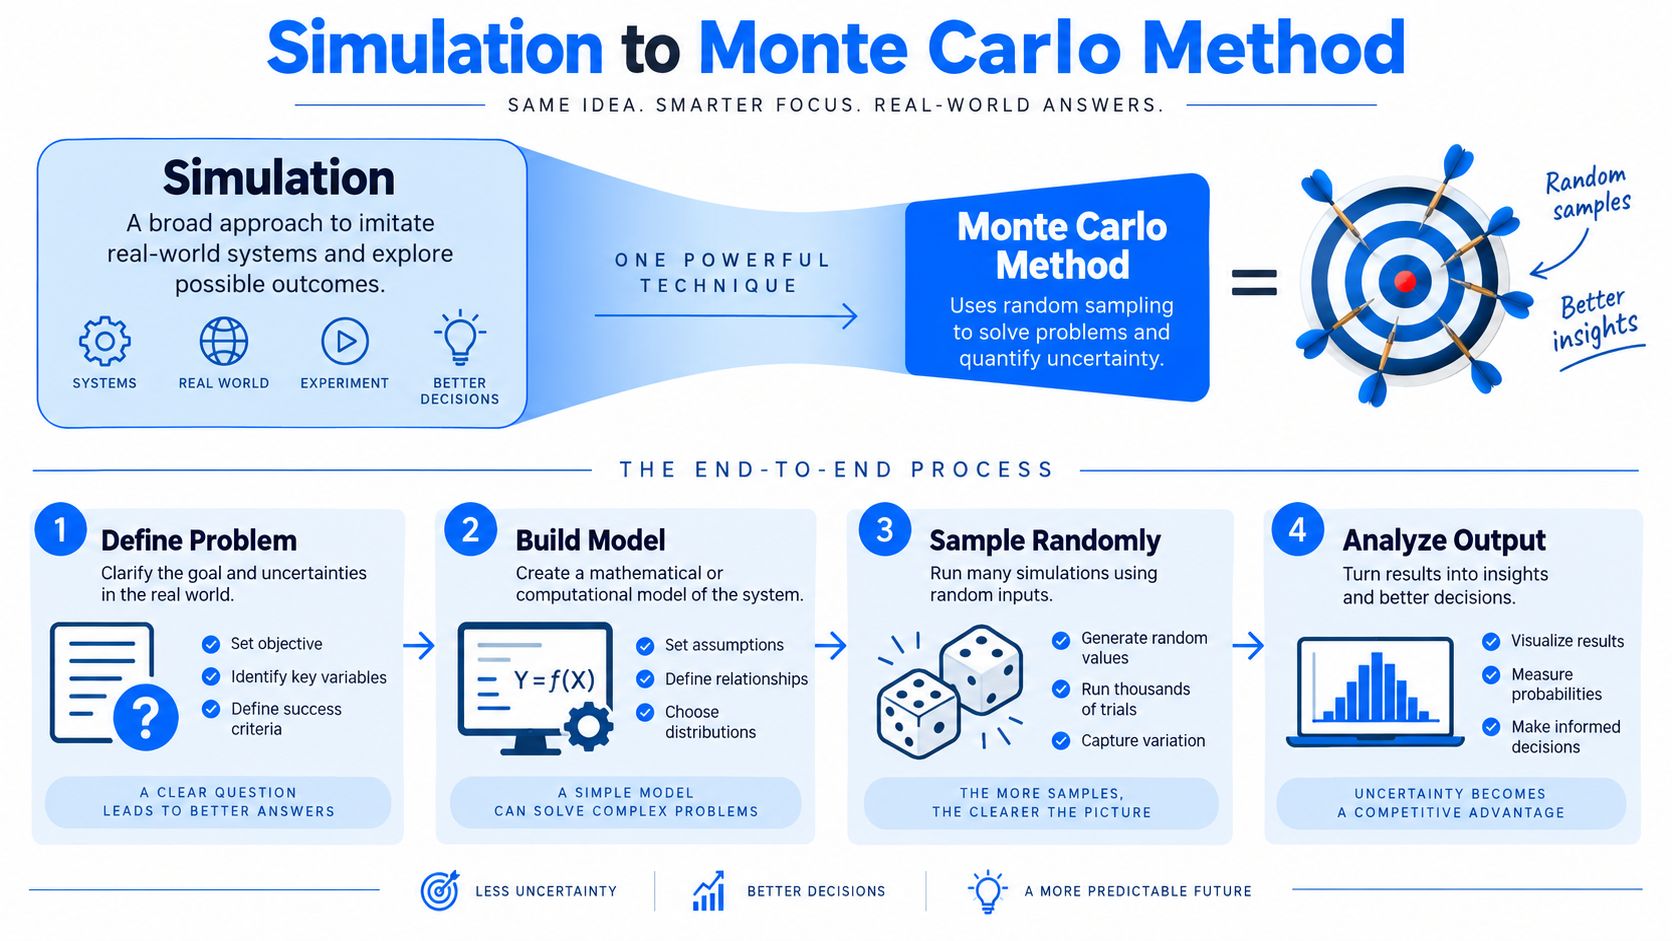
Symulacja to szeroka praktyka naśladowania rzeczywistego procesu za pomocą modelu. Inżynier danych może symulować potok poprzez generowanie przybycia danych, stosowanie transformacji, wprowadzanie awarii i mierzenie czasu zakończenia. Model może reprezentować zdarzenia w czasie, zależności między usługami lub wpływ reguł operacyjnych.
Metoda Monte Carlo to rodzina technik wykorzystujących wielokrotne losowe próbkowanie do oszacowania wyniku numerycznego lub rozkładu wyjściowego. Symulacja może być deterministyczna, sterowana zdarzeniami lub oparta na regułach. Monte Carlo dodaje losowość do danych wejściowych, procesu lub obu tych elementów, a następnie wykorzystuje powtarzane próby do przybliżenia tego, czego bezpośrednie obliczenia mogą nie być w stanie wygodnie rozwiązać.
Analogia do tarczy strzeleckiej
Wyobraź sobie kwadrat zawierający okrągłą tarczę strzelecką. Rzucaj losowo punkty w obrębie kwadratu i zapisuj, czy każdy punkt trafia wewnątrz okręgu. Ułamek punktów wewnątrz okręgu pozwala oszacować pole powierzchni koła w stosunku do kwadratu, co przy odpowiednio zdefiniowanej geometrii pozwala następnie oszacować liczbę pi.
Ten przykład jest użyteczny, ponieważ obnaża rdzeń pętli:
Zdefiniuj dziedzinę. Określ kwadrat i koło.
Próbkuj dane wejściowe. Generuj losowe współrzędne.
Oceń model. Sprawdź, czy każdy punkt wpada w obręb koła.
Agreguj wyniki. Przekształć liczbę trafień w oszacowanie.
Rzutki nie odkrywają ukrytego wzoru. Przybliżają odpowiedź poprzez wielokrotne obserwacje. Większa liczba prób zazwyczaj sprawia, że oszacowanie jest mniej wrażliwe na konkretną losową sekwencję, choć jakość wyniku nadal zależy od modelu i projektu próbkowania.
Odwzorowanie pętli w obszarze observability
W platformie danych kwadrat staje się przestrzenią prawdopodobnych warunków operacyjnych. Losowe współrzędne stają się próbkowanymi wskaźnikami napływu danych, czasami przetwarzania, zdarzeniami awarii lub wzorcami braków. Test koła staje się potokiem, regułą walidacyjną lub detektorem anomalii, który chcesz ocenić. Zagregowany wynik może być kwantylem opóźnienia, współczynnikiem pominiętych alertów lub zakresem metryki biznesowej.
Próba to jedno wykonanie modelu z jednym spróbkowanym zestawem danych wejściowych. Replikacja to powtórne wykonanie mające na celu wygenerowanie kolejnej porównywalnej obserwacji, często przy tych samych założeniach dotyczących modelu i próbkowania. Estymator to obliczenie zastosowane do wyników prób, takie jak średnia, kwantyl lub ułamek przekraczający próg.
Rozkład z próby opisuje, jak ten estymator zmienia się w powtarzanych próbach. Zbieżność oznacza, że estymator staje się wystarczająco stabilny dla decyzji, którą podejmujesz. Nie oznacza to, że model jest poprawny. Zbieżna symulacja ze słabymi założeniami wejściowymi może dać precyzyjną odpowiedź na niewłaściwe pytanie.
Praktyczne ujęcie tematu pod kątem observability można znaleźć w przewodniku digna dotyczącym metod Monte Carlo dla lepszego data observability. Ważnym nawykiem inżynieryjnym jest oddzielenie stochastycznych danych wejściowych od deterministycznej logiki biznesowej. To rozdzielenie umożliwia zastąpienie jednego założenia wejściowego, ponowne uruchomienie tego samego modelu i sprawdzenie, które wnioski ulegają zmianie.
Kluczowe podstawy statystyczne
Wyniki Monte Carlo są szacunkami, a nie gwarancjami. Jeśli każda próba daje wynik (Y_i), prostym estymatorem oczekiwanego wyniku jest średnia z próby:
[
\hat{\mu} = \frac{1}{N}\sum_{i=1}^{N}Y_i
]
Przy odpowiednich założeniach o niezależności i skończonej wariancji, błąd standardowy tego oszacowania wynosi w przybliżeniu:
[
SE(\hat{\mu}) = \frac{s}{\sqrt{N}}
]
Tutaj (s) to obserwowany błąd standardowy próby, a (N) to liczba prób. Zależność ta ma znaczenie operacyjne. Błąd kurczy się w tempie proporcjonalnym do odwrotności pierwiastka kwadratowego z N, więc czterokrotne zwiększenie liczby próby zmniejsza błąd standardowy o połowę. Większa liczba prób pomaga, ale zazwyczaj nie przynosi liniowych zysków.
Planowanie prób na podstawie docelowego przedziału
Zacznij od przebiegu pilotażowego i zmierz wariancję wyjściową. Jeśli chcesz uzyskać dwustronny przedział ufności o przybliżonej połowie szerokości (h) i używasz normalnej wartości krytycznej (z), praktyczny wzór planowania to:
[
N \approx \left(\frac{z s}{h}\right)^2
]
Wzór ten jest przybliżeniem, a nie substytutem sprawdzania zbieżności. Jest najbardziej użyteczny, gdy estymatorem jest średnia, a dane wyjściowe zachowują się przewidywalnie. Kwantyle, prawdopodobieństwa rzadkich zdarzeń, wyniki o ciężkich ogonach i próby zależne wymagają dokładniejszej diagnostyki, ponieważ ich niepewność może być znacznie większa, niż sugerują obliczenia oparte na średniej.
Śledź szacunek kumulatywnie, zamiast sprawdzać tylko ostateczną wartość. Wykreśl średnią ruchomą lub docelowy kwantyl w funkcji liczby prób i porównaj niezależne partie. Jeśli wynik zmienia się znacząco po nadejściu kolejnej partii, symulacja nie jest gotowa na wyciągnięcie ostatecznych wniosków operacyjnych.
Osobną kwestią jest efektywna liczebność próby. Jeśli próby są skorelowane, nominalna wartość (N) zawyża ilość niezależnych informacji. Zjawisko to pojawia się powszechnie, gdy inżynierowie ponownie wykorzystują ślad szeregu czasowego, przenoszą stan między próbami lub próbkowane są powiązane dane wejściowe niezależnie, mimo że produkcja pokazuje, że poruszają się one razem.
Ostrożna redukcja wariancji
Metody redukcji wariancji mogą poprawić precyzję bez konieczności uruchamiania większej liczby prób. Mogą one również utrudnić wyjaśnienie modelu, dlatego należy ich używać, gdy bazowa symulacja jest poprawna, a pozostałą niepewność warto optymalizować.
Technika | Główna idea | Najlepsze zastosowanie | Złożoność | Oczekiwana redukcja błędu |
|---|---|---|---|---|
Zmienne antytetyczne | Połączenie losowego losowania z losowaniem dopełniającym | Gładkie modele, w których sparowane wyniki mają tendencję do wzajemnego znoszenia się | Niska | Zależy od ujemnej korelacji między sparowanymi wynikami |
Zmienne kontrolne | Korygowanie szacunku przy użyciu powiązanej wielkości o znanym zachowaniu | Modele z silnymi obliczeniami referencyjnymi | Średnia | Zależy od relacji z wartością kontrolną |
Próbkowanie według ważności | Częstsze próbkowanie wpływowych obszarów i ponowne ważenie wyników | Rzadkie zdarzenia i prawdopodobieństwa ogonowe | Wysoka | Może być znaczna, gdy rozkład propozycji jest dobrze dobrany |
Próbkowanie warstwowe | Podział przestrzeni wejściowej na grupy i celowe próbkowanie każdej z nich | Niejednorodne populacje lub nierówne zakresy wejściowe | Średnia | Zależy od wariancji wewnątrzwarstwowej |
Więcej informacji na temat wyboru technik statystycznych można znaleźć w opracowaniu digna dotyczącym metod statystycznych do analizy danych. Podczas przeglądu projektu wyjaśnij nie tylko fakt, że wariancja spadła, ale także to, które założenie sprawia, że technika jest prawidłowa oraz w jaki sposób zweryfikowano logikę ważenia lub parowania.
Implementacja metody Monte Carlo
Powtarzalna implementacja oddziela model od losowych danych wejściowych. Taka konstrukcja pozwala testować alternatywne rozkłady bez konieczności przepisywania logiki potoku.
Kompaktowy wzorzec implementacji
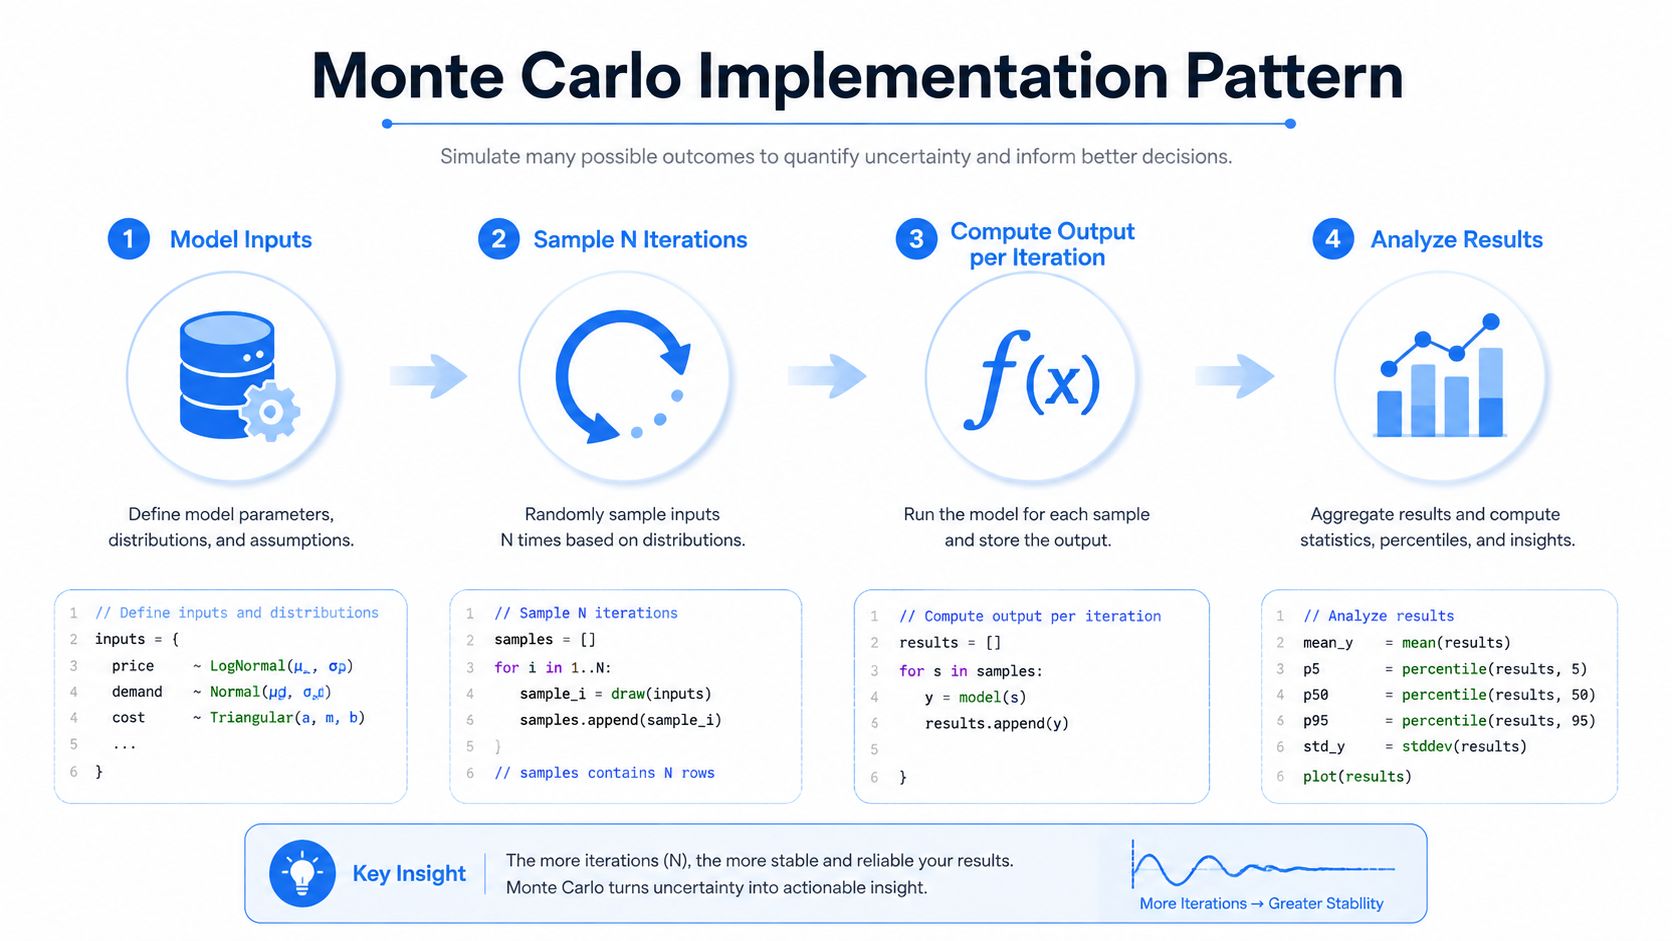
Użyj tego pseudokodu jako szkieletu:
Zdefiniuj dane wejściowe modelu i ich rozkłady.
Ustaw strategię ziarna generatora (seed) i wybierz liczbę iteracji (N).
Próbkuj niepewne dane wejściowe.
Oblicz jeden wynik dla każdej iteracji.
Zagreguj wyniki prób.
Raportuj oszacowanie i przedział niepewności.
Zapisz surowe wyniki i informacje diagnostyczne.
Model powinien być deterministyczny po dostarczeniu jego próbkowanych danych wejściowych. Jeśli obliczenia wyjściowe zawierają ukrytą losowość, ujawnij ją jako kolejny strumień wejściowy, aby można było ją odtworzyć i poddać audytowi.
Python z NumPy
Poniższy przykład szacuje kwantyl opóźnienia potoku, gdy czas obsługi charakteryzuje się prawostronną skośnością. Rozkład logarytmicznie normalny jest rozsądną demonstracją dla dodatnich, skośnych czasów obsługi, ale parametry produkcyjne powinny pochodzić z obserwowanych danych lub udokumentowanego założenia.
Ten kod traktuje każde uruchomienie jako syntetyczną partię zawierającą wiele czasów obsługi, a następnie oblicza całkowite opóźnienie na uruchomienie. Ostateczny kwantyl opisuje symulowany rozkład wyjściowy, podczas gdy przedział pokazuje zakres między wybranymi kwantylami wyjściowymi. Nie nazywaj tego przedziału formalnym przedziałem ufności bez sprawdzenia estymatora i projektu próbkowania. Na potrzeby formalnego badania oszacuj niepewność wokół samego kwantyla, często poprzez dzielenie na partie lub ponowne próbkowanie.
R z funkcjami bazowymi
Ta sama struktura działa w języku R. Funkcja rlnorm() generuje dodatnie, skośne wartości, a funkcja quantile() podsumowuje wynikowy wektor wyjściowy.
Stałe ziarno (seed) sprawia, że przebieg deweloperski jest powtarzalny, ale produkcyjna strategia generowania ziarna wymaga udokumentowania. Możesz używać rejestrowanego, stałego ziarna do celów audytu, odrębnych ziaren dla procesów równoległych lub kontrolowanego ziarna generowanego przez system orkiestracji. Przechowuj ziarno wraz z konfiguracją i wersją modelu.
Wybory inżynieryjne, które mają znaczenie
Wektoryzowane operacje NumPy zazwyczaj przewyższają pętle na poziomie Pythona w przypadku dużych obciążeń numerycznych. Jeśli macierz jest zbyt duża dla pamięci operacyjnej, losuj i przetwarzaj dane partiami, zachowując tylko statystyki lub surowe wyniki wymagane przez proces governance. Trzymaj próbnik rozkładu, model deterministyczny, estymator i kod raportowania w osobnych funkcjach, aby recenzenci mogli niezależnie przetestować każdą warstwę.
Dla przepływów wykrywania anomalii opartych na języku Python, materiały digna dotyczące wykrywania anomalii danych w Pythonie stanowią odpowiedni punkt integracji. Środowisko symulacyjne może współistnieć z monitorowaniem, zamiast je zastępować, generując scenariusze przeciążeniowe, które pomagają ocenić zachowanie detektora przed dostrojeniem progu produkcyjnego.
Praktyczne zastosowania dla zespołów ds. danych
Metoda Monte Carlo staje się użyteczna, gdy odpowiada na pytania decyzyjne, których obecny pulpit nawigacyjny nie jest w stanie rozstrzygnąć. Pulpit może pokazywać aktualną świeżość, wolumen lub metrykę jakości. Symulacja może pokazać, jak ta metryka zachowuje się, gdy kilka niepewnych warunków występuje jednocześnie.
Cztery poniższe zastosowania korzystają z tego samego podstawowego schematu, ale każde z nich wymaga innych założeń wejściowych i generuje inny artefakt dla interesariuszy.
Zastosowanie | Model wejściowy | Typowa liczba iteracji | Artefakt wyjściowy |
|---|---|---|---|
Zakresy dziennej liczby aktywnych użytkowników (DAU) | Historyczne wzorce aktywności, opóźnienia w raportowaniu i prawdopodobne braki danych | Wybierane na podstawie testów zbieżności | Wykres zakresu z oszacowaniem centralnym i granicami niepewności |
Testy przeciążeniowe ETL | Zmienność wskaźnika napływu danych, czas przetwarzania oraz zachowanie przy błędach lub ponownych próbach | Wybierane w celu ustabilizowania metryk ogonowych | Raport dotyczący wydajności i ryzyka awarii |
Wrażliwość na brakujące dane | Wzorce brakujących wierszy według segmentu zbioru danych i udziału w metrykach | Wybierane w celu porównania scenariuszy braków danych | Tabela wrażliwości KPI i rozkład wpływu |
Walidacja progów anomalii | Syntetyczne zmiany ruchu, zmienność bazowa i wprowadzone anomalie | Wybierane w celu porównania wyników wykrywania | Przegląd precyzji (precision) i pełności (recall) w różnych scenariuszach |
Zakresy metryk zamiast pozornej precyzji
Załóżmy, że raport dla kierownictwa wymaga podania zakresu dziennej liczby aktywnych użytkowników. Zespół może próbować aktywność z rozkładu empirycznego, a następnie różnicować opóźnienia ładowania i brakujące rekordy. Wynik nie zastępuje obserwowanej metryki. Jest to sposób na pokazanie, o ile raportowana wartość mogłaby się zmienić w prawdopodobnych warunkach danych.
Artefakt powinien jasno określać założenia. Interesariusze muszą wiedzieć, czy zakres odzwierciedla naturalną zmienność zachowań, degradację potoku, braki danych, czy wszystkie te trzy czynniki. Jeśli symulacja wykorzystuje niezależne losowania dla danych wejściowych, które normalnie zmieniają się razem, zakres może być myląco wąski lub niepotrzebnie szeroki.
Obciążenie i wrażliwość
W przypadku testów przeciążeniowych ETL należy wprowadzić zakłócenia (jitter) do wskaźników napływu danych i czasów przetwarzania, a następnie modelować ponowne próby i ścieżki awarii. Zbadaj nie tylko średni czas zakończenia, ale także ogon rozkładu, wzrost kolejek i punkt, w którym umowy SLA na niższych etapach kończą się niepowodzeniem. Test przeciążeniowy jest cenny, ponieważ ujawnia interakcje, których nie ujawni odtworzenie typowego dnia.
Analiza brakujących danych zasługuje na osobne traktowanie. Losowe usuwanie wierszy może zaniżać skalę szkód, gdy braki koncentrują się w określonym produkcie, regionie, poziomie klienta lub oknie czasowym. Uruchom osobne mechanizmy braków danych i porównaj wynikowe rozkłady wskaźników KPI dotyczących przychodów lub odpływu klientów (churn). Opublikowany artefakt powinien identyfikować, które segmenty napędzają zmianę, a nie tylko prezentować jedną ogólną korektę.
Testing anomaly detectors
Detektor anomalii potrzebuje czegoś więcej niż tylko progu, który wygląda rozsądnie na danych historycznych. Wygeneruj syntetyczny ruch zawierający normalną zmienność, opóźnione przybycia, przesunięcia wolumenu i znane wstrzyknięte Data Anomalies. Zmierz, czy detektor alarmuje wtedy, kiedy powinien, milczy podczas oczekiwanej zmienności i pozostaje użyteczny, gdy zmienia się linia bazowa.
Metoda Monte Carlo uzupełnia observability, zamiast je zastępować. Monitorowanie produkcji rejestruje to, co się wydarzyło. Symulacja bada, co mogłoby się wydarzyć przy określonych założeniach. Praktyczny przykład tego powiązania można znaleźć w artykule wykrywanie anomalii danych za pomocą symulacji Monte Carlo.
Typowe pułapki i najlepsze praktyki
Symulacja może zakończyć się niepowodzeniem po cichu, ponieważ kod działa pomyślnie, podczas gdy założenia oddalają się od realiów produkcji. Losowość dodaje elastyczności, ale tworzy też więcej sposobów na to, by pozornie rygorystyczny wynik maskował błąd modelowania.
Powtarzalność i jakość danych wejściowych
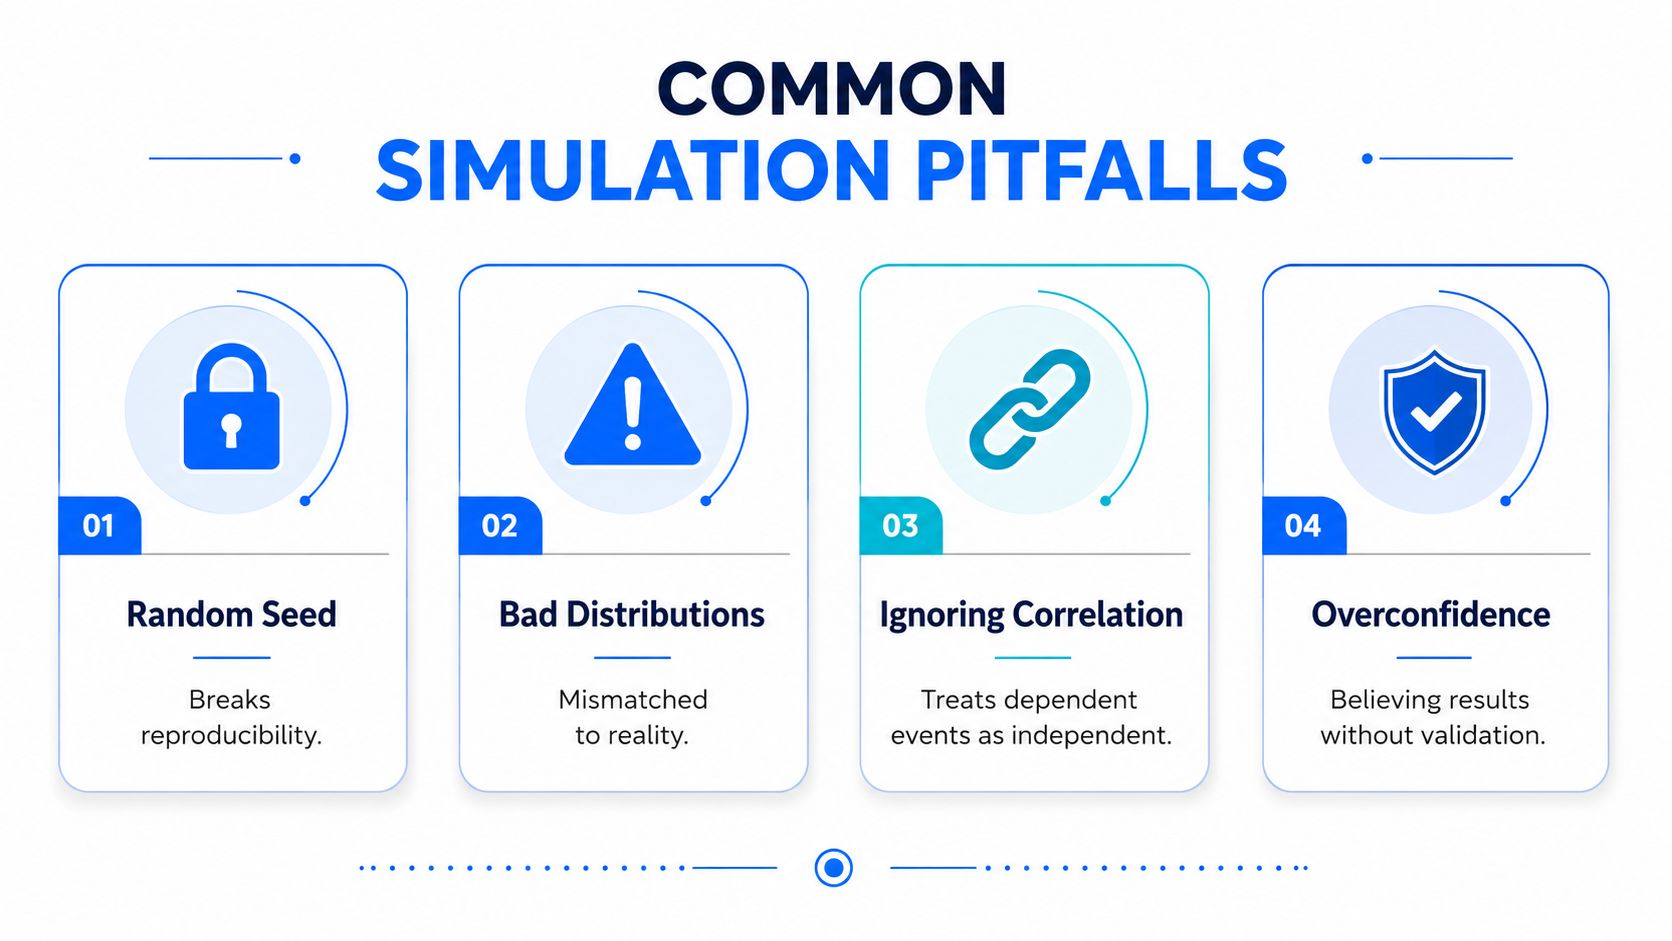
Nieuawnione ziarno (seed) utrudnia odtworzenie wyniku. Recenzent może uruchomić ten sam kod i otrzymać inny wynik, a następnie pomylić normalną zmienność próbkowania ze zmianą logiki. Zapisuj ziarno, generator, wersję modelu, konfigurację i migawkę danych wejściowych razem.
Rozkład powinien mieć uzasadnienie empiryczne lub domenowe. Wykreślaj histogramy źródłowe, badaj skośność oraz wartości odstające i porównuj symulowane losowania z obserwowanymi danymi. Rozkład normalny może być wygodny, ale wygoda nie czyni go odpowiednim dla opóźnionych dostaw danych, czasów obsługi czy interwałów awarii, które mają długi prawy ogon.
Zasada walidacji: Nigdy nie opisuj rozkładu jako realistycznego, dopóki symulowane losowania nie zostaną porównane z zachowaniem, które mają reprezentować.
Zależność i zbieżność
Niezależne losowania nie są automatycznie poprawne. Wolumen nadejść i opóźnienie przetwarzania mogą rosnąć razem. Brakujące wiersze mogą grupować się podczas określonej awarii na wcześniejszym etapie. Jeśli model próbuje te zmienne niezależnie, może wymazać to samo złożone zdarzenie, które zespół chce zbadać.
Użyj wykresów rozrzutu, analizy szeregów czasowych lub udokumentowanego modelu wspólnego, aby zbadać zależność. W przypadku symulacji łańcuchowych lub iteracyjnych wykresy autokorelacji mogą ujawnić, że sąsiednie próbki nie są niezależne. Diagnostyka Gelmana-Rubina może pomóc w porównaniu wielu łańcuchów, gdy odpowiednia jest metoda oparta na łańcuchach, ale nie jest to uniwersalny test zbieżności dla każdego niezależnego schematu Monte Carlo.
Niewystarczająca liczba iteracji prowadzi do niestabilnych szacunków ogonowych. Wykreślaj szacunki ruchome, porównuj partie i planuj liczbę prób wokół docelowej szerokości przedziału. Raportuj przedziały niepewności obok szacunków punktowych, szczególnie gdy interesariusze mogliby w przeciwnym razie potraktować wartość centralną jako obietnicę.
Unikanie nadmiernej pewności siebie przy walidacji
Detektor zweryfikowany wyłącznie na danych, które posłużyły do jego nastrojenia, może wydawać się skuteczniejszy, niż jest w rzeczywistości. Podziel dane według czasu lub warunków operacyjnych, przeprowadź walidację na okresie wstrzymanym (holdout) i przetestuj syntetyczne scenariusze, które nie były używane do wyboru progu. Celem nie jest wyprodukowanie korzystnego wyniku. Chodzi o odkrycie, w którym miejscu model przestaje wspierać decyzję operacyjną.
Budowanie wiarygodnych badań symulacyjnych
Traktuj badanie symulacyjne jak wdrożeniowy produkt danych. Przed zaufaniem jego wynikom zweryfikuj, czy:
Ziarno jest rejestrowane: Zapisz generator losowy, ziarno, wersję modelu i konfigurację.
Rozkłady są uzasadnione: Przechowuj dane źródłowe, metodę dopasowania lub uzasadnienie domenowe dla każdego niepewnego wejścia.
Zbieżność jest sprawdzana: Porównuj szacunki ruchome i partie z precyzją wymaganą do podjęcia decyzji.
Istnieje linia bazowa: Porównaj symulację z oszacowaniem analitycznym, historycznym odtworzeniem lub odniesieniem deterministycznym, jeśli są dostępne.
Surowe próby są przechowywane: Zachowaj wystarczającą ilość danych wyjściowych, aby odtworzyć podsumowania, zbadać ogony i przeanalizować nieoczekiwane scenariusze.
Dane wejściowe są monitorowane: Uruchom badanie ponownie, gdy zmienią się rozkłady danych nadrzędnych, wzorce obciążenia pracą lub zachowanie potoku.

Wybierz metodę Monte Carlo, gdy rozkład wejściowy jest znany, ale wyjściowy nie, gdy matematyka w postaci zamkniętej jest niepraktyczna lub gdy potrzebujesz empirycznych przedziałów ufności zamiast pojedynczego szacunku punktowego. W zespołach produkcyjnych decyzja ta współgra z szerszymi praktykami data observability, gdzie obserwowane zachowanie może dostarczać założeń i ujawniać, kiedy symulacja przestaje odzwierciedlać rzeczywistość.
digna zapewnia modułowe funkcje data observability w zakresie anomalii, Timeliness, walidacji, zmian schematów oraz metryk biznesowych lub platformowych w Twoim własnym środowisku. Odwiedź digna, aby połączyć obserwowane zachowanie potoku z analizą ryzyka opartą na symulacji i podejmować bardziej uzasadnione decyzje dotyczące niezawodności.
Najczęściej zadawane pytania
Czym różni się symulacja od metody Monte Carlo?
Symulacja to szeroka praktyka odwzorowywania rzeczywistego procesu modelem. Metoda Monte Carlo to rodzina technik w ramach tej praktyki, która korzysta z powtarzanego losowania, aby oszacować wynik liczbowy albo rozkład wyników.
Gdzie powstała metoda Monte Carlo?
W Los Alamos w połowie lat czterdziestych, skąd szybko przeszła z fizyki wojennej do szerokiej techniki obliczeniowej. To pochodzenie nadal kształtuje jej zastosowanie: powstała dla układów opierających się bezpośredniemu rachunkowi, a nie dla problemów mających już czyste wzory.
Jak wygląda podstawowa pętla symulacji?
Cztery powtarzane kroki: zdefiniuj dziedzinę, wylosuj wejścia, oblicz model i zagreguj wyniki. Przykład z tarczą do rzutek pokazuje pętlę wyraźnie, bo geometria jest oczywista, a bezpośrednie obliczenie nie.
Kiedy pojedynczy szacunek ukrywa potrzebną informację?
Zawsze wtedy, gdy decyzja zależy od wejść, które da się opisać wyłącznie jako zakresy albo rozkłady. Obliczenie deterministyczne bierze stałe wejścia i zwraca jeden wynik, a symulacja pozwala inżynierom zmieniać te wejścia łącznie i zobaczyć, jak rozkładają się rezultaty.
Jak powinno zaczynać się badanie symulacyjne?
Od decyzji, a nie od generatora liczb losowych. Nastawienie produkcyjne wychodzi od tego, do czego wynik posłuży, a potem cofa się do pytania, które wejścia zasługują na rozkłady i ile zbieżności decyzja faktycznie wymaga.