Strojenie wydajności bazy danych: opanuj swój system
|
8
min. czyt.
Twój dashboard nie przestał działać z dnia na dzień. Z każdym tygodniem stawał się nieco wolniejszy. Raport finansowy, który kiedyś ładował się natychmiast, teraz zawiesza się w godzinach szczytu. Odświeżanie BI zaczyna przekraczać swoje okno czasowe. Potok cech ML nadal działa, ale profil danych, na którym się opiera, zmienił się na tyle, że plany zapytań nie zachowują się już tak, jak podczas ostatniego strojenia systemu.
W takiej sytuacji jest dziś wiele zespołów. Traktują strojenie wydajności bazy danych jako ćwiczenie z wolnych zapytań, podczas gdy prawdziwym problemem jest dryf. Nie tylko dryf obciążenia, ale także dryf danych. Zmienia się liczba wierszy, rozkłady stają się skośne, pole dopuszczające wartości null zaczyna napływać według nowych wzorców, niezauważenie wchodzi aktualizacja schematu, a punkt odniesienia, któremu ufałeś, przestaje opisywać rzeczywistość.
Tradycyjne strojenie wciąż ma znaczenie. Nadal potrzebujesz planów wykonania, przeglądów indeksów, ustawień pamięci i zdyscyplinowanego wycofywania zmian. Jednak statyczne strojenie jest niewystarczające w systemach, w których kształt danych zmienia się każdego dnia.
Spis treści
Nie tylko wolne zapytania: prawdziwe źródło problemów z wydajnością
Ustal priorytety gorących punktów, aby znaleźć największe korzyści
Nie tylko wolne zapytania: prawdziwe źródło problemów z wydajnością
Większość incydentów wydajnościowych nie zaczyna się od jednego ewidentnie wadliwego zapytania. Zaczyna się od systemu, który staje się coraz mniej przewidywalny. Dashboard działa szybko rano, a w południe zachowuje się nieregularnie. Zadanie hurtowni, które wygodnie mieściło się w oknie wsadowym, zaczyna kolidować z innymi obciążeniami. Nikt wczoraj nie zmieniał SQL, a mimo to użytkownicy odczuwają spadek wydajności.
Stary schemat postępowania mówi: znajdź najwolniejsze zapytanie i je dostrój. To nadal ma wartość, ale pomija rosnącą grupę problemów, w których SQL jest jedynie objawem. Najnowsza analiza pokazuje, że 68% spadków wydajności baz danych w latach 2024–2025 wynika nie z nieefektywności zapytań, lecz z problemów z jakością danych na wcześniejszych etapach, które nieoczekiwanie zmieniają wzorce dostępu, a mimo to tylko 12% materiałów o strojeniu łączy metryki obserwowalności ze strojeniem wydajności – wynika z analizy strojenia wydajności baz danych przygotowanej przez Last9.
Dlaczego stabilne systemy stają się niestabilne
Zapytanie może być w pełni rozsądne dla kształtu danych z zeszłego miesiąca i słabo dopasowane do dzisiejszego. Dobrym przykładem jest PostgreSQL. W tabeli narasta rotacja danych, autovacuum nie nadąża, rośnie rozdęcie (bloat), a to, co wyglądało na umiarkowany skan, zamienia się w bardzo kosztowne operacje I/O. Zespoły SQL Server obserwują podobny dryf w zakresie rywalizacji o tempdb i wyboru planów przy zmieniających się wzorcach obciążenia. Środowiska Teradata mogą wyglądać zdrowo na poziomie systemu, podczas gdy jedna klasa obciążenia przesuwa się na tyle, by zaburzyć kolejkowanie i czas odpowiedzi.
Statyczne strojenie zakłada, że dane pozostają podobne. Systemy produkcyjne rzadko spełniają to założenie.
Dlatego strojenie wydajności bazy danych wymaga szerszej perspektywy. Zarządzasz nie tylko treścią zapytań i ustawieniami silnika. Zarządzasz także warunkami, w jakich te zapytania są wykonywane.
Praktycznie można to ująć tak:
Wolny SQL często oznacza słabe ścieżki dostępu, złe złączenia, nieaktualne statystyki lub nadmierną liczbę odczytów.
Dryf wydajności często oznacza, że obciążenie się zmieniło, bo zmieniły się dane.
Wpływ na biznes widać najpierw w nieaktualnych raportach, opóźnionych dashboardach i mniej wiarygodnych wynikach modeli.
Zespoły, które zajmują się wydajnością full-stack z perspektywy programistów, już rozumieją, że opóźnienia zwykle obejmują wiele warstw. Praca z bazą danych nie jest tu wyjątkiem. Jeśli ładowanie na wcześniejszym etapie wprowadza zduplikowane rekordy, zmienia kardynalność lub wzorzec napływu świeżych danych, plan zapytania może się pogorszyć, nawet gdy kod aplikacji pozostał nietknięty.
Ukryta luka w większości procesów strojenia
Tradycyjne punkty odniesienia to często migawki. Rejestrują dobry okres, może zły okres, a potem je porównują. To przydatne, ale nie mówi, kiedy sam punkt odniesienia przestaje być wiarygodny, bo schemat, wolumen, aktualność lub rozkład danych uległy dryfowi.
W tej luce kryje się wiele powracających incydentów. Baza danych nie pogorszyła się nagle. Zmieniło się otaczające ją środowisko, a zespół nadal stroił system według nieaktualnego obrazu.
Ustal punkt odniesienia: jak mierzyć i diagnozować problemy
Strojenie wydajności bazy danych zaczyna się od dowodów. Jeśli nie potrafisz opisać normalnego stanu systemu, nie stwierdzisz, czy zmiana cokolwiek poprawiła, czy tylko przeniosła problem w inne miejsce.
Podstawowy proces się nie zmienił, bo działa. Cykl „mierz, analizuj, optymalizuj, weryfikuj” jest uniwersalnym standardem i wymaga zarejestrowania opóźnień, przepustowości i wykorzystania zasobów przed jakąkolwiek optymalizacją, aby zmiany były weryfikowane względem punktu odniesienia, jak opisano w tym przeglądzie cyklu strojenia wydajności.
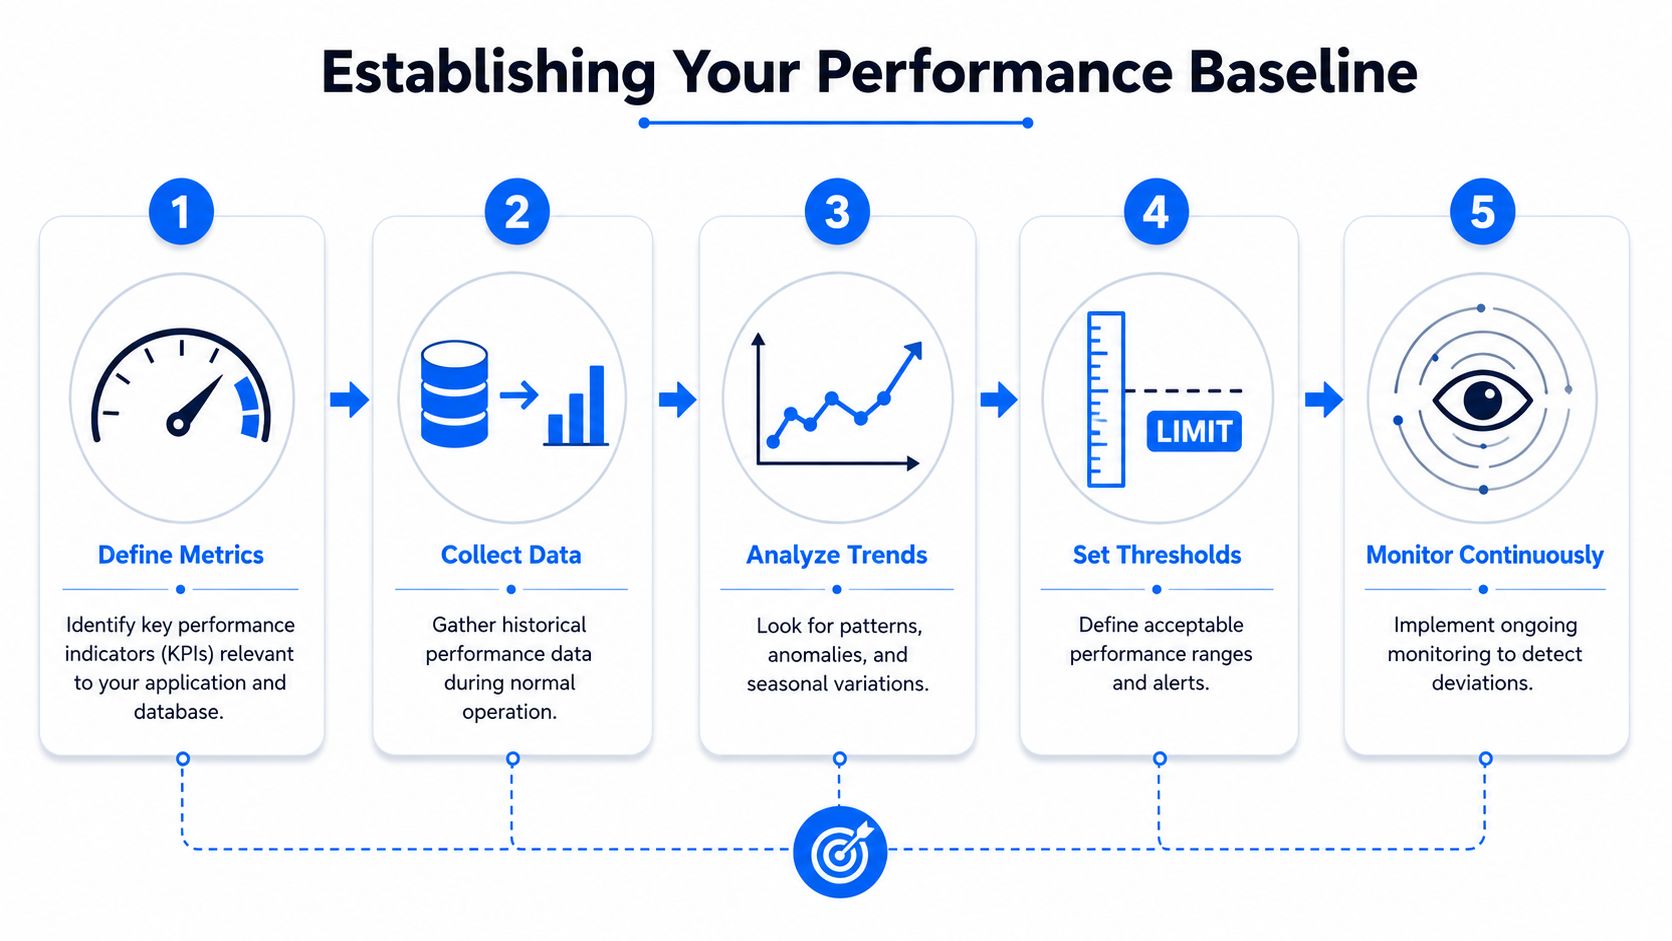
Najpierw mierz, potem zmieniaj system
Na tym etapie nawet dobre zespoły tracą cierpliwość. To zrozumiałe. Użytkownicy czekają, a presja, by „po prostu dodać indeks” albo „dać więcej pamięci”, jest duża. Oprzyj się tej pokusie, dopóki nie zarejestrujesz punktu odniesienia zarówno z okresów prawidłowego działania, jak i z okresów problemów.
Wytyczne Oracle dotyczące strojenia są w tej kwestii nadal przydatne, ponieważ kładą nacisk na zbieranie pełnych statystyk systemu operacyjnego, bazy danych i aplikacji zarówno w dobrym, jak i w złym stanie. Ta dyscyplina ma znaczenie. Brakujące statystyki to nie problem formalny. Zamieniają analizę przyczyn źródłowych w zgadywanie.
Praktyczna zasada: Jeśli nie zarejestrowałeś stanu „przed”, nie udowodnisz, że stan „po” jest lepszy.
Zbieranie punktu odniesienia powinno obejmować cały zakres działania obciążenia, a nie tylko jedną wolną instrukcję. Oznacza to mierzenie tego, co robi system, w podziale na moduły, okna czasowe i rodzaje zasobów.
Jeśli Twój zespół buduje bardziej rygorystyczną praktykę monitorowania, warto przejrzeć te techniki monitorowania i audytu baz danych równolegle z natywnymi narzędziami silnika.
Co uwzględnić w punkcie odniesienia
Konkretne narzędzia różnią się w zależności od platformy, ale kategorie są stałe. Query Store w SQL Server i Azure SQL, pg_stat_statements w PostgreSQL, widoki wydajności Oracle i tabele systemowe Teradata pomagają ujawnić te same klasy dowodów.
Sygnał | Na co zwrócić uwagę | Na co zwykle wskazuje |
|---|---|---|
Opóźnienie | Rosnące opóźnienia w ogonie rozkładu i niestabilne czasy odpowiedzi | Zmiany planów, presja na I/O, blokady, chybienia w pamięci podręcznej |
Przepustowość | Mniej wykonanej pracy na moduł lub okno zadania | Rywalizacja o zasoby, kolejkowanie, wzmocnienie zapisu |
CPU i pamięć | Nasycenie, nagłe zmiany, słabe zachowanie pamięci podręcznej | Złe plany, nadsubskrypcja, zbyt małe pamięci podręczne |
I/O i oczekiwania | Skoki odczytów, przelewanie na dysk, presja na pamięć masową, zdarzenia oczekiwania | Brakujące indeksy, presja sortowania, rozdęcie, praca na danych tymczasowych |
Błędy i ponowienia | Przekroczenia czasu, rotacja połączeń, nieudane odświeżenia | Wyczerpanie zasobów, źle dobrana wielkość puli, łańcuchy blokad |
W miarę możliwości rejestruj te metryki przy powtarzalnym obciążeniu. Jeśli próbkujesz tylko podczas awarii, nie dowiesz się, czy problem jest wyjątkowy, czy stanowi część trendu.
Solidny punkt odniesienia zwykle odpowiada na cztery pytania operacyjne:
Co było wolne. Nie jedna anegdota, ale dotknięte klasy zapytań, zadania i ścieżki użytkowników.
Gdzie występowała presja. CPU, pamięć, pamięć masowa, przestrzeń tymczasowa czy współbieżność.
Kiedy nastąpiła zmiana. Po wdrożeniu, po napływie danych, w oknie raportowym czy podczas konserwacji w tle.
Czy biznes to zauważył. Opóźnione dashboardy, nieaktualna analityka, niedotrzymane SLA czy opóźnione scorowanie modeli.
Punkty odniesienia potrzebują kontekstu, nie tylko metryk
Wąski punkt odniesienia może wprowadzać w błąd. Załóżmy, że zapytanie w hurtowni zwolniło po zmianie schematu, która dodała nową kolumnę, a proces ETL w dalszej części zaczął ją wypełniać według nieoczekiwanych wzorców wartości null. Plan zapytania może być bezpośrednim mechanizmem, ale diagnoza nie jest kompletna, dopóki nie połączysz zmiany wydajności ze zmianą kształtu danych.
Dlatego dojrzałe strojenie wydajności bazy danych nie kończy się na „zbieraniu metryk”. Wiąże metryki systemowe z harmonogramem obciążeń, stanem schematu i zachowaniem napływu danych. W przeciwnym razie Twój punkt odniesienia jest precyzyjny, ale niekompletny.
Ustal priorytety gorących punktów, aby znaleźć największe korzyści
Gdy już zmierzysz system, kolejną pułapką jest przypadkowe strojenie. Zespoły toną w wykresach, a potem przez tydzień dopracowują zapytania o niewielkim wpływie, podczas gdy prawdziwe wąskie gardło nadal pochłania CPU lub nasyca I/O.
Najszybszym wyjściem jest ustalanie priorytetów według wpływu. Nie według tego, które zapytanie wygląda brzydko. Nie według tego, który alert pojawił się pierwszy. Według tego, który gorący punkt zużywa najwięcej istotnych zasobów lub sprawia najwięcej problemów najszerszej grupie użytkowników.
Szereguj według wpływu, a nie uciążliwości
Zapytanie, które działa nieustannie i marnuje umiarkowane zasoby, może mieć większe znaczenie niż spektakularny jednorazowy raport. SQL Server Query Store, wizualizacje Azure SQL, widoki obciążenia Oracle, pg_stat_statements w PostgreSQL i metryki obciążenia Teradata pomagają odpowiedzieć na to samo pytanie: co jest wielokrotnie na tyle kosztowne, że kształtuje zachowanie systemu?
Zacznij od prostego modelu rankingowego:
Liczy się częstotliwość. Niewielka nieefektywność wykonywana przez cały dzień może zdominować całkowite obciążenie.
Liczy się zasięg. Zapytania powiązane ze współdzielonymi dashboardami lub kluczowymi API zasługują na więcej uwagi niż niszowe zadania administracyjne.
Liczy się rodzaj zasobu. Gorące punkty obciążające CPU i te obciążające I/O wymagają różnych ścieżek naprawy.
Liczy się moment wykonania. Zadanie kolidujące z porannym raportowaniem może być pilniejsze niż wolniejsze zadanie uruchamiane w nocy.
Nie optymalizuj najpierw najgłośniejszego zapytania. Optymalizuj to, które najbardziej zaburza działanie platformy.
Tu z pomocą przychodzą plany wykonania. Szukaj pełnych skanów dużych relacji, kosztownych złączeń ze złymi szacunkami liczby wierszy, przelewania danych do pamięci tymczasowej lub powtarzających się wyszukiwań kluczy, które zwiększają liczbę odczytów. W PostgreSQL sprawdź, czy presja punktów kontrolnych lub opóźnienie autovacuum pokrywają się ze spowolnieniem. W SQL Server przeanalizuj zachowanie tempdb i wzorce przydziałów pamięci. W Teradata sprawdź, które klasy obciążenia są kolejkowane i czy jedna rodzina zapytań nie monopolizuje zasobów.
Jak wygląda prawdziwy gorący punkt
Prawdziwy gorący punkt ma zwykle jedną z tych postaci:
Zapytanie raportowe, które dobrze działało na umiarkowanej tabeli, ale teraz skanuje znacznie więcej danych, bo zmienił się rozkład.
Często wykonywana instrukcja transakcyjna, która straciła wydajną ścieżkę dostępu po dryfie statystyk.
Transformacja w hurtowni, której pośredni wolumen sortowania rósł, aż zaczęła przelewać dane na dysk.
Szerokie złączenie w BI, które było akceptowalne, zanim dryf schematu wprowadził na wcześniejszym etapie zduplikowane lub osierocone klucze.
Zanim zaczniesz zmieniać obiekty, zestaw nakład pracy z wpływem. Niektóre korzyści są proste: odświeżenie statystyk, usunięcie ewidentnie nieużywanego indeksu, który zwiększa koszt zapisu, lub poprawienie predykatu uniemożliwiającego użycie indeksu. Inne wymagają większej ostrożności, bo zmieniają zachowanie aplikacji lub sposób przechowywania danych.
Nie chodzi o zbudowanie idealnego backlogu. Chodzi o wskazanie tych kilku zmian, które przywrócą platformie stabilne raporty, przewidywalne okna wsadowe i niezawodnych odbiorców danych.
Optymalizuj rdzeń: strojenie zapytań i schematu
Po uszeregowaniu gorących punktów najpierw dostrój ścieżkę główną. Zwykle oznacza to wzorce zapytań, indeksy, statystyki, a dopiero potem poważniejsze zmiany schematu. Większość systemów wciąż ma zaskakująco dużo możliwości poprawy o niskim ryzyku, zanim ktokolwiek będzie musiał rozmawiać o ponownym partycjonowaniu czy gruntownym przeprojektowaniu.
Zacznij od zmian o niskim ryzyku
Zdyscyplinowany proces zaczyna się od małych kroków. Odśwież statystyki, jeśli są nieaktualne. Przejrzyj plany wykonania. Dodawaj lub modyfikuj indeksy tylko wtedy, gdy uzasadniają to plan i wzorzec dostępu. Drobne poprawki SQL, korekty puli połączeń i weryfikacja planów zwykle powinny poprzedzać przeprojektowanie strukturalne.
Jeden praktyczny błąd pojawia się wszędzie: zespoły dodają kolejne indeksy, nie sprawdzając, czy istniejące już się nie pokrywają ani czy ścieżka zapisu udźwignie dodatkowy koszt utrzymania. Wskazówki zebrane w tym przeglądzie strojenia wydajności baz danych idą tu we właściwym kierunku. Usuwanie nieużywanych lub zbędnych indeksów może obniżyć narzut zapisu i koszty przechowywania, a bezrefleksyjne dodawanie kolejnych może skłonić optymalizator do złych wyborów lub zwiększyć obciążenie związane z utrzymaniem.
Kilka działań strojeniowych konsekwentnie się opłaca:
Uporządkuj nadmiar indeksów. Zbędne indeksy zwiększają koszt zapisu i mogą utrudniać diagnozowanie problemów.
Preferuj krótkie, celowe indeksy. Duże pola tekstowe są zwykle słabymi kandydatami na indeksy, bo zwiększają rozmiar struktury i koszt obliczeniowy.
Sprawdzaj zachowanie pamięci podręcznej po zmianach zapytań. Pule buforów powinny mieścić zbiór roboczy, nie zużywając całej pamięci systemu.
Przeprowadzaj regularne audyty. Przeglądy indeksów i higiena konfiguracji zapobiegają powolnej degradacji, która wkrada się do dojrzałych systemów.
Ostrożnie korzystaj z przepisywania zapytań przez AI
Przepisywanie zapytań przez AI jest kuszące, bo obiecuje szybkie korzyści. Czasem rzeczywiście pomaga. Może zaproponować uproszczenie złączeń, uporządkowanie predykatów lub alternatywne sformułowania, które ludzie mogą przeoczyć pod presją czasu.
Jednak w produkcyjnych bazach danych AI jest mieczem obosiecznym. Badanie branżowe z 2025 roku wykazało, że 44% optymalizacji zapytań wygenerowanych przez AI wprowadziło subtelne błędy w zbiorach danych z sektora finansowego i ochrony zdrowia z powodu błędnej interpretacji obsługi wartości null lub semantyki zakresów dat – wynika z tego podsumowania badania branżowego dotyczącego strojenia z użyciem AI.
Ten wynik potwierdza to, co doświadczeni inżynierowie już wiedzą. Szybkość zapytania to nie to samo co jego poprawność.
Traktuj sugestie AI jak szkic przygotowany przez młodszego recenzenta:
Sprawdź zmianę w planie wykonania.
Zweryfikuj semantykę na poziomie rekordów.
Porównaj zbiory wyników na reprezentatywnych przypadkach brzegowych.
Uważnie obserwuj obsługę wartości null, granice dat i zachowanie duplikatów.
Szybszy SQL, który zwraca niewłaściwe wiersze, to defekt produkcyjny, a nie optymalizacja.
Ma to jeszcze większe znaczenie w systemach analitycznych i ML. Subtelny błąd semantyczny w zapytaniu raportowym może skutkować nieaktualnym lub mylącym KPI. Błędne przepisanie zapytania w potoku cech może zmienić dane wejściowe modelu, sprawiając jednocześnie, że hurtownia wydaje się „szybsza”.
Kiedy zmiany schematu są warte zachodu
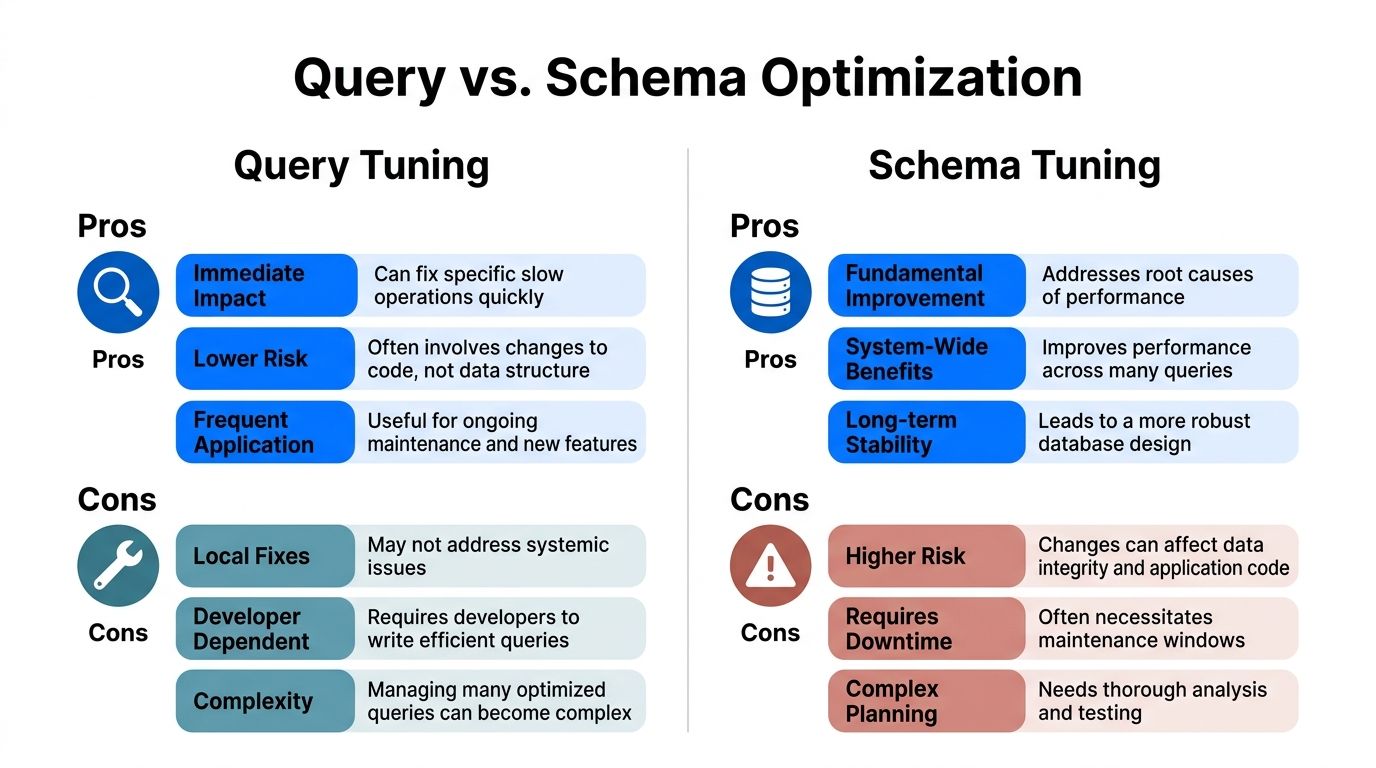
Strojenie zapytań ma charakter lokalny. Strojenie schematu ma charakter systemowy. Dlatego zmiany schematu mogą przynieść szerokie korzyści, ale niosą też większe ryzyko.
Stosuj zmiany schematu, gdy problem jest strukturalny, a nie kosmetyczny. Przykładem są tabele, które wyraźnie przerosły swój obecny układ, ścieżki złączeń, które stale zależą od niewygodnej struktury kluczy, czy obciążenia wymagające partycjonowania i zarządzania cyklem życia danych zamiast kolejnej rundy doraźnych poprawek zapytań.
Przydatny sposób ujęcia tego wyboru:
Opcja | Najlepsza, gdy | Główny kompromis |
|---|---|---|
Strojenie zapytań | Problem wywołuje niewielki zbiór instrukcji | Możesz naprawić tylko lokalne objawy |
Strojenie indeksów | Ścieżki dostępu są błędne lub niekompletne | Zapisy stają się droższe |
Strojenie schematu | Wiele zapytań cierpi z powodu tego samego ograniczenia projektowego | Wyższe ryzyko zmian i więcej koordynacji |
Kolejność ma znaczenie. Zacznij od najmniej inwazyjnej opcji, która może realnie rozwiązać problem. Jeśli nie przyniesie poprawy, wycofaj ją w czysty sposób i przejdź do kolejnej warstwy.
Takie podejście chroni strojenie wydajności bazy danych przed przypadkowym przekształceniem się w przeprojektowanie.
Strojenie silnika: konfiguracja i zasoby
Gdy prace nad zapytaniami i schematem są w toku, przenieś uwagę na sam silnik. Na tym etapie wiele zespołów albo przesadza, albo robi za mało. Albo kręcą każdym pokrętłem, jakie znajdą, albo pozostawiają oczywiste problemy z zasobami bez zmian, bo zakładają, że „to na pewno SQL”.
Oba podejścia są błędne.
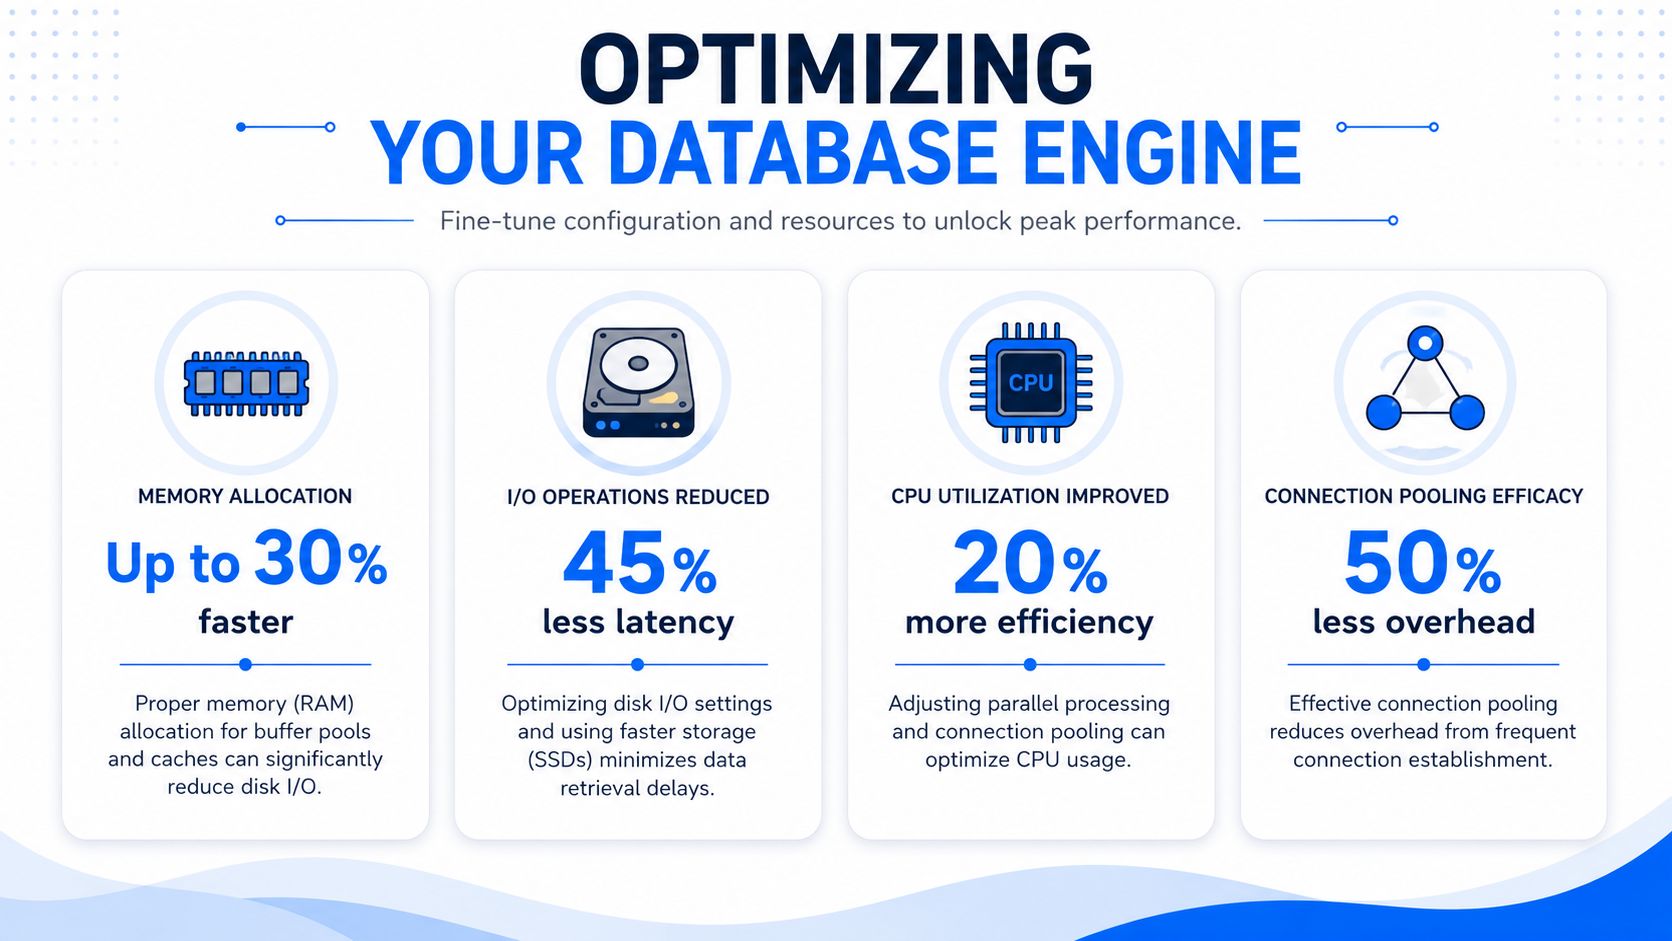
Traktuj konfigurację jak eksperyment
Strojenie konfiguracji działa tylko wtedy, gdy stosuje się ścisłą metodę pojedynczych zmian. Metodyka strojenia Oracle wyraźnie to podkreśla w wytycznych dotyczących metody strojenia krok po kroku. Zmieniaj jeden parametr lub obiekt naraz, rejestruj metryki przed zmianą i po niej, i nie ogłaszaj sukcesu, dopóki związek przyczynowy nie jest jasny.
Dotyczy to ustawień pamięci, pul połączeń, równoległości, rozmieszczenia danych w pamięci masowej i narzędzi diagnostycznych. Dotyczy to też drobnej, ale częstej pułapki: pozostawiania aktywnego śledzenia produkcyjnego lub sesji Extended Events po zakończeniu analizy. Jeśli nikt ich nie wyłączy, te narzędzia mogą stać się częścią profilu opóźnień.
Przydatna kolejność działań wygląda tak:
Najpierw pamięć. Sprawdź, czy pula buforów lub shared buffers mogą pomieścić zbiór roboczy, nie zagładzając reszty hosta.
Następnie zachowanie połączeń. Zbyt wiele aktywnych sesji może powodować sztuczną rywalizację o zasoby i presję na harmonogram.
Potem ścieżka I/O. Szukaj wzorców przelewania danych tymczasowych, głębokości kolejek lub złego rozmieszczenia krytycznych plików.
Dopiero wtedy głębsze ustawienia. Równoległość, ustawienia procesów roboczych i zaawansowane zachowanie silnika wymagają mocniejszych dowodów.
Istotne kontrole specyficzne dla platform
Szczegóły silników się różnią, ale niektórych kontroli nie można pominąć.
Interakcja Oracle z systemem operacyjnym
Ważna, sprawdzona od lat zasada Oracle nadal obowiązuje: jeśli wykorzystanie jądra systemu operacyjnego przekracza 40%, prawdopodobną przyczyną jest rywalizacja na poziomie systemu operacyjnego, np. stronicowanie, swapowanie, narzut transferu sieciowego lub thrashing procesów, a nie wyłącznie wady SQL, jak opisano w przewodniku Oracle po strojeniu wydajności. Gdy pojawi się ten próg, przestań udawać, że problem dotyczy tylko jednego zapytania.
SQL Server i tempdb
Jeśli tempdb jest źle rozmieszczona lub zbyt mała dla danego obciążenia, reszta dyskusji o strojeniu szybko staje się chaotyczna. Przelewanie danych, presja wersjonowania i współbieżne operacje na danych tymczasowych sprawiają, że objawy „wolnego zapytania” są poważniejsze, niż się wydaje.
PostgreSQL i zachowanie procesów konserwacyjnych
Uważnie obserwuj punkty kontrolne i autovacuum. Jeśli autovacuum nie nadąża, rozdęcie tabel może zamienić zwykłe odczyty w kosztowne operacje I/O. Jeśli ustawienia punktów kontrolnych nie pasują do wzorca zapisu, opóźnienia stają się nieregularne.
Teradata i klasy obciążenia
W Teradata średnie systemowe mogą ukrywać problemy. Przydatny jest widok zachowania na poziomie obciążeń, kolejkowania i tego, ile zasobów pochłania jedna klasa aktywności w krytycznych oknach czasowych.
Przy strojeniu silnika dyscyplina ma największe znaczenie. Jedna zmiana, jeden cykl pomiarowy, jedna ścieżka wycofania.
Bez takiego rygoru strojenie wydajności bazy danych staje się zabobonem. Nie będziesz wiedzieć, czy zmiana pamięci pomogła, czy zmiana puli zaszkodziła współbieżności, ani czy poprawka pamięci masowej przez tydzień maskowała problem z planem.
Od reaktywnego strojenia do ciągłej obserwowalności
Jednorazowe sesje strojenia są nadal potrzebne. Po prostu już nie wystarczają.
Powód jest prosty. Twoja platforma danych zmienia się dalej po zakończeniu sesji strojenia. Tabele rosną. Zadania na wcześniejszych etapach się spóźniają. Schematy ulegają dryfowi. Rozkłady rekordów się przesuwają. Punkt odniesienia zarejestrowany w spokojnym okresie stopniowo przestaje odzwierciedlać rzeczywistość produkcyjną.
Statyczne punkty odniesienia się dezaktualizują
Jeśli wracasz do wydajności tylko wtedy, gdy użytkownicy się skarżą, zawsze działasz z pozycji defensywnej. Do tego czasu problem zdążył już przełożyć się na nieaktualne raporty, niedziałające dashboardy, opóźnioną analitykę lub zawodne funkcje AI.
Ciągła obserwowalność zamyka tę lukę. Kluczowa zmiana polega na obserwowaniu nie tylko metryk silnika, ale także warunków danych, które unieważniają założenia dotyczące wydajności:
Anomalie wolumenu, które zmieniają wzorce dostępu
Zmiany schematu, takie jak dodane kolumny, usunięte pola czy zmiany typów
Dryf terminowości, gdy oczekiwane dane docierają z opóźnieniem lub wcale
Problemy z jakością na poziomie rekordów, w tym duplikaty, anomalie wartości null i zerwane relacje
AI może tu pomóc, jeśli stosuje się ją do wykrywania anomalii, a nie do bezrefleksyjnego przepisywania zapytań. Wykrywanie anomalii oparte na AI może zmniejszyć nakład pracy związany z ręcznym utrzymywaniem reguł nawet o 90%, gdy metody nienadzorowane uczą się normalnego zachowania i automatycznie ustalają adaptacyjne progi – wynika z opisu platformy danych dla przedsiębiorstw digna. Ma to znaczenie, ponieważ ręcznie utrzymywane progi szybko się starzeją w dynamicznych hurtowniach.
Co zmienia ciągła obserwowalność
Elementem architektury, który czyni to praktycznym, jest analiza wewnątrz bazy danych. Obliczanie metryk wewnątrz bazy danych eliminuje koszty przenoszenia danych, ponieważ inspekcja odbywa się bezpośrednio w źródłowych bazach danych, co umożliwia monitorowanie w czasie rzeczywistym i uczenie się punktów odniesienia, a dane klienta pozostają prywatne w jego własnym środowisku, jak opisano w tym przeglądzie analizy obciążeń wewnątrz bazy danych.
Ten model jest szczególnie przydatny w środowiskach chmury prywatnej i on-premises, w których zespoły potrzebują wglądu bez eksportowania wrażliwych danych produkcyjnych. Pasuje też do sposobu pracy inżynierów danych. Jeśli obserwowalność może działać blisko tabel obciążeń Teradata, statystyk systemowych PostgreSQL lub logiki walidacyjnej osadzonej w hurtowni, możesz wychwycić dryf, zanim stanie się incydentem odczuwalnym dla użytkowników.
Skuteczniejszy model operacyjny łączy:
telemetrię zapytań i silnika,
śledzenie schematów,
monitorowanie aktualności danych,
wykrywanie anomalii w kształcie danych,
oraz walidację na poziomie rekordów powiązaną z regułami biznesowymi.
Jeśli chcesz szerzej poznać ten model operacyjny, dobrym punktem wyjścia jest ten przegląd obserwowalności danych w praktyce.
Strojenie wydajności bazy danych działa najlepiej, gdy z akcji ratunkowej przekształca się w ciągłą pętlę kontrolną. W ten sposób chronisz nie tylko opóźnienia zapytań, ale także zaufanie do wyników, które dostarcza Twoja baza danych.
Jeśli Twój zespół chce połączyć wydajność bazy danych z dryfem danych, zmianami schematu, terminowością i walidacją na poziomie rekordów w jednym modelu operacyjnym, digna została do tego stworzona. Przeprowadza analizy w Twoim środowisku, pomaga wykrywać anomalie, zanim przełożą się na nieaktualne raporty lub zawodne dane wejściowe dla AI, i daje inżynierom sposób na utrzymanie wiarygodnych punktów odniesienia wydajności w miarę zmian danych.
Aby obserwować warunki danych, które po cichu unieważniają punkt odniesienia strojenia, takie jak zmiany wolumenu, zmiany schematu i opóźnione ładowania, zobacz, jak digna podchodzi do obserwowalności platformy danych wewnątrz Twojej własnej bazy danych.
Najczęściej zadawane pytania
Co powoduje spadek wydajności bazy danych z czasem?
Często są to dane, a nie SQL. Przytoczona w artykule analiza Last9 przypisuje 68% spadków wydajności baz danych w latach 2024–2025 problemom z jakością danych na wcześniejszych etapach, które zmieniają wzorce dostępu, takim jak zmieniająca się liczba wierszy, skośne rozkłady, nowe wzorce wartości null czy niezauważone aktualizacje schematu, przez które dawny punkt odniesienia traci aktualność.
Co powinien obejmować punkt odniesienia wydajności bazy danych?
Przydatny punkt odniesienia obejmuje opóźnienia, przepustowość, CPU i pamięć, I/O i zdarzenia oczekiwania, a także błędy i ponowienia, mierzone zarówno w okresach prawidłowego działania, jak i problemów. Powinien odpowiadać na cztery pytania: co było wolne, gdzie występowała presja, kiedy nastąpiła zmiana i czy biznes to zauważył poprzez opóźnione dashboardy lub niedotrzymane SLA.
Jak zdecydować, które wolne zapytania stroić najpierw?
Szereguj gorące punkty według wpływu, a nie według tego, które zapytanie wygląda najgorzej lub wywołało alert jako pierwsze. Uwzględnij częstotliwość, zasięg, rodzaj zasobu i moment wykonania: niewielka nieefektywność wykonywana przez cały dzień może zdominować całkowite obciążenie, a zadanie kolidujące z porannym raportowaniem może być ważniejsze niż wolniejsze zadanie nocne. Pomocne są Query Store i pg_stat_statements.
Czy przepisywanie zapytań SQL przez AI jest bezpieczne?
Tylko przy starannej weryfikacji. Przytoczone w artykule badanie branżowe z 2025 roku wykazało, że 44% optymalizacji zapytań wygenerowanych przez AI wprowadziło subtelne błędy w zbiorach danych z sektora finansowego i ochrony zdrowia, głównie w obsłudze wartości null i zakresów dat. Traktuj sugestie jak szkic młodszego kolegi: sprawdź plan, porównaj zbiory wyników i przetestuj przypadki brzegowe.
Jak testować zmiany konfiguracji bazy danych?
Zmieniaj jeden parametr naraz, rejestruj metryki przed zmianą i po niej oraz zachowaj ścieżkę wycofania, zgodnie z metodą krok po kroku Oracle. Działaj w kolejności: najpierw pamięć, potem zachowanie połączeń, następnie ścieżka I/O, a dopiero na końcu równoległość lub ustawienia procesów roboczych. Oracle wskazuje też, że wykorzystanie jądra systemu operacyjnego powyżej 40% oznacza rywalizację na poziomie systemu operacyjnego.


