Schematy w hurtowniach danych: Kompletny przewodnik na rok 2026
|
7
min. czyt.

Znasz to uczucie. Rano pulpit nawigacyjny wygląda dobrze, potem zaczyna się przegląd kadry kierowniczej i jeden wykres nagle staje się pusty, ponieważ ktoś zmienił nazwę kolumny na wcześniejszym etapie. Magazyn nie „zepsuł się” w sensie abstrakcyjnym — po prostu pękł kolejny Data Contract na dalszym etapie i nikt nie wychwycił tego wpływu wystarczająco wcześnie.
To główny powód, dla którego schematy w systemach magazynów danych mają znaczenie. To nie są tylko układy tabel — to struktura, która mówi każdemu odbiorcy, jak bezpiecznie odczytywać biznes, niezależnie od tego, czy tym odbiorcą jest narzędzie BI, warstwa semantyczna czy potok ML. Szersza definicja schematu według Oracle, jako kolekcji obiektów bazy danych, w tym tabel, widoków, indeksów i synonimów, pomaga oddzielić ogólną koncepcję bazy danych od wielowymiarowego wzorca magazynu, o który pytają analitycy (definicja schematu Oracle).
Spis treści
Schemat gwiazdy i sposób myślenia o modelowaniu wielowymiarowym
Praktyki z obszaru Observability, które chronią integralność schematu
Co naprawdę oznacza schemat w magazynie danych
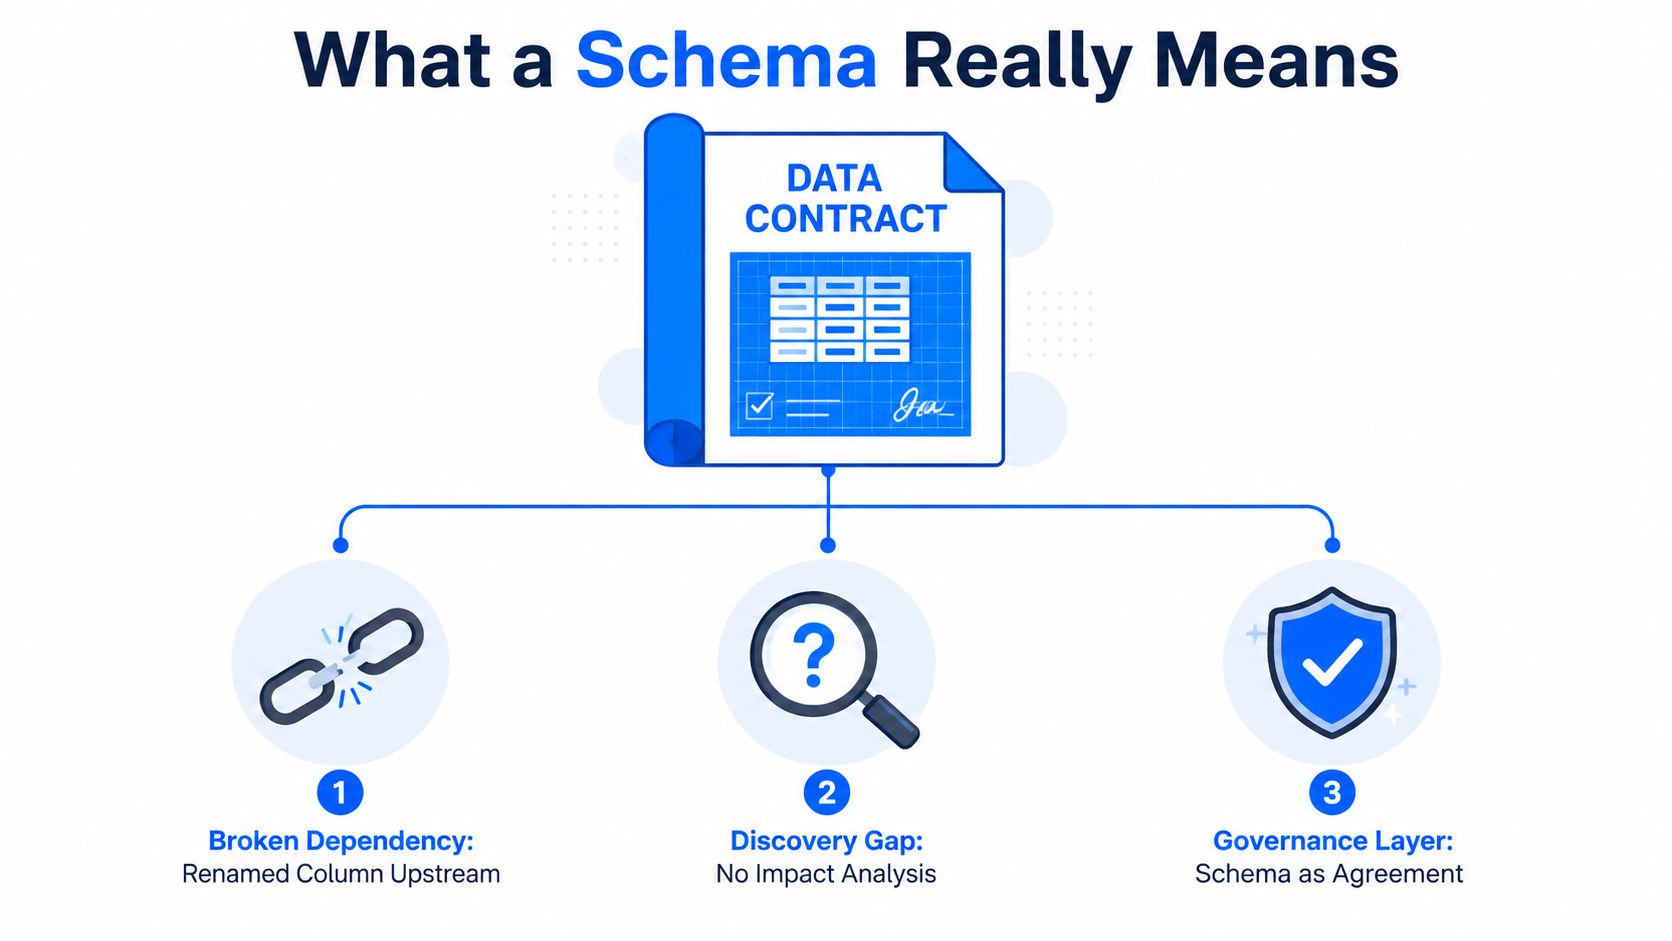
Schemat magazynu to sposób kodowania znaczenia, a nie tylko sposób rozmieszczania tabel. W praktyce jest to logiczny układ tabel, kluczy, relacji i ograniczeń, który pozwala magazynowi konsekwentnie odpowiadać na pytania biznesowe, nawet gdy surowe systemy źródłowe są nieuporządkowane. Właśnie dlatego w ogóle istnieją wielowymiarowe schematy magazynów — przekształcają one dane operacyjne w model semantyczny, który wspiera odczyt analityczny i utrzymuje znaczenie biznesowe powiązane z każdym wierszem.
Układ tabeli to nie cała historia
Schemat systemu transakcyjnego i schemat magazynu rozwiązują różne problemy. System źródłowy dba o szybkie zapisy, ścisłą integralność i codzienne aktualizacje. Magazyn dba o odczyty historyczne, powtarzalne złączenia i stabilne raportowanie w wielu wymiarach. Schemat magazynu zachowuje się jak kontrakt interfejsu, ponieważ analitycy i narzędzia BI zależą od tego, czy znaczenie każdej tabeli i klucza pozostaje na tyle stabilne, aby można było zadawać zapytania bez obaw.
To rozróżnienie ma znaczenie, gdy zmienia się nazwa kolumny lub klucz. Jeśli magazyn traktuje schemat jak kontrakt, zespoły mogą ocenić wpływ przed wdrożeniem zmiany. Jeśli traktują go jak luźny układ tabeli, najpierw psuje się downstreamowe BI, a governance zauważa to dopiero później. Ta sama idea dotyczy cech ML i zasileń zwrotnych ETL, ponieważ każdy odbiorca, który czyta z magazynu, zależy od tego, czy struktura pozostanie rozpoznawalna z jednej wersji na drugą.
Zasada praktyczna: schemat magazynu powinien mówić odbiorcom, co oznacza dany wiersz, zanim jeszcze napiszą SQL.
Dlaczego szersza definicja bazy danych wciąż ma znaczenie
Definicja Oracle jest przydatna, ponieważ przypomina zespołom, że schemat to posiadana kolekcja obiektów bazy danych, a nie tylko diagram. W magazynie ten szerszy zestaw obiektów może obejmować widoki, ograniczenia, indeksy i synonimy obok tabel wymiarów, co oznacza, że myślenie o schemacie musi obejmować wzorce dostępu i governance, a nie tylko styl modelowania (definicja schematu Oracle).
To szersze spojrzenie jest również tym, co sprawia, że śledzenie schematu jest użyteczne. Jeśli tabela, widok lub klucz zmienia swój kształt bez rejestrowania, odbiorcy na dalszych etapach mogą stracić zależność, na której polegali, nawet jeśli zapytanie wciąż się kompiluje. Schemat typu Data Contract działa jako warstwa governance, która uwidacznia te zależności, zanim ulegną uszkodzeniu, a infografika tutaj wyraźnie pokazuje tę relację Infografika pokazująca, że schemat typu data contract działa jako warstwa governance zapobiegająca uszkodzeniu zależności danych.
Najprościej rzecz ująć tak: schemat to umowa magazynu dotycząca znaczenia, struktury i zmian. Gdy ta umowa jest dokładnie śledzona, analitycy otrzymują spójne liczby, pulpity nawigacyjne BI pozostają czytelne, a zmiany inżynieryjne mogą posuwać się naprzód bez zaskakiwania osób zależnych od magazynu.
Schemat gwiazdy i sposób myślenia o modelowaniu wielowymiarowym
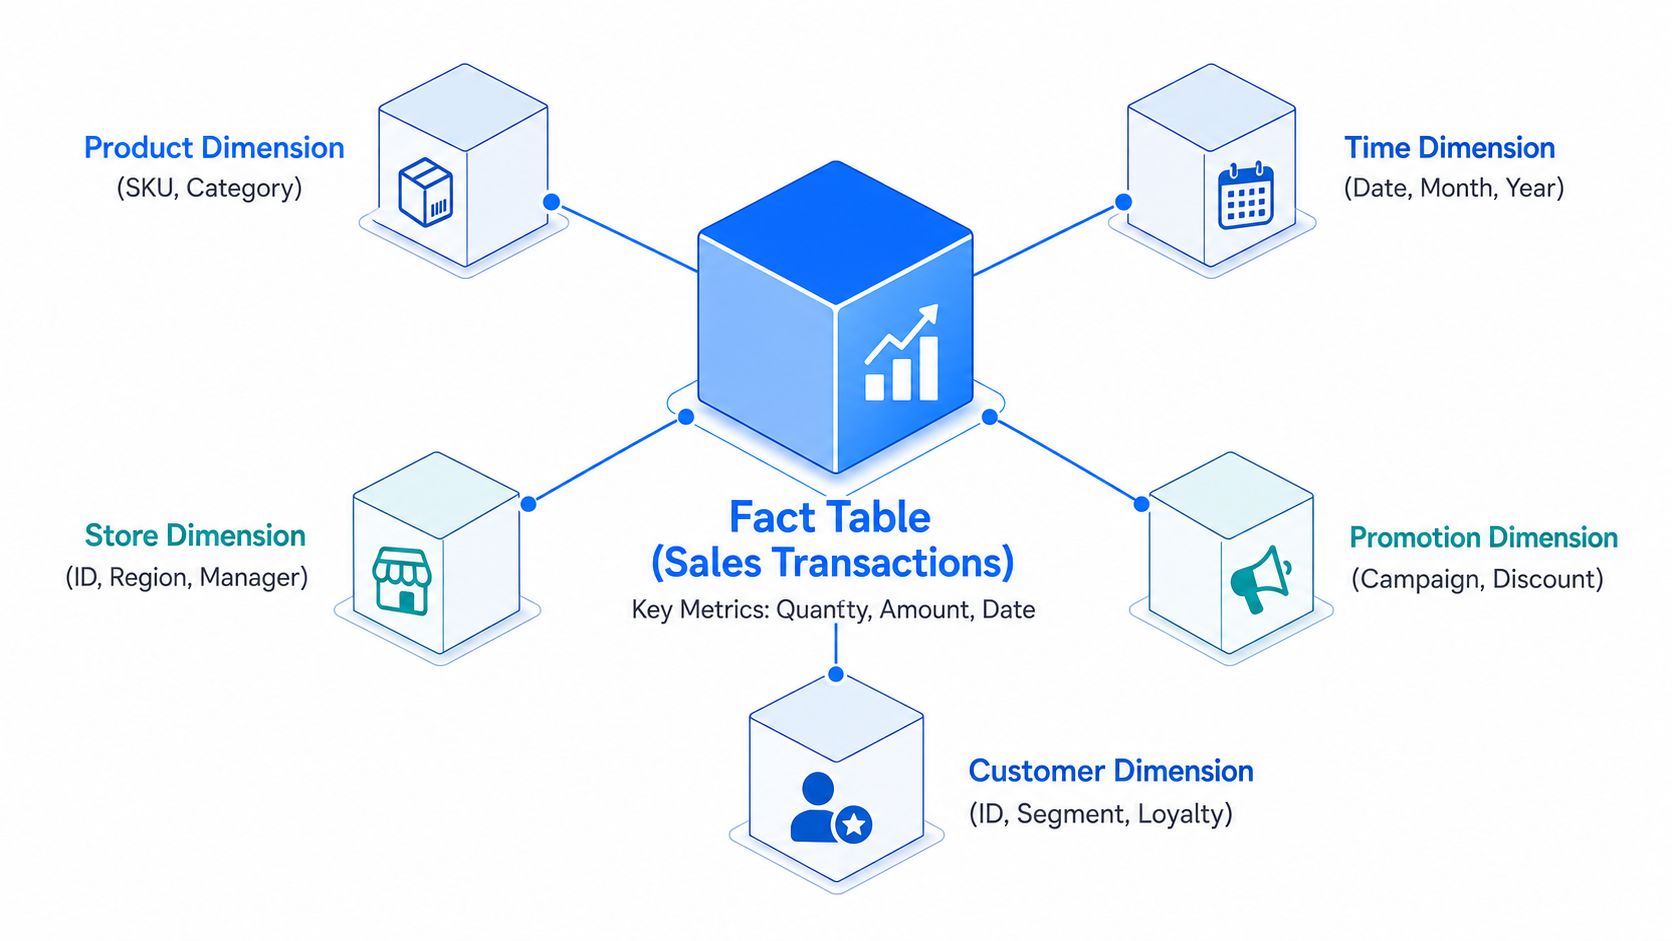
Zespół zajmujący się magazynem zazwyczaj odczuwa różnicę, gdy tylko model trafia do użytkowników BI. Zapytania stają się prostsze, złączenia stają się przewidywalne, a rozmowa przenosi się z pytania „gdzie to pole jest przechowywane?” na „jakie zdarzenie biznesowe opisuje ten wiersz?”. Schemat gwiazdy jest najbardziej przejrzystym wyrazem modelowania wielowymiarowego, ponieważ sprawia, że ta odpowiedź jest widoczna. Centralna tabela faktów zawiera zdarzenie biznesowe, a otaczające ją tabele wymiarów zapewniają kontekst. Przewodnik MotherDuck opisuje ten wzorzec wyraźnie: każdy wiersz faktów reprezentuje zdarzenie biznesowe, podczas gdy wymiary odpowiadają na pytania kto, co, gdzie, kiedy i dlaczego (przewodnik po schemacie gwiazdy MotherDuck).
Zacznij od zdarzenia biznesowego
Wielowymiarowe podejście Ralpha Kimballa wciąż kształtuje nowoczesne projektowanie magazynów, ponieważ zaczyna się od pytania, które inżynierowie muszą rozstrzygnąć w pierwszej kolejności — co oznacza jeden wiersz? Sekwencja zaczyna się od procesu biznesowego, następnie określany jest ziarno (grain), potem wymiary, a na końcu fakty na tym poziomie szczegółowości. Taka kolejność chroni zespół przed kłótniami o nazwy kolumn, zanim model uzyska stabilną jednostkę analizy.
Użytecznym modelem mentalnym jest tutaj hala magazynowa z jednym centrum i kilkoma szprychami. Centrum to tabela faktów, szprychy to wymiary, a każde złączenie następuje znaną ścieżką. Zespoły BI zazwyczaj uważają to za łatwiejsze w pracy niż strukturę znormalizowaną, ponieważ wzorzec relacji pozostaje widoczny, a miary pozostają zakotwiczone w zdarzeniu, które opisują.
Miary, fakty i wolno zmieniający się kontekst
Fakt to zdarzenie biznesowe i zazwyczaj niesie ze sobą jedną lub więcej numerycznych miar. Ilość sprzedaży jest addytywna, saldo konta jest póładdytywne, ponieważ zależy od okresu, który badasz, a cena jednostkowa jest nieaddytywna, ponieważ jej sumowanie zazwyczaj nie ma sensu. Klasyczne modelowanie wielowymiarowe uwzględnia również wolno zmieniające się wymiary, co jest sposobem, w jaki magazyn zachowuje historię, gdy atrybuty opisowe, takie jak miasto klienta czy kierownik sklepu, zmieniają się w czasie (Projektowanie koncepcyjne magazynów danych ze schematów ER)).
Schemat gwiazdy działa jak kontrakt interfejsu dla analityki. Definiuje, które zdarzenie jest udostępniane, jakie deskryptory są dostępne i jak należy obsługiwać zmiany, aby odbiorcy na dalszych etapach nie musieli zgadywać. Dlatego ma to znaczenie zarówno dla śledzenia schematu, jak i modelowania. Jeśli atrybut wymiaru lub klucz zmieni kształt bez zarejestrowania, raporty BI i potoki cech ML mogą stracić zależność, na której zostały zbudowane, nawet jeśli SQL wciąż się kompiluje.
Schemat gwiazdy to nie „szerokie tabele dla wygody”. To celowy model zapewniający stabilne znaczenie analityczne.
Wzorzec ten pozostaje popularny, ponieważ pasuje do agregacji i konsumpcji. Przegląd schematu gwiazdy firmy digna pokazuje tę samą podstawową ideę w prostym układzie, a format gwiazdy sprawia, że złączenia są łatwe do śledzenia w zapytaniach BI, bez konieczności wcześniejszego zrozumienia przez analityków każdego szczegółu operacyjnego.
Porównanie schematów gwiazdy, płatka śniegu i galaktyki
Zespół ds. magazynu zazwyczaj wybiera spośród schematów gwiazdy, płatka śniegu i galaktyki (zwanych również konstelacją faktów), decydując o tym, jak dużą strukturę ujawnić użytkownikom downstreamowym. Przydatne pytanie nie brzmi, która nazwa brzmi czysto, ale która struktura zachowuje się jak stabilny kontrakt interfejsu dla posiadanego obciążenia pracą, z najmniejszym zaskoczeniem dla odbiorców BI i ML w miarę zmian modelu w czasie (przegląd schematów magazynu Exasol).
Użyj obciążenia pracą jako diagnostyki
Zacznij od kształtu pracy, nie od nazewnictwa. Magazyn z jedną jasną domeną biznesową i wieloma użytkownikami pulpitów nawigacyjnych zazwyczaj pasuje do schematu gwiazdy, ponieważ centralna tabela faktów i bezpośrednio z nią połączone wymiary upraszczają ścieżkę zapytania. Magazyn, który współdzieli te same atrybuty opisowe w kilku powiązanych tabelach, może lepiej pasować do schematu płatka śniegu, ponieważ dodatkowa normalizacja zmniejsza powtarzalność przechowywania atrybutów. Magazyn, który wymaga kilku tabel faktów do współdzielenia wymiarów w procesach biznesowych, wskazuje na wzorzec galaktyki, gdzie ponowne użycie w różnych obszarach tematycznych ma większe znaczenie niż utrzymanie każdego zapytania tak krótkiego, jak to możliwe (przegląd schematów magazynu Exasol).
Szybka diagnostyka pomaga. Policz tabele faktów, a następnie zapytaj, jak często muszą być łączone. Jedna domena z powtarzającym się krojeniem i kostkowaniem zazwyczaj wskazuje na gwiazdę. Kilka domen ze współdzielonymi wymiarami wskazuje na galaktykę. Jeśli głównym problemem jest utrzymanie wymiarów, płatek śniegu może pomóc poprzez wydzielenie zmieniających się atrybutów do powiązanych tabel, ale tylko wtedy, gdy dodatkowe złączenia nie generują większego oporu niż usuwają.
Rodzina schematów | Struktura | Główny kompromis | Najlepsze dopasowanie |
|---|---|---|---|
Gwiazda (Star) | Jedna centralna tabela faktów z bezpośrednio powiązanymi wymiarami | Prostota ponad normalizację | Jednodomenowe BI i raportowanie |
Płatek śniegu (Snowflake) | Wymiary są podzielone na powiązane podtabele | Wydajność przechowywania ponad prostotę zapytań | Wymiary wymagające większego utrzymania strukturalnego |
Galaktyka (Galaxy) | Wiele tabel faktów współdzieli wymiary | Wielokrotne użycie ponad początkową prostotę modelowania | Magazyny korporacyjne obejmujące kilka procesów biznesowych |
What each design buys you
Schemat gwiazdy sprawia, że kontrakt jest łatwy do odczytania. Analitycy mogą prześledzić metrykę z powrotem do tabeli faktów, a następnie do wymiarów bez przechodzenia przez wiele złączeń, dlatego pozostaje on powszechny w magazynach zorientowanych na BI. Schemat płatka śniegu utrzymuje większą część hierarchii wymiarów oddzielnie, dzięki czemu model może dokładniej odzwierciedlać strukturę źródłową i upraszczać niektóre zadania konserwacyjne. Kosztem jest złożoność zapytań, ponieważ każda dodatkowa tabela dodaje kolejny punkt złączenia, który odbiorca musi zrozumieć.
Schematy galaktyki rozwiązują inny problem. Pomagają, gdy firma chce, aby te same definicje wymiarów obsługiwały więcej niż jeden proces analityczny, taki jak sprzedaż, zapasy i realizacja zamówień. W tym przypadku model służy mniej wygodzie, a bardziej dopasowaniu metryk w różnych zespołach i narzędziach. Aby uzyskać zwięzłe porównanie form gwiazdy i płatka śniegu, skorzystaj z przewodnika po schematach gwiazdy i płatka śniegu digna.
Wybór jest zazwyczaj kompromisem między prostotą zapytań, wspólnym znaczeniem a utrzymaniem. Jeśli analitycy potrzebują powtarzalnego kodu SQL z minimalną logiką złączeń, gwiazda jest zazwyczaj najczystszym rozwiązaniem. Jeśli współdzielone wymiary często się zmieniają, a zespół ds. magazynu chce utrzymać strukturę bliższą źródłu, płatek śniegu może zmniejszyć powtarzalność. Jeśli kilka tabel faktów musi pozostać spójnych w różnych obszarach biznesowych, galaktyka daje ten wspólny fundament bez zmuszania każdego zespołu do budowania własnej wersji tego samego modelu wymiarów.
Schema-on-Write and Schema-on-Read in Modern Warehouses
Schemat magazynu to nie tylko układ tabeli. To kontrakt, który mówi każdemu odbiorcy na dalszym etapie, jaki kształt będą miały dane, a kontrakt ten może być wymuszany przed zapisaniem danych lub interpretowany później w czasie zapytania. Schema-on-write stosuje reguły z góry, podczas gdy schema-on-read pozwala na zastosowanie struktury w momencie wysyłania zapytania do danych. Databricks opisuje systemy typu magazynowego jako miejsce dla ustrukturyzowanej, podlegającej zasadom governance analityki, podczas gdy systemy typu lake stosują schemat w czasie odczytu, a projekty lakehouse próbują łączyć oba podejścia (typy magazynów danych Databricks).
Gdzie następuje wymuszanie
Systemy schema-on-write definiują kształt tabeli przed rozpoczęciem ładowania. Typy danych są sprawdzane, rekordy, które nie pasują, są odrzucane na wczesnym etapie, a analitycy odpytują informacje, które zostały już ukształtowane do znanego zastosowania. Pasuje to do zespołów, które dbają bardziej o spójność, audytowalność i powtarzalne raportowanie niż o dokładne zachowanie każdego surowego pakietu danych w postaci, w jakiej dotarł.
Schema-on-read podąża inną ścieżką. Surowe dane są najpierw zapisywane, a silnik zapytań interpretuje strukturę tylko wtedy, gdy ktoś o to poprosi. To sprawia, że jest to przydatne do eksploracji, pracy w piaskownicy (sandbox) i niektórych procesów ML, zwłaszcza gdy zespół wciąż uczy się, co zawierają dane.
Kompromis jest prosty. Schema-on-write daje przewidywalność. Schema-on-read daje elastyczność. Większość platform korporacyjnych korzysta z obu rozwiązań, z uporządkowaną warstwą magazynu dla raportowania podlegającego zasadom governance oraz warstwą surową lub piaskownicą do eksperymentów i inżynierii cech.
Dlaczego większość zespołów kończy z obydwoma rozwiązaniami
Wzorzec lakehouse istnieje, ponieważ żadna skrajność nie pokrywa wszystkich potrzeb. Databricks opisuje nowoczesne architektury lakehouse jako łączące governance w stylu magazynu danych z elastycznością w stylu data lake, co pasuje do zespołów, które potrzebują zarówno surowej historii, jak i zaufanych struktur docelowych (marts) na tej samej szerszej platformie.
Zarządzane BI należy do strony opartej na wymuszaniu kontraktów. Eksploracja należy do strony elastycznej.
Ten podział sprawia, że analityczny magazyn danych pozostaje niezawodny, a jednocześnie daje analitykom danych dostęp do surowych danych wejściowych. Zapobiega to również wchłanianiu przez warstwę semantyczną każdej eksperymentalnej tabeli, która pojawia się na platformie. Jeśli obciążenie pracą wspiera raportowanie kadry kierowniczej, schema-on-write jest zazwyczaj bezpieczniejszym standardem. Jeśli chodzi o znajdowanie wzorców lub budowanie cech z surowych zdarzeń, schema-on-read jest często lepszym rozwiązaniem.
Wybór schematu wpływa również na observability. Kontrakt jest przydatny tylko wtedy, gdy zespoły widzą, kiedy się zmienia, mogą porównać stary kształt z nowym i ostrzec odbiorców na dalszych etapach, zanim zepsują się pulpity nawigacyjne lub modele. W tym miejscu znaczenie ma śledzenie schematu i powiązane z nim kontrole, ponieważ zmieniają one projektowanie schematu w coś, co operacje mogą monitorować, zamiast czegoś, co programiści odkrywają dopiero po nieudanym zapytaniu.
Dla zespołów przyglądających się szerszym strategiom zmian w projektach IT lekcja jest taka sama. Schemat musi zmieniać się w kontrolowany sposób, z widocznością dla ludzi i systemów, które od niego zależą.
Ewolucja schematu i bezpieczne zarządzanie zmianami
Najsilniejszy schemat magazynu to nie ten, który wyglądał najprościej pierwszego dnia. To ten, który może zmieniać się w przewidywalny sposób, nie powodując problemów u osób i systemów, które od niego zależą. Oznacza to myślenie o schemacie jak o kontrakcie interfejsu, a nie tylko strukturze przechowywania. Kontrakt ten jest konsumowany przez pulpity nawigacyjne, warstwy semantyczne i zautomatyzowane potoki, a odbiorcy ci mogą ulec awarii bez ostrzeżenia, gdy zmienia się kształt.
Zmiany krytyczne i niekrytyczne
Niektóre zmiany są łatwe do przyswojenia. Dodanie kolumny dopuszczającej wartości null, dodanie nowej tabeli lub rozszerzenie widoku często może nastąpić bez zakłócania pracy istniejących odbiorców. Inne zmiany są niebezpieczne. Zmiana nazwy kolumny, usunięcie pola lub zaostrzenie typu może zepsuć zapytanie, które działało wczoraj i nadal się kompiluje dzisiaj.
Dlatego bezpieczne zarządzanie zmianami zaczyna się od kompatybilności, a nie od wygody. Jeśli raport na dalszym etapie oczekuje pola o nazwie customer_id, zmiana jego nazwy na client_id bez warstwy kompatybilności zamienia zmianę metadanych w incydent produkcyjny. Mechanika zmiany ma mniejsze znaczenie niż wpływ na odbiorców.
Wzorce ograniczające promień rażenia
Zespoły zazwyczaj ograniczają ryzyko zmian za pomocą niewielkiego zestawu wzorców. Aliasowanie kolumn pozwala zachować stare nazwy przy jednoczesnym wprowadzaniu nowych. Warstwy kompatybilności oparte na widokach mogą prezentować stabilny interfejs, podczas gdy tabela bazowa ewoluuje. Podwójne zapisy i wersjonowane sufiksy tabel mogą dać odbiorcom czas na migrację bez zmuszania ich do gwałtownego przejścia na nowy system. Każdy wzorzec kupuje czas, a czas to to, co chroni magazyn przed utratą elastyczności.
Dla zespołów pracujących nad szerszą dyscypliną zmian, pomocnymi ramami mogą być strategie zmian w projektach IT, ponieważ ewolucja magazynu często kończy się niepowodzeniem z tego samego powodu, dla którego ogólnie nie udają się zmiany platformy — z powodu niejasnej odpowiedzialności i słabej komunikacji.
Praktyczna lista kontrolna migracji
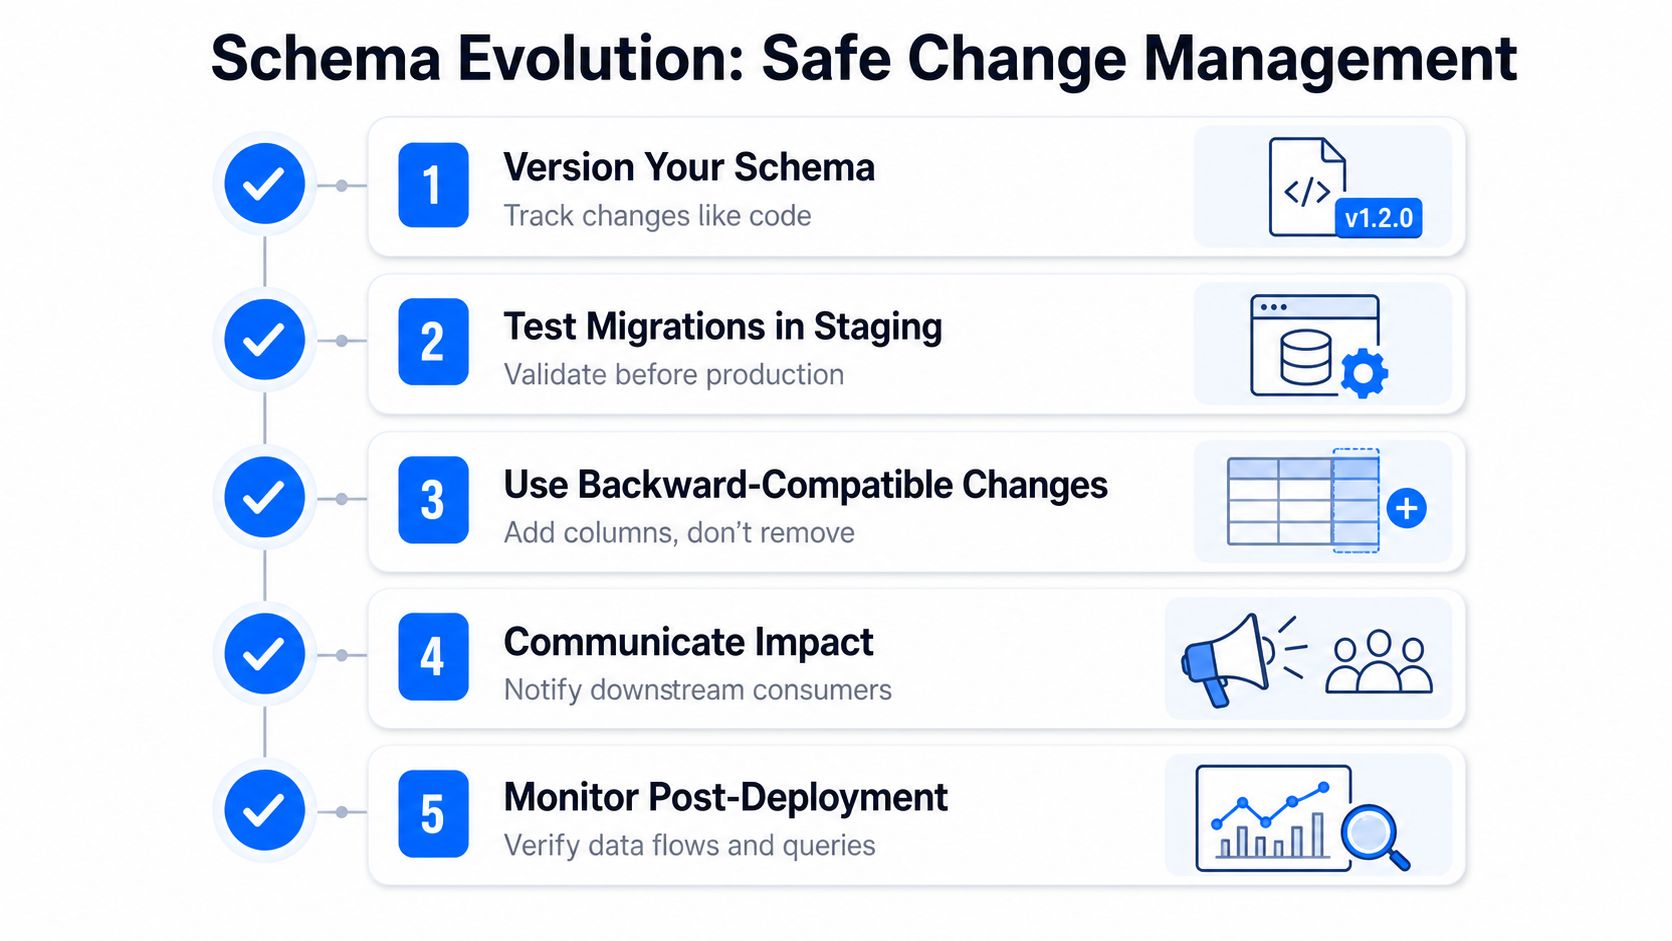
Wersjonuj schemat: Śledź zmiany tak jak kod, aby móc wyjaśnić, co i kiedy się zmieniło.
Najpierw testuj migracje etapowo: Zweryfikuj nowy kształt, zanim zobaczą go odbiorcy produkcyjni.
Preferuj zmiany wstecznie kompatybilne: Dodaj zanim usuniesz.
Komunikuj wpływ: Poinformuj właścicieli BI, inżynierii analitycznej i ML o tym, co ulegnie uszkodzeniu.
Monitoruj po wdrożeniu: Potwierdź, że zapytania, ładowania i pulpity nawigacyjne nadal zachowują się zgodnie z oczekiwaniami.
To jest zmiana mentalna, której potrzebują nowoczesne zespoły. Projektowanie schematu to praca nad cyklem życia, a nie praca nad diagramem. Jeśli model nie może bezpiecznie ewoluować, jego początkowa elegancja nie uratuje Cię później.
Praktyki z obszaru Observability, które chronią integralność schematu
Raport finansowy zwracający zera dwa dni po wdrożeniu to klasyczna cicha awaria. Zadania ładowania zakończyły się sukcesem, nikt nie zgłosił problemu przy pobieraniu danych, a jedyny widoczny symptom pojawił się znacznie później, gdy użytkownik biznesowy zaufał tej liczbie. Tego rodzaju dryf jest dokładnie tym powodem, dla którego integralność schematu musi być monitorowana, a nie zakładana z góry.
Obserwuj tryb awarii, a nie tylko potok
Zmiana schematu może wyglądać niegroźnie z punktu widzenia systemu źródłowego. Typ string staje się intem, kolumna się przesuwa lub pole znika z jednego środowiska i pojawia się w innym. Magazyn wciąż się ładuje, ale znaczenie nie odpowiada już temu, czego oczekują odbiorcy na dalszych etapach.
W tym miejscu śledzenie schematu zyskuje na znaczeniu. Narzędzie Schema Tracker firmy digna stale monitoruje strukturę tabel i wykrywa zmiany, takie jak dodane lub usunięte kolumny oraz modyfikacje typów danych. Jest przydatne, ponieważ wykrywa dryf strukturalny, zanim użytkownicy BI odkryją go w cyklu przeglądu. digna obsługuje również porównywanie schematów między środowiskami, co pomaga zespołom porównać wersje Dev, Test i Production przed uruchomieniem wydania na żywo.
Przypisz każdą praktykę observability do innego ryzyka
Ciągłe wykrywanie zmian schematu radzi sobie z dryfem strukturalnym. Monitorowanie terminowości wychwytuje brakujące lub opóźnione ładowania. Walidacja na poziomie rekordów sprawdza reguły biznesowe, dzięki czemu technicznie poprawny rekord, który narusza oczekiwaną logikę, wciąż zostaje oflagowany. Wykrywanie anomalii oparte na AI dodaje kolejną warstwę, obserwując zachowanie danych, a nie tylko metadane, co pomaga zespołom zauważyć, kiedy metryka zmienia się w nieoczekiwany sposób, nawet jeśli schemat nie uległ zmianie.
Te praktyki współpracują ze sobą. Śledzenie schematu mówi o zmianie struktury. Terminowość informuje, że dane nie dotarły na czas. Walidacja wskazuje, że rekord jest błędny według reguł biznesowych. Wykrywanie anomalii informuje, że zachowanie wygląda nietypowo, nawet jeśli wiersz technicznie istnieje.
Magazyn danych sam z siebie nie gwarantuje zaufania. Zaufanie wynika z obserwowania magazynu danych jako zależności produkcyjnej.
Jeśli chcesz poznać konkretny punkt odniesienia dla takiego sposobu myślenia, najlepsze praktyki observability digna pokazują, jak śledzenie schematu, walidacja, terminowość i monitorowanie anomalii łączą się w jeden model operacyjny.
Nie zatrzymuj się na alercie
Rzecz nie w tym, by zbierać więcej alertów. Chodzi o skrócenie czasu między dryfem a wykryciem. Dlatego observability musi być powiązane z własnością, eskalacją i znaną ścieżką przywracania stanu poprzedniego. Dla zespołów w środowiskach regulowanych jest to szczególnie ważne. Jeśli myślisz o bezpiecznym przetwarzaniu danych operacyjnych w innym kontekście, przewodnik WhisperAI po bezpiecznej transkrypcji jest dobrym przykładem tego, jak ściśle kontrolowane przepływy pracy zależą od niezawodnych mechanizmów kontroli danych.
Lista kontrolna i rekomendacje dla przedsiębiorstw
Zespoły w przedsiębiorstwach powinny traktować pracę nad schematami jako dyscyplinę governance, a nie preferencję modelowania. Zacznij od jasnego procesu biznesowego, zadeklaruj ziarno (grain), wybierz wymiary i zdefiniuj fakty na tym poziomie szczegółowości. Następnie zdecyduj, jak zachowasz kompatybilność, jak będziesz monitorować dryf i kto jest właścicielem każdej zmiany schematu w miarę ewolucji magazynu.
Działająca lista kontrolna dla przedsiębiorstw
Faza projektowania: Zacznij od schematu gwiazdy, chyba że obciążenie pracą wyraźnie wymaga normalizacji lub współdzielonych wymiarów.
Dyscyplina modelowania: Określ ziarno (grain) na wczesnym etapie i udokumentuj strategię wolno zmieniających się wymiarów dla każdego atrybutu opisowego, który może ulec zmianie.
Wdrożenie: Używaj kontraktów danych (data contracts), idempotentnych migracji i kontroli wersji dla zmian schematu.
Kontrola operacyjna: Śledź schematy, waliduj rekordy, monitoruj terminowość i wykrywaj anomalie w tym samym widoku operacyjnym.
Governance: Przechowuj historię zmian, analizę wpływu i mapowanie zgodności (Compliance) powiązane z kluczowymi tabelami.
W branżach regulowanych sam schemat staje się dowodem. Zespoły ds. usług finansowych, opieki zdrowotnej, telekomunikacji i sektora publicznego muszą wiedzieć, co się zmieniło, kiedy się zmieniło i które systemy downstream to widziały. Oznacza to, że magazyn danych jest nie tylko aktywem sprawozdawczym, ale częścią ścieżki audytu.
Co standaryzować w pierwszej kolejności
Pierwszym standardem powinna być kompatybilność. Drugim powinna być widoczność. Schemat, który zmienia się bez ścieżki przeglądu, ostatecznie nadszarpnie zaufanie, nawet jeśli wydajność zapytań wygląda dobrze. Schemat, który jest obserwowalny, wersjonowany i udokumentowany, może ewoluować bez zamieniania każdego wdrożenia w loterię.
Zacznij od prostych rzeczy, a następnie zaplanuj zmiany tak, jakby magazyn miał być używany przez lata — bo tak właśnie będzie.
digna zapewnia przedsiębiorstwom funkcje jakości danych i Data Observability, które śledzą zmiany schematów, walidują rekordy, monitorują terminowość i wykrywają anomalie w środowisku klienta. Jeśli budujesz magazyn danych, w którym BI, ML i governance zależą od stabilnych kontraktów, odwiedź digna, aby zobaczyć, jak to podejście pasuje do Twojego stosu technologicznego.
Najczęściej zadawane pytania
Co naprawdę koduje schemat hurtowni?
Znaczenie, a nie tylko sposób rozmieszczenia tabel. Traktowanie go jako układu tabel sprawia, że zmiana nazwy albo klucza przechodzi przegląd jako kosmetyczna, choć zmienia to, co faktycznie liczy wskaźnik niżej w łańcuchu.
Dlaczego nie da się użyć ponownie schematu transakcyjnego?
Bo oba rozwiązują różne problemy. Schemat transakcyjny optymalizuje poprawne zapisy pojedynczych rekordów, a schemat hurtowni optymalizuje pytania zadawane jednocześnie o wiele rekordów.
Kiedy ta różnica daje się we znaki?
Gdy kolumna zmienia nazwę albo zmienia się klucz. W tym momencie widok układu twierdzi, że nic się nie zepsuło, bo tabele nadal się łączą, a widok znaczenia widzi, że liczba wytwarzana przez raport się przesunęła.
Czym różnią się modele gwiazdy, płatka śniegu i galaktyki?
Ilością struktury, którą normalizują i dzielą. Gwiazda trzyma wymiary płasko wokół jednej tabeli faktów, płatek śniegu normalizuje te wymiary dalej, a galaktyka współdzieli zgodne wymiary między kilkoma tabelami faktów.
Czego potrzebuje ewolucja schematu, by pozostać bezpieczna?
Observability w punkcie zmiany. Śledzenie dodań, usunięć, zmian nazw i zmian typów wobec linii bazowej daje producentom i odbiorcom szansę na uzgodnienie, zanim zmiana strukturalna dotrze do pulpitu.




