9 rodzajów potoków danych: jak wybrać najlepszy w 2026 roku
|
10
min. czyt.

Więcej niż ETL: jak wybrać właściwą architekturę potoku danych
Twoje dashboardy są nieaktualne. Twoje modele ML dryfują. Interesariusze tracą zaufanie do danych. To typowe objawy niedopasowania architektury, czyli potoku danych, który nie nadąża już za potrzebami biznesu. Wybór właściwego potoku to nie tylko decyzja techniczna. To decyzja strategiczna, która wpływa na aktualność danych, niezawodność, nakład pracy operacyjnej i to, jak bardzo ludzie ufają każdej wykorzystywanej metryce.
Potoki rzadko zawodzą z powodu nietrafionego wyboru narzędzia. Problem wynika raczej z dopasowania niewłaściwej architektury do zadania. Nocne ładowanie hurtowni nie obsłuży zapobiegania nadużyciom finansowym. Stos strumieniowy to przesada przy cotygodniowym uzgadnianiu danych finansowych. Ten przewodnik koncentruje się na operacyjnej rzeczywistości stojącej za głównymi rodzajami potoków danych: gdzie każdy wzorzec zawodzi, czego zespoły zwykle nie doszacowują i jak od pierwszego dnia zapewnić każdemu z nich obserwowalność.
Jeśli budujesz zespół, jednocześnie porządkując architekturę, ten przewodnik po rolach inżynierów danych w Ameryce Łacińskiej daje przydatny kontekst na temat umiejętności, jakich wymagają takie systemy.
Spis treści
1. Potoki przetwarzania wsadowego
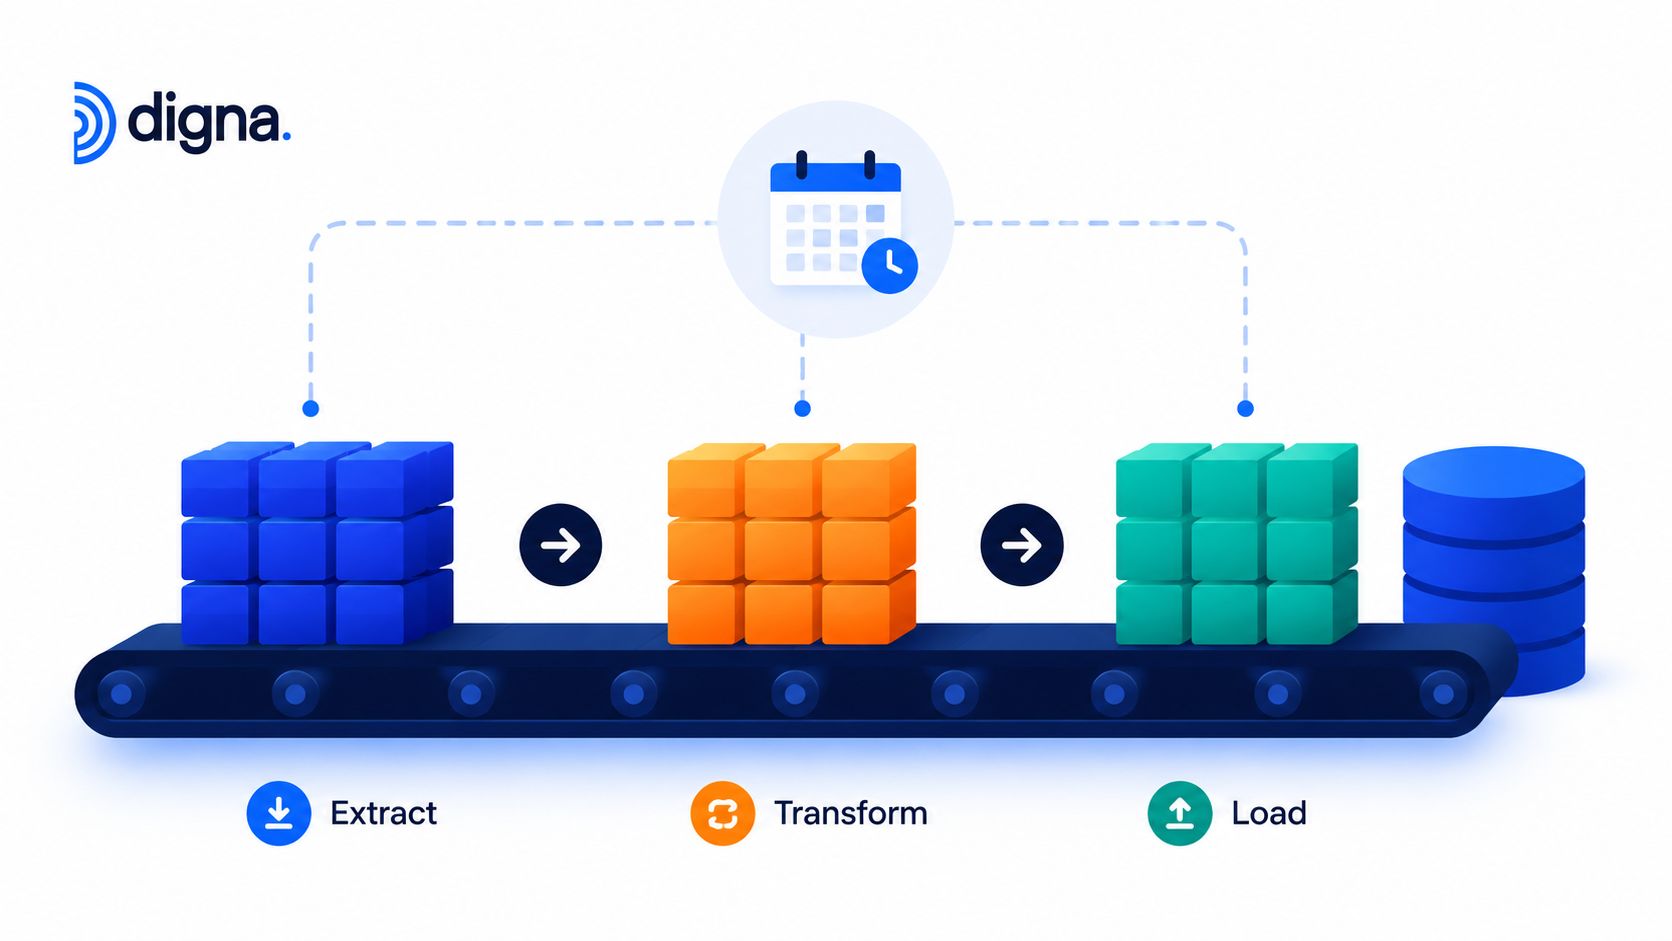
Potoki wsadowe wciąż stanowią trzon analityki w przedsiębiorstwach. IBM zauważa, że potoki przetwarzania wsadowego pozostają dominującą architekturą w tradycyjnej analityce i podejmowaniu decyzji na podstawie danych historycznych. Przetwarzają dane według stałych harmonogramów, np. co godzinę, codziennie lub co tydzień, i obsługują raportowanie, rozliczenia oraz analizy historyczne na dużą skalę w oparciu o sprawdzone wzorce ETL w korporacyjnych hurtowniach i składnicach danych (IBM o architekturach potoków danych).
Pokrywa się to z typowymi obserwacjami z produkcji. Nocne ładowanie hurtowni Snowflake, codzienna segmentacja klientów w systemach marketingowych, cotygodniowe uzgadnianie stanów magazynowych w handlu detalicznym i raportowanie finansowe na koniec dnia doskonale pasują do przetwarzania wsadowego. Jeśli decyzja biznesowa zapada jutro rano, a nie w ciągu najbliższych kilku sekund, przetwarzanie wsadowe jest często prostszym i tańszym rozwiązaniem.
Zespołom projektującym fundamenty pomoże przejrzysty przewodnik digna po architekturze potoków danych, który pokazuje, gdzie przetwarzanie wsadowe ma sens, a gdzie nie.
Gdzie przetwarzanie wsadowe wciąż wygrywa
Przetwarzanie wsadowe daje jasne punkty kontrolne. Wiesz, kiedy przebieg się zaczyna, kiedy się kończy i której partycji lub którego zestawu plików dotyczył. Taka struktura znacznie ułatwia uzupełnianie danych wstecz, uzgadnianie i rozmowy audytowe w porównaniu z systemami działającymi bez przerwy.
Sprawdza się też dobrze przy rozbudowanych regułach biznesowych. Jeśli normalizujesz dane finansowe z wielu ksiąg lub budujesz modele wymiarowe klasy hurtowni danych, często lepiej jest przetworzyć kompletny wycinek danych, niż gonić poprawność zdarzenie po zdarzeniu.
Praktyczna zasada: Jeśli odbiorca oczekuje wiarygodnej kompletności historycznej, a nie natychmiastowej reakcji, przetwarzanie wsadowe jest zwykle lepszym wyborem domyślnym.
Co zwykle idzie nie tak
Główny problem nie polega na tym, że przetwarzanie wsadowe jest przestarzałe. Chodzi o to, że zespoły monitorują infrastrukturę zamiast danych. DAG w Airflow może zakończyć się sukcesem, podczas gdy tabela źródłowa dociera z opóźnieniem, plik okazuje się pusty, a nowa kolumna niepostrzeżenie psuje model w dalszej części procesu.
Używaj digna Timeliness, aby wykrywać opóźnione lub brakujące partie danych, zanim dashboard stanie się nieaktualny. Używaj digna Data Validation do egzekwowania reguł biznesowych na poziomie rekordów podczas ładowania, a Schema Tracker do wychwytywania zmian kolumn lub typów, zanim kaskadowo spowodują awarie w BI. Zalecam też podział partii według domen logicznych, aby jeden wadliwy ekstrakt marketingowy nie blokował odtwarzania danych płacowych czy finansowych.
2. Potoki strumieniowe czasu rzeczywistego
Po przetwarzanie strumieniowe zespoły sięgają wtedy, gdy aktualność danych wpływa na działania, a nie tylko na analizy. Hevo opisuje potoki strumieniowe jako systemy ciągłego pozyskiwania danych, które aktualizują metryki, raporty i statystyki zbiorcze w ciągu sekund, a nawet milisekund, co czyni je kluczowymi dla wykrywania nadużyć, dashboardów na żywo, silników rekomendacji i innych zadań wrażliwych na czas w sektorach takich jak finanse i telekomunikacja (Hevo o potokach wsadowych i strumieniowych).
Brzmi to atrakcyjnie, ale kluczowe pytanie brzmi: czy ta szybkość jest Ci na tyle potrzebna, by płacić za złożoność? Monitorowanie płatności, alerty IoT, bieżący wgląd w stany magazynowe i rekomendacje produktów oparte na strumieniu kliknięć zwykle to uzasadniają. Cotygodniowy raport handlowych KPI już nie.
Co naprawdę daje przetwarzanie strumieniowe
Przetwarzanie strumieniowe skraca czas między powstaniem zdarzenia a podjęciem decyzji. Kontrole płatności w stylu Stripe, aktualizacje logistyczne zasilane przez Kinesis czy dashboardy operacyjne oparte na Kafce zależą właśnie od tej właściwości.
Ta architektura zmienia też sposób działania samej organizacji. Zespoły operacyjne przestają czekać na wczorajsze podsumowanie i zaczynają reagować na to, co dzieje się w tej chwili.
Problemy operacyjne
Systemy strumieniowe zawodzą inaczej niż wsadowe. Nie dostajesz po prostu komunikatu „zadanie nie powiodło się”. Dostajesz opóźnionych konsumentów, zdarzenia w niewłaściwej kolejności, duplikaty, spóźnione rekordy i dryf schematu w temacie, od którego zależy wiele usług w dalszej części procesu.
Praktyczna konfiguracja z digna wygląda tak:
Wczesne wykrywanie zmian tempa: digna Data Anomalies uczy się normalnego zachowania zdarzeń i wskazuje nieoczekiwane spadki lub skoki bez ciągłego dostrajania progów.
Ciągłe monitorowanie aktualności: obliczanie metryk przez digna bezpośrednio w bazie danych przydaje się do śledzenia opóźnień i sygnałów aktualności, których operatorzy potrzebują na co dzień.
Ochrona przed ewolucją tematów: digna Schema Tracker pomaga wychwycić zmiany schematu zdarzeń, zanim zepsują transformacje strumieniowe lub warstwy udostępniania.
Systemy strumieniowe zwykle nie zawodzą od razu głośno. Najpierw po cichu tracą jakość, a potem ktoś zauważa, że dashboard nie odpowiada już rzeczywistości.
Jeśli Twój strumień zawiera wrażliwe zdarzenia operacyjne, znaczenie ma wdrożenie w chmurze prywatnej. Zespoły w finansach, ochronie zdrowia i telekomunikacji często potrzebują obserwowalności we własnym środowisku, a nie w postaci kopii danych wysyłanej gdzie indziej.
3. Architektura lambda
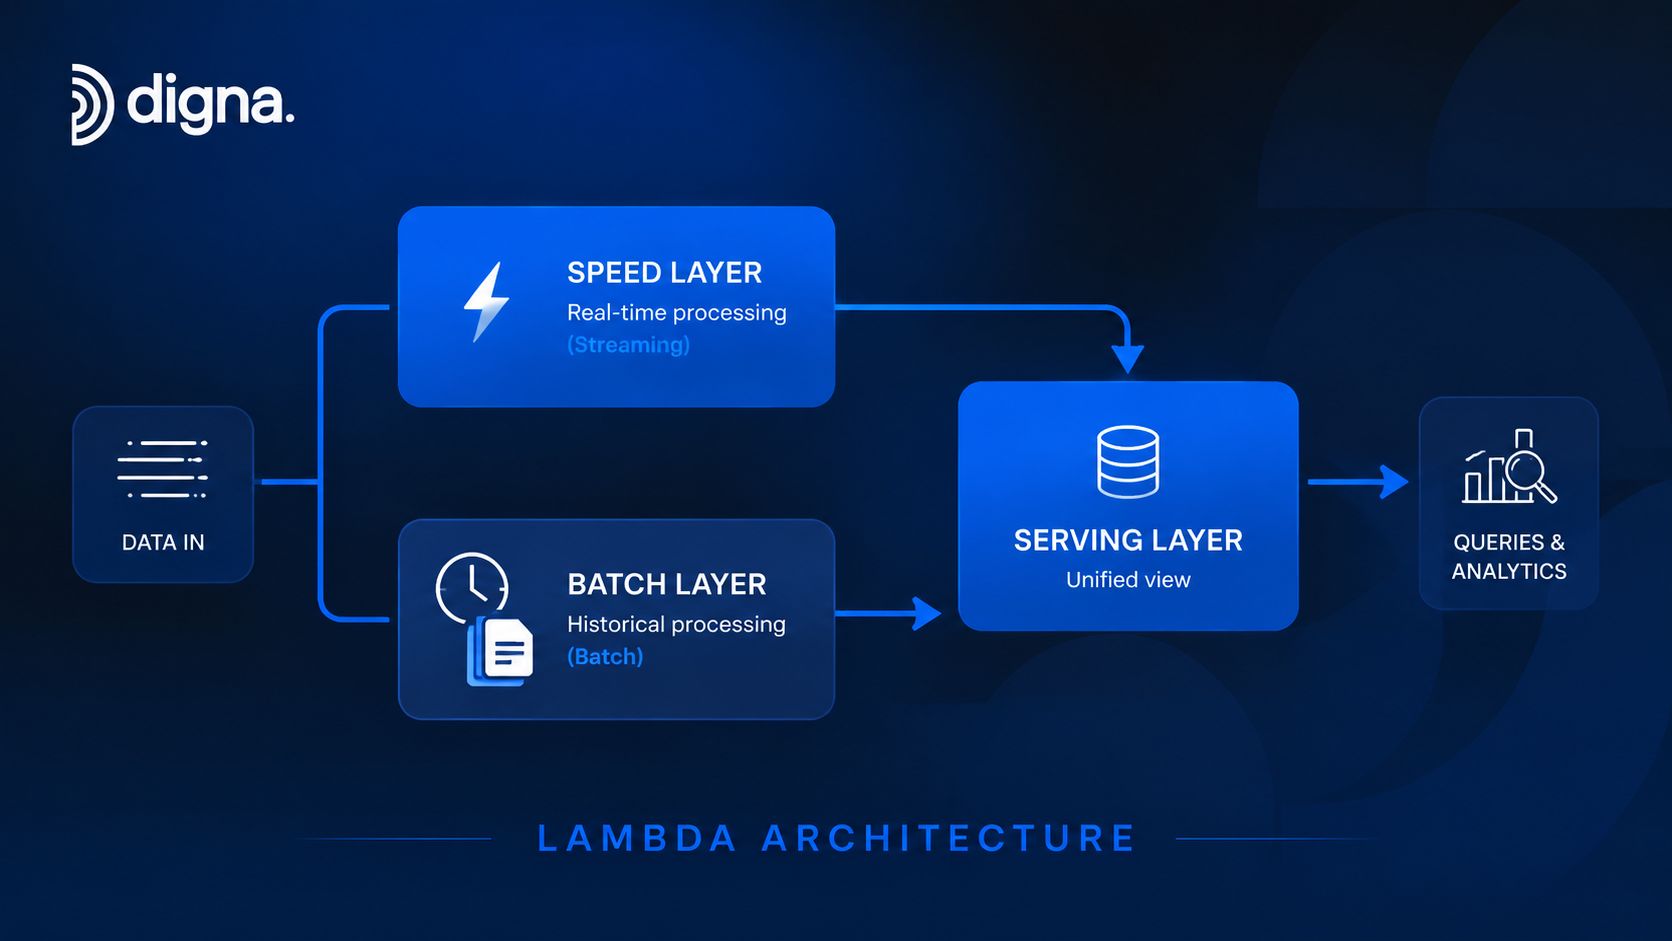
Architektura lambda istnieje, ponieważ niektóre organizacje potrzebują dwóch rzeczy jednocześnie: szybkich odpowiedzi teraz i dokładnych odpowiedzi później. Łączą więc strumieniową warstwę szybkości z warstwą wsadową, która ponownie oblicza pełny obraz, a następnie scalają oba wyniki w warstwie udostępniania.
Ten wzorzec wciąż pojawia się w analityce ryzyka, systemach rekomendacji i dużych platformach analitycznych, w których wartości śróddzienne mogą być przybliżone, ale wartości na koniec dnia muszą zostać skorygowane. Zaleta jest oczywista: nie trzeba wybierać między niskim opóźnieniem a kompletnością.
Dlaczego zespoły wybierają lambdę
Lambda przydaje się, gdy biznes może zaakceptować tymczasowe przybliżenie, ale nie trwałą niespójność. Dział ryzyka może potrzebować natychmiastowych szacunków ekspozycji w ciągu dnia, a w oficjalnym raportowaniu opierać się na pełniejszym przeliczeniu wsadowym. Zespół e-commerce może przesyłać na bieżąco aktualizacje zachowań użytkowników, a jednocześnie wsadowo trenować modele lub przeliczać szersze sygnały rekomendacyjne.
Taki podział może zmniejszyć obciążenie każdego pojedynczego silnika. Ścieżka strumieniowa odpowiada za natychmiastowość. Ścieżka wsadowa odpowiada za pełną, historyczną prawdę.
Kiedy lambda staje się kosztowna
Ukrytym kosztem jest zdublowana logika. Zespoły często implementują podobne reguły biznesowe dwukrotnie, a potem odkrywają, że „wystarczająco dobrze” w warstwie szybkości nie pokrywa się z „poprawnie” w warstwie wsadowej. Gdy te wyniki zaczynają się rozjeżdżać, zaufanie szybko spada.
Używaj digna do porównywania wyników z obu ścieżek, a nie tylko do sprawdzania, czy każda z nich osobno świeci się na zielono. Schema Tracker powinien obserwować obie warstwy, bo dryf w którejkolwiek z nich powoduje subtelne niezgodności. Data Validation również powinien działać w obu przepływach, aby kluczowe reguły dotyczące walut, identyfikatorów, wartości statusów czy semantyki ksiąg nie rozchodziły się z czasem.
Dobra konfiguracja lambdy traktuje rozbieżności jako pełnoprawny sygnał. digna Data Analytics jest tu przydatny, ponieważ pomaga operatorom sprawdzić, gdzie przybliżenia strumieniowe stale różnią się od późniejszych korekt wsadowych.
4. Architektura kappa
Kappa upraszcza lambdę do jednego modelu przetwarzania. Wszystko jest strumieniem. Nowe zdarzenia przechodzą przez ten sam procesor strumieniowy, a gdy trzeba ponownie przetworzyć historię, odtwarza się log przez tę samą logikę, zamiast utrzymywać osobną warstwę wsadową.
Inżynierowie to lubią, bo ścieżka kodu jest prostsza. Typowy kształt to Kafka z Kafka Streams lub Flink. Telemetria mobilna, platformy SaaS sterowane zdarzeniami i systemy IoT często dobrze do tego pasują, gdy log zdarzeń jest trwały, a odtwarzanie realne.
Dlaczego inżynierowie lubią kappę
Największą zaletą jest spójność. Jedna ścieżka transformacji oznacza mniej okazji do rozjeżdżania się logiki biznesowej. Jeśli ufasz swojemu logowi zdarzeń, odtwarzanie staje się Twoją strategią odzyskiwania i uzupełniania danych wstecz.
Sprawdza się to szczególnie w organizacjach, które już myślą kategoriami zdarzeń. Analityką produktową, strumieniami interakcji użytkowników i strumieniami aktywności mikrousług często łatwiej zarządzać w modelu kappa niż w rozdzielonym projekcie wsadowo-strumieniowym.
Co może zepsuć systemy oparte na odtwarzaniu
Odtwarzanie brzmi czysto, dopóki nie zderzy się z rzeczywistością operacyjną. Historyczne zdarzenia mogą już nie pasować do bieżącego schematu. Konsumenci w dalszej części procesu mogą nie być idempotentni. Ponowne przetwarzanie może zalać systemy zwymiarowane wyłącznie na ruch bieżący.
digna pomaga najbardziej wtedy, gdy traktujesz odtwarzanie jako obserwowalny tryb działania, a nie rzadki przypadek awaryjny. Ustal bazowe poziomy terminowości zarówno dla bieżącego przepływu, jak i dla okien odtwarzania. Stosuj Schema Tracker na logu zdarzeń, zanim zmiana wersji zamieni ponowne przetwarzanie historii w kaskadę awarii. Stosuj do odtwarzanych zdarzeń te same reguły Data Validation co do bieżących, w przeciwnym razie zatwierdzisz jedną ścieżkę i nieświadomie osłabisz drugą.
Ponowne przetwarzanie to nie tylko „uruchom jeszcze raz”. To osobny scenariusz niezawodności, który wymaga własnych oczekiwań.
5. Potoki Change Data Capture
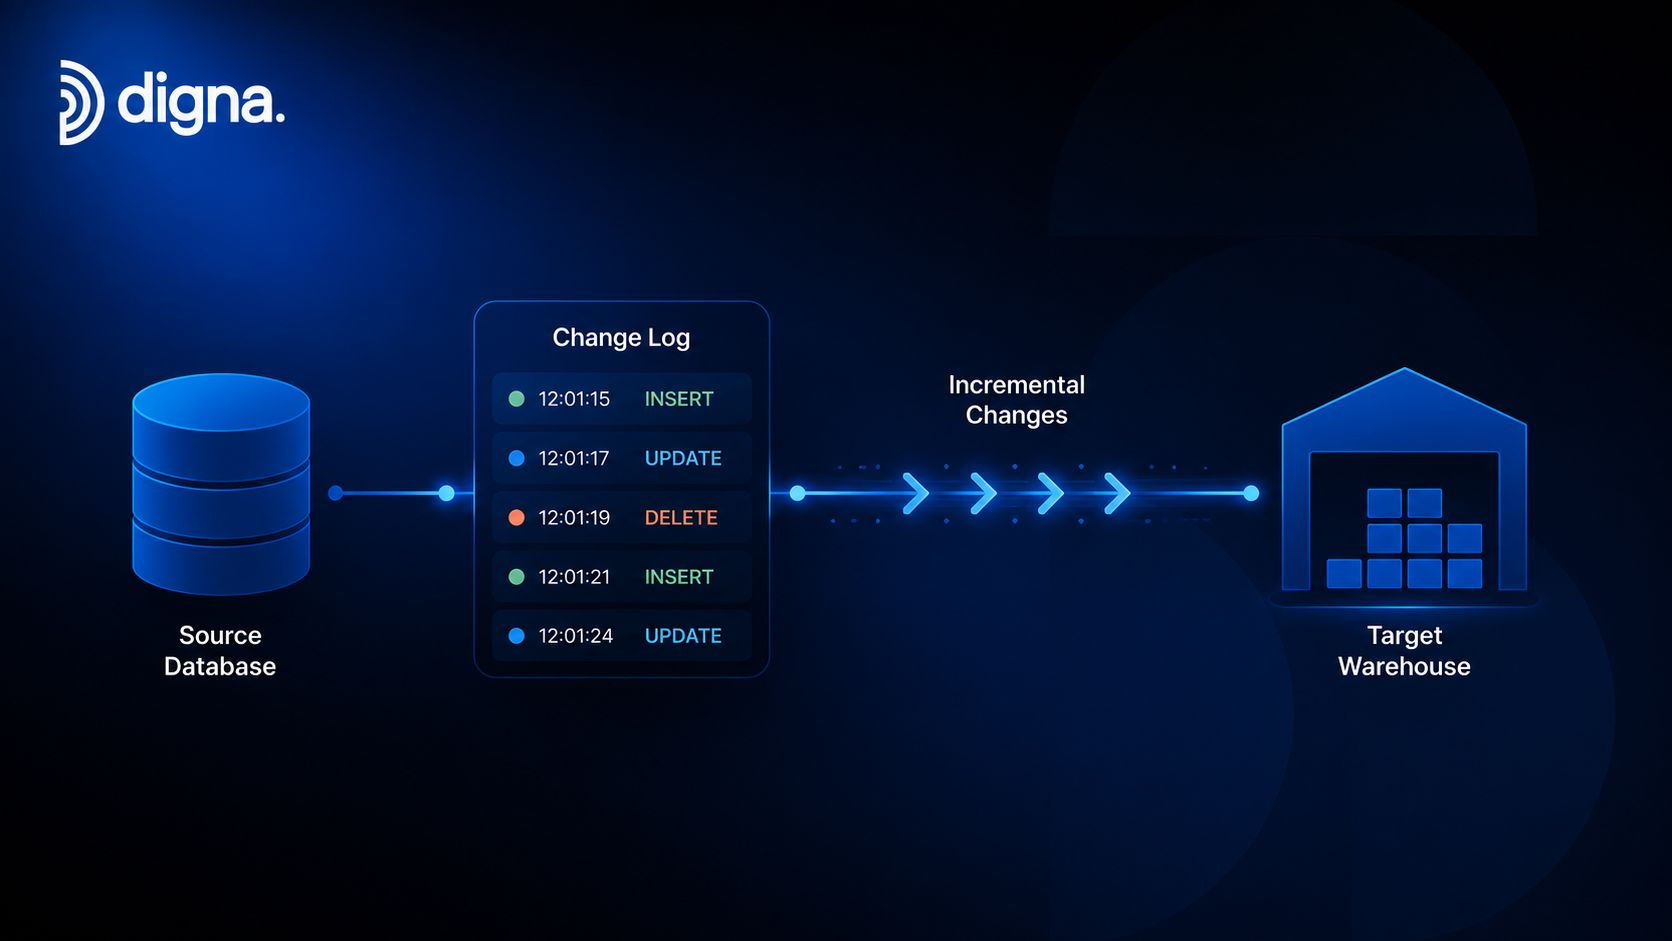
Potoki CDC przenoszą tylko to, co się zmieniło. Zamiast skanować pełne tabele przy każdym przebiegu, przechwytują wstawienia, aktualizacje i usunięcia z operacyjnych baz danych i propagują te zmiany dalej. Popularnymi wyborami są Debezium, AWS DMS i natywne mechanizmy replikacji.
To jeden z najbardziej praktycznych rodzajów potoków danych, ponieważ ogranicza niepotrzebne ponowne obliczenia i wspiera synchronizację między systemami z niższym opóźnieniem. Składnice raportowe, synchronizacja z hurtowniami w chmurze i analityka operacyjna często osiągają znacznie lepsze wyniki dzięki CDC niż dzięki wielokrotnym pełnym ekstraktom.
Dlaczego CDC szybko zyskuje na popularności
Research and Markets prognozuje, że potoki CDC będą drugim najszybciej rosnącym segmentem wśród rodzajów potoków danych, z przewidywanym CAGR na poziomie od 18% do 20% do 2030 roku, ponieważ przedsiębiorstwa dążą do synchronizacji o niskim opóźnieniu w takich zastosowaniach jak aktualizacje stanów magazynowych i ksiąg, bez ponownego przeliczania pełnych tabel (Research and Markets o segmentach narzędzi do potoków).
Ten wzrost ma sens. Pełne ładowanie tabel jest marnotrawstwem, gdy zmienił się tylko niewielki wycinek, i stanowi ryzyko operacyjne, gdy systemy źródłowe są wrażliwe na obciążenie związane z ekstrakcją.
Najtrudniejsze nie jest przechwytywanie
Najtrudniejsze jest zachowanie znaczenia. Usunięcia muszą pozostać widoczne w dalszej części procesu. Kolejność aktualizacji musi pozostać poprawna. Zmiany kluczy głównych i zmiany schematu mogą tworzyć duplikaty lub osierocone rekordy, jeśli potok traktuje je jak zwykłe zdarzenia dopisania.
Solidny model operacyjny CDC obejmuje:
Jawną walidację usunięć: digna Data Validation może potwierdzić, że systemy w dalszej części procesu odzwierciedlają usunięcia tak, jak oczekują tego konsumenci.
Pomiar opóźnienia replikacji: digna Timeliness pomaga operatorom zobaczyć, kiedy zmiany ze źródła docierają zbyt wolno, by wspierać proces biznesowy.
Śledzenie ewolucji źródeł: digna Schema Tracker jest ważny dla CDC, ponieważ zmiany w źródłowych bazach danych często zachodzą poza kontrolą zespołu analitycznego.
Podejrzane serie usunięć lub nietypowe wzorce aktualizacji również warto oznaczać za pomocą digna Data Anomalies. Na produkcji takie wzorce często ujawniają błędy aplikacji, zanim zauważą je programiści.
6. Potoki wirtualizacji danych
Nie każdy potok musi fizycznie przenosić dane. Wirtualizacja danych tworzy warstwę logiczną, która prezentuje ujednolicony widok wielu systemów, pozostawiając dane na miejscu. Znane przykłady to Denodo, zapytania federacyjne w hurtowniach, tabele zewnętrzne Snowflake i federacja w BigQuery.
Ten wzorzec przydaje się, gdy kopiowanie danych jest powolne, trudne organizacyjnie lub ograniczone przez zasady ładu danych. Placówki ochrony zdrowia mogą potrzebować ujednoliconego widoku pacjenta z różnych systemów szpitalnych. Instytucje finansowe mogą potrzebować międzyplatformowego widoku klienta bez konieczności wcześniejszego przenoszenia każdego starszego źródła do jednej hurtowni.
Kiedy wirtualizacja jest właściwym wyborem
Wirtualizacja sprawdza się, gdy dostęp jest ważniejszy niż złożone transformacje. Szybko daje zespołom wspólny interfejs semantyczny i może wspierać autonomię domen, gdy centralna konsolidacja trwałaby zbyt długo lub wywołałaby spory o własność danych.
Ogranicza też przenoszenie danych. To atrakcyjne, gdy systemy są duże, regulowane lub często się zmieniają.
Gdzie warstwy wirtualne zawodzą w praktyce
Największym błędem jest udawanie, że warstwa wirtualna usuwa problemy systemów źródłowych. Nie usuwa. Ujawnia je szybciej. Jeśli jedno źródło jest spóźnione, wolne lub niespójne strukturalnie, wynik federacji dziedziczy tę słabość.
Z tego powodu monitorowanie jakości musi zaczynać się na styku ze źródłem, a nie tylko w warstwie semantycznej. digna w konfiguracji chmury prywatnej jest tu przydatna, ponieważ zespoły mogą monitorować jakość i zmiany schematu w źródłach federacyjnych bez przenoszenia wrażliwych rekordów. Monitorowanie terminowości pomaga też ustalić, które źródło pogarsza wydajność zapytań lub aktualność danych, zanim zwirtualizowany wynik stanie się bezużyteczny.
Warstwa wirtualna może ujednolicić dostęp. Nie ujednolici niezawodności, jeśli nie obserwujesz każdego źródła osobno.
7. Strumieniowanie zdarzeń z event sourcingiem
Event sourcing zmienia pojęcie rekordu systemowego. Zamiast przechowywać tylko bieżący stan, system zapisuje każdą zmianę stanu jako niezmienne zdarzenie. Subskrybenci budują następnie na podstawie tej historii projekcje, widoki zmaterializowane i modele odczytu.
Dzięki temu architektura ta jest atrakcyjna w zarządzaniu zamówieniami, bankowych ścieżkach audytu, śledzeniu cyklu życia przejazdów i systemach CQRS, w których historia w czasie jest równie ważna jak stan bieżący. Jeśli ktoś zapyta: „Co wiedzieliśmy w tamtym momencie?”, event sourcing pozwala odpowiedzieć jednoznacznie.
Co dają niezmienne zdarzenia
Najczęściej wymienianą korzyścią jest audytowalność, ale praktycznym zyskiem jest możliwość rekonstrukcji. Zespoły mogą odbudowywać projekcje, analizować przejścia między stanami i dokładnie zrozumieć, które zdarzenia doprowadziły do stanu końcowego.
Ma to znaczenie w środowiskach regulowanych i w złożonych systemach transakcyjnych. Gdy zamówienie przechodzi od złożenia przez spakowanie i wysyłkę aż po zwrot środków, każde przejście ma znaczenie operacyjne.
Dlaczego obserwowalność ma tu większe znaczenie
System oparty na event sourcingu nie wybacza błędnie sformułowanych zdarzeń. Jeśli wadliwe zdarzenie trafi do logu, projekcje w dalszej części procesu mogą je różnie interpretować lub zawodzić w różnych miejscach. Wersjonowanie również jest trudne, ponieważ starzy i nowi konsumenci mogą współistnieć przez długi czas.
Używaj digna Data Validation do egzekwowania struktury zdarzeń i wymaganych pól, zanim szkody rozprzestrzenią się przez łańcuchy subskrybentów. Używaj Timeliness do wykrywania opóźnionych subskrybentów, a Schema Tracker do monitorowania przejść między wersjami zdarzeń, aby producenci bez ostrzeżenia nie psuli starszych projekcji. Data Anomalies przydaje się też do wychwytywania podejrzanych sekwencji zdarzeń, które mogą wskazywać na nadużycia, oszustwa lub błędy aplikacji.
W takich systemach „jakość potoku” i „poprawność aplikacji” nakładają się na siebie. Dlatego ogólne monitorowanie infrastruktury nie wystarcza.
8. Data mesh ze zdecentralizowanymi potokami
Data mesh to nie tyle pojedynczy wzorzec potoku, ile model operacyjny dla wielu potoków. Zespoły domenowe są właścicielami swoich produktów danych i stojących za nimi potoków, a warstwa ładu danych ustala wspólne standardy dotyczące wykrywalności, jakości, kontraktów i dostępu.
To podejście przemawia do dużych organizacji, w których jeden centralny zespół platformy danych stał się wąskim gardłem. Zespoły produktowe, finansowe, ryzyka, marketingu i operacji mogą działać szybciej, gdy same odpowiadają za dane, które wytwarzają.
Co naprawia decentralizacja
Naprawia utratę lokalnego kontekstu. Zespół domenowy zwykle lepiej niż odległy zespół centralny rozumie znaczenie anulowań, aktywnych użytkowników, odnowień polis czy nieudanych płatności. Poprawia to decyzje modelowe i czas reakcji, gdy coś się zmienia.
Skaluje też dostarczanie. Nie ma jednego centralnego backlogu dla każdej ekstrakcji, aktualizacji schematu i prośby konsumenta.
Jeśli Twoja organizacja odchodzi od scentralizowanej własności danych, warto bliżej przyjrzeć się architekturze data mesh i jej wpływowi na nowoczesne środowiska danych.
Co zamienia data mesh w chaos
Bez wspólnej obserwowalności data mesh staje się zbiorem odizolowanych awarii. Jeden zespół definiuje aktualność w jeden sposób, inny ignoruje kontrakty schematów, a konsumenci dostają pięć różnych standardów jakości w zależności od tego, którą domenę odpytują.
digna sprawdza się tu jako warstwa ujednolicająca. Każda domena może zachować autonomię w zakresie swoich potoków, korzystając z tych samych wzorców Data Validation, tych samych ram Timeliness i tej samej dyscypliny Schema Tracker. Znaczenie ma też wdrożenie w chmurze prywatnej lub on-premises, ponieważ zdecentralizowane zespoły często działają w wrażliwych obszarach biznesu, które nie mogą wysyłać danych produkcyjnych poza kontrolowane środowiska.
Nie chodzi o ponowną centralizację własności. Chodzi o standaryzację niezawodności bez spłaszczania wiedzy domenowej.
9. Potoki cech dla uczenia maszynowego
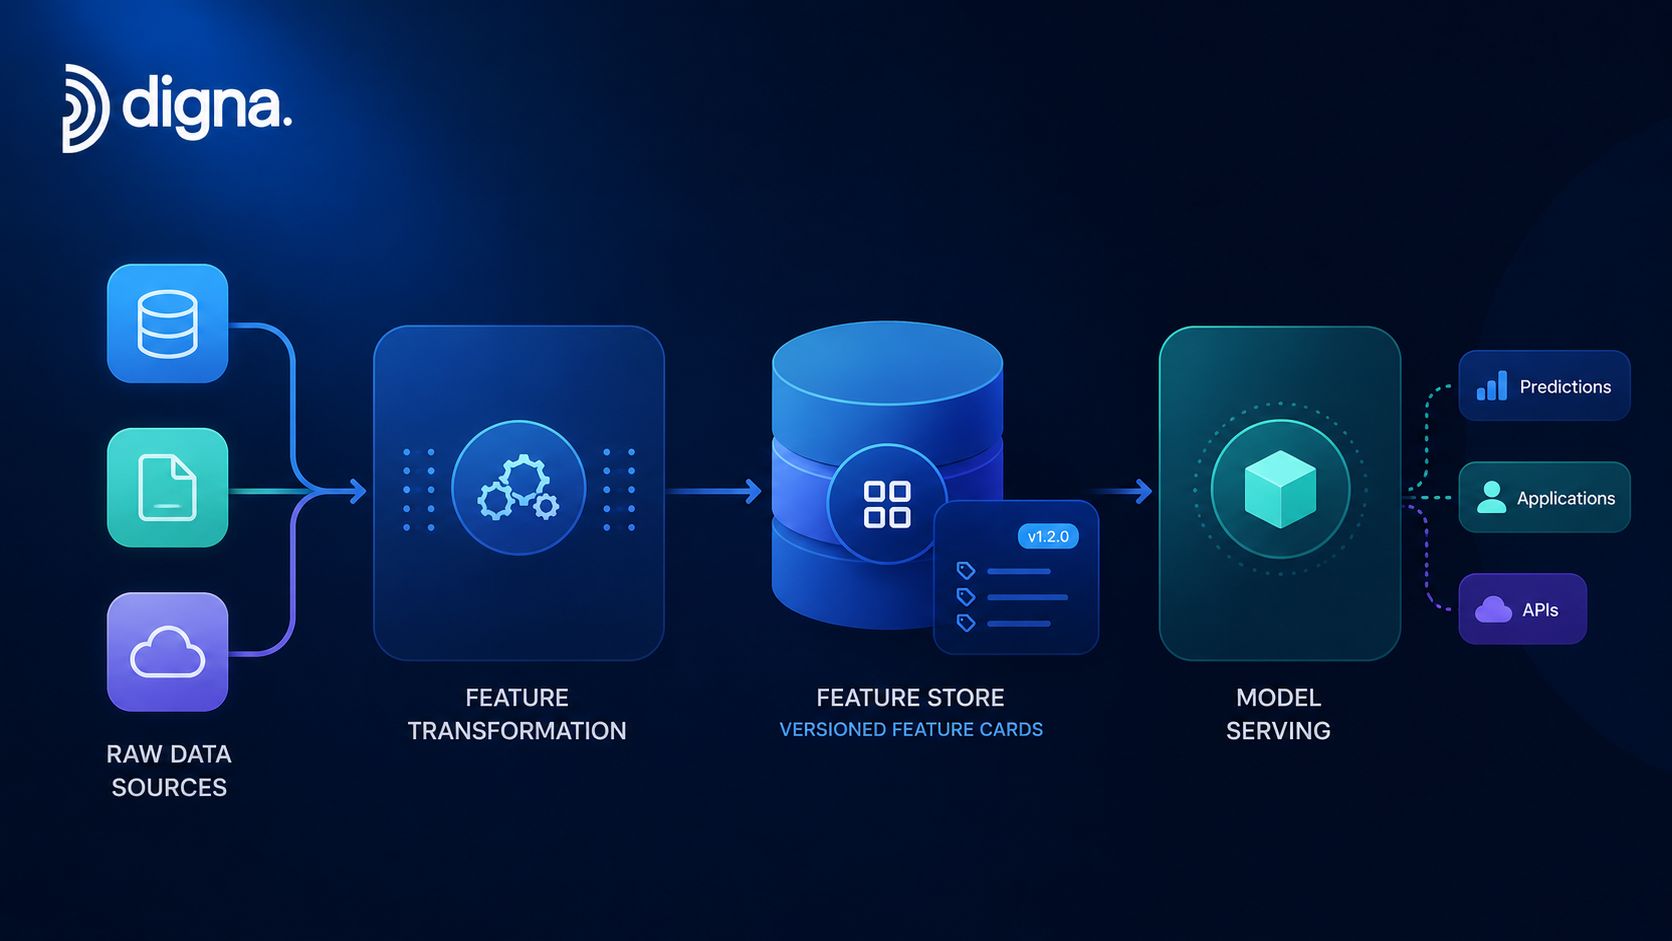
Potoki cech znajdują się na styku inżynierii danych i operacji ML. Obliczają, wersjonują, przechowują i udostępniają przygotowane dane wejściowe, z których modele korzystają podczas trenowania i wnioskowania. Popularne przykłady to Feast, Databricks Feature Store i Tecton.
Z daleka wyglądają podobnie do innych rodzajów potoków danych, ale standard operacyjny jest wyższy. Dashboard może przez jakiś czas tolerować nieaktualną metrykę. Model produkcyjny może niezauważenie tracić jakość, jeśli zmienia się aktualność cech, obsługa wartości null lub rozkład wartości, a nikt tego nie wychwyci.
Dlaczego potoki cech są inne
Mają dwóch konsumentów o różnych potrzebach. Systemy treningowe potrzebują odtwarzalności i spójności historycznej. Wnioskowanie online potrzebuje bieżących wartości i niskiego opóźnienia udostępniania.
Architektura zmienia się też w zależności od podejścia do transformacji. GII Research zauważa, że w środowiskach cloud-native ELT wyraźnie wyprzedziło tradycyjne ETL, ponieważ skalowalna moc obliczeniowa hurtowni umożliwia wydajną transformację po załadowaniu. ETL dominuje natomiast tam, gdzie wymagane jest rygorystyczne czyszczenie danych przed załadowaniem i egzekwowanie schematu. Dominującym modelem jest wdrożenie w chmurze, a podejścia hybrydowe z procesami serverless, takimi jak AWS Glue i Azure Data Factory, stają się standardem w organizacjach równoważących skalę z integracją starszych systemów (GII Research o modelach wdrożenia oraz ETL i ELT).
Awaria, którą zespoły zauważają za późno
Częstym błędem jest monitorowanie modelu przy jednoczesnym ignorowaniu potoku cech. Zanim spadnie wydajność modelu, problem z cechami może istnieć od wielu dni.
Praktyczna konfiguracja obserwowalności obejmuje:
Obserwację zachowań przypominających dryf w danych wejściowych: digna Data Anomalies może sygnalizować nieoczekiwane zmiany rozkładów cech, zanim przełożą się one na słabe wyniki modelu.
Monitorowanie aktualności udostępnianych danych: digna Timeliness pomaga wychwycić nieaktualne cechy, zanim magazyn online udostępni przestarzałe wartości.
Śledzenie zmian strukturalnych: digna Schema Tracker przydaje się, gdy definicje cech ewoluują, kolumny pojawiają się lub znikają albo wyniki transformacji zmieniają kształt.
Potoki cech potrzebują też twardych ograniczeń biznesowych. Jeśli cecha wyprowadzona z ceny staje się ujemna lub pole kategorii dociera puste, Data Validation powinien zatrzymać problem na granicy potoku. Dla zespołów budujących systemy personalizacji skierowane do klientów jest to równie ważne jak sam wybór modelu. Ta sama dyscyplina operacyjna wpływa też na sąsiednie systemy kształtujące doświadczenia użytkowników, w tym na działania związane z optymalizacją wizualizacji w e-commerce za pomocą AI.
Porównanie 9 rodzajów potoków danych
Potok / architektura | Złożoność wdrożenia 🔄 | Wymagania zasobowe i obciążenie operacyjne ⚡ | Oczekiwane rezultaty (aktualność / dokładność) ⭐📊 | Idealne zastosowania 📊 | Kluczowe zalety i szybka wskazówka 💡 |
|---|---|---|---|---|---|
Potoki przetwarzania wsadowego | Niska → umiarkowana (zadania według harmonogramu, prostsza eksploatacja) 🔄 | Wydajne przy dużych wolumenach; szczytowa rywalizacja o zasoby w oknach przetwarzania ⚡ | Wysoka dokładność ⭐⭐⭐, wysokie opóźnienie (godziny→dni) 📊 | Nocne raportowanie, ETL na dużą skalę, okresowa analityka | Sprawdzona niezawodność; wskazówka: monitoruj terminowość, aby wychwycić pominięte okna 💡 |
Potoki strumieniowe czasu rzeczywistego | Wysoka (rozproszone procesory strumieniowe i brokery) 🔄 | Wysokie stałe koszty obliczeń i eksploatacji; wymaga wyspecjalizowanego personelu ⚡ | Bardzo niskie opóźnienie, aktualność zbliżona do czasu rzeczywistego ⭐⭐📊 (dokładność zależy od gwarancji) | Wykrywanie nadużyć, dashboardy operacyjne, analityka na żywo | Umożliwia natychmiastowe wykrywanie; wskazówka: stosuj wykrywanie anomalii dla wzorców strumieniowych 💡 |
Architektura lambda | Bardzo wysoka (podwójne ścieżki kodu + warstwa udostępniania) 🔄 | Bardzo wysokie (utrzymanie infrastruktury wsadowej i strumieniowej) ⚡ | Przybliżenia o niskim opóźnieniu + dokładne korekty wsadowe ⭐⭐⭐📊 | Zadania wymagające zarówno natychmiastowego widoku, jak i dokładnego przeliczenia historii | Łączy szybkość z dokładnością; wskazówka: weryfikuj spójność między warstwami za pomocą monitorowania 💡 |
Architektura kappa | Wysoka (wyłącznie strumieniowa, z możliwością odtwarzania) 🔄 | Wysokie (przestrzeń w brokerze na historię i szczyty ponownego przetwarzania) ⚡ | Spójna logika, aktualność w czasie rzeczywistym; możliwe ponowne przetwarzanie ⭐⭐📊 | Systemy sterowane zdarzeniami, w których strumień obsługuje ponowne przetwarzanie (Kafka/Flink) | Prostota operacyjna w porównaniu z lambdą; wskazówka: zapewnij retencję logu zdarzeń i monitoruj odtwarzanie 💡 |
Potoki Change Data Capture (CDC) | Umiarkowana → wysoka (dostęp do logów, mapowanie) 🔄 | Niewielki transfer sieciowy; umiarkowana infrastruktura do przetwarzania i porządkowania ⚡ | Przyrostowe aktualizacje o niskim opóźnieniu, wysoka wierność ⭐⭐⭐📊 | Synchronizacje przyrostowe, hurtownie czasu rzeczywistego, składnice raportowe | Minimalizuje przenoszenie danych; wskazówka: starannie śledź zmiany schematu i obsługę usunięć 💡 |
Potoki wirtualizacji danych | Umiarkowana (warstwa semantyczna i konektory) 🔄 | Niewielkie zapotrzebowanie na pamięć masową, ale czas działania zależy od wydajności źródeł; zmienne koszty ⚡ | Aktualność w czasie rzeczywistym, ale zmienna wydajność zapytań ⭐⭐📊 | Analityka ad hoc, zapytania federacyjne, szybkie demonstracje ładu danych | Szybkie wdrożenie przy minimalnym przenoszeniu danych; wskazówka: monitoruj SLA źródeł i wydajność złączeń 💡 |
Strumieniowanie zdarzeń z event sourcingiem | Wysoka (niezmienny log, projekcje, wersjonowanie) 🔄 | Duże zapotrzebowanie na pamięć dla pełnej historii; złożoność operacyjna projekcji ⚡ | Pełna audytowalność i możliwość rekonstrukcji, analiza w czasie ⭐⭐⭐📊 | Ścieżki audytu, CQRS, systemy wymagające pełnej historii i odtwarzania | Doskonałe dla zgodności i debugowania; wskazówka: weryfikuj schematy zdarzeń i terminowość ich napływu 💡 |
Data mesh ze zdecentralizowanymi potokami | Wysoka (złożoność organizacyjna i techniczna) 🔄 | Wyższa łączna infrastruktura we wszystkich domenach; koszty narzędzi federacyjnych ⚡ | Rezultaty skalowalne i dopasowane do domen; jakość różni się w zależności od domeny ⭐⭐📊 | Duże organizacje dążące do autonomii domen i danych jako produktu | Skaluje się dzięki autonomii; wskazówka: egzekwuj federacyjną obserwowalność i wspólne kontrakty 💡 |
Potoki cech dla uczenia maszynowego | Wysoka (wersjonowanie cech, poprawność w punkcie czasu) 🔄 | Umiarkowane→wysokie zapotrzebowanie na pamięć i moc obliczeniową; eksploatacja magazynu cech ⚡ | Spójne cechy w trenowaniu i udostępnianiu, mniejszy dryf modeli ⭐⭐⭐📊 | Magazyny cech, udostępnianie modeli, odtwarzalne przepływy pracy ML | Zwiększa niezawodność ML; wskazówka: stale monitoruj aktualność i dryf cech 💡 |
Od architektury do eksploatacji: jak zapewnić niezawodność potoku
Wybór właściwej architektury to pierwsza ważna decyzja, ale nie ostatnia. Potoki wsadowe, strumieniowe, CDC, oparte na event sourcingu i ukierunkowane na ML rozwiązują różne problemy z dostarczaniem danych, ale każda architektura wnosi też własne ryzyka dla jakości i niezawodności.
Potoki wsadowe ukrywają opóźnienia, dopóki zaplanowany przebieg nie przekroczy swojego okna. Systemy strumieniowe działają dalej, niepostrzeżenie oddalając się od oczekiwanego zachowania. Lambda tworzy problemy ze spójnością między ścieżkami. Kappa sprawia, że poprawność odtwarzania staje się kwestią pierwszorzędną. CDC może szybko replikować zmiany, a mimo to błędnie obsługiwać usunięcia lub kolejność aktualizacji. Wirtualizacja może ujednolicić dostęp, maskując słabości systemów bazowych. Data mesh może przyspieszyć pracę domen, jednocześnie rozdrabniając standardy. Potoki cech mogą udostępniać dane długo po tym, jak dane wejściowe modeli stały się wadliwe.
Właśnie z powodu tej rzeczywistości operacyjnej diagramy architektury nie wystarczą. Każdy potok produkcyjny potrzebuje warstwy kontrolnej, która powie Ci, czy dane docierają na czas, czy rekordy nadal spełniają reguły biznesowe, czy zmieniły się schematy i czy wzorce w danych nadal wyglądają normalnie. Jeśli obserwujesz tylko zadania, kontenery lub wydatki na hurtownię, przeoczysz awarie, które niszczą zaufanie.
Najlepsze zespoły wbudowują obserwowalność i walidację w potok od pierwszego dnia. Nie czekają na pierwszą awarię dashboardu dla zarządu ani na pierwszy incydent z modelem. Definiują oczekiwane zachowanie w zakresie napływu danych. Śledzą zmiany schematów, zanim systemy w dalszej części procesu przestaną działać. Walidują kluczowe rekordy w momencie ich przenoszenia, a nie po tym, jak analitycy zgłoszą problemy. Analizują anomalie w kontekście, zamiast polegać wyłącznie na kruchych, ręcznie dostrajanych progach.
Właśnie tu digna dobrze sprawdza się we wszystkich głównych rodzajach potoków danych. Połączenie Timeliness, Data Validation, Schema Tracker, Data Anomalies i Data Analytics odpowiada na wzorce awarii, z którymi inżynierowie mierzą się w praktyce. Ponieważ digna oblicza metryki wewnątrz bazy danych klienta i obsługuje wdrożenia w chmurze prywatnej lub on-premises, zespoły mogą monitorować wrażliwe środowiska bez przekazywania danych produkcyjnych zewnętrznemu dostawcy.
Jest też korzyść strategiczna. Gdy interesariusze mogą ufać, że aktualność, struktura i poprawność rekordów są aktywnie monitorowane, dyskusje o architekturze stają się lepsze. Zespoły przestają abstrakcyjnie spierać się o style potoków i zaczynają wybierać projekt dopasowany do potrzeb biznesu, z jasnym planem bezpiecznej eksploatacji.
Niezawodne potoki danych to nie tylko przenoszenie danych z punktu A do punktu B. Chodzi o dostarczanie danych, na podstawie których ludzie mogą działać bez ciągłego ich podważania. To standard, do którego warto projektować.
Jeśli chcesz mieć taki poziom kontroli w potokach wsadowych, strumieniowych, CDC, potokach cech i zdecentralizowanych produktach danych, digna została do tego stworzona. Daje zespołom danych jedną platformę do wykrywania anomalii, walidacji na poziomie rekordów, monitorowania terminowości, śledzenia zmian schematów i historycznej analizy obserwowalności, a wszystko to przy zachowaniu danych w środowiskach kontrolowanych przez klienta.
Przebiegi wsadowe, które przekraczają swoje okno, i strumienie CDC z rosnącym opóźnieniem replikacji mają wspólny objaw: dane docierają później, niż oczekuje biznes. Właśnie tego uczy się digna Timeliness i właśnie o tym alarmuje.
Najczęściej zadawane pytania
Jakie są główne rodzaje potoków danych?
Artykuł omawia dziewięć: przetwarzanie wsadowe, przetwarzanie strumieniowe w czasie rzeczywistym, architekturę lambda, architekturę kappa, change data capture, wirtualizację danych, strumieniowanie zdarzeń z event sourcingiem, data mesh ze zdecentralizowanymi potokami oraz potoki cech dla uczenia maszynowego. Każdy rozwiązuje inny problem z dostarczaniem danych i każdy niesie własne ryzyka dla jakości i niezawodności, które trzeba monitorować od pierwszego dnia.
Kiedy stosować przetwarzanie wsadowe zamiast strumieniowego?
Wybierz przetwarzanie wsadowe, gdy decyzja biznesowa zapada jutro rano, a nie w ciągu najbliższych kilku sekund. Nocne ładowanie hurtowni Snowflake, cotygodniowe uzgadnianie stanów magazynowych w handlu detalicznym i raportowanie finansowe na koniec dnia dobrze pasują do przetwarzania wsadowego, natomiast wykrywanie nadużyć, alerty IoT i dashboardy na żywo zwykle uzasadniają dodatkowy koszt i złożoność przetwarzania strumieniowego.
Czym różni się architektura lambda od architektury kappa?
Lambda wykorzystuje dwie ścieżki: strumieniową warstwę szybkości dla szybkich, przybliżonych odpowiedzi oraz warstwę wsadową, która ponownie oblicza pełny obraz, a obie są scalane w warstwie udostępniania. Kappa traktuje wszystko jako strumień i ponownie przetwarza historię, odtwarzając log zdarzeń przez tę samą logikę, zwykle z użyciem Kafki oraz Kafka Streams lub Flink.
Co zwykle idzie nie tak w potokach change data capture?
Problemem rzadko jest samo przechwytywanie, lecz zachowanie znaczenia. Usunięcia muszą pozostać widoczne w dalszej części procesu, kolejność aktualizacji musi być poprawna, a zmiany kluczy głównych lub schematu mogą tworzyć duplikaty albo osierocone rekordy, jeśli traktuje się je jak zwykłe dopisania. Research and Markets prognozuje wzrost potoków CDC w tempie od 18% do 20% CAGR do 2030 roku.
Jak monitorować potoki cech dla uczenia maszynowego?
Monitoruj sam potok cech, a nie tylko model, ponieważ problemy z cechami mogą pozostawać niezauważone przez wiele dni, zanim spadnie wydajność. Artykuł zaleca obserwowanie rozkładów cech pod kątem dryfu, sprawdzanie aktualności udostępnianych danych, aby magazyn online nigdy nie serwował nieaktualnych wartości, śledzenie zmian schematu oraz walidację twardych ograniczeń, takich jak nieujemne cechy cenowe.



